Cursus
Développer des LLM
16 h
Imaginez deux étudiants passant le même examen. Le premier passe trois semaines à réviser un seul module, tandis que le second s’est déjà entraîné sur des millions de sujets différents et reçoit, le jour J, une feuille d’exemples corrigés.
Pendant l’essentiel de l’histoire de l’apprentissage automatique, les modèles tabulaires étaient comme le premier étudiant. Chaque nouveau jeu de données imposait de nettoyer les colonnes, d’ingénier des variables, d’entraîner XGBoost ou LightGBM, puis d’ajuster les hyperparamètres pendant des heures.
Les tabular foundation models, eux, ressemblent au second étudiant : vous leur fournissez quelques lignes étiquetées comme exemples, et ils prédisent le reste sans aucun entraînement.
En 2026, cette idée est passée des articles de recherche aux vrais produits, SAP s’engageant à investir plus d’1 milliard € dans Prior Labs et Google publiant son propre modèle. Dans cet article, nous verrons :
Pas d’inquiétude si vous avez peu d’expérience en deep learning. Le code utilise l’interface familière de scikit-learn, et si vous voulez un rappel express, 8 modèles de machine learning expliqués en 20 minutes couvre l’essentiel.
pip install tabicl.Un tabular foundation model est un réseau de neurones préentraîné sur des millions de jeux de données tabulaires synthétiques. Il apprend une stratégie générale pour prédire une colonne cible, puis applique cette stratégie à une nouvelle table par in-context learning, sans entraînement spécifique au jeu de données.
La grande nouveauté tient à quand a lieu l’apprentissage.
Avec XGBoost, l’apprentissage se fait à chaque fois sur vos données lorsque vous entraînez un nouveau modèle. Avec un foundation model tabulaire, l’apprentissage a eu lieu des mois plus tôt pendant la phase de préentraînement, et vos données ne sont qu’un input. Vous verrez aussi quelques termes récurrents :
Comparons-les maintenant aux méthodes de boosting et à l’AutoML :
| Tabular foundation models | Arbres à gradient boosting (XGBoost, LightGBM) | AutoML (AutoGluon, H2O AutoML) | |
|---|---|---|---|
| Temps d’entraînement sur de nouvelles données | Aucun | Secondes à minutes, plus réglages | Minutes à heures |
| Interprétablilité | Limitée (SHAP possible mais lent) | Bonne (importance des variables, SHAP rapide) | Variable, souvent des ensembles peu lisibles |
| Taille de jeu de données idéale | De quelques centaines à ~100 K lignes | De quelques milliers à des millions de lignes | De milliers à des millions de lignes |
| GPU requis ? | Recommandé au-delà de quelques milliers de lignes | Non | Généralement non |
| Petits jeux de données avec split aléatoire | Les meilleurs sur les benchmarks actuels | Solides une fois réglés | Solides mais lents |
Avant d’entrer dans le fonctionnement, comparons-les rapidement aux modèles les plus connus : les grands modèles de langage.
Les grands modèles de langage (LLM) et les tabular foundation models utilisent tous deux des transformers et apprennent à partir d’exemples fournis en entrée.
La différence tient à ce qu’ils sont conçus pour lire. Un LLM lit une table comme une longue chaîne de texte : il doit déduire, à partir de virgules et d’espaces, quels nombres appartiennent à la même colonne.
Il y a aussi un problème de sens.
La valeur 42 peut être un âge ou un chiffre d’affaires, mais le nombre seul ne le dit pas. Un tabular foundation model est entraîné à traiter chaque colonne comme une variable à part et chaque ligne comme un exemple, pour se concentrer sur les relations entre colonnes.
Voyez-le ainsi : un LLM excelle pour parler de vos données, un tabular foundation model est conçu pour faire le calcul dessus.
Les deux peuvent aussi travailler ensemble, comme H2O.ai positionne son modèle tabH2O : l’outil de prédiction qu’un agent IA appelle quand il lui faut un chiffre à partir d’un tableur.
Parce qu’une table n’a pas de structure commune que le réseau peut apprendre une fois pour toutes et réutiliser. Un pixel est un pixel dans chaque photo. Une colonne nommée score dans un jeu financier et une colonne score dans un jeu de football n’ont rien en commun.
Un article célèbre de 2022 signé Léo Grinsztajn, Edouard Oyallon et Gaël Varoquaux, Why do tree-based models still outperform deep learning on tabular data?, testant 45 jeux de données, a montré que les modèles à arbres, en particulier le gradient boosting, restent supérieurs sur des tables de taille moyenne (~10 000 lignes). Les raisons identifiées :
Deux problèmes très pratiques aggravent cela : une table peut mélanger numériques, catégorielles, rangs et valeurs manquantes, et la plupart des tables métier n’ont que quelques centaines ou milliers de lignes, bien trop peu pour entraîner un réseau à partir de zéro.
À mon sens, la petite taille des données est le problème majeur. Un réseau entraîné à zéro sur 800 lignes n’a aucun acquis sur lequel s’appuyer, alors qu’un arbre n’a pas besoin de connaissances préalables pour fonctionner.
C’est justement ce que le préentraînement a résolu. Un tabular foundation model s’est déjà exercé sur des millions de petites tables imparfaites avant de voir la vôtre : il ne part pas de zéro.
Un tabular foundation model prend ensemble vos lignes d’entraînement étiquetées et vos lignes de test non étiquetées comme une seule entrée, puis prédit les étiquettes manquantes en un seul passage avant. Ses poids ne changent jamais, comme un LLM qui répond à une question après quelques exemples dans le prompt.
Cela modifie aussi le sens des méthodes scikit-learn que vous connaissez.
Lorsque vous appelez .fit() sur TabICL, la documentation TabICL explique qu’il charge le checkpoint préentraîné, prétraite vos données et les stocke. Le vrai travail se fait pendant .predict().
Le nom .fit() demeure pour que le modèle s’insère facilement dans votre code scikit-learn existant.
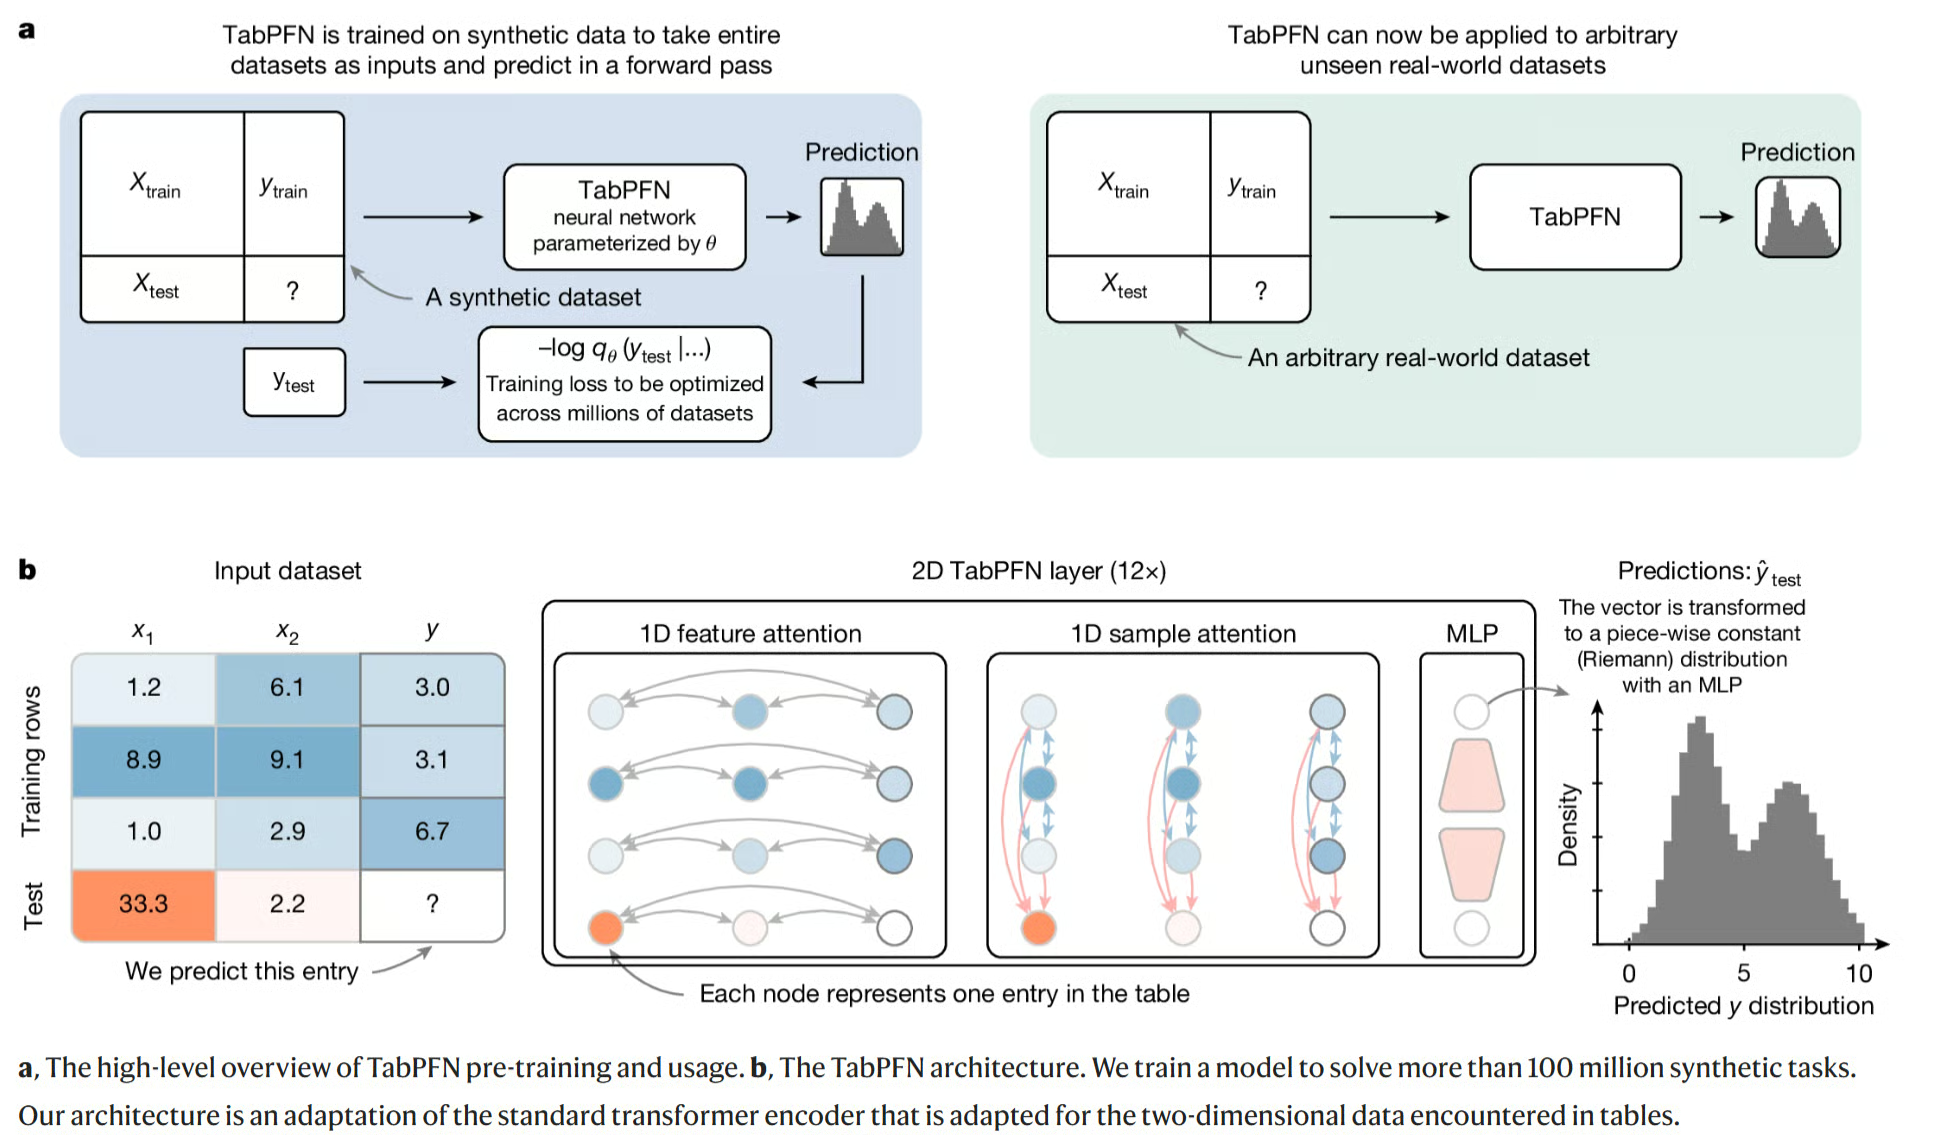
Figure 1 : TabPFN est préentraîné sur des millions de jeux synthétiques, puis prédit sur une table réelle en un forward pass. Le panneau du bas montre l’attention entre caractéristiques et échantillons. Source : Hollmann et al., « Accurate predictions on small data with a tabular foundation model », Nature (2025).
Le préentraînement synthétique consiste à entraîner le modèle sur des tables inventées plutôt que réelles, générées par un moteur qui fonctionne comme un modèle génératif.
Pensez à un pilote dans un simulateur de vol. Il s’exerce sur des milliers de faux vols, avec météos, aéroports et pannes variés, afin que le premier vrai vol ne soit pas une nouveauté.
TabPFN procède de manière similaire.
Ses créateurs ont écrit un générateur qui invente des règles aléatoires de « cause à effet » entre colonnes (par exemple, la colonne A influence B, qui influence la cible), puis produit des lignes à partir de ces règles.
Durant le préentraînement, la colonne cible est masquée, le modèle tente de la prédire, et cela se répète des millions de fois avec des règles, niveaux de bruit et tailles de table différents.
L’essentiel est que le modèle n’apprend aucun fait sur un domaine réel. Il acquiert des compétences générales : repérer les colonnes utiles, gérer les valeurs aberrantes, savoir quand être incertain.
De fait, l’article TabICLv2 attribue une bonne part des progrès à son nouveau générateur de données synthétiques.
Sans entrer dans tous les détails d’architecture, retenez qu’il existe deux conceptions principales :
Notez que ces deux familles sont entraînées sur des données synthétiques : « prior-fitted network » décrit une façon d’entraîner, pas un type de modèle à part.
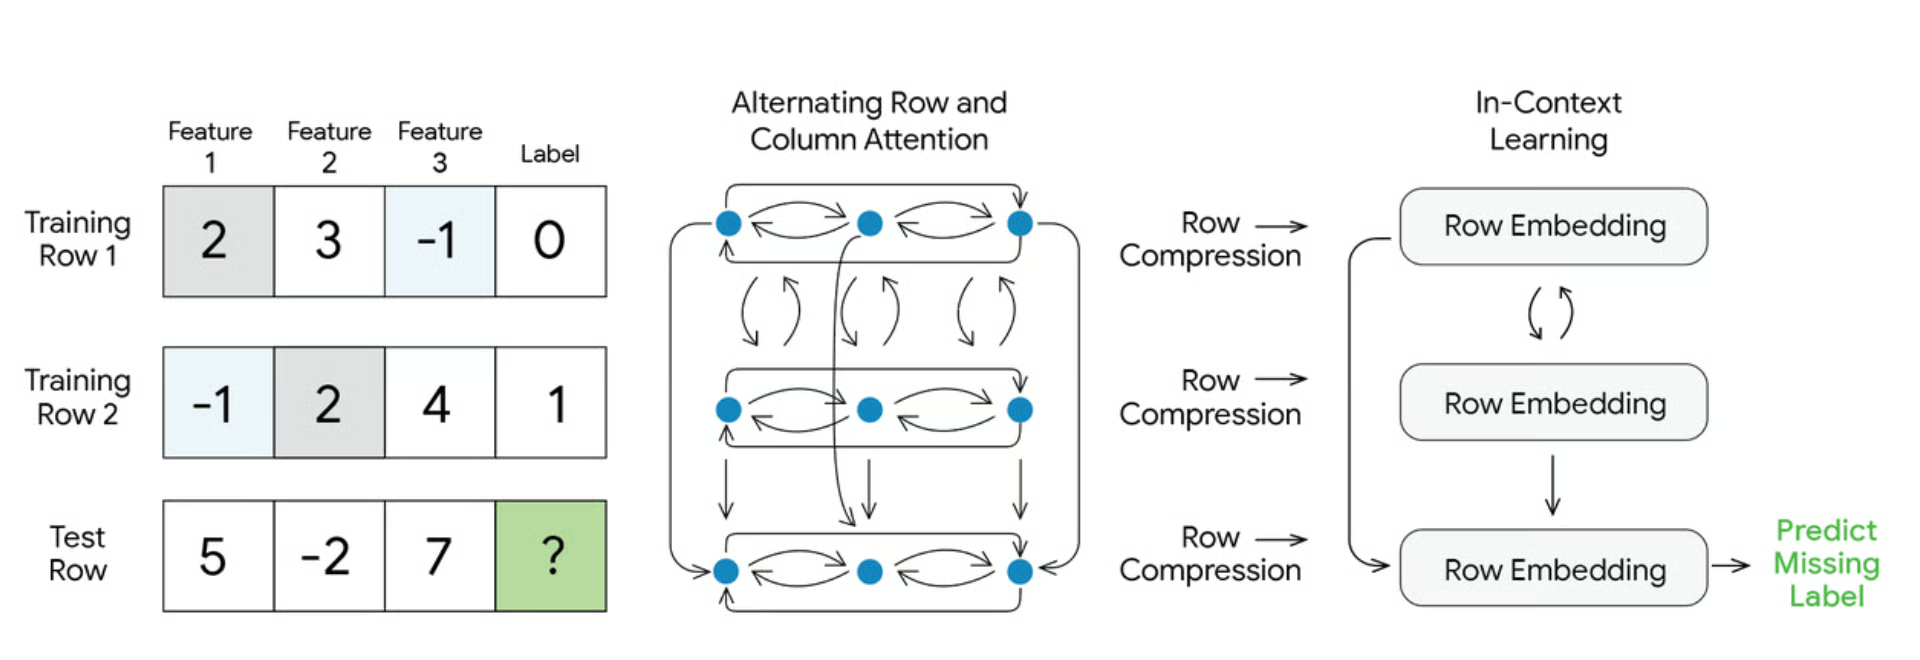
Figure 2 : TabFM mélange les deux approches : attention à la TabPFN sur lignes et colonnes, puis compression à la TabICL, puis in-context learning pour l’étiquette manquante. Source : Google Research, « Introducing TabFM: A zero-shot foundation model for tabular data » (2026).
Il y a un compromis qui surprend souvent.
XGBoost passe du temps à s’entraîner une fois, puis prédit presque instantanément.
Un tabular foundation model zappe l’entraînement, mais doit relire toutes vos lignes d’entraînement à chaque prédiction.
Imaginez un chef qui ne fait aucune préparation avant le service, mais doit relire tout le livre de recettes à chaque commande.
Avec un petit livre, ça passe, mais plus le jeu de données grossit, plus les prédictions ralentissent. TabICL et TabPFN peuvent mettre en cache leur « lecture » des données d’entraînement pour accélérer les prédictions répétées, mais la première passe coûte toujours.
Les modèles clés en 2026 sont TabPFN, TabICLv2, TabFM de Google, NEXUS de Fundamental et tabH2O de H2O.ai. Ce qui frappe, c’est la vitesse côté business : en cinq mois, on est passé des papiers académiques aux gros deals. Chronologie résumée :
Voyons-les un à un, en commençant par le modèle fondateur.
TabPFN a créé cette catégorie. TabPFN-2 a été publié dans Nature en janvier 2025 et a surpassé les arbres réglés jusqu’à 10 000 lignes.
Depuis, Prior Labs a enchaîné les versions. TabPFN-3, mai 2026, gère jusqu’à 1 million de lignes (et 200 variables). Il ajoute aussi un mode Thinking (via API payante) qui consacre plus de temps lors du fit pour améliorer les prédictions.
La dernière version, TabPFN-3.5, est sortie en septembre 2026. Son rapport technique revendique la tête sur plusieurs benchmarks majeurs, y compris sur des données temporelles et groupées. À prendre comme des chiffres éditeur en attendant des confirmations indépendantes.
Un point important : la licence. TabPFN-2 est utilisable commercialement avec attribution à Prior Labs, mais les versions 2.5 à 3.5 sont non commerciales. Vous pouvez expérimenter gratuitement, mais l’usage en production nécessite une licence payante.
TabICLv2 est actuellement le meilleur modèle tabulaire entièrement ouvert. Développé à l’Inria, publié en février 2026 et accepté à ICML 2026.
Le résultat phare de l’article TabICLv2 : sans aucun réglage, il dépasse RealTabPFN-2.5, l’état de l’art précédent, malgré l’optimisation, l’ensembling et le fine-tuning de ce dernier sur des données réelles.
D’après son dépôt GitHub, il surpasse aussi XGBoost, CatBoost et LightGBM très réglés sur environ 80 % des jeux du benchmark TabArena.
Il est aussi rapide : 50 000 lignes avec 100 variables en moins de 10 secondes sur un GPU H100, environ 10 fois plus vite que TabPFN-2.5.
Il donne le meilleur de 300 à 100 000 lignes et peut monter jusqu’à ~500 000 avec une légère perte de précision.
À mon avis, c’est celui par lequel la plupart devraient commencer.
Installation via pip install tabicl, API scikit-learn classique, licence permissive utilisable commercialement sans inscription. Le classement bouge vite, et le rapport de TabPFN-3.5 se donne désormais devant TabICLv2.
TabFM est le modèle tabulaire de Google Research, publié le 30 juin 2026. Sa spécificité tient à où vous pouvez l’utiliser : il est intégré à BigQuery, l’entrepôt de données cloud de Google, donc vous obtenez des prédictions en SQL.
-- Utiliser les clients passés (avec churn connu) pour prédire le churn des nouveaux clients
-- AI.PREDICT est en préversion, vérifiez la doc BigQuery pour la syntaxe la plus récente
SELECT *
FROM AI.PREDICT(
  TABLE my_dataset.customers_history,
  TABLE my_dataset.customers_new,
  label_col => 'churned'
);
Idéal pour celles et ceux qui maîtrisent SQL mais pas Python.
Cependant, la documentation BigQuery limite actuellement à 20 colonnes de caractéristiques et 10 classes, et Google prévoit une tarification à la consommation (tokens) en plus des frais BigQuery à partir du 30 octobre 2026. Les poids sur Hugging Face sont non commerciaux, donc l’usage commercial passe par BigQuery.
NEXUS est un modèle fermé orienté entreprises, développé par Fundamental, startup de San Francisco fondée par d’anciens chercheurs de DeepMind. Lancé en février 2026 avec 255 M$ et présenté comme un Large Tabular Model (LTM).
Les entreprises l’achètent et l’exploitent via AWS. Fundamental affirme que des entreprises du Fortune 100 l’utilisent déjà pour la prévision de la demande, la tarification et le churn. Mais il n’y a ni poids publics ni benchmarks vérifiables : à considérer comme une option enterprise.
tabH2O est le modèle de H2O.ai, avec une promesse simple : vous envoyez vos données, vous recevez des prédictions.
Il gère pour vous les valeurs manquantes et les catégories et peut tourner sur les serveurs de l’entreprise, point crucial pour banques et hôpitaux qui ne peuvent pas envoyer leurs données dans le cloud.
Ce que j’apprécie, c’est que l’article tabH2O ne survend pas le modèle. Il dépasse CatBoost et LightGBM réglés sur le benchmark TALENT, mais reste derrière TabICLv2.
| Modèle | Éditeur | Poids ouverts ? | Échelle max. | Licence | Idéal pour |
|---|---|---|---|---|---|
| TabPFN-2 | Prior Labs | Oui | 10K lignes | Commerciale avec attribution | Usage commercial d’un modèle éprouvé plus ancien |
| TabPFN-3 / 3.5 | Prior Labs (SAP) | Oui, sous réserve d’accepter une licence | Jusqu’à 1M de lignes | Non commerciale, API payante pour l’entreprise | Précision au top et avancées de recherche |
| TabICLv2 | Inria | Oui | Optimal jusqu’à 100K lignes | Open source permissive | Votre point de départ par défaut |
| TabFM | Google Research | Oui | 20 features dans BigQuery | Poids non commerciaux | Utilisateurs SQL sur BigQuery |
| NEXUS | Fundamental | Non | Non divulgué | Propriétaire | Grandes entreprises sur AWS |
| tabH2O | H2O.ai | Non | Non divulgué | API commerciale | Équipes sans stack ML, agents IA |
Exactement comme n’importe quel modèle scikit-learn.
Le plus parlant est de l’opposer à XGBoost. Faisons-le sur le jeu « breast cancer » intégré à scikit-learn.
D’abord, installer les packages :
pip install tabicl xgboost scikit-learnPuis exécuter les deux modèles sur le même split :
from sklearn.datasets import load_breast_cancer
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from tabicl import TabICLClassifier
from xgboost import XGBClassifier

# Charger un petit jeu tabulaire en DataFrame pandas
X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# Modèle tabulaire : fit() stocke simplement les lignes d’entraînement
tfm = TabICLClassifier()
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)

# Baseline XGBoost avec des réglages raisonnables, non optimisés
xgb = XGBClassifier(n_estimators=300, learning_rate=0.05, max_depth=4)
xgb.fit(X_train, y_train)
xgb_preds = xgb.predict(X_test)

print(f"TabICL accuracy:  {accuracy_score(y_test, tfm_preds):.3f}")
print(f"XGBoost accuracy: {accuracy_score(y_test, xgb_preds):.3f}")
Ce petit jeu tourne très bien sur un CPU d’ordinateur portable.
Les deux modèles auront un score très élevé sur un jeu propre comme celui-ci, ne les jugez pas sur un seul split. Le vrai test, ce sont vos propres données imparfaites.
Si vous voulez essayer TabPFN à la place, lancez pip install tabpfn, puis deux lignes à changer :
from tabpfn import TabPFNClassifier

tfm = TabPFNClassifier()  # Le premier run vous demande d’accepter la licence
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)
Un point crucial avant de comparer des modèles sur vos données réelles.
Si vous avez des dates, faites le split dans le temps et non aléatoirement. Sinon, le modèle jette un coup d’œil au futur, et comme vous le verrez plus loin, c’est précisément là que les tabular foundation models paraissent meilleurs qu’ils ne le sont.
Ils excellent quand votre jeu de données est petit à moyen et que les lignes de test ressemblent aux lignes d’entraînement. Ils peinent avec les données ordonnées dans le temps, groupées, les très grandes tables et quand l’explicabilité stricte est requise.
Ce « les lignes de test ressemblent aux lignes d’entraînement » a un nom : IID (indépendantes et identiquement distribuées), et c’est le point à vérifier en priorité.
Commençons par leurs points forts :
Passons aux limites, cruciales pour un projet réel.
Le benchmark BeyondArena, publié en juin 2026, a testé 11 modèles sur 142 jeux, y compris des splits temporels (prédire le futur à partir du passé) et par groupe (prédire pour un nouvel hôpital ou pays).
Conclusion : les tabular foundation models brillent sur des données IID petites à moyennes, tandis que les arbres et d’autres réseaux tiennent la corde sur le temporel, le groupé, le volumineux et le très large. Comme la plupart des données métier (ventes, fraude, churn) sont temporelles, cette limite se voit souvent en pratique.
TabPFN-3.5, publié après BeyondArena, affirme combler cet écart sur le temporel et le groupé. Prometteur, mais pas encore validé indépendamment.
Vous pouvez obtenir des valeurs SHAP pour TabICL et TabPFN, mais c’est bien plus long que SHAP sur un modèle à arbres, et il n’y a pas de coupures d’arbre à inspecter. En scoring crédit, où les règulateurs exigent de comprendre le modèle, c’est un vrai frein.
Au-delà de quelques milliers de lignes, un GPU devient souhaitable, et les prédictions ralentissent à mesure que l’entraînement grandit. Un XGBoost entraîné sur CPU restera le plus rapide.
TabPFN-2 est commercial avec crédit, les versions récentes de TabPFN sont non commerciales, les poids de TabFM sont non commerciaux, TabICLv2 est permissif.
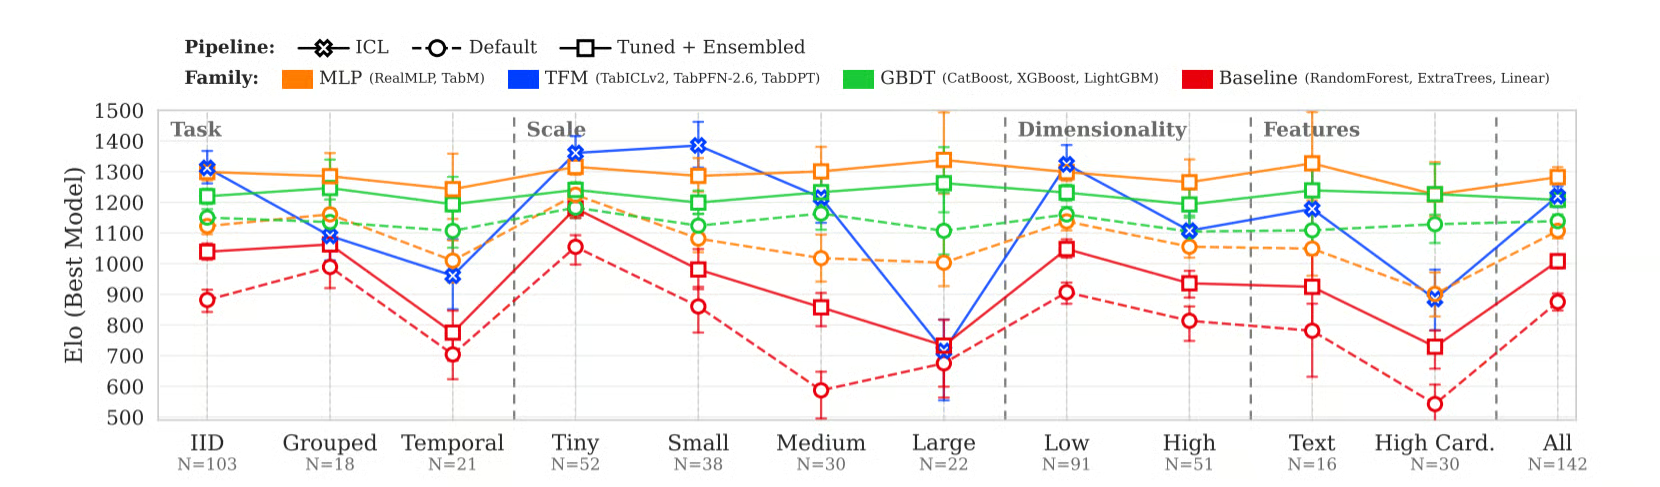
Figure 3 : Elo par famille (plus haut = mieux). Les tabular foundation models mènent sur petites données IID mais chutent sur les jeux temporels et volumineux, où arbres et MLP tiennent mieux. En bleu : le meilleur de TabICLv2, TabPFN-2.6 et TabDPT, pas les versions les plus récentes de TabPFN. Source : Purucker et al., « Beyond IID: How General Are Tabular Foundation Models, Really? » (2026), CC BY 4.0.
Vous serez sans doute d’accord : ces modèles ont relevé le niveau d’un baseline rapide et sans effort, mais les arbres restent souvent le meilleur choix en situation réelle.
Optez pour un tabular foundation model si votre jeu est petit à moyen et IID, et si vous n’avez pas besoin d’un modèle pleinement explicable ni de prédictions CPU ultra-rapides. Voici la grille décisionnelle que je recommande :
| Scénario | Approche recommandée |
|---|---|
| Moins de 10K lignes, IID, pas de besoin d’explication | Commencer par TabICLv2 ou TabPFN |
| 10K à 100K lignes, IID | Tester TabICLv2 et XGBoost, garder le gagnant |
| 100K à 1M de lignes | Commencer par XGBoost ou LightGBM, essayer TabPFN-3 en challenger |
| Données découpées dans le temps ou par groupe | Commencer par des modèles à arbres |
| Besoin de SHAP, importance des variables ou audit | Modèle à arbres avec SHAP |
| Prédictions rapides sans GPU | Modèle à arbres |
| POC express, sans stack ML | TabICLv2, ou BigQuery AI.PREDICT si vos données y sont |
| Agent IA qui doit prédire depuis des tables | Une API comme tabH2O ou NEXUS |
Avant de choisir, posez-vous ces trois questions :
Dernier conseil : lancez d’abord un tabular foundation model, cela ne coûte que quelques minutes. S’il ne bat pas XGBoost sur vos données, vous savez que l’ingénierie de variables et le tuning XGBoost valent l’investissement.
Souvenez-vous des deux étudiants du début : en 2026, le second, celui qui s’est exercé sur des millions d’examens, peut enfin dépasser celui qui a révisé des semaines, du moins sur des tables petites à moyennes.
Les tabular foundation models remplacent l’entraînement spécifique à chaque jeu par du préentraînement, et remplacent fit() par l’apprentissage à partir d’exemples.
Ce qui m’étonne le plus, c’est la vitesse des progrès. TabPFN-2 a montré en 2025 qu’un réseau pouvait battre des arbres réglés sur de petites tables, et TabICLv2 et TabPFN-3 ont depuis étendu cela à des tables bien plus grandes.
Les chantiers ouverts concernent le temporel, la donnée qui évolue, l’explicabilité et les licences : exactement ce qui conditionne le passage en production.
Mon conseil : considérez ces modèles comme votre nouveau point de départ, puis choisissez l’outil final selon vos données, vos contraintes et l’environnement d’exécution.
Et pour maîtriser les modèles à arbres qui restent gagnants dans de nombreux cas, explorez nos cours Machine Learning with Tree-Based Models in Python et le parcours Supervised Machine Learning in Python. Si vous travaillez en R, Machine Learning with Tree-Based Models in R couvre les mêmes notions.
Top DataCamp Courses
Cursus
Cours
Cursus
blog
Kurtis Pykes
9 min
blog
blog
Kurtis Pykes
15 min
Tutoriel
Josef Waples
8 min
Tutoriel
Samuel Shaibu
9 min
Tutoriel
DataCamp Team
3 min