Трек
Разработка больших языковых моделей
16 ч
Представьте двух студентов на одном экзамене. Первый тратит три недели, изучая только один модуль, а второй уже прорешал миллионы разных экзаменов и в день теста получает лист с разобранными примерами.
На протяжении большей части истории машинного обучения табличные модели были как первый студент. Каждый новый датасет означал чистку столбцов, создание признаков, обучение XGBoost или LightGBM и долгую настройку гиперпараметров.
Табличные базовые модели — это второй студент: вы даёте им размеченные строки в качестве примеров, и они предсказывают остальное вообще без обучения.
В 2026 году эта идея перешла от научных статей к реальным продуктам: SAP выделила более €1 млрд Prior Labs, а Google выпустила собственную модель. В этой статье мы рассмотрим:
Не переживайте, если у вас мало опыта в глубоком обучении. Код в статье использует знакомый интерфейс scikit-learn, а если нужен быстрый повтор, в материале 8 моделей машинного обучения за 20 минут разобраны основы.
pip install tabicl.Табличная базовая модель — это нейронная сеть, предобученная на миллионах синтетических табличных датасетов. Она усваивает общую стратегию предсказания целевого столбца и затем применяет её к новой таблице через обучение в контексте, без какого-либо обучения под конкретный датасет.
Главное изменение — это когда происходит обучение.
В XGBoost обучение происходит на ваших данных каждый раз, когда вы тренируете новую модель. В табличной базовой модели обучение было завершено месяцы назад на этапе предобучения, а ваши данные — просто вход. Ниже — несколько терминов, которые будут встречаться, поясним их простым языком:
Теперь сравним табличные базовые модели с методами бустинга и автоматическим ML (AutoML):
| Табличные базовые модели | Градиентный бустинг по деревьям (XGBoost, LightGBM) | AutoML (AutoGluon, H2O AutoML) | |
|---|---|---|---|
| Время обучения на новых данных | Нет | Секунды–минуты плюс настройка | Минуты–часы |
| Интерпретируемость | Ограниченная (SHAP возможен, но медленный) | Хорошая (важность признаков, быстрый SHAP) | Зависит, часто трудночитаемые ансамбли |
| Оптимальный размер датасета | Сотни — около 100 тыс. строк | Тысячи — многие миллионы строк | Тысячи — миллионы строк |
| Нужен ли GPU? | Рекомендуется свыше нескольких тысяч строк | Нет | Обычно нет |
| Малые датасеты со случайным разбиением | Лучшие в текущих бенчмарках | Сильны при настройке | Сильны, но медленны |
Прежде чем разбираться, как они работают, быстро сравним их с самыми известными и массовыми моделями — крупными языковыми моделями.
Большие языковые модели (LLM) и табличные базовые модели обе используют трансформеры и обе учатся на примерах во входных данных.
Разница в том, что именно они «читают». LLM видит таблицу как длинную строку текста, и ей приходится по запятым и пробелам определять, какие числа относятся к одному столбцу.
Есть и проблема смысла.
Значение 42 может быть и возрастом человека, и выручкой, но само по себе число этого не говорит. Табличная базовая модель обучена рассматривать каждый столбец как отдельную переменную, а каждую строку — как один пример, поэтому она фокусируется на связях между столбцами.
Можно думать так: LLM отлично «говорит» о ваших данных, а табличная базовая модель создана, чтобы «считать» по ним.
Они также могут работать вместе — именно так позиционирует свою модель tabH2O компания H2O.ai: как инструмент предсказаний, к которому обращается AI-агент, когда ему нужно число из электронной таблицы.
Табличные данные сложны для глубокого обучения, потому что у таблиц нет общей структуры, которую нейросеть могла бы выучить один раз и переиспользовать. Пиксель — это пиксель в каждом фото. Столбец с названием score в финансовом датасете и столбец score в футбольном датасете не имеют ничего общего.
Известная статья 2022 года Лэо Гринштайна, Эдуара Ойайона и Гаэля Вароксо Why do tree-based models still outperform deep learning on tabular data? протестировала 45 датасетов и показала, что модели на деревьях, особенно градиентный бустинг, по-прежнему превосходят глубокое обучение на средних таблицах порядка 10 000 строк. Причины такие:
Два практических фактора усугубляют ситуацию. В одной таблице могут смешиваться числа, категории, ранги и пропуски, а большинство бизнес-таблиц содержат лишь сотни или тысячи строк — слишком мало для нейросети «с нуля».
Я бы сказал, что малые датасеты — главная проблема. Нейросеть, обученная на 800 строках «с нуля», не на что опереться, тогда как деревьям не нужны предварительные знания, чтобы работать.
Именно это исправило предобучение. Табличная базовая модель уже «потренировалась» на миллионах небольших, «грязных», вымышленных таблиц до встречи с вашей, так что она не начинает с нуля.
Табличная базовая модель принимает ваши размеченные тренировочные строки и неразмеченные тестовые строки единым входом и предсказывает отсутствующие метки за один прямой проход. Её веса не меняются — как у LLM, отвечающей на вопрос после нескольких примеров в подсказке.
Это меняет и смысл знакомых методов scikit-learn.
Когда вы вызываете .fit() у TabICL, документация TabICL поясняет, что он загружает предобученный чекпойнт, предобрабатывает ваши данные и сохраняет их. Настоящая работа происходит в .predict().
Имя .fit() сохраняется, чтобы модель вписывалась в существующий код на scikit-learn.
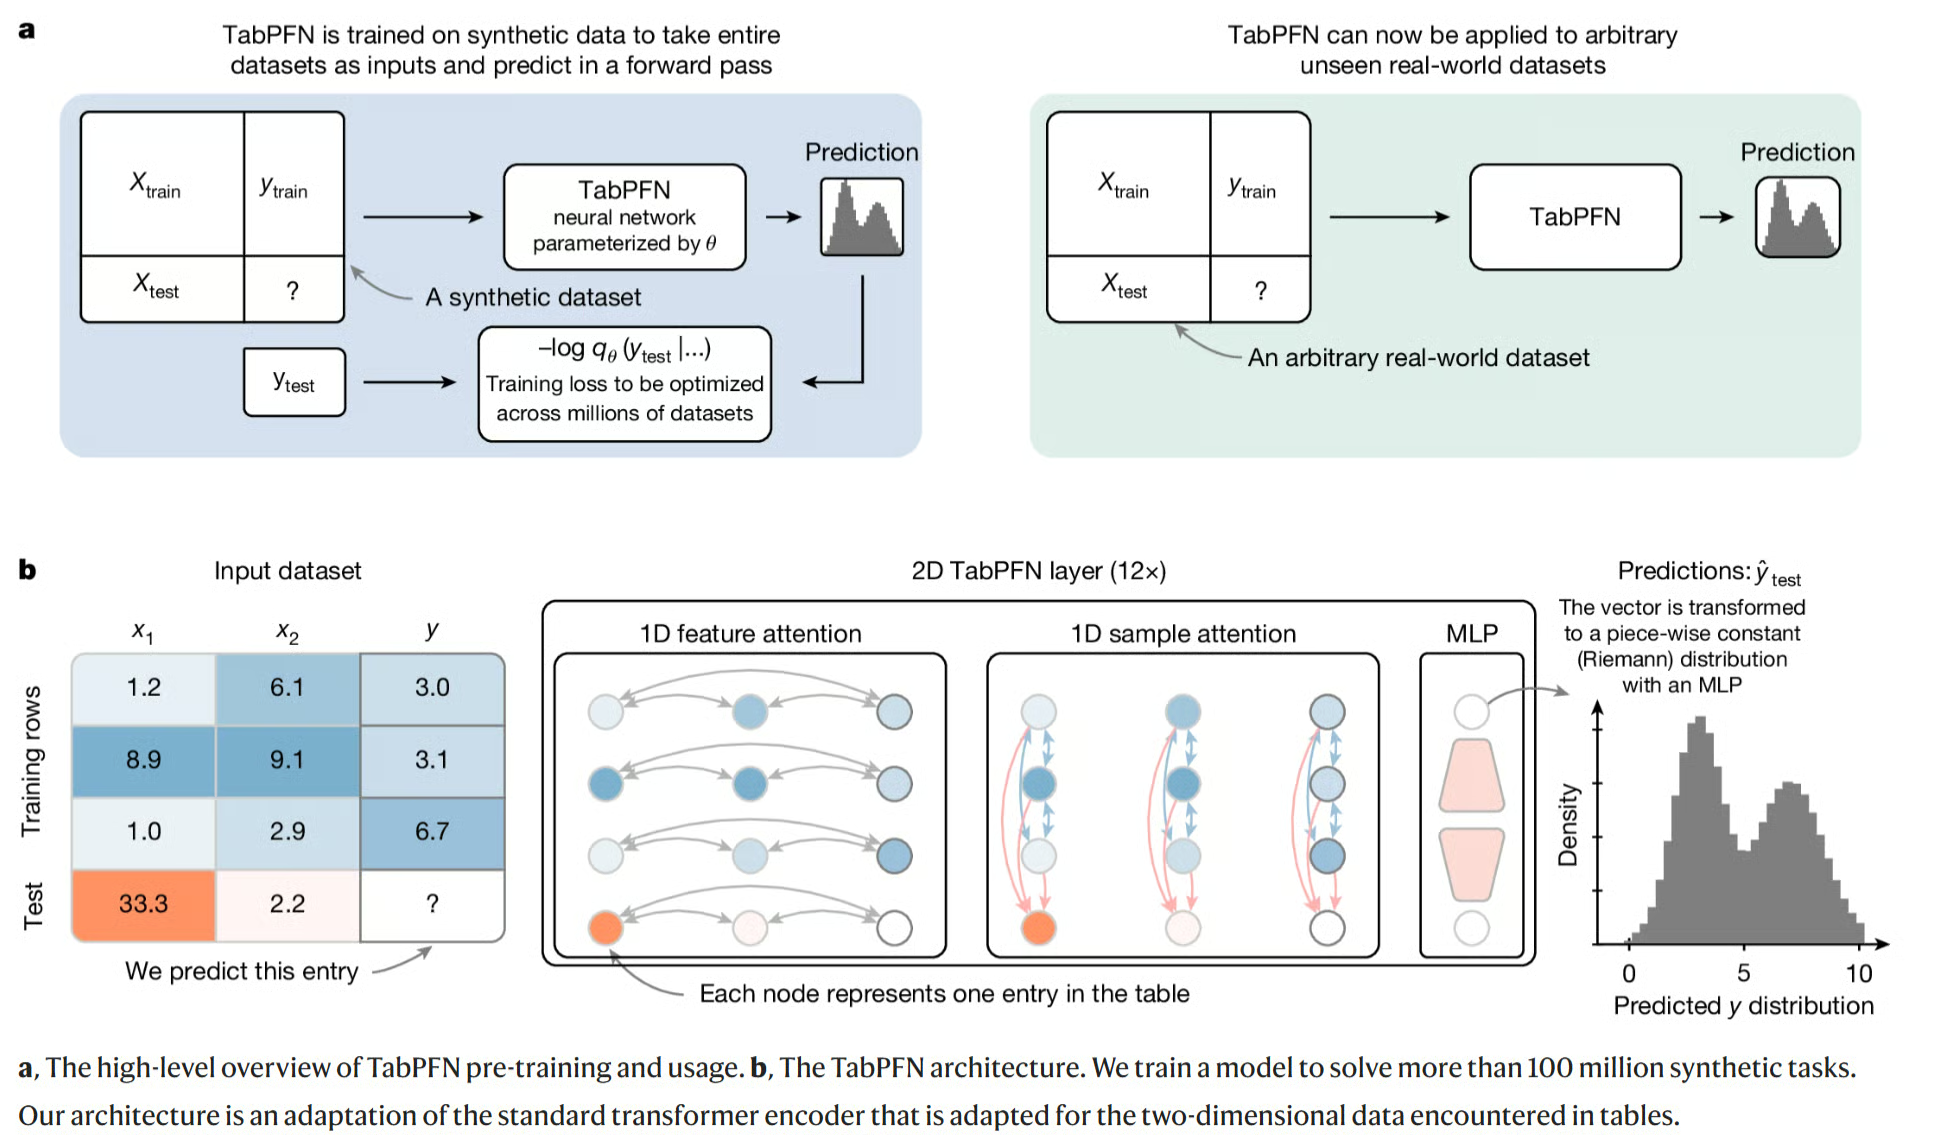
Рисунок 1. TabPFN предобучается на миллионах синтетических датасетов, затем предсказывает по реальной таблице за один прямой проход. Нижняя панель показывает, как внимание распределяется по признакам и объектам. Источник: Hollmann et al., «Accurate predictions on small data with a tabular foundation model», Nature (2025).
Синтетическое предобучение означает обучение модели на вымышленных таблицах, созданных генератором данных, работающим как генеративная модель.
Представьте пилота в авиасимуляторе. Он выполняет тысячи фиктивных полётов с разной погодой, аэропортами и отказами, чтобы первый реальный рейс не был в новинку.
TabPFN работает схожим образом.
Его авторы написали генератор, который придумывает случайные правила «причины и следствия» между столбцами (например, столбец A влияет на столбец B, который влияет на целевой), а затем генерирует строки по этим правилам.
Во время предобучения целевой столбец скрывается, модель пытается его предсказать, и это повторяется миллионы раз с разными правилами, уровнями шума и размерами таблиц.
Важно, что модель не запоминает факты о реальных темах. Она учится общим навыкам: выделять значимые столбцы, обрабатывать выбросы и понимать, когда она не уверена.
Собственно, в статье о TabICLv2 новая система генерации синтетических данных названа одной из ключевых причин улучшенной точности.
Необязательно вникать во все архитектурные детали, но полезно знать про два основных подхода:
Учтите, что обе семейства обучаются на синтетических данных, так что «prior-fitted network» описывает способ обучения, а не отдельный тип модели.
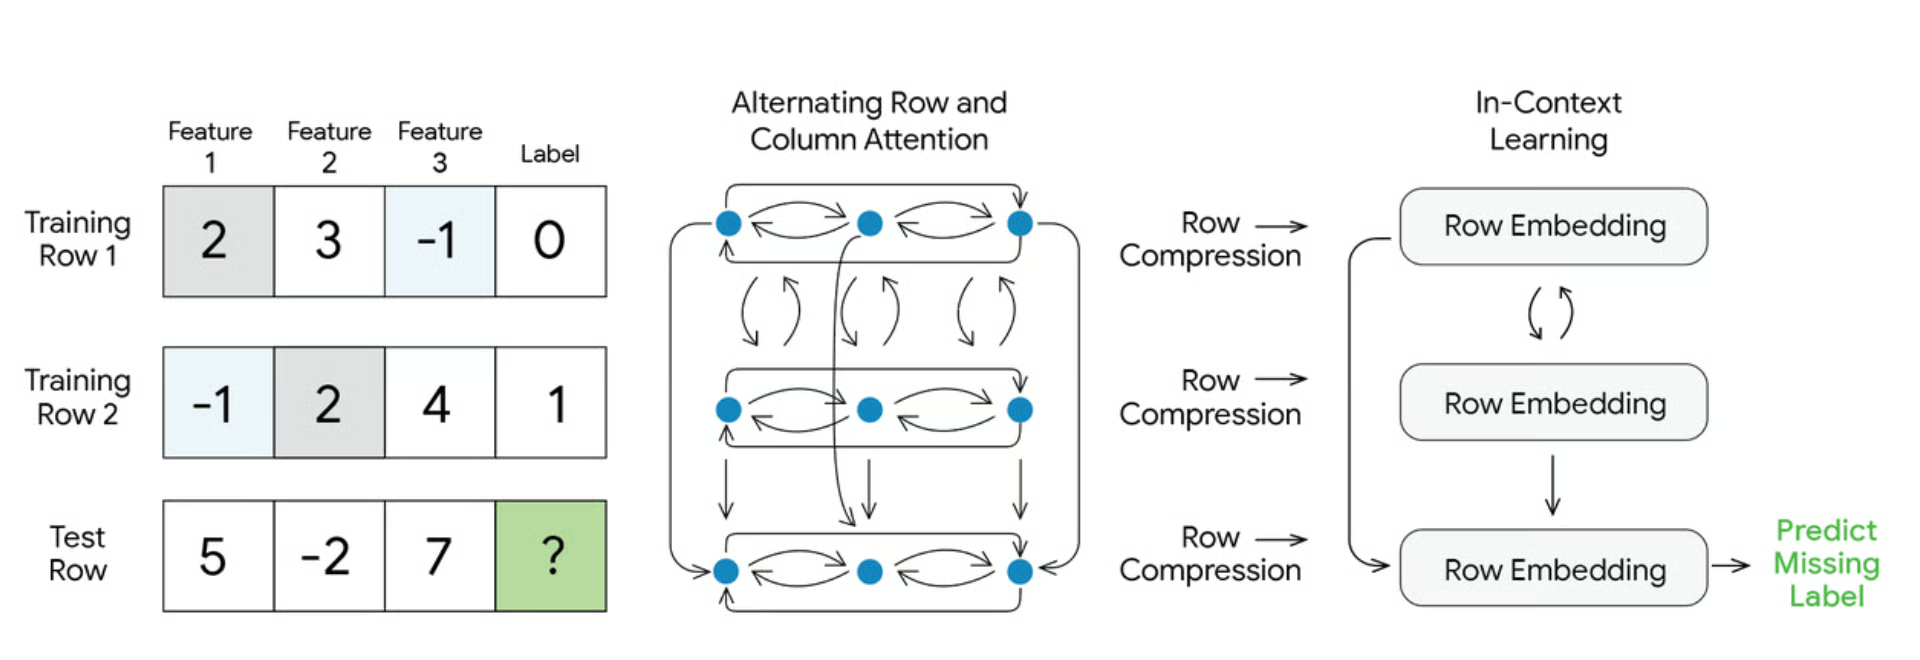
Рисунок 2. TabFM сочетает оба подхода: внимание в стиле TabPFN по строкам и столбцам, затем сжатие строк по типу TabICL и обучение в контексте для пропущенной метки. Источник: Google Research, «Introducing TabFM: A zero-shot foundation model for tabular data» (2026).
Здесь есть компромисс, о который многие спотыкаются.
XGBoost тратит время на разовое обучение, затем предсказывает почти мгновенно.
Табличная базовая модель пропускает обучение, но вынуждена каждый раз при предсказании читать все ваши тренировочные строки.
Это как шеф-повар, который не делает заготовки до смены, но для каждого заказа заново перечитывает всю кулинарную книгу.
Если книга маленькая — нормально, но с ростом датасета предсказания замедляются. И TabICL, и TabPFN могут кэшировать своё «прочтение» тренировочных данных для ускорения повторных предсказаний, но первый проход всё равно стоит времени.
Ключевые табличные базовые модели 2026 года — TabPFN, TabICLv2, TabFM от Google, NEXUS от Fundamental и tabH2O от H2O.ai. Примечательно, как быстро всё сдвинулось в бизнесе: за пять месяцев область прошла путь от академических статей до крупных сделок. Короткая хронология:
Теперь разберём каждую модель, начиная с той, которая положила начало направлению.
TabPFN — модель, создавшая эту категорию. TabPFN-2 была опубликована в Nature в январе 2025 года и обогнала настроенные модели на деревьях на датасетах до 10 000 строк.
С тех пор Prior Labs быстро выпускала новые версии. TabPFN-3 вышла в мае 2026 и обрабатывает до 1 млн строк (и до 200 признаков). Появился режим Thinking (через платный API), который тратит больше времени на этапе fit для улучшения предсказаний.
Последняя версия, TabPFN-3.5, вышла в сентябре 2026, и её технический отчёт заявляет о первом месте в нескольких крупных бенчмарках, включая задачи с упорядоченными по времени и сгруппированными данными. Я бы относился к этим цифрам как к данным компании до независимого подтверждения.
Ещё важный момент — лицензия. TabPFN-2 можно использовать коммерчески при указании Prior Labs, но версии с 2.5 по 3.5 — некоммерческие. Это значит, что экспериментировать с ними можно бесплатно, а для реального продукта нужна платная лицензия.
TabICLv2 — лучшая полностью открытая табличная базовая модель на сегодня. Её разработали в Inria, выпустили в феврале 2026 года, и она принята на ICML 2026.
Главный результат из статьи о TabICLv2: без какой-либо настройки она обогнала RealTabPFN-2.5, предыдущую лучшую модель, хотя та была настроена, ансамблирована и дообучена на реальных данных.
Согласно репозиторию на GitHub, она также обгоняет сильно настроенные XGBoost, CatBoost и LightGBM примерно на 80% датасетов в бенчмарке TabArena.
Она быстрая: обрабатывает 50 000 строк со 100 признаками менее чем за 10 секунд на H100 GPU — примерно в 10 раз быстрее TabPFN-2.5.
Лучше всего работает между 300 и 100 000 строк и может дотянуть до ~500 000 строк с некоторой потерей точности.
На мой взгляд, большинству читателей стоит начинать именно с неё.
Устанавливается через pip install tabicl, работает как любая модель scikit-learn, а разрешительная лицензия позволяет коммерческое использование без регистрации. Лидеры меняются быстро, и отчёт TabPFN-3.5 теперь ставит себя выше TabICLv2.
TabFM — табличная базовая модель Google Research, выпущенная 30 июня 2026 года. Её особенность — где её можно использовать: она встроена в BigQuery, облачное хранилище данных Google, так что получить предсказания можно на чистом SQL.
-- Use past customers (with known churn) to predict churn for new customers
-- AI.PREDICT is in preview, so check the BigQuery docs for the latest syntax
SELECT *
FROM AI.PREDICT(
  TABLE my_dataset.customers_history,
  TABLE my_dataset.customers_new,
  label_col => 'churned'
);
Это отлично для тех, кто знает SQL, но не Python.
Однако документация BigQuery пока ограничивает 20 признаками и 10 классами, а с 30 октября 2026 года Google планирует добавить тарификацию по токенам сверх стандартных платежей BigQuery. Веса модели на Hugging Face — некоммерческие, так что коммерческое использование — через BigQuery.
NEXUS — закрытая, корпоративная модель от Fundamental, стартапа из Сан‑Франциско, основанного бывшими исследователями DeepMind. Запущена в феврале 2026 с финансированием $255 млн; компания называет её Large Tabular Model (LTM).
Бизнесы покупают и запускают NEXUS через AWS; по словам Fundamental, компании из Fortune 100 уже используют её для прогнозирования спроса, ценообразования и оттока клиентов. Публичных весов и бенчмарков для самостоятельной проверки нет, так что я бы рассматривал её как корпоративный вариант.
tabH2O — модель H2O.ai, и вся идея проста: отправьте данные — получите предсказания.
Она сама обрабатывает пропуски и категории и может работать на серверах компании — важно для банков и больниц, которым нельзя отправлять данные в облако.
Мне нравится, что в статье о tabH2O нет перегибов. Она обогнала настроенные CatBoost и LightGBM на бенчмарке TALENT, но всё же уступила TabICLv2.
| Модель | Разработчик | Открытые веса? | Макс. масштаб | Лицензия | Лучше всего подходит для |
|---|---|---|---|---|---|
| TabPFN-2 | Prior Labs | Да | 10 тыс. строк | Коммерческое использование с атрибуцией | Коммерческое применение проверенной старой модели |
| TabPFN-3 / 3.5 | Prior Labs (SAP) | Да, после принятия лицензии | До 1 млн строк | Некоммерческая, платный API для бизнеса | Максимальная точность и исследования |
| TabICLv2 | Inria | Да | Оптимально до 100 тыс. строк | Разрешительная открытая лицензия | Ваш выбор по умолчанию |
| TabFM | Google Research | Да | 20 признаков в BigQuery | Некоммерческие веса | Пользователи SQL в BigQuery |
| NEXUS | Fundamental | Нет | Не раскрывается | Проприетарная | Крупные компании на AWS |
| tabH2O | H2O.ai | Нет | Не раскрывается | Коммерческий API | Команды без ML-инфраструктуры, AI‑агенты |
Табличная базовая модель в Python используется точно так же, как любая модель scikit-learn.
Лучший способ понять, что она даёт, — свести её в поединке с XGBoost. Сделаем это на встроенном датасете по раку груди из scikit-learn.
Сначала установим пакеты:
pip install tabicl xgboost scikit-learnЗатем запустим обе модели на одном и том же разбиении:
from sklearn.datasets import load_breast_cancer
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from tabicl import TabICLClassifier
from xgboost import XGBClassifier

# Load a small tabular dataset as a pandas DataFrame
X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# Tabular foundation model: fit() just stores the training rows
tfm = TabICLClassifier()
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)

# XGBoost baseline with reasonable, untuned settings
xgb = XGBClassifier(n_estimators=300, learning_rate=0.05, max_depth=4)
xgb.fit(X_train, y_train)
xgb_preds = xgb.predict(X_test)

print(f"TabICL accuracy:  {accuracy_score(y_test, tfm_preds):.3f}")
print(f"XGBoost accuracy: {accuracy_score(y_test, xgb_preds):.3f}")
Этот небольшой датасет нормально запускается на обычном ноутбуке с CPU.
Обе модели покажут очень высокие результаты на столь «чистых» данных, поэтому не судите по одному разбиению. Настоящая проверка — ваши собственные «грязные» данные.
Если хотите попробовать TabPFN, выполните pip install tabpfn — и нужно изменить лишь две строки:
from tabpfn import TabPFNClassifier

tfm = TabPFNClassifier()  # The first run asks you to accept the license
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)
Важный момент перед сравнением моделей на реальных данных.
Если в данных есть даты, делите по времени, а не случайно. Иначе модель подглядит в будущее — а, как увидите в следующем разделе, именно там табличные базовые модели выглядят лучше, чем есть на самом деле.
Табличные базовые модели хорошо работают, когда датасет малый или средний, а тестовые строки похожи на тренировочные. Им сложно с данными, упорядоченными по времени, сгруппированными, с очень большими таблицами и со строгими требованиями к объяснимости.
Это «тестовые строки похожи на тренировочные» — и есть IID (независимое и одинаково распределённое), и это самый важный момент, который стоит проверить в ваших данных.
Начнём с того, где они сильны:
Теперь об ограничениях — это важнее, если вы планируете реальный проект.
Бенчмарк BeyondArena, выпущенный в июне 2026, протестировал 11 моделей на 142 датасетах, включая разбиения по времени (прогноз будущего по прошлому) и по группам (прогноз для новой больницы или страны).
Вывод: табличные базовые модели лучше всего работают на малых и средних IID-данных, тогда как модели на деревьях и другие методы глубокого обучения лидируют на временных, сгруппированных, больших и очень широких данных. Поскольку большинство бизнес-данных (продажи, фрод, отток) упорядочены по времени, это ограничение всплывает во многих реальных проектах.
TabPFN-3.5, вышедшая после BeyondArena, специально заявляет о закрытии этого разрыва на временных и сгруппированных данных. Это многообещающе, но независимых проверок пока нет.
SHAP-значения можно получить и в TabICL, и в TabPFN, но это гораздо дольше, чем SHAP для деревьев, и там нет разбиений по узлам для анализа. В таких областях, как кредитный скоринг, где регуляторы требуют понятных объяснений, это серьёзная проблема.
Всё, что больше нескольких тысяч строк, по-настоящему хочет GPU, а предсказания замедляются по мере роста тренировочных данных. Обученный XGBoost на CPU по скорости выиграет всегда.
TabPFN-2 — коммерческая при указании авторства, новые версии TabPFN — некоммерческие, веса TabFM — некоммерческие, TabICLv2 — разрешительная.
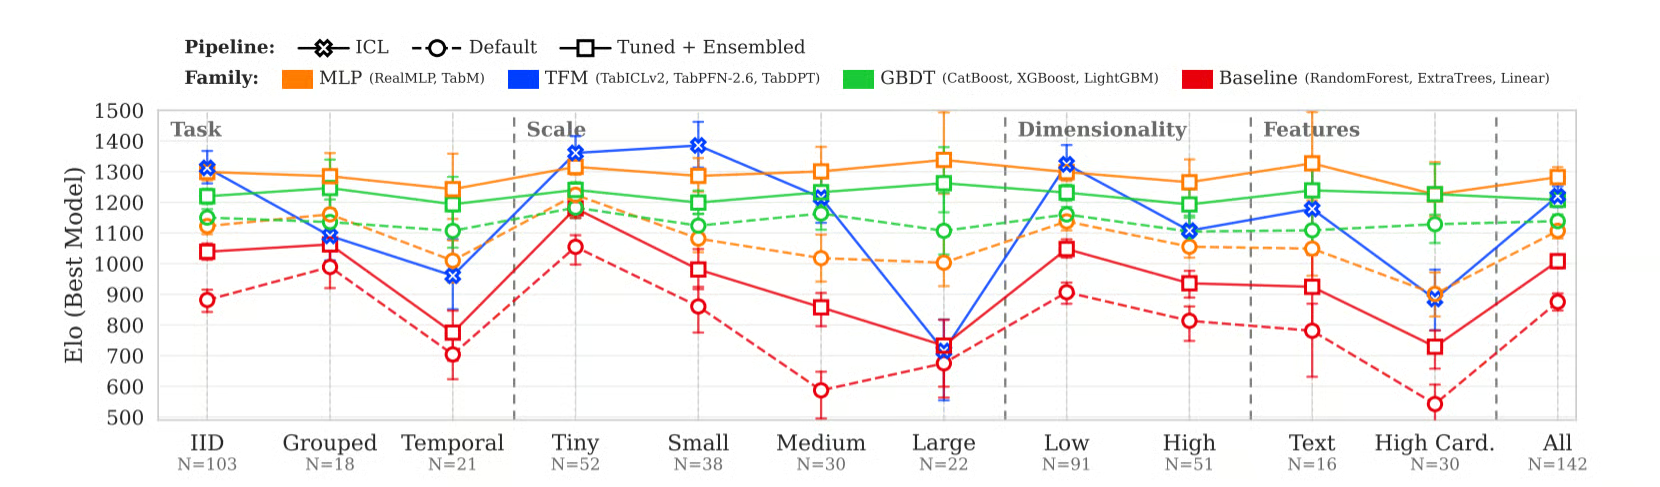
Рисунок 3. Эло по семействам моделей (выше — лучше). Табличные базовые модели лидируют на малых IID-данных, но проседают на временных и больших датасетах, где лучше держатся деревья и MLP. Синий — это лучшие из TabICLv2, TabPFN-2.6 и TabDPT, а не самые новые версии TabPFN. Источник: Purucker et al., «Beyond IID: How General Are Tabular Foundation Models, Really?» (2026), CC BY 4.0.
Надеюсь, вы согласитесь, что табличные базовые модели подняли планку для быстрой, «без усилий» базовой линии, но модели на деревьях по‑прежнему лучше подходят во множестве реальных ситуаций.
Используйте табличную базовую модель, когда ваш датасет малый или средний и IID, а также если вам не нужна полная объяснимость модели или очень быстрые предсказания на CPU. Вот таблица решений, которой я бы пользовался:
| Сценарий | Рекомендованный подход |
|---|---|
| До 10 тыс. строк, IID, нет требований к объяснимости | Начните с TabICLv2 или TabPFN |
| 10–100 тыс. строк, IID | Проверьте TabICLv2 и XGBoost, оставьте победителя |
| 100 тыс. — 1 млн строк | Начните с XGBoost или LightGBM, попробуйте TabPFN-3 как претендента |
| Разбиение по времени или по группам | Начинайте с моделей на деревьях |
| Нужны SHAP, важность признаков или аудит | Модель на деревьях с SHAP |
| Быстрые предсказания без GPU | Модель на деревьях |
| Быстрый PoC, без ML-инфраструктуры | TabICLv2 или BigQuery AI.PREDICT, если данные уже там |
| AI‑агенту нужны предсказания по таблицам | API вроде tabH2O или NEXUS |
Перед выбором модели я бы рекомендовал задать три вопроса:
И последнее. Сначала запустите табличную базовую модель — это займёт всего несколько минут. Если она не превзойдёт XGBoost на ваших данных, вы будете знать, что стоит вложиться во фичеринжиниринг и настройку XGBoost.
Помните двух студентов из начала статьи? В 2026 году второй — тот, кто прорешал миллионы экзаменов, — наконец-то обгоняет того, кто неделями зубрил, по крайней мере на малых и средних таблицах.
Табличные базовые модели заменяют обучение под каждый датасет предобучением и заменяют fit() обучением на примерах.
Больше всего удивляет, как быстро улучшилась область. TabPFN-2 в 2025 году впервые показала, что нейросеть может обойти настроенные деревья на малых таблицах, а TabICLv2 и TabPFN-3 расширили это на гораздо большие.
Открытые проблемы сейчас — данные, упорядоченные по времени, меняющиеся данные, объяснимость и лицензирование — именно то, что решает, попадёт ли модель в реальный продукт.
Так что мой совет: рассматривайте эти модели как новую точку старта, а финальный инструмент выбирайте по вашим данным, ограничениям и среде исполнения.
И если вы хотите в совершенстве освоить деревья, которые по‑прежнему побеждают во многих реальных задачах, загляните на наш курс Machine Learning with Tree-Based Models in Python и трек Supervised Machine Learning in Python. Если вы работаете в R, курс Machine Learning with Tree-Based Models in R охватывает те же темы.
Лучшие курсы DataCamp
Трек
Курс
Трек