트랙
대형 언어 모델 개발
16시간
같은 시험을 치르는 두 학생을 떠올려 보세요. 첫 번째 학생은 한 과목만 3주 동안 공부합니다. 두 번째 학생은 이미 수백만 개의 다양한 시험을 풀어 봤고, 시험 당일에는 풀이 예제가 적힌 한 장짜리 자료만 받습니다.
머신 러닝의 대부분 역사에서, 표형 모델은 첫 번째 학생에 가까웠습니다. 새 데이터셋이 나올 때마다 컬럼을 정리하고, 특징을 엔지니어링하고, XGBoost나 LightGBM을 학습시키고, 하이퍼파라미터를 몇 시간씩 튜닝해야 했습니다.
하지만 표형 기반 모델은 두 번째 학생입니다. 라벨이 붙은 행을 예제로 건네주면, 학습 없이 나머지를 예측합니다.
2026년, 이 아이디어는 연구 논문을 넘어 실제 제품으로 이어졌습니다. SAP가 Prior Labs에 10억 유로 이상을 투입하겠다고 발표했고, Google도 자체 모델을 공개했습니다. 이 글에서는 다음을 살펴보겠습니다.
딥러닝 경험이 많지 않아도 걱정하지 마세요. 이 글의 코드는 친숙한 scikit-learn 인터페이스를 사용합니다. 먼저 복습이 필요하다면, 20분 만에 이해하는 8가지 머신 러닝 모델에서 기본을 다룬 내용을 확인하세요.
pip install tabicl로 설치합니다.표형 기반 모델은 수백만 개의 합성 표형 데이터셋으로 사전학습해, 목표 열을 예측하는 일반 전략을 익힌 신경망입니다. 이후 인컨텍스트 러닝을 통해 각 데이터셋별 추가 학습 없이 그 전략을 새로운 표에 적용합니다.
여기서 큰 변화는 학습이 언제 일어나는가입니다.
XGBoost에서는 새 모델을 학습할 때마다 매번 여러분의 데이터에서 학습이 일어납니다. 표형 기반 모델에서는 학습이 수개월 전 사전학습 단계에서 이미 끝났고, 여러분의 데이터는 단지 입력일 뿐입니다. 자주 보게 될 용어를 몇 가지 평이한 말로 설명하면 다음과 같습니다.
이제 표형 기반 모델을 부스팅 기법과 자동화된 머신 러닝(AutoML)과 비교해 보겠습니다.
| 표형 기반 모델 | 그래디언트 부스팅 트리(XGBoost, LightGBM) | AutoML (AutoGluon, H2O AutoML) | |
|---|---|---|---|
| 새 데이터에서 학습 시간 | 없음 | 수초~수분 + 튜닝 | 수분~수시간 |
| 해석 가능성 | 제한적(SHAP 가능하나 느림) | 우수(피처 중요도, 빠른 SHAP) | 천차만별, 종종 이해 어려운 앙상블 |
| 권장 데이터셋 크기 | 수백 ~ 약 10만 행 | 수천 ~ 수천만 행 | 수천 ~ 수백만 행 |
| GPU 필요 여부 | 수천 행을 넘기면 권장 | 아니오 | 대개 아님 |
| 작고 무작위 분할된 데이터셋 | 현재 벤치마크에서 최상 | 튜닝 시 강력 | 강력하나 느림 |
본격적으로 원리를 보기 전에, 가장 유명하고 널리 쓰이는 모델인 대규모 언어 모델과 간단히 비교해 보겠습니다.
대규모 언어 모델(LLM)과 표형 기반 모델은 모두 트랜스포머를 사용하고, 입력에 포함된 예제로부터 학습합니다.
차이는 무엇을 읽도록 설계됐느냐입니다. LLM은 표를 긴 텍스트 문자열로 읽기 때문에, 쉼표와 공백을 단서로 어떤 숫자가 같은 컬럼에 속하는지 스스로 파악해야 합니다.
의미의 문제도 있습니다.
값 42는 누군가의 나이일 수도 있고 매출일 수도 있지만, 숫자 자체만으로는 구분할 수 없습니다. 표형 기반 모델은 각 컬럼을 독립 변수로, 각 행을 하나의 예제로 다루도록 학습되므로 컬럼 간 관계에 집중합니다.
이렇게 생각하면 이해가 쉽습니다. LLM은 데이터에 대해 말하는 데 뛰어나고, 표형 기반 모델은 그 데이터로 계산하는 데 특화되어 있습니다.
두 모델은 함께 사용할 수도 있습니다. 실제로 H2O.ai는 tabH2O 모델을 정확히 그렇게 포지셔닝합니다. 스프레드시트에서 숫자가 필요할 때 AI 에이전트가 호출하는 예측 도구로요.
표형 데이터가 딥러닝에 어려웠던 이유는, 표에는 신경망이 한 번 배우고 재사용할 수 있는 공통 구조가 없기 때문입니다. 사진의 픽셀은 어떤 사진에서나 픽셀입니다. 하지만 금융 데이터의 score 컬럼과 축구 데이터의 score 컬럼은 이름만 같을 뿐 공통점이 없습니다.
Léo Grinsztajn, Edouard Oyallon, Gaël Varoquaux의 유명한 2022년 논문 Why do tree-based models still outperform deep learning on tabular data?는 45개 데이터셋에서 이를 검증했고, 특히 그래디언트 부스팅 같은 트리 기반 모델이 약 1만 행 규모의 중간 크기 표에서 딥러닝을 여전히 앞선다고 보고했습니다. 그 이유로는 다음을 꼽았습니다.
실무적인 문제도 두 가지가 더 있습니다. 하나의 표에 숫자, 범주, 순위, 결측값이 뒤섞여 있을 수 있고, 대부분의 비즈니스 표는 수백 또는 수천 행에 불과해, 처음부터 신경망을 학습시키기에는 너무 작습니다.
가장 중요한 문제는 작은 데이터셋이라고 생각합니다. 800행으로 처음부터 학습한 신경망은 기대할 바탕지식이 없지만, 트리는 선행 지식 없이도 동작합니다.
사전학습은 정확히 이 점을 해결했습니다. 표형 기반 모델은 여러분의 표를 보기 전에 이미 수백만 개의 작고 지저분한 가짜 표로 연습을 마쳤기 때문에, 백지 상태에서 시작하지 않습니다.
표형 기반 모델은 라벨이 있는 학습 행과 라벨이 없는 테스트 행을 하나의 입력으로 함께 받아, 한 번의 순전파로 누락된 라벨을 예측합니다. 가중치는 바뀌지 않습니다. 프롬프트에 몇 개 예시를 주면 답을 내는 LLM과 같습니다.
이로 인해 익숙한 scikit-learn 메서드의 의미도 달라집니다.
TabICL에서 .fit()을 호출하면, TabICL 문서에 따르면 사전학습 체크포인트를 불러오고, 데이터를 전처리해 저장합니다. 실제 작업은 .predict() 중에 일어납니다.
.fit()이라는 이름을 유지하는 이유는 기존 scikit-learn 코드에 그대로 끼워 넣기 위해서입니다.
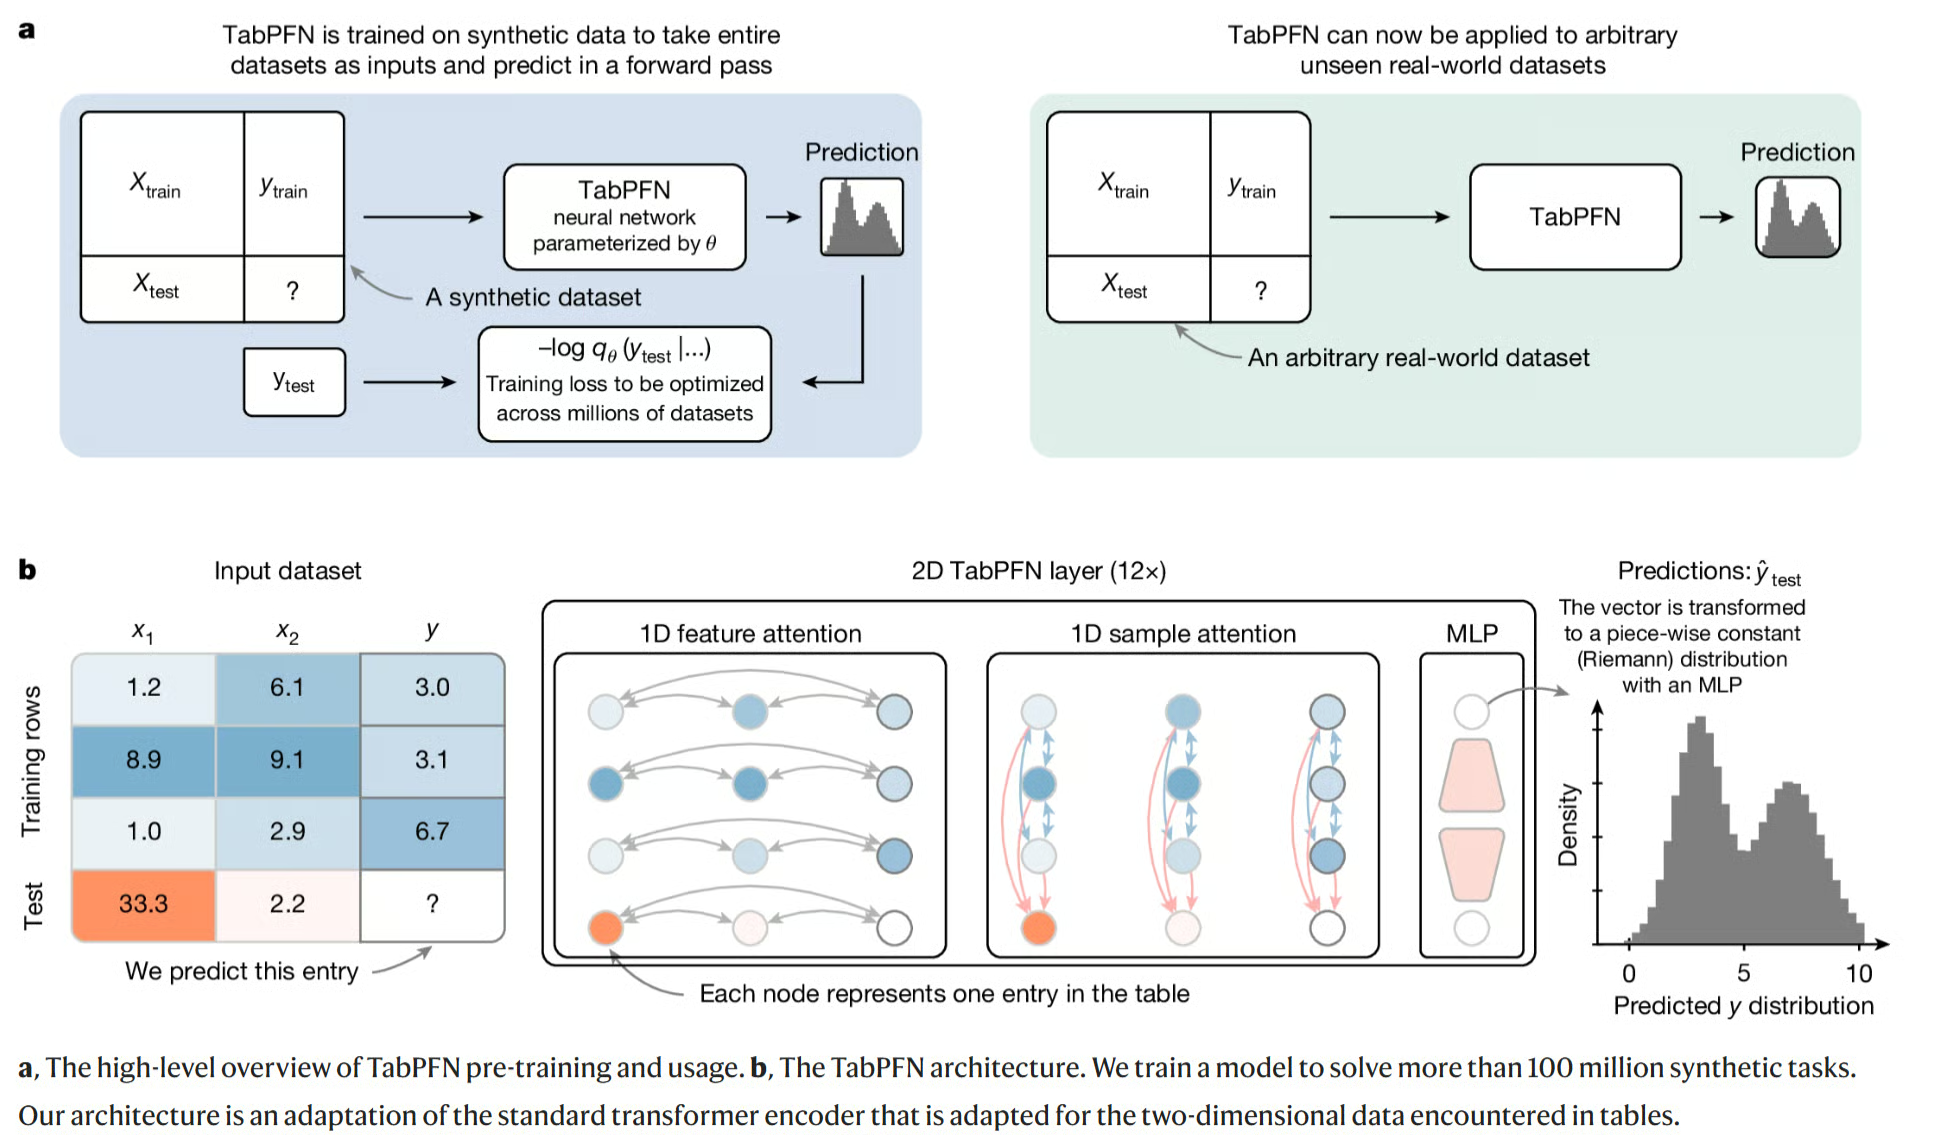
그림 1: TabPFN은 수백만 개의 합성 데이터셋으로 사전학습한 뒤, 실제 표를 한 번의 순전파로 예측합니다. 아래 패널은 특징과 샘플에 교차로 주의를 기울이는 방식을 보여줍니다. 출처: Hollmann 외, “Accurate predictions on small data with a tabular foundation model”, Nature (2025).
합성 사전학습은 실제 표 대신, 생성 모델처럼 동작하는 데이터 생성기로 만든 가짜 표로 모델을 학습시키는 것입니다.
비행 시뮬레이터에서 훈련하는 조종사를 떠올려 보세요. 조종사는 날씨, 공항, 고장 상황이 제각각인 수천 번의 가짜 비행을 연습해, 첫 실전 비행이 낯설지 않게 합니다.
TabPFN도 비슷하게 동작합니다.
연구진은 컬럼 간의 무작위 “원인과 결과” 규칙(예: A 컬럼이 B 컬럼에 영향을 주고, B가 타깃에 영향을 주는 식)을 만들어 내는 생성기를 작성하고, 그 규칙으로 행을 생성합니다.
사전학습 동안에는 타깃 컬럼을 숨기고, 모델이 이를 예측하도록 하며, 이 과정을 규칙, 노이즈 수준, 표 크기를 바꿔 가며 수백만 번 반복합니다.
중요한 점은, 모델이 어떤 실제 주제에 대한 사실을 배우는 것이 아니라는 것입니다. 대신 어떤 컬럼이 중요한지 파악하고, 이상치를 다루고, 확신이 서지 않을 때를 아는 등 일반 기술을 익힙니다.
실제로 TabICLv2 논문은 성능 향상의 핵심 이유로 새로운 합성 데이터 생성기를 꼽습니다.
세부 구조를 전부 이해할 필요는 없지만, 두 가지 주요 설계가 있다는 점은 알아두면 좋습니다.
두 계열 모두 합성 데이터로 학습되므로, “사전 적합 네트워크”는 별도의 모델 유형이 아니라 학습 방식을 설명하는 용어라는 점을 유의하세요.
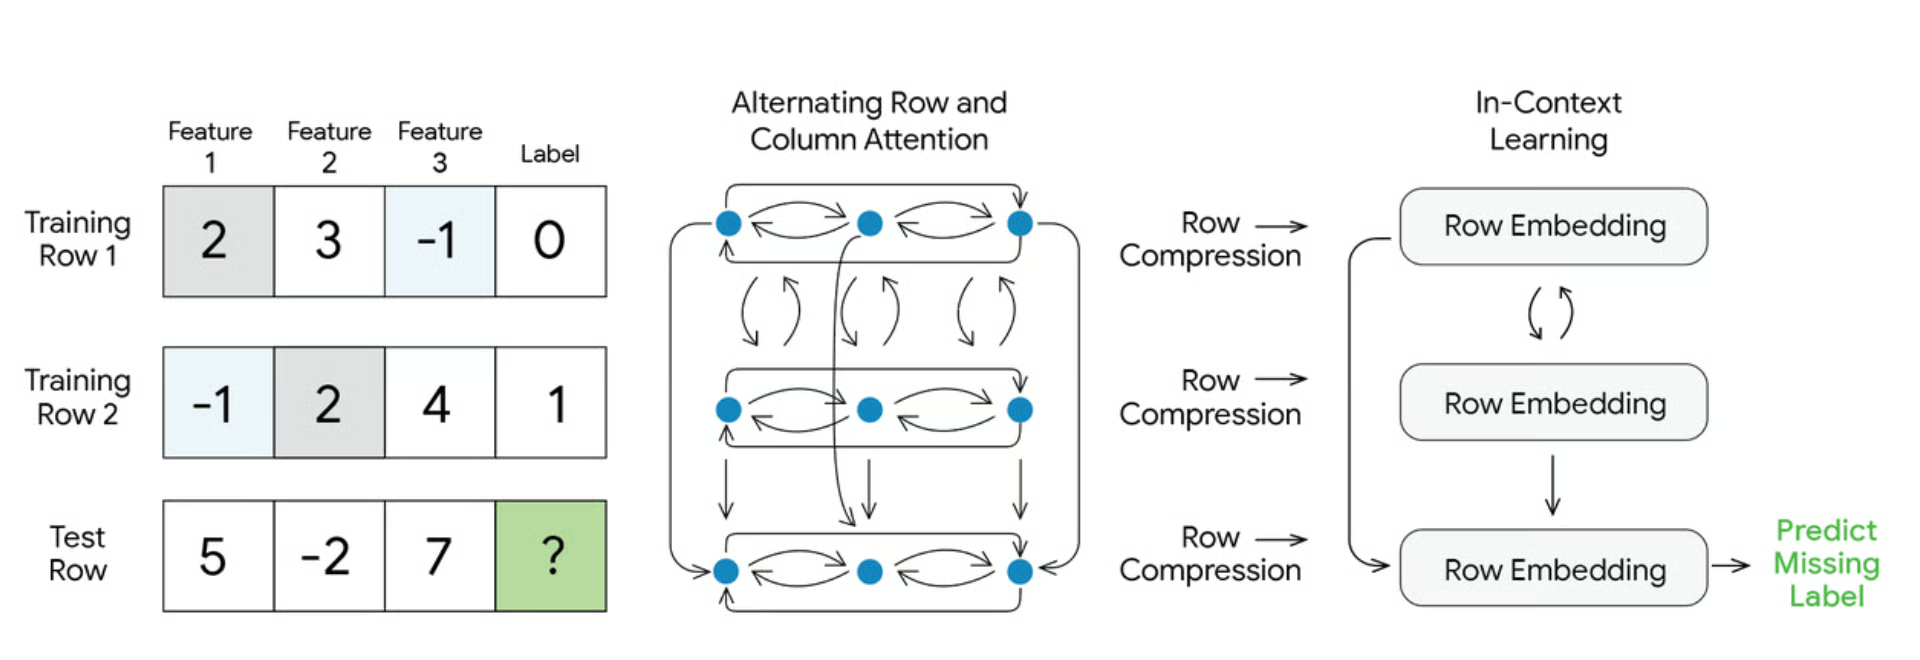
그림 2: TabFM은 두 설계를 혼합합니다. 행/열 방향의 TabPFN식 어텐션, 이후 TabICL식 행 압축, 그리고 누락 라벨에 대한 인컨텍스트 러닝. 출처: Google Research, “Introducing TabFM: A zero-shot foundation model for tabular data” (2026).
많은 사람이 놓치는 트레이드오프가 있습니다.
XGBoost는 한 번 시간을 들여 학습하고, 이후에는 거의 즉시 예측합니다.
표형 기반 모델은 학습을 건너뛰지만, 예측할 때마다 학습 행 전부를 다시 읽어야 합니다.
서비스 전 준비를 전혀 하지 않고, 주문마다 레시피 책을 처음부터 끝까지 다시 읽는 셰프를 떠올려 보세요.
책이 얇을 때는 괜찮지만, 데이터셋이 커질수록 예측은 느려집니다. TabICL과 TabPFN 모두 학습 데이터에 대한 “읽기”를 캐시해 반복 예측을 가속할 수 있지만, 첫 번째 패스에는 여전히 시간이 듭니다.
2026년의 핵심 표형 기반 모델은 TabPFN, TabICLv2, Google의 TabFM, Fundamental의 NEXUS, H2O.ai의 tabH2O입니다. 흥미로운 점은 비즈니스 전개 속도입니다. 불과 5개월 만에 학계 논문에서 대형 거래로 이어졌습니다. 간단한 타임라인은 다음과 같습니다.
이제 모든 것을 시작한 모델부터 차례로 살펴보겠습니다.
TabPFN은 이 카테고리를 만든 모델입니다. TabPFN-2는 2025년 1월 Nature에 실렸고, 최대 10,000행 데이터셋에서 튜닝한 트리 기반 모델을 이겼습니다.
그 이후 Prior Labs는 빠르게 새 버전을 내놓았습니다. TabPFN-3는 2026년 5월에 공개되었고 최대 100만 행(최대 200 특징)까지 처리합니다. 또한 Thinking 모드(유료 API)를 추가해, 적합 단계에서 더 많은 시간을 들여 더 나은 예측을 제공합니다.
최신 버전 TabPFN-3.5는 2026년 9월에 나왔고, 기술 보고서는 시간 순서형과 그룹형 데이터를 포함한 여러 주요 벤치마크에서 1위를 주장합니다. 외부 검증 전까지는 자사 수치로 보는 것이 안전합니다.
라이선스도 주의할 점입니다. TabPFN-2는 출처 표기만 하면 상업적 사용이 가능하지만, 2.5~3.5 버전은 비상업용입니다. 즉, 무료로 실험은 가능하나, 실제 제품에 쓰려면 유료 라이선스가 필요합니다.
TabICLv2는 현재 완전 개방형으로는 가장 뛰어난 표형 기반 모델입니다. Inria에서 개발되어 2026년 2월 공개, ICML 2026에 채택되었습니다.
TabICLv2 논문의 핵심 결과는, 어떤 튜닝도 없이, 이전 최고 모델이었던 RealTabPFN-2.5(튜닝, 앙상블, 실데이터 미세조정까지 한 모델)를 능가했다는 점입니다.
GitHub 저장소에 따르면, TabArena 벤치마크에서 대대적으로 튜닝한 XGBoost, CatBoost, LightGBM을 약 80%의 데이터셋에서 이깁니다.
속도도 빠릅니다. H100 GPU에서 5만 행, 100 특징을 10초 이내에 처리하며, 이는 TabPFN-2.5보다 약 10배 빠릅니다.
300~10만 행에서 최적으로 동작하고, 정확도 손실을 감수하면 약 50만 행까지 확장할 수 있습니다.
제 생각에, 대부분의 독자에게 가장 먼저 써 볼 만한 모델입니다.
pip install tabicl로 설치하고, 일반 scikit-learn 모델처럼 쓰면 되며, 관대한 라이선스로 가입 절차 없이 상업적으로도 사용할 수 있습니다. 다만 리더보드는 빠르게 변하고 있으며, TabPFN-3.5의 보고서는 현재 TabICLv2보다 앞선다고 자평합니다.
TabFM은 Google Research의 표형 기반 모델로, 2026년 6월 30일 공개되었습니다. 차별점은 사용 위치입니다. Google의 클라우드 데이터 웨어하우스인 BigQuery에 내장되어 있어, 순수 SQL만으로 예측을 받을 수 있습니다.
-- Use past customers (with known churn) to predict churn for new customers
-- AI.PREDICT is in preview, so check the BigQuery docs for the latest syntax
SELECT *
FROM AI.PREDICT(
  TABLE my_dataset.customers_history,
  TABLE my_dataset.customers_new,
  label_col => 'churned'
);
Python보다 SQL에 익숙한 분들께 훌륭합니다.
다만 현재 BigQuery 문서에는 특징 컬럼 20개, 클래스 10개 제한이 있고, 2026년 10월 30일부터 표준 BigQuery 요금에 토큰 기반 과금이 추가될 예정입니다. Hugging Face의 모델 가중치는 비상업용이므로, 상업적 사용은 BigQuery를 통해 이뤄집니다.
NEXUS는 전 DeepMind 연구원들이 창업한 샌프란시스코 스타트업 Fundamental의 폐쇄형, 엔터프라이즈 전용 모델입니다. 2026년 2월 2억 5,500만 달러 투자와 함께 출시되었고, 자사는 이를 대형 표형 모델(LTM)이라 부릅니다.
기업은 AWS를 통해 NEXUS를 구매·운영하며, Fundamental은 Fortune 100 기업들이 이를 수요 예측, 가격 책정, 이탈 예측에 이미 사용 중이라고 밝힙니다. 다만 공개 가중치나 자체 검증 가능한 벤치마크 결과가 없으므로, 엔터프라이즈 옵션으로 보는 것이 타당합니다.
tabH2O는 H2O.ai의 모델로, 핵심 아이디어는 단순합니다. 데이터를 보내면, 예측을 돌려준다.
결측값과 범주형을 알아서 정리해 주며, 병원·은행처럼 클라우드로 데이터를 보낼 수 없는 기관을 위해 온프레미스 실행도 가능합니다.
좋은 점은 tabH2O 논문이 과장하지 않는다는 것입니다. TALENT 벤치마크에서 튜닝한 CatBoost와 LightGBM을 이겼지만, 여전히 TabICLv2에는 뒤처졌습니다.
| 모델 | 개발사 | 가중치 공개? | 최대 규모 | 라이선스 | 적합한 용도 |
|---|---|---|---|---|---|
| TabPFN-2 | Prior Labs | 예 | 10K 행 | 출처 표기 시 상업용 가능 | 검증된 구버전의 상업적 활용 |
| TabPFN-3 / 3.5 | Prior Labs (SAP) | 라이선스 수락 후 가능 | 최대 100만 행 | 비상업용, 비즈니스용 유료 API | 최상위 정확도와 연구 |
| TabICLv2 | Inria | 예 | 최대 10만 행에서 최적 | 관대한 오픈 소스 | 기본 시작점 |
| TabFM | Google Research | 예 | BigQuery에서 20 특징 | 비상업용 가중치 | BigQuery의 SQL 사용자 |
| NEXUS | Fundamental | 아니오 | 미공개 | 독점 | AWS의 대기업 |
| tabH2O | H2O.ai | 아니오 | 미공개 | 상업용 API | ML 환경이 없는 팀, AI 에이전트 |
표형 기반 모델은 Python에서 다른 scikit-learn 모델과 완전히 동일하게 사용합니다.
무엇이 장점인지 보려면 XGBoost와 정면 비교하는 것이 가장 좋습니다. scikit-learn 내장 유방암 데이터셋으로 해 보겠습니다.
먼저 패키지를 설치합니다.
pip install tabicl xgboost scikit-learn그다음 같은 분할에서 두 모델을 실행합니다.
from sklearn.datasets import load_breast_cancer
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from tabicl import TabICLClassifier
from xgboost import XGBClassifier

# Load a small tabular dataset as a pandas DataFrame
X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# Tabular foundation model: fit() just stores the training rows
tfm = TabICLClassifier()
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)

# XGBoost baseline with reasonable, untuned settings
xgb = XGBClassifier(n_estimators=300, learning_rate=0.05, max_depth=4)
xgb.fit(X_train, y_train)
xgb_preds = xgb.predict(X_test)

print(f"TabICL accuracy:  {accuracy_score(y_test, tfm_preds):.3f}")
print(f"XGBoost accuracy: {accuracy_score(y_test, xgb_preds):.3f}")
이 작은 데이터셋은 일반 노트북 CPU에서도 잘 돌아갑니다.
이처럼 깨끗한 데이터에서는 두 모델 모두 점수가 매우 높게 나올 것입니다. 한 번의 분할 결과로 판단하지 마세요. 진짜 시험대는 여러분의 지저분한 실제 데이터입니다.
대신 TabPFN을 써 보고 싶다면 pip install tabpfn을 실행한 뒤, 두 줄만 바꾸면 됩니다.
from tabpfn import TabPFNClassifier

tfm = TabPFNClassifier()  # The first run asks you to accept the license
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)
실제 데이터에서 모델을 비교하기 전 반드시 기억할 점이 하나 있습니다.
데이터에 날짜가 있다면, 무작위가 아니라 시간 기준으로 분할하세요. 그렇지 않으면 모델이 미래를 엿보게 됩니다. 그리고 바로 다음 섹션에서 보겠지만, 그 지점이 표형 기반 모델이 실제보다 더 좋아 보이는 지점입니다.
표형 기반 모델은 데이터셋이 작거나 중간 규모이고, 테스트 행이 학습 행과 유사할 때 잘 동작합니다. 시간 순서형 데이터, 그룹형 데이터, 매우 큰 표, 엄격한 설명 가능성 요구에서는 어려움을 겪습니다.
“테스트 행이 학습 행과 유사하다”는 개념은 IID(독립이고 동일 분포)라고 부르며, 데이터에서 가장 먼저 확인해야 할 핵심 조건입니다.
먼저 잘 맞는 경우부터 보겠습니다.
이제 실제 프로젝트 계획 시 더 중요할 수 있는 한계를 보겠습니다.
2026년 6월 공개된 BeyondArena 벤치마크는 시간 기준 분할(과거로 미래 예측)과 그룹 기준 분할(새 병원이나 국가에 대한 예측)을 포함한 142개 데이터셋에서 11개 모델을 테스트했습니다.
결과는 표형 기반 모델이 작고 중간 크기의 IID 데이터에서 가장 성과가 좋고, 시간 순서형·그룹형·대규모·초광대역 데이터에서는 트리 기반이나 다른 딥러닝 모델이 앞선다는 것입니다. 대부분의 비즈니스 데이터(매출, 사기, 이탈)가 시간 순서형이므로, 이 한계는 실제 프로젝트에서 자주 드러납니다.
BeyondArena 이후 공개된 TabPFN-3.5는 시간 순서형과 그룹형 데이터에서 이 격차를 좁혔다고 주장합니다. 고무적이지만, 아직 독립적인 검증은 없습니다.
TabICL과 TabPFN 모두에서 SHAP 값을 구할 수 있지만, 트리 모델의 SHAP보다 훨씬 오래 걸리고, 살펴볼 트리 분할도 없습니다. 규제가 있어 모델을 이해해야 하는 신용평가 같은 분야에서는 실제 문제입니다.
수천 행을 넘기면 GPU가 사실상 필요하고, 학습 데이터가 클수록 예측이 느려집니다. CPU에서의 학습된 XGBoost 모델은 속도 면에서 언제나 승리합니다.
TabPFN-2는 출처 표기를 전제로 상업용 가능, 최신 TabPFN 버전은 비상업용, TabFM 가중치는 비상업용, TabICLv2는 관대합니다.
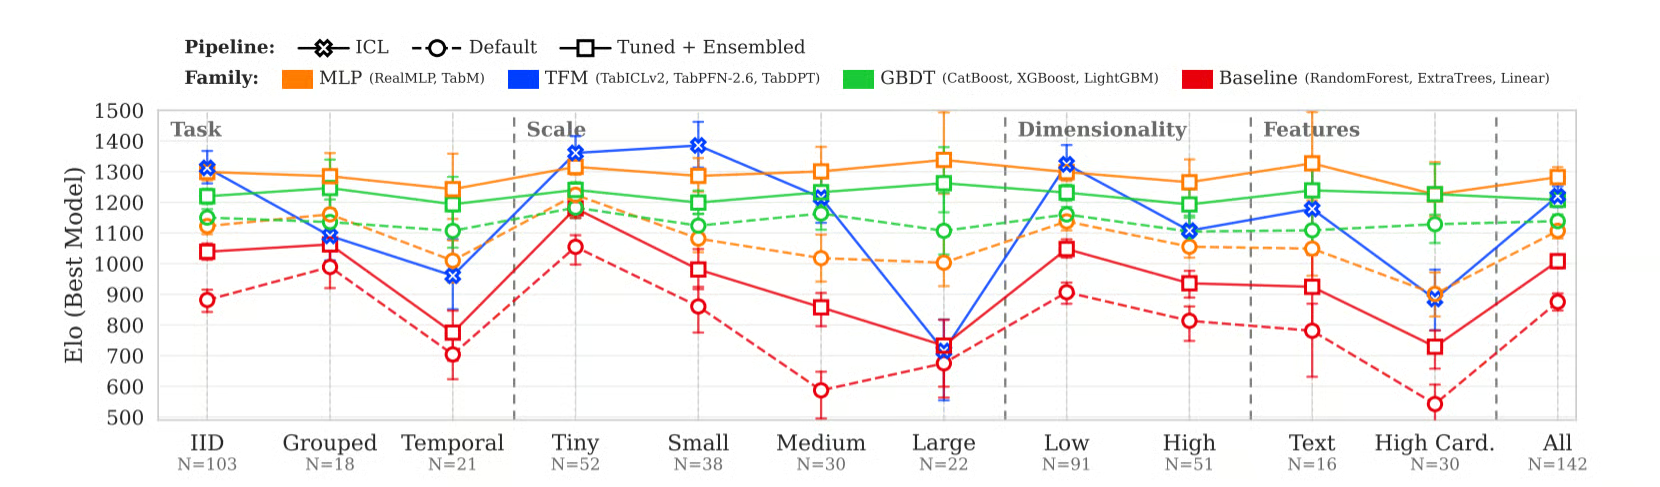
그림 3: 모델 계열별 Elo(높을수록 우수). 표형 기반 모델은 작은 IID 데이터에서 선도하지만, 시간형과 대규모 데이터에서는 하락하며 트리와 MLP가 더 잘 버팁니다. 파란색은 최신 TabPFN이 아닌 TabICLv2, TabPFN-2.6, TabDPT 중 최고를 의미합니다. 출처: Purucker 외, “Beyond IID: How General Are Tabular Foundation Models, Really?” (2026), CC BY 4.0.
바라건대, 표형 기반 모델이 “빠르고 손쉬운 기준선”의 수준을 한 단계 끌어올렸다는 점에는 동의하실 겁니다. 하지만 여전히 많은 실제 상황에서 트리 기반 모델이 더 좋은 선택입니다.
데이터셋이 작거나 중간 규모이고 IID이며, 완전한 설명 가능성이나 CPU에서의 매우 빠른 예측이 필요하지 않을 때 표형 기반 모델을 사용하세요. 제가 권하는 의사결정 표는 다음과 같습니다.
| 시나리오 | 권장 접근 |
|---|---|
| 1만 행 이하, IID, 설명 필요 없음 | TabICLv2 또는 TabPFN으로 시작 |
| 1만 ~ 10만 행, IID | TabICLv2와 XGBoost를 비교해 승자를 채택 |
| 10만 ~ 100만 행 | XGBoost 또는 LightGBM으로 시작, 도전자로 TabPFN-3 시도 |
| 시간 또는 그룹 기준 분할 | 트리 기반 모델부터 시작 |
| SHAP, 특징 중요도, 감사가 필요 | SHAP을 갖춘 트리 기반 모델 |
| GPU 없이 빠른 예측 | 트리 기반 모델 |
| 빠른 PoC, ML 환경 없음 | TabICLv2, 또는 데이터가 이미 BigQuery에 있다면 AI.PREDICT |
| 표에서 예측이 필요한 AI 에이전트 | tabH2O나 NEXUS 같은 API |
모델을 고르기 전에, 다음 세 가지를 자문해 보세요.
마지막으로 꼭 전하고 싶은 점이 있습니다. 표형 기반 모델을 먼저 돌려 보세요. 몇 분밖에 들지 않습니다. 만약 여러분의 데이터에서 XGBoost를 이기지 못한다면, 이제 특징 엔지니어링과 XGBoost 튜닝에 시간을 쓸 가치가 있음을 알게 된 것입니다.
글의 서두에 등장한 두 학생을 기억하시나요? 2026년, 수백만 개의 시험을 연습한 두 번째 학생이, 적어도 작고 중간 규모의 표에서는, 몇 주간 공부한 첫 번째 학생을 마침내 이기게 되었습니다.
표형 기반 모델은 데이터셋별 학습을 사전학습으로, fit()을 예제로부터의 학습으로 대체합니다.
가장 놀라운 점은 이 영역이 얼마나 빨리 발전했는가입니다. 2025년 TabPFN-2가 작은 표에서 튜닝한 트리를 이길 수 있음을 처음 보였고, 이후 TabICLv2와 TabPFN-3가 그 한계를 훨씬 더 큰 표로 밀어 올렸습니다.
현재의 열린 과제는 시간 순서형 데이터, 변화하는 데이터, 설명 가능성, 라이선스입니다. 이는 모델이 실제 제품에 들어갈 수 있는지를 좌우하는 요소이기도 합니다.
따라서 제 조언은 이렇습니다. 이 모델들을 새로운 출발점으로 삼고, 데이터, 제약, 모델이 실행될 환경에 맞춰 최종 도구를 고르세요.
그리고 여전히 많은 실제 상황에서 승리하는 트리 기반 모델을 마스터하고 싶다면, Machine Learning with Tree-Based Models in Python 코스와 Supervised Machine Learning in Python 트랙을 확인하세요. R을 사용한다면, Machine Learning with Tree-Based Models in R에서 동일 주제를 다룹니다.
DataCamp 추천 코스
트랙
강의
트랙