
लर्निंग पाथ
बड़े भाषा मॉडल विकसित करना
16 घंटा
कल्पना करें दो छात्र एक ही परीक्षा दे रहे हैं। पहला छात्र तीन हफ्ते सिर्फ एक ही मॉड्यूल की तैयारी करता है, जबकि दूसरा छात्र पहले से ही लाखों अलग-अलग परीक्षाओं पर अभ्यास कर चुका है और परीक्षा के दिन बस हल किए हुए उदाहरणों की शीट देख लेता है।
मशीन लर्निंग के अधिकांश इतिहास में, टैब्युलर मॉडल पहले छात्र जैसे रहे हैं। हर नए डेटासेट पर कॉलम साफ करना, फीचर इंजीनियरिंग, XGBoost या LightGBM ट्रेन करना, और घंटों तक हाइपरपैरामीटर ट्यून करना पड़ता था।
लेकिन टैब्युलर फाउंडेशन मॉडल दूसरे छात्र जैसे हैं: आप उन्हें अपने लेबल लगे रो उदाहरण के रूप में देते हैं, और वे बिना किसी ट्रेनिंग के बाकी की भविष्यवाणी कर देते हैं।
2026 में यह विचार रिसर्च पेपर्स से निकलकर असली प्रोडक्ट्स में आ गया—SAP ने Prior Labs में €1 बिलियन से अधिक की प्रतिबद्धता की और Google ने अपना मॉडल जारी किया। तो इस लेख में, हम देखेंगे:
यदि आपके पास डीप लर्निंग का अधिक अनुभव नहीं है तो चिंता न करें। इस लेख के कोड में परिचित scikit-learn इंटरफेस का उपयोग किया गया है, और यदि आप पहले ताज़ा करना चाहते हैं, तो 20 मिनट में 8 मशीन लर्निंग मॉडल समझाए गए मूल बातें कवर करता है।
pip install tabicl से इंस्टॉल होता है।टैब्युलर फाउंडेशन मॉडल एक ऐसा न्यूरल नेटवर्क है जिसे लाखों सिंथेटिक टैब्युलर डेटासेट्स पर प्रीट्रेन किया गया है ताकि वह टार्गेट कॉलम की भविष्यवाणी करने की एक सामान्य रणनीति सीख ले, और फिर वही रणनीति इन-कॉन्टेक्स्ट लर्निंग के जरिए नए टेबल पर, प्रति-डेटासेट ट्रेनिंग के बिना, लागू कर दे।
यहाँ बड़ा बदलाव यह है कि सीखना कब होता है।
XGBoost में, सीखना हर बार आपके डेटा पर नया मॉडल ट्रेन करते समय होता है। एक टैब्युलर फाउंडेशन मॉडल में, सीखना महीनों पहले प्रीट्रेनिंग के दौरान हो चुका होता है, और आपका डेटा केवल इनपुट होता है। कुछ शब्द बार-बार आएँगे, तो मैं उन्हें सरल भाषा में समझा देता हूँ:
अब देखें कि टैब्युलर फाउंडेशन मॉडल बूस्टिंग मेथड्स और ऑटोमेटेड मशीन लर्निंग (AutoML) से कैसे तुलना करते हैं:
| टैब्युलर फाउंडेशन मॉडल | ग्रेडिएंट-बूस्टेड ट्रीज़ (XGBoost, LightGBM) | AutoML (AutoGluon, H2O AutoML) | |
|---|---|---|---|
| नए डेटा पर ट्रेनिंग समय | कोई नहीं | सेकंड से मिनट, साथ में ट्यूनिंग | मिनट से घंटे |
| व्याख्येयता | सीमित (SHAP संभव है पर धीमा) | अच्छी (फीचर इम्पोर्टेंस, तेज़ SHAP) | बदलता रहता है, अक्सर कठिन एन्सेम्बल्स |
| उत्तम डेटासेट आकार | सैकड़ों से लगभग 100K रो | हज़ारों से कई मिलियन रो | हज़ारों से मिलियन रो |
| GPU चाहिए? | कुछ हज़ार रो से आगे अनुशंसित | नहीं | आम तौर पर नहीं |
| छोटे, यादृच्छिक रूप से विभाजित डेटासेट्स | मौजूदा बेंचमार्क्स पर सर्वश्रेष्ठ | ट्यून होने पर मज़बूत | मज़बूत पर धीमे |
इससे पहले कि हम देखें ये कैसे काम करते हैं, मैं इन्हें सबसे प्रसिद्ध और व्यापक रूप से इस्तेमाल होने वाले मॉडलों—लार्ज लैंग्वेज मॉडल्स—से जल्दी से तुलना करना चाहता हूँ।
लार्ज लैंग्वेज मॉडल (LLMs) और टैब्युलर फाउंडेशन मॉडल दोनों ट्रांसफॉर्मर्स का उपयोग करते हैं, और दोनों अपने इनपुट में दिए गए उदाहरणों से सीखते हैं।
अंतर यह है कि वे किसे पढ़ने के लिए बने हैं। एक LLM टेबल को लंबे टेक्स्ट स्ट्रिंग की तरह पढ़ता है, यानी उसे कॉमा और स्पेस से यह समझना पड़ता है कि कौन से नंबर एक ही कॉलम के हैं।
यहाँ अर्थ का भी मुद्दा है।
मान 42 किसी की उम्र भी हो सकता है या राजस्व का आंकड़ा भी—संख्या खुद नहीं बताती कि कौन सा। टैब्युलर फाउंडेशन मॉडल हर कॉलम को एक अलग वैरिएबल और हर रो को एक उदाहरण की तरह ट्रीट करने के लिए ट्रेन होता है, इसलिए वह कॉलमों के आपसी संबंधों पर ध्यान देता है।
मैं इसे यूँ सोचता हूँ: LLM आपके डेटा के बारे में बात करने में माहिर है, और टैब्युलर फाउंडेशन मॉडल उस पर गणना करने के लिए बना है।
दोनों साथ भी काम कर सकते हैं—यही H2O.ai अपने tabH2O मॉडल की पोजीशनिंग करता है: जब किसी AI एजेंट को स्प्रेडशीट से कोई संख्या चाहिए, तब यह भविष्यवाणी का टूल बनता है।
टैब्युलर डेटा डीप लर्निंग के लिए इसलिए कठिन था क्योंकि टेबल्स में कोई साझा संरचना नहीं होती जिसे न्यूरल नेटवर्क एक बार सीखकर दोहरा सके। हर फोटो में पिक्सल, पिक्सल ही होता है। एक वित्तीय डेटासेट में score नाम के कॉलम और एक फ़ुटबॉल डेटासेट में score नाम के कॉलम का आपस में कोई लेना-देना नहीं।
लियो ग्रिंस्चटैन, एडुआर ओयालों, और गेल वरोक्वो द्वारा 2022 का एक प्रसिद्ध पेपर, टैब्युलर डेटा पर ट्री-आधारित मॉडल अभी भी डीप लर्निंग से बेहतर क्यों हैं?, ने 45 डेटासेट्स पर यह जांचा और पाया कि ट्री-आधारित मॉडल, खासकर ग्रेडिएंट बूस्टिंग, लगभग 10,000 रो वाले माध्यम आकार के टेबल्स पर डीप लर्निंग से बेहतर हैं। उनके कारण:
दो व्यावहारिक समस्याएँ इसे और कठिन बनाती हैं। एक टेबल में संख्याएँ, श्रेणियाँ, रैंकिंग और मिसिंग वैल्यूज़ सब मिल सकते हैं, और अधिकांश बिज़नेस टेबल्स में सिर्फ सैकड़ों या हज़ारों रो होते हैं—जो किसी न्यूरल नेटवर्क को शून्य से ट्रेन करने के लिए बहुत कम हैं।
मेरे विचार में छोटा डेटासेट सबसे बड़ा मुद्दा है। 800 रो पर शून्य से ट्रेन किया गया न्यूरल नेटवर्क किसी सहारे के बिना होता है, जबकि एक ट्री को काम करने के लिए किसी पूर्वज्ञान की ज़रूरत नहीं।
इसी चीज़ को प्रीट्रेनिंग ने ठीक किया। टैब्युलर फाउंडेशन मॉडल आपके डेटा से पहले ही लाखों छोटे, उलझे हुए, बनाए गए टेबल्स पर अभ्यास कर चुका होता है, इसलिए वह शून्य से शुरू नहीं कर रहा।
टैब्युलर फाउंडेशन मॉडल आपके लेबल लगे ट्रेनिंग रो और बिना लेबल के टेस्ट रो को एक साथ इनपुट के रूप में लेते हैं और एक ही फॉरवर्ड पास में मिसिंग लेबल की भविष्यवाणी करते हैं। इसके वेट्स कभी नहीं बदलते—ठीक वैसे ही जैसे एक LLM, आपको प्रॉम्प्ट में कुछ उदाहरण देने के बाद, प्रश्न का उत्तर देता है।
इससे परिचित scikit-learn मेथड्स के अर्थ भी बदल जाते हैं।
जब आप TabICL पर .fit() कॉल करते हैं, तो TabICL डॉक्यूमेंटेशन बताता है कि यह प्रीट्रेन किया हुआ चेकपॉइंट लोड करता है, आपके डेटा को प्रीप्रोसेस करता है, और उसे स्टोर करता है। असली काम .predict() के दौरान होता है।
.fit() नाम इसलिए बना रहता है ताकि मॉडल आपके मौजूदा scikit-learn कोड में आसानी से फिट हो सके।
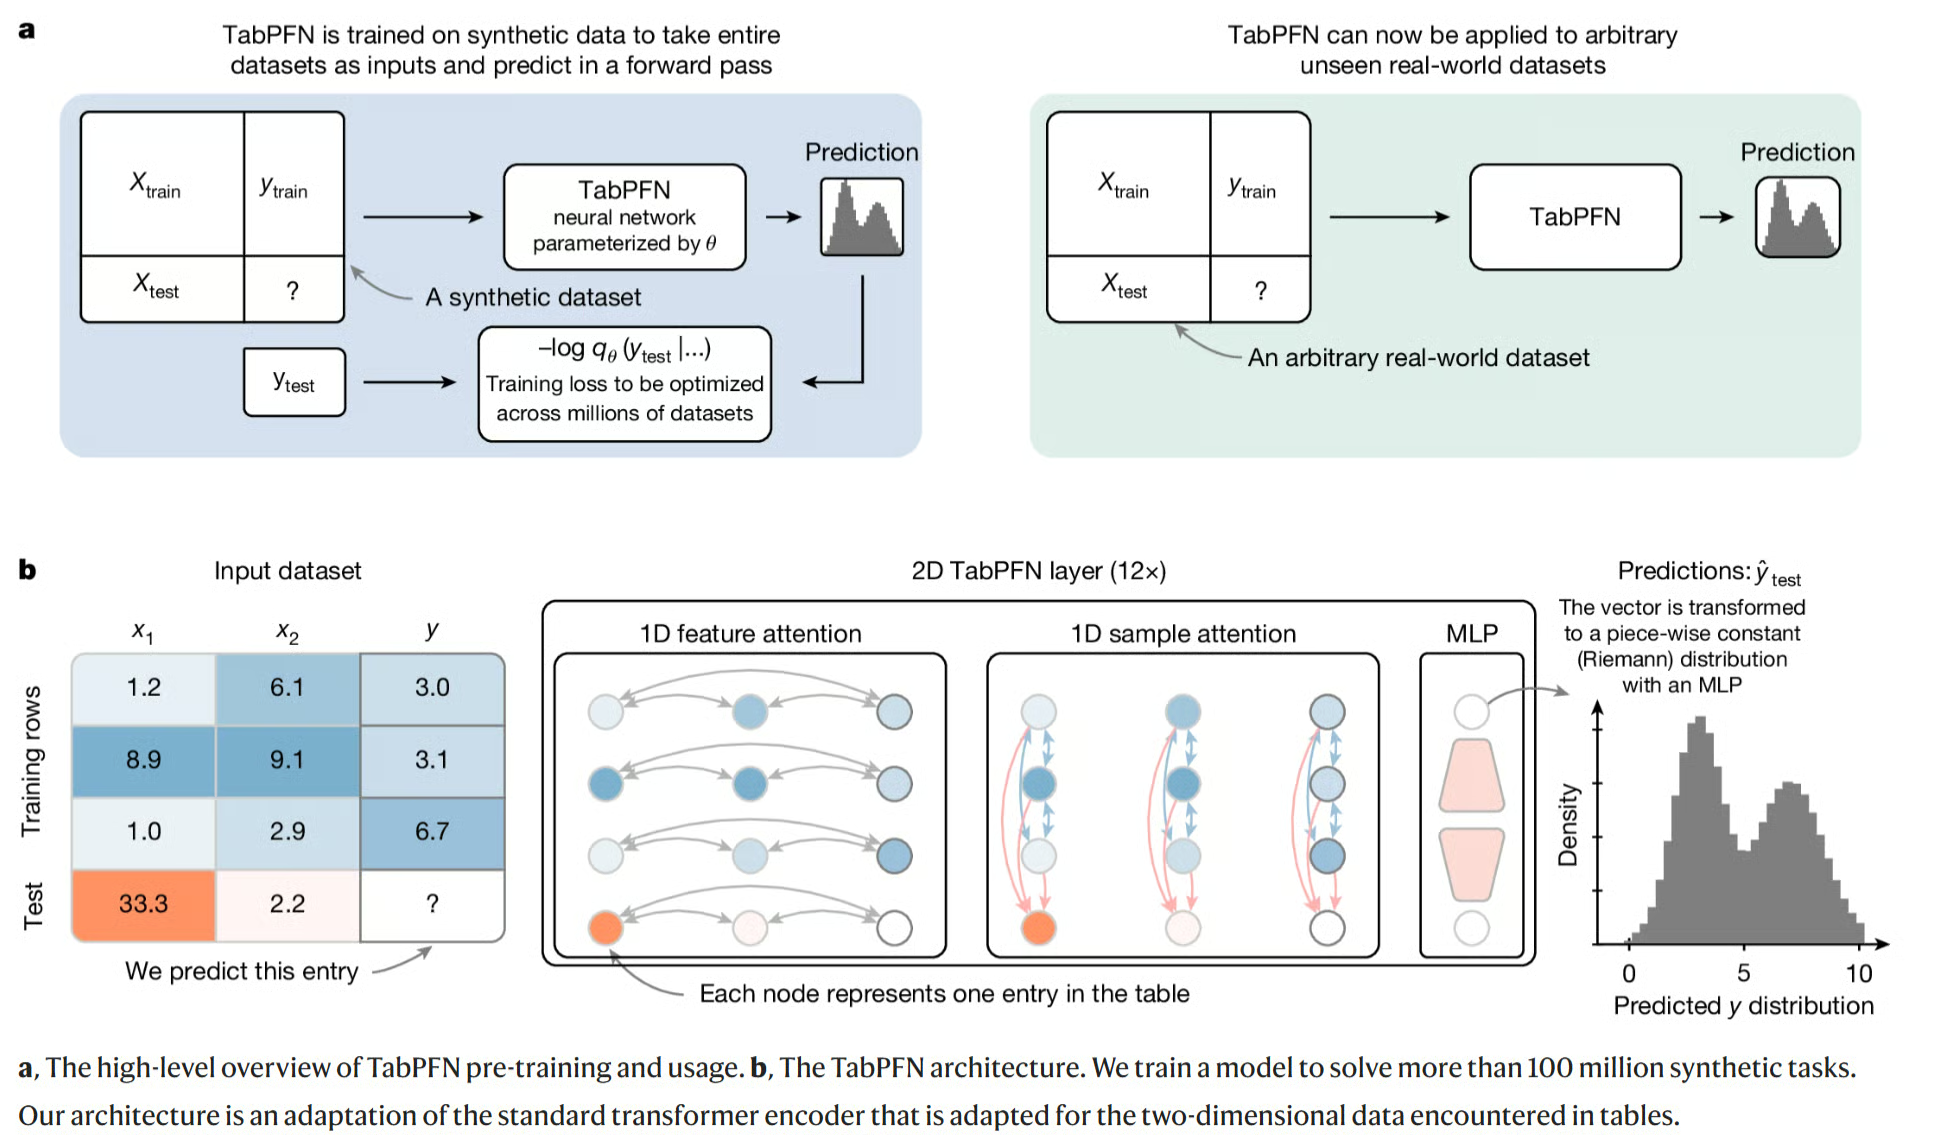
चित्र 1: TabPFN लाखों सिंथेटिक डेटासेट्स पर प्रीट्रेन होता है, फिर एक फॉरवर्ड पास में असली टेबल पर भविष्यवाणी करता है। नीचे वाला पैनल दिखाता है कि यह फीचर्स और सैंपल्स पर कैसे अटेंड करता है। स्रोत: Hollmann et al., “Accurate predictions on small data with a tabular foundation model”, Nature (2025).
सिंथेटिक प्रीट्रेनिंग का मतलब है असली टेबल्स की बजाय बनाए गए टेबल्स पर मॉडल को ट्रेन करना, जिन्हें एक डेटा जेनरेटर बनाता है जो जनरेटिव मॉडल जैसा काम करता है।
इसे ऐसे समझें जैसे पायलट फ्लाइट सिम्युलेटर में ट्रेनिंग करता है। पायलट अलग-अलग मौसम, एयरपोर्ट्स, और फॉल्ट्स के साथ हज़ारों नकली उड़ानें अभ्यास करता है ताकि पहली असली उड़ान नई न लगे।
TabPFN भी इसी तरह काम करता है।
इसके निर्माताओं ने एक जेनरेटर लिखा जो कॉलमों के बीच यादृच्छिक “कारण और प्रभाव” नियम गढ़ता है (जैसे कॉलम A, कॉलम B को प्रभावित करता है, जो टार्गेट को प्रभावित करता है), और फिर उन्हीं नियमों से रो बनाता है।
प्रीट्रेनिंग के दौरान, टार्गेट कॉलम छिपा दिया जाता है, मॉडल उसे प्रेडिक्ट करने की कोशिश करता है, और यह प्रक्रिया नियमों, शोर स्तरों, और टेबल आकारों को बदलते हुए लाखों बार दोहराई जाती है।
महत्वपूर्ण बात यह है कि मॉडल किसी वास्तविक विषय के तथ्यों को नहीं सीखता। यह सामान्य कौशल सीखता है—कौन से कॉलम मायने रखते हैं, आउटलायर्स से कैसे निपटना है, और कब अनिश्चित होना चाहिए।
वास्तव में, TabICLv2 पेपर अपने नए सिंथेटिक डेटा जेनरेटर को बेहतर प्रदर्शन का एक प्रमुख कारण बताता है।
आपको आर्किटेक्चर की हर बारीकी जानने की ज़रूरत नहीं है, पर यह जानना उपयोगी है कि दो मुख्य डिज़ाइन हैं:
ध्यान दें कि दोनों परिवार सिंथेटिक डेटा पर ट्रेन होते हैं, इसलिए “प्रायर-फिटेड नेटवर्क” उनके ट्रेन होने के तरीके का वर्णन है, कोई अलग मॉडल प्रकार नहीं।
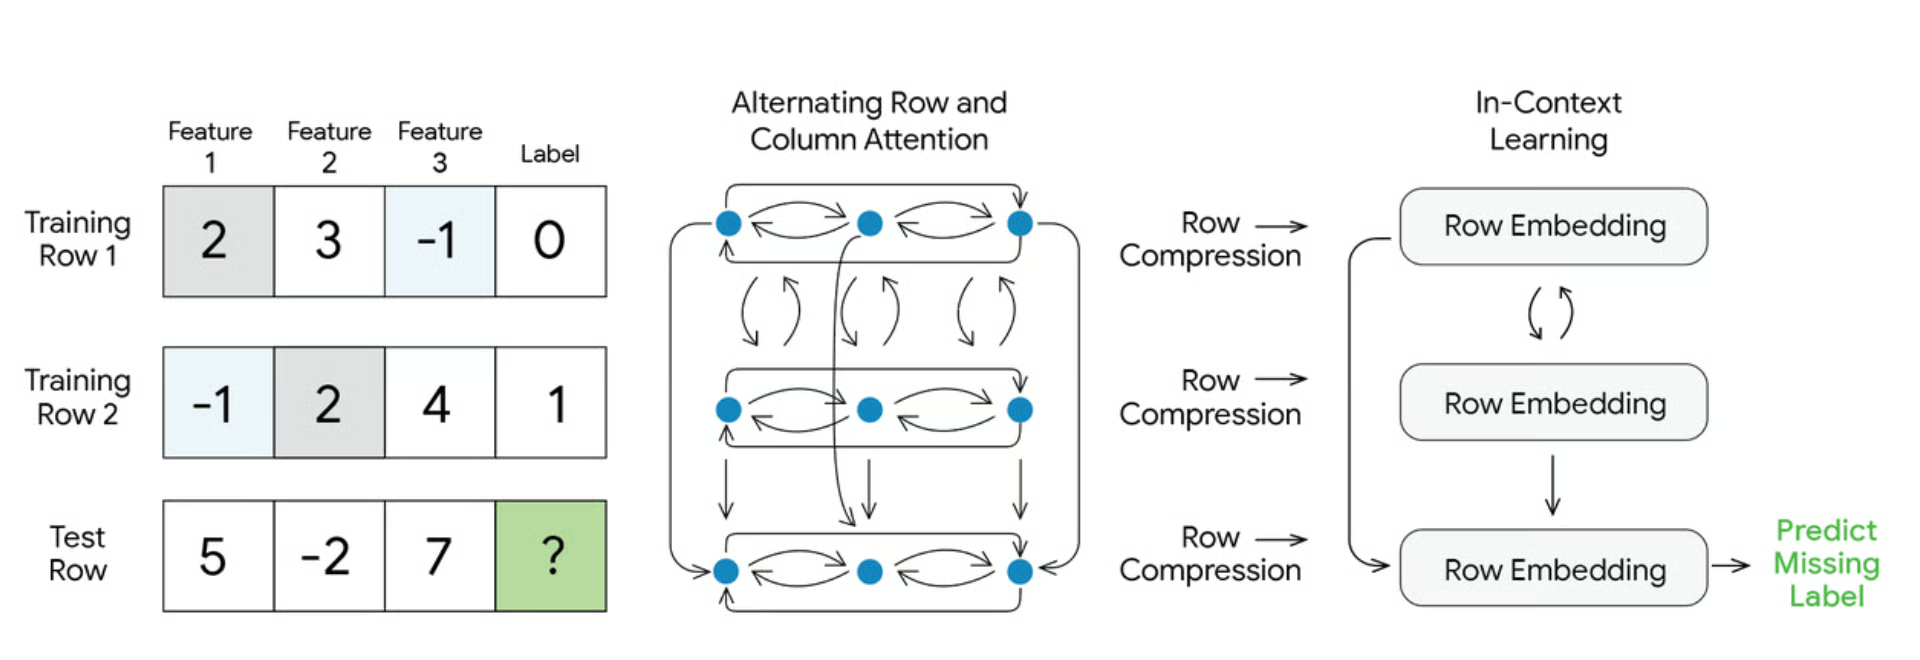
चित्र 2: TabFM दोनों डिज़ाइनों को मिलाता है: TabPFN-शैली की रो और कॉलम अटेंशन, फिर TabICL-शैली रो कम्प्रेशन, फिर मिसिंग लेबल के लिए इन-कॉन्टेक्स्ट लर्निंग। स्रोत: Google Research, “Introducing TabFM: A zero-shot foundation model for tabular data” (2026).
यहाँ एक ट्रेड-ऑफ है जो कई लोगों को चौंका देता है।
XGBoost एक बार ट्रेनिंग में समय लगाता है, फिर लगभग तुरंत प्रेडिक्ट करता है।
टैब्युलर फाउंडेशन मॉडल ट्रेनिंग छोड़ देता है, लेकिन उसे हर बार भविष्यवाणी करते समय आपके सभी ट्रेनिंग रो पढ़ने पड़ते हैं।
सोचिए एक ऐसे शेफ के बारे में जो सर्विस से पहले कोई तैयारी नहीं करता, पर हर ऑर्डर के लिए पूरी रेसिपी बुक फिर से पढ़ता है।
छोटी बुक पर यह ठीक है, पर जैसे-जैसे आपका डेटासेट बढ़ता है, प्रेडिक्शन धीमे हो जाते हैं। TabICL और TabPFN दोनों अपनी ट्रेनिंग डेटा की “रीडिंग” को कैश कर सकते हैं ताकि दोहराए गए प्रेडिक्शन तेज़ हों, पर पहली बार फिर भी समय लगता है।
2026 के प्रमुख टैब्युलर फाउंडेशन मॉडल हैं: TabPFN, TabICLv2, Google का TabFM, Fundamental का NEXUS, और H2O.ai का tabH2O। रोचक बात यह है कि बिज़नेस पक्ष कितनी तेजी से आगे बढ़ा: पाँच महीनों में यह क्षेत्र अकादमिक पेपर्स से बड़े सौदों तक पहुँच गया। एक संक्षिप्त टाइमलाइन:
अब एक-एक कर देखते हैं, उस मॉडल से शुरू करते हुए जिसने यह सब शुरू किया।
TabPFN वह मॉडल है जिसने यह श्रेणी बनाई। TabPFN-2 जनवरी 2025 में Nature में प्रकाशित हुआ और 10,000 रो तक के डेटासेट्स पर ट्यून किए गए ट्री-आधारित मॉडलों को पछाड़ दिया।
तब से, Prior Labs ने तेजी से नए वर्ज़न जारी किए हैं। TabPFN-3 मई 2026 में आया और 10 लाख रो (और 200 फीचर्स तक) संभालता है। इसमें Thinking मोड (इसके पेड API के जरिए) भी जोड़ा गया जो फिटिंग चरण में अतिरिक्त समय लेकर बेहतर भविष्यवाणी करता है।
ताज़ा वर्ज़न TabPFN-3.5 सितंबर 2026 में आया, और इसके टेक्निकल रिपोर्ट में कई बड़े बेंचमार्क्स पर प्रथम स्थान का दावा है, जिनमें टाइम-ऑर्डर्ड और ग्रुप्ड डेटा भी शामिल हैं। जब तक अन्य लोग पुष्टि न करें, मैं इन्हें कंपनी के अपने आँकड़े मानूँगा।
एक और बात लाइसेंस की है। TabPFN-2 को आप वाणिज्यिक रूप से इस्तेमाल कर सकते हैं बशर्ते Prior Labs को क्रेडिट दें, पर 2.5 से 3.5 तक के वर्ज़न नॉन-कमर्शियल हैं। यानी आप इन्हें मुफ़्त में आज़मा सकते हैं, पर असली प्रोडक्ट में उपयोग के लिए पेड लाइसेंस चाहिए।
TabICLv2 अभी सबसे अच्छा पूर्णत: ओपन टैब्युलर फाउंडेशन मॉडल है। यह Inria में बना, फरवरी 2026 में जारी हुआ, और ICML 2026 में स्वीकृत हुआ।
TabICLv2 पेपर का प्रमुख परिणाम यह है कि बिना किसी ट्यूनिंग के, इसने RealTabPFN-2.5 (पिछला सर्वश्रेष्ठ मॉडल) को पीछे छोड़ दिया, जबकि उस मॉडल को ट्यून, एन्सेम्बल, और असली डेटा पर फाइन-ट्यून किया गया था।
इसके GitHub रिपॉजिटरी के अनुसार, यह TabArena बेंचमार्क में लगभग 80% डेटासेट्स पर भारी ट्यून किए गए XGBoost, CatBoost, और LightGBM से भी बेहतर है।
यह तेज़ भी है—H100 GPU पर 100 फीचर्स के साथ 50,000 रो को 10 सेकंड से कम में संभालता है, जो TabPFN-2.5 से करीब 10 गुना तेज़ है।
यह 300 से 100,000 रो के बीच सबसे अच्छा काम करता है और लगभग 500,000 रो तक थोड़ी सटीकता की गिरावट के साथ खिंच सकता है।
मेरी राय में, अधिकांश पाठकों को यहीं से शुरू करना चाहिए।
यह pip install tabicl से इंस्टॉल होता है, किसी भी scikit-learn मॉडल की तरह काम करता है, और इसका उदार लाइसेंस आपको बिना साइन-अप के व्यावसायिक उपयोग की अनुमति देता है। हालांकि लीडरबोर्ड तेज़ी से बदल रहा है, और TabPFN-3.5 की रिपोर्ट अब खुद को TabICLv2 से आगे बताती है।
TabFM, Google Research का टैब्युलर फाउंडेशन मॉडल है, जो 30 जून 2026 को जारी हुआ। इसकी खास बात है आप इसे कहाँ उपयोग कर सकते हैं: यह BigQuery—Google का क्लाउड डेटा वेयरहाउस—में बिल्ट-इन है, इसलिए आप साधारण SQL से भविष्यवाणियाँ ले सकते हैं।
-- Use past customers (with known churn) to predict churn for new customers
-- AI.PREDICT is in preview, so check the BigQuery docs for the latest syntax
SELECT *
FROM AI.PREDICT(
  TABLE my_dataset.customers_history,
  TABLE my_dataset.customers_new,
  label_col => 'churned'
);
यह उन लोगों के लिए बढ़िया है जो SQL जानते हैं पर Python नहीं।
हालाँकि, BigQuery डॉक्यूमेंटेशन फिलहाल आपको 20 फीचर कॉलम और 10 क्लासेज तक सीमित करता है, और Google 30 अक्टूबर 2026 से मानक BigQuery शुल्कों के ऊपर टोकन-आधारित कीमतें जोड़ने की योजना बना रहा है। Hugging Face पर मॉडल वेट्स नॉन-कमर्शियल हैं, इसलिए व्यावसायिक उपयोग BigQuery के जरिए होता है।
NEXUS, Fundamental नामक सैन फ्रांसिस्को स्टार्टअप का क्लोज़्ड, केवल-व्यवसाय मॉडल है, जिसकी स्थापना पूर्व DeepMind शोधकर्ताओं ने की। यह फरवरी 2026 में $255M फंडिंग के साथ लॉन्च हुआ, और कंपनी इसे Large Tabular Model (LTM) कहती है।
बिज़नेस NEXUS को AWS के माध्यम से खरीदते और चलाते हैं, और Fundamental का कहना है कि Fortune 100 कंपनियाँ इसे डिमांड फोरकास्टिंग, प्राइसिंग, और कस्टमर चर्न के लिए पहले से उपयोग कर रही हैं। पर कोई सार्वजनिक वेट्स या बेंचमार्क नतीजे उपलब्ध नहीं हैं जिन्हें आप खुद जाँच सकें, इसलिए मैं इसे एंटरप्राइज़ विकल्प ही मानूँगा।
tabH2O, H2O.ai का मॉडल है, और इसका पूरा विचार सरल है: अपना डेटा भेजें, भविष्यवाणियाँ वापस पाएं।
यह आपके लिए मिसिंग वैल्यूज़ और कैटेगरीज़ को संभालता है और किसी कंपनी के अपने सर्वर्स पर चल सकता है—जो बैंकों और अस्पतालों के लिए महत्वपूर्ण है जो डेटा क्लाउड में नहीं भेज सकते।
अच्छी बात यह है कि tabH2O पेपर इसे बढ़ा-चढ़ा कर नहीं बेचता। इसने TALENT बेंचमार्क पर ट्यून किए हुए CatBoost और LightGBM को हराया, पर TabICLv2 से पीछे रहा।
| मॉडल | निर्माता | ओपन वेट्स? | अधिकतम स्केल | लाइसेंस | किसके लिए सर्वोत्तम |
|---|---|---|---|---|---|
| TabPFN-2 | Prior Labs | हाँ | 10K रो | क्रेडिट के साथ व्यावसायिक | एक सिद्ध पुराने मॉडल का व्यावसायिक उपयोग |
| TabPFN-3 / 3.5 | Prior Labs (SAP) | हाँ, लाइसेंस स्वीकारने के बाद | 1M रो तक | नॉन-कमर्शियल, बिज़नेस के लिए पेड API | टॉप सटीकता और रिसर्च |
| TabICLv2 | Inria | हाँ | 100K रो तक सर्वोत्तम | उदार ओपन सोर्स | आपका डिफ़ॉल्ट शुरुआती बिंदु |
| TabFM | Google Research | हाँ | BigQuery में 20 फीचर्स | नॉन-कमर्शियल वेट्स | BigQuery पर SQL उपयोगकर्ता |
| NEXUS | Fundamental | नहीं | प्रकटीकरण नहीं | स्वामित्व | AWS पर बड़ी कंपनियाँ |
| tabH2O | H2O.ai | नहीं | प्रकटीकरण नहीं | व्यावसायिक API | बिना ML सेटअप वाली टीमें, AI एजेंट्स |
आप Python में टैब्युलर फाउंडेशन मॉडल को बिल्कुल किसी भी scikit-learn मॉडल की तरह उपयोग करते हैं।
यह समझने का सबसे अच्छा तरीका है कि यह क्या देता है—इसे XGBoost के साथ आमने-सामने रखें, तो चलिए scikit-learn के बिल्ट-इन ब्रेस्ट कैंसर डेटासेट पर ऐसा करते हैं।
पहले, पैकेज इंस्टॉल करें:
pip install tabicl xgboost scikit-learnफिर, दोनों मॉडल एक ही स्प्लिट पर चलाएँ:
from sklearn.datasets import load_breast_cancer
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from tabicl import TabICLClassifier
from xgboost import XGBClassifier

# Load a small tabular dataset as a pandas DataFrame
X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# Tabular foundation model: fit() just stores the training rows
tfm = TabICLClassifier()
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)

# XGBoost baseline with reasonable, untuned settings
xgb = XGBClassifier(n_estimators=300, learning_rate=0.05, max_depth=4)
xgb.fit(X_train, y_train)
xgb_preds = xgb.predict(X_test)

print(f"TabICL accuracy:  {accuracy_score(y_test, tfm_preds):.3f}")
print(f"XGBoost accuracy: {accuracy_score(y_test, xgb_preds):.3f}")
यह छोटा डेटासेट सामान्य लैपटॉप CPU पर ठीक चलता है।
इतना साफ डेटासेट होने पर दोनों मॉडल बहुत ऊँचा स्कोर करेंगे, इसलिए कृपया उन्हें एक ही स्प्लिट पर जज न करें। असली परीक्षा आपका अपना उलझा हुआ डेटा होगा।
यदि आप इसके बजाय TabPFN आज़माना चाहते हैं, तो pip install tabpfn चलाएँ, और फिर सिर्फ दो लाइनें बदलें:
from tabpfn import TabPFNClassifier

tfm = TabPFNClassifier()  # The first run asks you to accept the license
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)
असली डेटा पर मॉडल्स की तुलना करने से पहले एक महत्वपूर्ण बात।
यदि आपके डेटा में तारीखें हैं, तो रैंडम की बजाय समय के अनुसार स्प्लिट करें। नहीं तो, मॉडल भविष्य में झाँक लेता है—और जैसा आप अगला सेक्शन में देखेंगे, यही वह जगह है जहाँ टैब्युलर फाउंडेशन मॉडल वास्तव में जितने अच्छे हैं, उससे बेहतर दिखते हैं।
टैब्युलर फाउंडेशन मॉडल तब अच्छा काम करते हैं जब आपका डेटासेट छोटा से मध्यम हो और टेस्ट रो, ट्रेनिंग रो जैसे दिखते हों। ये टाइम-ऑर्डर्ड डेटा, ग्रुप्ड डेटा, बहुत बड़ी टेबल्स, और कड़ी व्याख्येयता की ज़रूरतों में संघर्ष करते हैं।
“टेस्ट रो ट्रेनिंग रो जैसे दिखते हों” को IID (independent and identically distributed) कहा जाता है, और यह आपकी डेटा जाँच की एकल सबसे महत्वपूर्ण चीज़ है।
चलें, जहाँ ये अच्छे चलते हैं, वहाँ से शुरू करें:
अब सीमाएँ—जो मेरे विचार में असली प्रोजेक्ट में और भी मायने रखती हैं।
BeyondArena बेंचमार्क, जो जून 2026 में जारी हुआ, ने 142 डेटासेट्स पर 11 मॉडलों का परीक्षण किया, जिनमें समय के अनुसार स्प्लिट (अतीत से भविष्य की भविष्यवाणी) और समूह के अनुसार स्प्लिट (नए अस्पताल या देश के लिए भविष्यवाणी) शामिल थे।
इसने पाया कि टैब्युलर फाउंडेशन मॉडल छोटे और मध्यम IID डेटा पर सबसे अच्छा करते हैं, जबकि ट्री-आधारित और अन्य डीप लर्निंग मॉडल टाइम-ऑर्डर्ड, ग्रुप्ड, बड़े, और बहुत चौड़े डेटा पर आगे हैं। चूँकि अधिकांश बिज़नेस डेटा (सेल्स, फ्रॉड, चर्न) समयानुसार होता है, यह सीमा अधिकांश वास्तविक प्रोजेक्ट्स में दिखती है।
BeyondArena के बाद जारी TabPFN-3.5 ने खासतौर पर टाइम-ऑर्डर्ड और ग्रुप्ड डेटा पर इस गैप को पाटने का दावा किया है। यह आशाजनक है, पर अभी स्वतंत्र रूप से परखा नहीं गया।
आप TabICL और TabPFN दोनों से SHAP वैल्यू ले सकते हैं, पर यह ट्री मॉडल पर SHAP से कहीं अधिक समय लेता है, और जाँचने के लिए कोई ट्री स्प्लिट्स नहीं होते। क्रेडिट स्कोरिंग जैसी जगहों पर, जहाँ रेगुलेटर्स को मॉडल समझना होता है, यह वास्तविक समस्या है।
कुछ हज़ार रो से आगे आपको वास्तव में GPU चाहिए होता है, और जैसे-जैसे ट्रेनिंग डेटा बढ़ता है, प्रेडिक्शन धीमे होते जाते हैं। CPU पर प्रशिक्षित XGBoost हर बार गति में जीतेगा।
TabPFN-2 क्रेडिट के साथ व्यावसायिक है, नए TabPFN वर्ज़न नॉन-कमर्शियल हैं, TabFM वेट्स नॉन-कमर्शियल हैं, और TabICLv2 उदार है।
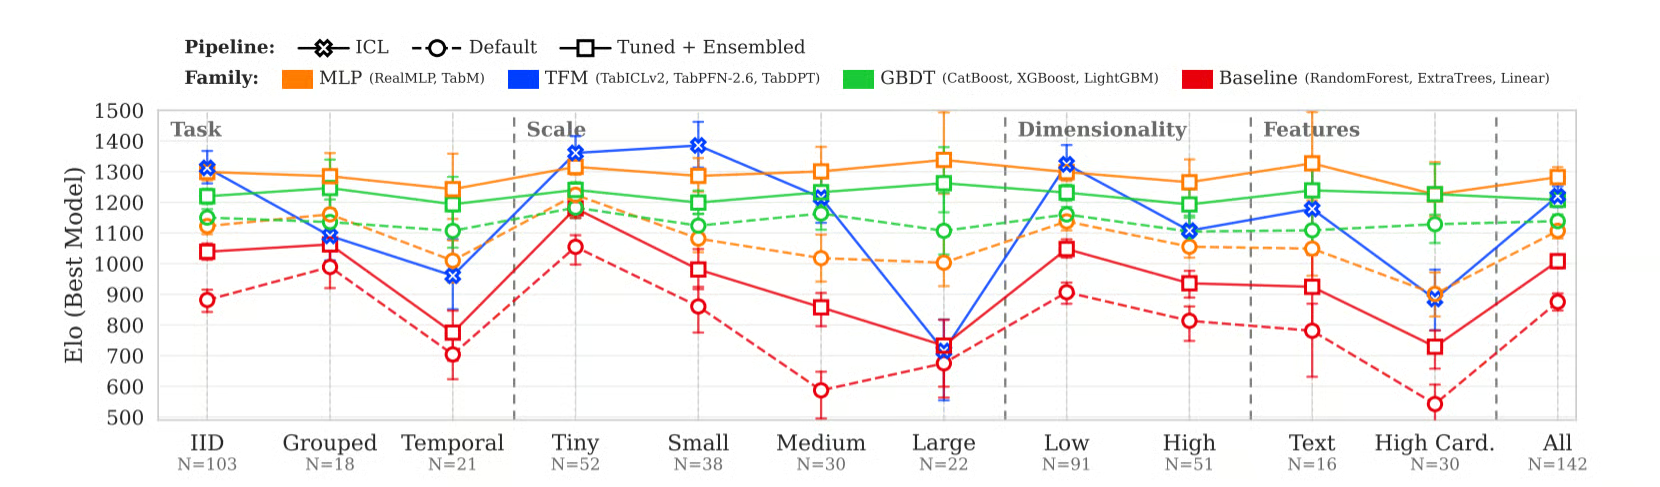
चित्र 3: मॉडल परिवार द्वारा Elo (जितना ऊँचा उतना बेहतर)। टैब्युलर फाउंडेशन मॉडल छोटे IID डेटा पर आगे हैं पर टेम्पोरल और बड़े डेटासेट्स पर गिरते हैं, जहाँ ट्रीज़ और MLP बेहतर टिकते हैं। नीला TabICLv2, TabPFN-2.6, और TabDPT में से सर्वश्रेष्ठ है, नवीनतम TabPFN वर्ज़न नहीं। स्रोत: Purucker et al., “Beyond IID: How General Are Tabular Foundation Models, Really?” (2026), CC BY 4.0.
उम्मीद है, आप सहमत होंगे कि टैब्युलर फाउंडेशन मॉडल्स ने बिना मेहनत के क्विक बेसलाइन की गुणवत्ता का स्तर ऊपर उठा दिया है, लेकिन कई वास्तविक स्थितियों में ट्री-आधारित मॉडल अभी भी बेहतर विकल्प हैं।
जब आपका डेटासेट छोटा से मध्यम और IID हो, और आपको पूरी तरह व्याख्येय मॉडल या CPU पर बहुत तेज़ प्रेडिक्शन की ज़रूरत न हो, तब आपको टैब्युलर फाउंडेशन मॉडल इस्तेमाल करना चाहिए। यहाँ एक निर्णय तालिका है जिसे मैं उपयोग करूँगा:
| परिदृश्य | अनुशंसित तरीका |
|---|---|
| 10K रो से कम, IID, व्याख्येयता की कोई जरूरत नहीं | TabICLv2 या TabPFN से शुरुआत करें |
| 10K से 100K रो, IID | TabICLv2 और XGBoost दोनों जाँचें, जो जीते उसे रखें |
| 100K से 1M रो | XGBoost या LightGBM से शुरू करें, TabPFN-3 को चैलेंजर की तरह आज़माएँ |
| समय या समूह के आधार पर स्प्लिट किया डेटा | ट्री-आधारित मॉडलों से शुरू करें |
| SHAP, फीचर इम्पोर्टेंस या ऑडिटिंग चाहिए | SHAP के साथ ट्री-आधारित मॉडल |
| GPU के बिना तेज़ प्रेडिक्शन | ट्री-आधारित मॉडल |
| त्वरित प्रूफ ऑफ कॉन्सेप्ट, कोई ML सेटअप नहीं | TabICLv2, या यदि आपका डेटा पहले से वहाँ है तो BigQuery AI.PREDICT |
| ऐसा AI एजेंट जिसे टेबल्स से प्रेडिक्शन चाहिए | tabH2O या NEXUS जैसा API |
मॉडल चुनने से पहले, मैं ये तीन प्रश्न पूछने की सलाह दूँगा:
और आखिरी बात यह: पहले टैब्युलर फाउंडेशन मॉडल चलाएँ, क्योंकि इसमें कुछ ही मिनट लगते हैं। यदि यह आपके डेटा पर XGBoost को नहीं हरा पाता, तो अब आपको पता है कि फीचर इंजीनियरिंग और XGBoost ट्यूनिंग पर समय लगाना सार्थक है।
लेख की शुरुआत के दो छात्रों को याद है? 2026 में, दूसरा छात्र—जो लाखों परीक्षाओं पर अभ्यास कर चुका है—आखिरकार पहले को हरा सकता है, कम से कम छोटे और मध्यम टेबल्स पर।
टैब्युलर फाउंडेशन मॉडल प्रति-डेटासेट ट्रेनिंग को प्रीट्रेनिंग से बदल देते हैं, और fit() को उदाहरणों से सीखने से।
मुझे सबसे अधिक यह बात चौंकाती है कि यह डोमेन कितनी जल्दी सुधरा है। TabPFN-2 ने 2025 में पहली बार दिखाया कि एक न्यूरल नेटवर्क छोटे टेबल्स पर ट्यून किए गए ट्रीज़ को हरा सकता है, और तब से TabICLv2 और TabPFN-3 ने इसे बहुत बड़े टेबल्स तक धकेला है।
अब खुले प्रश्न हैं—टाइम-ऑर्डर्ड डेटा, बदलता डेटा, व्याख्येयता, और लाइसेंसिंग—और यही वे चीज़ें हैं जो तय करती हैं कि कोई मॉडल असली प्रोडक्ट तक पहुँचता है या नहीं।
तो मेरी सलाह है कि इन मॉडलों को अपने नए शुरुआती बिंदु की तरह लें और अंतिम टूल अपने डेटा, अपनी सीमाओं, और मॉडल जहाँ चलेगा उसके आधार पर चुनें।
और यदि आप उन ट्री-आधारित मॉडलों में महारत हासिल करना चाहते हैं जो कई वास्तविक स्थितियों में आज भी जीतते हैं, तो हमारा Machine Learning with Tree-Based Models in Python कोर्स और Supervised Machine Learning in Python ट्रैक देखें। यदि आप R में काम करते हैं, तो Machine Learning with Tree-Based Models in R भी वही सामग्री कवर करता है।
शीर्ष DataCamp कोर्स
लर्निंग पाथ
कोर्स
लर्निंग पाथ