
Leerpad
Grote taalmodellen ontwikkelen
16 uur
Stel je twee studenten voor die hetzelfde examen maken. De eerste student leert drie weken lang alleen één onderdeel, terwijl de tweede al op miljoenen verschillende examens heeft geoefend en op de dag zelf gewoon een blad met uitgewerkte voorbeelden krijgt.
Gedurende het grootste deel van machine learning waren tabulaire modellen de eerste student. Elk nieuw dataset betekende kolommen opschonen, features engineeren, XGBoost of LightGBM trainen en urenlang hyperparameters tunen.
Tabular foundation models zijn echter de tweede student: je geeft ze je gelabelde rijen als voorbeelden en ze voorspellen de rest met helemaal geen training.
In 2026 ging dit idee van onderzoekspapers naar echte producten, met SAP dat meer dan €1 miljard toezegde aan Prior Labs en Google dat zijn eigen model uitbracht. In dit artikel kijken we dus naar:
Maak je geen zorgen als je niet veel deep learning-ervaring hebt. De code in dit artikel gebruikt de vertrouwde scikit-learn-interface, en als je eerst een korte opfrisser wilt, behandelt 8 Machine Learning-modellen uitgelegd in 20 minuten de basis.
pip install tabicl.Een tabular foundation model is een neuraal netwerk dat is voorgetraind op miljoenen synthetische tabulaire datasets, een algemene strategie leert om een doelkolom te voorspellen en die strategie vervolgens toepast op een nieuwe tabel via in-context learning, zonder enige training per dataset.
De grote verandering is wanneer het leren plaatsvindt.
Bij XGBoost vindt het leren plaats op jouw data elke keer dat je een nieuw model traint. Bij een tabulair foundation model vond het leren maanden geleden plaats tijdens de pretraining en is jouw data eenvoudigweg de invoer. Er zijn ook een paar termen die je vaak zult zien, dus laat me ze in gewone taal uitleggen:
Laten we nu bekijken hoe tabular foundation models zich verhouden tot boosting-methoden en automated machine learning (AutoML):
| Tabular foundation models | Gradient-boosted trees (XGBoost, LightGBM) | AutoML (AutoGluon, H2O AutoML) | |
|---|---|---|---|
| Traineduur op nieuwe data | Geen | Seconden tot minuten, plus tuning | Minuten tot uren |
| Interpretatie | Beperkt (SHAP kan, maar is traag) | Goed (feature importance, snelle SHAP) | Verschillend, vaak moeilijk leesbare ensembles |
| Beste datasetgrootte | Honderden tot ongeveer 100K rijen | Duizenden tot vele miljoenen rijen | Duizenden tot miljoenen rijen |
| GPU nodig? | Aanbevolen boven enkele duizenden rijen | Nee | Meestal niet |
| Kleine, willekeurig gesplitste datasets | Beste op huidige benchmarks | Sterk wanneer getuned | Sterk maar traag |
Voordat we kijken hoe ze werken, wil ik ze kort vergelijken met de bekendste en meest gebruikte modellen: large language models.
Large language models (LLM’s) en tabular foundation models gebruiken allebei transformers, en beide leren van voorbeelden in hun invoer.
Het verschil is wat ze zijn gebouwd om te lezen. Een LLM leest een tabel als één lange tekststring, wat betekent dat het uit komma’s en spaties moet afleiden welke getallen bij dezelfde kolom horen.
Er is ook een betekeniskwestie.
De waarde 42 kan iemands leeftijd zijn of een omzetcijfer, maar niets in het getal zelf vertelt je wat het is. Een tabulair foundation model is getraind om elke kolom als een eigen variabele te behandelen en elke rij als één voorbeeld, zodat het zich richt op hoe de kolommen zich tot elkaar verhouden.
Ik denk er graag zo over: een LLM is geweldig in praten over je data, en een tabulair foundation model is gebouwd om het rekenwerk erop te doen.
Ze kunnen ook samenwerken, precies zoals H2O.ai zijn tabH2O-model positioneert: als het voorspelinstrument dat een AI-agent aanroept wanneer die een getal uit een spreadsheet nodig heeft.
Tabulaire data was lastig voor deep learning omdat tabellen geen gedeelde structuur hebben die een neuraal netwerk één keer kan leren en hergebruiken. Een pixel is een pixel in elke foto. Een kolom met de naam score in een financieel dataset en een kolom met de naam score in een voetbaldataset hebben niets met elkaar gemeen.
Een bekende paper uit 2022 van Léo Grinsztajn, Edouard Oyallon en Gaël Varoquaux, Why do tree-based models still outperform deep learning on tabular data?, testte dit op 45 datasets en stelde vast dat boombasede modellen, vooral gradient boosting, nog steeds beter presteren dan deep learning op middelgrote tabellen van rond de 10.000 rijen. De gevonden redenen zijn:
Twee praktische problemen maken dit erger. Eén enkele tabel kan nummers, categorieën, rangordes en missende waarden mixen, en de meeste zakelijke tabellen hebben slechts honderden of duizenden rijen, veel te weinig voor een neuraal netwerk dat vanaf nul wordt getraind.
Ik zou stellen dat kleine datasets het belangrijkste probleem zijn. Een neuraal netwerk dat vanaf nul traint op 800 rijen heeft niets om op terug te vallen, terwijl een boom geen voorkennis nodig heeft om te werken.
Pretraining loste dit precies op. Een tabulair foundation model heeft al op miljoenen kleine, rommelige, verzonnen tabellen geoefend voordat het de jouwe ziet, dus het begint niet vanaf nul.
Een tabulair foundation model neemt je gelabelde trainingsrijen en je ongelabelde testrijen samen als één invoer en voorspelt de ontbrekende labels in één forward pass. De gewichten veranderen nooit, net als een LLM die een vraag beantwoordt nadat je een paar voorbeelden in de prompt hebt gegeven.
Dit verandert ook wat de bekende scikit-learn-methoden betekenen.
Wanneer je .fit() aanroept op TabICL, legt de TabICL-documentatie uit dat het de voorgetrainde checkpoint laadt, je data preprocesset en opslaat. Het echte werk gebeurt tijdens .predict().
De naam .fit() blijft zodat het model in je bestaande scikit-learn-code past.
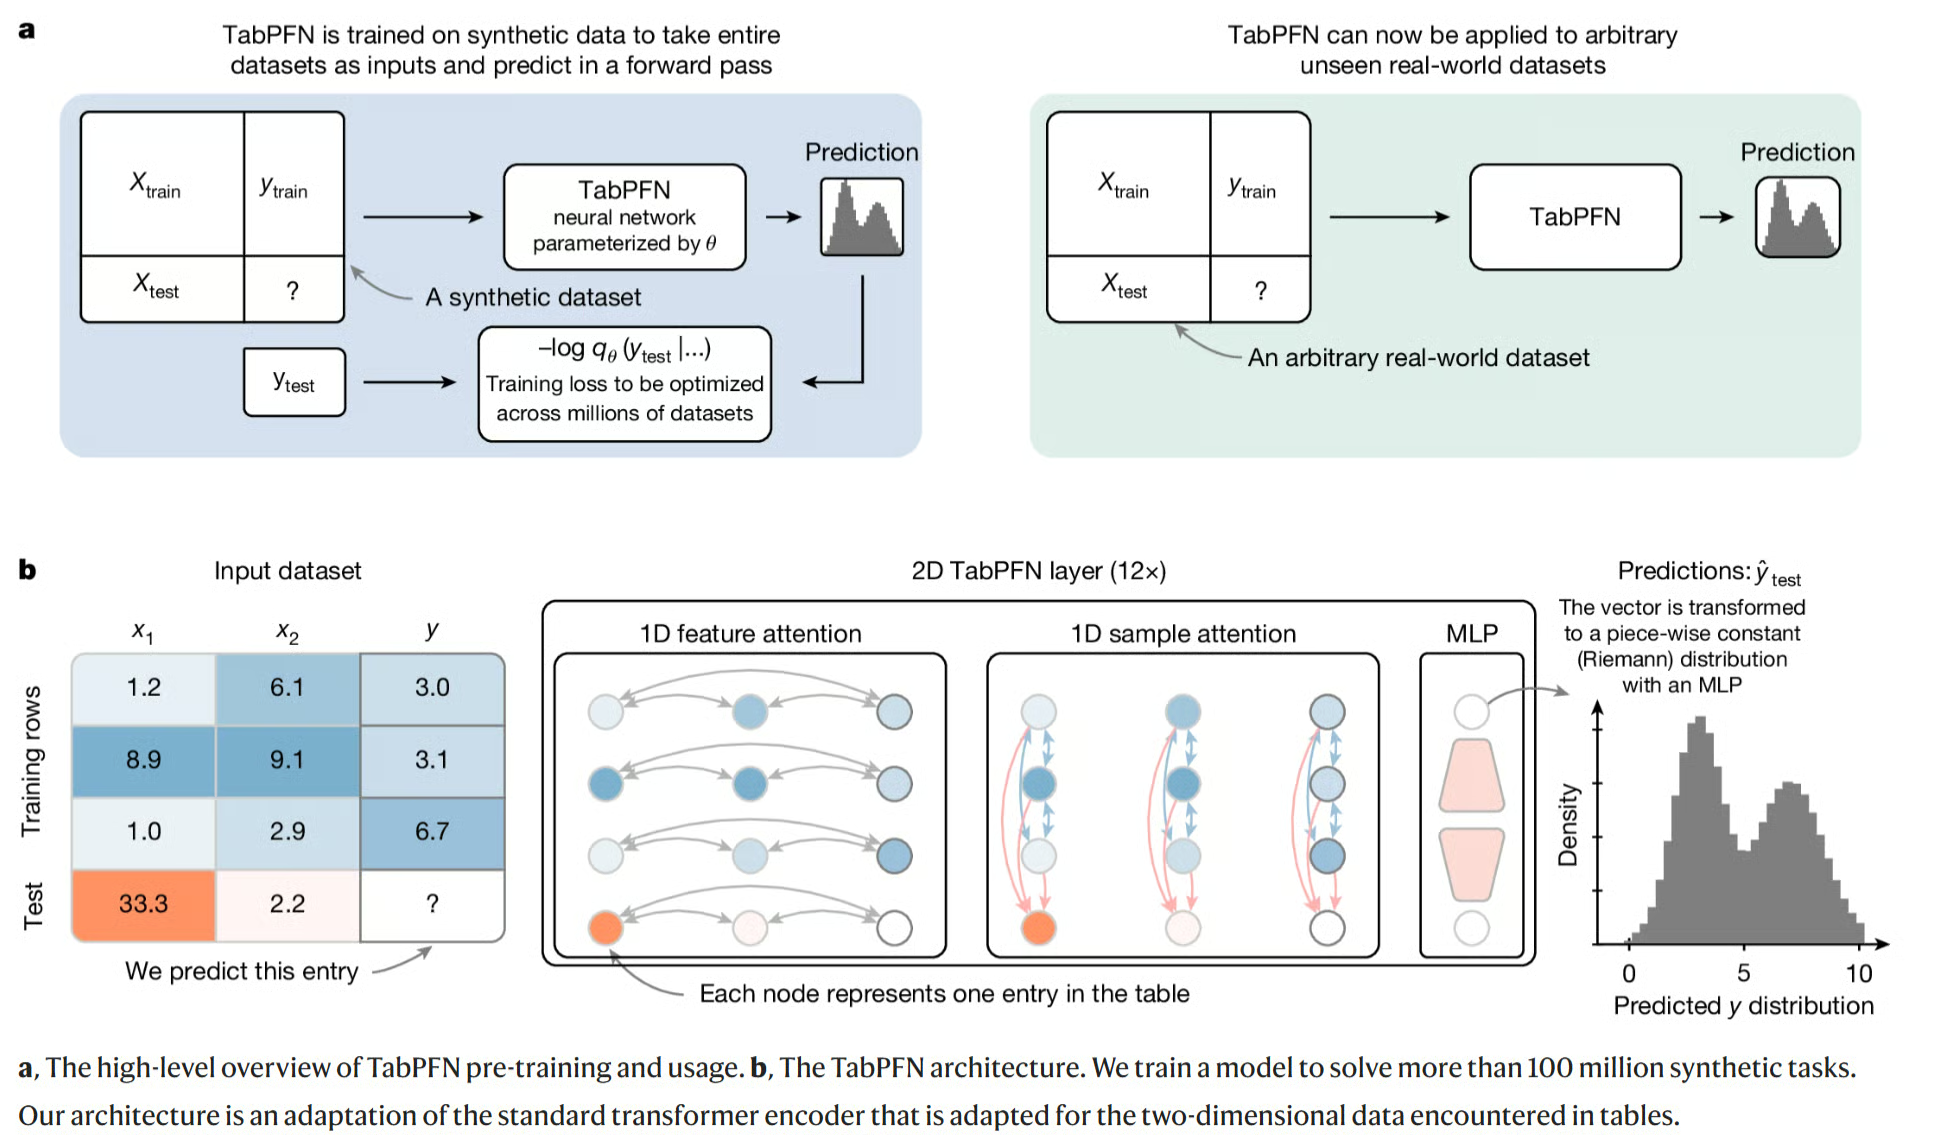
Figuur 1: TabPFN wordt voorgetraind op miljoenen synthetische datasets en voorspelt vervolgens op een echte tabel in één forward pass. Het onderste paneel laat zien hoe het zowel over features als samples aandacht besteedt. Bron: Hollmann et al., “Accurate predictions on small data with a tabular foundation model”, Nature (2025).
Synthetische pretraining betekent dat je het model traint op verzonnen tabellen in plaats van echte, geproduceerd door een datagenerator die werkt als een generatief model.
Denk aan een piloot die traint in een vluchtsimulator. De piloot oefent duizenden nepvluchten met verschillend weer, luchthavens en storingen, zodat de eerste echte vlucht niet nieuw aanvoelt.
TabPFN werkt op een vergelijkbare manier.
De makers schreven een generator die willekeurige “oorzaak-en-gevolg”-regels tussen kolommen verzint (bijvoorbeeld, kolom A beïnvloedt kolom B, die het doel beïnvloedt) en genereert vervolgens rijen uit die regels.
Tijdens de pretraining wordt de doelkolom verborgen, probeert het model die te voorspellen en dit herhaalt zich miljoenen keren met verschillende regels, ruisniveaus en tabelgroottes.
Belangrijk is dat het model nooit feiten over een echt onderwerp leert. Het leert algemene vaardigheden zoals herkennen welke kolommen ertoe doen, omgaan met uitschieters en weten wanneer het onzeker moet zijn.
De TabICLv2-paper schrijft zijn nieuwe synthetische datagenerator zelfs aan als een belangrijke reden voor de betere prestaties.
Je hoeft niet elk detail van de architecturen te begrijpen, maar het helpt om te weten dat er twee hoofdontwerpen zijn:
Let op: beide families zijn getraind op synthetische data, dus “prior-fitted network” beschrijft hoe ze zijn getraind in plaats van een apart type model.
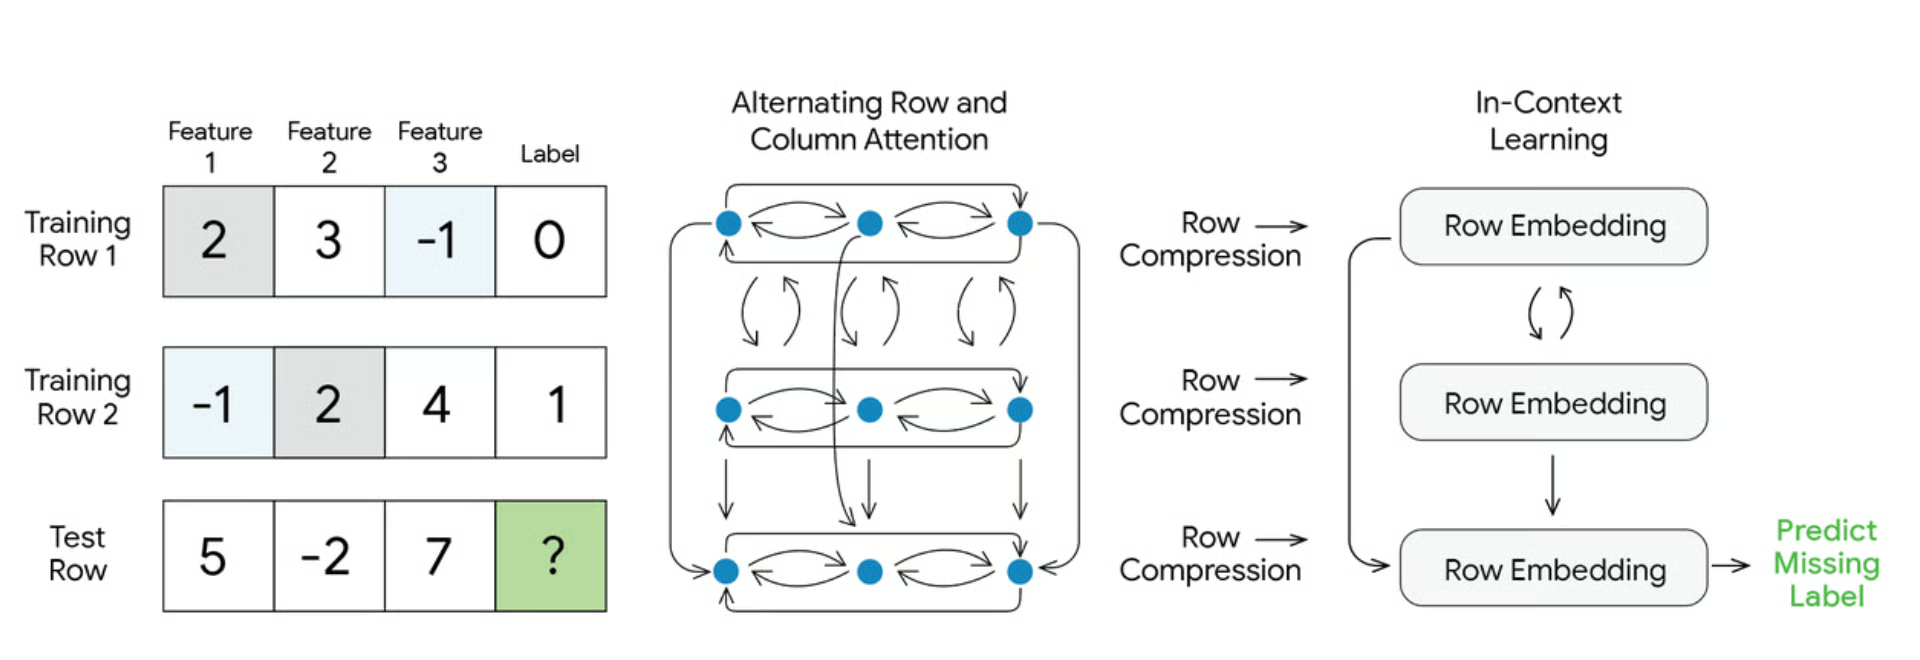
Figuur 2: TabFM mixt beide ontwerpen: TabPFN-stijl attentie over rijen en kolommen, daarna TabICL-stijl rijcompressie en vervolgens in-context learning voor het ontbrekende label. Bron: Google Research, “Introducing TabFM: A zero-shot foundation model for tabular data” (2026).
Er is een trade-off die veel mensen verrast.
XGBoost besteedt één keer tijd aan trainen en voorspelt daarna bijna direct.
Een tabulair foundation model slaat trainen over, maar moet al je trainingsrijen lezen elke keer dat het voorspelt.
Denk aan een chef die geen mise-en-place doet voor de service, maar bij elke bestelling het hele receptenboek opnieuw moet doorlezen.
Voor een dun boek is dat prima, maar naarmate je dataset groeit, worden voorspellingen trager. Zowel TabICL als TabPFN kunnen hun “lezing” van de trainingsdata cachen om herhaalde voorspellingen te versnellen, maar de eerste pass kost nog steeds tijd.
De belangrijkste tabular foundation models in 2026 zijn TabPFN, TabICLv2, Google’s TabFM, Fundamental’s NEXUS en H2O.ai’s tabH2O. Wat ik interessant vind, is hoe snel de zakelijke kant ging: vijf maanden brachten dit gebied van academische papers naar grote deals. Hier is een korte tijdlijn:
Laten we nu elk model doornemen, te beginnen met het model dat dit alles startte.
TabPFN is het model dat deze categorie creëerde. TabPFN-2 werd in januari 2025 in Nature gepubliceerd en versloeg getunede boombasede modellen op datasets tot 10.000 rijen.
Sindsdien heeft Prior Labs snel nieuwe versies uitgebracht. TabPFN-3 verscheen in mei 2026 en ondersteunt tot 1 miljoen rijen (en tot 200 features). Het voegde ook een Thinking-modus toe (via de betaalde API) die extra tijd besteedt in de fit-fase om betere voorspellingen te maken.
De nieuwste versie, TabPFN-3.5, kwam in september 2026 uit, en het technische rapport claimt de eerste plaats op verschillende grote benchmarks, ook op tijdgeordende en gegroepeerde data. Ik zou die cijfers zien als de eigen cijfers van het bedrijf totdat anderen ze bevestigen.
Nog iets is de licentie. TabPFN-2 kan commercieel worden gebruikt zolang je Prior Labs vermeldt, maar versies 2.5 tot 3.5 zijn niet-commercieel. Dat betekent dat je er gratis mee kunt experimenteren, maar gebruik in een echt product vereist een betaalde licentie.
TabICLv2 is op dit moment het beste volledig open tabular foundation model. Het is gebouwd bij Inria, uitgebracht in februari 2026 en geaccepteerd op ICML 2026.
Het kernresultaat uit de TabICLv2-paper is dat het, zonder enige tuning, RealTabPFN-2.5, het vorige beste model, versloeg, zelfs al was dat model getuned, geënsembleerd en gefinetuned op echte data.
Volgens de GitHub-repository verslaat het ook zwaar getunede XGBoost, CatBoost en LightGBM op ongeveer 80% van de datasets in de TabArena-benchmark.
Het is ook snel: 50.000 rijen met 100 features in minder dan 10 seconden op een H100-GPU, ongeveer 10 keer sneller dan TabPFN-2.5.
Het werkt het best tussen 300 en 100.000 rijen en kan zich uitstrekken tot rond 500.000 rijen met enig verlies aan nauwkeurigheid.
Naar mijn mening is dit degene waarmee de meeste lezers zouden moeten beginnen.
Je installeert het met pip install tabicl, het werkt als elk scikit-learn-model en de soepele licentie laat je het commercieel gebruiken zonder ergens te hoeven aanmelden. Het leaderboard verandert snel, en het rapport van TabPFN-3.5 zet zichzelf nu boven TabICLv2.
TabFM is het tabulaire foundation model van Google Research, uitgebracht op 30 juni 2026. Wat het anders maakt, is waar je het kunt gebruiken: het is ingebouwd in BigQuery, Google’s cloud datawarehouse, zodat je met gewone SQL voorspellingen kunt krijgen.
-- Use past customers (with known churn) to predict churn for new customers
-- AI.PREDICT is in preview, so check the BigQuery docs for the latest syntax
SELECT *
FROM AI.PREDICT(
  TABLE my_dataset.customers_history,
  TABLE my_dataset.customers_new,
  label_col => 'churned'
);
Dit is ideaal voor mensen die wel SQL kennen maar geen Python.
De BigQuery-documentatie beperkt je momenteel echter tot 20 featurekolommen en 10 klassen, en Google is van plan om vanaf 30 oktober 2026 token-based pricing toe te voegen bovenop de standaard BigQuery-kosten. De modelgewichten op Hugging Face zijn niet-commercieel, dus commercieel gebruik verloopt via BigQuery.
NEXUS is een gesloten, uitsluitend zakelijk model van Fundamental, een startup uit San Francisco opgericht door voormalige DeepMind-onderzoekers. Het werd gelanceerd in februari 2026 met $255 miljoen aan financiering, en het bedrijf noemt het een Large Tabular Model (LTM).
Bedrijven kopen en draaien NEXUS via AWS, en Fundamental zegt dat Fortune 100-bedrijven het al gebruiken voor vraagprognoses, prijsstelling en klantverloop. Er zijn echter geen publieke gewichten of benchmarkresultaten die je zelf kunt controleren, dus ik zou het zien als een enterprise-optie.
tabH2O is het model van H2O.ai, en het hele idee is simpel: stuur je data, krijg voorspellingen terug.
Het ruimt missende waarden en categorieën voor je op en kan draaien op de eigen servers van een bedrijf, wat telt voor banken en ziekenhuizen die geen data naar de cloud mogen sturen.
Wat ik prettig vind, is dat de tabH2O-paper het niet oversellt. Het versloeg getunede CatBoost en LightGBM op de TALENT-benchmark, maar stond nog steeds onder TabICLv2.
| Model | Maker | Open gewichten? | Maximale schaal | Licentie | Beste voor |
|---|---|---|---|---|---|
| TabPFN-2 | Prior Labs | Ja | 10K rijen | Commercieel met naamsvermelding | Commercieel gebruik van een bewezen ouder model |
| TabPFN-3 / 3.5 | Prior Labs (SAP) | Ja, na accepteren van een licentie | Tot 1M rijen | Niet-commercieel, betaalde API voor zakelijk gebruik | Topnauwkeurigheid en research |
| TabICLv2 | Inria | Ja | Beste tot 100K rijen | Soepele open source | Je standaard startpunt |
| TabFM | Google Research | Ja | 20 features in BigQuery | Niet-commerciële gewichten | SQL-gebruikers op BigQuery |
| NEXUS | Fundamental | Nee | Niet bekendgemaakt | Propriëtair | Grote bedrijven op AWS |
| tabH2O | H2O.ai | Nee | Niet bekendgemaakt | Commerciële API | Teams zonder ML-setup, AI-agents |
Je gebruikt een tabulair foundation model in Python precies zoals elk ander scikit-learn-model.
De beste manier om te zien wat het biedt, is het head-to-head zetten met XGBoost, dus laten we dat doen op de ingebouwde borstkanker-dataset van scikit-learn.
Eerst installeren we de pakketten:
pip install tabicl xgboost scikit-learnDaarna draaien we beide modellen op dezelfde split:
from sklearn.datasets import load_breast_cancer
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from tabicl import TabICLClassifier
from xgboost import XGBClassifier

# Load a small tabular dataset as a pandas DataFrame
X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# Tabular foundation model: fit() just stores the training rows
tfm = TabICLClassifier()
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)

# XGBoost baseline with reasonable, untuned settings
xgb = XGBClassifier(n_estimators=300, learning_rate=0.05, max_depth=4)
xgb.fit(X_train, y_train)
xgb_preds = xgb.predict(X_test)

print(f"TabICL accuracy:  {accuracy_score(y_test, tfm_preds):.3f}")
print(f"XGBoost accuracy: {accuracy_score(y_test, xgb_preds):.3f}")
Deze kleine dataset draait prima op een normale laptop-CPU.
Beide modellen zullen op iets schoons als dit heel hoog scoren, dus oordeel alsjeblieft niet op basis van één split. De echte test is jouw eigen rommelige data.
Als je in plaats daarvan TabPFN wilt proberen, voer dan pip install tabpfn uit, en dan is het maar een wijziging van twee regels:
from tabpfn import TabPFNClassifier

tfm = TabPFNClassifier()  # The first run asks you to accept the license
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)
Eén belangrijk punt voordat je modellen op echte data vergelijkt.
Als je data datums bevat, splitst je dan op tijd in plaats van willekeurig. Anders mag het model naar de toekomst gluren, en zoals je in de volgende sectie zult zien, is dat precies waar tabular foundation models beter lijken dan ze echt zijn.
Tabular foundation models werken goed wanneer je dataset klein tot middelgroot en IID is, en de testrijen lijken op de trainingsrijen. Ze hebben moeite met tijdgeordende data, gegroepeerde data, zeer grote tabellen en strikte uitlegbaarheidseisen.
Dat “testrijen lijken op trainingsrijen”-idee heeft een naam, IID (independent and identically distributed), en het is het allerbelangrijkste om voor je data te checken.
Laten we beginnen met waar ze goed werken:
Dan nu de beperkingen, die naar mijn idee zwaarder wegen als je deze in een echt project wilt gebruiken.
De BeyondArena-benchmark, uitgebracht in juni 2026, testte 11 modellen op 142 datasets, inclusief datasets gesplitst op tijd (de toekomst voorspellen op basis van het verleden) en per groep (voorspellen voor een nieuw ziekenhuis of land).
Daaruit bleek dat tabular foundation models het best presteren op kleine en middelgrote IID-data, terwijl boombasede en andere deep learning-modellen nog steeds leiden op tijdgeordende, gegroepeerde, grote en zeer brede data. Aangezien de meeste zakelijke data (sales, fraude, churn) in de tijd geordend is, zie je deze beperking in veel echte projecten terug.
TabPFN-3.5, uitgebracht na BeyondArena, claimt specifiek dit gat te dichten op tijdgeordende en gegroepeerde data. Dat is veelbelovend, maar het is nog niet onafhankelijk getest.
Je kunt SHAP-waarden krijgen uit zowel TabICL als TabPFN, maar het duurt veel langer dan SHAP op een boommodel, en er zijn geen boom-splits om te inspecteren. In domeinen zoals kredietbeoordeling, waar toezichthouders het model moeten begrijpen, is dit een echt probleem.
Alles boven enkele duizenden rijen wil eigenlijk een GPU, en voorspellingen worden trager naarmate je trainingsdata groeit. Een getraind XGBoost-model op een CPU wint elke keer op snelheid.
TabPFN-2 is commercieel met vermelding, nieuwere TabPFN-versies zijn niet-commercieel, TabFM-gewichten zijn niet-commercieel en TabICLv2 is permissief.
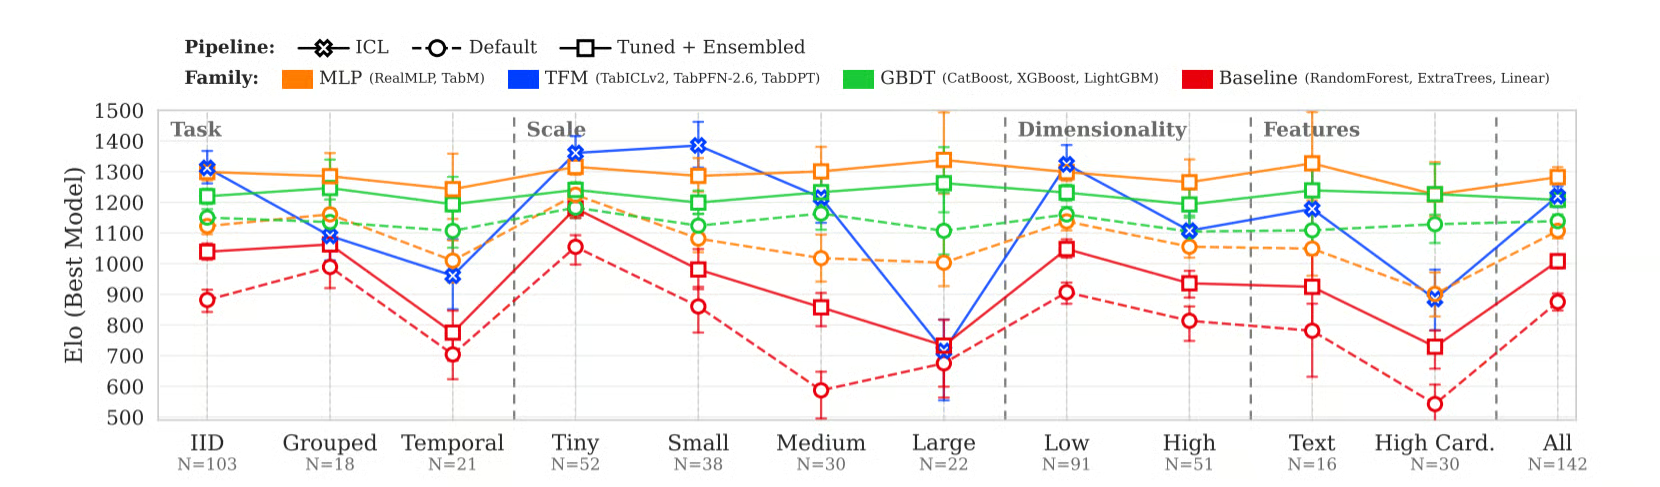
Figuur 3: Elo per modelfamilie (hoger is beter). Tabular foundation models leiden op kleine IID-data maar zakken op temporele en grote datasets, waar bomen en MLP’s beter standhouden. Blauw is de beste van TabICLv2, TabPFN-2.6 en TabDPT, niet de nieuwste TabPFN-versies. Bron: Purucker et al., “Beyond IID: How General Are Tabular Foundation Models, Really?” (2026), CC BY 4.0.
Hopelijk ben je het met me eens dat tabular foundation models de lat hebben verhoogd voor hoe goed een snelle, moeiteloze baseline kan zijn, maar dat boombasede modellen in veel echte situaties nog steeds de betere keuze zijn.
Je gebruikt een tabulair foundation model wanneer je dataset klein tot middelgroot en IID is, en je geen volledig uitlegbaar model nodig hebt of razendsnelle voorspellingen op een CPU. Hier is de beslijstabel die ik zou gebruiken:
| Scenario | Aanbevolen aanpak |
|---|---|
| Onder 10K rijen, IID, geen uitlegbaarheidsbehoefte | Begin met TabICLv2 of TabPFN |
| 10K tot 100K rijen, IID | Test TabICLv2 en XGBoost, houd de winnaar |
| 100K tot 1M rijen | Begin met XGBoost of LightGBM, probeer TabPFN-3 als uitdager |
| Data gesplitst op tijd of per groep | Begin met boombasede modellen |
| SHAP, feature importance of auditing nodig | Boommodel met SHAP |
| Snelle voorspellingen zonder GPU | Boommodel |
| Snelle proof of concept, geen ML-setup | TabICLv2, of BigQuery AI.PREDICT als je data daar al staat |
| AI-agent die voorspellingen uit tabellen nodig heeft | Een API zoals tabH2O of NEXUS |
Voordat je een model kiest, zou ik deze drie vragen stellen:
En het laatste punt dat ik wil maken is dit. Draai eerst een tabulair foundation model, want het kost je maar een paar minuten. Als het XGBoost op jouw data niet kan verslaan, weet je nu dat tijd besteden aan feature engineering en het tunen van XGBoost de moeite waard is.
Weet je nog die twee studenten uit het begin? In 2026 kan de tweede student, degene die op miljoenen examens heeft geoefend, eindelijk de student verslaan die wekenlang heeft gestudeerd, in elk geval op kleine en middelgrote tabellen.
Tabular foundation models vervangen training per dataset door pretraining, en vervangen fit() door leren van voorbeelden.
Wat mij het meest verrast, is hoe snel dit domein is verbeterd. TabPFN-2 liet in 2025 voor het eerst zien dat een neuraal netwerk getunede bomen kon verslaan op kleine tabellen, en TabICLv2 en TabPFN-3 hebben dat sindsdien op veel grotere tabellen doorgetrokken.
De open problemen zijn nu tijdgeordende data, veranderende data, uitlegbaarheid en licenties, precies de dingen die bepalen of een model het tot een echt product schopt.
Mijn advies is dus om deze modellen als je nieuwe startpunt te zien en de uiteindelijke tool te kiezen op basis van jouw data, jouw beperkingen en waar het model zal draaien.
En als je de boombasede modellen wilt beheersen die in veel echte situaties nog steeds winnen, bekijk dan onze cursus Machine Learning with Tree-Based Models in Python en het Supervised Machine Learning in Python-traject. Werk je in R, dan behandelt Machine Learning with Tree-Based Models in R hetzelfde terrein.
Topcursussen bij DataCamp
Leerpad
Cursus
Leerpad
blog
Adel Nehme
15 min

