
学习路径
开发大型语言模型
16 小时
想象两位参加同一场考试的学生。第一位学生花三周时间只学习一个模块;第二位学生则已做过上百万份不同的试卷,并在考试当天拿到一张带有解题步骤的示例清单。
在大部分机器学习的发展历程中,表格模型更像第一位学生。每拿到一个新数据集,都要清洗列、做特征工程、训练 XGBoost 或 LightGBM,并花上数小时调参。
而表格基础模型就像第二位学生:您把带标签的行作为示例交给它,它就能在完全不训练的情况下预测其余部分。
到了 2026 年,这个理念从研究论文走向落地产品:SAP 向 Prior Labs 投入超过 €1 十亿,Google 也发布了自家模型。因此,本文将讨论:
即使您缺乏深度学习经验也不必担心。本文的代码使用熟悉的 scikit-learn 接口;如果您需要快速复习,20 分钟看懂 8 种机器学习模型涵盖了基础。
pip install tabicl 安装。表格基础模型是在数百万张合成表格数据上预训练的神经网络,它学会了预测目标列的一般策略,然后通过上下文学习将该策略应用到新表上,而无需针对每个数据集进行训练。
这里最大的变化在于学习发生的时间。
用 XGBoost 时,每训练一个新模型,学习都会在您的数据上进行。用表格基础模型时,学习早在数月前的预训练阶段就已完成,您的数据只是输入。此外,您会经常看到几个术语,下面用通俗语言解释一下:
现在,让我们把表格基础模型与提升方法以及自动化机器学习(AutoML)做个比较:
| 表格基础模型 | 梯度提升树(XGBoost、LightGBM) | AutoML(AutoGluon、H2O AutoML) | |
|---|---|---|---|
| 在新数据上的训练时间 | 无 | 数秒到数分钟,另加调参 | 数分钟到数小时 |
| 可解释性 | 有限(可用 SHAP,但较慢) | 较好(特征重要性,SHAP 快) | 不一,常为难读的集成模型 |
| 最适用数据集规模 | 数百到约 10 万行 | 上千到数百万行 | 上千到数百万行 |
| 需要 GPU 吗? | 建议超过数千行就使用 | 不需要 | 通常不需要 |
| 小规模、随机切分数据集 | 当前基准上表现最佳 | 调参后表现强 | 表现强但较慢 |
在了解工作原理之前,我想先把它们和最知名、最常用的模型——大型语言模型——简单对比一下。
大型语言模型(LLM)与表格基础模型都使用Transformer,且都会从输入中的示例学习。
区别在于它们被构建来读取的对象不同。LLM 把表格当作一长串文本读取,这意味着它需要从逗号和空格中推断哪些数字属于同一列。
还存在语义问题。
数值 42 可能是年龄,也可能是营收,但数字本身并不会告诉您是哪一种。表格基础模型被训练为将每列视作独立变量、每行视作一个样本,因此会专注于列与列之间的关系。
我喜欢这样理解:LLM 擅长“谈论”您的数据,而表格基础模型则是为“对数据做数学运算”而生。
两者也可协同工作,这正是 H2O.ai 的 tabH2O 的定位:当 AI 代理需要从电子表格中得到一个数值时,调用它来做预测。
表格数据之所以难,是因为表格缺乏可被神经网络“一次学会、处处复用”的共享结构。每张照片里的像素都是像素;但金融数据集里名为 score 的列,与足球数据集里名为 score 的列,并无共性。
Léo Grinsztajn、Edouard Oyallon 与 Gaël Varoquaux 在 2022 年的一篇知名论文 Why do tree-based models still outperform deep learning on tabular data?(为何树模型仍优于深度学习处理表格数据?)在 45 个数据集上检验后发现,基于树的模型,尤其是梯度提升,在约 1 万行的中等规模表格上依旧胜过深度学习。原因包括:
还有两个实际问题让情况更糟。一张表里可能混有数值、类别、排序以及缺失值;而多数业务表只有数百到数千行,远不足以从零训练一个神经网络。
我认为,小数据集是最关键的问题。从零开始在 800 行上训练的神经网络无从借力,而树模型无需任何先验知识也能工作。
预训练正是为此而生。表格基础模型在见到您的数据之前,已经在数百万张小而杂乱的虚构表格上练过手,因此并非从零起步。
表格基础模型把带标签的训练行与未标注的测试行合并为一个输入,并在一次前向传播中预测缺失的标签。它的权重从不改变,就像 LLM 在您给出几个示例后回答问题一样。
这也改变了熟悉的 scikit-learn 方法的含义。
当您在 TabICL 上调用 .fit() 时,TabICL 文档解释说它会加载预训练检查点、预处理并存储您的数据。真正的工作发生在 .predict() 期间。
.fit() 这个名称保留下来,是为了让模型无缝融入您现有的 scikit-learn 代码。
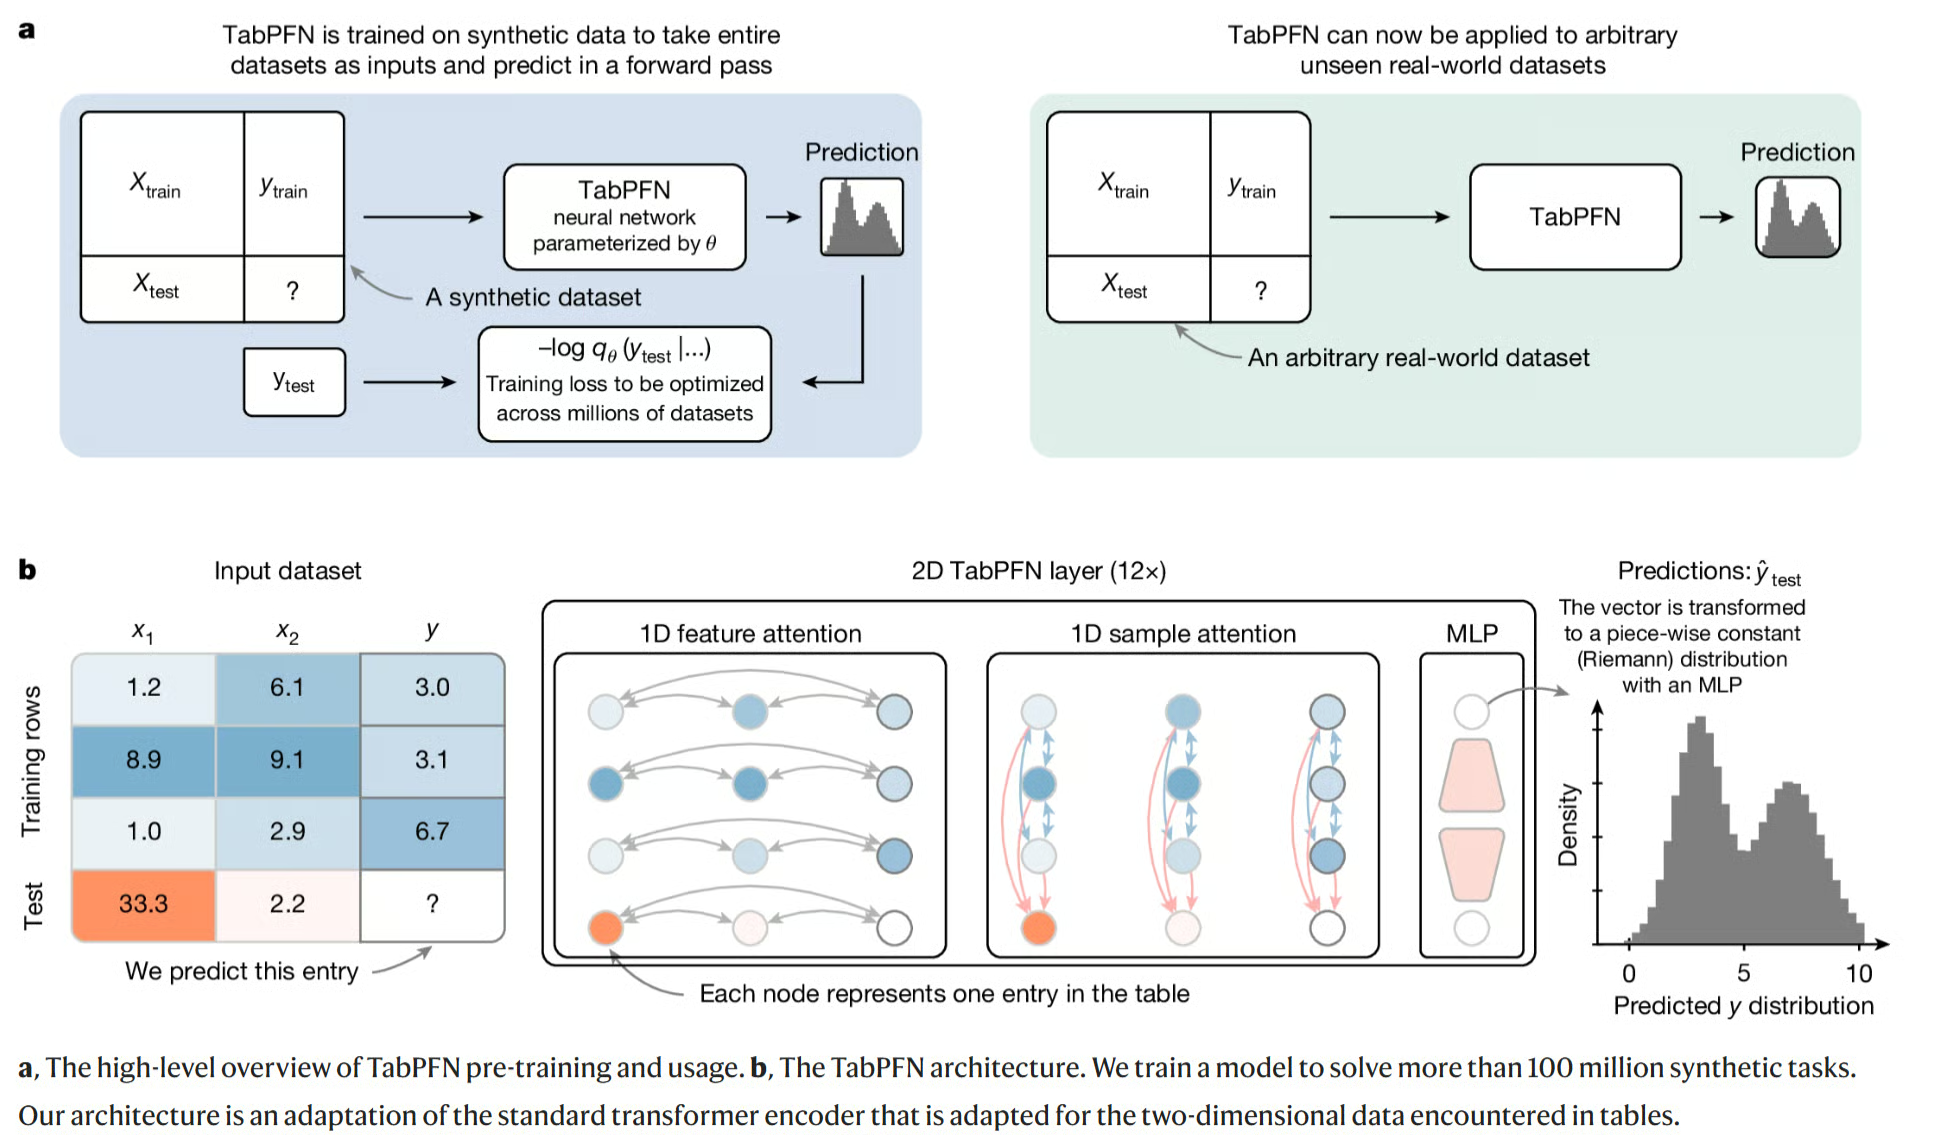
图 1:TabPFN 先在数百万个合成数据集上预训练,然后在真实表格上一趟前向传递完成预测。底部面板展示了它在特征与样本维度上的注意力机制。来源:Hollmann 等,《Accurate predictions on small data with a tabular foundation model》,Nature(2025)。
合成预训练指在虚构表格上训练模型,这些表格由类似生成式模型的数据生成器产生。
可以把它想象成飞行员在模拟器中训练。飞行员在不同天气、机场与故障条件下练了上千次假飞行,这样第一次真实飞行就不再陌生。
TabPFN 的工作方式类似。
其作者编写了一个生成器,随机发明列与列之间的“因果”规则(例如,A 列影响 B 列,而 B 列影响目标),再根据这些规则生成行。
在预训练期间,目标列被隐藏,模型尝试去预测它,如此在不同规则、噪声水平与表格规模下重复上百万次。
重要的是,模型从不会学习任何真实主题的事实。它学习的是通用能力,如识别哪些列重要、处理离群值、以及在何时保持不确定。
事实上,TabICLv2 论文将其新的合成数据生成器视为性能提升的关键原因之一。
您不必掌握所有架构细节,但了解两种主要设计思路会有所帮助:
注意,这两大家族都在合成数据上训练,因此“先验拟合网络”描述的是训练方式,而非另一类模型。
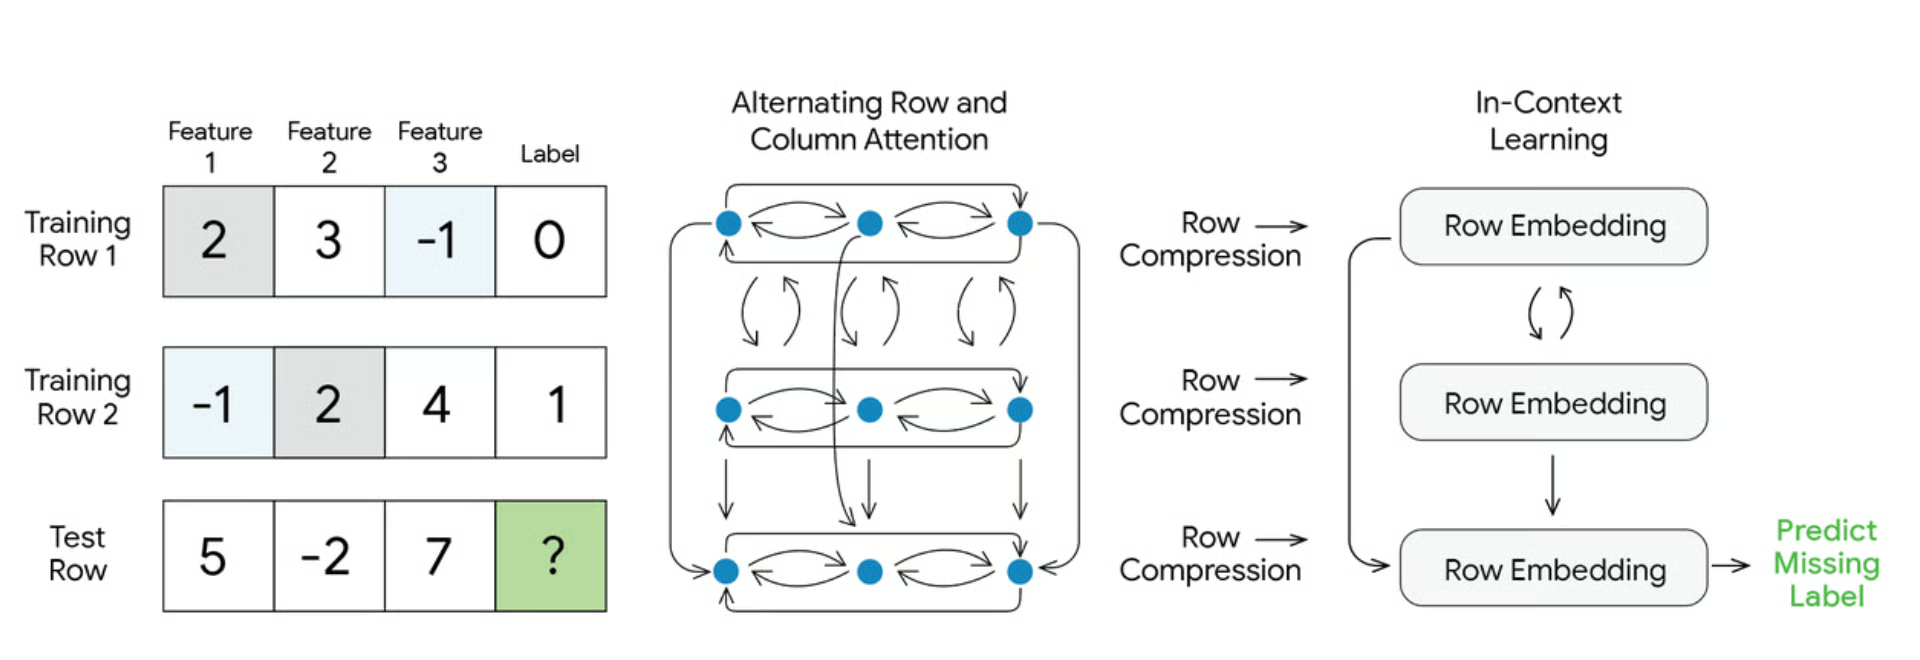
图 2:TabFM 融合两种设计:先做 TabPFN 风格的行/列注意力,再做 TabICL 风格的行压缩,最后在上下文中预测缺失标签。来源:Google Research,《Introducing TabFM: A zero-shot foundation model for tabular data》(2026)。
这里有个权衡,容易让人忽略。
XGBoost 训练时花时间,但预测几乎瞬时完成。
表格基础模型跳过训练,但它在每次预测时都必须重新读取所有训练行。
想象一位厨师不做任何备料,但每接一单都要把整本菜谱从头到尾重读一遍。
如果“菜谱”不厚还好,但随着数据集变大,预测会变慢。TabICL 与 TabPFN 都能缓存对训练数据的“阅读”来加速重复预测,但首轮仍需时间。
2026 年的关键模型有 TabPFN、TabICLv2、Google 的 TabFM、Fundamental 的 NEXUS,以及 H2O.ai 的 tabH2O。我觉得有趣的是商业端推进之快:短短五个月,这一领域从学术论文走到重大交易。时间线如下:
下面逐一介绍,从开创此类目的模型开始。
TabPFN 是开创该类别的模型。TabPFN-2 于 2025 年 1 月发表在 Nature 上,并在最多 10,000 行的数据集上击败了调参后的树模型。
此后,Prior Labs 快速推出新版本。TabPFN-3 于 2026 年 5 月发布,最多可处理100 万行(最多 200 个特征)。它还通过付费 API 增加了“思考模式(Thinking mode)”,在拟合阶段花更多时间以获得更好预测。
最新版本 TabPFN-3.5 于 2026 年 9 月发布,其技术报告宣称在多个重要基准上名列前茅,包括时间有序与分组数据。我建议在其他方验证前,将其视作公司自报数据。
另一个要点是许可。TabPFN-2 可在注明来源的前提下商用,但 2.5 到 3.5 版本为非商业许可。意味着您可免费试验,但用于真实产品需购买付费许可。
TabICLv2 目前是最佳的完全开源表格基础模型。它由 Inria 开发,2026 年 2 月发布,并被 ICML 2026 接收。
TabICLv2 论文的核心结果是:在不做任何调参的情况下,它击败了上一代最佳模型 RealTabPFN-2.5,尽管后者做了调参、集成,并在真实数据上进行了微调。
根据其GitHub 仓库,在 TabArena 基准中,它还在约 80% 的数据集上优于重度调参的 XGBoost、CatBoost 与 LightGBM。
它也很快:在 H100 GPU 上,5 万行、100 个特征可在 10 秒内处理完,比 TabPFN-2.5 快约 10 倍。
最佳适用范围是 300 到 100,000 行,可在精度有所损失的情况下扩展到约 50 万行。
在我看来,这是大多数读者的首选起点。
它可通过 pip install tabicl 安装,使用方式与任何 scikit-learn 模型一致,且其宽松许可允许商业使用,无需注册。不过榜单变化很快,TabPFN-3.5 的报告现已将其自身排名在 TabICLv2 之上。
TabFM 是 Google Research 的表格基础模型,2026 年 6 月 30 日发布。它的不同点在于使用场景:它已内置于 Google 的云数据仓库 BigQuery,您可以用纯 SQL 直接获取预测。
-- Use past customers (with known churn) to predict churn for new customers
-- AI.PREDICT is in preview, so check the BigQuery docs for the latest syntax
SELECT *
FROM AI.PREDICT(
  TABLE my_dataset.customers_history,
  TABLE my_dataset.customers_new,
  label_col => 'churned'
);
这对熟悉 SQL 而不熟悉 Python 的人来说非常友好。
不过,BigQuery 文档目前将特征列限制为 20 个、类别数限制为 10 个,且 Google 计划自 2026 年 10 月 30 日起在标准 BigQuery 计费之外另加基于 token 的定价。发布在 Hugging Face 上的模型权重为非商业用途,因此商业使用需通过 BigQuery。
NEXUS 是 Fundamental 推出的封闭、仅面向企业的模型,这家位于旧金山的初创公司由前 DeepMind 研究人员创立。该模型于 2026 年 2 月发布,并获 2.55 亿美元融资,公司称其为大型表格模型(LTM)。
企业可通过 AWS 购买并运行 NEXUS。Fundamental 称财富 100 强公司已将其用于需求预测、定价与客户流失分析。不过,目前尚无公开的模型权重或基准结果可供自行核验,因此我倾向于将其视为企业级选项。
tabH2O 是 H2O.ai 的模型,其核心理念很简单:发送您的数据,返回预测结果。
它会替您处理缺失值与类别列,并可部署在企业自有服务器上,这对无法将数据上传云端的银行与医院而言十分重要。
我欣赏的一点是,tabH2O 论文对其能力并未夸大。它在 TALENT 基准上击败了调参后的 CatBoost 与 LightGBM,但仍落后于 TabICLv2。
| 模型 | 创建方 | 开放权重? | 最大规模 | 许可 | 最佳适用 |
|---|---|---|---|---|---|
| TabPFN-2 | Prior Labs | 是 | 10K 行 | 注明来源即可商用 | 成熟旧版模型的商业使用 |
| TabPFN-3 / 3.5 | Prior Labs(SAP) | 是,需接受许可 | 最高 100 万行 | 非商业,企业用付费 API | 顶级精度与研究 |
| TabICLv2 | Inria | 是 | 最佳至 100K 行 | 宽松开源 | 您的默认起点 |
| TabFM | Google Research | 是 | BigQuery 中 20 个特征 | 非商业权重 | BigQuery 上的 SQL 用户 |
| NEXUS | Fundamental | 否 | 未披露 | 专有 | AWS 上的大型企业 |
| tabH2O | H2O.ai | 否 | 未披露 | 商业 API | 无 ML 基础设施的团队、AI 代理 |
在 Python 中使用表格基础模型的方式与使用其他任何 scikit-learn 模型完全相同。
最好的方式是把它和 XGBoost 正面比一比,所以我们用 scikit-learn 内置的乳腺癌数据集来试验。
首先,安装依赖包:
pip install tabicl xgboost scikit-learn然后在相同切分上运行两个模型:
from sklearn.datasets import load_breast_cancer
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from tabicl import TabICLClassifier
from xgboost import XGBClassifier

# Load a small tabular dataset as a pandas DataFrame
X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# Tabular foundation model: fit() just stores the training rows
tfm = TabICLClassifier()
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)

# XGBoost baseline with reasonable, untuned settings
xgb = XGBClassifier(n_estimators=300, learning_rate=0.05, max_depth=4)
xgb.fit(X_train, y_train)
xgb_preds = xgb.predict(X_test)

print(f"TabICL accuracy:  {accuracy_score(y_test, tfm_preds):.3f}")
print(f"XGBoost accuracy: {accuracy_score(y_test, xgb_preds):.3f}")
这样的小数据集在普通笔记本 CPU 上也能顺畅运行。
在这样干净的数据上,两者的分数都会很高,所以请不要只凭一次切分就下结论。真正的考验是您自己凌乱的数据。
如果您想改用 TabPFN,运行 pip install tabpfn,然后只需改两行:
from tabpfn import TabPFNClassifier

tfm = TabPFNClassifier()  # The first run asks you to accept the license
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)
在您用真实数据比较模型之前,有一件重要的事。
如果数据带有日期,请按时间而非随机切分。否则模型就能偷看“未来”,正如下一节将看到的,这恰恰会让表格基础模型看起来比实际更好。
当数据集小到中等、且测试行与训练行相似时,表格基础模型表现良好。它们在时间有序数据、分组数据、超大表格以及严格可解释性需求上会吃力。
“测试行与训练行相似”有个名字,IID(独立同分布)。这是您需要检查的数据属性中最重要的一点。
先看它们的强项:
下面是局限之处:如果计划在真实项目中使用,我认为它们更重要。
2026 年 6 月发布的BeyondArena 基准在 142 个数据集上测试了 11 个模型,包括按时间切分(用过去预测未来)与按组切分(为新医院或国家预测)的数据。
结果显示,表格基础模型在小与中等规模的 IID 数据上效果最佳;而在时间有序、分组、超大与超宽数据上,基于树与其他深度学习模型依然领先。由于大多数业务数据(销售、欺诈、流失)都按时间演进,这一限制往往会在真实项目中显现。
BeyondArena 之后发布的 TabPFN-3.5 明确宣称已在时间有序与分组数据上缩小差距。这令人期待,但尚未得到独立测试。
您可以从 TabICL 与 TabPFN 获取 SHAP 值,但耗时远多于树模型的 SHAP,且没有可供检查的树分裂。在信贷评分等领域,监管方需要理解模型,这会成为实际障碍。
一旦超过几千行,基本就需要 GPU,且随着训练数据增长,预测会变慢。CPU 上已训练好的 XGBoost 在速度上几乎总能胜出。
TabPFN-2 需注明来源即可商用;更新的 TabPFN 版本为非商业;TabFM 权重为非商业;TabICLv2 则是宽松许可。
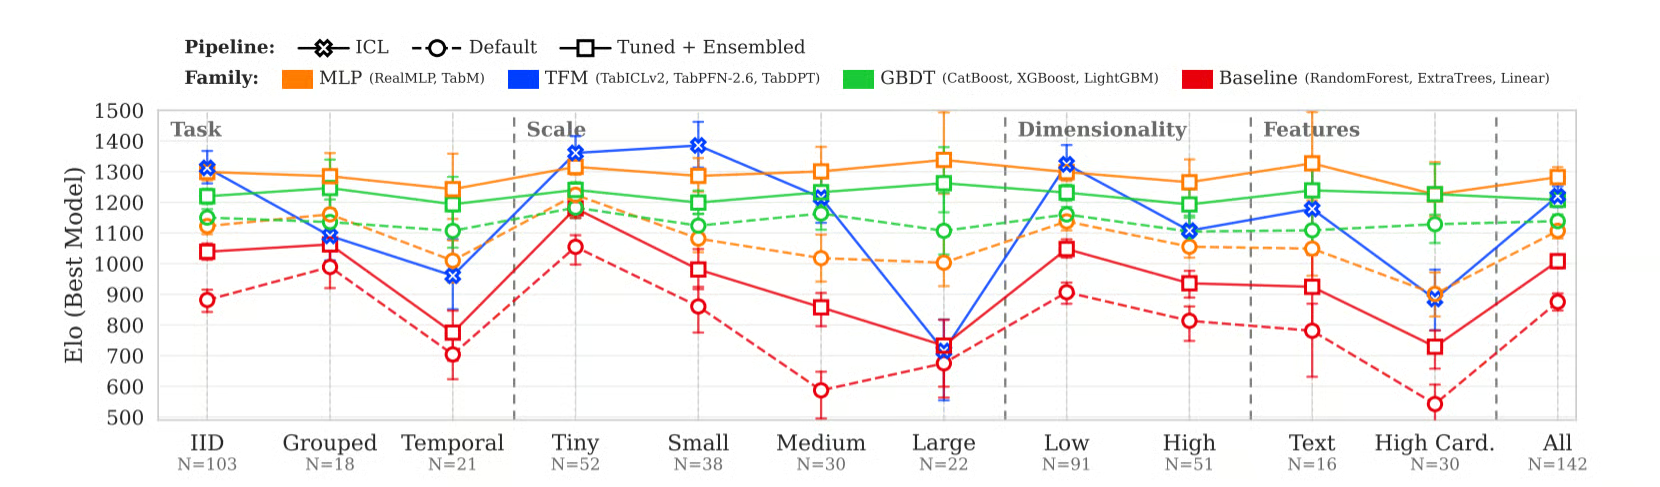
图 3:按模型家族的 Elo(越高越好)。表格基础模型在小型 IID 数据上领先,但在时序与大型数据集上出现下滑,而树与 MLP 更稳定。蓝色代表 TabICLv2、TabPFN-2.6 与 TabDPT 的最佳结果,并非最新 TabPFN 版本。来源:Purucker 等,《Beyond IID: How General Are Tabular Foundation Models, Really?》(2026),CC BY 4.0。
希望您也认同:表格基础模型已经显著抬高了“零门槛基线”的水平,但在大量真实情境中,树模型依然是更好的选择。
当您的数据集小到中等且为 IID,并且不需要完全可解释的模型或在 CPU 上极快的预测时,您应该考虑使用表格基础模型。以下是我会采用的决策表:
| 场景 | 推荐方法 |
|---|---|
| 少于 1 万行、IID、无可解释性要求 | 从 TabICLv2 或 TabPFN 开始 |
| 1 万到 10 万行、IID | 测试 TabICLv2 与 XGBoost,保留优者 |
| 10 万到 100 万行 | 先用 XGBoost 或 LightGBM,再用 TabPFN-3 作为挑战者 |
| 按时间或按组切分的数据 | 从树模型开始 |
| 需要 SHAP、特征重要性或审计 | 配合 SHAP 的树模型 |
| 无需 GPU 的快速预测 | 树模型 |
| 快速概念验证、无需 ML 基础设施 | TabICLv2,或若数据已在 BigQuery 上则用 AI.PREDICT |
| AI 代理需要从表格中获得预测 | tabH2O 或 NEXUS 这类 API |
在选型之前,我建议先问自己三个问题:
最后一点建议是:先跑一个表格基础模型,因为这只需几分钟。如果它在您的数据上无法胜过 XGBoost,那么您就知道值得把时间投入到特征工程与 XGBoost 调参上。
还记得文章开头的两位学生吗?到了 2026 年,第二位——那个做过上百万份试卷的学生——终于能在小到中等表格上击败那个苦读数周的学生。
表格基础模型用预训练取代了“按数据集逐一训练”,并用“示例学习”取代了传统的 fit()。
最让我惊讶的是这一领域进步之快。2025 年,TabPFN-2 首次证明在小型表上神经网络可以战胜调参后的树模型;此后,TabICLv2 与 TabPFN-3 又把边界推进到了更大的数据集。
现在的开放问题是时间有序数据、数据分布漂移、可解释性与许可,而这些恰恰决定了模型能否进入真实产品。
所以我的建议是:把这些模型当作新的起点,然后根据您的数据、约束条件,以及模型的运行环境来选择最终方案。
如果您想精通仍在许多真实场景中获胜的树模型,欢迎学习我们的 Machine Learning with Tree-Based Models in Python 课程和 Supervised Machine Learning in Python 学习路径。若您使用 R,可参考 Machine Learning with Tree-Based Models in R,内容相同。
热门 DataCamp 课程
学习路径
课程
学习路径