Ścieżka
Tworzenie dużych modeli językowych
16 godz.
Wyobraź sobie dwóch uczniów piszących ten sam egzamin. Pierwszy przez trzy tygodnie uczy się tylko jednego modułu, a drugi ma już przećwiczone miliony różnych egzaminów i w dniu testu dostaje kartkę z rozwiązanymi przykładami.
Przez większość historii uczenia maszynowego modele tabelaryczne były jak ten pierwszy uczeń. Każdy nowy zbiór danych oznaczał czyszczenie kolumn, inżynierię cech, trenowanie XGBoosta lub LightGBM oraz godzinny tuning hiperparametrów.
Tabularne modele bazowe są natomiast jak ten drugi: podajesz im oznakowane wiersze jako przykłady, a one przewidują resztę bez żadnego trenowania.
W 2026 r. ten pomysł przeszedł z artykułów naukowych do realnych produktów: SAP przeznaczył ponad 1 mld € na Prior Labs, a Google wypuścił własny model. W tym artykule omówimy więc:
Nie martw się, jeśli nie masz dużego doświadczenia z deep learningiem. Kod w tym artykule używa znajomego interfejsu scikit-learn, a jeśli chcesz szybkie odświeżenie, 8 modeli uczenia maszynowego wyjaśnionych w 20 minut pokrywa podstawy.
pip install tabicl.Tabularny model bazowy to sieć neuronowa wstępnie wytrenowana na milionach syntetycznych zbiorów tabelarycznych, która uczy się ogólnej strategii przewidywania kolumny docelowej, a następnie stosuje ją do nowej tabeli poprzez uczenie w kontekście, bez trenowania dla konkretnego zbioru.
Duża zmiana dotyczy tego, kiedy zachodzi uczenie.
W XGBooscie uczenie odbywa się na twoich danych za każdym razem, gdy trenujesz nowy model. W przypadku modelu bazowego dla tabel uczenie miało miejsce miesiące temu podczas pretrenowania, a twoje dane są po prostu wejściem. Pojawi się też kilka terminów, które będziesz często widzieć, więc wyjaśnię je prostym językiem:
Teraz porównajmy je z metodami boostingu oraz automatycznego uczenia maszynowego (AutoML):
| Tabularne modele bazowe | Drzewa gradientowe (XGBoost, LightGBM) | AutoML (AutoGluon, H2O AutoML) | |
|---|---|---|---|
| Czas trenowania na nowych danych | Brak | Sekundy do minut, plus tuning | Minuty do godzin |
| Interpretowalność | Ograniczona (SHAP możliwy, ale wolny) | Dobra (ważność cech, szybki SHAP) | Różna, często trudne do interpretacji zespoły |
| Najlepszy rozmiar zbioru | Setki do ok. 100 tys. wierszy | Tysiące do wielu milionów wierszy | Tysiące do milionów wierszy |
| Potrzebny GPU? | Zalecany powyżej kilku tysięcy wierszy | Nie | Zwykle nie |
| Małe zbiory z losowym podziałem | Najlepsze w obecnych benchmarkach | Mocne po tuningu | Mocne, ale wolne |
Zanim jednak przejdziemy do działania, szybko porównajmy je z najsłynniejszymi, najczęściej używanymi modelami: dużymi modelami językowymi.
Duże modele językowe (LLM) i tabularne modele bazowe korzystają z transformerów i oba uczą się na przykładach przekazanych na wejściu.
Różni je to, do czego są zbudowane. LLM czyta tabelę jako długi ciąg tekstu, więc musi z przecinków i spacji wywnioskować, które liczby należą do tej samej kolumny.
Jest też problem znaczenia.
Wartość 42 może oznaczać czyjś wiek albo przychód — sama liczba tego nie zdradza. Tabularny model bazowy jest trenowany tak, by traktować każdą kolumnę jako osobną zmienną, a każdy wiersz jako jeden przykład, dzięki czemu skupia się na relacjach między kolumnami.
Lubię myśleć o tym tak: LLM świetnie „opowiada” o twoich danych, a tabularny model bazowy jest zbudowany, by „policzyć” to, co trzeba.
Oba mogą też współpracować — dokładnie tak pozycjonuje swój model tabH2O firma H2O.ai: jako narzędzie predykcyjne, które agent AI wywołuje, gdy potrzebuje liczby z arkusza kalkulacyjnego.
Dane tabelaryczne były trudne dla deep learningu, bo tabele nie mają wspólnej struktury, której sieć neuronowa mogłaby się raz nauczyć i wielokrotnie używać. Piksel to piksel w każdym zdjęciu. Kolumna o nazwie score w zbiorze finansowym i kolumna score w zbiorze piłkarskim nie mają ze sobą nic wspólnego.
Szeroko cytowana praca z 2022 r. autorstwa Léo Grinsztajna, Edouarda Oyallona i Gaëla Varoquaux Why do tree-based models still outperform deep learning on tabular data? przetestowała to na 45 zbiorach danych i wykazała, że modele drzewiaste, zwłaszcza gradient boosting, nadal przewyższają deep learning na średnich tabelach ok. 10 tys. wierszy. Powody były następujące:
Dwa praktyczne problemy pogłębiają sytuację: pojedyncza tabela może mieszać liczby, kategorie, rangi i braki danych, a większość tabel biznesowych ma tylko setki lub tysiące wierszy — zdecydowanie za mało dla sieci trenowanej od zera.
Uważałbym, że małe zbiory danych to najważniejszy problem. Sieć uczona od zera na 800 wierszach nie ma się na czym oprzeć, podczas gdy drzewo nie potrzebuje żadnej wiedzy wstępnej, by działać.
Właśnie to naprawiło pretrenowanie. Tabularny model bazowy ma już przećwiczone miliony małych, chaotycznych, wymyślonych tabel, zanim zobaczy twoją, więc nie startuje od zera.
Tabularny model bazowy bierze twoje oznakowane wiersze treningowe i nieoznakowane wiersze testowe razem jako jedno wejście i przewiduje brakujące etykiety w pojedynczym przejściu w przód. Jego wagi się nie zmieniają — tak jak LLM odpowiadający na pytanie po podaniu kilku przykładów w promptcie.
To zmienia też znaczenie znajomych metod scikit-learn.
Gdy wywołujesz .fit() na TabICL, dokumentacja TabICL wyjaśnia, że ładuje on wstępnie wytrenowany checkpoint, przetwarza twoje dane i je zapisuje. Prawdziwa praca dzieje się podczas .predict().
Nazwa .fit() zostaje, aby model pasował do twojego istniejącego kodu scikit-learn.
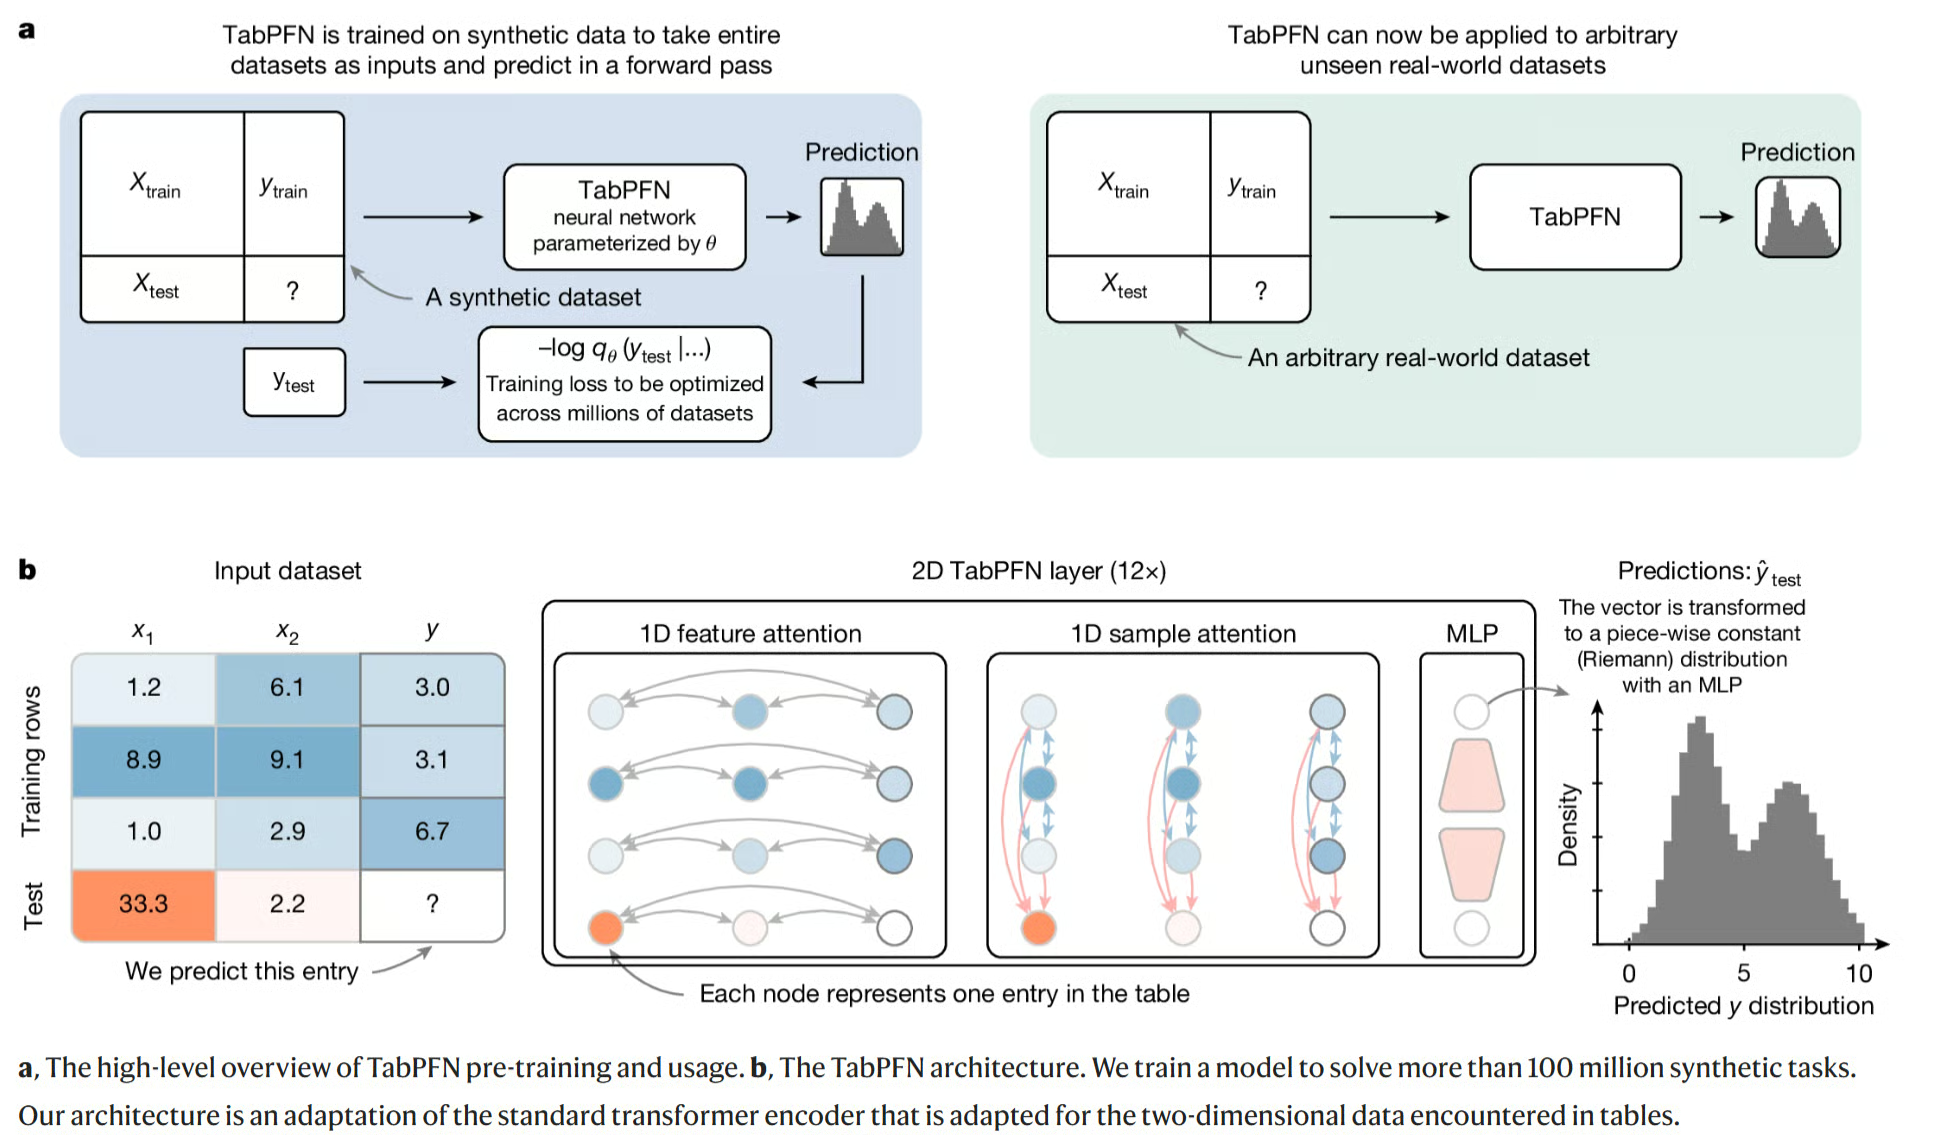
Rysunek 1: TabPFN jest wstępnie trenowany na milionach syntetycznych zbiorów danych, a następnie przewiduje na prawdziwej tabeli w jednym przejściu w przód. Dolny panel pokazuje, jak zwraca uwagę na cechy i próbki. Źródło: Hollmann i in., „Accurate predictions on small data with a tabular foundation model”, Nature (2025).
Syntetyczne pretrenowanie oznacza trenowanie modelu na wymyślonych tabelach zamiast na prawdziwych, tworzonych przez generator danych działający jak model generatywny.
Pomyśl o pilocie szkolącym się w symulatorze. Ćwiczy tysiące fikcyjnych lotów z różną pogodą, lotniskami i usterkami, dzięki czemu pierwszy prawdziwy lot nie jest dla niego nowością.
TabPFN działa podobnie.
Jego twórcy napisali generator, który wymyśla losowe reguły „przyczyna–skutek” między kolumnami (np. kolumna A wpływa na kolumnę B, która wpływa na cel), a następnie generuje wiersze z tych reguł.
Podczas pretrenowania kolumna docelowa jest ukryta, model próbuje ją przewidzieć i powtarza to miliony razy z różnymi regułami, poziomami szumu i rozmiarami tabel.
Ważne jest to, że model nie uczy się faktów o żadnym prawdziwym temacie. Uczy się ogólnych umiejętności, takich jak wyłapywanie istotnych kolumn, radzenie sobie z wartościami odstającymi i rozpoznawanie, kiedy jest niepewny.
W rzeczy samej, artykuł TabICLv2 wskazuje nowy generator danych syntetycznych jako kluczowy powód lepszej jakości.
Nie musisz znać wszystkich detali architektur, ale warto wiedzieć, że są dwa główne podejścia:
Zauważ, że obie rodziny trenowane są na danych syntetycznych, więc „prior-fitted network” opisuje sposób trenowania, a nie osobny typ modelu.
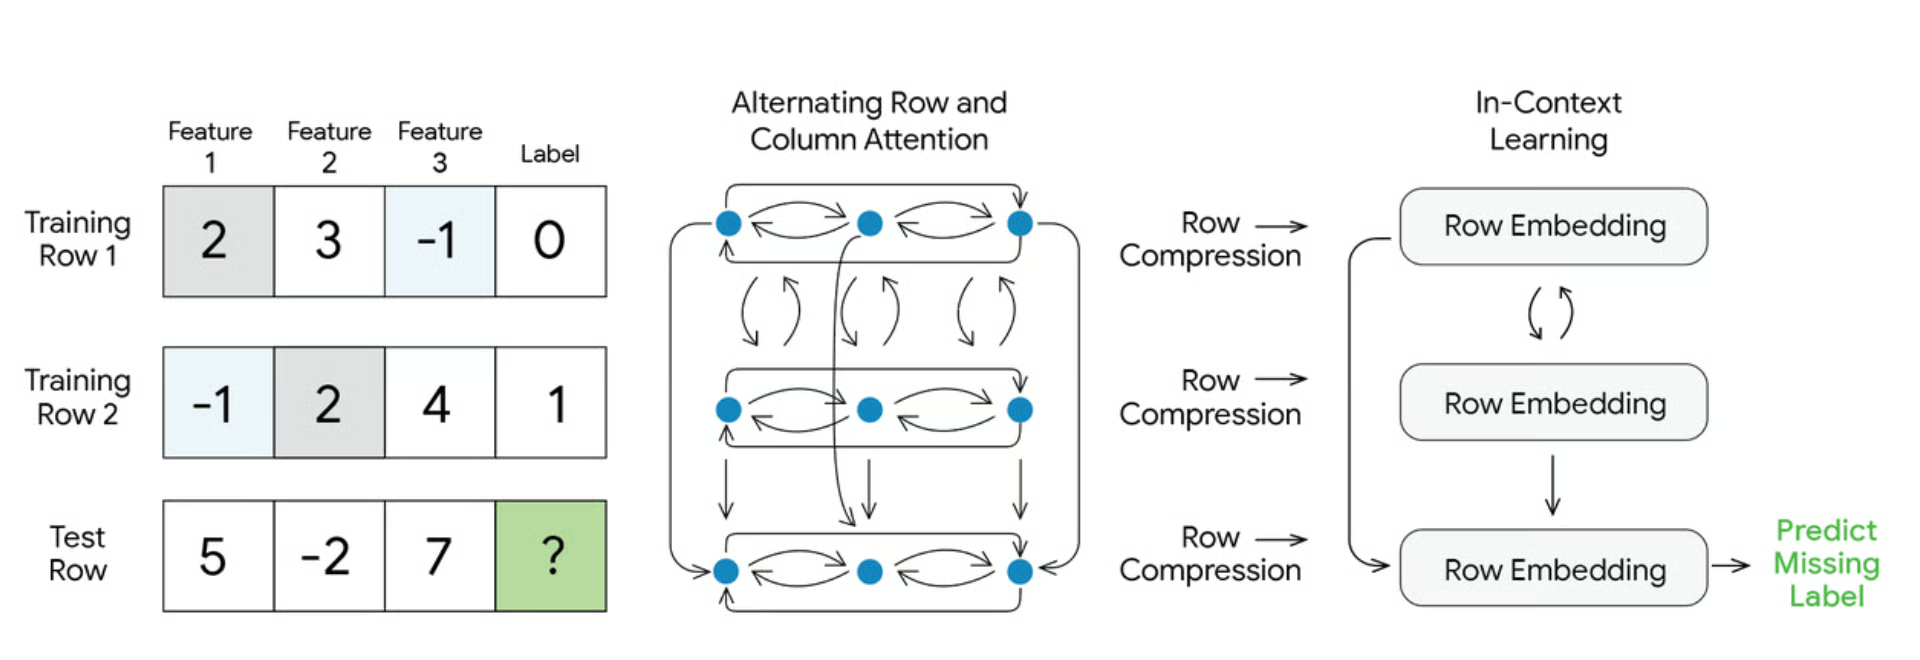
Rysunek 2: TabFM łączy oba podejścia: uwaga w stylu TabPFN po wierszach i kolumnach, potem kompresja wierszy w stylu TabICL, a następnie uczenie w kontekście dla brakującej etykiety. Źródło: Google Research, „Introducing TabFM: A zero-shot foundation model for tabular data” (2026).
Jest tu kompromis, który wielu zaskakuje.
XGBoost poświęca czas na jednorazowe trenowanie, a potem przewiduje niemal natychmiast.
Tabularny model bazowy pomija trenowanie, ale musi czytać wszystkie twoje wiersze treningowe za każdym razem, gdy przewiduje.
Pomyśl o kucharzu, który nie robi żadnego prepworku przed serwisem, ale do każdego zamówienia musi od nowa przekartkować całą książkę kucharską.
Przy cienkiej książce to w porządku, ale gdy zbiór rośnie, predykcje zwalniają. Zarówno TabICL, jak i TabPFN mogą cache’ować swoje „czytanie” danych treningowych, by przyspieszyć powtarzane predykcje, ale pierwszy przebieg i tak kosztuje czas.
Kluczowe tabularne modele bazowe w 2026 r. to TabPFN, TabICLv2, TabFM Google'a, NEXUS od Fundamental i tabH2O od H2O.ai. Co ciekawe, biznes ruszył bardzo szybko: pięć miesięcy przeniosło ten obszar z prac naukowych do dużych umów. Oto krótka oś czasu:
Przejdźmy teraz przez każdy z nich, zaczynając od modelu, który wszystko rozpoczął.
TabPFN to model, który stworzył tę kategorię. TabPFN-2 ukazał się w Nature w styczniu 2025 r. i pokonał tuningowane modele drzewiaste na zbiorach do 10 000 wierszy.
Od tego czasu Prior Labs szybko wydaje nowe wersje. TabPFN-3 pojawił się w maju 2026 r. i obsługuje do 1 miliona wierszy (i do 200 cech). Dodał też tryb „Thinking” (w płatnym API), który poświęca więcej czasu na etapie fit, by poprawić predykcje.
Najnowsza wersja, TabPFN-3.5, ukazała się we wrześniu 2026 r., a jej raport techniczny rości sobie pierwsze miejsca na kilku głównych benchmarkach, także na danych uporządkowanych w czasie i pogrupowanych. Traktowałbym to jako dane firmy do czasu niezależnych potwierdzeń.
Ważna jest też licencja. TabPFN-2 można używać komercyjnie pod warunkiem wskazania Prior Labs, ale wersje 2.5–3.5 są niekomercyjne. To znaczy, że możesz je bezpłatnie testować, ale użycie w produkcie wymaga płatnej licencji.
TabICLv2 to obecnie najlepszy w pełni otwarty tabularny model bazowy. Powstał w Inria, wydany w lutym 2026 r., przyjęty na ICML 2026.
Kluczowy wynik z artykułu TabICLv2 jest taki, że bez jakiegokolwiek tuningu pokonał RealTabPFN-2.5, poprzedni najlepszy model, mimo że tamten był strojony, ensemblowany i dostrajany na prawdziwych danych.
Według repozytorium na GitHubie pokonuje też mocno tuningowane XGBoost, CatBoost i LightGBM na ok. 80% zbiorów w benchmarku TabArena.
Jest też szybki — obsługuje 50 000 wierszy i 100 cech w mniej niż 10 sekund na GPU H100, czyli ok. 10 razy szybciej niż TabPFN-2.5.
Najlepiej działa między 300 a 100 000 wierszy i może rozciągnąć się do ok. 500 000 wierszy kosztem części dokładności.
Moim zdaniem większość czytelników powinna zacząć właśnie od niego.
Instalujesz go przez pip install tabicl, działa jak każdy model scikit-learn, a liberalna licencja pozwala używać go komercyjnie bez rejestracji. Ranking szybko się zmienia, a raport TabPFN-3.5 obecnie klasyfikuje siebie wyżej niż TabICLv2.
TabFM to tabularny model bazowy Google Research, udostępniony 30 czerwca 2026 r. Wyróżnia go to, gdzie możesz go używać: jest wbudowany w BigQuery, hurtownię danych Google, więc predykcje dostaniesz zwykłym SQL-em.
-- Use past customers (with known churn) to predict churn for new customers
-- AI.PREDICT is in preview, so check the BigQuery docs for the latest syntax
SELECT *
FROM AI.PREDICT(
  TABLE my_dataset.customers_history,
  TABLE my_dataset.customers_new,
  label_col => 'churned'
);
To świetne dla osób, które znają SQL, ale nie Python.
Jednak dokumentacja BigQuery obecnie ogranicza cię do 20 kolumn cech i 10 klas, a Google planuje dodać rozliczanie tokenowe ponad standardowe opłaty BigQuery od 30 października 2026 r. Wagi modelu na Hugging Face są niekomercyjne, więc użycie komercyjne odbywa się przez BigQuery.
NEXUS to zamknięty, biznesowy model firmy Fundamental, startupu z San Francisco założonego przez byłych badaczy DeepMind. Zadebiutował w lutym 2026 r. z finansowaniem 255 mln USD, a firma nazywa go Large Tabular Model (LTM).
Firmy kupują i uruchamiają NEXUS przez AWS, a Fundamental twierdzi, że używają go już spółki z listy Fortune 100 do prognoz popytu, cen i churnu klientów. Nie ma jednak publicznych wag ani benchmarków do samodzielnej weryfikacji, więc traktowałbym go jako opcję korporacyjną.
tabH2O to model H2O.ai, a jego idea jest prosta: wyślij dane, odbierz predykcje.
Sam radzi sobie z brakami i kategoriami i może działać na serwerach firmy, co ma znaczenie dla banków i szpitali, które nie mogą wysyłać danych do chmury.
Podoba mi się, że artykuł o tabH2O nie przesadza w obietnicach. Pokonał tuningowane CatBoost i LightGBM na benchmarku TALENT, ale wciąż był za TabICLv2.
| Model | Twórca | Otwarte wagi? | Maks. skala | Licencja | Najlepsze do |
|---|---|---|---|---|---|
| TabPFN-2 | Prior Labs | Tak | 10 tys. wierszy | Komercyjna z atrybucją | Komercyjne użycie sprawdzonego starszego modelu |
| TabPFN-3 / 3.5 | Prior Labs (SAP) | Tak, po akceptacji licencji | Do 1 mln wierszy | Niekomercyjna, płatne API dla biznesu | Topowa dokładność i badania |
| TabICLv2 | Inria | Tak | Najlepszy do 100 tys. wierszy | Liberalna open source | Twój domyślny punkt startowy |
| TabFM | Google Research | Tak | 20 cech w BigQuery | Niekomercyjne wagi | Użytkownicy SQL w BigQuery |
| NEXUS | Fundamental | Nie | Nie ujawniono | Własnościowa | Duże firmy na AWS |
| tabH2O | H2O.ai | Nie | Nie ujawniono | Komercyjne API | Zespoły bez infrastruktury ML, agenci AI |
Używasz tabularnego modelu bazowego w Pythonie dokładnie tak jak każdego innego modelu scikit-learn.
Najlepiej porównać go łeb w łeb z XGBoostem, więc zróbmy to na wbudowanym zbiorze scikit-learn dotyczącym raka piersi.
Najpierw instalujemy paczki:
pip install tabicl xgboost scikit-learnPotem uruchamiamy oba modele na tym samym podziale:
from sklearn.datasets import load_breast_cancer
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from tabicl import TabICLClassifier
from xgboost import XGBClassifier

# Load a small tabular dataset as a pandas DataFrame
X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# Tabular foundation model: fit() just stores the training rows
tfm = TabICLClassifier()
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)

# XGBoost baseline with reasonable, untuned settings
xgb = XGBClassifier(n_estimators=300, learning_rate=0.05, max_depth=4)
xgb.fit(X_train, y_train)
xgb_preds = xgb.predict(X_test)

print(f"TabICL accuracy:  {accuracy_score(y_test, tfm_preds):.3f}")
print(f"XGBoost accuracy: {accuracy_score(y_test, xgb_preds):.3f}")
Ten mały zbiór zadziała bez problemu na zwykłym laptopie z CPU.
Oba modele uzyskają tu bardzo wysokie wyniki, więc nie oceniaj ich po jednym podziale. Prawdziwy test to twoje własne, nieidealne dane.
Jeśli chcesz zamiast tego spróbować TabPFN, uruchom pip install tabpfn, a potem to tylko dwie linijki zmiany:
from tabpfn import TabPFNClassifier

tfm = TabPFNClassifier()  # The first run asks you to accept the license
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)
Jedna ważna rzecz, zanim porównasz modele na prawdziwych danych.
Jeśli masz daty, dziel po czasie zamiast losowo. W przeciwnym razie model podgląda przyszłość — a jak zobaczysz w następnej sekcji, właśnie tam tabularne modele bazowe wypadają lepiej, niż powinny.
Tabularne modele bazowe działają dobrze, gdy zbiór jest mały lub średni, a wiersze testowe przypominają wiersze treningowe. Mają trudności z danymi uporządkowanymi w czasie, pogrupowanymi, bardzo dużymi tabelami oraz gdy potrzebna jest ścisła wyjaśnialność.
To „wiersze testowe przypominają treningowe” ma nazwę IID (niezależne i jednakowo rozkładalne) i jest najważniejszą rzeczą do sprawdzenia w twoich danych.
Zacznijmy od tego, gdzie sprawdzają się dobrze:
Teraz ograniczenia — moim zdaniem ważniejsze, jeśli planujesz użycie w realnym projekcie.
Benchmark BeyondArena, wydany w czerwcu 2026 r., przetestował 11 modeli na 142 zbiorach, w tym dzielonych po czasie (przewidywanie przyszłości z przeszłości) i po grupach (przewidywanie dla nowego szpitala czy kraju).
Wynik: tabularne modele bazowe są najlepsze na małych i średnich danych IID, podczas gdy modele drzewiaste i inne sieci nadal prowadzą na danych czasowych, pogrupowanych, dużych i bardzo szerokich. Ponieważ większość danych biznesowych (sprzedaż, fraud, churn) jest uporządkowana w czasie, ograniczenie to pojawia się w wielu realnych projektach.
TabPFN-3.5, wydany po BeyondArena, wprost twierdzi, że domyka tę lukę na danych czasowych i grupowych. To obiecujące, ale jeszcze nie niezależnie potwierdzone.
Możesz uzyskać wartości SHAP zarówno z TabICL, jak i TabPFN, ale trwa to znacznie dłużej niż SHAP dla modelu drzewiastego, a nie ma tu też podziałów drzew do inspekcji. W obszarach takich jak scoring kredytowy, gdzie regulator musi rozumieć model, to realny problem.
Wszystko powyżej kilku tysięcy wierszy naprawdę chce GPU, a predykcje zwalniają wraz ze wzrostem danych treningowych. Wytrenowany XGBoost na CPU zawsze wygra szybkością.
TabPFN-2 jest komercyjny z atrybucją, nowsze TabPFN są niekomercyjne, wagi TabFM są niekomercyjne, a TabICLv2 ma liberalną licencję.
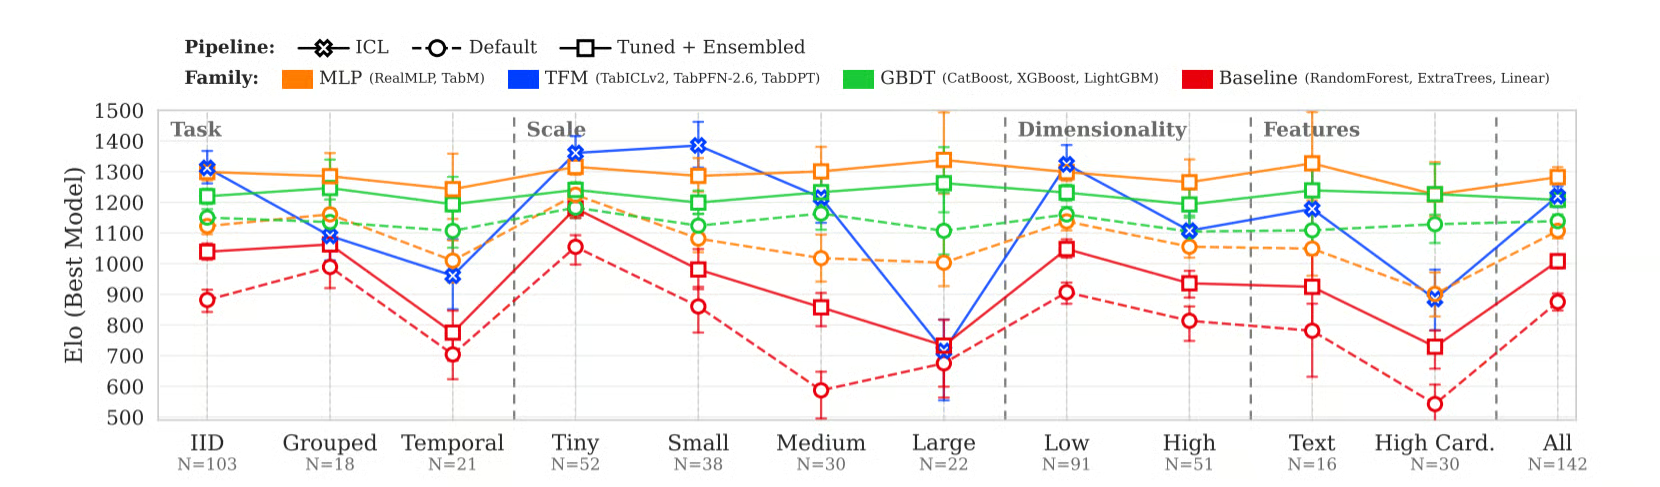
Rysunek 3: Elo według rodziny modeli (wyżej = lepiej). Tabularne modele bazowe prowadzą na małych danych IID, ale spadają na zbiorach czasowych i dużych, gdzie lepiej trzymają się drzewa i MLP. Niebieski to najlepsze z TabICLv2, TabPFN-2.6 i TabDPT, a nie najnowsze wersje TabPFN. Źródło: Purucker i in., „Beyond IID: How General Are Tabular Foundation Models, Really?” (2026), CC BY 4.0.
Mam nadzieję, że zgodzisz się, iż tabularne modele bazowe podniosły poprzeczkę dla jakości szybkiej, bezwysiłkowej bazy, ale modele drzewiaste wciąż są lepszym wyborem w wielu realnych sytuacjach.
Powinieneś użyć tabularnego modelu bazowego, gdy twój zbiór jest mały lub średni i IID, a nie potrzebujesz w pełni wyjaśnialnego modelu ani bardzo szybkich predykcji na CPU. Oto tabela decyzji, której bym użył:
| Scenariusz | Zalecane podejście |
|---|---|
| Poniżej 10 tys. wierszy, IID, brak potrzeb wyjaśnialności | Zacznij od TabICLv2 lub TabPFN |
| 10 tys. do 100 tys. wierszy, IID | Przetestuj TabICLv2 i XGBoost, zostaw zwycięzcę |
| 100 tys. do 1 mln wierszy | Zacznij od XGBoost lub LightGBM, spróbuj TabPFN-3 jako pretendenta |
| Dane dzielone po czasie lub po grupach | Zacznij od modeli drzewiastych |
| Potrzebujesz SHAP, ważności cech lub audytu | Model drzewiasty z SHAP |
| Szybkie predykcje bez GPU | Model drzewiasty |
| Szybki proof of concept, bez setupu ML | TabICLv2 lub BigQuery AI.PREDICT, jeśli twoje dane już tam są |
| Agent AI potrzebujący predykcji z tabel | API takie jak tabH2O lub NEXUS |
Przed wyborem modelu polecam zadać te trzy pytania:
I ostatnia myśl: uruchom najpierw tabularny model bazowy, bo to kosztuje cię tylko kilka minut. Jeśli nie pokona XGBoosta na twoich danych, wiesz już, że warto poświęcić czas na inżynierię cech i tuning XGBoosta.
Pamiętasz dwóch uczniów z początku? W 2026 r. ten drugi, który ćwiczył na milionach egzaminów, wreszcie potrafi pokonać tego, który uczył się tygodniami — przynajmniej na małych i średnich tabelach.
Tabularne modele bazowe zastępują trenowanie per zbiór pretrenowaniem, a fit() — uczeniem się na przykładach.
Najbardziej zaskakuje mnie tempo postępu. TabPFN-2 w 2025 r. pokazał, że sieć neuronowa może pokonać tuningowane drzewa na małych tabelach, a TabICLv2 i TabPFN-3 przesunęły to na dużo większe.
Otwarte problemy to teraz dane uporządkowane w czasie, zmieniające się dane, wyjaśnialność i licencjonowanie — czyli dokładnie te kwestie, które decydują, czy model trafi do prawdziwego produktu.
Moja rada: traktuj te modele jako nowy punkt startowy i wybierz końcowe narzędzie na podstawie twoich danych, ograniczeń i miejsca uruchomienia.
A jeśli chcesz opanować modele drzewiaste, które wciąż wygrywają w wielu realnych sytuacjach, sprawdź nasz kurs Machine Learning with Tree-Based Models in Python oraz ścieżkę Supervised Machine Learning in Python. Jeśli pracujesz w R, Machine Learning with Tree-Based Models in R omawia te same zagadnienia.
Najlepsze kursy DataCamp
Ścieżka
Kurs
Ścieżka