Program
Büyük Dil Modelleri Geliştirme
16 sa
Aynı sınava giren iki öğrenciyi hayal edin. İlk öğrenci üç hafta boyunca sadece bir modüle çalışır, ikinci öğrenci ise daha önce milyonlarca farklı sınavda pratik yapmıştır ve sınav günü eline yalnızca çözümlü örneklerin olduğu bir kağıt verilir.
Makine öğreniminin büyük kısmı boyunca, tablolu modeller ilk öğrenci gibiydi. Her yeni veri kümesi; sütunları temizlemek, özellik mühendisliği yapmak, XGBoost veya LightGBM’i eğitmek ve hiperparametreleri saatlerce ayarlamak demekti.
Tablolu temel modeller ise ikinci öğrenci gibidir: Etiketli satırlarınızı onlara örnek olarak verirsiniz ve onlar da geri kalanını hiç eğitim gerektirmeden tahmin eder.
2026’da bu fikir araştırma makalelerinden gerçek ürünlere geçti; SAP Prior Labs’a 1 milyar €’dan fazla kaynak ayırdı ve Google kendi modelini yayınladı. Bu yazıda şunlara bakacağız:
Derin öğrenme deneyiminiz azsa endişelenmeyin. Bu yazıdaki kod alışıldık scikit-learn arayüzünü kullanır; önce hızlı bir tazelemeye ihtiyacınız varsa, 20 Dakikada 8 Makine Öğrenimi Modeli temelleri kapsar.
pip install tabicl ile kuruluyor.Tablolu temel model, milyonlarca sentetik tablolu veri kümesinde önceden eğitilmiş, hedef sütunu tahmin etmeye yönelik genel bir strateji öğrenen ve bu stratejiyi yeni bir tabloda bağlama dayalı öğrenme yoluyla, her veri kümesi için eğitim olmadan uygulayan bir sinir ağıdır.
Buradaki büyük değişim, öğrenmenin ne zaman gerçekleştiğidir.
XGBoost’ta öğrenme her yeni model eğittiğinizde veriniz üzerinde olur. Bir tablolu temel modelde ise öğrenme aylar önce ön eğitim sırasında gerçekleşmiştir ve veriniz yalnızca girdidir. Ayrıca sıkça göreceğiniz bazı terimler var; bunları sade bir dille açıklayayım:
Şimdi tablolu temel modellerin boosting yöntemleri ve otomatik makine öğrenimi (AutoML) ile nasıl karşılaştığına bakalım:
| Tablolu temel modeller | Gradyan destekli ağaçlar (XGBoost, LightGBM) | AutoML (AutoGluon, H2O AutoML) | |
|---|---|---|---|
| Yeni veride eğitim süresi | Yok | Saniyelerden dakikalara, artı ayar | Dakikalardan saatlere |
| Yorumlanabilirlik | Sınırlı (SHAP mümkün ama yavaş) | İyi (özellik önemi, hızlı SHAP) | Değişken, çoğu zaman okunması zor ansambllar |
| En uygun veri seti boyutu | Yüzlerden yaklaşık 100K satıra | Binlerden milyonlarca satıra | Binlerden milyonlara |
| GPU gerekir mi? | Birkaç bini geçince önerilir | Hayır | Genellikle hayır |
| Küçük, rastgele bölünmüş veri setleri | Mevcut kıyaslamalarda en iyi | Ayarlandığında güçlü | Güçlü ama yavaş |
Nasıl çalıştıklarına geçmeden önce, onları en ünlü ve yaygın kullanılan modellerle, büyük dil modelleriyle kısaca karşılaştırmak istiyorum.
Büyük dil modelleri (LLM’ler) ve tablolu temel modellerin ikisi de transformer kullanır ve girdilerindeki örneklerden öğrenir.
Fark, okumak üzere tasarlandıkları şeydedir. Bir LLM, bir tabloyu uzun bir metin dizesi olarak okur; bu da virgül ve boşluklardan, hangi sayıların aynı sütuna ait olduğunu çıkarması gerektiği anlamına gelir.
Ayrıca bir anlam problemi de vardır.
42 değeri birinin yaşı da olabilir bir gelir rakamı da; sayının kendisi hangisi olduğunu söylemez. Bir tablolu temel model, her sütunu kendi başına bir değişken ve her satırı tek bir örnek olarak ele alacak şekilde eğitilmiştir; dolayısıyla sütunların birbirleriyle nasıl ilişkili olduğuna odaklanır.
Bunu şöyle düşünmeyi seviyorum: Bir LLM veriniz hakkında konuşmakta harikadır; bir tablolu temel model ise onun üzerinde matematik yapmak için tasarlanmıştır.
İkisi birlikte de çalışabilir; H2O.ai’nin tabH2O modelini konumlandırma şekli tam olarak budur: Bir AI ajanın, bir e-tablodan sayısal bir değer gerektiğinde çağırdığı tahmin aracı.
Tablolu veriler derin öğrenme için zordu çünkü tablolarda, bir sinir ağının bir kez öğrenip tekrar kullanabileceği ortak bir yapı yoktur. Her fotoğrafta bir piksel pikseldir. Bir finans veri setindeki score adlı sütunla bir futbol veri setindeki score adlı sütunun ortak hiçbir yanı yoktur.
Léo Grinsztajn, Edouard Oyallon ve Gaël Varoquaux’nun 2022 tarihli, iyi bilinen Ağaç tabanlı modeller neden hâlâ tablolu verilerde derin öğrenmeyi geçiyor? makalesi, bunu 45 veri setinde test etti ve özellikle gradyan boosting olmak üzere ağaç tabanlı modellerin, yaklaşık 10.000 satırlık orta boy tablolarda derin öğrenmeyi geçtiğini buldu. Saptadıkları nedenler şunlardı:
İki pratik sorun bunu daha da kötüleştirir. Tek bir tablo; sayıları, kategorileri, sıralamaları ve eksik değerleri karıştırabilir ve çoğu iş tablosu yalnızca yüzlerce ya da binlerce satıra sahiptir; bu da sıfırdan eğitilen bir sinir ağı için çok azdır.
Bence en önemli sorun küçük veri setleridir. Sıfırdan 800 satırda eğitilen bir sinir ağının dayanacağı bir şey yoktur; oysa bir ağaç çalışmak için ön bilgiye ihtiyaç duymaz.
Ön eğitim tam olarak bunu çözdü. Bir tablolu temel model, sizinkini görmeden önce zaten milyonlarca küçük, dağınık, uydurma tablo üzerinde pratik yapmıştır; yani sıfırdan başlamaz.
Bir tablolu temel model, etiketli eğitim satırlarınızı ve etiketsiz test satırlarınızı tek bir girdi olarak birlikte alır ve eksik etiketleri tek bir ileri geçişte tahmin eder. Ağırlıkları asla değişmez; tıpkı girdiye birkaç örnek koyduktan sonra bir soruyu cevaplayan bir LLM gibi.
Bu, alışıldık scikit-learn yöntemlerinin ne anlama geldiğini de değiştirir.
TabICL üzerinde .fit() çağırdığınızda, TabICL dokümantasyonu bunun önceden eğitilmiş kontrol noktasını yüklediğini, verinizi ön işlediğini ve sakladığını açıklar. Asıl iş .predict() sırasında olur.
Modelin mevcut scikit-learn kodunuza takılabilmesi için .fit() adı aynı kalır.
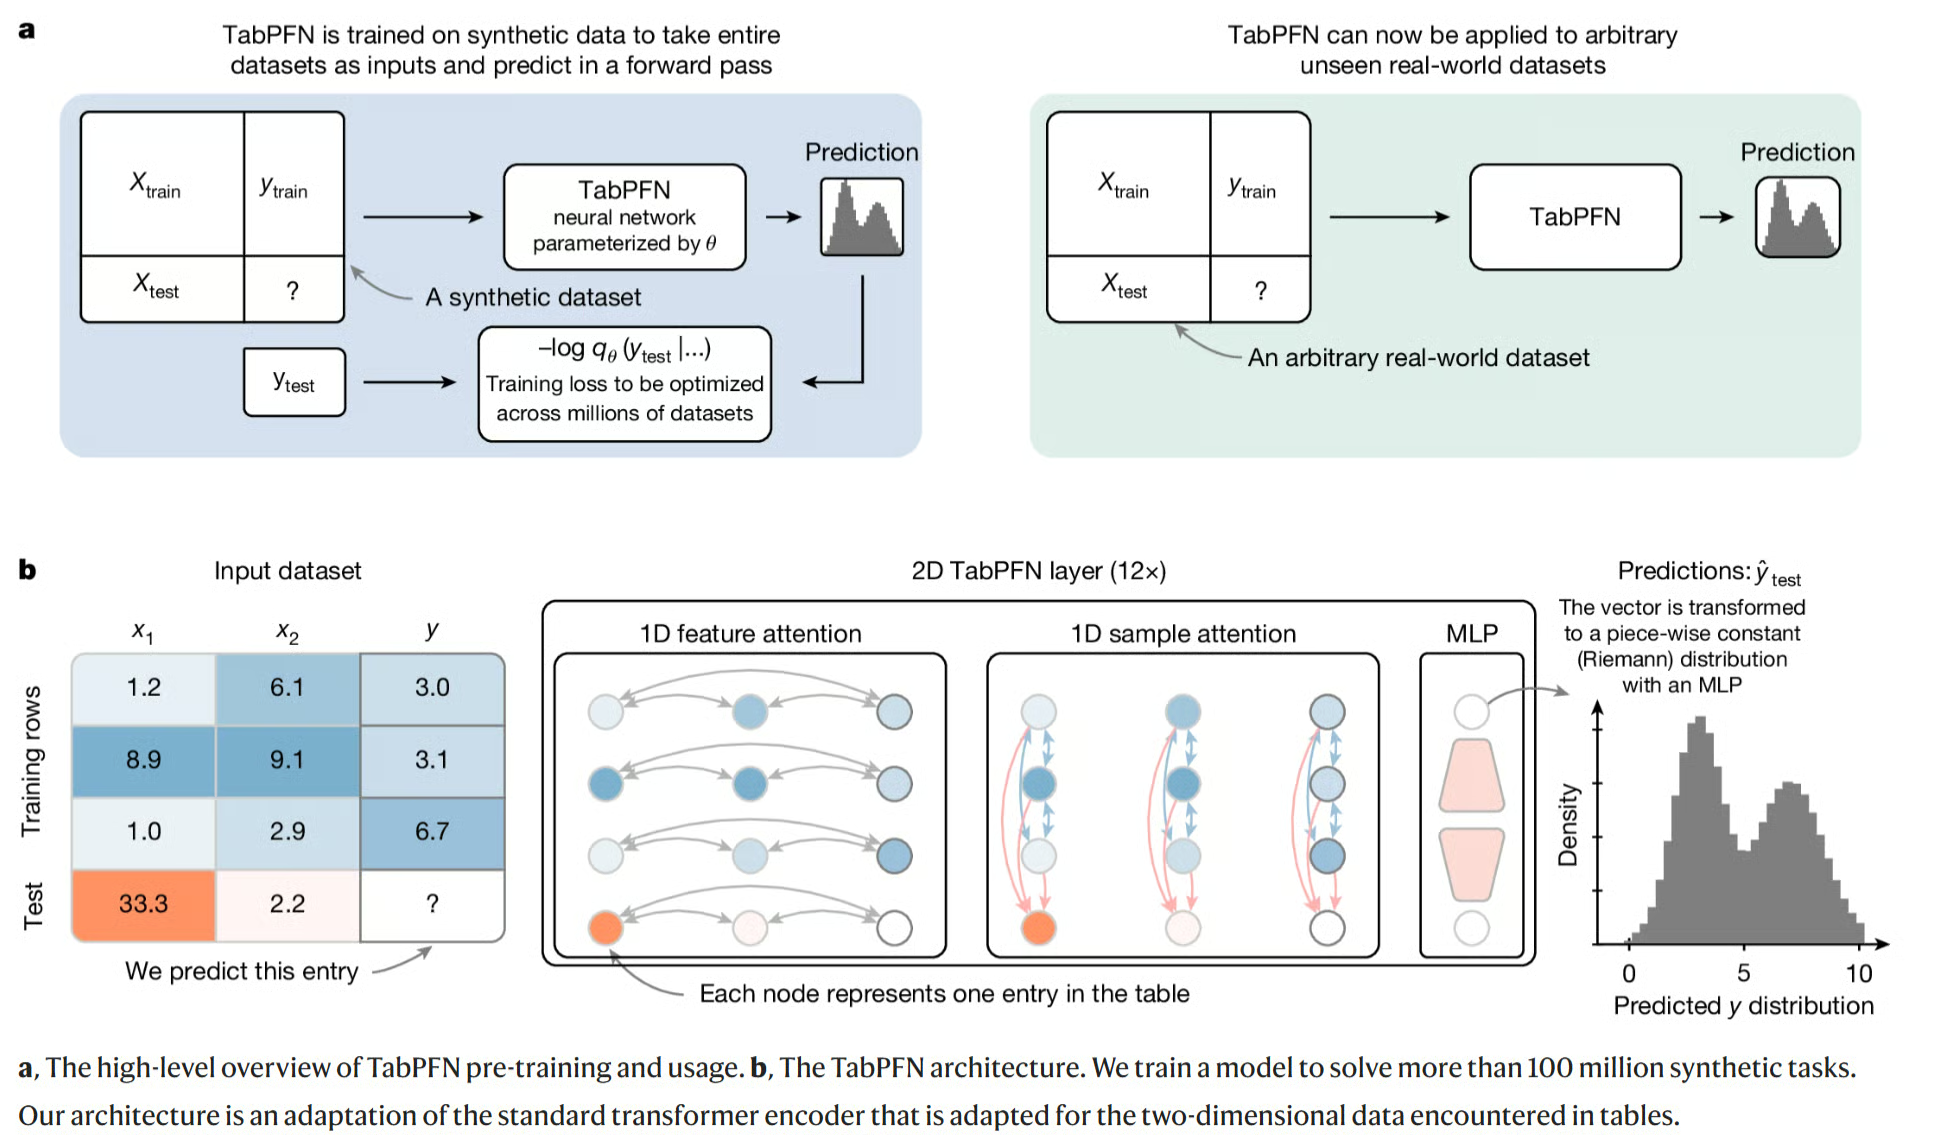
Şekil 1: TabPFN milyonlarca sentetik veri setinde önceden eğitilir, ardından tek bir ileri geçişte gerçek bir tabloda tahmin yapar. Alt panel, özellikler ve örnekler arasında nasıl dikkat kurduğunu gösterir. Kaynak: Hollmann ve diğ., “Küçük veride doğru tahminler yapan bir tablolu temel model”, Nature (2025).
Sentetik ön eğitim, modeli gerçekler yerine uydurma tablolarla; bir üretken model gibi çalışan bir veri üreticisi tarafından oluşturulan tablolarla eğitmektir.
Bir pilotun uçuş simülatöründe eğitimini düşünün. Pilot; farklı hava koşulları, havalimanları ve arızalarla binlerce sahte uçuş yapar ki ilk gerçek uçuş yeni gelmesin.
TabPFN benzer şekilde çalışır.
Geliştiricileri, sütunlar arasında rastgele “neden-sonuç” kuralları uyduran (örneğin, A sütunu B’yi etkiler, B hedefi etkiler) ve sonra bu kurallardan satırlar üreten bir üretici yazdı.
Ön eğitim sırasında hedef sütun gizlenir, model onu tahmin etmeye çalışır ve bu; farklı kurallar, gürültü seviyeleri ve tablo boyutlarıyla milyonlarca kez tekrarlanır.
Önemli olan, modelin herhangi bir gerçek konu hakkında bilgi öğrenmemesidir. Hangi sütunların önemli olduğunu fark etme, aykırı değerlere karşı başa çıkma ve ne zaman emin olmamak gerektiğini bilme gibi genel becerileri öğrenir.
Nitekim TabICLv2 makalesi, daha iyi performansının başlıca nedeni olarak yeni sentetik veri üreticisini gösterir.
Mimarilerin her ayrıntısını anlamanız gerekmez; ancak iki ana tasarım olduğunu bilmek faydalıdır:
Her iki ailenin de sentetik verilerle eğitildiğini ve “öncel uyumlu ağ”ın, ayrı bir model türünden ziyade nasıl eğitildiklerini tanımladığını unutmayın.
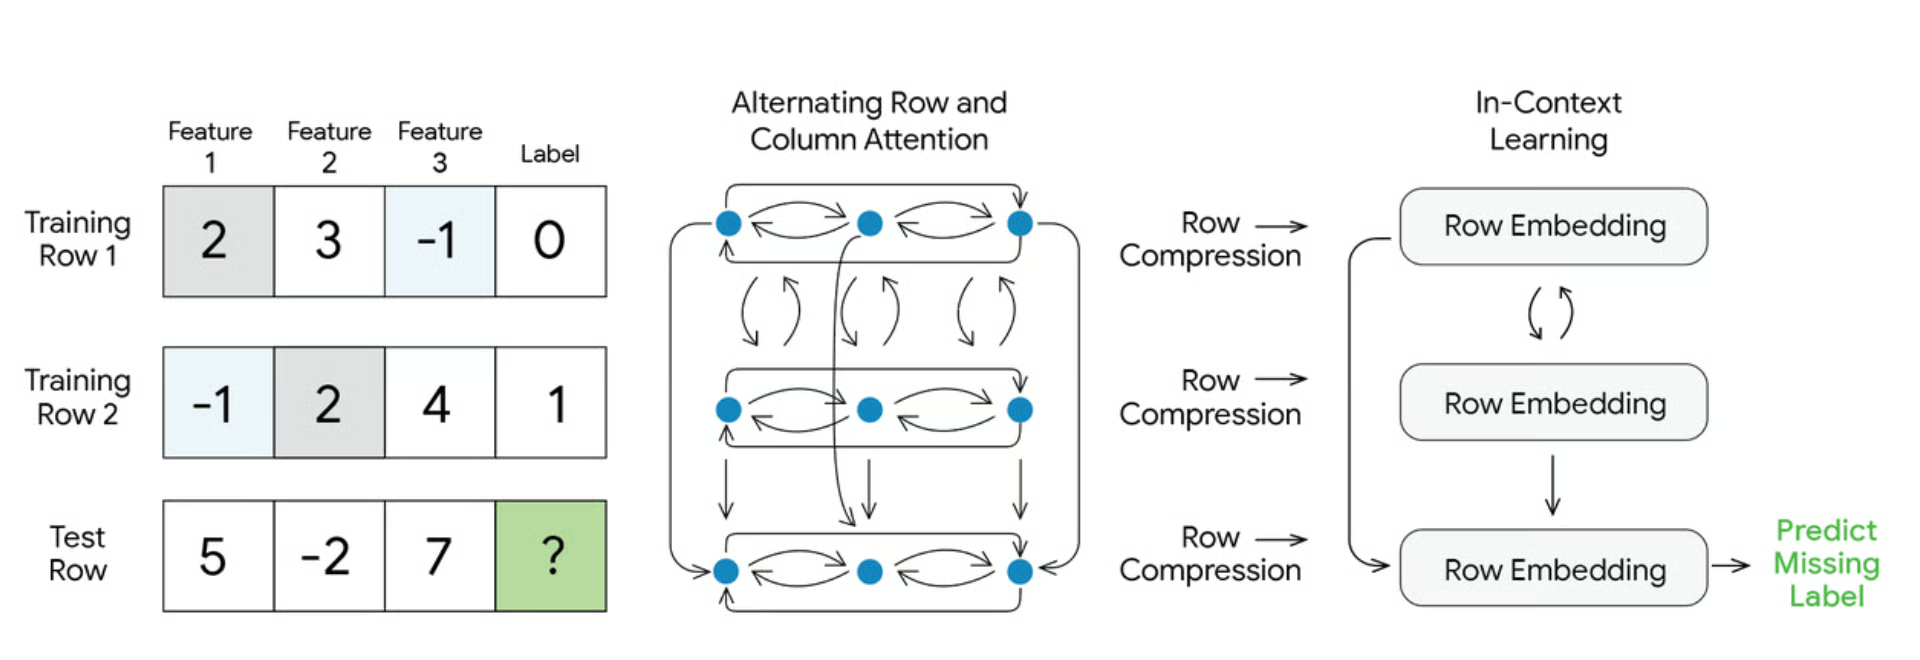
Şekil 2: TabFM iki tasarımı harmanlar: satırlar ve sütunlar boyunca TabPFN tarzı dikkat, ardından TabICL tarzı satır sıkıştırma ve eksik etiket için bağlama dayalı öğrenme. Kaynak: Google Research, “TabFM’i tanıtıyoruz: Tablolu veriler için sıfır atış temel model” (2026).
Burada çoğu kişiyi ters köşe yapan bir ödünleşim var.
XGBoost bir kez eğitimde zaman harcar, sonra neredeyse anında tahmin eder.
Bir tablolu temel model eğitimi atlar; ancak her tahminde, tüm eğitim satırlarınızı yeniden okumak zorundadır.
Servis öncesi hiçbir ön hazırlık yapmayan ama her siparişte tüm yemek kitabını baştan sona okuyan bir şefi düşünün.
Küçük bir kitap için bu sorun değildir; ancak veri kümeniz büyüdükçe tahminler yavaşlar. Hem TabICL hem TabPFN, tekrar eden tahminleri hızlandırmak için eğitim verilerinin “okunmasını” önbelleğe alabilir; fakat ilk geçiş yine de zaman alır.
2026’daki başlıca tablolu temel modeller TabPFN, TabICLv2, Google’ın TabFM’i, Fundamental’ın NEXUS’u ve H2O.ai’ın tabH2O’sudur. İş tarafının ne kadar hızlı hareket ettiğini ilginç buluyorum: Beş ay, bu alanı akademik makalelerden büyük anlaşmalara taşıdı. Kısa bir zaman çizelgesi şöyle:
Şimdi hepsini, işe her şeyi başlatan modelden başlayarak tek tek inceleyelim.
Bu kategoriyi oluşturan model TabPFN’dir. TabPFN-2, Ocak 2025’te Nature’da yayımlandı ve 10.000 satıra kadar olan veri setlerinde ayarlı ağaç tabanlı modelleri geçti.
O zamandan beri Prior Labs hızlıca yeni sürümler çıkardı. TabPFN-3 Mayıs 2026’da geldi ve 1 milyon satıra kadar (ve 200 özelliğe kadar) destek veriyor. Ayrıca uyum aşamasında fazladan zaman harcayarak daha iyi tahmin yapan Düşünme modunu (ücretli API’siyle) ekledi.
En son sürüm TabPFN-3.5, Eylül 2026’da çıktı ve teknik raporu, zaman sıralı ve gruplanmış veriler de dahil olmak üzere birkaç büyük kıyaslamada birinciliği iddia ediyor. Bunları, başkaları doğrulayana kadar şirketin kendi rakamları olarak görürdüm.
Bir diğer konu lisans. TabPFN-2, Prior Labs’a atıf yaptığınız sürece ticari olarak kullanılabilir; ancak 2.5 ile 3.5 arası sürümler ticari olmayan lisanslıdır. Bu, ücretsiz deneyebileceğiniz, fakat gerçek bir üründe kullanmak için ücretli lisans gerektirdiği anlamına gelir.
TabICLv2 şu anda tamamen açık en iyi tablolu temel modeldir. Inria’da geliştirildi, Şubat 2026’da yayımlandı ve ICML 2026’da kabul edildi.
TabICLv2 makalesinin manşet sonucu; herhangi bir ayar yapılmadan, önceki en iyi model olan RealTabPFN-2.5’i, o model gerçek verilerde ayarlanmış, birleştirilmiş ve ince ayar yapılmış olmasına rağmen geçmesidir.
GitHub deposuna göre, TabArena kıyaslamasında veri setlerinin yaklaşık %80’inde, yoğun şekilde ayarlanmış XGBoost, CatBoost ve LightGBM’i de geride bırakıyor.
Ayrıca hızlıdır; 100 özellikli 50.000 satırı bir H100 GPU’da 10 saniyenin altında işler; bu da TabPFN-2.5’ten yaklaşık 10 kat hızlıdır.
En iyi 300 ile 100.000 satır arasında çalışır ve bir miktar doğruluk kaybıyla yaklaşık 500.000 satıra kadar esneyebilir.
Bana göre çoğu okuyucunun başlaması gereken model budur.
pip install tabicl ile kurulur, herhangi bir scikit-learn modeli gibi çalışır ve izin verici lisansı, hiçbir şeye kayıt olmadan ticari kullanım sağlar. Liderlik tablosu hızlı değişiyor; TabPFN-3.5’in raporu artık kendisini TabICLv2’nin önünde sıralıyor.
TabFM, Google Research’ün tablolu temel modelidir ve 30 Haziran 2026’da yayımlandı. Onu farklı kılan, nerede kullanabildiğinizdir: Google’ın bulut veri ambarı BigQuery’ye yerleşiktir; böylece düz SQL ile tahmin alabilirsiniz.
-- Use past customers (with known churn) to predict churn for new customers
-- AI.PREDICT is in preview, so check the BigQuery docs for the latest syntax
SELECT *
FROM AI.PREDICT(
  TABLE my_dataset.customers_history,
  TABLE my_dataset.customers_new,
  label_col => 'churned'
);
Bu, SQL bilip Python bilmeyenler için harikadır.
Ancak BigQuery dokümantasyonu şu anda 20 özellik sütunu ve 10 sınıfla sınırlar ve Google, 30 Ekim 2026’dan itibaren standart BigQuery ücretlerine ek olarak jeton bazlı fiyatlandırma eklemeyi planlıyor. Hugging Face’teki model ağırlıkları ticari olmayan lisanslıdır; bu nedenle ticari kullanım BigQuery üzerinden olur.
NEXUS, eski DeepMind araştırmacıları tarafından kurulan San Francisco merkezli Fundamental şirketinin kapalı, yalnızca işletmelere yönelik modelidir. Şubat 2026’da 255 milyon $ fonla piyasaya sürüldü ve şirket buna Büyük Tablolu Model (LTM) diyor.
İşletmeler NEXUS’u AWS üzerinden satın alıp çalıştırır ve Fundamental, Fortune 100 şirketlerinin bunu talep tahmini, fiyatlandırma ve müşteri kaybı için zaten kullandığını söylüyor. Ancak herkese açık ağırlıklar veya kendiniz kontrol edebileceğiniz kıyas sonuçları yok; bu yüzden bunu kurumsal bir seçenek olarak görürdüm.
tabH2O, H2O.ai’ın modelidir ve tüm fikri basittir: verinizi gönderin, tahminleri alın.
Eksik değerleri ve kategorileri sizin için temizler ve bir şirketin kendi sunucularında çalışabilir; bu da veriyi buluta gönderemeyen banka ve hastaneler için önemlidir.
Beğendiğim şey, tabH2O makalesinin bunu abartmamasıdır. TALENT kıyaslamasında ayarlı CatBoost ve LightGBM’i geçti; ancak yine de TabICLv2’nin gerisinde kaldı.
| Model | Geliştirici | Açık ağırlık? | Azami ölçek | Lisans | En uygun kullanım |
|---|---|---|---|---|---|
| TabPFN-2 | Prior Labs | Evet | 10K satır | Atıfla ticari | Kendini kanıtlamış eski bir modelin ticari kullanımı |
| TabPFN-3 / 3.5 | Prior Labs (SAP) | Evet, bir lisans kabulünden sonra | 1M satıra kadar | Ticari olmayan, işletme için ücretli API | Üst düzey doğruluk ve araştırma |
| TabICLv2 | Inria | Evet | En iyi 100K satıra kadar | İzin verici açık kaynak | Varsayılan başlangıç noktanız |
| TabFM | Google Research | Evet | BigQuery’de 20 özellik | Ticari olmayan ağırlıklar | BigQuery’deki SQL kullanıcıları |
| NEXUS | Fundamental | Hayır | Açıklanmadı | Mülkiyetli | AWS üzerindeki büyük şirketler |
| tabH2O | H2O.ai | Hayır | Açıklanmadı | Ticari API | ML kurulumu olmayan ekipler, AI ajanları |
Bir tablolu temel modeli Python’da tıpkı diğer scikit-learn modelleri gibi kullanırsınız.
Ne sunduğunu görmenin en iyi yolu, onu XGBoost ile başa baş yarıştırmaktır; hadi bunu scikit-learn’ün yerleşik meme kanseri veri setinde yapalım.
Önce paketleri kuralım:
pip install tabicl xgboost scikit-learnSonra her iki modeli de aynı bölmede çalıştıralım:
from sklearn.datasets import load_breast_cancer
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from tabicl import TabICLClassifier
from xgboost import XGBClassifier

# Load a small tabular dataset as a pandas DataFrame
X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# Tabular foundation model: fit() just stores the training rows
tfm = TabICLClassifier()
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)

# XGBoost baseline with reasonable, untuned settings
xgb = XGBClassifier(n_estimators=300, learning_rate=0.05, max_depth=4)
xgb.fit(X_train, y_train)
xgb_preds = xgb.predict(X_test)

print(f"TabICL accuracy:  {accuracy_score(y_test, tfm_preds):.3f}")
print(f"XGBoost accuracy: {accuracy_score(y_test, xgb_preds):.3f}")
Bu küçük veri seti normal bir dizüstü bilgisayar CPU’sunda gayet iyi çalışır.
Bu kadar temiz bir veri setinde her iki model de çok yüksek puan alacaktır; o yüzden lütfen tek bir bölmeye göre yargılamayın. Gerçek sınav, kendi dağınık verileriniz olacaktır.
Yerine TabPFN denemek isterseniz, pip install tabpfn çalıştırın ve ardından yalnızca iki satır değişiklik yeterlidir:
from tabpfn import TabPFNClassifier

tfm = TabPFNClassifier()  # The first run asks you to accept the license
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)
Gerçek verilerde modelleri karşılaştırmadan önce önemli bir nokta.
Verinizde tarihler varsa, rastgele değil zamana göre bölün. Aksi halde model geleceğe göz atmış olur ve bir sonraki bölümde göreceğiniz gibi, tablolu temel modellerin gerçekte olduklarından daha iyi göründükleri yer tam da burasıdır.
Tablolu temel modeller, veri kümeniz küçük-orta ölçekliyse ve test satırları eğitim satırlarına benziyorsa iyi çalışır. Zaman sıralı verilerde, gruplanmış verilerde, çok büyük tablolarda ve sıkı açıklanabilirlik gereksinimlerinde zorlanırlar.
“Test satırları eğitim satırlarına benziyor” fikrinin bir adı vardır: IID (bağımsız ve özdeş dağılımlı) ve veriniz hakkında kontrol etmeniz gereken tek en önemli şey budur.
İyi çalıştıkları yerlerle başlayalım:
Şimdi de sınırlamalara; gerçek bir projede bunların daha çok önem taşıdığını düşünüyorum.
Haziran 2026’da yayımlanan BeyondArena kıyaslaması, 142 veri setinde 11 modeli test etti; zamanla bölünmüş (geçmişten geleceği tahmin) ve grupla bölünmüş (yeni bir hastane ya da ülke için tahmin) olanlar dahil.
Küçük ve orta IID verilerde tablolu temel modellerin en iyi olduğunu; zaman sıralı, gruplanmış, büyük ve çok geniş verilerde ise ağaç tabanlı ve diğer derin öğrenme modellerinin önde olduğunu buldu. Çoğu iş verisi (satış, sahtekarlık, kayıp) zaman sıralı olduğundan, bu sınırlama gerçek projelerin çoğunda karşınıza çıkar.
BeyondArena’dan sonra yayımlanan TabPFN-3.5, özellikle zaman sıralı ve gruplanmış verilerdeki bu farkı kapattığını iddia ediyor. Bu umut verici; ancak henüz bağımsız olarak test edilmedi.
Hem TabICL’den hem TabPFN’den SHAP değerleri alabilirsiniz; ancak bu, ağaç modelinde SHAP’e göre çok daha uzun sürer ve incelenecek ağaç bölmeleri yoktur. Düzenleyicilerin modeli anlaması gereken kredi skorlama gibi alanlarda bu gerçek bir sorundur.
Birkaç bin satırı aşan her şey gerçekten bir GPU ister ve eğitim veriniz büyüdükçe tahminler yavaşlar. CPU’da eğitilmiş bir XGBoost modeli hızda her zaman kazanır.
TabPFN-2 atıfla ticari, daha yeni TabPFN sürümleri ticari olmayan, TabFM ağırlıkları ticari olmayan ve TabICLv2 izin vericidir.
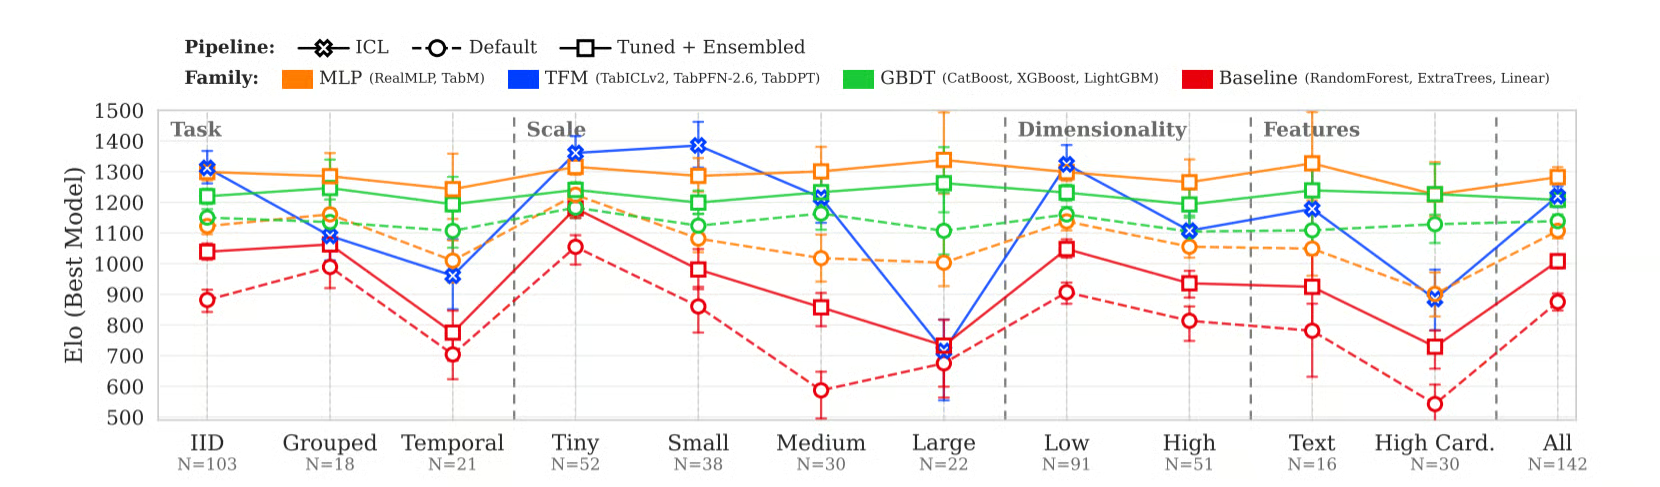
Şekil 3: Model ailelerine göre Elo (yüksek daha iyidir). Tablolu temel modeller küçük IID veride önde, ancak zamansal ve büyük veri setlerinde düşer; ağaçlar ve MLP’ler daha iyi dayanır. Mavi; en yeni TabPFN sürümleri değil, TabICLv2, TabPFN-2.6 ve TabDPT’nin en iyisidir. Kaynak: Purucker ve diğ., “IID Ötesi: Tablolu Temel Modeller Gerçekte Ne Kadar Genel?” (2026), CC BY 4.0.
Umarım bana katılırsınız: tablolu temel modeller, zahmetsiz hızlı bir başlangıç noktasının kalitesini yükseltti; ancak ağaç tabanlı modellerin hâlâ birçok gerçek durumda daha iyi bir seçim olduğu yerler çok.
Veri kümeniz küçük-orta ve IID olduğunda; tamamen açıklanabilir bir modele veya CPU’da çok hızlı tahminlere ihtiyaç duymadığınızda tablolu bir temel model kullanmalısınız. İşte kullanacağım karar tablosu:
| Senaryo | Önerilen yaklaşım |
|---|---|
| 10K satır altı, IID, açıklanabilirlik gereksinimi yok | TabICLv2 veya TabPFN ile başlayın |
| 10K ile 100K satır arası, IID | TabICLv2 ve XGBoost’u test edin, kazananı saklayın |
| 100K ile 1M satır arası | XGBoost veya LightGBM ile başlayın, meydan okumacı olarak TabPFN-3’ü deneyin |
| Zamana veya gruba göre bölünmüş veri | Ağaç tabanlı modellerle başlayın |
| SHAP, özellik önemi veya denetim gerekir | SHAP’lı ağaç tabanlı model |
| GPU olmadan hızlı tahminler | Ağaç tabanlı model |
| Hızlı kavram kanıtı, ML kurulumu yok | TabICLv2 veya veriniz zaten oradaysa BigQuery AI.PREDICT |
| Tablolardan tahmin gerektiren bir AI ajanı | tabH2O veya NEXUS gibi bir API |
Bir model seçmeden önce şu üç soruyu sormanızı öneririm:
Ve söylemek istediğim son nokta şu. Bir tablolu temel modeli önce çalıştırın; çünkü birkaç dakikanızı alır. Verinizde XGBoost’u geçemezse, artık özellik mühendisliği ve XGBoost’u ayarlamaya zaman harcamanın değerli olduğunu biliyorsunuz.
Bu yazının başındaki iki öğrenciyi hatırlıyor musunuz? 2026’da, milyonlarca sınavda pratik yapan ikinci öğrenci, en azından küçük ve orta boy tablolarda, haftalarca çalışanı nihayet geçebiliyor.
Tablolu temel modeller, her veri kümesine özel eğitimi ön eğitimle ve fit() işlemini örneklerden öğrenmeyle değiştirir.
Beni en çok şaşırtan, bu alanın ne kadar hızlı geliştiği. TabPFN-2, 2025’te sinir ağının küçük tablolarda ayarlı ağaçları geçebileceğini ilk gösterdi; TabICLv2 ve TabPFN-3 ise bunu çok daha büyük tablolara taşıdı.
Şu anki açık sorunlar; zaman sıralı veriler, değişen veriler, açıklanabilirlik ve lisanslamadır ki bunlar, bir modelin gerçek bir ürüne girip girmeyeceğini belirleyen şeylerin ta kendisidir.
Bu yüzden tavsiyem; bu modelleri yeni başlangıç noktanız olarak görmek ve nihai aracı verinize, kısıtlarınıza ve modelin nerede çalışacağına göre seçmektir.
Ve pek çok gerçek durumda hâlâ kazanan ağaç tabanlı modellere hâkim olmak istiyorsanız, Python ile Ağaç Tabanlı Modellerle Makine Öğrenimi kursumuza ve Python ile Denetimli Makine Öğrenimi eğitim yoluna göz atın. R ile çalışıyorsanız, R ile Ağaç Tabanlı Modellerle Makine Öğrenimi aynı içeriği kapsar.
Öne Çıkan DataCamp Kursları
Program
Kurs
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme