
Lộ trình
Phát triển các mô hình ngôn ngữ quy mô lớn
16 giờ
Hãy tưởng tượng có hai sinh viên làm cùng một bài thi. Sinh viên đầu tiên dành ba tuần chỉ học một học phần, còn sinh viên thứ hai đã luyện hàng triệu đề thi khác nhau và chỉ cần một tờ ví dụ đã giải sẵn vào ngày thi.
Trong phần lớn quá khứ của machine learning, các mô hình cho dữ liệu bảng giống như sinh viên đầu tiên. Mỗi bộ dữ liệu mới đều đồng nghĩa với việc làm sạch cột, tạo đặc trưng, huấn luyện XGBoost hoặc LightGBM, và tinh chỉnh siêu tham số trong nhiều giờ.
Mô hình nền tảng cho dữ liệu bảng thì giống sinh viên thứ hai: bạn đưa cho chúng các hàng đã gán nhãn làm ví dụ, và chúng dự đoán phần còn lại với không cần huấn luyện gì cả.
Năm 2026, ý tưởng này đã đi từ các bài báo nghiên cứu đến sản phẩm thực tế, với SAP cam kết hơn €1 tỷ cho Prior Labs và Google phát hành mô hình riêng. Vì vậy trong bài viết này, chúng ta sẽ xem xét:
Đừng lo nếu bạn chưa có nhiều kinh nghiệm deep learning. Mã trong bài sử dụng giao diện quen thuộc của scikit-learn, và nếu muốn ôn nhanh trước, bài 8 Mô hình Machine Learning trong 20 phút sẽ bao quát những điều cơ bản.
pip install tabicl.Đó là một mạng nơ-ron được tiền huấn luyện trên hàng triệu bộ dữ liệu bảng tổng hợp, học một chiến lược tổng quát để dự đoán cột mục tiêu, rồi áp dụng chiến lược đó cho một bảng mới thông qua in-context learning, mà không cần huấn luyện theo từng bộ dữ liệu.
Điểm thay đổi lớn ở đây là khi nào việc học diễn ra.
Với XGBoost, quá trình học diễn ra trên dữ liệu của bạn mỗi lần bạn huấn luyện một mô hình mới. Với một mô hình nền tảng cho dữ liệu bảng, việc học đã diễn ra từ nhiều tháng trước trong giai đoạn tiền huấn luyện, và dữ liệu của bạn chỉ là đầu vào. Cũng có vài thuật ngữ bạn sẽ gặp thường xuyên, nên tôi giải thích ngắn gọn:
Bây giờ, hãy so sánh mô hình nền tảng cho dữ liệu bảng với các phương pháp boosting và AutoML:
| Mô hình nền tảng cho dữ liệu bảng | Cây tăng cường độ dốc (XGBoost, LightGBM) | AutoML (AutoGluon, H2O AutoML) | |
|---|---|---|---|
| Thời gian huấn luyện trên dữ liệu mới | Không | Vài giây đến vài phút, cộng tinh chỉnh | Vài phút đến vài giờ |
| Khả năng diễn giải | Hạn chế (có thể dùng SHAP nhưng chậm) | Tốt (tầm quan trọng đặc trưng, SHAP nhanh) | Thay đổi, thường là ensemble khó đọc |
| Quy mô dữ liệu phù hợp nhất | Hàng trăm đến khoảng 100K hàng | Hàng nghìn đến hàng chục triệu hàng | Hàng nghìn đến hàng triệu hàng |
| Cần GPU? | Khuyến nghị khi vượt vài nghìn hàng | Không | Thường không |
| Bộ dữ liệu nhỏ, chia ngẫu nhiên | Đứng đầu trên benchmark hiện tại | Mạnh khi được tinh chỉnh | Mạnh nhưng chậm |
Trước khi tìm hiểu cách chúng hoạt động, tôi muốn so nhanh với mô hình nổi tiếng nhất: các mô hình ngôn ngữ lớn.
Mô hình ngôn ngữ lớn (LLM) và mô hình nền tảng cho dữ liệu bảng đều dùng transformer, và đều học từ ví dụ trong đầu vào.
Khác biệt là chúng được xây để đọc gì. Một LLM đọc một bảng như một chuỗi văn bản dài, nghĩa là nó phải suy ra từ dấu phẩy và khoảng trắng xem số nào thuộc cùng một cột.
Còn có vấn đề về ngữ nghĩa.
Giá trị 42 có thể là tuổi của ai đó hoặc một con số doanh thu, nhưng bản thân con số không nói bạn biết là gì. Mô hình nền tảng cho dữ liệu bảng được huấn luyện để coi mỗi cột là một biến riêng và mỗi hàng là một ví dụ, nên nó tập trung vào quan hệ giữa các cột.
Tôi thích nghĩ thế này: LLM rất giỏi “nói” về dữ liệu của bạn, còn mô hình nền tảng cho dữ liệu bảng được xây để “tính toán” trên dữ liệu đó.
Hai loại này cũng có thể phối hợp, đúng như cách H2O.ai định vị mô hình tabH2O: công cụ dự đoán mà một tác nhân AI gọi tới khi cần một con số từ bảng tính.
Dữ liệu bảng khó với deep learning vì bảng không có cấu trúc chung để mạng nơ-ron học một lần rồi tái sử dụng. Một pixel thì pixel nào trong ảnh cũng giống nhau. Nhưng một cột tên score trong dữ liệu tài chính và một cột score trong dữ liệu bóng đá không có gì chung.
Một bài báo nổi tiếng năm 2022 của Léo Grinsztajn, Edouard Oyallon và Gaël Varoquaux, Tại sao mô hình cây vẫn vượt deep learning trên dữ liệu bảng?, kiểm thử trên 45 bộ dữ liệu và thấy rằng mô hình cây, đặc biệt là gradient boosting, vẫn thắng deep learning trên các bảng cỡ trung khoảng 10.000 hàng. Các lý do gồm:
Hai vấn đề thực tế nữa làm tình hình tệ hơn. Một bảng có thể trộn số, danh mục, thứ hạng, và giá trị khuyết, và hầu hết bảng doanh nghiệp chỉ có hàng trăm hoặc hàng nghìn hàng, quá ít cho mạng nơ-ron huấn luyện từ đầu.
Tôi cho rằng dữ liệu nhỏ là vấn đề quan trọng nhất. Một mạng nơ-ron huấn luyện từ số 0 trên 800 hàng không có gì để dựa vào, trong khi cây không cần kiến thức tiên nghiệm để hoạt động.
Tiền huấn luyện đã khắc phục đúng điểm này. Một mô hình nền tảng cho dữ liệu bảng đã luyện trên hàng triệu bảng giả nhỏ, lộn xộn trước khi thấy dữ liệu của bạn, nên nó không bắt đầu từ con số 0.
Một mô hình nền tảng cho dữ liệu bảng nhận các hàng huấn luyện đã gán nhãn và các hàng kiểm thử chưa gán nhãn cùng nhau làm một đầu vào, rồi dự đoán nhãn còn thiếu chỉ trong một lần lan truyền tiến. Trọng số của nó không bao giờ thay đổi, giống cách một LLM trả lời câu hỏi sau khi bạn đưa vài ví dụ trong prompt.
Điều này cũng làm thay đổi ý nghĩa các phương thức quen thuộc của scikit-learn.
Khi bạn gọi .fit() trên TabICL, tài liệu TabICL giải thích rằng nó nạp checkpoint tiền huấn luyện, tiền xử lý dữ liệu của bạn và lưu lại. Công việc thực sự diễn ra trong .predict().
Tên .fit() được giữ lại để mô hình gắn vào code scikit-learn sẵn có của bạn.
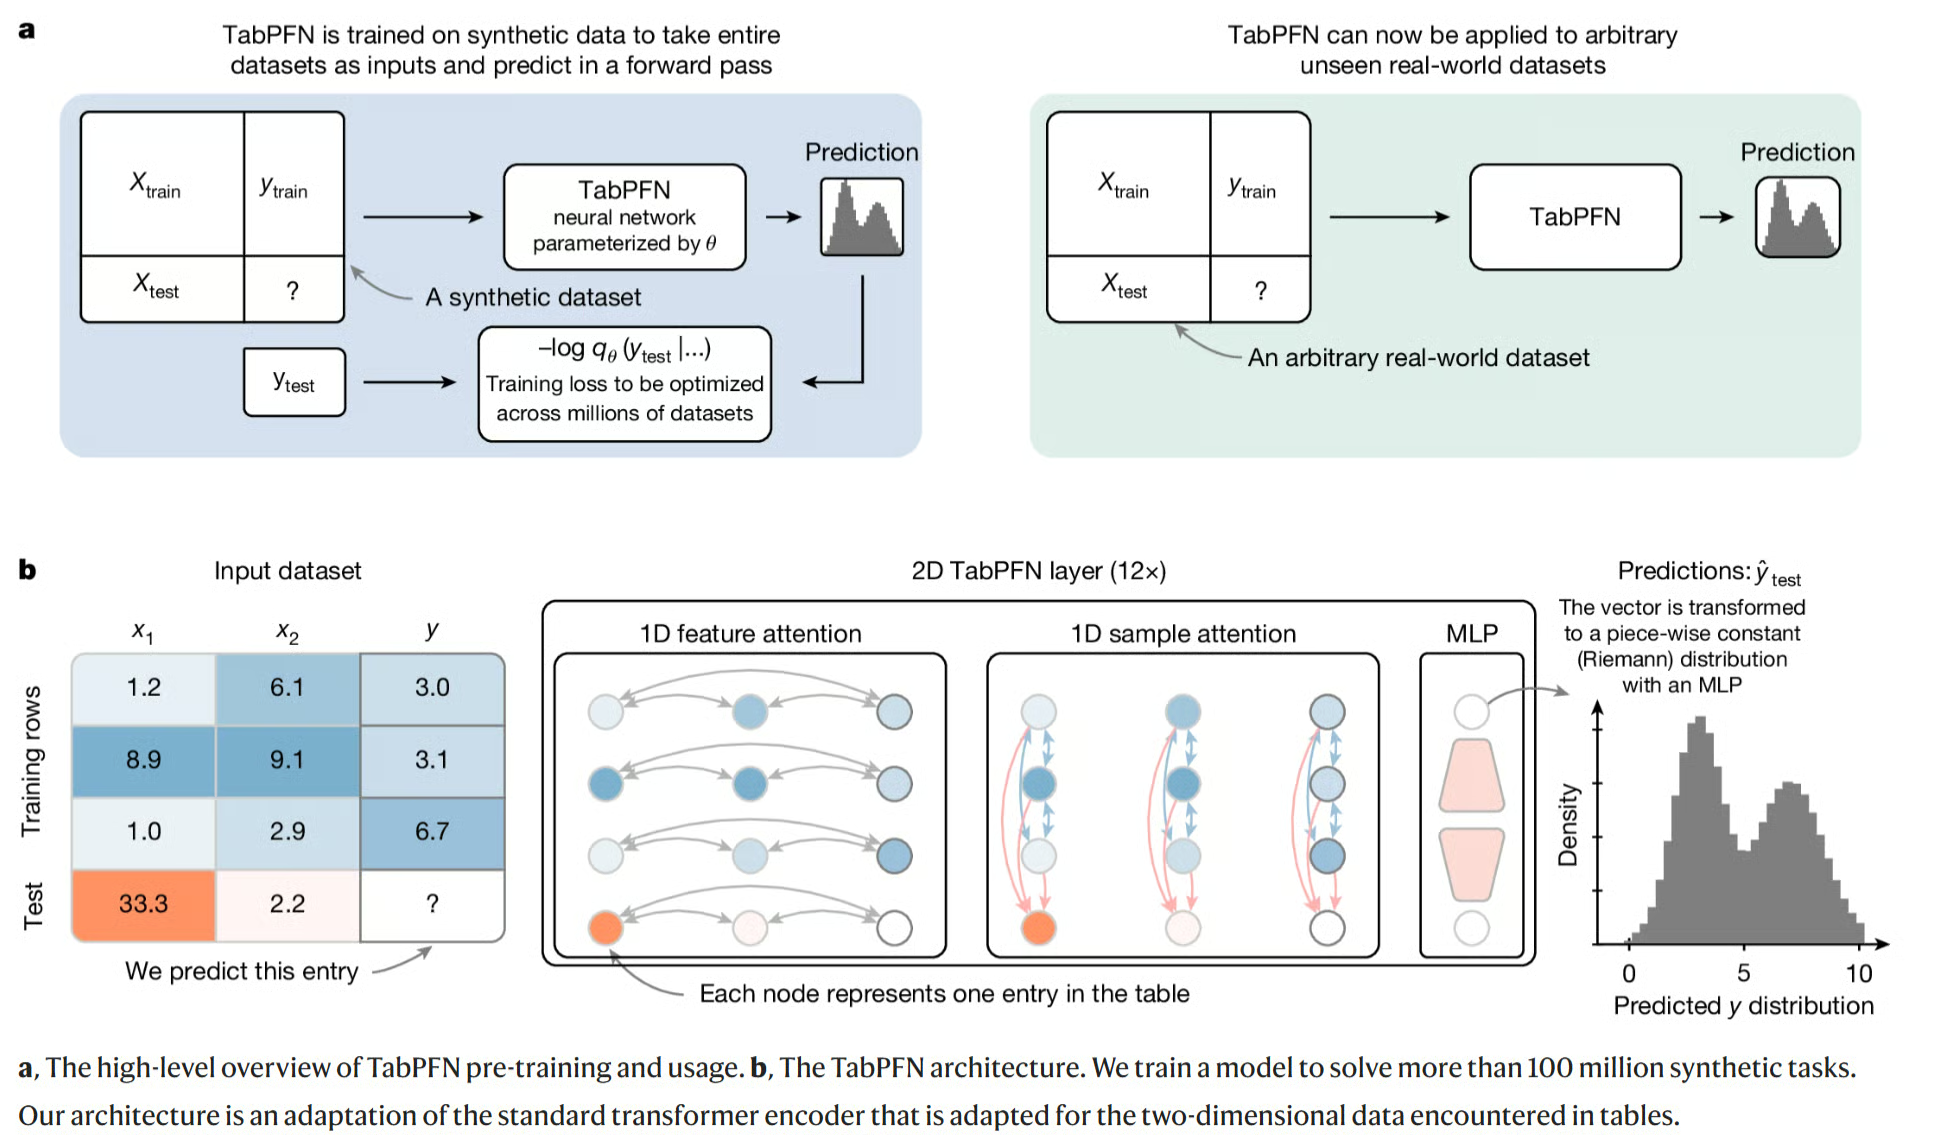
Hình 1: TabPFN được tiền huấn luyện trên hàng triệu bộ dữ liệu tổng hợp, rồi dự đoán trên một bảng thực trong một lần lan truyền tiến. Khung dưới cho thấy cách nó chú ý theo cả chiều đặc trưng và mẫu. Nguồn: Hollmann et al., “Accurate predictions on small data with a tabular foundation model”, Nature (2025).
Tiền huấn luyện bằng dữ liệu tổng hợp nghĩa là huấn luyện mô hình trên các bảng giả, được tạo bởi một bộ sinh dữ liệu hoạt động như một mô hình sinh.
Hãy nghĩ đến phi công tập trong buồng mô phỏng. Phi công thực hành hàng nghìn chuyến bay giả với thời tiết, sân bay, sự cố khác nhau, để chuyến bay thật đầu tiên không còn lạ lẫm.
TabPFN hoạt động tương tự.
Nhóm tác giả viết một bộ sinh quy tắc “nhân quả” ngẫu nhiên giữa các cột (ví dụ, cột A ảnh hưởng cột B, rồi ảnh hưởng mục tiêu), rồi tạo hàng từ các quy tắc đó.
Trong tiền huấn luyện, cột mục tiêu bị ẩn đi, mô hình cố đoán nó, và điều này lặp lại hàng triệu lần với các quy tắc, mức nhiễu và kích thước bảng khác nhau.
Điều quan trọng là mô hình không học sự kiện về bất kỳ chủ đề thực nào. Nó học kỹ năng tổng quát như xác định cột nào quan trọng, xử lý ngoại lệ, và biết khi nào nên không chắc chắn.
Thực tế, bài TabICLv2 ghi công bộ sinh dữ liệu tổng hợp mới là lý do chính giúp cải thiện hiệu năng.
Bạn không cần hiểu mọi chi tiết kiến trúc, nhưng biết rằng có hai thiết kế chính sẽ hữu ích:
Lưu ý cả hai họ đều được huấn luyện trên dữ liệu tổng hợp, nên “prior-fitted network” mô tả cách huấn luyện chứ không phải loại mô hình riêng.
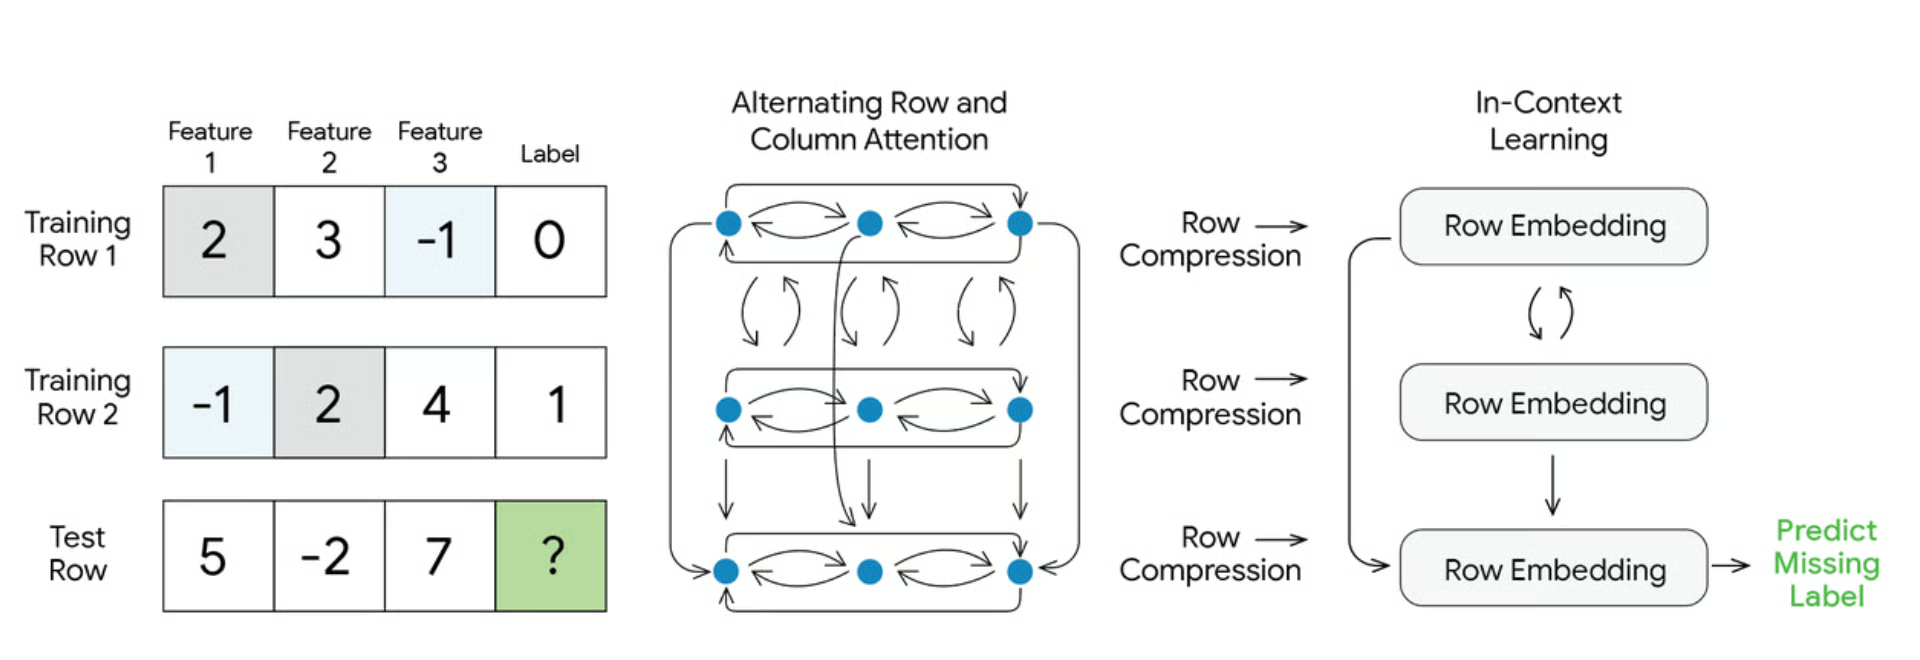
Hình 2: TabFM kết hợp cả hai: attention kiểu TabPFN theo hàng và cột, sau đó nén hàng kiểu TabICL, rồi in-context learning cho nhãn còn thiếu. Nguồn: Google Research, “Introducing TabFM: A zero-shot foundation model for tabular data” (2026).
Có một đánh đổi dễ khiến nhiều người “hụt”.
XGBoost tốn thời gian huấn luyện một lần, rồi dự đoán gần như tức thì.
Một mô hình nền tảng cho dữ liệu bảng bỏ qua huấn luyện, nhưng mỗi lần dự đoán nó phải đọc toàn bộ các hàng huấn luyện của bạn.
Hãy nghĩ đến đầu bếp không sơ chế trước giờ phục vụ và phải đọc lại cả sách công thức cho mỗi món gọi.
Với “quyển sách” nhỏ thì ổn, nhưng khi dữ liệu lớn dần, dự đoán sẽ chậm hơn. Cả TabICL và TabPFN đều có thể lưu đệm phần “đọc” dữ liệu huấn luyện để tăng tốc cho các lần dự đoán lặp lại, nhưng lần đầu vẫn tốn thời gian.
Các mô hình chính năm 2026 gồm TabPFN, TabICLv2, TabFM của Google, NEXUS của Fundamental và tabH2O của H2O.ai. Điều thú vị là tốc độ thương mại hóa: chỉ năm tháng từ bài báo học thuật đến các thương vụ lớn. Dòng thời gian ngắn gọn:
Giờ hãy đi qua từng mô hình, bắt đầu với mô hình khai sinh cả lĩnh vực này.
TabPFN là mô hình tạo nên danh mục này. TabPFN-2 được đăng trên Nature tháng 1/2025 và vượt các mô hình cây đã tinh chỉnh trên các bộ dữ liệu tới 10.000 hàng.
Kể từ đó, Prior Labs phát hành phiên bản mới nhanh chóng. TabPFN-3 ra mắt tháng 5/2026 và xử lý tới 1 triệu hàng (và tối đa 200 đặc trưng). Nó cũng bổ sung Chế độ “Thinking” (qua API trả phí) dành thêm thời gian ở bước fit để dự đoán tốt hơn.
Phiên bản mới nhất, TabPFN-3.5, ra tháng 9/2026, và báo cáo kỹ thuật tuyên bố đứng đầu nhiều benchmark lớn, gồm cả dữ liệu theo thời gian và theo nhóm. Tôi sẽ coi đó là số liệu phía công ty cho tới khi có kiểm chứng độc lập.
Vấn đề nữa là giấy phép. TabPFN-2 có thể dùng thương mại miễn là ghi công Prior Labs, nhưng các bản 2.5 đến 3.5 là phi thương mại. Nghĩa là bạn có thể thử miễn phí, nhưng dùng trong sản phẩm thực cần giấy phép trả phí.
TabICLv2 hiện là mô hình nền tảng cho dữ liệu bảng mở tốt nhất. Xây dựng tại Inria, phát hành tháng 2/2026 và được nhận tại ICML 2026.
Kết quả nổi bật từ bài TabICLv2 là, không cần tinh chỉnh, nó vượt RealTabPFN-2.5, mô hình tốt nhất trước đó, mặc dù mô hình kia đã được tinh chỉnh, ensemble và fine-tune trên dữ liệu thật.
Theo kho GitHub, nó cũng vượt các bản XGBoost, CatBoost và LightGBM đã tinh chỉnh nặng trên khoảng 80% bộ dữ liệu trong benchmark TabArena.
Nó cũng nhanh, xử lý 50.000 hàng với 100 đặc trưng dưới 10 giây trên GPU H100, nhanh hơn khoảng 10 lần so với TabPFN-2.5.
Nó hoạt động tốt nhất trong khoảng 300 đến 100.000 hàng và có thể mở rộng tới khoảng 500.000 hàng với chút suy giảm độ chính xác.
Theo tôi, đây là lựa chọn mà đa số độc giả nên bắt đầu.
Bạn cài bằng pip install tabicl, dùng như bất kỳ mô hình scikit-learn nào, và giấy phép thoáng cho phép dùng thương mại mà không cần đăng ký gì. Tuy nhiên, bảng xếp hạng thay đổi nhanh, và báo cáo TabPFN-3.5 hiện tự xếp trên TabICLv2.
TabFM là mô hình cho dữ liệu bảng của Google Research, phát hành ngày 30/6/2026. Điểm khác biệt là nơi bạn có thể dùng: nó tích hợp trong BigQuery, kho dữ liệu đám mây của Google, nên bạn có thể dự đoán bằng SQL thuần.
-- Use past customers (with known churn) to predict churn for new customers
-- AI.PREDICT is in preview, so check the BigQuery docs for the latest syntax
SELECT *
FROM AI.PREDICT(
  TABLE my_dataset.customers_history,
  TABLE my_dataset.customers_new,
  label_col => 'churned'
);
Điều này rất tiện cho những ai biết SQL nhưng không rành Python.
Tuy nhiên, tài liệu BigQuery hiện giới hạn 20 cột đặc trưng và 10 lớp, và Google dự định áp dụng giá theo token bên trên phí BigQuery tiêu chuẩn từ 30/10/2026. Trọng số mô hình trên Hugging Face là phi thương mại, nên dùng thương mại phải qua BigQuery.
NEXUS là mô hình đóng, chỉ cho doanh nghiệp của Fundamental, một startup ở San Francisco do cựu nhà nghiên cứu DeepMind sáng lập. Ra mắt tháng 2/2026 với 255 triệu USD gọi vốn, công ty gọi đây là một Large Tabular Model (LTM).
Doanh nghiệp mua và vận hành NEXUS qua AWS, và Fundamental cho biết các công ty Fortune 100 đã dùng cho dự báo nhu cầu, định giá và rời bỏ khách hàng. Tuy nhiên, không có trọng số hay kết quả benchmark công khai để tự kiểm chứng, nên tôi coi đây là lựa chọn cấp doanh nghiệp.
tabH2O là mô hình của H2O.ai, với ý tưởng đơn giản: gửi dữ liệu, nhận dự đoán.
Nó tự xử lý giá trị thiếu và cột danh mục cho bạn và có thể chạy trên máy chủ nội bộ của công ty, điều quan trọng với ngân hàng và bệnh viện không thể gửi dữ liệu lên đám mây.
Điều tôi thích là bài tabH2O không thổi phồng quá mức. Nó vượt CatBoost và LightGBM đã tinh chỉnh trên benchmark TALENT, nhưng vẫn xếp sau TabICLv2.
| Mô hình | Nhà phát triển | Trọng số mở? | Quy mô tối đa | Giấy phép | Phù hợp nhất cho |
|---|---|---|---|---|---|
| TabPFN-2 | Prior Labs | Có | 10K hàng | Thương mại kèm ghi công | Dùng thương mại với mô hình cũ đã chứng minh |
| TabPFN-3 / 3.5 | Prior Labs (SAP) | Có, sau khi chấp nhận giấy phép | Tới 1M hàng | Phi thương mại, API trả phí cho doanh nghiệp | Độ chính xác hàng đầu và nghiên cứu |
| TabICLv2 | Inria | Có | Tốt nhất tới 100K hàng | Mã nguồn mở thoáng | Điểm khởi đầu mặc định |
| TabFM | Google Research | Có | 20 đặc trưng trong BigQuery | Trọng số phi thương mại | Người dùng SQL trên BigQuery |
| NEXUS | Fundamental | Không | Không công bố | Độc quyền | Các công ty lớn trên AWS |
| tabH2O | H2O.ai | Không | Không công bố | API thương mại | Nhóm không có hạ tầng ML, tác nhân AI |
Bạn dùng mô hình nền tảng cho dữ liệu bảng trong Python y như bất kỳ mô hình scikit-learn nào.
Cách tốt nhất để thấy giá trị là đặt cạnh XGBoost, vậy hãy làm trên bộ dữ liệu ung thư vú tích hợp của scikit-learn.
Trước hết, cài đặt các gói:
pip install tabicl xgboost scikit-learnRồi chạy cả hai mô hình trên cùng một phép chia:
from sklearn.datasets import load_breast_cancer
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from tabicl import TabICLClassifier
from xgboost import XGBClassifier

# Load a small tabular dataset as a pandas DataFrame
X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# Tabular foundation model: fit() just stores the training rows
tfm = TabICLClassifier()
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)

# XGBoost baseline with reasonable, untuned settings
xgb = XGBClassifier(n_estimators=300, learning_rate=0.05, max_depth=4)
xgb.fit(X_train, y_train)
xgb_preds = xgb.predict(X_test)

print(f"TabICL accuracy:  {accuracy_score(y_test, tfm_preds):.3f}")
print(f"XGBoost accuracy: {accuracy_score(y_test, xgb_preds):.3f}")
Bộ dữ liệu nhỏ này chạy ổn trên CPU của laptop bình thường.
Cả hai mô hình sẽ đạt điểm rất cao trên dữ liệu sạch thế này, nên đừng đánh giá chỉ bằng một phép chia. Bài test thực sự là dữ liệu “lộn xộn” của bạn.
Nếu muốn thử TabPFN, chạy pip install tabpfn, rồi chỉ cần đổi hai dòng:
from tabpfn import TabPFNClassifier

tfm = TabPFNClassifier()  # The first run asks you to accept the license
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)
Một lưu ý quan trọng trước khi so mô hình trên dữ liệu thật.
Nếu dữ liệu có ngày tháng, hãy chia theo thời gian thay vì ngẫu nhiên. Nếu không, mô hình sẽ “liếc” được tương lai, và như bạn sẽ thấy ở phần sau, đó chính là nơi mô hình nền tảng cho dữ liệu bảng trông tốt hơn thực tế.
Chúng hoạt động tốt khi bộ dữ liệu nhỏ đến trung bình và các hàng kiểm thử giống các hàng huấn luyện. Chúng gặp khó với dữ liệu theo thời gian, theo nhóm, bảng rất lớn và yêu cầu giải thích nghiêm ngặt.
Ý tưởng “hàng kiểm thử giống hàng huấn luyện” có tên là IID (độc lập và phân phối như nhau), và đây là điều quan trọng nhất cần kiểm tra về dữ liệu của bạn.
Bắt đầu với những nơi chúng hoạt động tốt:
Giờ đến các hạn chế, điều tôi cho là quan trọng hơn nếu bạn định dùng trong dự án thực.
Benchmark BeyondArena, phát hành tháng 6/2026, kiểm thử 11 mô hình trên 142 bộ dữ liệu, bao gồm các bộ chia theo thời gian (dự đoán tương lai từ quá khứ) và theo nhóm (dự đoán cho bệnh viện hay quốc gia mới).
Kết quả cho thấy mô hình nền tảng cho dữ liệu bảng tốt nhất trên dữ liệu IID nhỏ và trung bình, trong khi mô hình cây và các mô hình deep learning khác vẫn dẫn đầu trên dữ liệu theo thời gian, theo nhóm, rất lớn và rất rộng. Vì đa số dữ liệu doanh nghiệp (bán hàng, gian lận, rời bỏ) được sắp theo thời gian, hạn chế này xuất hiện trong hầu hết dự án thực.
TabPFN-3.5, phát hành sau BeyondArena, đặc biệt tuyên bố thu hẹp khoảng cách trên dữ liệu theo thời gian và theo nhóm. Đó là tín hiệu tốt, nhưng chưa được kiểm chứng độc lập.
Bạn có thể lấy giá trị SHAP từ cả TabICL và TabPFN, nhưng mất nhiều thời gian hơn so với SHAP trên mô hình cây, và không có các nút chia cây để kiểm tra. Trong các lĩnh vực như chấm điểm tín dụng, nơi cơ quan quản lý cần hiểu mô hình, đây là vấn đề thực sự.
Bất cứ gì vượt vài nghìn hàng thực sự muốn có GPU, và dự đoán chậm dần khi dữ liệu huấn luyện lớn lên. Một mô hình XGBoost đã huấn luyện trên CPU sẽ luôn thắng về tốc độ.
Giấy phép cũng rất khác nhau
TabPFN-2 là thương mại kèm ghi công, các bản TabPFN mới hơn là phi thương mại, trọng số TabFM là phi thương mại, còn TabICLv2 thì thoáng.
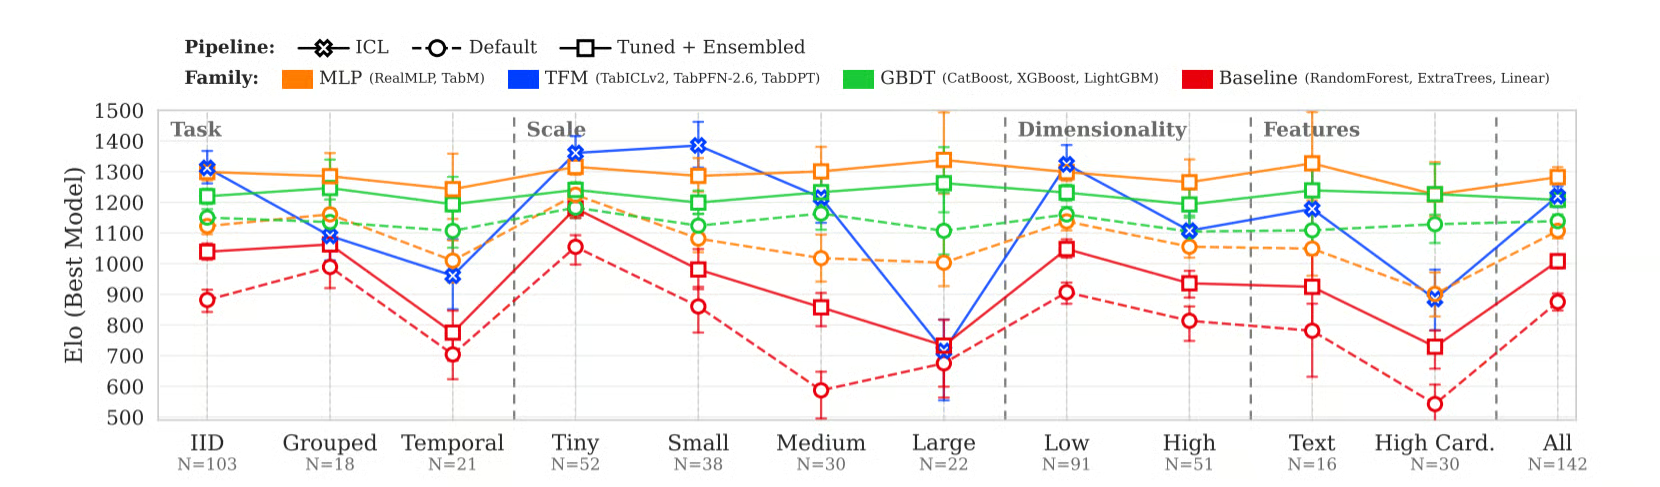
Hình 3: Điểm Elo theo họ mô hình (cao hơn là tốt hơn). Mô hình nền tảng cho dữ liệu bảng dẫn đầu trên dữ liệu IID nhỏ nhưng giảm trên dữ liệu thời gian và dữ liệu lớn, nơi cây và MLP vững hơn. Màu xanh là kết quả tốt nhất của TabICLv2, TabPFN-2.6 và TabDPT, không phải các bản TabPFN mới nhất. Nguồn: Purucker et al., “Beyond IID: How General Are Tabular Foundation Models, Really?” (2026), CC BY 4.0.
Hy vọng bạn đồng ý rằng mô hình nền tảng cho dữ liệu bảng đã nâng tiêu chuẩn cho một baseline nhanh, không tốn công, nhưng mô hình cây vẫn là lựa chọn tốt hơn trong nhiều tình huống thực tế.
Hãy dùng khi bộ dữ liệu của bạn nhỏ đến trung bình và IID, và bạn không cần mô hình hoàn toàn giải thích được hoặc dự đoán rất nhanh trên CPU. Đây là bảng quyết định tôi sẽ dùng:
| Kịch bản | Cách tiếp cận khuyến nghị |
|---|---|
| Dưới 10K hàng, IID, không cần giải thích | Bắt đầu với TabICLv2 hoặc TabPFN |
| 10K đến 100K hàng, IID | Thử TabICLv2 và XGBoost, giữ mô hình thắng |
| 100K đến 1M hàng | Bắt đầu với XGBoost hoặc LightGBM, thử TabPFN-3 làm đối thủ |
| Dữ liệu chia theo thời gian hoặc theo nhóm | Bắt đầu với mô hình cây |
| Cần SHAP, tầm quan trọng đặc trưng hoặc kiểm toán | Mô hình cây với SHAP |
| Dự đoán nhanh không có GPU | Mô hình cây |
| POC nhanh, không có hạ tầng ML | TabICLv2, hoặc BigQuery AI.PREDICT nếu dữ liệu đã ở đó |
| Tác nhân AI cần dự đoán từ bảng | Một API như tabH2O hoặc NEXUS |
Trước khi chọn mô hình, tôi khuyên bạn hỏi ba câu sau:
Và điểm cuối cùng tôi muốn nói là: hãy chạy một mô hình nền tảng cho dữ liệu bảng trước, vì nó chỉ tốn của bạn vài phút. Nếu nó không vượt được XGBoost trên dữ liệu của bạn, giờ bạn biết rằng đầu tư thời gian vào tạo đặc trưng và tinh chỉnh XGBoost là đáng giá.
Hãy nhớ hai sinh viên ở đầu bài? Năm 2026, sinh viên thứ hai, người đã luyện hàng triệu đề, cuối cùng có thể vượt người ôn hàng tuần, ít nhất trên các bảng nhỏ và trung bình.
Mô hình nền tảng cho dữ liệu bảng thay thế việc huấn luyện theo từng bộ dữ liệu bằng tiền huấn luyện, và thay fit() bằng học từ ví dụ.
Điều làm tôi ngạc nhiên nhất là tốc độ cải thiện. TabPFN-2 lần đầu cho thấy năm 2025 rằng mạng nơ-ron có thể vượt cây đã tinh chỉnh trên bảng nhỏ, và TabICLv2 cùng TabPFN-3 đã đẩy giới hạn đó lên bảng lớn hơn nhiều.
Bài toán còn mở hiện nay là dữ liệu theo thời gian, dữ liệu thay đổi, khả năng giải thích và giấy phép — chính là những thứ quyết định mô hình có vào được sản phẩm thật hay không.
Vì vậy, lời khuyên của tôi là hãy coi các mô hình này như điểm khởi đầu mới và chọn công cụ cuối cùng dựa trên dữ liệu, ràng buộc của bạn và nơi mô hình sẽ chạy.
Nếu bạn muốn làm chủ các mô hình cây vẫn thắng trong nhiều tình huống thực tế, hãy xem khóa Machine Learning với mô hình dựa trên cây trong Python và lộ trình Supervised Machine Learning trong Python. Nếu bạn làm việc với R, khóa Machine Learning với mô hình dựa trên cây trong R bao quát nội dung tương tự.
Khóa học DataCamp nổi bật
Lộ trình
Khóa học
Lộ trình
blog
Matt Crabtree
10 phút
