แทร็ก
การพัฒนาโมเดลภาษาขนาดใหญ่
16 ชม.
ลองจินตนาการถึงนักเรียนสองคนทำข้อสอบเดียวกัน คนแรกใช้เวลา 3 สัปดาห์อ่านเพียงหนึ่งวิชา ส่วนคนที่สองฝึกทำข้อสอบมาหลายล้านฉบับ และในวันสอบก็ได้แผ่นตัวอย่างวิธีทำโจทย์มาอ่าน
ตลอดช่วงเวลาส่วนใหญ่ของ แมชชีนเลิร์นนิง โมเดลเชิงตารางก็เป็นเหมือนนักเรียนคนแรก ทุกครั้งที่มีชุดข้อมูลใหม่ ต้องทำความสะอาดคอลัมน์ สร้างฟีเจอร์ ฝึก XGBoost หรือ LightGBM และปรับจูนไฮเปอร์พารามิเตอร์กันเป็นชั่วโมง
Tabular foundation models กลับเหมือนนักเรียนคนที่สอง: เพียงยื่นแถวข้อมูลที่มีป้ายกำกับเป็นตัวอย่างให้ แล้วโมเดลจะทำนายแถวที่เหลือโดย ไม่ต้องฝึกสอนใด ๆ เลย
ในปี 2026 ไอเดียนี้ขยับจากงานวิจัยสู่ผลิตภัณฑ์จริง SAP ทุ่มงบกว่า €1 พันล้านให้ Prior Labs และ Google ก็ปล่อยโมเดลของตนเองออกมา ดังนั้นบทความนี้จะกล่าวถึง:
ไม่ต้องกังวลหากยังไม่มีประสบการณ์ดีปเลิร์นนิงมากนัก โค้ดในบทความนี้ใช้หน้าตาคุ้นเคยแบบ scikit-learn และหากอยากทบทวนสั้น ๆ ก่อน 8 โมเดลแมชชีนเลิร์นนิงอธิบายใน 20 นาที ครอบคลุมพื้นฐานไว้แล้ว
pip install tabiclTabular foundation model คือโครงข่ายประสาทที่ผ่านพรีเทรนบนชุดข้อมูลเชิงตารางสังเคราะห์นับล้านชุด เรียนรู้ยุทธศาสตร์ทั่วไปในการทำนายคอลัมน์เป้าหมาย แล้วนำยุทธศาสตร์นั้นไปใช้กับตารางใหม่ผ่าน in-context learning โดยไม่ต้องฝึกสอนเฉพาะชุดข้อมูล
ความเปลี่ยนแปลงครั้งใหญ่คือ ช่วงเวลา ที่การเรียนรู้เกิดขึ้น
กับ XGBoost การเรียนรู้เกิดขึ้นบนข้อมูลของคุณทุกครั้งที่ฝึกโมเดลใหม่ ส่วนใน foundation model เชิงตาราง การเรียนรู้เกิดขึ้นไปแล้วหลายเดือนก่อนหน้านี้ระหว่างพรีเทรน และข้อมูลของคุณเป็นเพียงอินพุต นอกจากนี้จะมีคำศัพท์ไม่กี่คำที่เจอบ่อย ขออธิบายแบบตรงไปตรงมา:
ต่อไป มาดูว่าโมเดลเชิงตารางเปรียบเทียบกับวิธี บูสต์ติ้ง และ AutoML อย่างไร:
| Tabular foundation models | ต้นไม้แบบกราดิเอนต์บูสต์ (XGBoost, LightGBM) | AutoML (AutoGluon, H2O AutoML) | |
|---|---|---|---|
| เวลาฝึกบนข้อมูลใหม่ | ไม่มี | วินาทีถึงนาที บวกการจูน | นาทีถึงชั่วโมง |
| ความสามารถในการอธิบาย | จำกัด (ทำ SHAP ได้แต่ช้า) | ดี (ความสำคัญของฟีเจอร์, SHAP เร็ว) | แปรผัน มักเป็นเอนซอมเบิลที่อ่านยาก |
| ขนาดชุดข้อมูลที่เหมาะ | หลักร้อยถึงราว 100K แถว | หลักพันถึงหลายล้านแถว | หลักพันถึงล้านแถว |
| ต้องใช้ GPU ไหม? | แนะนำเมื่อเกินไม่กี่พันแถว | ไม่ | โดยมากไม่ |
| ชุดข้อมูลเล็ก แบ่งแบบสุ่ม | ดีที่สุดในเบนช์มาร์กปัจจุบัน | แข็งแกร่งเมื่อจูน | แข็งแกร่งแต่ช้า |
ก่อนดูว่ามันทำงานอย่างไร ขอเทียบกับโมเดลยอดนิยมที่ใช้กันแพร่หลายที่สุดก่อน: large language models
Large language models (LLMs) และ tabular foundation models ต่างก็ใช้ ทรานส์ฟอร์เมอร์ และต่างก็เรียนรู้จากตัวอย่างในอินพุต
ความต่างคือสิ่งที่พวกมันถูกออกแบบมาให้อ่าน LLM อ่านตารางเป็นสตริงข้อความยาว ๆ จึงต้องตีความจากจุลภาคและช่องว่างว่าเลขใดอยู่คอลัมน์เดียวกัน
ยังมีปัญหาความหมายด้วย
ค่า 42 อาจเป็นอายุของใครสักคนหรือรายได้ แต่ตัวเลขเองไม่ได้บอกว่าอย่างไหน โมเดลเชิงตารางถูกฝึกให้มองแต่ละคอลัมน์เป็นตัวแปรของตนเองและแต่ละแถวเป็นหนึ่งตัวอย่าง จึงโฟกัสที่ความสัมพันธ์ระหว่างคอลัมน์
มองแบบนี้จะเข้าใจง่าย: LLM เก่งในการ “พูดถึง” ข้อมูลของคุณ ส่วน foundation model เชิงตารางถูกสร้างมาเพื่อ “คำนวณ” กับมัน
ทั้งสองยังทำงานร่วมกันได้ด้วย ซึ่งเป็นแนวทางที่ H2O.ai วางตำแหน่งโมเดล tabH2O: เป็นเครื่องมือทำนายที่เอเจนต์ AI เรียกใช้เมื่ออยากได้ตัวเลขจากสเปรดชีต
ข้อมูลเชิงตารางยากสำหรับดีปเลิร์นนิงเพราะตารางไม่มีโครงสร้างร่วมที่โครงข่ายประสาทจะเรียนครั้งเดียวแล้วนำไปใช้ซ้ำได้ พิกเซลก็คือพิกเซลในทุกภาพ แต่คอลัมน์ชื่อ score ในชุดข้อมูลการเงินกับคอลัมน์ชื่อ score ในข้อมูลฟุตบอลไม่มีอะไรเหมือนกัน
งานปี 2022 โดย Léo Grinsztajn, Edouard Oyallon และ Gaël Varoquaux เรื่อง Why do tree-based models still outperform deep learning on tabular data? ทดสอบ 45 ชุดข้อมูลและพบว่าโมเดลแบบต้นไม้ โดยเฉพาะ กราดิเอนต์บูสต์ ยังชนะดีปเลิร์นนิงบนตารางขนาดกลางราว 10,000 แถว เหตุผลที่พบคือ:
ปัญหาเชิงปฏิบัติอีกสองอย่างยิ่งทำให้แย่ลง ตารางเดียวอาจปะปนตัวเลข หมวดหมู่ อันดับ และค่าว่าง และตารางธุรกิจส่วนใหญ่มีเพียงหลักร้อยหรือพันแถว ซึ่งน้อยเกินไปสำหรับการฝึกโครงข่ายจากศูนย์
ในมุมมองของผู้เขียน ชุดข้อมูลเล็กคือปัญหาสำคัญสุด โครงข่ายที่ฝึกจากศูนย์บน 800 แถวไม่มีอะไรพึ่งพา ในขณะที่ต้นไม้ไม่ต้องอาศัยความรู้เดิมใด ๆ ก็ทำงานได้
นี่เองที่การพรีเทรนเข้ามาแก้ โมเดลเชิงตารางฝึกซ้อมกับตารางเล็ก ๆ ที่รกและถูกสร้างขึ้นมาหลายล้านชุดก่อนเห็นของคุณ จึงไม่เริ่มจากศูนย์
โมเดลเชิงตารางรับแถวฝึกที่ติดป้ายกำกับและแถวทดสอบที่ไม่ติดป้ายกำกับเป็นอินพุตเดียวกัน แล้วทำนายป้ายกำกับที่ขาดหายไปในหนึ่ง forward pass น้ำหนักของโมเดลไม่เปลี่ยน เช่นเดียวกับ LLM ที่ตอบคำถามหลังได้รับตัวอย่างไม่กี่รายการในพรอมป์ต์
สิ่งนี้ยังทำให้ความหมายของเมธอดคุ้นเคยใน scikit-learn เปลี่ยนไปด้วย
เมื่อเรียก .fit() บน TabICL ตามที่ เอกสาร TabICL อธิบายไว้ มันจะโหลดเช็คพอยต์ที่พรีเทรนไว้ จัดการพรีโพรเซสข้อมูลของคุณ และเก็บไว้ งานจริงเกิดตอน .predict()
ชื่อ .fit() ถูกคงไว้เพื่อให้โมเดลเสียบเข้ากับโค้ด scikit-learn ที่มีอยู่ได้
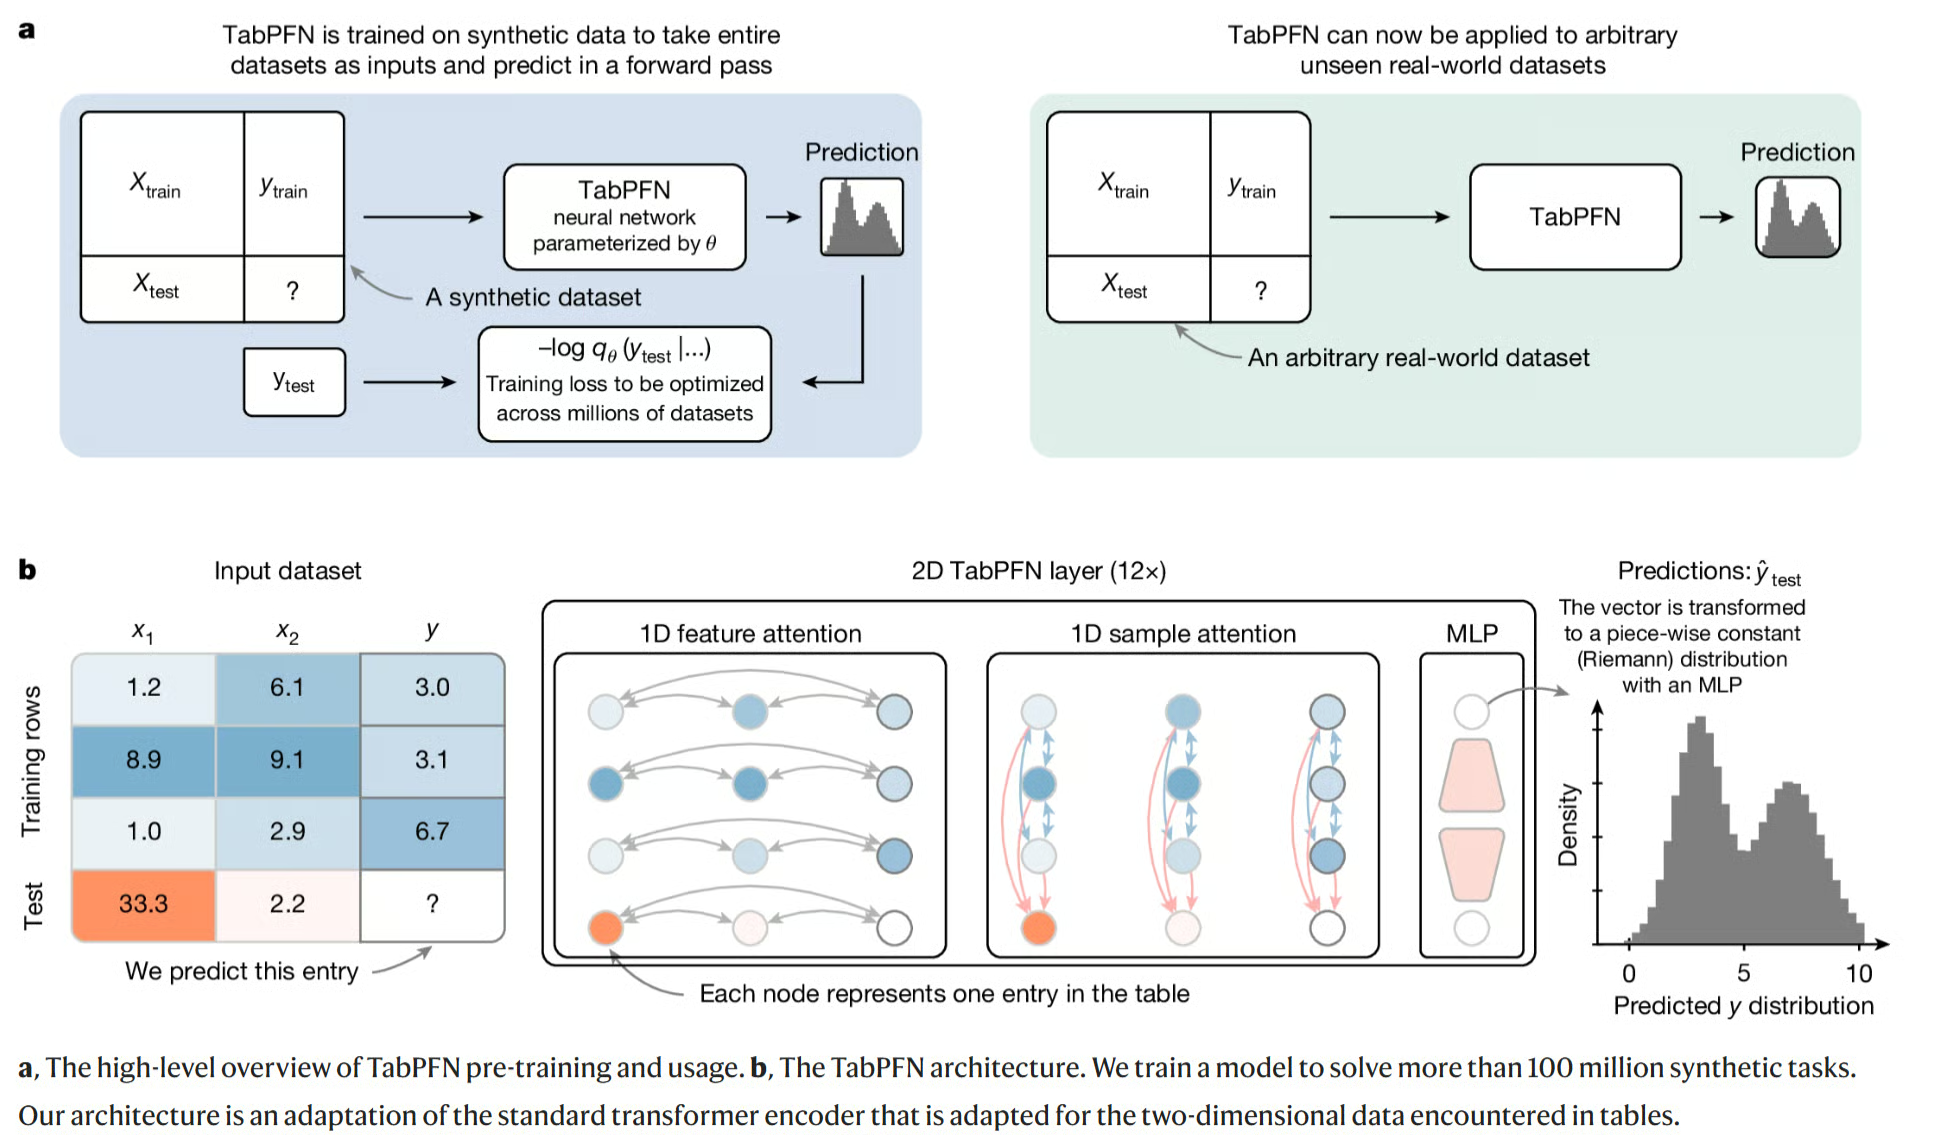
ภาพที่ 1: TabPFN ผ่านพรีเทรนบนชุดข้อมูลสังเคราะห์นับล้านครั้ง แล้วทำนายบนตารางจริงในหนึ่ง forward pass แผงล่างแสดงการให้ความสนใจข้ามฟีเจอร์และตัวอย่าง ที่มา: Hollmann และคณะ, “Accurate predictions on small data with a tabular foundation model”, Nature (2025)
การพรีเทรนแบบสังเคราะห์หมายถึงการฝึกโมเดลบนตารางที่สร้างขึ้น ไม่ใช่ข้อมูลจริง โดยอาศัยตัวสร้างข้อมูลที่ทำงานคล้าย โมเดลกำเนิด
เปรียบเหมือนนักบินฝึกในเครื่องจำลอง นักบินฝึกบินปลอม ๆ นับพันเที่ยวภายใต้สภาพอากาศ สนามบิน และความขัดข้องที่หลากหลาย เพื่อให้เที่ยวบินจริงครั้งแรกไม่รู้สึกแปลกใหม่
TabPFN ทำงานในลักษณะคล้ายกัน
ผู้สร้างเขียนตัวสร้างที่คิดกฎความสัมพันธ์เชิง “เหตุและผล” แบบสุ่มระหว่างคอลัมน์ (เช่น คอลัมน์ A มีผลต่อคอลัมน์ B ซึ่งมีผลต่อเป้าหมาย) แล้วสร้างแถวตามกฎนั้น
ระหว่างพรีเทรนจะซ่อนคอลัมน์เป้าหมายไว้ โมเดลพยายามทำนาย และทำซ้ำเป็นล้านครั้งด้วยกฎ ระดับสัญญาณรบกวน และขนาดตารางที่แตกต่างกัน
สิ่งสำคัญคือ โมเดลไม่เคยเรียน “ข้อเท็จจริง” ของหัวข้อจริงใด ๆ แต่เรียน “ทักษะทั่วไป” เช่น การจับว่าคอลัมน์ไหนสำคัญ การรับมือกับค่านอกกลุ่ม และการรู้ว่าเมื่อใดควรไม่มั่นใจ
จริง ๆ แล้ว งาน TabICLv2 ให้เครดิตตัวสร้างข้อมูลสังเคราะห์รุ่นใหม่ว่าเป็นเหตุผลสำคัญของผลงานที่ดีขึ้น
ไม่จำเป็นต้องเข้าใจรายละเอียดสถาปัตยกรรมทั้งหมด แต่การรู้ว่ามีดีไซน์หลักอยู่สองแบบจะช่วยได้:
โปรดทราบว่าโมเดลทั้งสองตระกูลฝึกบนข้อมูลสังเคราะห์ ดังนั้น “prior-fitted network” จึงบอกวิธีการฝึก ไม่ใช่ชนิดโมเดลที่ต่างกัน
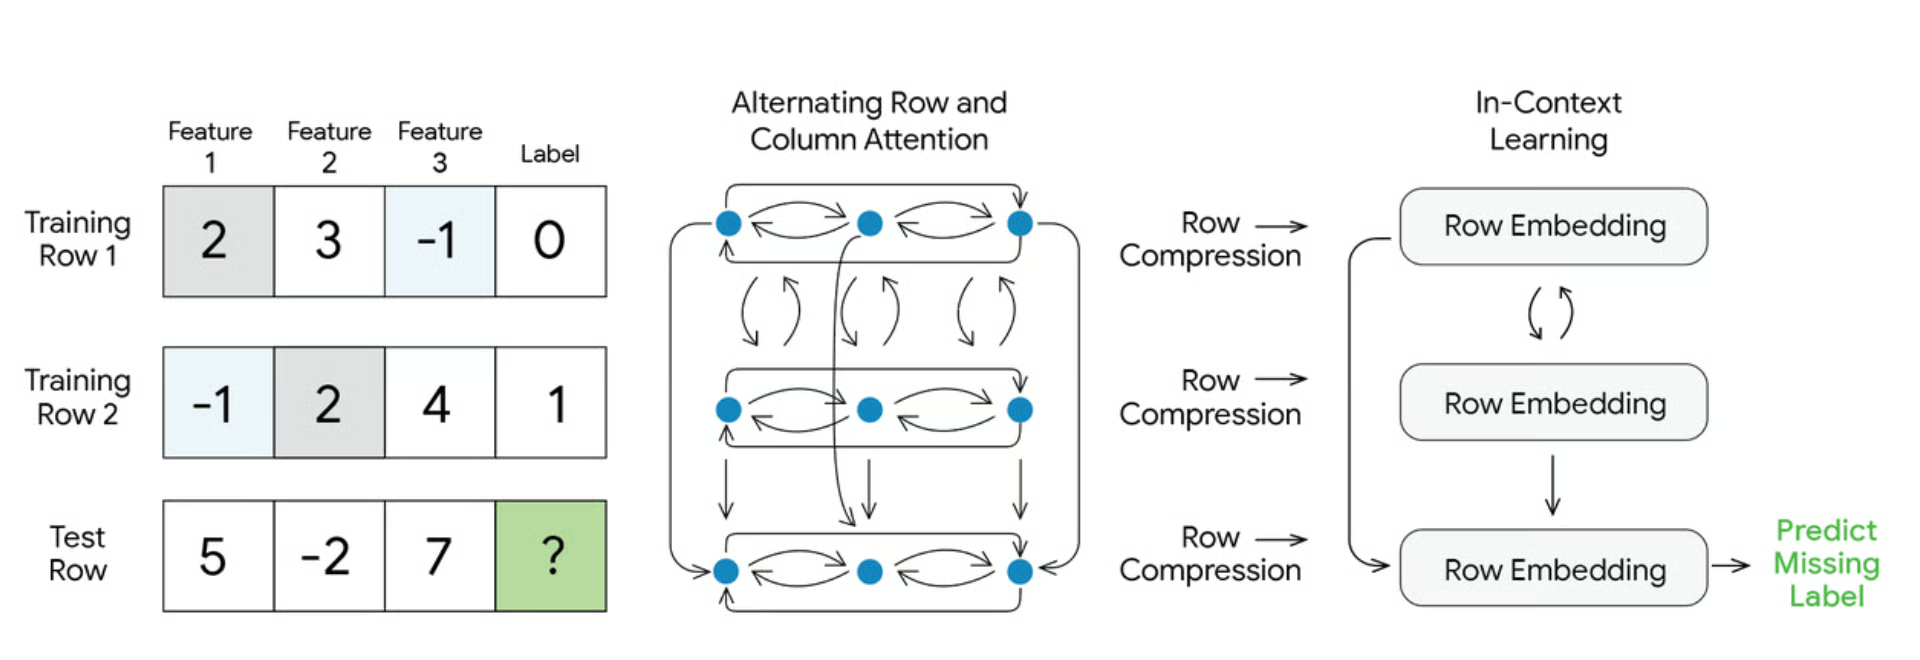
ภาพที่ 2: TabFM ผสมทั้งสองแนวคิด: attention แบบ TabPFN ข้ามแถวและคอลัมน์ จากนั้นบีบอัดแถวแบบ TabICL แล้วจึงทำ in-context learning เพื่อทำนายป้ายกำกับที่ขาด ที่มา: Google Research, “Introducing TabFM: A zero-shot foundation model for tabular data” (2026)
มีข้อแลกเปลี่ยนที่ทำให้หลายคนพลาด
XGBoost ใช้เวลาฝึกครั้งเดียว แล้วพยากรณ์แทบจะทันที
โมเดลเชิงตารางข้ามขั้นตอนการฝึก แต่ต้องอ่านแถวฝึกของคุณทั้งหมดทุกครั้งที่ทำนาย
นึกถึงเชฟที่ไม่เตรียมของก่อนบริการ แต่ต้องกลับไปอ่านตำราอาหารทั้งเล่มทุกครั้งที่มีออร์เดอร์
ถ้าตำราเล่มเล็กก็พอได้ แต่เมื่อชุดข้อมูลโตขึ้น การพยากรณ์จะช้าลง ทั้ง TabICL และ TabPFN แคชผลการ “อ่าน” ข้อมูลฝึกเพื่อเร่งการทำนายซ้ำได้ แต่รอบแรกยังกินเวลา
โมเดลหลักในปี 2026 ได้แก่ TabPFN, TabICLv2, TabFM ของ Google, NEXUS ของ Fundamental และ tabH2O ของ H2O.ai สิ่งที่น่าสนใจคือฝั่งธุรกิจเคลื่อนเร็วมาก เพียงห้าเดือนจากงานวิชาการสู่ดีลใหญ่ ๆ ไทม์ไลน์โดยสรุปมีดังนี้:
ต่อไปมาดูทีละตัว เริ่มจากโมเดลที่จุดประกายหมวดนี้
TabPFN คือโมเดลที่สร้างหมวดนี้ขึ้นมา TabPFN-2 ตีพิมพ์ใน Nature เดือนมกราคม 2025 และชนะโมเดลต้นไม้ที่จูนแล้วบนชุดข้อมูลสูงสุด 10,000 แถว
จากนั้น Prior Labs ก็ปล่อยรุ่นใหม่อย่างรวดเร็ว TabPFN-3 ในเดือนพฤษภาคม 2026 รองรับได้ถึง 1 ล้านแถว (และสูงสุด 200 ฟีเจอร์) และเพิ่มโหมด Thinking (ผ่าน API แบบชำระเงิน) ที่ใช้เวลามากขึ้นในช่วง fit เพื่อทำนายได้ดีขึ้น
รุ่นล่าสุด TabPFN-3.5 ออกในกันยายน 2026 และ รายงานทางเทคนิค อ้างว่าคว้าอันดับหนึ่งในเบนช์มาร์กใหญ่หลายรายการ รวมถึงข้อมูลเรียงตามเวลาและแบ่งตามกลุ่ม แนะนำให้มองว่าเป็นตัวเลขจากบริษัทจนกว่าจะมีผู้อื่นยืนยัน
อีกเรื่องคือสัญญาอนุญาต TabPFN-2 ใช้เชิงพาณิชย์ได้ถ้าให้เครดิต Prior Labs แต่รุ่น 2.5 ถึง 3.5 ไม่อนุญาตเชิงพาณิชย์ หมายความว่าทดลองได้ฟรี แต่ใช้ในผลิตภัณฑ์จริงต้องซื้อไลเซนส์
TabICLv2 คือโมเดลเชิงตารางแบบเปิดที่ดีที่สุดในตอนนี้ พัฒนาโดย Inria เปิดตัวกุมภาพันธ์ 2026 และรับเข้า ICML 2026
ผลลัพธ์เด่นจาก งาน TabICLv2 คือแม้ไม่จูนใด ๆ ก็ชนะ RealTabPFN-2.5 ซึ่งเป็นโมเดลตัวท็อปก่อนหน้า ทั้งที่ตัวนั้นถูกจูน ทำเอนซอมเบิล และไฟน์จูนบนข้อมูลจริงแล้ว
ตาม ที่เก็บ GitHub ยังชนะ XGBoost, CatBoost และ LightGBM ที่จูนหนักในประมาณ 80% ของชุดข้อมูลบนเบนช์มาร์ก TabArena
ยังเร็วด้วย รองรับ 50,000 แถว 100 ฟีเจอร์ในเวลาไม่ถึง 10 วินาทีบน H100 GPU เร็วกว่า TabPFN-2.5 ราว 10 เท่า
ทำงานดีที่สุดระหว่าง 300 ถึง 100,000 แถว และยืดได้ถึงราว 500,000 แถวโดยความแม่นยำลดลงบ้าง
ในความเห็นของผู้เขียน นี่คือจุดเริ่มต้นที่เหมาะกับผู้อ่านส่วนใหญ่
ติดตั้งด้วย pip install tabicl ใช้งานเหมือนโมเดล scikit-learn ทั่วไป และไลเซนส์ผ่อนปรนให้ใช้เชิงพาณิชย์ได้โดยไม่ต้องสมัครอะไร อย่างไรก็ดีตารางผู้นำเปลี่ยนเร็ว และรายงานของ TabPFN-3.5 ตอนนี้จัดตัวเองไว้เหนือ TabICLv2
TabFM คือโมเดลเชิงตารางของ Google Research เปิดตัว 30 มิถุนายน 2026 จุดต่างสำคัญคือ สถานที่ใช้งาน: ฝังอยู่ใน BigQuery คลังข้อมูลบนคลาวด์ของ Google จึงขอพยากรณ์ด้วย SQL ธรรมดาได้
-- Use past customers (with known churn) to predict churn for new customers
-- AI.PREDICT is in preview, so check the BigQuery docs for the latest syntax
SELECT *
FROM AI.PREDICT(
  TABLE my_dataset.customers_history,
  TABLE my_dataset.customers_new,
  label_col => 'churned'
);
เหมาะมากสำหรับผู้ที่ถนัด SQL แต่ไม่ถนัด Python
อย่างไรก็ตาม เอกสาร BigQuery ปัจจุบันจำกัดที่ 20 คอลัมน์ฟีเจอร์และ 10 คลาส และ Google มีแผนคิดราคาตามโทเคนเพิ่มเติมจากค่าบริการ BigQuery มาตรฐานตั้งแต่ 30 ตุลาคม 2026 น้ำหนักโมเดลบน Hugging Face ไม่อนุญาตเชิงพาณิชย์ ดังนั้นการใช้งานเชิงพาณิชย์ต้องผ่าน BigQuery
NEXUS เป็นโมเดลแบบปิดเพื่อธุรกิจจาก Fundamental สตาร์ทอัพซานฟรานซิสโกโดยอดีตนักวิจัย DeepMind เปิดตัวกุมภาพันธ์ 2026 พร้อมเงินทุน $255M บริษัทเรียกมันว่า Large Tabular Model (LTM)
ธุรกิจซื้อและรัน NEXUS ผ่าน AWS และ Fundamental ระบุว่าบริษัท Fortune 100 ใช้งานแล้วในงานคาดการณ์อุปสงค์ ตั้งราคา และชะลดลูกค้า แต่ไม่มีน้ำหนักโมเดลหรือผลเบนช์มาร์กสาธารณะให้ตรวจสอบ จึงควรมองเป็นตัวเลือกระดับเอนเตอร์ไพรส์
tabH2O คือโมเดลของ H2O.ai และแนวคิดหลักเรียบง่าย: ส่งข้อมูลของคุณมา แล้วรับผลพยากรณ์กลับ
จัดการค่าว่างและคอลัมน์หมวดหมู่ให้ และรันบนเซิร์ฟเวอร์ขององค์กรได้ ซึ่งสำคัญสำหรับธนาคารและโรงพยาบาลที่ไม่สามารถส่งข้อมูลขึ้นคลาวด์
จุดที่ชอบคือ งาน tabH2O ไม่โอ้อวดเกินจริง ทำคะแนนชนะ CatBoost และ LightGBM ที่จูนแล้วบนเบนช์มาร์ก TALENT แต่ยังตามหลัง TabICLv2
| โมเดล | ผู้พัฒนา | เปิดน้ำหนักไหม? | สเกลสูงสุด | ไลเซนส์ | เหมาะสำหรับ |
|---|---|---|---|---|---|
| TabPFN-2 | Prior Labs | เปิด | 10K แถว | เชิงพาณิชย์พร้อมให้เครดิต | การใช้งานเชิงพาณิชย์ของโมเดลรุ่นเก่าที่พิสูจน์แล้ว |
| TabPFN-3 / 3.5 | Prior Labs (SAP) | เปิด หลังยอมรับไลเซนส์ | สูงสุด 1M แถว | ไม่เชิงพาณิชย์ API แบบชำระเงินสำหรับธุรกิจ | ความแม่นยำสูงสุดและงานวิจัย |
| TabICLv2 | Inria | เปิด | ดีที่สุดถึง 100K แถว | โอเพ่นซอร์สแบบผ่อนปรน | จุดเริ่มต้นเริ่มต้นของคุณ |
| TabFM | Google Research | เปิด | 20 ฟีเจอร์ใน BigQuery | น้ำหนักไม่เชิงพาณิชย์ | ผู้ใช้ SQL บน BigQuery |
| NEXUS | Fundamental | ไม่เปิด | ไม่เปิดเผย | กรรมสิทธิ์ | บริษัทยักษ์บน AWS |
| tabH2O | H2O.ai | ไม่เปิด | ไม่เปิดเผย | API เชิงพาณิชย์ | ทีมที่ไม่มีระบบ ML ตั้งต้น เอเจนต์ AI |
ใช้งาน tabular foundation model ใน Python ได้เหมือนโมเดล scikit-learn อื่น ๆ ทุกประการ
วิธีเห็นประโยชน์ชัดที่สุดคือจับชนกับ XGBoost มาลองบนชุดข้อมูลมะเร็งเต้านมของ scikit-learn
อันดับแรก ติดตั้งแพ็กเกจ:
pip install tabicl xgboost scikit-learnจากนั้นรันทั้งสองโมเดลบนสPLIT เดียวกัน:
from sklearn.datasets import load_breast_cancer
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from tabicl import TabICLClassifier
from xgboost import XGBClassifier

# Load a small tabular dataset as a pandas DataFrame
X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# Tabular foundation model: fit() just stores the training rows
tfm = TabICLClassifier()
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)

# XGBoost baseline with reasonable, untuned settings
xgb = XGBClassifier(n_estimators=300, learning_rate=0.05, max_depth=4)
xgb.fit(X_train, y_train)
xgb_preds = xgb.predict(X_test)

print(f"TabICL accuracy:  {accuracy_score(y_test, tfm_preds):.3f}")
print(f"XGBoost accuracy: {accuracy_score(y_test, xgb_preds):.3f}")
ชุดข้อมูลเล็กแบบนี้รันบน CPU แล็ปท็อปทั่วไปได้สบาย
ทั้งสองโมเดลจะทำคะแนนสูงมากบนข้อมูลที่สะอาดขนาดนี้ อย่าตัดสินจากสPLIT เดียว การทดสอบจริงคืองานข้อมูลรก ๆ ของคุณเอง
ถ้าอยากลอง TabPFN แทน ให้รัน pip install tabpfn แล้วเปลี่ยนสองบรรทัดเท่านั้น:
from tabpfn import TabPFNClassifier

tfm = TabPFNClassifier()  # The first run asks you to accept the license
tfm.fit(X_train, y_train)
tfm_preds = tfm.predict(X_test)
อีกเรื่องสำคัญก่อนเปรียบเทียบโมเดลบนข้อมูลจริง
หากข้อมูลมีวันที่ ให้แบ่งตามลำดับเวลาแทนการสุ่ม ไม่เช่นนั้นโมเดลจะได้แอบมองอนาคต และตามที่จะเห็นในหัวข้อต่อไป นั่นคือบริเวณที่ foundation models เชิงตารางดูดีกว่าความจริง
โมเดลเชิงตารางทำงานดีเมื่อชุดข้อมูลมีขนาดเล็กถึงกลาง และแถวทดสอบมีลักษณะเหมือนแถวฝึก มักลำบากกับข้อมูลตามลำดับเวลา ข้อมูลแบ่งตามกลุ่ม ตารางใหญ่มาก ๆ และกรณีที่ต้องอธิบายได้เข้มงวด
แนวคิด “แถวทดสอบเหมือนแถวฝึก” นี้มีชื่อว่า IID (independent and identically distributed) และเป็นสิ่งสำคัญที่สุดที่ต้องตรวจในข้อมูลของคุณ
เริ่มจากจุดแข็ง:
ต่อไปคือข้อจำกัด ซึ่งสำคัญยิ่งขึ้นหากคิดจะใช้จริงในโปรเจกต์
เบนช์มาร์ก BeyondArena เปิดตัวมิถุนายน 2026 ทดสอบ 11 โมเดลบน 142 ชุดข้อมูล รวมถึงการแบ่งตามเวลา (ทำนายอนาคตจากอดีต) และแบ่งตามกลุ่ม (ทำนายสำหรับโรงพยาบาลหรือประเทศใหม่)
ผลคือโมเดลเชิงตารางเด่นบนข้อมูล IID ขนาดเล็กและกลาง ขณะที่โมเดลต้นไม้และดีปเลิร์นนิงแบบอื่นยังนำบนข้อมูลเรียงเวลา แบ่งกลุ่ม ชุดใหญ่ และมิติเยอะ เนื่องจากข้อมูลธุรกิจส่วนใหญ่ (ยอดขาย ทุจริต ชะลด) เรียงตามเวลา ข้อจำกัดนี้จึงโผล่ในโปรเจกต์จริงจำนวนมาก
TabPFN-3.5 ซึ่งออกหลัง BeyondArena อ้างโดยเฉพาะว่าปิดช่องว่างนี้บนข้อมูลเรียงเวลาและแบ่งกลุ่ม น่าสนใจแต่ยังไม่มีการทดสอบโดยอิสระ
ทั้ง TabICL และ TabPFN ให้ค่า SHAP ได้ แต่ใช้เวลานานกว่า SHAP บนโมเดลต้นไม้ มาก และไม่มีจุดแบ่งของต้นไม้ให้ตรวจ ในโดเมนอย่างเครดิตสกอริงที่หน่วยงานกำกับต้องเข้าใจโมเดล นี่คือปัญหาจริง
อะไรก็ตามที่เกินไม่กี่พันแววย่อมต้องการ GPU และการพยากรณ์จะช้าลงเมื่อข้อมูลฝึกโตขึ้น XGBoost ที่ฝึกแล้วบน CPU จะชนะด้านความเร็วเสมอ
TabPFN-2 ใช้เชิงพาณิชย์ได้พร้อมเครดิต รุ่นใหม่ของ TabPFN ไม่เชิงพาณิชย์ น้ำหนัก TabFM ไม่เชิงพาณิชย์ ส่วน TabICLv2 เป็นแบบผ่อนปรน
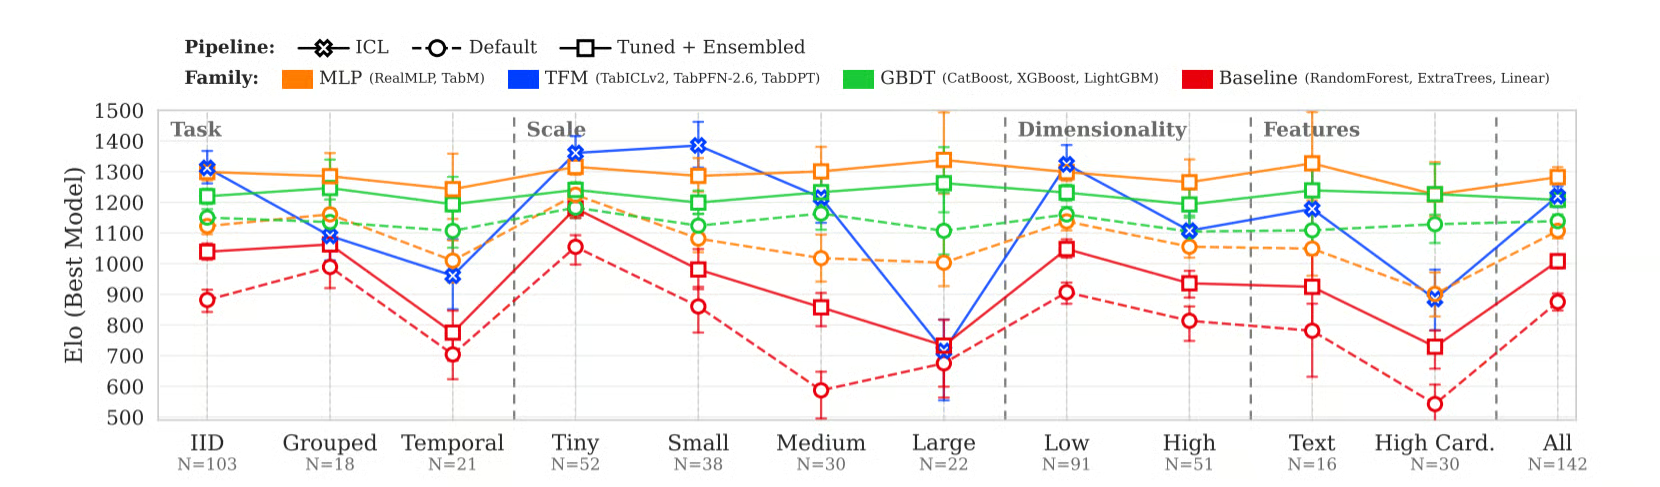
ภาพที่ 3: คะแนน Elo แยกตามตระกูลโมเดล (สูงกว่าดีกว่า) โมเดลเชิงตารางนำบนข้อมูล IID ขนาดเล็ก แต่ตกลงบนข้อมูลตามเวลาและชุดใหญ่ ซึ่งต้นไม้และ MLP ทนทานกว่า สีน้ำเงินคือโมเดลที่ดีที่สุดในกลุ่ม TabICLv2, TabPFN-2.6 และ TabDPT ไม่ใช่ TabPFN รุ่นใหม่ล่าสุด ที่มา: Purucker และคณะ, “Beyond IID: How General Are Tabular Foundation Models, Really?” (2026), CC BY 4.0
หวังว่าจะเห็นพ้องกันว่าโมเดลเชิงตารางยกระดับมาตรฐานของเบสไลน์แบบเร็ว-ไม่ต้องออกแรงให้ดีขึ้นมาก แต่โมเดลต้นไม้ก็ยังเป็นตัวเลือกที่ดีกว่าในหลายสถานการณ์จริง
ควรใช้โมเดลเชิงตารางเมื่อชุดข้อมูลของคุณมีขนาดเล็กถึงกลางและเป็น IID และไม่ต้องการโมเดลที่อธิบายได้เต็มที่หรือการพยากรณ์ที่เร็วมากบน CPU ต่อไปนี้คือ “ตารางตัดสินใจ” ที่แนะนำ:
| สถานการณ์ | แนวทางแนะนำ |
|---|---|
| ต่ำกว่า 10K แถว เป็น IID ไม่มีข้อกำหนดอธิบาย | เริ่มด้วย TabICLv2 หรือ TabPFN |
| 10K ถึง 100K แถว เป็น IID | ทดสอบ TabICLv2 และ XGBoost เก็บตัวที่ชนะ |
| 100K ถึง 1M แถว | เริ่มด้วย XGBoost หรือ LightGBM แล้วลอง TabPFN-3 เป็นผู้ท้าชิง |
| ข้อมูลแบ่งตามเวลา หรือแบ่งตามกลุ่ม | เริ่มด้วยโมเดลต้นไม้ |
| ต้องการ SHAP ความสำคัญฟีเจอร์ หรือการตรวจสอบ | โมเดลต้นไม้พร้อม SHAP |
| พยากรณ์เร็วโดยไม่ใช้ GPU | โมเดลต้นไม้ |
| พิสูจน์แนวคิดแบบเร็ว ไม่ต้องตั้งระบบ ML | TabICLv2 หรือ BigQuery AI.PREDICT หากข้อมูลอยู่ที่นั่นแล้ว |
| เอเจนต์ AI ที่ต้องการพยากรณ์จากตาราง | API อย่าง tabH2O หรือ NEXUS |
ก่อนเลือกโมเดล แนะนำให้ถามสามคำถามนี้:
ข้อสุดท้าย อยากให้ลองรันโมเดลเชิงตารางก่อน เพราะใช้เวลาไม่กี่นาที หากมันชนะ XGBoost บนข้อมูลของคุณไม่ได้ ก็รู้แล้วว่าการลงทุนทำฟีเจียร์และจูน XGBoost นั้นคุ้มค่า
จำสองนักเรียนจากต้นบทความได้ไหม? ในปี 2026 นักเรียนคนที่สอง ผู้ฝึกทำข้อสอบมาหลายล้านครั้ง ในที่สุดก็ชนะคนที่อ่านหนังสือเป็นสัปดาห์ ๆ อย่างน้อยบนตารางขนาดเล็กและกลาง
โมเดลเชิงตารางแทนที่การฝึกเฉพาะชุดข้อมูลด้วยการพรีเทรน และแทนที่ fit() ด้วยการเรียนจากตัวอย่าง
สิ่งที่น่าประหลาดใจที่สุดคือความเร็วของการพัฒนา TabPFN-2 แสดงในปี 2025 ว่าโครงข่ายประสาทชนะต้นไม้ที่จูนแล้วบนตารางเล็กได้ และ TabICLv2 กับ TabPFN-3 ก็ขยายขอบเขตไปสู่ตารางใหญ่กว่านั้น
โจทย์เปิดในตอนนี้คือข้อมูลตามเวลา ข้อมูลที่เปลี่ยนแปลง การอธิบายผล และไลเซนส์ ซึ่งล้วนเป็นปัจจัยตัดสินว่าโมเดลจะได้ไปอยู่ในผลิตภัณฑ์จริงหรือไม่
ข้อแนะนำคือมองโมเดลเหล่านี้เป็นจุดเริ่มต้นใหม่ แล้วเลือกเครื่องมือสุดท้ายตามข้อมูลของคุณ ข้อจำกัดของคุณ และสภาพแวดล้อมที่จะรัน
และหากอยากเชี่ยวชาญโมเดลต้นไม้ที่ยังชนะในสถานการณ์จริงอีกมาก ลองดูคอร์ส Machine Learning with Tree-Based Models in Python และแทร็ก Supervised Machine Learning in Python หากทำงานด้วย R มีคอร์ส Machine Learning with Tree-Based Models in R ครอบคลุมเนื้อหาเดียวกัน
คอร์สยอดนิยมจาก DataCamp
แทร็ก
คอร์ส
แทร็ก