

Ce este PySpark?
PySpark este API-ul Python pentru Apache Spark. Codul tău Python descrie transformările dorite, iar motorul Spark, care rulează pe Java Virtual Machine (JVM), le planifică și le execută în întregul cluster. Obții execuția distribuită a lui Spark fără să scrii Scala sau Java.
Data scientist-ii folosesc PySpark pentru a curăța și agrega seturi mari de date, data engineer-ii îl folosesc pentru pipeline-uri ETL, iar ambele categorii folosesc pyspark.ml pentru a antrena modele pe date care nu încap pe o singură mașină. Dacă îți petreci majoritatea timpului în pandas, API-ul DataFrame îți va părea familiar.
Când să folosești PySpark în loc de pandas
PySpark merită când datele depășesc o singură mașină; sub acest prag, pandas este de obicei mai rapid deoarece nu are costuri de pornire JVM sau de programare a task-urilor.
| Caracteristică | pandas | PySpark |
|---|---|---|
| Mărimea datelor | Limitată de RAM-ul unei singure mașini | Limitată de memoria și discul combinate ale clusterului |
| Execuție | Imediată, în principal pe un singur nucleu | Leneșă, în paralel pe nuclee sau mașini |
| Cost de pornire | Niciunul | Câteva secunde pentru a porni JVM și SparkSession |
| Date în streaming | Nesuportat | Structured Streaming |
| Învățare automată | Ecosistemul scikit-learn | pyspark.ml (distribuit) |
| Toleranță la erori | Inexistentă; o cădere pierde munca | Partițiile pierdute sunt recomputate din linia lor de proveniență |
Regula mea practică: dacă datele încap în memorie cu marjă și sarcina rulează pe un singur laptop, rămâi la pandas. Treci la PySpark când te lupți cu erori de memorie sau când sarcina va rula în cele din urmă pe un cluster sau pe o platformă precum Databricks.
Cum instalezi PySpark
PySpark se instalează din PyPI cu o singură comandă pip, care include și runtime-ul Spark, astfel încât nu ai nevoie de un download separat de Spark sau Hadoop pentru lucru local. Înainte să o rulezi, verifică cele două prerechizite.
Prerechizite
Conform ghidului oficial de instalare, PySpark 4.3 necesită:
- Python 3.11 sau mai nou. PySpark 4.3 a renunțat la Python 3.10; vezi ghidul nostru de configurare Python dacă ai nevoie de o versiune mai nouă.
- Java 17 sau mai nou (Spark 4.3 rulează pe Java 17, 21 și 25) cu variabila de mediu
JAVA_HOMEsetată către aceasta. Ghidul nostru pentru instalarea Java explică pașii pentru fiecare sistem de operare.
Poți verifica ambele dintr-un terminal:
python3 --version # Python 3.11 or later
java -version # openjdk version "17" or laterDacă lucrezi în DataLab sau Databricks, PySpark este deja instalat și poți trece direct la setul de date.
Instalarea PySpark cu pip
Îți recomand un mediu virtual ca să eviți coliziuni între dependențele PySpark și alte proiecte:
python3 -m venv pyspark-env
source pyspark-env/bin/activate
pip install "pyspark[sql]" "pandas<3"
python3 -c "import pyspark; print(pyspark.__version__)"4.3.0Pe Windows, folosește python în loc de python3 și activează mediul cu pyspark-env\Scripts\activate. Extra-ul [sql] adaugă pandas, PyArrow și NumPy, pe care PySpark le folosește pentru toPandas() și pandas UDF-uri. Fixez pandas<3 deoarece PySpark 4.3 afișează un avertisment că încă nu suportă complet pandas 3.0.
Două erori explică majoritatea eșecurilor la prima rulare:
JAVA_GATEWAY_EXITEDsau "Unable to locate a Java Runtime": Java lipsește sauJAVA_HOMEnu este setată.PYTHON_VERSION_MISMATCH: Procesele worker ale Spark au preluat un alt Python decât scriptul tău. SeteazăPYSPARK_PYTHONcătre interpretul mediului tău, de exempluexport PYSPARK_PYTHON=$(which python).
Pentru pași specifici sistemului de operare, inclusiv Windows, vezi ghidul nostru de instalare PySpark.
Obținerea setului de date
Exemplele folosesc un set de date e-commerce cu 541.909 tranzacții ale unui retailer online din Marea Britanie, acoperind perioada decembrie 2010 – decembrie 2011. Fiecare rând reprezintă o linie de produs pe o factură, cu 8 coloane:
InvoiceNo: numărul facturii (numerele care încep cu "C" sunt anulări)StockCodeșiDescription: codul și numele produsuluiQuantityșiUnitPrice: unități cumpărate și preț pe unitate, în lire sterlineInvoiceDate: data și ora achizițieiCustomerID: identificatorul clientului (lipsește pe unele rânduri)Country: țara clientului
Îl poți descărca ca datacamp_ecommerce.csv de pe pagina setului de date DataLab. Este setul de date Online Retail din UCI Machine Learning Repository, astfel încât poți construi același fișier și din sursa publică (necesită pip install openpyxl):
import io
import urllib.request
import zipfile
import pandas as pd
url = "https://archive.ics.uci.edu/static/public/352/online+retail.zip"
with urllib.request.urlopen(url) as response:
archive = zipfile.ZipFile(io.BytesIO(response.read()))
retail = pd.read_excel(
archive.open("Online Retail.xlsx"),
dtype={"InvoiceNo": str, "StockCode": str, "CustomerID": "Int64"},
)
# Match the DataLab file's date format, e.g. 12/1/10 8:26
retail["InvoiceDate"] = retail["InvoiceDate"].map(
lambda ts: f"{ts.month}/{ts.day}/{ts:%y} {ts.hour}:{ts:%M}"
)
retail.to_csv("datacamp_ecommerce.csv", index=False)Citirea fișierului Excel de 23 MB durează aproximativ un minut. Salvează CSV-ul în folderul din care vei rula restul codului.
Crearea unui SparkSession
Un SparkSession este punctul de intrare pentru orice program PySpark: leagă codul tău Python de motorul Spark și creează DataFrame-uri. Creezi unul per aplicație, folosind builder pattern:
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("PySparkTutorial").getOrCreate()
print(spark.version)4.3.0getOrCreate() returnează sesiunea deja pornită dacă există una, deci e sigur să o apelezi de două ori într-un notebook. Lansat dintr-un proces Python obișnuit, Spark rulează în modul local (local[*]), folosind fiecare nucleu CPU al mașinii tale ca worker, și servește interfața Spark la http://localhost:4040 pentru monitorizarea joburilor. Când ai terminat, spark.stop() eliberează resursele.
Încărcarea setului de date e-commerce
Cu sesiunea pornită, putem citi fișierul CSV într-un DataFrame. Trec o schemă explicită în loc de inferSchema=True, care face ca Spark să scaneze încă o dată întregul fișier doar pentru a ghici tipurile coloanelor:
import pyspark.sql.functions as F
schema = """
InvoiceNo STRING, StockCode STRING, Description STRING, Quantity INT,
InvoiceDate STRING, UnitPrice DOUBLE, CustomerID INT, Country STRING
"""
orders = spark.read.csv(
"datacamp_ecommerce.csv", header=True, schema=schema, escape='"'
)
orders = orders.withColumn("InvoiceDate", F.to_timestamp("InvoiceDate", "M/d/yy H:mm"))
orders.printSchema()root
|-- InvoiceNo: string (nullable = true)
|-- StockCode: string (nullable = true)
|-- Description: string (nullable = true)
|-- Quantity: integer (nullable = true)
|-- InvoiceDate: timestamp (nullable = true)
|-- UnitPrice: double (nullable = true)
|-- CustomerID: integer (nullable = true)
|-- Country: string (nullable = true)Două detalii din fragmentul de mai sus contează:
escape='"'gestionează numele de produse care conțin ghilimele duble, cum ar fiRECORD FRAME 7"" SINGLE SIZE. Caracterul de escape implicit al Spark este backslash.- Modelul de dată
M/d/yy H:mmse potrivește cu valori precum12/1/10 8:26. Începând cu Spark 4.0, modul ANSI SQL este activ implicit, așa căto_timestamp()ridică o eroareCANNOT_PARSE_TIMESTAMPpentru o valoare care nu se potrivește cu modelul. FoloseșteF.try_to_timestamp()dacă preferi să obțiiNULLpentru rândurile invalide.
Pentru a vedea primele rânduri și a le număra:
orders.show(5, truncate=False)
print(orders.count())+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|InvoiceNo|StockCode|Description |Quantity|InvoiceDate |UnitPrice|CustomerID|Country |
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|536365 |85123A |WHITE HANGING HEART T-LIGHT HOLDER |6 |2010-12-01 08:26:00|2.55 |17850 |United Kingdom|
|536365 |71053 |WHITE METAL LANTERN |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84406B |CREAM CUPID HEARTS COAT HANGER |8 |2010-12-01 08:26:00|2.75 |17850 |United Kingdom|
|536365 |84029G |KNITTED UNION FLAG HOT WATER BOTTLE|6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84029E |RED WOOLLY HOTTIE WHITE HEART. |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
only showing top 5 rows
541909Pentru mai multe opțiuni de citire, precum fișiere multiple, delimitatori și înregistrări corupte, vezi tutorialul nostru PySpark pentru citirea CSV.
RDD-uri vs. DataFrame-uri
RDD-urile și DataFrame-urile sunt cele două modalități prin care PySpark reprezintă date distribuite, iar pentru aproape tot codul nou, DataFrame-urile sunt alegerea potrivită.
| Abstracție | Ce este | Când să o folosești |
|---|---|---|
| RDD (Resilient Distributed Dataset) | Colecție de nivel jos, imuabilă, de obiecte Python arbitrare, împărțită în partiții | Date nestructurate sau când ai nevoie de control fin asupra partiționării |
| DataFrame | Tabel distribuit cu coloane denumite și tipizate, similar cu un DataFrame pandas | Analiză, interogări SQL, ETL și machine learning |
Iată aceeași agregare, cantitatea totală pe țară, scrisă în ambele moduri:
sales = [("United Kingdom", 6), ("France", 24), ("United Kingdom", 8)]
# RDD: scrii logica cu funcții Python
rdd = spark.sparkContext.parallelize(sales)
print(rdd.reduceByKey(lambda a, b: a + b).collect())
# DataFrame: declari rezultatul, iar Spark plănuiește cum să-l calculeze
sales_df = spark.createDataFrame(sales, ["country", "quantity"])
sales_df.groupBy("country").sum("quantity").show()[('France', 24), ('United Kingdom', 14)]
+--------------+-------------+
| country|sum(quantity)|
+--------------+-------------+
|United Kingdom| 14|
| France| 24|
+--------------+-------------+Versiunea RDD rulează lambda-ul tău în procese worker Python. Versiunea DataFrame trece prin optimizerul Catalyst al Spark, care rescrie interogarea într-un plan eficient ce rulează în JVM, așa că de obicei codul pe DataFrame este mai rapid fără reglaje. Restul tutorialului folosește DataFrame-uri.
Evaluare întârziată: Transformări vs. Acțiuni
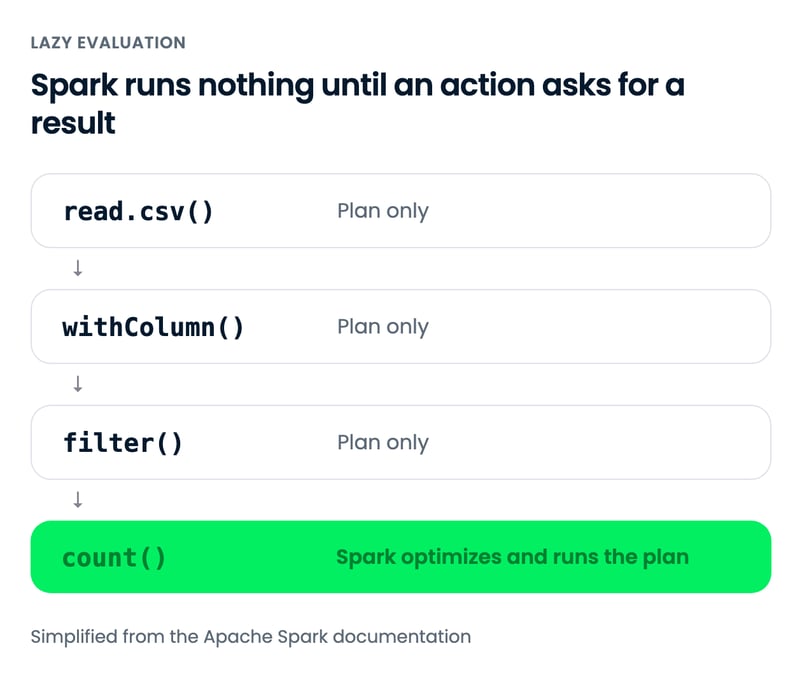
Evaluarea întârziată înseamnă că Spark nu execută o transformare când o apelezi; înregistrează pasul într-un plan și rulează întregul plan doar când o acțiune cere un rezultat.
| Transformări | Acțiuni | |
|---|---|---|
| Ce fac | Descriu un nou DataFrame | Returnează un rezultat sau scriu date |
| Când rulează | Niciodată de unele singure | Imediat, declanșând fiecare transformare în așteptare |
| Exemple | select(), filter(), withColumn(), groupBy(), join() | show(), count(), collect(), toPandas(), write |
Filtrul de mai jos returnează instant, chiar dacă setul de date are peste jumătate de milion de rânduri, pentru că încă nu s-a citit nimic. Apelul count() este cel care lansează un job:
uk_orders = orders.filter(F.col("Country") == "United Kingdom") # transformation: no job yet
print(uk_orders.count()) # action: Spark reads the file now495478Așteptarea până la o acțiune îi permite lui Spark să optimizeze întregul lanț dintr-odată. explain() afișează planul fizic ales (scurtat aici):
uk_orders.explain()== Physical Plan ==
*(1) Project [InvoiceNo#0, StockCode#1, ...]
+- *(1) Filter (isnotnull(Country#7) AND (Country#7 = United Kingdom))
+- FileScan csv [...] PushedFilters: [IsNotNull(Country), EqualTo(Country,United Kingdom)], ...Intrarea PushedFilters arată cum Spark împinge filtrul pe țară în citirea fișierului, astfel încât rândurile din alte țări sunt eliminate pe măsură ce CSV-ul este citit. O consecință practică: o eroare de date într-o transformare, cum ar fi o dată care nu poate fi parsată în modul ANSI, apare abia când rulează următoarea acțiune, câteva linii mai jos.
Operațiuni uzuale pe DataFrame
Majoritatea codului PySpark este un lanț din cinci operațiuni pe DataFrame: select(), filter(), withColumn(), groupBy() și join(). Fiecare returnează un nou DataFrame, deci le poți înlănțui în orice ordine.
Selectarea coloanelor cu select()
select() returnează un DataFrame doar cu coloanele pe care le numești:
orders.select("InvoiceNo", "Description", "Quantity", "UnitPrice").show(3, truncate=False)+---------+----------------------------------+--------+---------+
|InvoiceNo|Description |Quantity|UnitPrice|
+---------+----------------------------------+--------+---------+
|536365 |WHITE HANGING HEART T-LIGHT HOLDER|6 |2.55 |
|536365 |WHITE METAL LANTERN |6 |3.39 |
|536365 |CREAM CUPID HEARTS COAT HANGER |8 |2.75 |
+---------+----------------------------------+--------+---------+
only showing top 3 rowsFiltrarea rândurilor cu filter()
filter() păstrează rândurile care îndeplinesc o condiție. Acest set de date amestecă vânzări cu anulări (numere de factură care încep cu „C”), cantități negative și rânduri fără client, așa că voi păstra doar vânzările valide:
sales_only = orders.filter(
(F.col("Quantity") > 0)
& (F.col("UnitPrice") > 0)
& F.col("CustomerID").isNotNull()
& ~F.col("InvoiceNo").startswith("C")
)
print(sales_only.count())397884Combină condițiile cu & (și), | (sau) și ~ (nu) și pune fiecare condiție între paranteze, fiindcă altfel ordinea operatorilor din Python ar evalua & înainte de >. Tutorialul nostru PySpark pentru filter acoperă mai multe tipare.
Adăugarea de coloane cu withColumn()
withColumn() adaugă o coloană sau o înlocuiește pe una cu același nume. Aici calculează valoarea fiecărei linii:
sales_only = sales_only.withColumn("TotalAmount", F.round(F.col("Quantity") * F.col("UnitPrice"), 2))
sales_only.select("InvoiceNo", "Quantity", "UnitPrice", "TotalAmount").show(3)+---------+--------+---------+-----------+
|InvoiceNo|Quantity|UnitPrice|TotalAmount|
+---------+--------+---------+-----------+
| 536365| 6| 2.55| 15.3|
| 536365| 6| 3.39| 20.34|
| 536365| 8| 2.75| 22.0|
+---------+--------+---------+-----------+
only showing top 3 rowsVezi tutorialul nostru PySpark withColumn() pentru coloane condiționale cu F.when().
Agregarea cu groupBy() și agg()
groupBy() grupează rândurile după una sau mai multe coloane, iar agg() calculează una sau mai multe sumarizări pe grup. Care țări aduc cele mai mari venituri?
country_revenue = (
sales_only.groupBy("Country")
.agg(
F.count_distinct("CustomerID").alias("customers"),
F.round(F.sum("TotalAmount"), 2).alias("revenue"),
)
.orderBy(F.desc("revenue"))
)
country_revenue.show(5)+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+
only showing top 5 rowsRegatul Unit domină, cum te-ai aștepta de la un retailer din Marea Britanie. Rândurile mai interesante sunt Țările de Jos și Irlanda (listată ca EIRE): 9 și 3 clienți cheltuiesc mai mult decât cei 94 din Germania, ceea ce sugerează cumpărători en-gros.
Observă că import modulul functions ca F în loc să folosesc from pyspark.sql.functions import *, care umbrește sum(), min() și max() din Python. Începând cu PySpark 4.0, acel import wildcard nu mai expune nici vechiul nume camelCase countDistinct.
Tutorialul nostru PySpark groupBy intră mai adânc în agregări.
Îmbinarea DataFrame-urilor cu join()
join() combină două DataFrame-uri pe o cheie comună. Pentru a eticheta fiecare țară cu o regiune, voi îmbina un tabel mic de lookup care omite deliberat Australia:
regions = spark.createDataFrame(
[("United Kingdom", "UK"), ("Netherlands", "EU"), ("EIRE", "EU"),
("Germany", "EU"), ("France", "EU")],
["Country", "region"],
)
country_revenue.join(regions, on="Country", how="left").orderBy(F.desc("revenue")).show(6)+--------------+---------+----------+------+
| Country|customers| revenue|region|
+--------------+---------+----------+------+
|United Kingdom| 3920|7308391.55| UK|
| Netherlands| 9| 285446.34| EU|
| EIRE| 3| 265545.9| EU|
| Germany| 94| 228867.14| EU|
| France| 87| 209024.05| EU|
| Australia| 9| 138521.31| NULL|
+--------------+---------+----------+------+
only showing top 6 rowsUn left join păstrează fiecare rând din DataFrame-ul din stânga și completează nepotrivirile cu NULL, motiv pentru care Australia rămâne în rezultat. Un inner join (how="inner", implicitul) ar fi eliminat-o. Tutorialul nostru despre join-uri în PySpark compară toate tipurile de join și performanța lor.
Spark SQL în PySpark
Spark SQL îți permite să interoghezi un DataFrame cu SQL standard, înregistrându-l ca vizualizare temporară. Această interogare reproduce tabelul cu veniturile pe țară din secțiunea groupBy:
sales_only.createOrReplaceTempView("sales")
spark.sql("""
SELECT Country,
COUNT(DISTINCT CustomerID) AS customers,
ROUND(SUM(TotalAmount), 2) AS revenue
FROM sales
GROUP BY Country
ORDER BY revenue DESC
LIMIT 5
""").show()+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+Ambele versiuni se compilează în același plan optimizat, deci niciuna nu este mai rapidă. Folosesc SQL pentru agregări lungi pe care analiștii le vor citi, iar API-ul DataFrame când am nevoie de logică Python în jurul interogării, precum construirea de filtre într-o buclă. spark.sql() returnează un DataFrame, deci le poți combina liber.
Vizualizarea temporară durează până când se oprește SparkSession.
Machine Learning cu PySpark: Un exemplu K-Means
Modulul pyspark.ml al PySpark antrenează modele pe DataFrame-uri, iar un Pipeline leagă pregătirea caracteristicilor și modelul într-un singur obiect pe care îl poți antrena și reutiliza. Ca exemplu, voi segmenta clienții retailerului cu clustering K-Means pe recency, frequency și monetary value (RFM), o segmentare standard în marketing:
- Recency: zile de la ultima achiziție a clientului
- Frequency: numărul de facturi distincte
- Monetary: suma totală cheltuită
Construirea caracteristicilor RFM cu groupBy()
Un singur groupBy() peste DataFrame-ul curățat sales_only produce toate cele 3 caracteristici. Recency se măsoară din ziua de după ultima factură din date:
snapshot = sales_only.agg(F.date_add(F.max("InvoiceDate"), 1)).first()[0]
rfm = sales_only.groupBy("CustomerID").agg(
F.datediff(F.lit(snapshot), F.max("InvoiceDate")).alias("recency"),
F.count_distinct("InvoiceNo").alias("frequency"),
F.round(F.sum("TotalAmount"), 2).alias("monetary"),
)
rfm.describe("recency", "frequency", "monetary").show()+-------+------------------+-----------------+------------------+
|summary| recency| frequency| monetary|
+-------+------------------+-----------------+------------------+
| count| 4338| 4338| 4338|
| mean| 93.05947441217151|4.272014753342554|2054.2664591977896|
| stddev|100.01226424171826|7.697997826095038| 8989.230441421178|
| min| 1| 1| 3.75|
| max| 374| 209| 280206.02|
+-------+------------------+-----------------+------------------+Uită-te la coloana monetary: o medie de aproximativ £2.054, o deviație standard de peste patru ori mai mare și un maxim peste £280.000. K-Means măsoară distanța euclidiană, deci câțiva mari cheltuitori ar domina clusterele. Luarea logaritmului fiecărei caracteristici comprimă acea coadă lungă.
Scalare și clustering într-un Pipeline
Pipeline-ul are 3 etape: VectorAssembler împachetează caracteristicile în singura coloană vector pe care o așteaptă modelele pyspark.ml, StandardScaler le aduce pe aceeași scară, iar KMeans le grupează. Îl antrenez pentru k = 2 până la 6 și punctez fiecare model cu silhouette score, care variază între -1 și 1, mai mare însemnând clustere mai bine separate:
from pyspark.ml import Pipeline
from pyspark.ml.clustering import KMeans
from pyspark.ml.evaluation import ClusteringEvaluator
from pyspark.ml.feature import StandardScaler, VectorAssembler
rfm_log = rfm.select(
"CustomerID",
"recency", "frequency", "monetary",
F.log1p("recency").alias("log_recency"),
F.log1p("frequency").alias("log_frequency"),
F.log1p("monetary").alias("log_monetary"),
).cache()
assembler = VectorAssembler(
inputCols=["log_recency", "log_frequency", "log_monetary"], outputCol="features_raw"
)
scaler = StandardScaler(
inputCol="features_raw", outputCol="features", withMean=True, withStd=True
)
evaluator = ClusteringEvaluator(featuresCol="features", metricName="silhouette")
for k in range(2, 7):
kmeans = KMeans(featuresCol="features", k=k, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
score = evaluator.evaluate(model.transform(rfm_log))
print(f"k={k} silhouette={score:.3f}")k=2 silhouette=0.624
k=3 silhouette=0.502
k=4 silhouette=0.502
k=5 silhouette=0.478
k=6 silhouette=0.470.cache() păstrează rfm_log în memorie, pentru că fiecare antrenare și evaluare din buclă îl citește din nou; fără asta, Spark ar recomputa tabelul RFM din CSV la fiecare antrenare.
Alegerea lui k și interpretarea segmentelor
Scorul silhouette atinge vârful la k = 2, dar 2 segmente separă în principal clienții activi de cei inactivi, cu care echipa de marketing poate face puține. k = 4 obține același scor ca k = 3 și împarte clienții activi în mari cheltuitori și nou-veniți, așa că îl voi folosi și voi profila fiecare cluster:
kmeans = KMeans(featuresCol="features", k=4, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
segments = model.transform(rfm_log)
(segments.groupBy("prediction")
.agg(
F.count("*").alias("customers"),
F.round(F.avg("recency"), 1).alias("avg_recency"),
F.round(F.avg("frequency"), 1).alias("avg_frequency"),
F.round(F.avg("monetary"), 1).alias("avg_monetary"),
)
.orderBy("prediction")
.show())+----------+---------+-----------+-------------+------------+
|prediction|customers|avg_recency|avg_frequency|avg_monetary|
+----------+---------+-----------+-------------+------------+
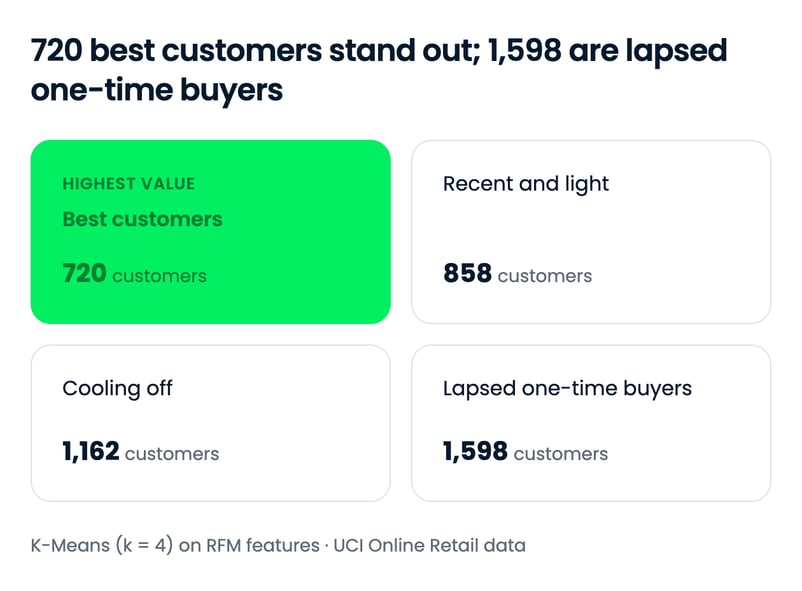
| 0| 1598| 181.2| 1.3| 326.2|
| 1| 720| 13.2| 13.7| 8072.7|
| 2| 1162| 77.1| 3.9| 1765.2|
| 3| 858| 17.4| 2.3| 613.7|
+----------+---------+-----------+-------------+------------+Cele patru segmente se interpretează clar:
- Clusterul 1, cei mai buni clienți (720): au cumpărat în ultimele 2 săptămâni în medie, cu aproximativ 14 comenzi și peste £8.000 cheltuiți fiecare. Aici se potrivesc ofertele de retenție și loialitate.
- Clusterul 3, recenți și cu volum mic (858): activi în ultimele 3 săptămâni, dar cu doar vreo 2 comenzi. Mulți sunt probabil clienți noi care merită îndrumați spre a doua și a treia comandă.
- Clusterul 2, în răcire (1.162): cheltuieli medii, dar cam 11 săptămâni de la ultima achiziție. O campanie de recâștigare are cele mai bune șanse aici.
- Clusterul 0, cumpărători ocazionali care au dispărut (1.598): în mare parte o singură comandă, în jur de £326, acum aproximativ 6 luni. Cel mai mare grup și cel mai puțin valoros.
Numerele clusterelor sunt etichete arbitrare, iar o altă sămânță le poate reordona, așa că profilează întotdeauna clusterele înainte de a le numi. Pentru a înțelege cum își alege K-Means centroizii, vezi introducerea noastră în clusteringul k-means, iar referința API pyspark.ml listează fiecare model și transformator. Cursul nostru Machine Learning cu PySpark acoperă clasificare, regresie și reglarea modelelor cu Pipeline-uri.
Gânduri de final
PySpark se reduce la câteva idei: un SparkSession pentru început, DataFrame-uri pentru aproape tot, transformări leneșe care rulează doar când o acțiune are nevoie de un rezultat și alegerea de a scrie fiecare interogare în Python sau SQL. Tot ce este în acest tutorial a rulat în modul local pe un laptop, iar același cod rulează neschimbat pe un cluster.
Un fișier cu 541.909 rânduri nu are nevoie de un cluster, iar pandas s-ar fi descurcat. Asta a fost intenționat, pentru că obiceiurile care contează pe date mari (scheme explicite, filtrare devreme, caching pentru ceea ce refolosești și verificarea cu explain()) sunt mai ușor de format pe date pe care le poți inspecta.
De aici, acestea sunt următorii pași buni, în funcție de obiectivul tău:
- Exersează API-ul DataFrame cu exerciții: Introducere în PySpark
- Pregătește date reale, dezordonate: Curățarea datelor cu PySpark
- Păstrează sintaxa la îndemână: fișa noastră PySpark
- Pregătește-te pentru un interviu de angajare: Top întrebări de interviu PySpark
Dacă vrei să mergi mai departe, îți recomand parcursul Big Data cu PySpark, care acoperă gestionarea datelor, ingineria caracteristicilor, pipeline-uri de machine learning și motoare de recomandare, în ordine. Pentru echipe, DataCamp for Business oferă trasee de învățare pentru roluri de data engineering.
Întrebări frecvente despre PySpark
Care sunt cerințele preliminare pentru a învăța PySpark?
PySpark 4.3 necesită Python 3.11 sau mai nou și Java 17 sau mai nou (Spark 4.3 rulează pe Java 17, 21 și 25), cu JAVA_HOME indicând către instalarea ta de Java. Ar trebui să fii confortabil cu Python de bază; experiența cu DataFrame-uri pandas ajută, pentru că API-ul PySpark DataFrame folosește idei similare. Nu ai nevoie de experiență anterioară cu sisteme distribuite.
Este PySpark mai rapid decât pandas?
Nu pe date mici. pandas rulează în același proces fără cost de pornire, în timp ce PySpark petrece câteva secunde pornind JVM-ul și programând task-uri, așa că de obicei pandas câștigă pe date care încap confortabil în memorie. PySpark este mai rapid atunci când munca depășește memoria sau CPU-ul unei singure mașini, deoarece procesează partiții în paralel pe nuclee sau noduri din cluster.
Care este diferența dintre RDD-uri și DataFrame-uri în PySpark?
Un RDD (Resilient Distributed Dataset) este structura de nivel jos a PySpark: o colecție distribuită de obiecte Python arbitrare pe care le procesezi cu propriile funcții. Un DataFrame organizează datele în coloane denumite și tipizate, ca un DataFrame pandas, iar optimizerul Catalyst al Spark transformă interogările pe DataFrame în planuri de execuție eficiente. Folosește DataFrame-uri pentru aproape tot codul nou, iar RDD-uri doar pentru date nestructurate sau control fin al partiționării.
Cum rulez PySpark într-un Jupyter Notebook?
Instalează Java 17 sau mai nou, apoi rulează pip install "pyspark[sql]" în mediul pe care îl folosește notebook-ul tău. Creează un SparkSession în prima celulă:
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("MyNotebook").getOrCreate()Dacă preferi să eviți configurarea locală, notebook-urile DataLab și Databricks vin cu PySpark preinstalat.
Când ar trebui să folosesc PySpark în loc de pandas?
Folosește PySpark când datele tale nu încap în memoria unei singure mașini, când un job trebuie să ruleze pe un cluster sau pe o platformă ca Databricks, sau când construiești pipeline-uri care vor crește dincolo de un laptop. Pentru analiză exploratorie pe date care încap în memorie, pandas este mai simplu și pornește instantaneu. Codul PySpark scris local rulează neschimbat pe un cluster, așa că are sens să începi cu el dacă este probabilă scalarea.
Ce este evaluarea întârziată în PySpark?
Evaluarea întârziată înseamnă că PySpark nu rulează transformări precum filter() sau withColumn() când le apelezi. Le înregistrează într-un plan și rulează acel plan doar când o acțiune, cum ar fi count(), show() sau write, are nevoie de un rezultat. Așteptarea îi permite lui Spark să optimizeze întregul lanț, de exemplu prin împingerea filtrelor în citirea fișierului.
Cum rulez interogări SQL în PySpark?
Înregistrează un DataFrame ca vizualizare temporară cu df.createOrReplaceTempView("sales"), apoi interoghează-l cu spark.sql("SELECT ... FROM sales"). Rezultatul este un DataFrame obișnuit, deci poți combina liber SQL și cod pe DataFrame. Ambele se compilează în același plan optimizat, deci niciuna nu este mai rapidă.
Am nevoie de Hadoop pentru a rula PySpark?
Nu. pip install pyspark include runtime-ul Spark, care rulează în modul local pe mașina ta fără Hadoop. Ai nevoie de componente Hadoop doar dacă citești din HDFS sau rulezi Spark pe un cluster YARN.
PySpark este API-ul Python pentru Apache Spark. Scrii cod DataFrame sau SQL în Python, iar Spark împarte munca între toate nucleele CPU de pe laptopul tău sau pe fiecare mașină dintr-un cluster. Apelez la el când un set de date nu mai încape lejer în pandas sau când aceeași sarcină trebuie să ruleze ulterior pe un cluster fără rescriere.
În acest tutorial PySpark, voi instala PySpark 4.3, voi crea un SparkSession și voi explica cele două idei care îi împiedică cel mai des pe începători: RDD-uri versus DataFrame-uri și evaluarea leneșă. Apoi vom parcurge operațiile pe care le vei folosi zilnic (select, filter, groupBy, join și Spark SQL) pe un set de date e-commerce cu 541.909 rânduri și vom încheia cu un model de segmentare a clienților K-Means construit cu API-ul Pipeline din
pyspark.ml.Dacă vrei exerciții ghidate alături de acest tutorial, cursul nostru Introduction to PySpark acoperă aceleași subiecte. Pentru un plan de învățare mai amplu, vezi ghidul nostru How to Learn PySpark From Scratch.
Pe scurt
pip install "pyspark[sql]"; PySpark 4.3 necesită Python 3.11+ și Java 17+.SparkSession, iar DataFrame-urile (nu RDD-urile) sunt API-ul implicit.count()saushow().pyspark.mlleagă pregătirea caracteristicilor și modelele precum K-Means într-un singur obiect.Ce este Apache Spark?
Apache Spark este un motor open-source pentru procesarea distribuită a datelor. Împarte un set de date în partiții, le procesează în paralel într-un cluster și păstrează rezultatele intermediare în memorie, în loc să le scrie pe disc între pași.
Această arhitectură în memorie este principalul motiv pentru care Spark a înlocuit Hadoop MapReduce pentru majoritatea sarcinilor batch (comparăm cele două în Hadoop vs Spark). Spark a început la AMPLab al UC Berkeley în 2009, a devenit proiect Apache de nivel superior în 2014 și a ajuns la versiunea 4.3 pe 30 octombrie 2026.
Un singur motor acoperă mai multe tipuri de sarcini prin bibliotecile sale integrate:
pyspark.ml) pentru învățare automată distribuităPentru o privire mai atentă asupra modului în care driverul, managerul de cluster și executorii își împart munca, vezi ghidul nostru despre arhitectura Apache Spark.