

Czym jest PySpark?
PySpark to interfejs API w Pythonie dla Apache Spark. Twój kod w Pythonie opisuje pożądane transformacje, a silnik Sparka, działający na Maszynie Wirtualnej Javy (JVM), planuje je i wykonuje w całym klastrze. Dostajesz rozproszone wykonywanie Sparka bez pisania w Scali czy Javie.
Data scientistci używają PySpark do czyszczenia i agregowania dużych zbiorów danych, inżynierowie danych do potoków ETL, a obie grupy korzystają z pyspark.ml, by trenować modele na danych, które nie mieszczą się na jednej maszynie. Jeśli dziś większość twojej pracy odbywa się w pandas, API DataFrame będzie ci znajome.
Kiedy używać PySpark zamiast pandas
PySpark opłaca się wtedy, gdy dane przerastają jedną maszynę; poniżej tego progu pandas jest zwykle szybsze, bo nie ma narzutu uruchamiania JVM ani planowania zadań.
| Funkcja | pandas | PySpark |
|---|---|---|
| Rozmiar danych | Ograniczony pamięcią RAM jednej maszyny | Ograniczony łączną pamięcią i dyskiem klastra |
| Wykonywanie | Chciwe, głównie jednordzeniowe | Leniwe, równolegle na rdzeniach lub maszynach |
| Narzut startowy | Brak | Kilka sekund na uruchomienie JVM i SparkSession |
| Dane strumieniowe | Nieobsługiwane | Structured Streaming |
| Uczenie maszynowe | ekosystem scikit-learn | pyspark.ml (rozproszone) |
| Tolerancja błędów | Brak; awaria traci dotychczasową pracę | Utracone partycje są odtwarzane z rodowodu (lineage) |
Moja zasada: jeśli dane mieszczą się w pamięci z zapasem i zadanie działa na jednym laptopie, zostań przy pandas. Przełącz się na PySpark, gdy walczysz z błędami pamięci albo gdy zadanie ma ostatecznie działać w klastrze lub na platformie takiej jak Databricks.
Jak zainstalować PySpark
PySpark instaluje się z PyPI jednym poleceniem pip, które zawiera środowisko uruchomieniowe Sparka, więc do pracy lokalnej nie potrzebujesz osobnego pobierania Sparka ani Hadoop. Zanim je uruchomisz, sprawdź dwa wymagania wstępne.
Wymagania wstępne
Zgodnie z oficjalnym przewodnikiem instalacji, PySpark 4.3 wymaga:
- Pythona 3.11 lub nowszego. PySpark 4.3 porzucił wsparcie dla Pythona 3.10; jeśli potrzebujesz nowszej wersji, zobacz nasz przewodnik po konfiguracji Pythona.
- Javy 17 lub nowszej (Spark 4.3 działa na Javie 17, 21 i 25) ze zmienną środowiskową
JAVA_HOMEwskazującą na nią. Nasz przewodnik instalacji Javy omawia każdy system operacyjny.
Oba możesz sprawdzić z terminala:
python3 --version # Python 3.11 or later
java -version # openjdk version "17" or laterJeśli pracujesz w DataLab lub Databricks, PySpark jest już zainstalowany i możesz przejść do zbioru danych.
Instalacja PySpark przez pip
Polecam wirtualne środowisko, żeby zależności PySpark nie kolidowały z innymi projektami:
python3 -m venv pyspark-env
source pyspark-env/bin/activate
pip install "pyspark[sql]" "pandas<3"
python3 -c "import pyspark; print(pyspark.__version__)"4.3.0W systemie Windows użyj python zamiast python3 i aktywuj środowisko poleceniem pyspark-env\Scripts\activate. Dodatek [sql] instaluje pandas, PyArrow i NumPy, których PySpark używa dla toPandas() i pandas UDF. Spinam pandas<3, ponieważ PySpark 4.3 wypisuje ostrzeżenie, że nie wspiera jeszcze w pełni pandas 3.0.
Dwa błędy odpowiadają za większość nieudanych pierwszych uruchomień:
JAVA_GATEWAY_EXITEDlub „Unable to locate a Java Runtime”: brakuje Javy lubJAVA_HOMEnie jest ustawione.PYTHON_VERSION_MISMATCH: procesy robocze Sparka podłapały innego Pythona niż ten użyty w twoim skrypcie. UstawPYSPARK_PYTHONna interpreter twojego środowiska, na przykładexport PYSPARK_PYTHON=$(which python).
Po kroki specyficzne dla systemów operacyjnych, w tym Windows, zajrzyj do naszego przewodnika instalacji PySpark.
Pobranie zbioru danych
Przykłady korzystają ze zbioru danych e-commerce zawierającego 541 909 transakcji brytyjskiego sklepu internetowego, obejmującego okres od grudnia 2010 do grudnia 2011. Każdy wiersz to jedna pozycja na fakturze, z 8 kolumnami:
InvoiceNo: numer faktury (numery zaczynające się od „C” to anulowania)StockCodeiDescription: kod produktu i nazwaQuantityiUnitPrice: liczba sztuk i cena za sztukę, w funtach szterlingachInvoiceDate: data i godzina zakupuCustomerID: identyfikator klienta (brakuje w niektórych wierszach)Country: kraj klienta
Możesz pobrać go jako datacamp_ecommerce.csv ze strony DataLab dataset page. To zbiór Online Retail z repozytorium UCI Machine Learning, więc możesz też zbudować ten sam plik ze źródła publicznego (wymaga pip install openpyxl):
import io
import urllib.request
import zipfile
import pandas as pd
url = "https://archive.ics.uci.edu/static/public/352/online+retail.zip"
with urllib.request.urlopen(url) as response:
archive = zipfile.ZipFile(io.BytesIO(response.read()))
retail = pd.read_excel(
archive.open("Online Retail.xlsx"),
dtype={"InvoiceNo": str, "StockCode": str, "CustomerID": "Int64"},
)
# Match the DataLab file's date format, e.g. 12/1/10 8:26
retail["InvoiceDate"] = retail["InvoiceDate"].map(
lambda ts: f"{ts.month}/{ts.day}/{ts:%y} {ts.hour}:{ts:%M}"
)
retail.to_csv("datacamp_ecommerce.csv", index=False)Wczytanie 23‑MB pliku Excel trwa około minuty. Zapisz CSV w folderze, z którego będziesz uruchamiać resztę kodu.
Tworzenie SparkSession
SparkSession to punkt wejścia do każdego programu w PySparku: łączy twój kod w Pythonie z silnikiem Spark i tworzy DataFrame’y. Tworzysz jedną sesję na aplikację, korzystając ze wzorca buildera:
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("PySparkTutorial").getOrCreate()
print(spark.version)4.3.0getOrCreate() zwraca działającą sesję, jeśli taka istnieje, więc w notatniku możesz wywołać to bezpiecznie dwa razy. Uruchomiony z zwykłego procesu Pythona, Spark działa w trybie lokalnym (local[*]), używając wszystkich rdzeni CPU twojej maszyny jako workerów, i udostępnia interfejs Spark UI pod adresem http://localhost:4040 do podglądu zadań. Gdy skończysz, spark.stop() zwalnia zasoby.
Wczytywanie zbioru danych e-commerce
Gdy sesja działa, możemy wczytać plik CSV do DataFrame’a. Przekazuję jawny schemat zamiast inferSchema=True, co powoduje, że Spark skanuje plik jeszcze raz tylko po to, by odgadnąć typy kolumn:
import pyspark.sql.functions as F
schema = """
InvoiceNo STRING, StockCode STRING, Description STRING, Quantity INT,
InvoiceDate STRING, UnitPrice DOUBLE, CustomerID INT, Country STRING
"""
orders = spark.read.csv(
"datacamp_ecommerce.csv", header=True, schema=schema, escape='"'
)
orders = orders.withColumn("InvoiceDate", F.to_timestamp("InvoiceDate", "M/d/yy H:mm"))
orders.printSchema()root
|-- InvoiceNo: string (nullable = true)
|-- StockCode: string (nullable = true)
|-- Description: string (nullable = true)
|-- Quantity: integer (nullable = true)
|-- InvoiceDate: timestamp (nullable = true)
|-- UnitPrice: double (nullable = true)
|-- CustomerID: integer (nullable = true)
|-- Country: string (nullable = true)Dwa szczegóły z tego fragmentu mają znaczenie:
escape='"'obsługuje nazwy produktów zawierające podwójne cudzysłowy, takie jakRECORD FRAME 7"" SINGLE SIZE. Domyślnym znakiem ucieczki w Sparku jest backslash.- Wzorzec daty
M/d/yy H:mmpasuje do wartości takich jak12/1/10 8:26. Od Sparka 4.0 tryb ANSI SQL jest domyślnie włączony, więcto_timestamp()zgłasza błądCANNOT_PARSE_TIMESTAMPdla wartości, która nie pasuje do wzorca. UżyjF.try_to_timestamp(), jeśli wolisz dostaćNULLdla błędnych wierszy.
Aby podejrzeć pierwsze wiersze i je policzyć:
orders.show(5, truncate=False)
print(orders.count())+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|InvoiceNo|StockCode|Description |Quantity|InvoiceDate |UnitPrice|CustomerID|Country |
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|536365 |85123A |WHITE HANGING HEART T-LIGHT HOLDER |6 |2010-12-01 08:26:00|2.55 |17850 |United Kingdom|
|536365 |71053 |WHITE METAL LANTERN |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84406B |CREAM CUPID HEARTS COAT HANGER |8 |2010-12-01 08:26:00|2.75 |17850 |United Kingdom|
|536365 |84029G |KNITTED UNION FLAG HOT WATER BOTTLE|6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84029E |RED WOOLLY HOTTIE WHITE HEART. |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
only showing top 5 rows
541909Więcej opcji wczytywania, takich jak wiele plików, różne delimitery i uszkodzone rekordy, znajdziesz w naszym samouczku o wczytywaniu CSV w PySparku.
RDD vs. DataFrame
RDD i DataFrame to dwa sposoby reprezentowania rozproszonych danych w PySparku i w niemal całym nowym kodzie lepszym wyborem są DataFrame’y.
| Abstrakcja | Co to jest | Kiedy używać |
|---|---|---|
| RDD (Resilient Distributed Dataset) | Niskopoziomowa, niezmienna kolekcja dowolnych obiektów Pythona, podzielona na partycje | Dane niestrukturyzowane lub gdy potrzebujesz drobiazgowej kontroli nad partycjonowaniem |
| DataFrame | Rozproszona tabela z nazwanymi, typowanymi kolumnami, podobna do pandas DataFrame | Analiza, zapytania SQL, ETL i uczenie maszynowe |
Ta sama agregacja — łączna ilość na kraj — zapisana na dwa sposoby:
sales = [("United Kingdom", 6), ("France", 24), ("United Kingdom", 8)]
# RDD: piszesz logikę funkcjami Pythona
rdd = spark.sparkContext.parallelize(sales)
print(rdd.reduceByKey(lambda a, b: a + b).collect())
# DataFrame: deklarujesz wynik, a Spark planuje, jak go obliczyć
sales_df = spark.createDataFrame(sales, ["country", "quantity"])
sales_df.groupBy("country").sum("quantity").show()[('France', 24), ('United Kingdom', 14)]
+--------------+-------------+
| country|sum(quantity)|
+--------------+-------------+
|United Kingdom| 14|
| France| 24|
+--------------+-------------+Wersja na RDD uruchamia twoją lambdę w procesach roboczych Pythona. Wersja na DataFrame przechodzi przez optimizer Cataly st w Sparku, który przepisuje zapytanie na wydajny plan działający w JVM, więc kod na DataFrame’ach jest zwykle szybszy bez strojenia. Reszta tego tutorialu używa DataFrame’ów.
Leniwa ewaluacja: transformacje vs. akcje
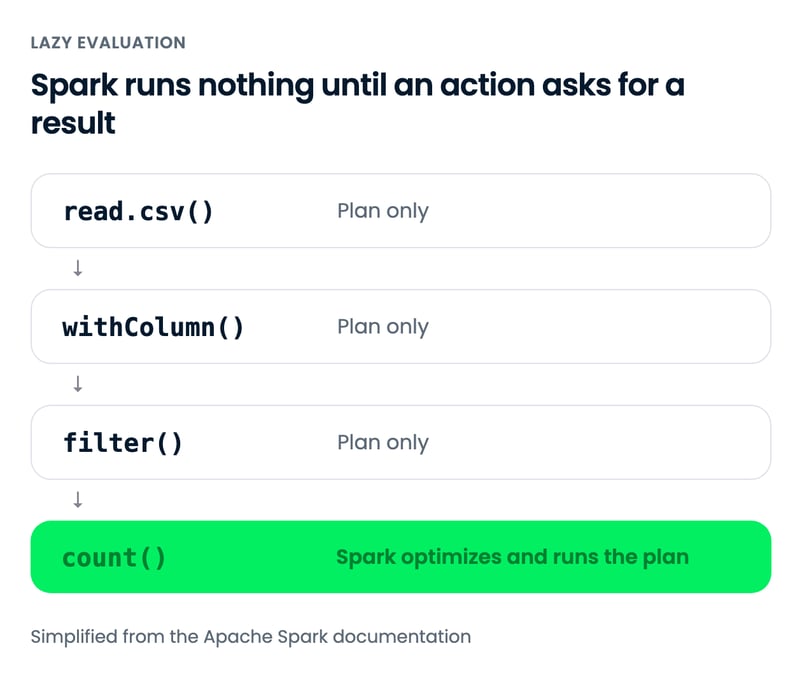
Leniwa ewaluacja oznacza, że Spark nie wykonuje transformacji w momencie jej wywołania; zapisuje krok w planie i uruchamia cały plan dopiero wtedy, gdy akcja poprosi o wynik.
| Transformacje | Akcje | |
|---|---|---|
| Co robią | Opisują nowy DataFrame | Zwracają wynik lub zapisują dane |
| Kiedy się wykonują | Nigdy samodzielnie | Natychmiast, uruchamiając wszystkie oczekujące transformacje |
| Przykłady | select(), filter(), withColumn(), groupBy(), join() | show(), count(), collect(), toPandas(), write |
Poniższy filtr zwraca wynik natychmiast, mimo że zbiór ma ponad pół miliona wierszy, bo nic jeszcze nie zostało wczytane. To wywołanie count() uruchamia zadanie:
uk_orders = orders.filter(F.col("Country") == "United Kingdom") # transformacja: brak zadania
print(uk_orders.count()) # akcja: Spark czyta plik teraz495478Czekanie do akcji pozwala Spar kowi zoptymalizować cały łańcuch naraz. explain() wypisuje wybrany plan fizyczny (tu skrócony):
uk_orders.explain()== Physical Plan ==
*(1) Project [InvoiceNo#0, StockCode#1, ...]
+- *(1) Filter (isnotnull(Country#7) AND (Country#7 = United Kingdom))
+- FileScan csv [...] PushedFilters: [IsNotNull(Country), EqualTo(Country,United Kingdom)], ...Pozycja PushedFilters pokazuje, że Spark spycha filtr po kraju do etapu skanowania pliku, więc wiersze z innych krajów są odrzucane podczas czytania CSV. Praktyczna konsekwencja: błąd danych wewnątrz transformacji, np. data, której nie da się sparsować w trybie ANSI, ujawni się dopiero przy kolejnej akcji kilka linii dalej.
Najczęstsze operacje na DataFrame’ach
Większość kodu w PySparku to łańcuch pięciu operacji na DataFrame’ach: select(), filter(), withColumn(), groupBy() i join(). Każda zwraca nowy DataFrame, więc możesz je dowolnie łączyć.
Wybieranie kolumn za pomocą select()
select() zwraca DataFrame zawierający tylko wymienione kolumny:
orders.select("InvoiceNo", "Description", "Quantity", "UnitPrice").show(3, truncate=False)+---------+----------------------------------+--------+---------+
|InvoiceNo|Description |Quantity|UnitPrice|
+---------+----------------------------------+--------+---------+
|536365 |WHITE HANGING HEART T-LIGHT HOLDER|6 |2.55 |
|536365 |WHITE METAL LANTERN |6 |3.39 |
|536365 |CREAM CUPID HEARTS COAT HANGER |8 |2.75 |
+---------+----------------------------------+--------+---------+
only showing top 3 rowsFiltrowanie wierszy za pomocą filter()
filter() zostawia wiersze spełniające warunek. Ten zbiór danych miesza sprzedaż ze zwrotami (numery faktur zaczynające się od „C”), ujemnymi ilościami i wierszami bez klienta, więc zostawię tylko prawidłową sprzedaż:
sales_only = orders.filter(
(F.col("Quantity") > 0)
& (F.col("UnitPrice") > 0)
& F.col("CustomerID").isNotNull()
& ~F.col("InvoiceNo").startswith("C")
)
print(sales_only.count())397884Łącz warunki za pomocą & (and), | (or) i ~ (not) i owiń każdy w nawiasy, bo inaczej Pythonowa kolejność operatorów spowoduje, że & zostanie obliczone przed >. Nasz samouczek filtrowania w PySparku pokazuje więcej wzorców.
Dodawanie kolumn za pomocą withColumn()
withColumn() dodaje kolumnę lub zastępuje istniejącą o tej samej nazwie. Tutaj wylicza wartość każdej pozycji:
sales_only = sales_only.withColumn("TotalAmount", F.round(F.col("Quantity") * F.col("UnitPrice"), 2))
sales_only.select("InvoiceNo", "Quantity", "UnitPrice", "TotalAmount").show(3)+---------+--------+---------+-----------+
|InvoiceNo|Quantity|UnitPrice|TotalAmount|
+---------+--------+---------+-----------+
| 536365| 6| 2.55| 15.3|
| 536365| 6| 3.39| 20.34|
| 536365| 8| 2.75| 22.0|
+---------+--------+---------+-----------+
only showing top 3 rowsZobacz nasz samouczek PySpark withColumn() o kolumnach warunkowych z F.when().
Agregacje z groupBy() i agg()
groupBy() grupuje wiersze po jednej lub kilku kolumnach, a agg() liczy po jednej lub kilku metrykach na grupę. Które kraje generują największy przychód?
country_revenue = (
sales_only.groupBy("Country")
.agg(
F.count_distinct("CustomerID").alias("customers"),
F.round(F.sum("TotalAmount"), 2).alias("revenue"),
)
.orderBy(F.desc("revenue"))
)
country_revenue.show(5)+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+
only showing top 5 rowsWielka Brytania dominuje, co nie dziwi u brytyjskiego sprzedawcy. Ciekawsze są Niderlandy i Irlandia (w danych jako EIRE): 9 i 3 klientów wydaje więcej niż 94 w Niemczech, co sugeruje odbiorców hurtowych.
Zwróć uwagę, że importuję moduł functions jako F, zamiast używać from pyspark.sql.functions import *, które przesłania wbudowane w Pythonie sum(), min() i max(). Od PySparka 4.0 ten import z gwiazdką nie udostępnia też starej nazwy w camelCase countDistinct.
Nasz samouczek groupBy w PySparku szczegółowo omawia agregacje.
Łączenie DataFrame’ów za pomocą join()
join() łączy dwa DataFrame’y po wspólnym kluczu. Aby przypisać krajom regiony, dołączę małą tabelę słownikową, celowo pomijając Australię:
regions = spark.createDataFrame(
[("United Kingdom", "UK"), ("Netherlands", "EU"), ("EIRE", "EU"),
("Germany", "EU"), ("France", "EU")],
["Country", "region"],
)
country_revenue.join(regions, on="Country", how="left").orderBy(F.desc("revenue")).show(6)+--------------+---------+----------+------+
| Country|customers| revenue|region|
+--------------+---------+----------+------+
|United Kingdom| 3920|7308391.55| UK|
| Netherlands| 9| 285446.34| EU|
| EIRE| 3| 265545.9| EU|
| Germany| 94| 228867.14| EU|
| France| 87| 209024.05| EU|
| Australia| 9| 138521.31| NULL|
+--------------+---------+----------+------+
only showing top 6 rowsLeft join zachowuje każdy wiersz z lewego DataFrame’a i uzupełnia brakujące dopasowania wartością NULL, dlatego Australia zostaje w wyniku. Inner join (how="inner", domyślny) by ją odrzucił. Nasz samouczek łączeń w PySparku porównuje wszystkie typy joinów i ich wydajność.
Spark SQL w PySparku
Spark SQL pozwala zapytać DataFrame’a standardowym SQL-em po zarejestrowaniu go jako widoku tymczasowego. To zapytanie odtwarza tabelę przychodu per kraj z sekcji groupBy:
sales_only.createOrReplaceTempView("sales")
spark.sql("""
SELECT Country,
COUNT(DISTINCT CustomerID) AS customers,
ROUND(SUM(TotalAmount), 2) AS revenue
FROM sales
GROUP BY Country
ORDER BY revenue DESC
LIMIT 5
""").show()+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+Obie wersje kompilują się do tego samego zoptymalizowanego planu, więc żadna nie jest szybsza. SQL wybieram do długich agregacji, które będą czytać analitycy, a API DataFrame — gdy potrzebuję logiki w Pythonie wokół zapytania, np. budowania filtrów w pętli. spark.sql() zwraca DataFrame, więc możesz swobodnie mieszać oba podejścia.
Widok tymczasowy istnieje do czasu zatrzymania SparkSession.
Uczenie maszynowe w PySparku: przykład k-średnich
Moduł pyspark.ml trenuje modele na DataFrame’ach, a Pipeline łączy przygotowanie cech i model w jeden obiekt, który możesz dopasować i ponownie używać. Na przykładzie pokażę segmentację klientów sprzedawcy metodą k-średnich na podstawie recency, frequency i monetary value (RFM) — standardowej segmentacji marketingowej:
- Recency: liczba dni od ostatniego zakupu klienta
- Frequency: liczba unikatowych faktur
- Monetary: łączna kwota wydana
Budowa cech RFM z groupBy()
Jedno groupBy() na oczyszczonym DataFrame’ie sales_only tworzy wszystkie 3 cechy. Recency mierzymy od dnia po ostatniej fakturze w danych:
snapshot = sales_only.agg(F.date_add(F.max("InvoiceDate"), 1)).first()[0]
rfm = sales_only.groupBy("CustomerID").agg(
F.datediff(F.lit(snapshot), F.max("InvoiceDate")).alias("recency"),
F.count_distinct("InvoiceNo").alias("frequency"),
F.round(F.sum("TotalAmount"), 2).alias("monetary"),
)
rfm.describe("recency", "frequency", "monetary").show()+-------+------------------+-----------------+------------------+
|summary| recency| frequency| monetary|
+-------+------------------+-----------------+------------------+
| count| 4338| 4338| 4338|
| mean| 93.05947441217151|4.272014753342554|2054.2664591977896|
| stddev|100.01226424171826|7.697997826095038| 8989.230441421178|
| min| 1| 1| 3.75|
| max| 374| 209| 280206.02|
+-------+------------------+-----------------+------------------+Spójrz na kolumnę monetary: średnia ok. £2 054, odchylenie standardowe ponad cztery razy większe i maksimum powyżej £280 000. K-średnich mierzy odległość euklidesową, więc kilku dużych wydających zdominowałoby klastry. Wzięcie logarytmu z każdej cechy kompresuje ten długi ogon.
Skalowanie i klastrowanie w Pipeline
Pipeline ma 3 etapy: VectorAssembler pakuje cechy w pojedynczą kolumnę wektora, której oczekują modele pyspark.ml, StandardScaler sprowadza je do tej samej skali, a KMeans klastruje. Dopasowuję modele dla k = 2 do 6 i oceniam każdy wynikiem silhouette w przedziale od -1 do 1 — im wyższy, tym lepsze rozdzielenie klastrów:
from pyspark.ml import Pipeline
from pyspark.ml.clustering import KMeans
from pyspark.ml.evaluation import ClusteringEvaluator
from pyspark.ml.feature import StandardScaler, VectorAssembler
rfm_log = rfm.select(
"CustomerID",
"recency", "frequency", "monetary",
F.log1p("recency").alias("log_recency"),
F.log1p("frequency").alias("log_frequency"),
F.log1p("monetary").alias("log_monetary"),
).cache()
assembler = VectorAssembler(
inputCols=["log_recency", "log_frequency", "log_monetary"], outputCol="features_raw"
)
scaler = StandardScaler(
inputCol="features_raw", outputCol="features", withMean=True, withStd=True
)
evaluator = ClusteringEvaluator(featuresCol="features", metricName="silhouette")
for k in range(2, 7):
kmeans = KMeans(featuresCol="features", k=k, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
score = evaluator.evaluate(model.transform(rfm_log))
print(f"k={k} silhouette={score:.3f}")k=2 silhouette=0.624
k=3 silhouette=0.502
k=4 silhouette=0.502
k=5 silhouette=0.478
k=6 silhouette=0.470.cache() utrzymuje rfm_log w pamięci, bo każde dopasowanie i ewaluacja w pętli znowu je czytają; bez tego Spark przeliczałby tabelę RFM z CSV przy każdym dopasowaniu.
Wybór k i odczyt segmentów
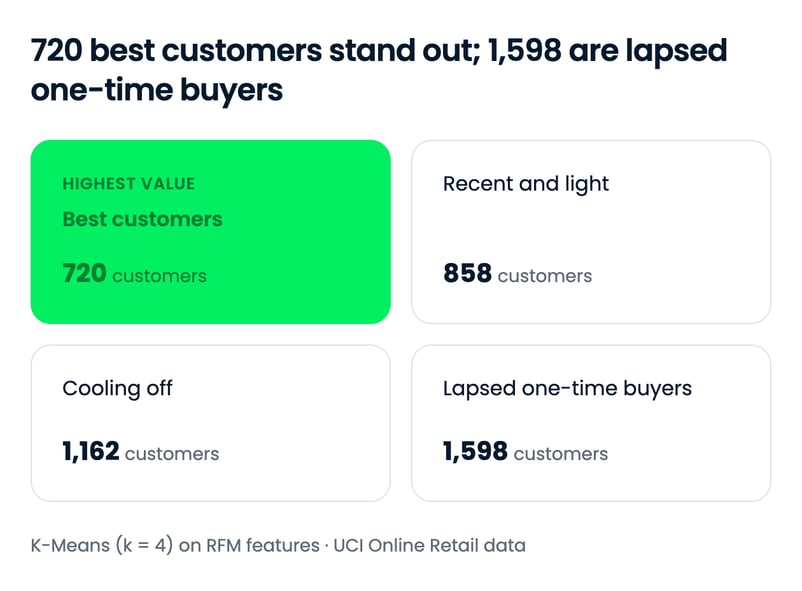
Wynik silhouette jest najwyższy przy k = 2, ale 2 segmenty głównie dzielą aktywnych klientów od utraconych, z czym zespół marketingu niewiele zrobi. k = 4 uzyskuje taki sam wynik jak k = 3 i rozdziela aktywnych klientów na dużych wydających i nowicjuszy, więc użyję go i sprofiluję każdy klaster:
kmeans = KMeans(featuresCol="features", k=4, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
segments = model.transform(rfm_log)
(segments.groupBy("prediction")
.agg(
F.count("*").alias("customers"),
F.round(F.avg("recency"), 1).alias("avg_recency"),
F.round(F.avg("frequency"), 1).alias("avg_frequency"),
F.round(F.avg("monetary"), 1).alias("avg_monetary"),
)
.orderBy("prediction")
.show())+----------+---------+-----------+-------------+------------+
|prediction|customers|avg_recency|avg_frequency|avg_monetary|
+----------+---------+-----------+-------------+------------+
| 0| 1598| 181.2| 1.3| 326.2|
| 1| 720| 13.2| 13.7| 8072.7|
| 2| 1162| 77.1| 3.9| 1765.2|
| 3| 858| 17.4| 2.3| 613.7|
+----------+---------+-----------+-------------+------------+Cztery segmenty czytelnie się interpretują:
- Klaster 1, najlepsi klienci (720): średnio zakup w ostatnich 2 tygodniach, około 14 zamówień i ponad £8 000 wydane. Tu kieruj działania retencyjne i lojalnościowe.
- Klaster 3, niedawni i „lekcy” (858): aktywni w ostatnich 3 tygodniach, ale z ok. 2 zamówieniami. Wielu to pewnie nowi klienci, których warto poprowadzić do drugiego i trzeciego zamówienia.
- Klaster 2, „stygnący” (1 162): średnie wydatki, ale ok. 11 tygodni od ostatniego zakupu. Kampania odzyskująca ma tu najlepsze szanse.
- Klaster 0, nieaktywni jednorazowi nabywcy (1 598): zwykle pojedyncze zamówienie, około £326, mniej więcej 6 miesięcy temu. Największa i najmniej wartościowa grupa.
Numery klastrów to arbitralne etykiety i inny seed może je przestawić, więc zawsze profiluj klastry przed ich nazwaniem. Jeśli chcesz zrozumieć, jak k-średnich wybiera centroidy, zobacz nasze wprowadzenie do klasteryzacji k-średnich, a dokumentacja API pyspark.ml wymienia wszystkie modele i transformatory. Nasz kurs Machine Learning with PySpark obejmuje klasyfikację, regresję i strojenie modeli z Pipeline’ami.
Na koniec
PySpark sprowadza się do kilku idei: SparkSession na start, DataFrame’y do prawie wszystkiego, leniwe transformacje, które wykonują się dopiero, gdy akcja potrzebuje wyniku, oraz wybór, czy każde zapytanie pisać w Pythonie, czy w SQL. Wszystko w tym tutorialu działało w trybie lokalnym na laptopie i ten sam kod zadziała bez zmian na klastrze.
Plik z 541 909 wierszami nie potrzebuje klastra i pandas by sobie z nim poradził. To celowe, bo nawyki istotne przy dużych danych (jawne schematy, wczesne filtrowanie, cache’owanie tego, co ponownie używasz, i sprawdzanie explain()) łatwiej wyrobić na danych, które możesz obejrzeć.
Stąd najlepsze kolejne kroki — zależnie od celu:
- Poćwicz API DataFrame na zadaniach: Introduction to PySpark
- Przygotuj nieuporządkowane dane z życia: Cleaning Data with PySpark
- Miej składnię pod ręką: nasze ściągi do PySparka
- Przygotuj się do rozmowy rekrutacyjnej: Top PySpark interview questions
Jeśli chcesz iść dalej, polecam ścieżkę Big Data with PySpark, która po kolei omawia zarządzanie danymi, inżynierię cech, pipeline’y uczenia maszynowego i silniki rekomendacyjne. Dla zespołów DataCamp for Business oferuje ścieżki nauki dla ról data engineering.
PySpark — najczęstsze pytania
Jakie są wymagania wstępne do nauki PySparka?
PySpark 4.3 wymaga Pythona 3.11 lub nowszego oraz Javy 17 lub nowszej (Spark 4.3 działa na Javie 17, 21 i 25), z JAVA_HOME wskazującym na twoją instalację Javy. Powinieneś czuć się swobodnie z podstawami Pythona; doświadczenie z pandas DataFrame’ami pomaga, bo API DataFrame w PySparku opiera się na podobnych ideach. Nie potrzebujesz wcześniejszego doświadczenia z systemami rozproszonymi.
Czy PySpark jest szybszy niż pandas?
Nie przy małych danych. pandas działa w tym samym procesie bez kosztu startu, podczas gdy PySpark spędza kilka sekund na uruchomieniu JVM i planowaniu zadań, więc pandas zwykle wygrywa dla danych, które mieszczą się wygodnie w pamięci. PySpark jest szybszy, gdy praca przekracza pamięć lub CPU jednej maszyny, bo przetwarza partycje równolegle na rdzeniach lub węzłach klastra.
Jaka jest różnica między RDD a DataFrame w PySparku?
RDD (Resilient Distributed Dataset) to niskopoziomowa struktura PySparka: rozproszona kolekcja dowolnych obiektów Pythona, które przetwarzasz własnymi funkcjami. DataFrame organizuje dane w nazwane, typowane kolumny, jak w pandas DataFrame, a optimizer Catalyst w Sparku zamienia zapytania na DataFrame’ach w wydajne plany wykonania. Używaj DataFrame’ów w prawie każdym nowym kodzie, a RDD tylko dla danych niestrukturyzowanych lub drobiazgowej kontroli partycjonowania.
Jak uruchomić PySparka w Jupyter Notebook?
Zainstaluj Javę 17 lub nowszą, potem uruchom pip install "pyspark[sql]" w środowisku używanym przez twój notatnik. Utwórz SparkSession w pierwszej komórce:
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("MyNotebook").getOrCreate()Jeśli wolisz pominąć lokalną konfigurację, notatniki DataLab i Databricks mają PySparka wstępnie zainstalowanego.
Kiedy używać PySparka zamiast pandas?
Używaj PySparka, gdy twoje dane nie mieszczą się w pamięci jednej maszyny, gdy zadanie ma działać na klastrze lub platformie typu Databricks, albo gdy budujesz pipeline’y, które wyrosną poza laptop. Do eksploracyjnej analizy danych mieszczących się w pamięci pandas jest prostszy i startuje natychmiast. Kod PySparka pisany lokalnie działa bez zmian na klastrze, więc warto od niego zacząć, jeśli skala może rosnąć.
Na czym polega leniwa ewaluacja w PySparku?
Leniwa ewaluacja oznacza, że PySpark nie wykonuje transformacji takich jak filter() czy withColumn() w momencie ich wywołania. Zapisuje je w planie i uruchamia ten plan dopiero, gdy akcja — np. count(), show() lub write — potrzebuje wyniku. Czekanie pozwala Spar kowi zoptymalizować cały łańcuch, np. poprzez spychanie filtrów do skanowania pliku.
Jak uruchamiać zapytania SQL w PySparku?
Zarejestruj DataFrame jako widok tymczasowy poleceniem df.createOrReplaceTempView("sales"), a potem zapytaj go przez spark.sql("SELECT ... FROM sales"). Wynik to zwykły DataFrame, więc możesz swobodnie mieszać SQL i kod na DataFrame’ach. Oba kompilują się do tego samego zoptymalizowanego planu, więc żaden nie jest szybszy.
Czy potrzebuję Hadoop, żeby uruchomić PySparka?
Nie. pip install pyspark zawiera runtime Sparka, który działa lokalnie na twojej maszynie bez Hadoop. Składniki Hadoop są potrzebne tylko wtedy, gdy czytasz z HDFS lub uruchamiasz Sparka na klastrze YARN.
PySpark to interfejs API w Pythonie dla Apache Spark. Piszesz kod DataFrame lub SQL w Pythonie, a Spark dzieli pracę na wszystkie rdzenie CPU w twoim laptopie lub na wszystkie maszyny w klastrze. Sięgam po niego, gdy zbiór danych nie mieści się już wygodnie w pandas albo gdy to samo zadanie ma później działać w klastrze bez przepisywania.
W tym samouczku PySpark zainstaluję PySpark 4.3, utworzę SparkSession i wyjaśnię dwie kwestie, na których najczęściej potykają się początkujący: RDD kontra DataFrame’y oraz leniwa ewaluacja. Potem przejdziemy przez operacje, których będziesz używać na co dzień (select, filter, groupBy, join i Spark SQL) na zbiorze danych e-commerce liczącym 541 909 wierszy, a na końcu zbudujemy model segmentacji klientów K-Means za pomocą API Pipeline z
pyspark.ml.Jeśli chcesz ćwiczeń z podpowiedziami do tego samouczka, nasz kurs Introduction to PySpark obejmuje ten sam materiał. Dłuższy plan nauki znajdziesz w przewodniku How to Learn PySpark From Scratch.
TL;DR
pip install "pyspark[sql]"; PySpark 4.3 wymaga Pythona 3.11+ i Javy 17+.SparkSession, a domyślnym API są DataFrame’y (nie RDD).count()lubshow().pyspark.mlłączą przygotowanie cech i modele, takie jak K-Means, w jeden obiekt.Czym jest Apache Spark?
Apache Spark to otwartoźródłowy silnik do rozproszonego przetwarzania danych. Dzieli zbiór danych na partycje, przetwarza je równolegle w całym klastrze i trzyma wyniki pośrednie w pamięci zamiast zapisywać je na dysk między krokami.
To przetwarzanie w pamięci jest głównym powodem, dla którego Spark zastąpił Hadoop MapReduce w większości wsadowych obciążeń (porównujemy je w Hadoop vs Spark). Spark powstał w AMPLab na Uniwersytecie Kalifornijskim w Berkeley w 2009 roku, został projektem najwyższego poziomu Apache w 2014, a wersję 4.3 wydano 30 października 2026.
Jeden silnik obsługuje kilka rodzajów zadań dzięki wbudowanym bibliotekom:
pyspark.ml) do rozproszonego uczenia maszynowegoAby bliżej zobaczyć, jak driver, menedżer klastra i egzekutory dzielą pracę, zajrzyj do naszego przewodnika po architekturze Apache Spark.