

Что такое PySpark?
PySpark — это Python‑API для Apache Spark. Ваш код на Python описывает нужные преобразования, а движок Spark, работающий на JVM, планирует и выполняет их в кластере. Вы получаете распределённое выполнение Spark без написания кода на Scala или Java.
Дата-сайентисты используют PySpark для очистки и агрегации больших наборов данных, дата-инженеры — для ETL‑конвейеров, а обе группы — pyspark.ml для обучения моделей на данных, которые не помещаются на одну машину. Если вы в основном работаете в pandas, API DataFrame покажется знакомым.
Когда использовать PySpark вместо pandas
PySpark окупается, когда данные выходят за рамки одной машины; при меньших объёмах pandas обычно быстрее, так как у него нет накладных расходов на запуск JVM и планирование задач.
| Возможность | pandas | PySpark |
|---|---|---|
| Размер данных | Ограничен ОЗУ одной машины | Ограничен суммарной памятью и диском кластера |
| Выполнение | Жадное, в основном одно ядро | Ленивое, параллельно по ядрам или машинам |
| Накладные расходы запуска | Отсутствуют | Несколько секунд на запуск JVM и SparkSession |
| Стриминговые данные | Не поддерживается | Structured Streaming |
| Машинное обучение | Экосистема scikit-learn | pyspark.ml (распределённое) |
| Отказоустойчивость | Нет; при сбое работа теряется | Потерянные партиции пересчитываются по их родословной |
Моё правило: если данные помещаются в память с запасом и задача запускается на одном ноутбуке, оставайтесь с pandas. Переходите на PySpark, когда вы боретесь с ошибками памяти или когда задача в итоге будет запускаться в кластере или на платформе вроде Databricks.
Как установить PySpark
PySpark устанавливается из PyPI одной командой pip и включает рантайм Spark, поэтому для локальной работы отдельные загрузки Spark или Hadoop не нужны. Перед запуском проверьте два предварительных требования.
Предварительные требования
Согласно официальному руководству по установке, PySpark 4.3 требует:
- Python 3.11 или новее. Поддержка Python 3.10 в PySpark 4.3 прекращена; см. наш гид по настройке Python, если нужен более новый релиз.
- Java 17 или новее (Spark 4.3 работает на Java 17, 21 и 25) с переменной окружения
JAVA_HOME, указывающей на неё. Наше руководство по установке Java описывает шаги для каждой ОС.
Обе версии можно проверить в терминале:
python3 --version # Python 3.11 or later
java -version # openjdk version "17" or laterЕсли вы работаете в DataLab или Databricks, PySpark уже установлен — переходите к датасету.
Установка PySpark через pip
Рекомендую виртуальное окружение, чтобы зависимости PySpark не конфликтовали с другими проектами:
python3 -m venv pyspark-env
source pyspark-env/bin/activate
pip install "pyspark[sql]" "pandas<3"
python3 -c "import pyspark; print(pyspark.__version__)"4.3.0В Windows используйте python вместо python3, а окружение активируйте через pyspark-env\Scripts\activate. Дополнение [sql] добавляет pandas, PyArrow и NumPy, которые PySpark использует для toPandas() и pandas UDF. Я фиксирую pandas<3, потому что PySpark 4.3 выводит предупреждение о том, что pandas 3.0 ещё не полностью поддерживается.
Две ошибки объясняют большинство неудачных первых запусков:
JAVA_GATEWAY_EXITEDили «Unable to locate a Java Runtime»: Java отсутствует или не заданJAVA_HOME.PYTHON_VERSION_MISMATCH: Рабочие процессы Spark подхватили другую версию Python, чем ваш скрипт. УстановитеPYSPARK_PYTHONна интерпретатор вашего окружения, напримерexport PYSPARK_PYTHON=$(which python).
Для шагов, зависящих от ОС, включая Windows, см. наш гид по установке PySpark.
Получение датасета
Примеры используют e-commerce датасет из 541 909 транзакций от британского онлайн‑ритейлера за период с декабря 2010 по декабрь 2011. Каждая строка — это одна товарная позиция в счёте, 8 столбцов:
InvoiceNo: номер счёта (номера, начинающиеся с «C», — отмены)StockCodeиDescription: код и название товараQuantityиUnitPrice: купленное количество и цена за единицу в фунтах стерлинговInvoiceDate: дата и время покупкиCustomerID: идентификатор клиента (в некоторых строках отсутствует)Country: страна клиента
Его можно скачать как datacamp_ecommerce.csv со страницы датасета DataLab. Это датасет Online Retail из репозитория UCI, поэтому тот же файл можно собрать из публичного источника (понадобится pip install openpyxl):
import io
import urllib.request
import zipfile
import pandas as pd
url = "https://archive.ics.uci.edu/static/public/352/online+retail.zip"
with urllib.request.urlopen(url) as response:
archive = zipfile.ZipFile(io.BytesIO(response.read()))
retail = pd.read_excel(
archive.open("Online Retail.xlsx"),
dtype={"InvoiceNo": str, "StockCode": str, "CustomerID": "Int64"},
)
# Match the DataLab file's date format, e.g. 12/1/10 8:26
retail["InvoiceDate"] = retail["InvoiceDate"].map(
lambda ts: f"{ts.month}/{ts.day}/{ts:%y} {ts.hour}:{ts:%M}"
)
retail.to_csv("datacamp_ecommerce.csv", index=False)Чтение 23‑МБ Excel‑файла занимает около минуты. Сохраните CSV в папку, из которой вы будете запускать остальной код.
Создание SparkSession
SparkSession — точка входа в любую программу PySpark: он соединяет ваш код на Python с движком Spark и создаёт DataFrame. На приложение создавайте один объект через шаблон builder:
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("PySparkTutorial").getOrCreate()
print(spark.version)4.3.0getOrCreate() возвращает работающую сессию, если она уже есть, поэтому вызывать его дважды в ноутбуке безопасно. Запущенный из обычного процесса Python, Spark работает в локальном режиме (local[*]), используя все ядра CPU вашей машины как воркеры, и поднимает интерфейс Spark UI на http://localhost:4040 для мониторинга задач. По завершении вызов spark.stop() освобождает ресурсы.
Загрузка e-commerce датасета
С запущенной сессией читаем CSV в DataFrame. Я передаю явную схему вместо inferSchema=True, которое заставляет Spark лишний раз сканировать весь файл, чтобы угадать типы столбцов:
import pyspark.sql.functions as F
schema = """
InvoiceNo STRING, StockCode STRING, Description STRING, Quantity INT,
InvoiceDate STRING, UnitPrice DOUBLE, CustomerID INT, Country STRING
"""
orders = spark.read.csv(
"datacamp_ecommerce.csv", header=True, schema=schema, escape='"'
)
orders = orders.withColumn("InvoiceDate", F.to_timestamp("InvoiceDate", "M/d/yy H:mm"))
orders.printSchema()root
|-- InvoiceNo: string (nullable = true)
|-- StockCode: string (nullable = true)
|-- Description: string (nullable = true)
|-- Quantity: integer (nullable = true)
|-- InvoiceDate: timestamp (nullable = true)
|-- UnitPrice: double (nullable = true)
|-- CustomerID: integer (nullable = true)
|-- Country: string (nullable = true)Два важных момента в этом фрагменте:
escape='"'обрабатывает названия товаров с двойными кавычками, напримерRECORD FRAME 7"" SINGLE SIZE. Символ экранирования по умолчанию в Spark — обратная косая.- Шаблон даты
M/d/yy H:mmсоответствует значениям вида12/1/10 8:26. Начиная с Spark 4.0, режим ANSI SQL включён по умолчанию, поэтомуto_timestamp()выдаёт ошибкуCANNOT_PARSE_TIMESTAMPна значение, не соответствующее шаблону. ИспользуйтеF.try_to_timestamp(), если для плохих строк вы предпочитаете получатьNULL.
Чтобы просмотреть первые строки и посчитать их число:
orders.show(5, truncate=False)
print(orders.count())+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|InvoiceNo|StockCode|Description |Quantity|InvoiceDate |UnitPrice|CustomerID|Country |
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|536365 |85123A |WHITE HANGING HEART T-LIGHT HOLDER |6 |2010-12-01 08:26:00|2.55 |17850 |United Kingdom|
|536365 |71053 |WHITE METAL LANTERN |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84406B |CREAM CUPID HEARTS COAT HANGER |8 |2010-12-01 08:26:00|2.75 |17850 |United Kingdom|
|536365 |84029G |KNITTED UNION FLAG HOT WATER BOTTLE|6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84029E |RED WOOLLY HOTTIE WHITE HEART. |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
only showing top 5 rows
541909Другие варианты чтения — несколько файлов, разделители, битые записи — см. в нашем руководстве по чтению CSV в PySpark.
RDD против DataFrame
RDD и DataFrame — два способа представления распределённых данных в PySpark, и почти для всего нового кода правильный выбор — DataFrame.
| Абстракция | Что это | Когда использовать |
|---|---|---|
| RDD (Resilient Distributed Dataset) | Низкоуровневая неизменяемая коллекция произвольных объектов Python, разбитая на партиции | Неструктурированные данные или когда нужен тонкий контроль над партиционированием |
| DataFrame | Распределённая таблица с именованными типизированными столбцами, похожая на pandas DataFrame | Аналитика, SQL‑запросы, ETL и машинное обучение |
Одинаковая агрегация — суммарное количество по странам — записанная двумя способами:
sales = [("United Kingdom", 6), ("France", 24), ("United Kingdom", 8)]
# RDD: вы пишете логику на Python‑функциях
rdd = spark.sparkContext.parallelize(sales)
print(rdd.reduceByKey(lambda a, b: a + b).collect())
# DataFrame: вы декларируете результат, а Spark планирует, как его посчитать
sales_df = spark.createDataFrame(sales, ["country", "quantity"])
sales_df.groupBy("country").sum("quantity").show()[('France', 24), ('United Kingdom', 14)]
+--------------+-------------+
| country|sum(quantity)|
+--------------+-------------+
|United Kingdom| 14|
| France| 24|
+--------------+-------------+Версия на RDD выполняет вашу lambda в рабочих процессах Python. Версия на DataFrame проходит через оптимизатор Catalyst, который переписывает запрос в эффективный план, исполняемый внутри JVM, поэтому код на DataFrame обычно быстрее без какой‑либо настройки. Дальше в руководстве мы используем DataFrame.
Ленивые вычисления: преобразования против действий
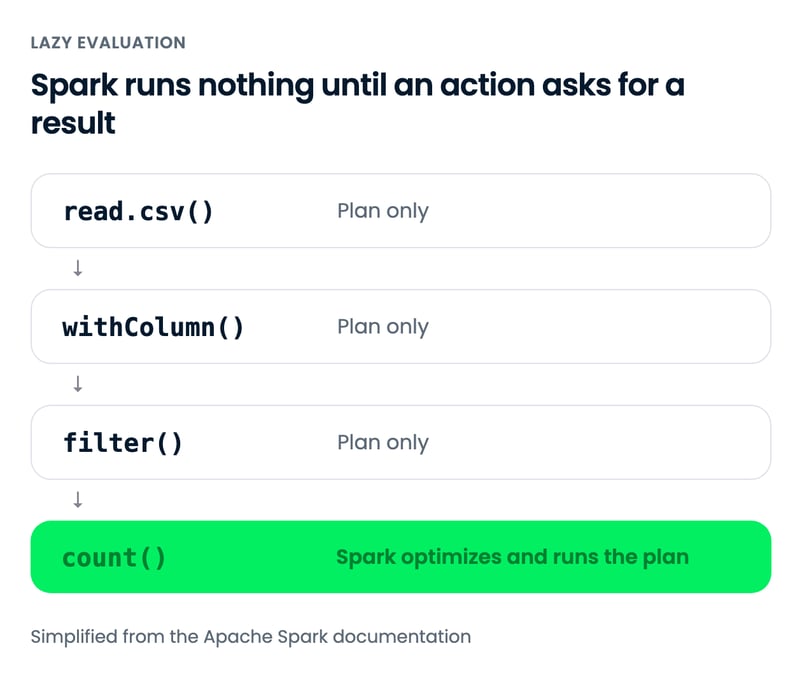
Ленивые вычисления означают, что Spark не выполняет преобразование в момент вызова; он записывает шаг в план и запускает весь план только тогда, когда действие запрашивает результат.
| Преобразования | Действия | |
|---|---|---|
| Что делают | Описывают новый DataFrame | Возвращают результат или записывают данные |
| Когда выполняются | Никогда сами по себе | Сразу, запуская все ожидающие преобразования |
| Примеры | select(), filter(), withColumn(), groupBy(), join() | show(), count(), collect(), toPandas(), write |
Фильтр ниже возвращается мгновенно, даже несмотря на более чем полмиллиона строк, потому что чтение ещё не началось. Именно вызов count() запускает задачу:
uk_orders = orders.filter(F.col("Country") == "United Kingdom") # преобразование: ещё без задачи
print(uk_orders.count()) # действие: Spark читает файл сейчас495478Ожидание до действия позволяет Spark оптимизировать всю цепочку за раз. explain() печатает выбранный физический план (усечён здесь):
uk_orders.explain()== Physical Plan ==
*(1) Project [InvoiceNo#0, StockCode#1, ...]
+- *(1) Filter (isnotnull(Country#7) AND (Country#7 = United Kingdom))
+- FileScan csv [...] PushedFilters: [IsNotNull(Country), EqualTo(Country,United Kingdom)], ...Запись PushedFilters показывает, что Spark проталкивает фильтр по стране в чтение файла, поэтому строки из других стран отбрасываются уже при парсинге CSV. Практическое следствие: ошибка данных внутри преобразования, например дата, не распарсившаяся в ANSI‑режиме, проявится только при следующем действии несколькими строками ниже.
Типовые операции с DataFrame
Большинство кода PySpark — это цепочка из пяти операций DataFrame: select(), filter(), withColumn(), groupBy() и join(). Каждая возвращает новый DataFrame, так что их можно свободно комбинировать.
Выбор столбцов с select()
select() возвращает DataFrame только с указанными столбцами:
orders.select("InvoiceNo", "Description", "Quantity", "UnitPrice").show(3, truncate=False)+---------+----------------------------------+--------+---------+
|InvoiceNo|Description |Quantity|UnitPrice|
+---------+----------------------------------+--------+---------+
|536365 |WHITE HANGING HEART T-LIGHT HOLDER|6 |2.55 |
|536365 |WHITE METAL LANTERN |6 |3.39 |
|536365 |CREAM CUPID HEARTS COAT HANGER |8 |2.75 |
+---------+----------------------------------+--------+---------+
only showing top 3 rowsФильтрация строк с filter()
filter() оставляет строки, соответствующие условию. В этом датасете вперемешку продажи и отмены (номера счетов, начинающиеся на «C»), отрицательные количества и строки без клиента, поэтому оставим только валидные продажи:
sales_only = orders.filter(
(F.col("Quantity") > 0)
& (F.col("UnitPrice") > 0)
& F.col("CustomerID").isNotNull()
& ~F.col("InvoiceNo").startswith("C")
)
print(sales_only.count())397884Комбинируйте условия с & (и), | (или) и ~ (не), оборачивая каждое в скобки, иначе приоритет операторов в Python сначала применит & перед >. Больше примеров — в нашем руководстве по filter в PySpark.
Добавление столбцов с withColumn()
withColumn() добавляет столбец или заменяет существующий с тем же именем. Здесь он считает стоимость каждой позиции:
sales_only = sales_only.withColumn("TotalAmount", F.round(F.col("Quantity") * F.col("UnitPrice"), 2))
sales_only.select("InvoiceNo", "Quantity", "UnitPrice", "TotalAmount").show(3)+---------+--------+---------+-----------+
|InvoiceNo|Quantity|UnitPrice|TotalAmount|
+---------+--------+---------+-----------+
| 536365| 6| 2.55| 15.3|
| 536365| 6| 3.39| 20.34|
| 536365| 8| 2.75| 22.0|
+---------+--------+---------+-----------+
only showing top 3 rowsСм. наше руководство по withColumn() в PySpark для условных столбцов с F.when().
Агрегации с groupBy() и agg()
groupBy() группирует строки по одному или нескольким столбцам, а agg() считает одну или несколько сводок по группе. Какие страны приносят больше всего выручки?
country_revenue = (
sales_only.groupBy("Country")
.agg(
F.count_distinct("CustomerID").alias("customers"),
F.round(F.sum("TotalAmount"), 2).alias("revenue"),
)
.orderBy(F.desc("revenue"))
)
country_revenue.show(5)+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+
only showing top 5 rowsВеликобритания доминирует, что ожидаемо для британского ритейлера. Интереснее Нидерланды и Ирландия (EIRE): 9 и 3 клиента тратят больше, чем 94 в Германии — это наводит на мысль о закупках оптом.
Обратите внимание, я импортирую модуль функций как F вместо from pyspark.sql.functions import *, который затеняет встроенные в Python sum(), min() и max(). Начиная с PySpark 4.0, такой импорт звёздочкой также больше не экспортирует старое camelCase‑имя countDistinct.
Глубже в агрегации — в нашем руководстве по groupBy в PySpark.
Соединения DataFrame с join()
join() объединяет два DataFrame по общему ключу. Чтобы проставить каждой стране регион, присоединим небольшую таблицу соответствий и намеренно оставим Австралию незаполненной:
regions = spark.createDataFrame(
[("United Kingdom", "UK"), ("Netherlands", "EU"), ("EIRE", "EU"),
("Germany", "EU"), ("France", "EU")],
["Country", "region"],
)
country_revenue.join(regions, on="Country", how="left").orderBy(F.desc("revenue")).show(6)+--------------+---------+----------+------+
| Country|customers| revenue|region|
+--------------+---------+----------+------+
|United Kingdom| 3920|7308391.55| UK|
| Netherlands| 9| 285446.34| EU|
| EIRE| 3| 265545.9| EU|
| Germany| 94| 228867.14| EU|
| France| 87| 209024.05| EU|
| Australia| 9| 138521.31| NULL|
+--------------+---------+----------+------+
only showing top 6 rowsЛевое соединение сохраняет все строки из левого DataFrame и заполняет пропуски NULL, поэтому Австралия остаётся в результате. Внутреннее соединение (how="inner", по умолчанию) её бы отбросило. Наше руководство по соединениям в PySpark сравнивает все типы и их производительность.
Spark SQL в PySpark
Spark SQL позволяет выполнять запросы к DataFrame стандартным SQL, зарегистрировав его как временное представление. Этот запрос воспроизводит таблицу выручки по странам из раздела groupBy:
sales_only.createOrReplaceTempView("sales")
spark.sql("""
SELECT Country,
COUNT(DISTINCT CustomerID) AS customers,
ROUND(SUM(TotalAmount), 2) AS revenue
FROM sales
GROUP BY Country
ORDER BY revenue DESC
LIMIT 5
""").show()+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+Обе версии компилируются в один и тот же оптимизированный план, так что ни одна не быстрее. Я использую SQL для длинных агрегаций, которые будут читать аналитики, а API DataFrame — когда вокруг запроса нужна логика на Python, например построение фильтров в цикле. spark.sql() возвращает DataFrame, так что их можно свободно комбинировать.
Временное представление живёт до остановки SparkSession.
Машинное обучение в PySpark: пример K‑Means
Модуль pyspark.ml обучает модели на DataFrame, а Pipeline объединяет подготовку признаков и модель в один объект, который можно обучить и переиспользовать. Для демонстрации сегментируем клиентов ритейлера методом K‑Means по давности, частоте и денежной ценности (RFM) — стандартной маркетинговой сегментации:
- Recency: дни с момента последней покупки клиента
- Frequency: количество уникальных счетов
- Monetary: общая сумма трат
Построение RFM‑признаков с groupBy()
Один groupBy() по очищенному DataFrame sales_only даёт все 3 признака. Давность измеряется от дня после последней даты в данных:
snapshot = sales_only.agg(F.date_add(F.max("InvoiceDate"), 1)).first()[0]
rfm = sales_only.groupBy("CustomerID").agg(
F.datediff(F.lit(snapshot), F.max("InvoiceDate")).alias("recency"),
F.count_distinct("InvoiceNo").alias("frequency"),
F.round(F.sum("TotalAmount"), 2).alias("monetary"),
)
rfm.describe("recency", "frequency", "monetary").show()+-------+------------------+-----------------+------------------+
|summary| recency| frequency| monetary|
+-------+------------------+-----------------+------------------+
| count| 4338| 4338| 4338|
| mean| 93.05947441217151|4.272014753342554|2054.2664591977896|
| stddev|100.01226424171826|7.697997826095038| 8989.230441421178|
| min| 1| 1| 3.75|
| max| 374| 209| 280206.02|
+-------+------------------+-----------------+------------------+Посмотрите на monetary: среднее около £2 054, стандартное отклонение в четыре с лишним раза выше и максимум свыше £280 000. K‑Means измеряет евклидово расстояние, поэтому несколько крупных покупателей доминировали бы в кластерах. Логарифмирование каждого признака сжимает этот «длинный хвост».
Масштабирование и кластеризация в Pipeline
Конвейер состоит из 3 этапов: VectorAssembler упаковывает признаки в единственный векторный столбец, который ожидают модели pyspark.ml, StandardScaler приводит их к одной шкале, а KMeans выполняет кластеризацию. Обучим для k = 2…6 и оценим каждую модель силуэт‑метрикой от −1 до 1: чем выше, тем лучше разделены кластеры.
from pyspark.ml import Pipeline
from pyspark.ml.clustering import KMeans
from pyspark.ml.evaluation import ClusteringEvaluator
from pyspark.ml.feature import StandardScaler, VectorAssembler
rfm_log = rfm.select(
"CustomerID",
"recency", "frequency", "monetary",
F.log1p("recency").alias("log_recency"),
F.log1p("frequency").alias("log_frequency"),
F.log1p("monetary").alias("log_monetary"),
).cache()
assembler = VectorAssembler(
inputCols=["log_recency", "log_frequency", "log_monetary"], outputCol="features_raw"
)
scaler = StandardScaler(
inputCol="features_raw", outputCol="features", withMean=True, withStd=True
)
evaluator = ClusteringEvaluator(featuresCol="features", metricName="silhouette")
for k in range(2, 7):
kmeans = KMeans(featuresCol="features", k=k, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
score = evaluator.evaluate(model.transform(rfm_log))
print(f"k={k} silhouette={score:.3f}")k=2 silhouette=0.624
k=3 silhouette=0.502
k=4 silhouette=0.502
k=5 silhouette=0.478
k=6 silhouette=0.470.cache() держит rfm_log в памяти, потому что каждое обучение и оценка в цикле снова читает его; без кеширования Spark пересчитывал бы RFM‑таблицу из CSV при каждом fit.
Выбор k и интерпретация сегментов
Силуэт максимален при k = 2, но 2 сегмента в основном делят активных клиентов и «остывших», с чем маркетингу не так много что делать. k = 4 даёт ту же оценку, что и k = 3, и делит активных на крупных покупателей и новичков, так что возьмём его и опишем кластеры:
kmeans = KMeans(featuresCol="features", k=4, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
segments = model.transform(rfm_log)
(segments.groupBy("prediction")
.agg(
F.count("*").alias("customers"),
F.round(F.avg("recency"), 1).alias("avg_recency"),
F.round(F.avg("frequency"), 1).alias("avg_frequency"),
F.round(F.avg("monetary"), 1).alias("avg_monetary"),
)
.orderBy("prediction")
.show())+----------+---------+-----------+-------------+------------+
|prediction|customers|avg_recency|avg_frequency|avg_monetary|
+----------+---------+-----------+-------------+------------+
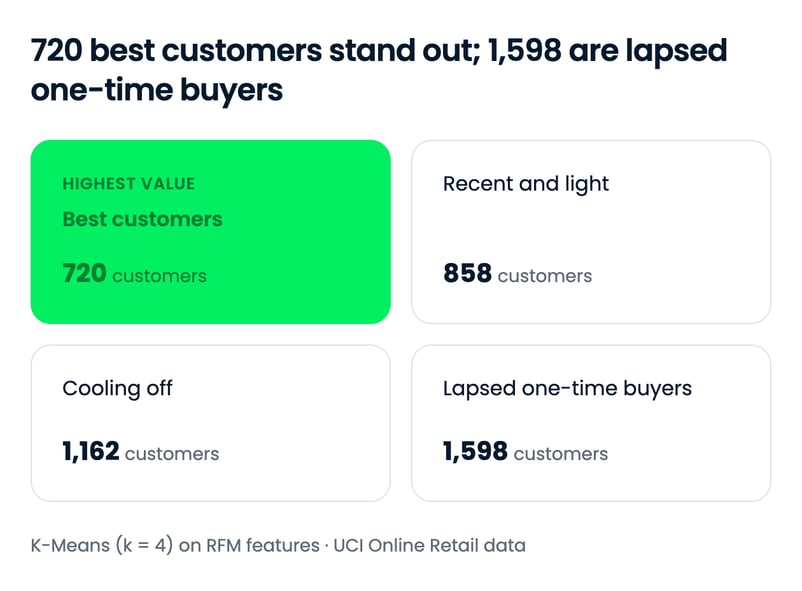
| 0| 1598| 181.2| 1.3| 326.2|
| 1| 720| 13.2| 13.7| 8072.7|
| 2| 1162| 77.1| 3.9| 1765.2|
| 3| 858| 17.4| 2.3| 613.7|
+----------+---------+-----------+-------------+------------+Четыре сегмента читаются однозначно:
- Кластер 1, лучшие клиенты (720): в среднем покупали в последние 2 недели, около 14 заказов и более £8 000 трат на каждого. Сюда идут удержание и программы лояльности.
- Кластер 3, недавние и «лёгкие» (858): активность за последние 3 недели, но около 2 заказов. Многие — вероятно, новые клиенты, которых стоит подтолкнуть ко 2‑й и 3‑й покупке.
- Кластер 2, «остывающие» (1 162): средние траты, но около 11 недель с последней покупки. Здесь у кампании «вернуть клиента» наилучшие шансы.
- Кластер 0, разовые давно ушедшие (1 598): в основном один заказ, примерно на £326, около полугода назад. Самая большая и наименее ценная группа.
Номера кластеров — произвольные метки, и другой сид может их переупорядочить, поэтому всегда профилируйте сегменты перед тем, как их называть. Как K‑Means выбирает центроиды, см. в нашем введении в кластеризацию k‑means, а справочник API pyspark.ml перечисляет все модели и трансформеры. Курс Machine Learning with PySpark охватывает классификацию, регрессию и настройку моделей в Pipelines.
Итоги
PySpark сводится к нескольким идеям: SparkSession для старта, DataFrame почти для всего, ленивые преобразования, которые выполняются только при необходимости результата, и выбор — писать каждый запрос на Python или SQL. Всё в этом руководстве запускалось в локальном режиме на ноутбуке, и тот же код без изменений работает в кластере.
Файл на 541 909 строк не требует кластера, и pandas бы справился. Это сделано намеренно, потому что привычки, важные на больших данных (явные схемы, ранняя фильтрация, кеширование повторного использования и проверка explain()), проще выработать на данных, которые можно просмотреть глазами.
Дальше — лучшие следующие шаги в зависимости от цели:
- Попрактикуйтесь в API DataFrame: Introduction to PySpark
- Готовьте «грязные» реальные данные: Cleaning Data with PySpark
- Держите синтаксис под рукой: наш шпаргалка по PySpark
- Готовьтесь к собеседованию: Top PySpark interview questions
Если хотите пойти дальше, рекомендуем трек Big Data with PySpark, где последовательно разбираются управление данными, построение признаков, конвейеры ML и рекомендательные системы. Для команд DataCamp for Business предлагает учебные пути для ролей в дата‑инжиниринге.
Частые вопросы по PySpark
Каковы предварительные требования для изучения PySpark?
PySpark 4.3 требует Python 3.11 или новее и Java 17 или новее (Spark 4.3 работает на Java 17, 21 и 25), при этом JAVA_HOME должен указывать на установку Java. Вам стоит уверенно владеть базовым Python; опыт с pandas DataFrame помогает, так как API DataFrame в PySpark использует схожие идеи. Предварительный опыт с распределёнными системами не требуется.
Быстрее ли PySpark, чем pandas?
Не на малых данных. pandas работает в процессе без стоимости запуска, тогда как PySpark тратит несколько секунд на старт JVM и планирование задач, поэтому на данных, которые комфортно помещаются в память, чаще выигрывает pandas. PySpark быстрее, когда работа выходит за рамки памяти или CPU одной машины, так как он обрабатывает партиции параллельно по ядрам или узлам кластера.
В чём разница между RDD и DataFrame в PySpark?
RDD (Resilient Distributed Dataset) — низкоуровневая структура PySpark: распределённая коллекция произвольных объектов Python, которую вы обрабатываете своими функциями. DataFrame организует данные в именованные типизированные столбцы, как в pandas DataFrame, а оптимизатор Catalyst в Spark превращает запросы DataFrame в эффективные планы выполнения. Используйте DataFrame почти для всего нового кода, а RDD — лишь для неструктурированных данных или тонкого контроля партиционирования.
Как запустить PySpark в Jupyter Notebook?
Установите Java 17 или новее, затем выполните pip install "pyspark[sql]" в том окружении, которое использует ваш ноутбук. Создайте SparkSession в первой ячейке:
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("MyNotebook").getOrCreate()Если хотите пропустить локальную настройку, ноутбуки DataLab и Databricks идут с предустановленным PySpark.
Когда стоит использовать PySpark вместо pandas?
Используйте PySpark, когда ваши данные не помещаются в память одной машины, когда задачу нужно запускать в кластере или на платформе вроде Databricks, или когда вы строите конвейеры, которые вырастут за пределы ноутбука. Для исследовательского анализа на данных, помещающихся в память, pandas проще и стартует мгновенно. Код PySpark, написанный локально, без изменений работает в кластере, поэтому начинать с него логично, если масштабирование вероятно.
Что такое ленивые вычисления в PySpark?
Ленивые вычисления означают, что PySpark не выполняет преобразования, такие как filter() или withColumn(), в момент их вызова. Он записывает их в план и исполняет этот план только тогда, когда действие — например, count(), show() или write — требует результат. Ожидание позволяет Spark оптимизировать всю цепочку, например протолкнуть фильтры в чтение файла.
Как выполнять SQL‑запросы в PySpark?
Зарегистрируйте DataFrame как временное представление с помощью df.createOrReplaceTempView("sales"), затем выполните запрос spark.sql("SELECT ... FROM sales"). Результат — обычный DataFrame, поэтому можно свободно смешивать SQL и код DataFrame. Оба варианта компилируются в один оптимизированный план, так что ни один не быстрее.
Нужен ли Hadoop для запуска PySpark?
Нет. pip install pyspark включает рантайм Spark, который локально работает на вашей машине без Hadoop. Компоненты Hadoop нужны только если вы читаете из HDFS или запускаете Spark на кластере YARN.
PySpark — это Python‑API для Apache Spark. Вы пишете код DataFrame или SQL на Python, а Spark распределяет работу по всем ядрам процессора на вашем ноутбуке или по всем машинам в кластере. Я использую его, когда набор данных уже не помещается в pandas или когда ту же задачу позже нужно будет запускать в кластере без переписывания.
В этом руководстве по PySpark мы установим PySpark 4.3, создадим SparkSession и разберём две идеи, которые чаще всего сбивают новичков: RDD против DataFrame и ленивые вычисления. Затем выполним повседневные операции (select, filter, groupBy, join и Spark SQL) на e-commerce датасете из 541 909 строк и завершим моделью сегментации клиентов K‑Means, собранной с помощью Pipeline API
pyspark.ml.Если вам нужны практические упражнения параллельно с этим туториалом, курс Introduction to PySpark охватывает те же темы. Для более длинного плана обучения см. руководство How to Learn PySpark From Scratch.
Кратко
pip install "pyspark[sql]"; PySpark 4.3 требует Python 3.11+ и Java 17+.SparkSession, а DataFrame (не RDD) — это основной API.count()илиshow().pyspark.mlобъединяют подготовку признаков и модели, такие как K‑Means, в один объект.Что такое Apache Spark?
Apache Spark — это движок с открытым исходным кодом для распределённой обработки данных. Он делит набор данных на партиции, обрабатывает их параллельно по всему кластеру и держит промежуточные результаты в памяти вместо записи на диск между шагами.
Именно благодаря работе в памяти Spark вытеснил Hadoop MapReduce для большинства пакетных задач (сравнение см. в Hadoop vs Spark). Spark появился в AMPLab Беркли в 2009 году, стал верхнеуровневым проектом Apache в 2014‑м и достиг версии 4.3 30 октября 2026 года.
Один движок покрывает несколько типов нагрузок через встроенные библиотеки:
pyspark.ml) для распределённого машинного обученияПодробнее о том, как драйвер, менеджер кластера и исполнители делят работу, см. наш гид по архитектуре Apache Spark.