

PySpark คืออะไร?
PySpark คือ API ภาษา Python สำหรับ Apache Spark โค้ด Python จะอธิบายการแปลงข้อมูลที่ต้องการ และเอนจินของ Spark ซึ่งรันบน Java Virtual Machine (JVM) จะวางแผนและประมวลผลให้ทั่วทั้งคลัสเตอร์ ได้การประมวลผลแบบกระจายของ Spark โดยไม่ต้องเขียน Scala หรือ Java
นักวิทยาศาสตร์ข้อมูลใช้ PySpark ในการทำความสะอาดและสรุปรวมชุดข้อมูลขนาดใหญ่ วิศวกรข้อมูลใช้สำหรับสายงาน ETL และทั้งสองกลุ่มใช้ pyspark.ml เพื่อเทรนโมเดลบนข้อมูลที่ไม่พอจะใส่ในเครื่องเดียว หากคุ้นเคยกับ pandas อยู่แล้ว DataFrame API จะให้ความรู้สึกคุ้นมือ
ควรใช้ PySpark แทน pandas เมื่อใด
PySpark คุ้มค่าต่อการใช้เมื่อข้อมูลใหญ่เกินเครื่องเดียว หากน้อยกว่านั้น โดยมาก pandas จะเร็วกว่าเพราะไม่มีค่าใช้จ่ายเริ่มต้นของ JVM หรือการจัดสรรงาน
| คุณสมบัติ | pandas | PySpark |
|---|---|---|
| ขนาดข้อมูล | จำกัดด้วย RAM ของเครื่องเดียว | จำกัดด้วยหน่วยความจำและดิสก์รวมของคลัสเตอร์ |
| การประมวลผล | แบบ eager ส่วนใหญ่ใช้คอร์เดียว | แบบขี้เกียจ ทำงานขนานข้ามคอร์หรือหลายเครื่อง |
| ค่าใช้จ่ายเริ่มต้น | ไม่มี | ไม่กี่วินาทีในการเริ่ม JVM และ SparkSession |
| ข้อมูลสตรีมมิง | ไม่รองรับ | Structured Streaming |
| แมชชีนเลิร์นนิง | ระบบนิเวศของ scikit-learn | pyspark.ml (แบบกระจาย) |
| ความทนทานต่อความล้มเหลว | ไม่มี; หากแครช งานจะหาย | พาร์ทิชันที่หายจะถูกคำนวณซ้ำจากลำดับวงศ์ (lineage) |
กฎโดยรวม: หากข้อมูลพออยู่ในหน่วยความจำได้สบายและงานรันบนแล็ปท็อปเครื่องเดียว ให้ใช้ pandas ต่อไป เปลี่ยนมาใช้ PySpark เมื่อเริ่มเจอปัญหาหน่วยความจำ หรือเมื่องานจะต้องไปรันบนคลัสเตอร์หรือแพลตฟอร์มอย่าง Databricks ในภายหลัง
วิธีติดตั้ง PySpark
ติดตั้ง PySpark จาก PyPI ด้วยคำสั่ง pip เดียว ซึ่งมาพร้อมกับรันไทม์ของ Spark อยู่แล้ว จึงไม่ต้องดาวน์โหลด Spark หรือ Hadoop แยกต่างหากสำหรับการทำงานในเครื่อง ก่อนรัน ให้ตรวจสอบสิ่งที่ต้องมีสองอย่าง
สิ่งที่ต้องมี
ตาม คู่มือติดตั้งอย่างเป็นทางการ PySpark 4.3 ต้องการ:
- Python 3.11 ขึ้นไป PySpark 4.3 เลิกสนับสนุน Python 3.10; หากต้องการเวอร์ชันใหม่กว่า ดู คู่มือตั้งค่า Python ของเรา
- Java 17 ขึ้นไป (Spark 4.3 รันได้บน Java 17, 21 และ 25) โดยต้องตั้งค่า environment variable
JAVA_HOMEให้ชี้ไปยัง Java คู่มือ ติดตั้ง Java ของเราอธิบายตามระบบปฏิบัติการ
ตรวจสอบทั้งสองรายการจากเทอร์มินัลได้:
python3 --version # Python 3.11 หรือใหม่กว่า
java -version # openjdk version "17" หรือใหม่กว่าหากทำงานใน DataLab หรือ Databricks จะมี PySpark ติดตั้งไว้แล้ว สามารถข้ามไปส่วนชุดข้อมูลได้
ติดตั้ง PySpark ด้วย pip
แนะนำให้ใช้ virtual environment เพื่อไม่ให้ dependency ของ PySpark ชนกับโปรเจ็กต์อื่น:
python3 -m venv pyspark-env
source pyspark-env/bin/activate
pip install "pyspark[sql]" "pandas<3"
python3 -c "import pyspark; print(pyspark.__version__)"4.3.0บน Windows ใช้ python แทน python3 และเปิดใช้งานสภาพแวดล้อมด้วย pyspark-env\Scripts\activate ส่วน [sql] extra จะเพิ่ม pandas, PyArrow และ NumPy ซึ่ง PySpark ใช้กับ toPandas() และ pandas UDFs มีการปักหมุด pandas<3 เพราะ PySpark 4.3 แจ้งเตือนว่ายังไม่รองรับ pandas 3.0 อย่างสมบูรณ์
ข้อผิดพลาดสองอย่างที่เจอบ่อยในการรันครั้งแรก:
JAVA_GATEWAY_EXITEDหรือ "Unable to locate a Java Runtime": ไม่มี Java หรือไม่ได้ตั้งค่าJAVA_HOMEPYTHON_VERSION_MISMATCH: โพรเซสฝั่ง worker ของ Spark ใช้ Python คนละตัวกับสคริปต์ ให้ตั้งค่าPYSPARK_PYTHONให้ชี้ไปยังอินเทอร์พรีเตอร์ของสภาพแวดล้อม เช่นexport PYSPARK_PYTHON=$(which python)
สำหรับขั้นตอนเฉพาะระบบปฏิบัติการ รวมถึง Windows ดู คู่มือติดตั้ง PySpark ของเรา
การเตรียมชุดข้อมูล
ตัวอย่างใช้ชุดข้อมูลอีคอมเมิร์ซซึ่งมีธุรกรรม 541,909 รายการจากผู้ค้าปลีกออนไลน์ในสหราชอาณาจักร ครอบคลุมธันวาคม 2010 ถึงธันวาคม 2011 แต่ละแถวคือหนึ่งรายการสินค้าในใบแจ้งหนี้ มี 8 คอลัมน์ดังนี้:
InvoiceNo: หมายเลขใบแจ้งหนี้ (หมายเลขที่ขึ้นต้นด้วย "C" คือการยกเลิก)StockCodeและDescription: รหัสสินค้าและชื่อสินค้าQuantityและUnitPrice: จำนวนที่ซื้อและราคาต่อหน่วย เป็นปอนด์สเตอร์ลิงInvoiceDate: วันที่และเวลาที่ซื้อCustomerID: รหัสลูกค้า (บางแถวอาจว่าง)Country: ประเทศของลูกค้า
ดาวน์โหลดได้ในชื่อ datacamp_ecommerce.csv จากหน้า ชุดข้อมูล DataLab เป็นชุดข้อมูล Online Retail จาก UCI Machine Learning Repository จึงสามารถสร้างไฟล์เดียวกันจากแหล่งสาธารณะได้เช่นกัน (ต้อง pip install openpyxl):
import io
import urllib.request
import zipfile
import pandas as pd
url = "https://archive.ics.uci.edu/static/public/352/online+retail.zip"
with urllib.request.urlopen(url) as response:
archive = zipfile.ZipFile(io.BytesIO(response.read()))
retail = pd.read_excel(
archive.open("Online Retail.xlsx"),
dtype={"InvoiceNo": str, "StockCode": str, "CustomerID": "Int64"},
)
# Match the DataLab file's date format, e.g. 12/1/10 8:26
retail["InvoiceDate"] = retail["InvoiceDate"].map(
lambda ts: f"{ts.month}/{ts.day}/{ts:%y} {ts.hour}:{ts:%M}"
)
retail.to_csv("datacamp_ecommerce.csv", index=False)การอ่านไฟล์ Excel ขนาด 23 MB ใช้เวลาประมาณหนึ่งนาที ให้บันทึกไฟล์ CSV ไว้ในโฟลเดอร์เดียวกับที่รันโค้ดส่วนที่เหลือ
การสร้าง SparkSession
SparkSession คือจุดเริ่มต้นของทุกโปรแกรม PySpark: ทำหน้าที่เชื่อมโค้ด Python เข้ากับเอนจินของ Spark และสร้าง DataFrame คุณจะสร้างหนึ่งตัวต่อแอปพลิเคชันด้วยรูปแบบบิลเดอร์:
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("PySparkTutorial").getOrCreate()
print(spark.version)4.3.0getOrCreate() จะคืนค่าเซสชันที่กำลังรันอยู่หากมีอยู่แล้ว จึงเรียกซ้ำในโน้ตบุ๊กได้อย่างปลอดภัย หากรันจากกระบวนการ Python ปกติ Spark จะรันในโหมดโลคัล (local[*]) โดยใช้ทุกคอร์ของ CPU ในเครื่องเป็นเวิร์กเกอร์ และเปิด Spark UI ที่ http://localhost:4040 เพื่อดูงานต่าง ๆ เมื่อทำงานเสร็จแล้ว spark.stop() จะคืนทรัพยากร
โหลดชุดข้อมูลอีคอมเมิร์ซ
เมื่อเซสชันทำงานแล้ว เราจะอ่านไฟล์ CSV เข้าเป็น DataFrame โดยระบุสคีมาอย่างชัดเจนแทนการใช้ inferSchema=True ซึ่งจะทำให้ Spark สแกนทั้งไฟล์อีกรอบเพื่อเดาประเภทคอลัมน์:
import pyspark.sql.functions as F
schema = """
InvoiceNo STRING, StockCode STRING, Description STRING, Quantity INT,
InvoiceDate STRING, UnitPrice DOUBLE, CustomerID INT, Country STRING
"""
orders = spark.read.csv(
"datacamp_ecommerce.csv", header=True, schema=schema, escape='"'
)
orders = orders.withColumn("InvoiceDate", F.to_timestamp("InvoiceDate", "M/d/yy H:mm"))
orders.printSchema()root
|-- InvoiceNo: string (nullable = true)
|-- StockCode: string (nullable = true)
|-- Description: string (nullable = true)
|-- Quantity: integer (nullable = true)
|-- InvoiceDate: timestamp (nullable = true)
|-- UnitPrice: double (nullable = true)
|-- CustomerID: integer (nullable = true)
|-- Country: string (nullable = true)มีสองจุดที่สำคัญในสคริปต์ข้างต้น:
escape='"'จัดการชื่อสินค้า ที่มีเครื่องหมายอัญประกาศซ้ำ เช่นRECORD FRAME 7"" SINGLE SIZEโดยปริยาย Spark ใช้แบ็กสแลชเป็นอักขระ escape- รูปแบบวันที่
M/d/yy H:mmตรงกับค่าลักษณะ12/1/10 8:26ตั้งแต่ Spark 4.0 โหมด ANSI SQL เปิดใช้งานโดยค่าเริ่มต้น ดังนั้นto_timestamp()จะส่งข้อผิดพลาดCANNOT_PARSE_TIMESTAMPหากค่าไม่ตรงกับรูปแบบ ใช้F.try_to_timestamp()หากต้องการให้แถวที่ไม่ถูกต้องเป็นNULLแทน
เพื่อดูแถวแรก ๆ และนับจำนวน:
orders.show(5, truncate=False)
print(orders.count())+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|InvoiceNo|StockCode|Description |Quantity|InvoiceDate |UnitPrice|CustomerID|Country |
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|536365 |85123A |WHITE HANGING HEART T-LIGHT HOLDER |6 |2010-12-01 08:26:00|2.55 |17850 |United Kingdom|
|536365 |71053 |WHITE METAL LANTERN |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84406B |CREAM CUPID HEARTS COAT HANGER |8 |2010-12-01 08:26:00|2.75 |17850 |United Kingdom|
|536365 |84029G |KNITTED UNION FLAG HOT WATER BOTTLE|6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84029E |RED WOOLLY HOTTIE WHITE HEART. |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
only showing top 5 rows
541909สำหรับตัวเลือกการอ่านเพิ่มเติม เช่น หลายไฟล์ ตัวคั่น และเรคคอร์ดที่เสียหาย ดูได้ที่ บทความสอนอ่าน CSV ด้วย PySpark ของเรา
RDD เทียบกับ DataFrame
RDD และ DataFrame เป็นสองแนวทางในการแทนข้อมูลแบบกระจายใน PySpark และสำหรับโค้ดใหม่เกือบทั้งหมด ควรเลือกใช้ DataFrame
| นามธรรม | คืออะไร | ใช้เมื่อไร |
|---|---|---|
| RDD (Resilient Distributed Dataset) | โครงสร้างระดับล่าง เป็นคอลเลกชันที่แก้ไขไม่ได้ของอ็อบเจ็กต์ Python แบบใดก็ได้ แบ่งเป็นพาร์ทิชัน | ข้อมูลที่ไม่เป็นโครงสร้าง หรือเมื่อจำเป็นต้องควบคุมการแบ่งพาร์ทิชันอย่างละเอียด |
| DataFrame | ตารางแบบกระจายที่มีคอลัมน์แบบมีชื่อและมีชนิดข้อมูล คล้าย DataFrame ของ pandas | งานวิเคราะห์ คิวรี SQL งาน ETL และการเรียนรู้ของเครื่อง |
ตัวอย่างการรวมยอดแบบเดียวกัน ปริมาณรวมต่อประเทศ เขียนได้ทั้งสองวิธีดังนี้:
sales = [("United Kingdom", 6), ("France", 24), ("United Kingdom", 8)]
# RDD: คุณเขียนลอจิกด้วยฟังก์ชัน Python เอง
rdd = spark.sparkContext.parallelize(sales)
print(rdd.reduceByKey(lambda a, b: a + b).collect())
# DataFrame: คุณประกาศผลลัพธ์ แล้ว Spark วางแผนวิธีคำนวณให้
sales_df = spark.createDataFrame(sales, ["country", "quantity"])
sales_df.groupBy("country").sum("quantity").show()[('France', 24), ('United Kingdom', 14)]
+--------------+-------------+
| country|sum(quantity)|
+--------------+-------------+
|United Kingdom| 14|
| France| 24|
+--------------+-------------+เวอร์ชัน RDD จะรันแลมบ์ดาของคุณในโพรเซสเวิร์กเกอร์ของ Python ส่วนเวอร์ชัน DataFrame จะผ่านตัวเพิ่มประสิทธิภาพ Catalyst ของ Spark ซึ่งเขียนคิวรีใหม่ให้เป็นแผนที่มีประสิทธิภาพและรันใน JVM ดังนั้นโค้ด DataFrame มักเร็วกว่าโดยไม่ต้องจูน โค้ดที่เหลือในบทความนี้ใช้ DataFrame
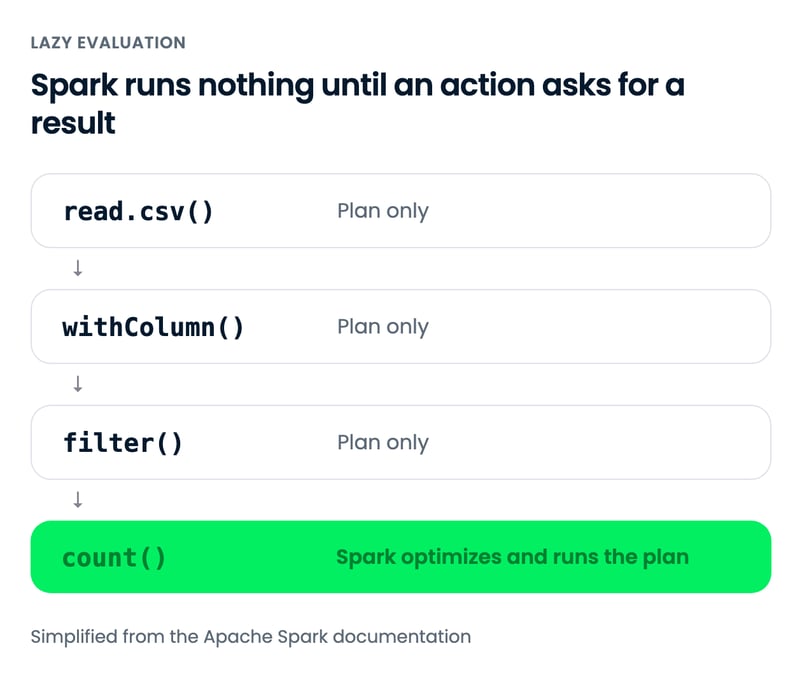
การประเมินผลแบบขี้เกียจ: Transformation เทียบกับ Action
การประเมินผลแบบขี้เกียจหมายความว่า Spark จะไม่รัน transformation ตอนที่เรียก มันเพียงบันทึกขั้นตอนในแผน และจะรันทั้งแผนก็ต่อเมื่อมี action ขอผลลัพธ์
| Transformations | Actions | |
|---|---|---|
| ทำอะไร | อธิบาย DataFrame ตัวใหม่ | คืนผลลัพธ์หรือเขียนข้อมูล |
| รันเมื่อไร | ไม่รันเองตามลำพัง | รันทันทีและกระตุ้นให้ทุก transformation ที่รออยู่ทำงาน |
| ตัวอย่าง | select(), filter(), withColumn(), groupBy(), join() | show(), count(), collect(), toPandas(), write |
ตัวอย่าง filter ด้านล่างจะคืนค่าทันที แม้ว่าชุดข้อมูลจะมีมากกว่าครึ่งล้านแถว เพราะยังไม่มีการอ่านข้อมูล count() ต่างหากที่เป็นตัวเริ่มงาน:
uk_orders = orders.filter(F.col("Country") == "United Kingdom") # transformation: ยังไม่เกิดงาน
print(uk_orders.count()) # action: Spark อ่านไฟล์ตอนนี้495478การรอจนถึง action ทำให้ Spark เพิ่มประสิทธิภาพทั้งสายงานได้พร้อมกัน explain() จะแสดงแผนทางกายภาพที่เลือก (ตัดให้สั้นไว้ที่นี่):
uk_orders.explain()== Physical Plan ==
*(1) Project [InvoiceNo#0, StockCode#1, ...]
+- *(1) Filter (isnotnull(Country#7) AND (Country#7 = United Kingdom))
+- FileScan csv [...] PushedFilters: [IsNotNull(Country), EqualTo(Country,United Kingdom)], ...รายการ PushedFilters แสดงว่า Spark ผลักเงื่อนไขประเทศลงไปถึงขั้นอ่านไฟล์ จึงตัดแถวของประเทศอื่นทิ้งตั้งแต่ตอนอ่าน CSV ผลที่ตามมาที่ใช้ได้จริงอย่างหนึ่งคือ ข้อผิดพลาดข้อมูลภายใน transformation เช่น วันที่พาร์สไม่ผ่านในโหมด ANSI จะผุดขึ้นเมื่อมี action ถัดไปทำงานเท่านั้น ซึ่งอาจจะอยู่อีกหลายบรรทัดต่อมา
การดำเนินงาน DataFrame ที่พบบ่อย
โค้ด PySpark ส่วนใหญ่เป็นการเชื่อมห้าการดำเนินการของ DataFrame: select(), filter(), withColumn(), groupBy() และ join() แต่ละคำสั่งจะคืน DataFrame ใหม่ จึงเชื่อมต่อกันได้ตามต้องการ
เลือกคอลัมน์ด้วย select()
select() จะคืน DataFrame เฉพาะคอลัมน์ที่ระบุ:
orders.select("InvoiceNo", "Description", "Quantity", "UnitPrice").show(3, truncate=False)+---------+----------------------------------+--------+---------+
|InvoiceNo|Description |Quantity|UnitPrice|
+---------+----------------------------------+--------+---------+
|536365 |WHITE HANGING HEART T-LIGHT HOLDER|6 |2.55 |
|536365 |WHITE METAL LANTERN |6 |3.39 |
|536365 |CREAM CUPID HEARTS COAT HANGER |8 |2.75 |
+---------+----------------------------------+--------+---------+
only showing top 3 rowsกรองแถวด้วย filter()
filter() จะคงแถวที่ตรงตามเงื่อนไขไว้ ชุดข้อมูลนี้ผสมระหว่างการขายกับการยกเลิก (เลขใบแจ้งหนี้ขึ้นต้นด้วย "C") มีจำนวนติดลบ และแถวที่ไม่มีลูกค้า จึงจะคงเฉพาะการขายที่ถูกต้องไว้:
sales_only = orders.filter(
(F.col("Quantity") > 0)
& (F.col("UnitPrice") > 0)
& F.col("CustomerID").isNotNull()
& ~F.col("InvoiceNo").startswith("C")
)
print(sales_only.count())397884รวมเงื่อนไขด้วย & (และ), | (หรือ), และ ~ (ไม่ใช่) และครอบแต่ละเงื่อนไขด้วยวงเล็บ เพราะลำดับความสำคัญของโอเปอเรเตอร์ใน Python จะประเมิน & ก่อน > บทความ สอน filter ใน PySpark ของเราครอบคลุมรูปแบบเพิ่มเติม
เพิ่มคอลัมน์ด้วย withColumn()
withColumn() เพิ่มคอลัมน์ใหม่ หรือแทนที่คอลัมน์ชื่อเดิม ตัวอย่างนี้คำนวณมูลค่าต่อรายการ:
sales_only = sales_only.withColumn("TotalAmount", F.round(F.col("Quantity") * F.col("UnitPrice"), 2))
sales_only.select("InvoiceNo", "Quantity", "UnitPrice", "TotalAmount").show(3)+---------+--------+---------+-----------+
|InvoiceNo|Quantity|UnitPrice|TotalAmount|
+---------+--------+---------+-----------+
| 536365| 6| 2.55| 15.3|
| 536365| 6| 3.39| 20.34|
| 536365| 8| 2.75| 22.0|
+---------+--------+---------+-----------+
only showing top 3 rowsดูบทความ สอน withColumn() ใน PySpark สำหรับคอลัมน์แบบมีเงื่อนไขด้วย F.when()
การรวมข้อมูลด้วย groupBy() และ agg()
groupBy() จัดกลุ่มแถวตามหนึ่งคอลัมน์ขึ้นไป และ agg() คำนวณสรุปหลายค่าในแต่ละกลุ่ม ประเทศใดสร้างรายได้มากที่สุด?
country_revenue = (
sales_only.groupBy("Country")
.agg(
F.count_distinct("CustomerID").alias("customers"),
F.round(F.sum("TotalAmount"), 2).alias("revenue"),
)
.orderBy(F.desc("revenue"))
)
country_revenue.show(5)+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+
only showing top 5 rowsสหราชอาณาจักรโดดเด่นตามคาด เพราะเป็นผู้ค้าปลีกในสหราชอาณาจักร ที่น่าสนใจกว่าคือเนเธอร์แลนด์และไอร์แลนด์ (ระบุเป็น EIRE): ลูกค้า 9 และ 3 รายใช้จ่ายมากกว่าเยอรมนีที่มี 94 ราย บ่งชี้ถึงผู้ซื้อแบบขายส่ง
สังเกตว่ามีการอิมพอร์ตโมดูลฟังก์ชันเป็น F แทนการใช้ from pyspark.sql.functions import * ซึ่งจะทับเงา sum(), min(), และ max() ที่เป็นบิลต์อินของ Python นับตั้งแต่ PySpark 4.0 การอิมพอร์ตแบบไวลด์การ์ดนี้ก็จะไม่เปิดเผยชื่อแบบ camelCase เก่า countDistinct อีกต่อไป
บทความ สอน groupBy ใน PySpark ของเราเจาะลึกการรวมข้อมูล
การรวม DataFrame ด้วย join()
join() รวม DataFrame สองตัวด้วยคีย์ร่วมกัน เพื่อระบุภูมิภาคให้แต่ละประเทศ จะทำการ join กับตาราง lookup ขนาดเล็กที่ตั้งใจเว้น Australia ไว้:
regions = spark.createDataFrame(
[("United Kingdom", "UK"), ("Netherlands", "EU"), ("EIRE", "EU"),
("Germany", "EU"), ("France", "EU")],
["Country", "region"],
)
country_revenue.join(regions, on="Country", how="left").orderBy(F.desc("revenue")).show(6)+--------------+---------+----------+------+
| Country|customers| revenue|region|
+--------------+---------+----------+------+
|United Kingdom| 3920|7308391.55| UK|
| Netherlands| 9| 285446.34| EU|
| EIRE| 3| 265545.9| EU|
| Germany| 94| 228867.14| EU|
| France| 87| 209024.05| EU|
| Australia| 9| 138521.31| NULL|
+--------------+---------+----------+------+
only showing top 6 rowsleft join จะคงทุกแถวจาก DataFrame ด้านซ้ายไว้ และเติมค่า NULL ให้กรณีที่ไม่มีคู่ จึงเห็น Australia อยู่ในผลลัพธ์ ส่วน inner join (how="inner" ค่าปริยาย) จะตัดออก บทความ สอน join ใน PySpark ของเราเปรียบเทียบชนิดของ join ทั้งหมดพร้อมประสิทธิภาพ
Spark SQL ใน PySpark
Spark SQL ช่วยให้คิวรี DataFrame ด้วย SQL มาตรฐานได้โดยการลงทะเบียนเป็น temporary view คิวรีนี้ทำซ้ำตารางรายได้ตามประเทศจากส่วน groupBy:
sales_only.createOrReplaceTempView("sales")
spark.sql("""
SELECT Country,
COUNT(DISTINCT CustomerID) AS customers,
ROUND(SUM(TotalAmount), 2) AS revenue
FROM sales
GROUP BY Country
ORDER BY revenue DESC
LIMIT 5
""").show()+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+ทั้งสองเวอร์ชันคอมไพล์เป็นแผนที่เพิ่มประสิทธิภาพเหมือนกัน จึงไม่ได้ต่างกันด้านความเร็ว เลือกใช้ SQL เมื่อเป็นการรวมข้อมูลยาว ๆ ที่นักวิเคราะห์จะอ่าน และใช้ DataFrame API เมื่อจำเป็นต้องมีลอจิก Python ล้อมรอบคิวรี เช่น การสร้างตัวกรองในลูป spark.sql() คืนค่าเป็น DataFrame จึงผสมสองแนวทางได้อย่างอิสระ
temporary view จะคงอยู่จนกว่า SparkSession จะหยุด
การเรียนรู้ของเครื่องด้วย PySpark: ตัวอย่าง K-Means
โมดูล pyspark.ml ของ PySpark เทรนโมเดลบน DataFrame และ Pipeline จะเชื่อมขั้นตอนเตรียมฟีเจอร์กับโมเดลเป็นอ็อบเจ็กต์เดียวที่ fit และนำกลับมาใช้ใหม่ได้ เพื่อสาธิต จะทำการแบ่งกลุ่มลูกค้าของผู้ค้าปลีกด้วยการจัดกลุ่มแบบ K-Means โดยใช้ recency, frequency และ monetary value (RFM) ซึ่งเป็นการแบ่งกลุ่มทางการตลาดมาตรฐาน:
- Recency: จำนวนวันนับจากการซื้อครั้งล่าสุดของลูกค้า
- Frequency: จำนวนใบแจ้งหนี้ที่แตกต่างกัน
- Monetary: ยอดใช้จ่ายรวม
สร้างฟีเจอร์ RFM ด้วย groupBy()
เพียงหนึ่งคำสั่ง groupBy() บน DataFrame sales_only ที่ผ่านการทำความสะอาดแล้ว ก็สร้างฟีเจอร์ทั้ง 3 ได้ครบ โดย recency วัดจากวันถัดจากใบแจ้งหนี้ล่าสุดในข้อมูล:
snapshot = sales_only.agg(F.date_add(F.max("InvoiceDate"), 1)).first()[0]
rfm = sales_only.groupBy("CustomerID").agg(
F.datediff(F.lit(snapshot), F.max("InvoiceDate")).alias("recency"),
F.count_distinct("InvoiceNo").alias("frequency"),
F.round(F.sum("TotalAmount"), 2).alias("monetary"),
)
rfm.describe("recency", "frequency", "monetary").show()+-------+------------------+-----------------+------------------+
|summary| recency| frequency| monetary|
+-------+------------------+-----------------+------------------+
| count| 4338| 4338| 4338|
| mean| 93.05947441217151|4.272014753342554|2054.2664591977896|
| stddev|100.01226424171826|7.697997826095038| 8989.230441421178|
| min| 1| 1| 3.75|
| max| 374| 209| 280206.02|
+-------+------------------+-----------------+------------------+ลองดูคอลัมน์ monetary: ค่าเฉลี่ยราว £2,054 ส่วนเบี่ยงเบนมาตรฐานมากกว่านั้นสี่เท่า และค่าสูงสุดเกิน £280,000 K-Means วัดระยะทางแบบยูคลิด จึงมีลูกค้าใช้จ่ายสูงไม่กี่รายที่ครองกลุ่มได้ การทำลอการิทึมของแต่ละฟีเจอร์ก่อนจะช่วยบีบหางยาวนั้น
การปรับสเกลและการจัดกลุ่มใน Pipeline
Pipeline มี 3 ขั้น: VectorAssembler รวมฟีเจอร์ให้เป็นคอลัมน์เวกเตอร์เดี่ยวตามที่โมเดลใน pyspark.ml ต้องการ StandardScaler ปรับให้อยู่ในสเกลเดียวกัน และ KMeans ทำการจัดกลุ่ม จะ fit โมเดลที่ k = 2 ถึง 6 และให้คะแนนแต่ละรุ่นด้วยค่า silhouette ซึ่งมีช่วง -1 ถึง 1 ค่ายิ่งสูงยิ่งแยกกลุ่มได้ดี:
from pyspark.ml import Pipeline
from pyspark.ml.clustering import KMeans
from pyspark.ml.evaluation import ClusteringEvaluator
from pyspark.ml.feature import StandardScaler, VectorAssembler
rfm_log = rfm.select(
"CustomerID",
"recency", "frequency", "monetary",
F.log1p("recency").alias("log_recency"),
F.log1p("frequency").alias("log_frequency"),
F.log1p("monetary").alias("log_monetary"),
).cache()
assembler = VectorAssembler(
inputCols=["log_recency", "log_frequency", "log_monetary"], outputCol="features_raw"
)
scaler = StandardScaler(
inputCol="features_raw", outputCol="features", withMean=True, withStd=True
)
evaluator = ClusteringEvaluator(featuresCol="features", metricName="silhouette")
for k in range(2, 7):
kmeans = KMeans(featuresCol="features", k=k, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
score = evaluator.evaluate(model.transform(rfm_log))
print(f"k={k} silhouette={score:.3f}")k=2 silhouette=0.624
k=3 silhouette=0.502
k=4 silhouette=0.502
k=5 silhouette=0.478
k=6 silhouette=0.470.cache() เก็บ rfm_log ไว้ในหน่วยความจำ เพราะการ fit และประเมินผลในลูปอ่านข้อมูลนี้ซ้ำ หากไม่มี มันจะคำนวณตาราง RFM จาก CSV ใหม่ทุกครั้งที่ fit
การเลือกค่า k และการตีความกลุ่ม
คะแนน silhouette สูงสุดที่ k = 2 แต่ 2 กลุ่มมักจะแยกลูกค้าที่แอคทีฟออกจากลูกค้าที่หายไป ซึ่งทีมการตลาดทำอะไรได้ไม่มาก k = 4 ได้คะแนนเท่ากับ k = 3 และยังแยกลูกค้าที่แอคทีฟออกเป็นสายเปย์กับมือใหม่ จึงจะใช้ค่านี้และทำโปรไฟล์แต่ละกลุ่ม:
kmeans = KMeans(featuresCol="features", k=4, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
segments = model.transform(rfm_log)
(segments.groupBy("prediction")
.agg(
F.count("*").alias("customers"),
F.round(F.avg("recency"), 1).alias("avg_recency"),
F.round(F.avg("frequency"), 1).alias("avg_frequency"),
F.round(F.avg("monetary"), 1).alias("avg_monetary"),
)
.orderBy("prediction")
.show())+----------+---------+-----------+-------------+------------+
|prediction|customers|avg_recency|avg_frequency|avg_monetary|
+----------+---------+-----------+-------------+------------+
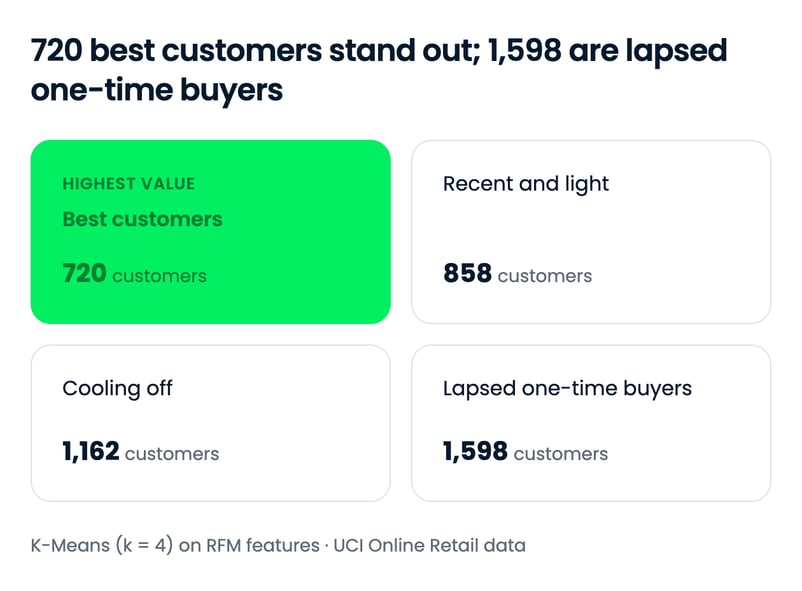
| 0| 1598| 181.2| 1.3| 326.2|
| 1| 720| 13.2| 13.7| 8072.7|
| 2| 1162| 77.1| 3.9| 1765.2|
| 3| 858| 17.4| 2.3| 613.7|
+----------+---------+-----------+-------------+------------+ทั้งสี่กลุ่มอ่านความหมายได้ชัดเจน:
- คลัสเตอร์ 1 ลูกค้าชั้นดี (720): โดยเฉลี่ยซื้อในช่วง 2 สัปดาห์ที่ผ่านมา มีประมาณ 14 ออเดอร์ และใช้จ่ายเกิน £8,000 ต่อราย เหมาะกับแคมเปญรักษาฐานและความภักดี
- คลัสเตอร์ 3 สดใหม่แต่เบา (858): แอคทีฟในช่วง 3 สัปดาห์ที่ผ่านมา แต่มีเพียงราว 2 ออเดอร์ หลายรายน่าจะเป็นลูกค้าใหม่ที่ควรบ่มเพาะให้เกิดออเดอร์ที่สองและสาม
- คลัสเตอร์ 2 เริ่มเย็นชา (1,162): ใช้จ่ายระดับกลาง แต่ห่างจากการซื้อครั้งล่าสุดราว 11 สัปดาห์ เหมาะกับแคมเปญเรียกคืนลูกค้า
- คลัสเตอร์ 0 ครั้งเดียวแล้วหาย (1,598): ส่วนใหญ่สั่งเพียงครั้งเดียว ราว £326 เมื่อประมาณ 6 เดือนก่อน เป็นกลุ่มใหญ่สุดแต่มีมูลค่าน้อยสุด
หมายเลขคลัสเตอร์เป็นเพียงป้ายกำกับตามอำเภอใจ และ seed ที่ต่างกันอาจสลับลำดับได้ จึงควรทำโปรไฟล์คลัสเตอร์ก่อนตั้งชื่อเสมอ หากต้องการเรียนรู้ว่า K-Means เลือกเซนทรอยด์อย่างไร ดู บทนำสู่การจัดกลุ่ม k-means และ เอกสารอ้างอิง API ของ pyspark.ml ที่แสดงโมเดลและทรานส์ฟอร์เมอร์ทั้งหมด คอร์ส Machine Learning with PySpark ของเราครอบคลุมการจำแนก การถดถอย และการปรับจูนโมเดลด้วย Pipeline
ข้อคิดส่งท้าย
PySpark สรุปได้ในไม่กี่แนวคิด: เริ่มจาก SparkSession ใช้ DataFrame สำหรับแทบทุกอย่าง transformation แบบขี้เกียจที่รันก็ต่อเมื่อ action ต้องการผลลัพธ์ และการเลือกว่าจะเขียนคิวรีด้วย Python หรือ SQL ทุกอย่างในบทความนี้รันในโหมดโลคัลบนแล็ปท็อป และโค้ดเดียวกันนี้รันบนคลัสเตอร์ได้โดยไม่ต้องเปลี่ยน
ไฟล์ 541,909 แถวไม่จำเป็นต้องใช้คลัสเตอร์ และ pandas ก็จัดการได้ ตั้งใจทำเช่นนั้น เพราะนิสัยที่สำคัญเมื่อทำงานกับข้อมูลขนาดใหญ่ (กำหนดสคีมาให้ชัด กรองตั้งแต่เนิ่น ๆ แคชสิ่งที่ใช้ซ้ำ และตรวจ explain()) สร้างได้ง่ายกว่าบนข้อมูลที่สามารถตรวจสอบได้
จากนี้ไป ขั้นตอนถัดไปที่แนะนำขึ้นกับเป้าหมาย:
- ฝึกใช้ DataFrame API ด้วยแบบฝึกหัด: Introduction to PySpark
- เตรียมข้อมูลจริงที่ยุ่งเหยิง: Cleaning Data with PySpark
- เก็บไวยากรณ์ไว้ข้างตัว: ชีตสรุป PySpark ของเรา
- เตรียมตัวสัมภาษณ์งาน: รวมคำถามสัมภาษณ์ PySpark ยอดนิยม
หากต้องการก้าวต่อไป แนะนำแทร็ก Big Data with PySpark ของเรา ซึ่งครอบคลุมการจัดการข้อมูล การวิศวกรรมฟีเจอร์ ไปจนถึง Pipeline สำหรับการเรียนรู้ของเครื่อง และระบบแนะนำ สำหรับทีม DataCamp for Business มีเส้นทางการเรียนรู้สำหรับบทบาทด้านวิศวกรรมข้อมูล
คำถามที่พบบ่อยเกี่ยวกับ PySpark
ต้องมีความรู้อะไรมาก่อนจึงจะเรียน PySpark ได้?
PySpark 4.3 ต้องการ Python 3.11 ขึ้นไป และ Java 17 ขึ้นไป (Spark 4.3 รองรับ Java 17, 21 และ 25) โดยมี JAVA_HOME ชี้ไปยังตำแหน่งติดตั้ง Java ควรคุ้นเคยกับพื้นฐาน Python และถ้ามีประสบการณ์กับ pandas DataFrame จะช่วยได้ เพราะ API ของ PySpark DataFrame ใช้แนวคิดคล้ายกัน ไม่จำเป็นต้องมีประสบการณ์ด้านระบบกระจายมาก่อน
PySpark เร็วกว่า pandas หรือไม่?
ไม่จำเป็นสำหรับข้อมูลขนาดเล็ก pandas รันในโพรเซสเดียวโดยไม่มีค่าใช้จ่ายในการเริ่มต้น ขณะที่ PySpark ใช้เวลาสองสามวินาทีในการเริ่ม JVM และจัดตารางงาน ดังนั้นบนข้อมูลที่พอดีกับหน่วยความจำ pandas มักเร็วกกว่า PySpark จะเร็วกว่าเมื่อปริมาณงานเกินหน่วยความจำหรือ CPU ของเครื่องเดียว เพราะสามารถประมวลผลพาร์ทิชันแบบขนานข้ามคอร์หรือโหนดคลัสเตอร์
ความแตกต่างระหว่าง RDD กับ DataFrame ใน PySpark คืออะไร?
RDD (Resilient Distributed Dataset) คือโครงสร้างระดับล่างของ PySpark: คอลเลกชันแบบกระจายของอ็อบเจ็กต์ Python ใด ๆ ที่คุณประมวลผลด้วยฟังก์ชันของคุณเอง ส่วน DataFrame จัดระเบียบข้อมูลเป็นคอลัมน์ที่มีชื่อและชนิดข้อมูล คล้ายกับ pandas DataFrame และตัวเพิ่มประสิทธิภาพ Catalyst ของ Spark จะเปลี่ยนคิวรี DataFrame ให้เป็นแผนการรันที่มีประสิทธิภาพ ใช้ DataFrame สำหรับโค้ดใหม่แทบทั้งหมด และใช้ RDD เมื่อข้อมูลไม่เป็นโครงสร้างหรือเมื่อจำเป็นต้องควบคุมการแบ่งพาร์ทิชันอย่างละเอียด
จะรัน PySpark ใน Jupyter Notebook ได้อย่างไร?
ติดตั้ง Java 17 ขึ้นไป จากนั้นรัน pip install "pyspark[sql]" ในสภาพแวดล้อมที่โน้ตบุ๊กใช้งาน สร้าง SparkSession ในเซลล์แรก:
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("MyNotebook").getOrCreate()หากต้องการข้ามการตั้งค่าโลคัล DataLab และโน้ตบุ๊ก Databricks มาพร้อม PySpark ติดตั้งไว้แล้ว
ควรใช้ PySpark แทน pandas เมื่อไร?
ใช้ PySpark เมื่อข้อมูลไม่พอจะวางในหน่วยความจำของเครื่องเดียว เมื่อจำเป็นต้องรันงานบนคลัสเตอร์หรือแพลตฟอร์มอย่าง Databricks หรือเมื่อกำลังสร้าง pipeline ที่จะเติบโตเกินกว่าแล็ปท็อป สำหรับการสำรวจข้อมูลที่พอดีกับหน่วยความจำ pandas เรียบง่ายกว่าและเริ่มได้ทันที โค้ด PySpark ที่เขียนบนโลคัลสามารถรันบนคลัสเตอร์ได้โดยไม่ต้องเปลี่ยน จึงสมเหตุสมผลที่จะเริ่มใช้หากมีแนวโน้มต้องขยายสเกล
Lazy evaluation ใน PySpark คืออะไร?
การประเมินผลแบบขี้เกียจหมายถึง PySpark จะไม่รัน transformation อย่าง filter() หรือ withColumn() ตอนที่เรียก แต่จะบันทึกไว้ในแผน และจะรันแผนนั้นก็ต่อเมื่อมี action อย่าง count(), show() หรือ write ต้องการผลลัพธ์ การรอช่วยให้ Spark เพิ่มประสิทธิภาพทั้งสายงาน เช่น ผลักตัวกรองลงไปยังขั้นตอนอ่านไฟล์
จะรันคิวรี SQL ใน PySpark ได้อย่างไร?
ลงทะเบียน DataFrame เป็น temporary view ด้วย df.createOrReplaceTempView("sales") แล้วคิวรีด้วย spark.sql("SELECT ... FROM sales") ผลลัพธ์คือ DataFrame ปกติ จึงผสมโค้ด SQL และ DataFrame ได้อิสระ ทั้งสองแบบคอมไพล์เป็นแผนเพิ่มประสิทธิภาพเดียวกัน จึงไม่ต่างกันด้านความเร็ว
ต้องมี Hadoop เพื่อรัน PySpark หรือไม่?
ไม่จำเป็น pip install pyspark รวมรันไทม์ของ Spark ไว้แล้ว ซึ่งรันในโหมดโลคัลบนเครื่องของคุณโดยไม่ต้องมี Hadoop ต้องใช้คอมโพเนนต์ของ Hadoop ก็ต่อเมื่ออ่านจาก HDFS หรือรัน Spark บนคลัสเตอร์ YARN
PySpark คือ API ภาษา Python สำหรับ Apache Spark เขียนโค้ด DataFrame หรือ SQL ใน Python แล้ว Spark จะแบ่งงานไปทำพร้อมกันบนทุกคอร์ของ CPU ในแล็ปท็อปหรือทุกเครื่องในคลัสเตอร์ ใช้เมื่อตัวชุดข้อมูลเริ่มใหญ่เกินกว่าจะทำงานใน pandas ได้อย่างสบาย หรือเมื่องานเดียวกันต้องไปรันบนคลัสเตอร์ภายหลังโดยไม่ต้องเขียนใหม่
ในบทเรียน PySpark นี้ จะติดตั้ง PySpark 4.3 สร้าง SparkSession และอธิบายสองแนวคิดที่มักทำให้มือใหม่สะดุด: RDD เทียบกับ DataFrame และการประมวลผลแบบขี้เกียจ (lazy evaluation) จากนั้นจะลงมือทำกับโอเปอเรชันที่ใช้งานทุกวัน (select, filter, groupBy, join และ Spark SQL) บนชุดข้อมูลอีคอมเมิร์ซ 541,909 แถว และปิดท้ายด้วยโมเดลแบ่งกลุ่มลูกค้าแบบ K-Means ที่สร้างด้วย API แบบ Pipeline ของ
pyspark.mlหากต้องการแบบฝึกหัดที่มีคำแนะนำควบคู่ไปกับบทเรียนนี้ คอร์ส Introduction to PySpark ของเราครอบคลุมเนื้อหาเดียวกัน สำหรับแผนการเรียนระยะยาว ดูคู่มือ วิธีเรียนรู้ PySpark ตั้งแต่เริ่มต้น
สรุปสั้นๆ
pip install "pyspark[sql]"; PySpark 4.3 ต้องใช้ Python 3.11+ และ Java 17+SparkSessionและ DataFrame (ไม่ใช่ RDD) คือ API เริ่มต้นcount()หรือshow()pyspark.mlPipeline เชื่อมต่อขั้นเตรียมฟีเจอร์และโมเดลอย่าง K-Means ไว้ในอ็อบเจ็กต์เดียวApache Spark คืออะไร?
Apache Spark คือเอนจินโอเพ่นซอร์สสำหรับการประมวลผลข้อมูลแบบกระจาย แบ่งชุดข้อมูลออกเป็นพาร์ทิชัน ประมวลผลแบบขนานทั่วทั้งคลัสเตอร์ และเก็บผลลัพธ์ชั่วคราวไว้ในหน่วยความจำแทนการเขียนลงดิสก์ระหว่างขั้นตอน
การทำงานในหน่วยความจำนี่เองเป็นเหตุผลหลักที่ Spark เข้ามาแทน Hadoop MapReduce สำหรับงานแบตช์ส่วนใหญ่ (มีการเปรียบเทียบไว้ใน Hadoop vs Spark) Spark เริ่มต้นที่ AMPLab แห่ง UC Berkeley ในปี 2009 กลายเป็นโครงการระดับบนสุดของ Apache ในปี 2014 และออกเวอร์ชัน 4.3 เมื่อวันที่ 30 ตุลาคม 2026
เอนจินเดียวรองรับหลายงานผ่านไลบรารีในตัว:
pyspark.ml) สำหรับแมชชีนเลิร์นนิงแบบกระจายหากต้องการดูรายละเอียดว่าตัว driver, ตัวจัดการคลัสเตอร์ และ executor แบ่งงานกันอย่างไร ดูได้ที่ คู่มือสถาปัตยกรรม Apache Spark