

PySparkとは?
PySparkはApache SparkのPython APIです。Pythonコードで望む変換を記述すると、Java仮想マシン(JVM)上で動くSparkエンジンが、その処理を計画・実行してクラスター全体に分散します。ScalaやJavaを書かずにSparkの分散実行を利用できます。
データサイエンティストはPySparkで大規模データのクレンジングや集計を行い、データエンジニアはETLパイプラインに使います。どちらもpyspark.mlで、1台のマシンに収まらないデータに対してモデルを学習します。普段pandasで作業しているなら、DataFrame APIは親しみやすく感じられるはずです。
pandasではなくPySparkを使うべきとき
データが1台のマシンを超えたときにPySparkの真価が出ます。それ以下では、JVMの起動やタスクスケジューリングのオーバーヘッドがない分、通常はpandasの方が速いです。
| 機能 | pandas | PySpark |
|---|---|---|
| データサイズ | 1台のマシンのRAMに制限される | クラスターの合計メモリとディスクに制限される |
| 実行方式 | 即時評価、ほぼ単一コア | 遅延評価、コアやマシン間で並列 |
| 起動オーバーヘッド | なし | JVMとSparkSessionの起動に数秒 |
| ストリーミングデータ | 非対応 | Structured Streaming |
| 機械学習 | scikit-learnエコシステム | pyspark.ml(分散) |
| フォールトトレランス | なし。クラッシュすると作業は失われる | 失われたパーティションは系譜情報から再計算 |
私の目安はこうです。データが十分な余裕をもってメモリに入り、処理が1台のノートPCで完結するならpandasを使い続ける。メモリエラーと格闘し始めたら、あるいはその処理が将来的にクラスターやDatabricksのようなプラットフォームで走るなら、PySparkに切り替えるべきです。
PySparkのインストール方法
PySparkはPyPIからpipコマンド1つでインストールでき、Sparkランタイムが同梱されます。そのためローカル作業では別途SparkやHadoopをダウンロードする必要はありません。実行前に、2つの前提条件を確認してください。
前提条件
公式インストールガイドによると、PySpark 4.3には次が必要です。
- Python 3.11以上。PySpark 4.3はPython 3.10のサポートを終了しました。新しいバージョンが必要な場合はPythonセットアップガイドを参照してください。
- Java 17以上(Spark 4.3はJava 17、21、25で動作)で、
JAVA_HOME環境変数がそのパスを指していること。各OSでの手順はJavaのインストールガイドで解説しています。
どちらもターミナルから確認できます。
python3 --version # Python 3.11 or later
java -version # openjdk version "17" or laterDataLabやDatabricksで作業する場合、PySparkはすでにインストールされているため、データセットの章に進んでください。
pipでPySparkをインストール
他のプロジェクトとの依存関係の衝突を避けるため、仮想環境を使うことをおすすめします。
python3 -m venv pyspark-env
source pyspark-env/bin/activate
pip install "pyspark[sql]" "pandas<3"
python3 -c "import pyspark; print(pyspark.__version__)"4.3.0Windowsではpythonを使い、環境はpyspark-env\Scripts\activateで有効化してください。[sql]エクストラは、PySparkがtoPandas()やpandas UDFで利用するpandas、PyArrow、NumPyを追加します。pandas<3を固定しているのは、PySpark 4.3が現時点ではpandas 3.0を完全にはサポートしない旨の警告を出すためです。
初回実行失敗の大半は次の2つが原因です。
JAVA_GATEWAY_EXITEDまたは「Java Runtimeが見つかりません」:Javaが未インストール、またはJAVA_HOMEが未設定。PYTHON_VERSION_MISMATCH:ワーカープロセスがスクリプトと異なるPythonを拾っています。PYSPARK_PYTHONを環境のインタープリタに設定してください(例:export PYSPARK_PYTHON=$(which python))。
Windowsを含むOSごとの詳細手順は、PySparkインストールガイドをご覧ください。
データセットの取得
サンプルでは、英国のオンライン小売業者の541,909件の取引(2010年12月〜2011年12月)からなるECデータセットを使用します。各行は請求書の1商品行で、8列を持ちます。
InvoiceNo:請求書番号(先頭が「C」の番号はキャンセル)StockCodeとDescription:商品コードと名称QuantityとUnitPrice:購入数量と単価(英ポンド)InvoiceDate:購入の日時CustomerID:顧客ID(一部の行は欠損)Country:顧客の国
DataLabのデータセットページからdatacamp_ecommerce.csvとしてダウンロードできます。これはUCI Machine Learning RepositoryのOnline Retailデータセットであり、公開ソースから同じファイルを生成することも可能です(pip install openpyxlが必要)。
import io
import urllib.request
import zipfile
import pandas as pd
url = "https://archive.ics.uci.edu/static/public/352/online+retail.zip"
with urllib.request.urlopen(url) as response:
archive = zipfile.ZipFile(io.BytesIO(response.read()))
retail = pd.read_excel(
archive.open("Online Retail.xlsx"),
dtype={"InvoiceNo": str, "StockCode": str, "CustomerID": "Int64"},
)
# Match the DataLab file's date format, e.g. 12/1/10 8:26
retail["InvoiceDate"] = retail["InvoiceDate"].map(
lambda ts: f"{ts.month}/{ts.day}/{ts:%y} {ts.hour}:{ts:%M}"
)
retail.to_csv("datacamp_ecommerce.csv", index=False)23MBのExcelファイルを読むのに約1分かかります。CSVは、この先のコードを実行するフォルダに保存してください。
SparkSessionの作成
SparkSessionはすべてのPySparkプログラムのエントリポイントです。PythonコードをSparkエンジンに接続し、DataFrameを作成します。アプリケーションごとに1つ、ビルダー・パターンで作成します。
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("PySparkTutorial").getOrCreate()
print(spark.version)4.3.0getOrCreate()はすでに実行中のセッションがあればそれを返すため、ノートブックで2回呼んでも安全です。通常のPythonプロセスから起動した場合、Sparkはローカルモード(local[*])で動作し、マシン上のすべてのCPUコアをワーカーとして使います。ジョブの進行はhttp://localhost:4040のSpark UIで確認できます。作業が終わったらspark.stop()でリソースを解放します。
ECデータセットの読み込み
セッションが動いていれば、CSVをDataFrameに読み込めます。ここではinferSchema=Trueではなく明示的なスキーマを渡します。inferSchemaは列型推定のためにファイル全体を余分に走査するためです。
import pyspark.sql.functions as F
schema = """
InvoiceNo STRING, StockCode STRING, Description STRING, Quantity INT,
InvoiceDate STRING, UnitPrice DOUBLE, CustomerID INT, Country STRING
"""
orders = spark.read.csv(
"datacamp_ecommerce.csv", header=True, schema=schema, escape='"'
)
orders = orders.withColumn("InvoiceDate", F.to_timestamp("InvoiceDate", "M/d/yy H:mm"))
orders.printSchema()root
|-- InvoiceNo: string (nullable = true)
|-- StockCode: string (nullable = true)
|-- Description: string (nullable = true)
|-- Quantity: integer (nullable = true)
|-- InvoiceDate: timestamp (nullable = true)
|-- UnitPrice: double (nullable = true)
|-- CustomerID: integer (nullable = true)
|-- Country: string (nullable = true)このスニペットでは2点が重要です。
escape='"'は、RECORD FRAME 7"" SINGLE SIZEのように二重引用符が含まれる商品名を処理します。Sparkのデフォルトのエスケープ文字はバックスラッシュです。- 日付パターン
M/d/yy H:mmは12/1/10 8:26のような値に一致します。Spark 4.0以降、ANSI SQLモードがデフォルトのため、パターンに一致しない値に対してto_timestamp()はCANNOT_PARSE_TIMESTAMPエラーを投げます。問題のある行をNULLで受け取りたい場合はF.try_to_timestamp()を使ってください。
先頭行と件数を確認します。
orders.show(5, truncate=False)
print(orders.count())+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|InvoiceNo|StockCode|Description |Quantity|InvoiceDate |UnitPrice|CustomerID|Country |
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|536365 |85123A |WHITE HANGING HEART T-LIGHT HOLDER |6 |2010-12-01 08:26:00|2.55 |17850 |United Kingdom|
|536365 |71053 |WHITE METAL LANTERN |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84406B |CREAM CUPID HEARTS COAT HANGER |8 |2010-12-01 08:26:00|2.75 |17850 |United Kingdom|
|536365 |84029G |KNITTED UNION FLAG HOT WATER BOTTLE|6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84029E |RED WOOLLY HOTTIE WHITE HEART. |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
only showing top 5 rows
541909複数ファイル、区切り文字、不正レコードなどの読み込みオプションは、PySparkでCSVを読むチュートリアルをご覧ください。
RDDとDataFrame
RDDとDataFrameはPySparkで分散データを表す2つの方法で、ほとんどの新しいコードではDataFrameが最適です。
| 抽象化 | 概要 | 使用シーン |
|---|---|---|
| RDD(Resilient Distributed Dataset) | 任意のPythonオブジェクトからなる低レベルの不変コレクション。パーティションに分割 | 非構造データ、またはパーティション制御を細かく行いたい場合 |
| DataFrame | pandasのDataFrameに似た、名前と型を持つ列で構成された分散テーブル | 分析、SQLクエリ、ETL、機械学習 |
以下は同じ集計(国ごとの合計数量)を両方の方法で書いた例です。
sales = [("United Kingdom", 6), ("France", 24), ("United Kingdom", 8)]
# RDD: Python関数でロジックを書く
rdd = spark.sparkContext.parallelize(sales)
print(rdd.reduceByKey(lambda a, b: a + b).collect())
# DataFrame: 結果を宣言し、Sparkが計算方法を計画する
sales_df = spark.createDataFrame(sales, ["country", "quantity"])
sales_df.groupBy("country").sum("quantity").show()[('France', 24), ('United Kingdom', 14)]
+--------------+-------------+
| country|sum(quantity)|
+--------------+-------------+
|United Kingdom| 14|
| France| 24|
+--------------+-------------+RDD版はPythonのワーカープロセスでラムダを実行します。DataFrame版はSparkのCatalystオプティマイザを経由し、クエリを効率的な計画に書き換えてJVM内で実行するため、通常はDataFrameコードの方がチューニングなしでも速くなります。本チュートリアルの残りはDataFrameを使います。
遅延評価:変換とアクション
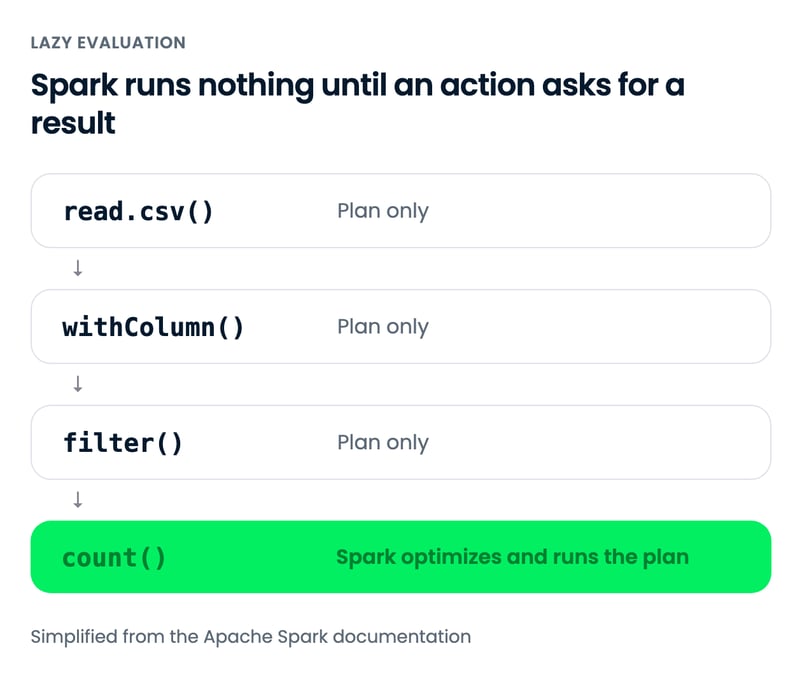
遅延評価とは、変換を呼び出してもその場では実行せず、計画に記録して、結果が必要なアクションが呼ばれたときに初めて全体を実行することを意味します。
| 変換(Transformations) | アクション(Actions) | |
|---|---|---|
| 何をするか | 新しいDataFrameを記述する | 結果を返す、またはデータを書き出す |
| いつ実行されるか | 単独では実行されない | 直ちに実行され、保留中の変換がすべて起動する |
| 例 | select()、filter()、withColumn()、groupBy()、join() | show()、count()、collect()、toPandas()、write |
次のfilterは、データセットが50万行以上あっても即座に返ります。まだ何も読み込まれていないためです。ジョブを起動するのはcount()の呼び出しです。
uk_orders = orders.filter(F.col("Country") == "United Kingdom") # transformation: no job yet
print(uk_orders.count()) # action: Spark reads the file now495478アクションまで待つことで、Sparkはチェーン全体を一括で最適化できます。explain()は選ばれた物理計画を出力します(以下は抜粋)。
uk_orders.explain()== Physical Plan ==
*(1) Project [InvoiceNo#0, StockCode#1, ...]
+- *(1) Filter (isnotnull(Country#7) AND (Country#7 = United Kingdom))
+- FileScan csv [...] PushedFilters: [IsNotNull(Country), EqualTo(Country,United Kingdom)], ...PushedFiltersの項目は、Sparkが国フィルターをファイルスキャンにプッシュダウンし、CSVの読み込み時に他国の行を除外していることを示します。実務上の注意として、変換の中のデータエラー(たとえばANSIモードでの日時パース失敗)は、その次のアクションが走るまで数行後に表面化します。
一般的なDataFrame操作
PySparkコードの大半は、select()、filter()、withColumn()、groupBy()、join()という5つのDataFrame操作の連鎖です。各操作は新しいDataFrameを返すため、任意の順序で連結できます。
select()で列を選択
select()は指定した列だけを持つDataFrameを返します。
orders.select("InvoiceNo", "Description", "Quantity", "UnitPrice").show(3, truncate=False)+---------+----------------------------------+--------+---------+
|InvoiceNo|Description |Quantity|UnitPrice|
+---------+----------------------------------+--------+---------+
|536365 |WHITE HANGING HEART T-LIGHT HOLDER|6 |2.55 |
|536365 |WHITE METAL LANTERN |6 |3.39 |
|536365 |CREAM CUPID HEARTS COAT HANGER |8 |2.75 |
+---------+----------------------------------+--------+---------+
only showing top 3 rowsfilter()で行を抽出
filter()は条件に一致する行を残します。このデータセットには、販売データとキャンセル(請求書番号が「C」で始まる)、負の数量、顧客IDなしの行が混在しているため、有効な販売だけを残します。
sales_only = orders.filter(
(F.col("Quantity") > 0)
& (F.col("UnitPrice") > 0)
& F.col("CustomerID").isNotNull()
& ~F.col("InvoiceNo").startswith("C")
)
print(sales_only.count())397884条件は&(AND)、|(OR)、~(NOT)で組み合わせます。Pythonの演算子優先順位では&が>より先に評価されるため、各条件を丸括弧で囲む点に注意してください。さらに詳しいパターンはPySpark filterチュートリアルで解説しています。
withColumn()で列を追加
withColumn()は列を追加するか、同名の列を置き換えます。ここでは各行の金額を計算します。
sales_only = sales_only.withColumn("TotalAmount", F.round(F.col("Quantity") * F.col("UnitPrice"), 2))
sales_only.select("InvoiceNo", "Quantity", "UnitPrice", "TotalAmount").show(3)+---------+--------+---------+-----------+
|InvoiceNo|Quantity|UnitPrice|TotalAmount|
+---------+--------+---------+-----------+
| 536365| 6| 2.55| 15.3|
| 536365| 6| 3.39| 20.34|
| 536365| 8| 2.75| 22.0|
+---------+--------+---------+-----------+
only showing top 3 rows条件付き列の作成にはF.when()を使います。詳細はPySpark withColumn()チュートリアルを参照してください。
groupBy()とagg()で集計
groupBy()は1つ以上の列で行をグループ化し、agg()でグループごとの要約統計を計算します。どの国が最も売上を上げているでしょうか。
country_revenue = (
sales_only.groupBy("Country")
.agg(
F.count_distinct("CustomerID").alias("customers"),
F.round(F.sum("TotalAmount"), 2).alias("revenue"),
)
.orderBy(F.desc("revenue"))
)
country_revenue.show(5)+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+
only showing top 5 rows英国が優勢なのは英国の小売業者なので当然です。興味深いのはオランダとアイルランド(EIRE表記)で、9人と3人の顧客が、94人のドイツより多く消費しており、卸売の可能性を示唆します。
関数モジュールはFという短縮名でインポートし、from pyspark.sql.functions import *は避けています。ワイルドカードはPython組み込みのsum()、min()、max()を覆い隠してしまうためです。なおSpark 4.0以降、そのワイルドカードは旧来のキャメルケース名countDistinctも公開しません。
集計の詳細はPySpark groupByチュートリアルで扱っています。
join()でDataFrameを結合
join()は共通キーで2つのDataFrameを結合します。各国に地域ラベルを付けるために、意図的にオーストラリアを欠落させた小さな参照表を結合します。
regions = spark.createDataFrame(
[("United Kingdom", "UK"), ("Netherlands", "EU"), ("EIRE", "EU"),
("Germany", "EU"), ("France", "EU")],
["Country", "region"],
)
country_revenue.join(regions, on="Country", how="left").orderBy(F.desc("revenue")).show(6)+--------------+---------+----------+------+
| Country|customers| revenue|region|
+--------------+---------+----------+------+
|United Kingdom| 3920|7308391.55| UK|
| Netherlands| 9| 285446.34| EU|
| EIRE| 3| 265545.9| EU|
| Germany| 94| 228867.14| EU|
| France| 87| 209024.05| EU|
| Australia| 9| 138521.31| NULL|
+--------------+---------+----------+------+
only showing top 6 rows左外部結合は左側のDataFrameの行をすべて保持し、不一致はNULLで埋めるため、オーストラリアは結果に残ります。内部結合(how="inner"、デフォルト)なら落ちます。すべての結合タイプとその性能差はPySpark joinsチュートリアルで比較しています。
PySparkでのSpark SQL
DataFrameを一時ビューとして登録すると、標準SQLでクエリできます。次のクエリは、先ほどのgroupBy節の国別売上表を再現します。
sales_only.createOrReplaceTempView("sales")
spark.sql("""
SELECT Country,
COUNT(DISTINCT CustomerID) AS customers,
ROUND(SUM(TotalAmount), 2) AS revenue
FROM sales
GROUP BY Country
ORDER BY revenue DESC
LIMIT 5
""").show()+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+どちらも同じ最適化計画にコンパイルされるため、速度差はありません。アナリストが読む長い集計にはSQLを、ループでフィルターを組み立てるなどPythonのロジックが必要な場合はDataFrame APIを使います。spark.sql()はDataFrameを返すため、両者は自由に組み合わせられます。
一時ビューはSparkSessionが停止するまで有効です。
PySparkで機械学習:K-Meansの例
PySparkのpyspark.mlはDataFrame上でモデル学習を行い、Pipelineは特徴量作成とモデルを1つのオブジェクトに連結して学習・再利用できます。ここでは、リサンシー、頻度、金額(RFM)に基づくK-Meansクラスタリングで小売顧客をセグメント化してみます。これは標準的なマーケティングのセグメンテーションです。
- Recency:最後の購入からの経過日数
- Frequency:異なる請求書の数
- Monetary:合計支出額
groupBy()でRFM特徴量を作成
クリーニング済みのsales_onlyに対する1回のgroupBy()で3つの特徴量が得られます。Recencyは、データ内の最後の請求書の翌日を基準に測ります。
snapshot = sales_only.agg(F.date_add(F.max("InvoiceDate"), 1)).first()[0]
rfm = sales_only.groupBy("CustomerID").agg(
F.datediff(F.lit(snapshot), F.max("InvoiceDate")).alias("recency"),
F.count_distinct("InvoiceNo").alias("frequency"),
F.round(F.sum("TotalAmount"), 2).alias("monetary"),
)
rfm.describe("recency", "frequency", "monetary").show()+-------+------------------+-----------------+------------------+
|summary| recency| frequency| monetary|
+-------+------------------+-----------------+------------------+
| count| 4338| 4338| 4338|
| mean| 93.05947441217151|4.272014753342554|2054.2664591977896|
| stddev|100.01226424171826|7.697997826095038| 8989.230441421178|
| min| 1| 1| 3.75|
| max| 374| 209| 280206.02|
+-------+------------------+-----------------+------------------+monetary列に注目してください。平均は約£2,054、標準偏差はそれの4倍超、最大は£280,000を超えます。K-Meansはユークリッド距離を用いるため、少数の大口顧客がクラスタを支配してしまいます。各特徴量の対数を先に取ることで、こうしたロングテールを圧縮できます。
Pipelineでスケーリングとクラスタリング
Pipelineは3段階です。VectorAssemblerが特徴量をpyspark.mlのモデルが期待する単一のベクトル列にまとめ、StandardScalerがスケールをそろえ、KMeansがクラスタリングを行います。k=2〜6で学習し、スコアはシルエット係数で評価します。値は-1〜1で、高いほどクラスタの分離が良いことを意味します。
from pyspark.ml import Pipeline
from pyspark.ml.clustering import KMeans
from pyspark.ml.evaluation import ClusteringEvaluator
from pyspark.ml.feature import StandardScaler, VectorAssembler
rfm_log = rfm.select(
"CustomerID",
"recency", "frequency", "monetary",
F.log1p("recency").alias("log_recency"),
F.log1p("frequency").alias("log_frequency"),
F.log1p("monetary").alias("log_monetary"),
).cache()
assembler = VectorAssembler(
inputCols=["log_recency", "log_frequency", "log_monetary"], outputCol="features_raw"
)
scaler = StandardScaler(
inputCol="features_raw", outputCol="features", withMean=True, withStd=True
)
evaluator = ClusteringEvaluator(featuresCol="features", metricName="silhouette")
for k in range(2, 7):
kmeans = KMeans(featuresCol="features", k=k, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
score = evaluator.evaluate(model.transform(rfm_log))
print(f"k={k} silhouette={score:.3f}")k=2 silhouette=0.624
k=3 silhouette=0.502
k=4 silhouette=0.502
k=5 silhouette=0.478
k=6 silhouette=0.470.cache()はrfm_logをメモリに保持します。ループ内の各学習と評価が同じデータを再読込するためです。これがないと、毎回CSVからRFMテーブルを再計算することになります。
kの選択とセグメントの読み解き
シルエット係数はk=2で最大ですが、2つだと主にアクティブ顧客と離反顧客の分割に留まり、マーケティング施策に活かしづらいことが多いです。k=4はk=3と同等のスコアで、アクティブ顧客を大口と新規に分けてくれるので、これを採用し各クラスタをプロファイリングします。
kmeans = KMeans(featuresCol="features", k=4, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
segments = model.transform(rfm_log)
(segments.groupBy("prediction")
.agg(
F.count("*").alias("customers"),
F.round(F.avg("recency"), 1).alias("avg_recency"),
F.round(F.avg("frequency"), 1).alias("avg_frequency"),
F.round(F.avg("monetary"), 1).alias("avg_monetary"),
)
.orderBy("prediction")
.show())+----------+---------+-----------+-------------+------------+
|prediction|customers|avg_recency|avg_frequency|avg_monetary|
+----------+---------+-----------+-------------+------------+
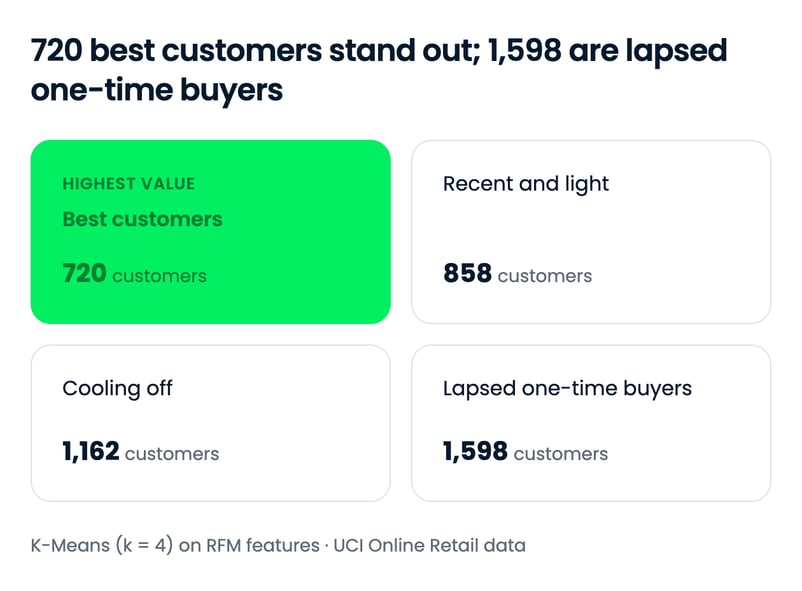
| 0| 1598| 181.2| 1.3| 326.2|
| 1| 720| 13.2| 13.7| 8072.7|
| 2| 1162| 77.1| 3.9| 1765.2|
| 3| 858| 17.4| 2.3| 613.7|
+----------+---------+-----------+-------------+------------+4つのセグメントは次のように読み取れます。
- クラスタ1:最優良顧客(720名) 平均で直近2週間以内に購入、注文は約14件、1人あたり£8,000超の支出。リテンションやロイヤルティ施策の対象。
- クラスタ3:最近アクティブだが軽め(858名) 直近3週間以内に活動があるが、注文は平均2件程度。新規顧客が多く、2件目・3件目への育成が有望。
- クラスタ2:離反傾向(1,162名) 中程度の支出だが、最後の購入から約11週間。休眠復活キャンペーンの効果が見込める層。
- クラスタ0:離反した一度きりの購入者(1,598名) 多くが1回限りの注文で約£326、約6か月前。最大だが価値は低い層。
クラスタ番号は単なるラベルで、シードが違えば並び順も変わる可能性があるため、命名前に必ず各クラスタをプロファイリングしてください。K-Meansがセントロイドをどう選ぶかはk-meansクラスタリング入門を、利用可能なモデルやトランスフォーマーの一覧はpyspark.ml APIリファレンスを参照してください。コースMachine Learning with PySparkでは、分類・回帰・パイプラインでのモデルチューニングも扱います。
まとめ
PySparkの要点は、起点となるSparkSession、ほぼすべてに使うDataFrame、アクションが必要になるまで実行を遅らせる変換、そしてPythonかSQLかという記法の選択です。本チュートリアルの内容はすべてノートPCのローカルモードで動作し、同じコードがクラスター上でも変更なしで動きます。
541,909行のファイルにクラスターは不要で、pandasでも処理できました。これは意図的です。大規模データで重要となる習慣(明示スキーマ、早めのフィルタリング、再利用する中間結果のキャッシュ、explain()の確認)は、中身を目視できる規模のデータの方が身につけやすいからです。
ここから先は、目的に応じて次のステップがおすすめです。
- DataFrame APIを演習で実践:Introduction to PySpark
- 現実世界の汚れたデータに対処:Cleaning Data with PySpark
- 構文を手元に置く:PySparkチートシート
- 面接対策:Top PySpark interview questions
さらに学びたい場合は、データマネジメント、特徴量エンジニアリング、機械学習パイプライン、レコメンドエンジンを順に学べるBig Data with PySparkトラックをおすすめします。チーム向けには、DataCamp for Businessがデータエンジニアリング職の学習パスを提供しています。
PySparkに関するFAQ
PySpark学習の前提条件は何ですか?
PySpark 4.3にはPython 3.11以上とJava 17以上(Spark 4.3はJava 17、21、25で動作)が必要で、JAVA_HOMEはJavaのインストール先を指している必要があります。基本的なPythonに慣れていることが望ましく、pandasのDataFrame経験があると、PySparkのDataFrame APIの理解に役立ちます。分散システムの事前知識は不要です。
PySparkはpandasより速いですか?
小規模データでは違います。pandasはプロセス内で起動コストなしに動作する一方、PySparkはJVMの起動やタスクのスケジューリングに数秒を要するため、メモリに余裕で収まるデータでは通常pandasが勝ります。データが1台のメモリやCPUを超えたら、PySparkはパーティションをコアやノード間で並列処理するため高速になります。
PySparkのRDDとDataFrameの違いは何ですか?
RDD(Resilient Distributed Dataset)はPySparkの低レベル構造で、任意のPythonオブジェクトからなる分散コレクションを自前の関数で処理します。DataFrameは、pandasのDataFrameのように、名前と型を持つ列にデータを整理し、SparkのCatalystオプティマイザがDataFrameクエリを効率的な実行計画に変換します。新しいコードのほぼすべてはDataFrameを使い、RDDは非構造データやパーティション制御が細かく必要な場合に限ります。
Jupyter NotebookでPySparkを動かすには?
Java 17以上をインストールした上で、ノートブックが使う環境でpip install "pyspark[sql]"を実行してください。最初のセルでSparkSessionを作成します。
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("MyNotebook").getOrCreate()ローカル環境の設定を省きたい場合は、DataLabやDatabricksのノートブックにPySparkがプリインストールされています。
pandasではなくPySparkを使うべきタイミングは?
データが1台のメモリに収まらないとき、クラスターやDatabricksのようなプラットフォームでジョブを実行する必要があるとき、あるいはラップトップの範囲を超えて成長する見込みのあるパイプラインを構築するときにPySparkを使ってください。メモリに収まるデータでの探索的分析には、pandasの方がシンプルで即時に起動します。ローカルで書いたPySparkコードはクラスターでもそのまま動くため、将来的なスケールが見込まれるなら最初からPySparkで始めるのも合理的です。
PySparkの遅延評価とは何ですか?
遅延評価とは、filter()やwithColumn()のような変換を呼び出しても即時には実行せず、計画に記録しておき、count()、show()、writeのようなアクションが結果を必要としたときにその計画を実行することです。待つことで、Sparkはチェーン全体を最適化できます。たとえば、フィルターをファイルスキャンにプッシュダウンできます。
PySparkでSQLクエリを実行するには?
df.createOrReplaceTempView("sales")でDataFrameを一時ビューとして登録し、spark.sql("SELECT ... FROM sales")でクエリします。結果は通常のDataFrameなので、SQLとDataFrameコードを自由に混在させられます。どちらも同じ最適化計画にコンパイルされるため、速度差はありません。
PySparkを動かすのにHadoopは必要ですか?
不要です。pip install pysparkでSparkランタイムも同梱され、ローカルモードでHadoopなしに動作します。HDFSからの読み込みやYARNクラスター上での実行時のみ、Hadoopコンポーネントが必要です。
PySparkはApache SparkのPython APIです。PythonでDataFrameコードやSQLを書くだけで、SparkがノートPCのすべてのCPUコアやクラスター内の各マシンに処理を分散してくれます。pandasでは収まりきらなくなったデータや、同じ処理を後でクラスター上で書き換えなしに実行したいときに使います。
このPySparkチュートリアルでは、PySpark 4.3をインストールし、SparkSessionを作成して、多くの初心者がつまずく2つの概念(RDDとDataFrameの違い、遅延評価)を説明します。続いて、日常的によく使う操作(select、filter、groupBy、join、Spark SQL)を、541,909行のECデータセットで実践し、最後に
pyspark.mlのPipeline APIでK-Means顧客セグメンテーションモデルを構築します。本チュートリアルと併せて演習形式で学びたい場合は、当社のIntroduction to PySparkコースで同様の内容を扱っています。学習計画を長めに取りたい場合は、ガイドHow to Learn PySpark From Scratchをご覧ください。
要点
pip install "pyspark[sql]"でインストールします。PySpark 4.3はPython 3.11+とJava 17+が必要です。SparkSessionから始まり、標準APIはRDDではなくDataFrameです。count()やshow()のようなアクションが呼ばれるまで実行されません。pyspark.mlのPipelineは、特徴量作成とK-Meansのようなモデルを1つのオブジェクトに連結します。Apache Sparkとは?
Apache Sparkは分散データ処理のためのオープンソースエンジンです。データセットをパーティションに分割し、クラスター全体で並列処理し、ステップ間で中間結果をディスクではなくメモリに保持します。
このインメモリ設計こそが、多くのバッチ処理でSparkがHadoop MapReduceに取って代わった主な理由です(詳しくはHadoop vs Sparkを参照)。Sparkは2009年にUC BerkeleyのAMPLabで始まり、2014年にApacheのトップレベルプロジェクトとなり、2026年10月30日にバージョン4.3に到達しました。
1つのエンジンが内蔵ライブラリで複数のワークロードをカバーします。
pyspark.ml):分散機械学習ドライバー、クラスター・マネージャー、エグゼキューターがどのように処理を分担するかの詳細は、Apache Sparkのアーキテクチャガイドをご覧ください。