
Kurs
Docker'a Giriş
4 sa
52.8K
BT alanındaki her geliştirici ve operasyon mühendisi, uygulamaları yerelde veya bulutta oluşturup dağıtmak için Docker’a aşinadır. Ancak bir geliştirici veya makine öğrenimi operasyonları (MLOps) mühendisi olarak, kaynakları optimize etmek, güvenliği artırmak ve sistem entegrasyonunu iyileştirmek isteyebilirsiniz. Podman bu noktada güçlü bir alternatif sunar. Docker ve Docker Desktop’a alternatif olan ücretsiz ve açık kaynaklı bir araçtır.
Bu eğitimde Podman’ın ne olduğunu, Podman ile Docker arasındaki farkları ve Podman’ın nasıl kurulup kullanılacağını inceleyeceğiz. Ayrıca Dockerfile ve Podman komutlarını kullanarak makine öğrenimi modellerini yerelde nasıl eğitip değerlendireceğimizi ve dağıtacağımızı ele alacağız.
Görsel: Yazar
Podman, geliştiricilere ve makine öğrenimi mühendislerine sorunsuz ve güvenli bir deneyim sunmak üzere tasarlanmış açık kaynaklı bir konteyner yönetim aracıdır. Docker’dan farklı olarak Podman, arka planda daemon çalıştırmadan (daemonless) çalışır; bu da konteynerleri ayrıcalıksız (rootless) süreçler olarak çalıştırmaya olanak tanıyarak güvenliği ve esnekliği artırır. Bu temel özellik, Podman’ın kök ayrıcalıkları gerektirmeden konteynerleri çalıştırmasını sağlar ve potansiyel güvenlik açıklarını azaltır.
Podman, OCI (Open Container Initiative) standartlarıyla tamamen uyumludur; bu sayede Podman ile oluşturulan konteyner ve imajlar runc, Buildah ve Skopeo gibi OCI uyumlu diğer araç ve platformlarla kolayca entegre edilebilir. Ayrıca Podman, Kubernetes pod’larına benzer şekilde aynı ağ ad alanını paylaşan konteyner grupları olan pod’ların oluşturulmasını ve yönetimini de destekler.
Podman kullanmanın en iyi yönlerinden biri, Docker’a çok benzer bir deneyim sunmasıdır. Komut satırı arayüzü Docker’a yakındır ve Docker Hub’dan imaj çekebilirsiniz. Bu benzerlik, Docker’a aşina olanlar için geçişi kolaylaştırırken, konteynerleştirilmiş uygulama geliştirme ve dağıtımının gelişen ihtiyaçlarını karşılayan gelişmiş özellikler de sunar.
Podman, MLOps araç setinin yalnızca bir parçasıdır. MLOps ekosisteminde kullanılan tüm araç türlerini öğrenmek için şu blog yazısını okuyun: 2025’te Bilmeniz Gereken 25 MLOps Aracı.
Docker ve Podman, öne çıkan konteyner yönetim araçlarıdır ve her biri farklı özellik ve yetenekler sunar. Bu karşılaştırma, aralarındaki farkları inceleyerek ihtiyaçlarınıza en uygun seçimi yapmanıza yardımcı olacaktır.
|
Docker |
Podman |
|
|
Mimari |
Docker, dockerd adlı bir daemon sürecine sahip istemci-sunucu mimarisi kullanır. |
Podman daemon’sızdır; güvenliği ve sadeliği artıran fork-exec modeli kullanır. |
|
Güvenlik |
Docker varsayılan olarak konteynerleri root olarak çalıştırır; bu durum güvenlik riskleri doğurabilir. |
Podman, varsayılan olarak ayrıcalıksız (rootless) konteynerleri destekler ve güvenlik risklerini azaltır. |
|
İmaj Yönetimi |
Docker, kendi araçlarıyla konteyner imajları oluşturup yönetebilir. |
Podman, imaj oluşturmak için Buildah’a dayanır ve Docker kayıt defterlerindeki imajları çalıştırabilir. |
|
Uyumluluk |
Docker yaygın olarak kullanılır ve birçok CI/CD aracıyla entegredir. |
Podman, Docker uyumlu bir CLI sunar; bu da iş akışlarını değiştirmeden geçişi kolaylaştırır. |
|
Konteyner Orkestrasyonu |
Docker, orkestrasyon için Docker Swarm ve Kubernetes’i destekler. |
Podman, Docker Swarm’ı desteklemez ancak pod’lar aracılığıyla Kubernetes ile çalışabilir. |
|
Platform Desteği |
Docker, Linux, macOS ve Windows’ta (WSL ile) yerel olarak çalışır. |
Podman da Linux, macOS ve Windows’u (WSL ile) destekler. |
|
Performans |
Docker, verimli kaynak yönetimi ve hızlı dağıtımıyla bilinir. |
Podman genel olarak benzer performans sunar ve daha hızlı başlangıç süreleri sağlar. |
|
Kullanım Senaryoları |
Docker, yerleşik araç ve entegrasyonlara ihtiyaç duyan projeler için idealdir. |
Podman, güvenliği ve hafif operasyonları önceleyen ortamlar için uygundur. Büyük ölçekli dağıtımlar için idealdir. |
Docker ile Podman arasındaki seçim, büyük ölçüde güvenlik, uyumluluk ve orkestrasyon ihtiyaçları gibi özel proje gereksinimlerine bağlıdır.
Docker, yerleşik CI/CD hatları ve kapsamlı konteyner yönetimi için güçlü bir seçenek olmaya devam ederken; Podman, güvenlik ve ayrıcalıksız çalışma önceliği olan ortamlar için güvenli ve hafif bir alternatif sunar. Ayrıca daha hızlı başlangıç süreleri sunması, büyük ölçekli dağıtımlar için idealdir.
Örnek kod ve örnekler içeren giriş yazımızı okuyarak Veri Bilimi için Docker’ı keşfedin.
Öncelikle resmi web sitesine giderek Podman Desktop paketini indirip kurmanız gerekir.
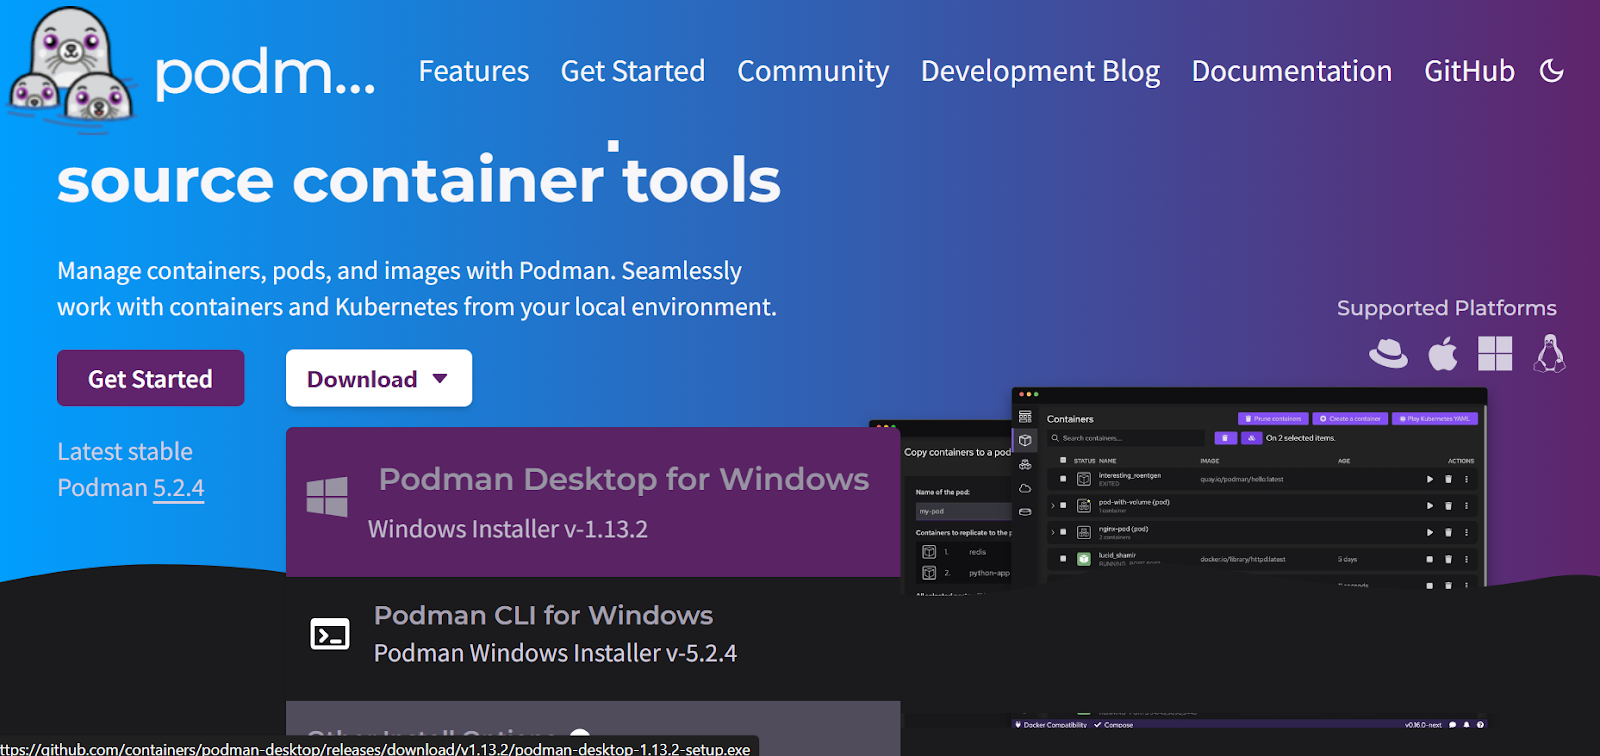
Kaynak: Podman
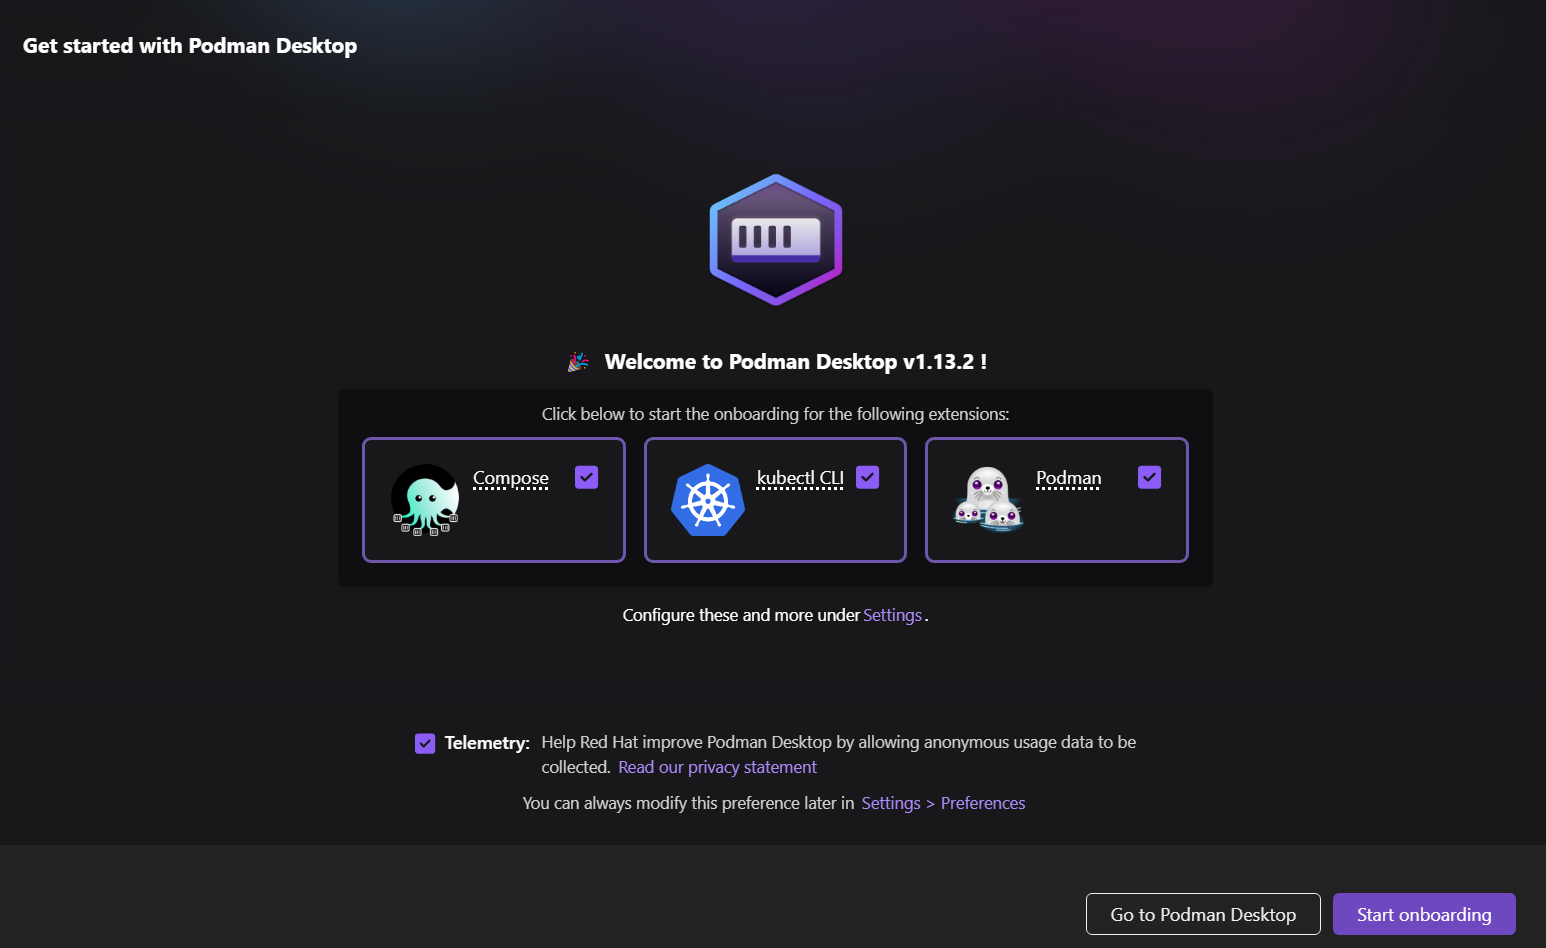
Kurulum basit ve hızlıdır. Birkaç dakika içinde, isteğe bağlı eklentileri kurmanızı isteyen başlarken ekranına ulaşacaksınız.
Windows’ta WSL yoksa, otomatik olarak WSL kuracaktır.
Sonraki adımda, Podman makinesini yapılandırın.
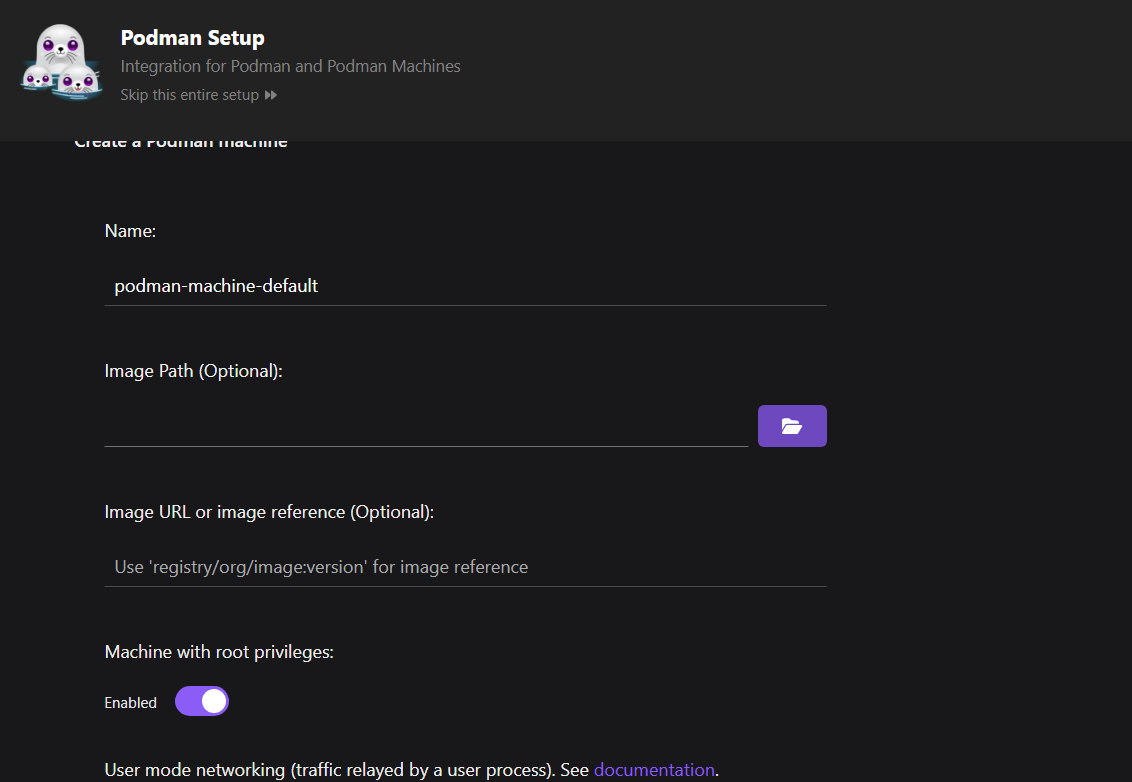
Docker ile karşılaştırıldığında, bir makine kurmanız gerekmez. Ancak Podman’da, aynı anda farklı konteynerleri yöneten birden fazla makineyi yönetebilirsiniz; bu da daha iyi kaynak yönetimi sağlar.
Makinemiz çalışır durumda; imaj oluşturmaya ve konteynerleri çalıştırmaya hazır.
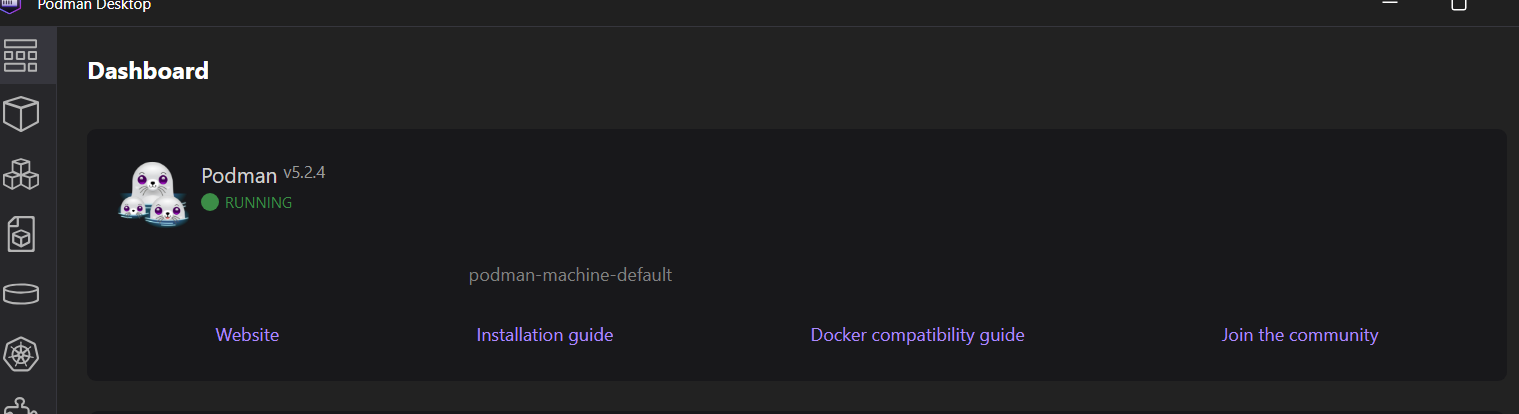
Podman’ın doğru çalıştığını doğrulamak için quay.io’dan örnek bir imaj çekecek ve konteyneri çalıştıracağız.
$ podman run quay.io/podman/helloPodman makinesi imajı başarıyla çekti ve konteyneri çalıştırarak log’ları gösterdi.
Trying to pull quay.io/podman/hello:latest...
Getting image source signatures
Copying blob sha256:81df7ff16254ed9756e27c8de9ceb02a9568228fccadbf080f41cc5eb5118a44
Copying config sha256:5dd467fce50b56951185da365b5feee75409968cbab5767b9b59e325fb2ecbc0
Writing manifest to image destination
!... Hello Podman World ...!

         .--"--.
       / -     - \
      / (O)   (O) \
   ~~~| -=(,Y,)=- |
    .---. /`  \   |~~
 ~/  o  o \~~~~.----. ~~
  | =(X)= |~  / (O (O) \
   ~~~~~~~  ~| =(Y_)=-  |
  ~~~~    ~~~|   U      |~~

Project:   https://github.com/containers/podman
Website:   https://podman.io
Desktop:   https://podman-desktop.io
Documents: https://docs.podman.io
YouTube:   https://youtube.com/@Podman
X/Twitter: @Podman_io
Mastodon: @Podman_io@fosstodon.orgBu MLOps projesinde, Dockerfile ve Podman kullanarak model eğitimini ve değerlendirmesini otomatikleştirecek ve modeli servis edeceğiz. Bu, Docker’a benzer olacaktır; ancak imajları oluşturmak ve konteyneri çalıştırmak için Podman CLI kullanacağız.
Kavramlara yeniyseniz, MLOps Kavramları kursunu tamamlayarak temelleri öğrenebilirsiniz.
Makine öğrenimi projesini kurmak için bir eğitim (training) ve servis (serving) betiği ile Python paketlerini kurmak üzere bir requirements.txt dosyası oluşturmamız gerekir.
Eğitim Python betiği kredi skoru sınıflandırma veri setini yükleyecek, işleyecek, kodlayacak ve modeli eğitecek. Ayrıca model değerlendirmesi de yapacağız. Son aşamada, önişleme ve eğitim hattını (pipeline) model ile birlikte pickle formatında kaydedeceğiz.
src/train.py:
# src/train.py

import os
import pickle

import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from sklearn.compose import ColumnTransformer
from sklearn.ensemble import RandomForestClassifier
from sklearn.impute import SimpleImputer
from sklearn.metrics import (
    accuracy_score,
    classification_report,
    confusion_matrix,
    roc_auc_score,
)
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder


def load_data():
    data_path = "data/train.csv"
    df = pd.read_csv(data_path,low_memory=False)
    print("Data loaded successfully!")
    return df


def preprocess_data(df):
    # Drop unnecessary columns
    df = df.drop(columns=["ID", "Customer_ID", "SSN", "Name", "Month"])

    # Drop rows with missing values
    df = df.dropna()

    # Convert data types
    # Convert the 'Age' column to numeric, setting errors='coerce' to handle non-numeric values
    df["Age"] = pd.to_numeric(df["Age"], errors="coerce")

    # Filter the DataFrame to include only rows where 'Age' is between 1 and 60
    df = df[(df["Age"] >= 1) & (df["Age"] <= 60)]

    df["Annual_Income"] = pd.to_numeric(df["Annual_Income"], errors="coerce")
    df["Monthly_Inhand_Salary"] = pd.to_numeric(
        df["Monthly_Inhand_Salary"], errors="coerce"
    )

    # Separate features and target
    X = df.drop("Credit_Score", axis=1)
    y = df["Credit_Score"]

    print("Data preprocessed successfully!")
    return X, y


def encode_data(X):
    # Identify categorical and numerical features
    categorical_features = [
        "Occupation",
        "Credit_Mix",
        "Payment_of_Min_Amount",
        "Payment_Behaviour",
        "Type_of_Loan",
    ]
    numerical_features = X.select_dtypes(include=["int64", "float64"]).columns.tolist()

    # Define preprocessing steps
    numerical_transformer = SimpleImputer(strategy="median")

    categorical_transformer = Pipeline(
        steps=[
            ("imputer", SimpleImputer(strategy="most_frequent")),
            ("onehot", OneHotEncoder(handle_unknown="ignore")),
        ]
    )

    preprocessor = ColumnTransformer(
        transformers=[
            ("num", numerical_transformer, numerical_features),
            ("cat", categorical_transformer, categorical_features),
        ]
    )

    return preprocessor


def split_data(X, y):
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=42
    )
    return X_train, X_test, y_train, y_test


def train_model(X_train, y_train, preprocessor):
    # Create a pipeline with preprocessing and model
    clf = Pipeline(
        steps=[
            ("preprocessor", preprocessor),
            ("classifier", RandomForestClassifier(n_estimators=100)),
        ]
    )

    # Train the model
    clf.fit(X_train, y_train)

    # Return the trained model
    return clf


def evaluate_model(clf, X_test, y_test):
    # Predict and evaluate
    y_pred = clf.predict(X_test)
    acc = accuracy_score(y_test, y_pred)
    report = classification_report(y_test, y_pred, labels=["Poor", "Standard", "Good"])
    cm = confusion_matrix(y_test, y_pred, labels=["Poor", "Standard", "Good"])

    # Calculate AUC score
    y_test_encoded = y_test.replace({"Poor": 0, "Standard": 1, "Good": 2})
    y_pred_proba = clf.predict_proba(X_test)
    auc_score = roc_auc_score(y_test_encoded, y_pred_proba, multi_class="ovr")

    # Print metrics
    print("Model Evaluation Metrics:")
    print(f"Accuracy: {acc}")
    print(f"AUC Score: {auc_score}")
    print("Classification Report:")
    print(report)

    # Plot confusion matrix
    plt.figure(figsize=(8, 6))
    plt.imshow(cm, interpolation="nearest", cmap=plt.cm.Blues)
    plt.title("Confusion Matrix")
    plt.colorbar()
    tick_marks = np.arange(3)
    plt.xticks(tick_marks, ["Poor", "Standard", "Good"], rotation=45)
    plt.yticks(tick_marks, ["Poor", "Standard", "Good"])
    plt.ylabel("True label")
    plt.xlabel("Predicted label")
    plt.tight_layout()
    cm_path = os.path.join("model", "confusion_matrix.png")
    plt.savefig(cm_path)
    print(f"Confusion matrix saved to {cm_path}")


def save_model(clf):
    model_dir = "model"
    os.makedirs(model_dir, exist_ok=True)
    model_path = os.path.join(model_dir, "model.pkl")

    # Save the trained model
    with open(model_path, "wb") as f:
        pickle.dump(clf, f)
    print(f"Model saved to {model_path}")


def main():
    # Execute steps
    df = load_data()
    X, y = preprocess_data(df)
    preprocessor = encode_data(X)
    X_train, X_test, y_train, y_test = split_data(X, y)
    clf = train_model(X_train, y_train, preprocessor)
    evaluate_model(clf, X_test, y_test)
    save_model(clf)


if __name__ == "__main__":
    main()
Model servis betiği, kaydedilmiş model hattını model dosyasıyla yükleyecek; kullanıcıdan gelen sözlük (dict) listesi alan bir POST isteği işlevi oluşturacak; bunu bir DataFrame’e dönüştürüp tahmin üretmesi için modele verecek ve ardından tahmin edilen etiketi döndürecektir. API çerçevesi olarak FastAPI kullanıyoruz; yalnızca birkaç satır kodla modeli servis etmemizi sağlıyor.
src/app.py:
# src/app.py

import pickle
from fastapi import FastAPI
from pydantic import BaseModel
import pandas as pd
import os

# Load the trained model
model_path = os.path.join("model", "model.pkl")
with open(model_path, "rb") as f:
    model = pickle.load(f)

app = FastAPI()


class InputData(BaseModel):
    data: list  # List of dictionaries representing feature values


@app.post("/predict")
def predict(input_data: InputData):
    # Convert input data to DataFrame
    X_new = pd.DataFrame(input_data.data)
    # Ensure the columns match the training data
    prediction = model.predict(X_new)
    # Return predictions
    return {"prediction": prediction.tolist()}
Yukarıdaki betikleri çalıştırmak için gerekli tüm Python paketlerini içeren bir requirements.txt dosyası oluşturmamız gerekir. Bu dosya, Docker konteynerinde çalışan bir ortam kurmak için kullanılacak ve Python betiklerini sorunsuz şekilde çalıştırmamızı sağlayacaktır.
requirements.txt:
fastapi
uvicorn[standard]
numpy
pandas
scikit-learn
pydantic
matplotlibBir “Dockerfile” oluşturun ve aşağıdaki kodu ekleyin.
Bu Dockerfile’ın gerçekleştirdiği adımlar şunlardır:
# Dockerfile

FROM python:3.9-slim

WORKDIR /app

# Install dependencies
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

# Copy the application code
COPY ./src/ ./src/
COPY ./data/ ./data/

# Ensure the model directory exists and is copied
RUN mkdir -p model

# Run the training script during the build
RUN python src/train.py

# Expose the port for the API
EXPOSE 8000


# Run the FastAPI app
CMD ["uvicorn", "src.app:app", "--host", "0.0.0.0", "--port", "8000"]
Yerel çalışma alanınız aşağıdaki gibi düzenlenmiş olmalıdır:
data klasörümodels klasörüsrc klasörürequirements.txt dosyası ve bir DockerfileKalan dosyalar, otomasyon ve Git işlemleri için ek bileşenlerdir.
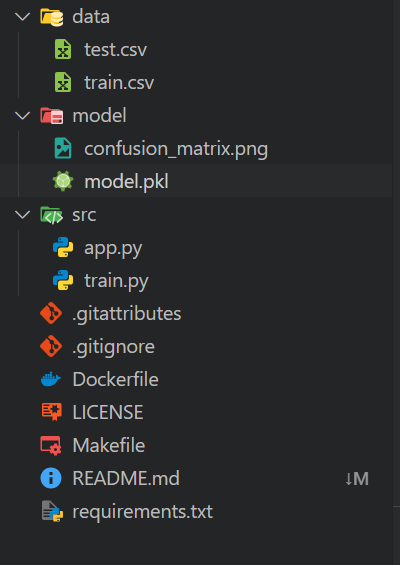
Docker imajını oluşturmak basittir: build komutuna Docker imaj adınızı ve Dockerfile’ın bulunduğu geçerli dizini verin.
$ podman build -t mlops_app .Derleyici, Dockerfile’daki tüm komutları sırasıyla çalıştıracak; ortam kurulumundan makine öğrenimi uygulamasını servis etmeye kadar.
Ayrıca log’larda model değerlendirme sonuçlarının yer aldığını da görebiliriz. Modelin doğruluğu %75 ve ROC AUC skoru 0,89; bu ortalama düzeyde kabul edilir.
STEP 1/11: FROM python:3.9-slim
STEP 2/11: WORKDIR /app
--> Using cache 72ac9e49ae29da1ff19e118653efca17e7a489ae9e7ead917c83d942a3ea4e13
--> 72ac9e49ae29
STEP 3/11: COPY requirements.txt .
--> Using cache 3a05ca95caaf98c448c53a796714328bf9f7cff7896cce348f84a26b8d0dae61
--> 3a05ca95caaf
STEP 4/11: RUN pip install --no-cache-dir -r requirements.txt
--> Using cache 28109d1183449396a5df0006ab603dd5cf2aa2c06a810bdc6bcf0f843f855ee0
--> 28109d118344
STEP 5/11: COPY ./src/ ./src/
--> f814f699c58a
STEP 6/11: COPY ./data/ ./data/
--> 922550900cd0
STEP 7/11: RUN mkdir -p model
--> 36fc01f2d169
STEP 8/11: RUN python src/train.py
Data loaded successfully!
Data preprocessed successfully!
Data encoded successfully!
Data split successfully!
Model trained successfully!
Model Evaluation Metrics:
Accuracy: 0.7546181417149159
ROC AUC Score: 0.8897184704689612
Classification Report:
              precision    recall  f1-score   support

        Good       0.71      0.67      0.69      1769
        Poor       0.75      0.76      0.75      3403
    Standard       0.77      0.78      0.78      5709

    accuracy                           0.75     10881
   macro avg       0.74      0.74      0.74     10881
weighted avg       0.75      0.75      0.75     10881

Model saved to model/model.pkl
--> 5d4777c08580
STEP 9/11: EXPOSE 8000
--> 7bb09a613e7f
STEP 10/11: WORKDIR /app/src
--> 06b6394c2e2d
STEP 11/11: CMD ["uvicorn", "app:app", "--host", "0.0.0.0", "--port", "8000"]
COMMIT mlops-app
--> 9a7a42b03664
Successfully tagged localhost/mlops-app:latest
9a7a42b03664f1e4631330cd682cb2de26e513c5d776fa2ce2042b3bb9455e14
Podman Desktop uygulamasını açıp “Images” sekmesine tıklarsanız, mlops_app imajınızın başarıyla oluşturulduğunu göreceksiniz.
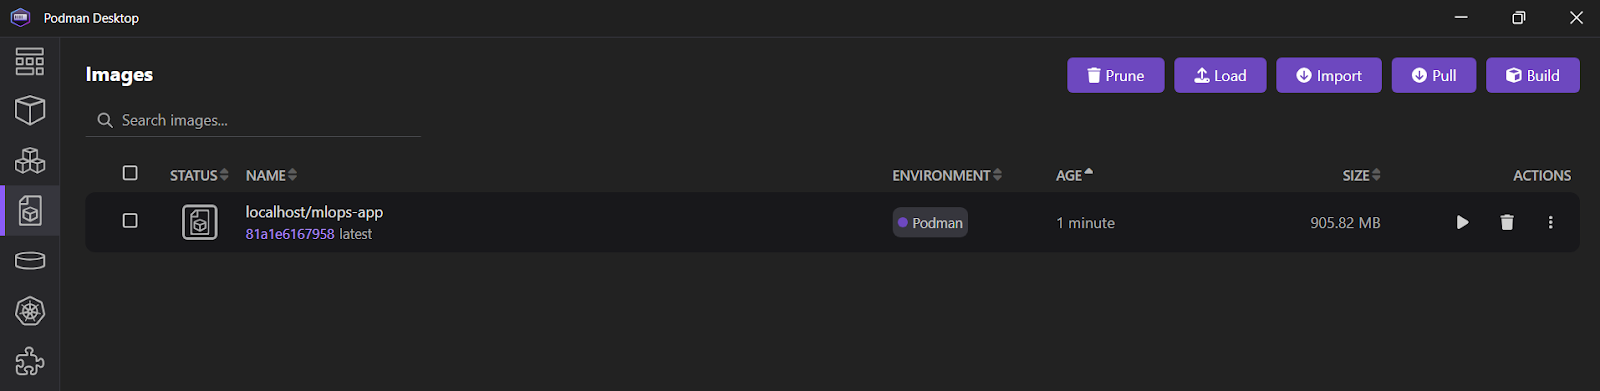
Tüm ilgili Docker komutlarını öğrenmek için Veri Bilimi için Docker kopya kağıdına göz atın. Yalnızca ilk komut olan, docker’ı podman ile değiştirin.
mlops-app imajından "mlops_container" adlı bir konteyneri başlatmak için run komutunu kullanacağız. Bu işlem, ayrık modda (-d) yapılacak ve konteynerin 8000 portu ana makinedeki 8000 portuna eşlenecek. Bu kurulum, FastAPI uygulamasına konteyner dışından erişimi sağlayacaktır.
$ podman run -d --name mlops_container -p 8000:8000 mlops-app "mlops_container" için tüm log’ları görüntülemek üzere logs komutunu kullanın.
$ podman logs -f mlops_container Çıktı:
INFO:     Started server process [1]
INFO:     Waiting for application startup.
INFO:     Application startup complete.
INFO:     Uvicorn running on http://0.0.0.0:8000 (Press CTRL+C to quit)
INFO:     10.88.0.1:36886 - "POST /predict HTTP/1.1" 200 OK
Podman Desktop uygulamasını açıp “Containers” sekmesine tıklayarak çalışan konteynerleri görüntüleyebilirsiniz.
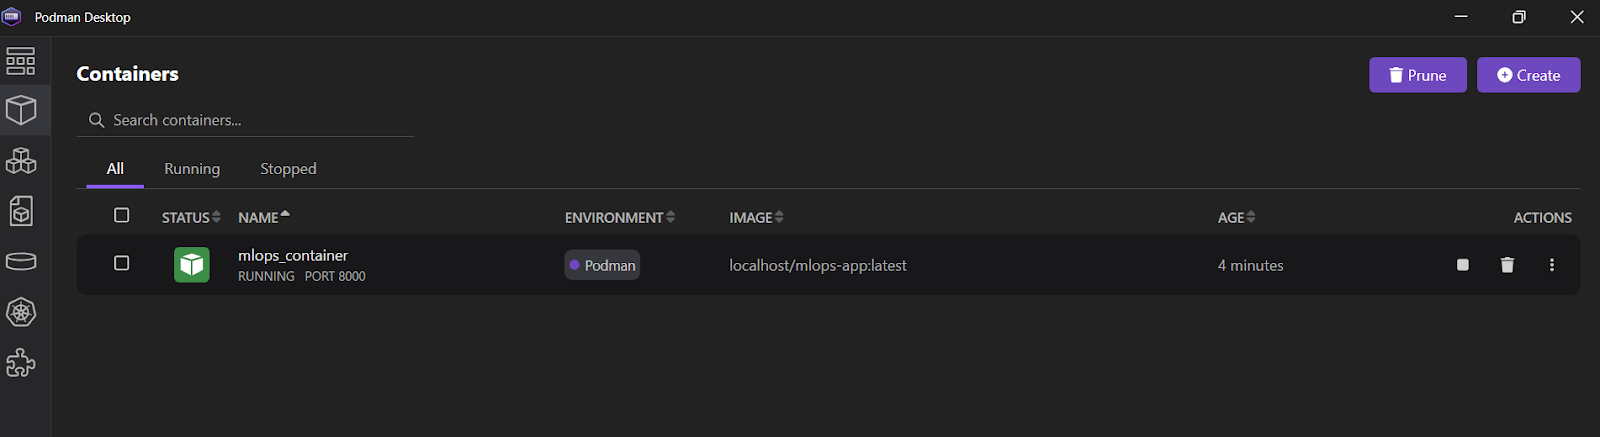
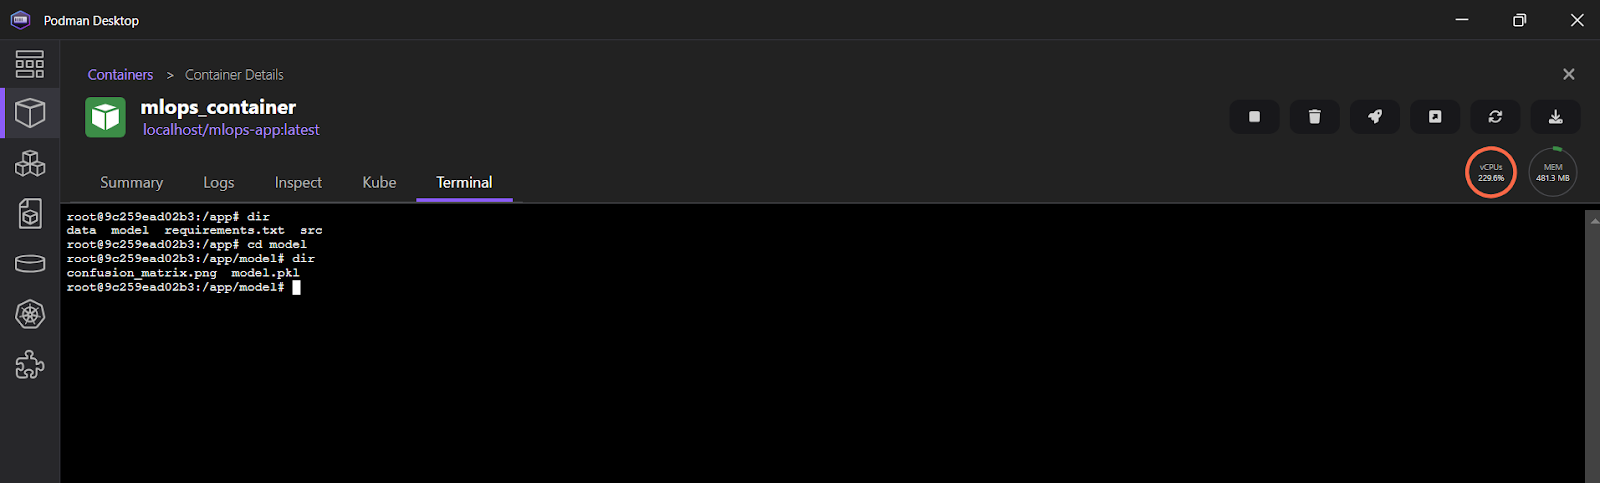
Podman Desktop uygulamasında log’ları görüntülemek için “mlops_container” üzerine tıklayın ve ardından “Terminal” sekmesini seçin.
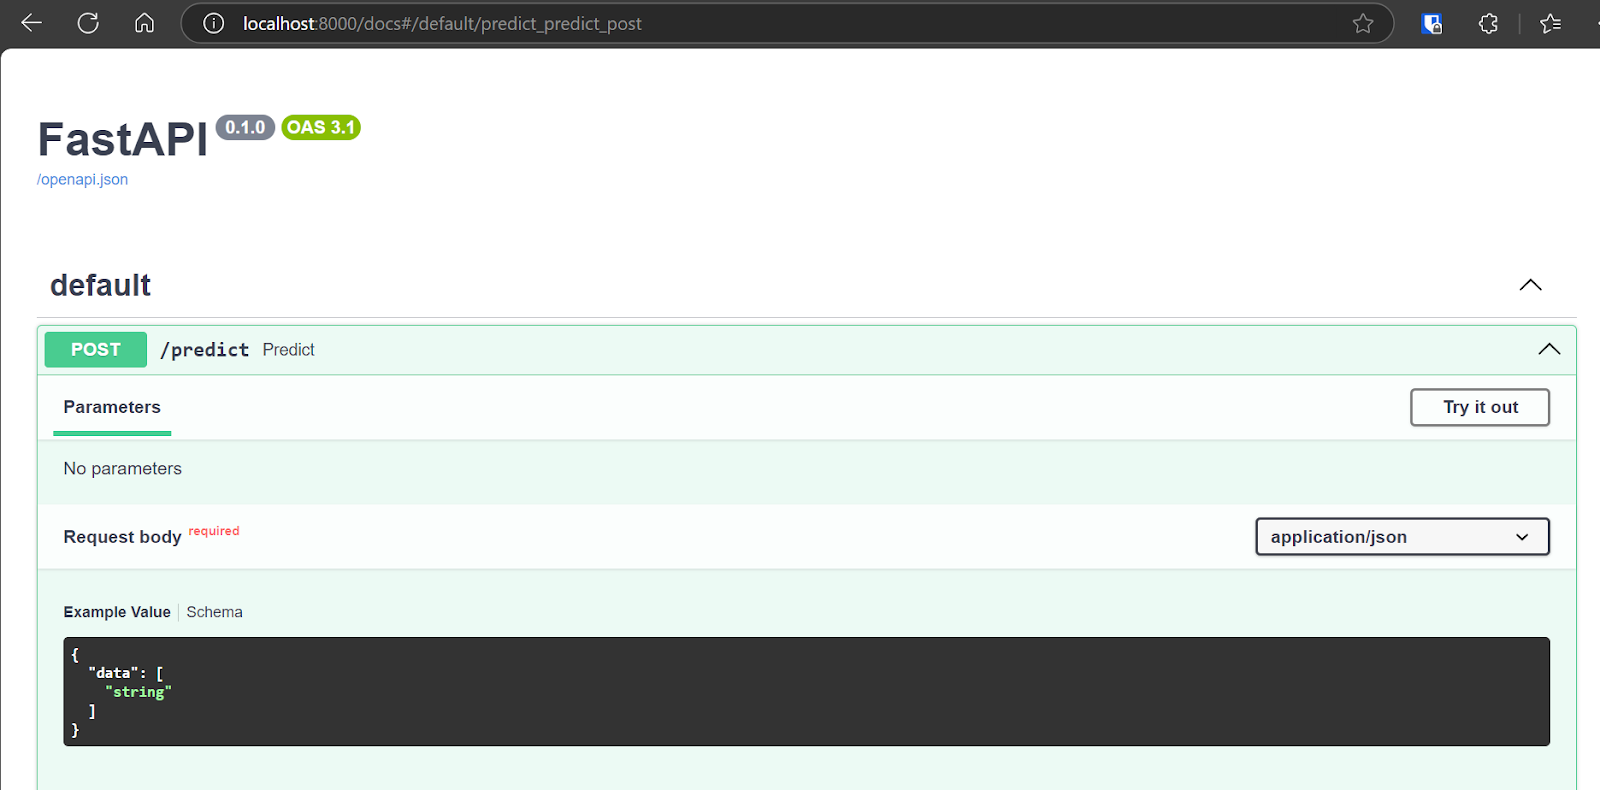
Şimdi, http://localhost:8000/docs adresindeki etkileşimli Swagger UI’a erişerek dağıtılmış uygulamayı test edeceğiz. Swagger UI, mevcut tüm API uç noktalarını keşfetmenize olanak tanıyan kullanıcı dostu bir arayüz sunar.
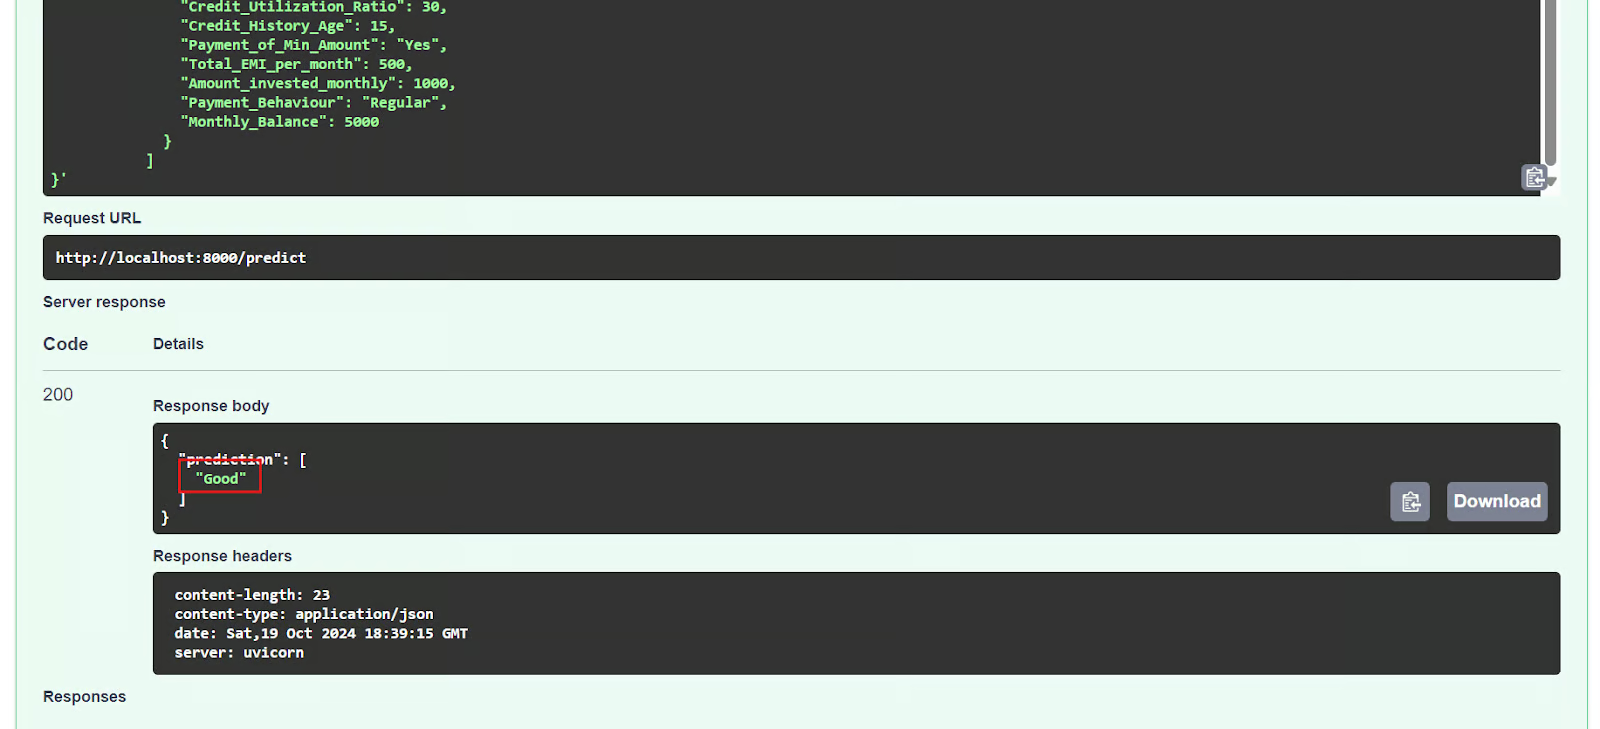
API’yi terminalde CURL komutunu kullanarak da test edebiliriz.
$ curl -X POST "http://localhost:8000/predict" \
     -H "Content-Type: application/json" \
     -d '{
           "data": [
             {
               "Age": 35,
               "Occupation": "Engineer",
               "Annual_Income": 85000,
               "Monthly_Inhand_Salary": 7000,
               "Num_Bank_Accounts": 2,
               "Num_Credit_Card": 3,
               "Interest_Rate": 5,
               "Num_of_Loan": 1,
               "Type_of_Loan": "Personal Loan",
               "Delay_from_due_date": 2,
               "Num_of_Delayed_Payment": 1,
               "Changed_Credit_Limit": 15000,
               "Num_Credit_Inquiries": 2,
               "Credit_Mix": "Good",
               "Outstanding_Debt": 10000,
               "Credit_Utilization_Ratio": 30,
               "Credit_History_Age": 15,
               "Payment_of_Min_Amount": "Yes",
               "Total_EMI_per_month": 500,
               "Amount_invested_monthly": 1000,
               "Payment_Behaviour": "Regular",
               "Monthly_Balance": 5000
             }
           ]
         }'
FastAPI sunucusu doğru şekilde çalışıyor; kullanıcı girdisini başarıyla işliyor ve doğru bir tahmin döndürüyor.
{"prediction":["Good"]}API ile denemeler yaptıktan sonra, stop komutunu kullanarak konteyneri durduracağız.
$ podman stop mlops_container Ayrıca, sistem kaynaklarını serbest bırakmak için rm komutunu kullanarak konteyneri kaldırabiliriz. Konteyner kaldırılmadan önce durdurulmuş olmalıdır.
$ podman rm mlops_container Yerelde saklanan "mlops-app" adlı konteyner imajını kaldırmak için rmi komutunu kullanacağız.
$ podman rmi mlops-app Yukarıdaki kodu çalıştırırken sorun yaşıyorsanız veya kendi Docker dosyanızı oluşturuyorsanız, lütfen şu GitHub deposuna bakın: kingabzpro/mlops-with-podman. Sisteminizde kodu çalıştırmanız için bir kullanım kılavuzu ve gerekli tüm dosyaları içerir.
Öğrenme yolculuğunuzdaki bir sonraki adım, başlangıçtan ileri düzeye kadar uzanan 10 Docker proje fikrini Podman ile denemektir. Bu, Podman ekosistemini daha iyi anlamanıza yardımcı olacaktır.
Podman, belirli kullanım senaryoları için Docker’a güçlü bir alternatif sunar; yine de birçok geliştirici, geniş entegrasyonları ve kullanıcı dostu araçları nedeniyle Docker Desktop ve CLI’ı tercih etmeye devam etmektedir.
Bununla birlikte, doğrudan bir MLOps projesi için mühendisler, Docker Desktop’a kıyasla daha hafif ve kolay kurulum sunan Podman’ı tercih edebilir.
Bu eğitimde, Docker ile karşılaştırarak popüler bir konteyner yönetim aracı olan Podman’ı inceledik ve Podman Desktop’ın nasıl kurulacağını gösterdik. Ayrıca bir MLOps projesini Podman ile adım adım ele alarak bir Dockerfile oluşturmayı, imaj derlemeyi ve konteyner çalıştırmayı gösterdik. Podman ile başlamak kolaydır ve Docker’a zaten aşinaysanız geçişin ne kadar sorunsuz olduğunu takdir edeceksiniz.
Modern MLOps çerçevesini; makine öğrenimi modellerinin yaşam döngüsü ve dağıtımını keşfetmek için MLOps Deployment and LifeCycling kursunu alın.
En İyi DataCamp Kursları
Kurs
Kurs
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



