
कोर्स
Docker परिचय
4 घंटा
52.1K
आईटी क्षेत्र में हर डेवलपर और ऑपरेशंस इंजीनियर स्थानीय या क्लाउड में एप्लिकेशन बनाने और परिनियोजित करने के लिए Docker से परिचित है। हालांकि, एक डेवलपर या मशीन लर्निंग ऑपरेशंस इंजीनियर के रूप में, आप संसाधनों का अनुकूलन, सुरक्षा में सुधार और सिस्टम एकीकरण को बेहतर करने की तलाश में हो सकते हैं। Podman एक प्रभावशाली विकल्प पेश करता है। यह एक मुफ्त, ओपन-सोर्स टूल है जो Docker और Docker Desktop का विकल्प है।
इस ट्यूटोरियल में, हम जानेंगे कि Podman क्या है, Podman और Docker में क्या अंतर हैं, और Podman को कैसे इंस्टॉल और उपयोग करें। साथ ही, हम यह भी कवर करेंगे कि Dockerfile और Podman कमांड्स का उपयोग करके मशीन लर्निंग मॉडलों को स्थानीय रूप से कैसे ट्रेन, मूल्यांकित और डिप्लॉय किया जाए।
चित्र: लेखक द्वारा
Podman एक ओपन-सोर्स कंटेनर मैनेजमेंट टूल है, जिसे डेवलपर्स और मशीन लर्निंग इंजीनियर्स को सहज और सुरक्षित अनुभव प्रदान करने के लिए डिज़ाइन किया गया है। Docker के विपरीत, Podman डेमॉनलेस तरीके से काम करता है, जो उपयोगकर्ताओं को कंटेनरों को रूटलेस प्रक्रियाओं के रूप में चलाने की अनुमति देकर सुरक्षा और लचीलेपन को बढ़ाता है। यह प्रमुख विशेषता Podman को रूट विशेषाधिकारों की आवश्यकता के बिना कंटेनर चलाने में सक्षम बनाती है, जिससे संभावित कमजोरियों को कम किया जा सकता है।
Podman पूरी तरह से OCI (Open Container Initiative) मानकों के अनुरूप है, जिससे Podman के साथ बनाए गए कंटेनर और इमेज runc, Buildah और Skopeo जैसे अन्य OCI-अनुरूप टूल और प्लेटफ़ॉर्म के साथ आसानी से एकीकृत हो सकते हैं। इसके अलावा, Podman pods के निर्माण और प्रबंधन का समर्थन करता है, जो एक ही नेटवर्क नेमस्पेस साझा करने वाले कंटेनरों के समूह होते हैं, जो Kubernetes pods के समान हैं।
Podman का उपयोग करने के सबसे अच्छे पहलुओं में से एक यह है कि यह Docker जैसा अनुभव प्रदान करता है। कमांड-लाइन इंटरफ़ेस Docker के समान है, और आप Docker Hub से इमेज भी खींच सकते हैं। यह समानता Docker से परिचित लोगों के लिए आसान संक्रमण सुनिश्चित करती है, साथ ही उन्नत सुविधाएँ भी देती है जो कंटेनराइज़्ड एप्लिकेशन विकास और परिनियोजन की बदलती ज़रूरतों को पूरा करती हैं।
Podman, MLOps के टूलकिट में से सिर्फ एक टूल है। MLOps इकोसिस्टम में उपयोग होने वाले सभी प्रकार के टूल्स के बारे में जानने के लिए ब्लॉग पढ़ें 2025 में जानने लायक 25 शीर्ष MLOps टूल्स।
Docker और Podman प्रमुख कंटेनर मैनेजमेंट टूल हैं, जिनमें प्रत्येक में विशिष्ट विशेषताएँ और क्षमताएँ हैं। यह तुलना इनके अंतर को परखेगी और आपको यह तय करने में मदद करेगी कि आपकी आवश्यकताओं के लिए कौन सा बेहतर बैठता है।
|
Docker |
Podman |
|
|
आर्किटेक्चर |
Docker क्लाइंट-सरवर आर्किटेक्चर का उपयोग करता है जिसमें dockerd नामक डेमॉन प्रक्रिया होती है। |
Podman डेमॉनलेस है और fork-exec मॉडल का उपयोग करता है, जो सुरक्षा और सरलता को बढ़ाता है। |
|
सुरक्षा |
Docker डिफ़ॉल्ट रूप से कंटेनरों को root के रूप में चलाता है, जो सुरक्षा जोखिम पैदा कर सकता है। |
Podman डिफ़ॉल्ट रूप से रूटलेस कंटेनरों का समर्थन करता है, जिससे सुरक्षा जोखिम कम होते हैं। |
|
इमेज प्रबंधन |
Docker अपने स्वयं के टूल्स का उपयोग करके कंटेनर इमेज बना और प्रबंधित कर सकता है। |
Podman इमेज बनाने के लिए Buildah पर निर्भर करता है और Docker रजिस्ट्रियों से इमेज चला सकता है। |
|
अनुकूलता |
Docker व्यापक रूप से उपयोग होता है और कई CI/CD टूल्स के साथ इंटीग्रेटेड है। |
Podman Docker-संगत CLI प्रदान करता है, जिससे वर्कफ़्लो बदले बिना स्विच करना आसान हो जाता है। |
|
कंटेनर ऑर्केस्ट्रेशन |
Docker ऑर्केस्ट्रेशन के लिए Docker Swarm और Kubernetes का समर्थन करता है। |
Podman Docker Swarm का समर्थन नहीं करता, लेकिन pods का उपयोग करके Kubernetes के साथ काम कर सकता है। |
|
प्लेटफ़ॉर्म सपोर्ट |
Docker मूल रूप से Linux, macOS और Windows (WSL के साथ) पर चलता है। |
Podman भी Linux, macOS और Windows (WSL के साथ) का समर्थन करता है। |
|
प्रदर्शन |
Docker अपने कुशल संसाधन प्रबंधन और तेज़ परिनियोजन के लिए जाना जाता है। |
Podman आमतौर पर प्रदर्शन में तुलनीय है और तेज़ स्टार्टअप समय प्रदान करता है। |
|
उपयोग के मामले |
Docker उन प्रोजेक्ट्स के लिए आदर्श है जिनमें स्थापित टूल्स और इंटीग्रेशन की आवश्यकता होती है। |
Podman उन वातावरणों के लिए उपयुक्त है जहाँ सुरक्षा और हल्के ऑपरेशंस प्राथमिकता हैं। बड़े पैमाने पर परिनियोजन के लिए आदर्श। |
Docker और Podman के बीच चयन काफी हद तक आपकी परियोजना की विशिष्ट आवश्यकताओं पर निर्भर करता है, विशेषकर सुरक्षा, अनुकूलता और ऑर्केस्ट्रेशन को लेकर।
स्थापित CI/CD पाइपलाइनों और व्यापक कंटेनर प्रबंधन के लिए Docker एक मज़बूत विकल्प बना रहता है, जबकि Podman सुरक्षा और रूटलेस ऑपरेशंस को प्राथमिकता देने वाले वातावरणों के लिए एक सुरक्षित, हल्का विकल्प प्रदान करता है। यह तेज़ स्टार्टअप समय भी देता है, जो बड़े पैमाने पर परिनियोजन के लिए आदर्श है।
हमारा परिचयात्मक लेख पढ़कर डेटा साइंस के लिए Docker जानें, जिसमें नमूना कोड और उदाहरण शामिल हैं।
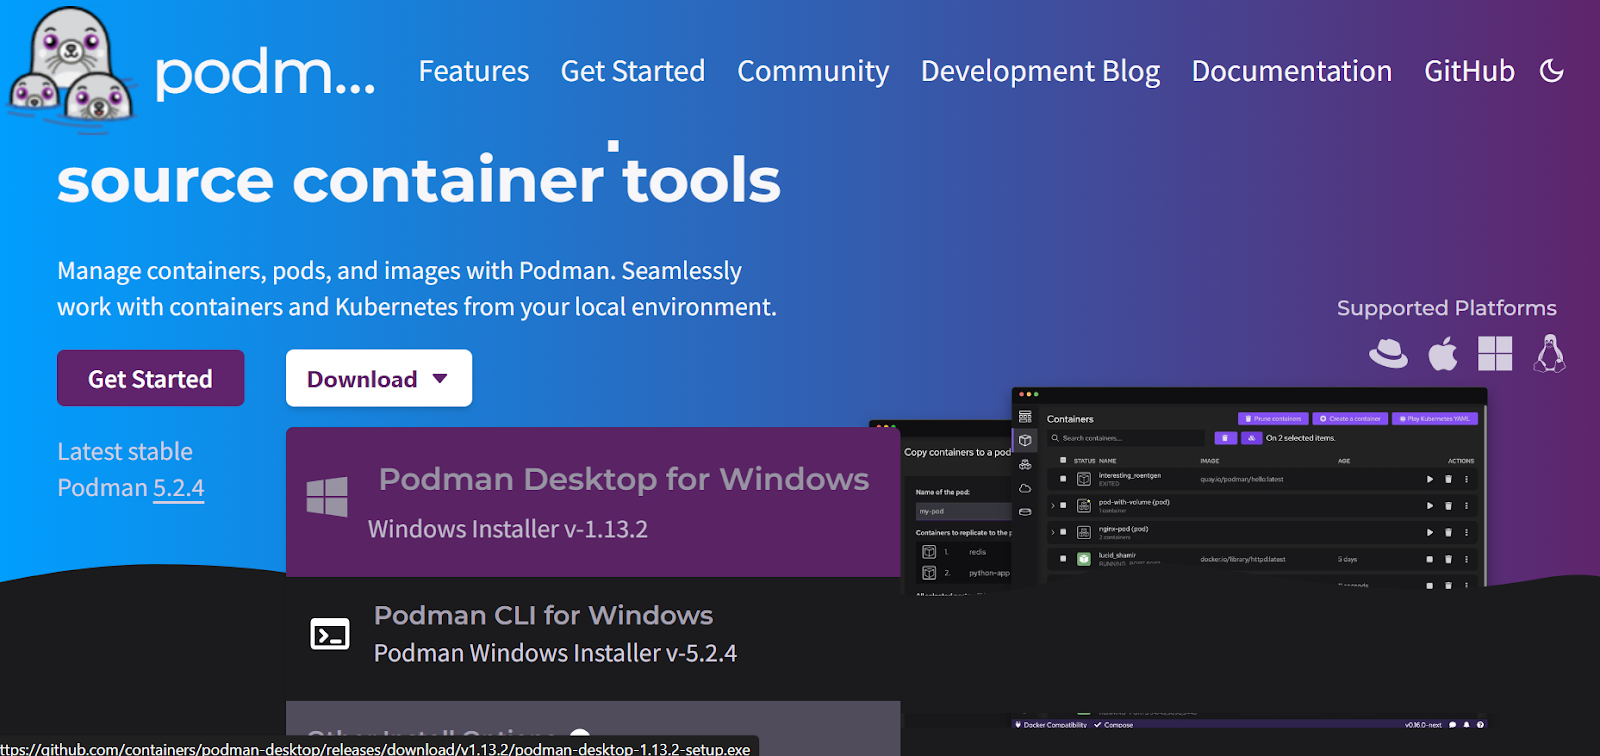
सबसे पहले, आप आधिकारिक वेबसाइट पर जाकर Podman Desktop पैकेज डाउनलोड और इंस्टॉल करना चाहेंगे।
स्रोत: Podman
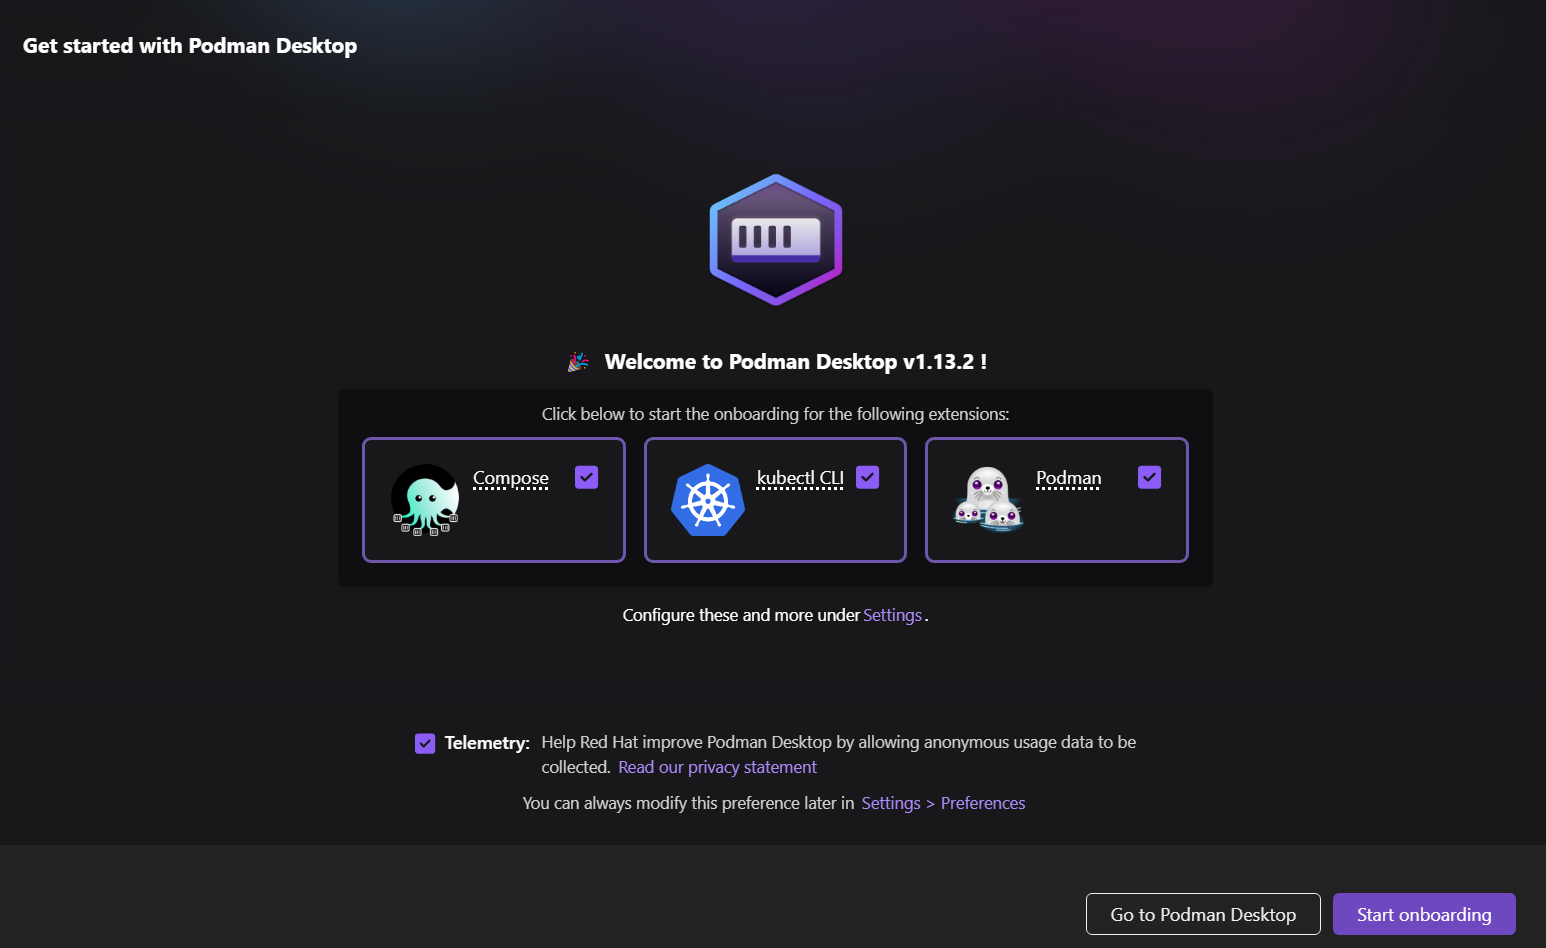
इंस्टॉलेशन सरल और तेज़ है। कुछ ही मिनटों में, आप गेटिंग स्टार्टेड स्क्रीन पर होंगे, जहाँ आपसे वैकल्पिक एक्सटेंशन इंस्टॉल करने के लिए कहा जाएगा।
यदि आपके Windows में WSL नहीं है, तो यह स्वचालित रूप से WSL इंस्टॉल कर देगा।
अगला, Podman मशीन सेटअप करें।
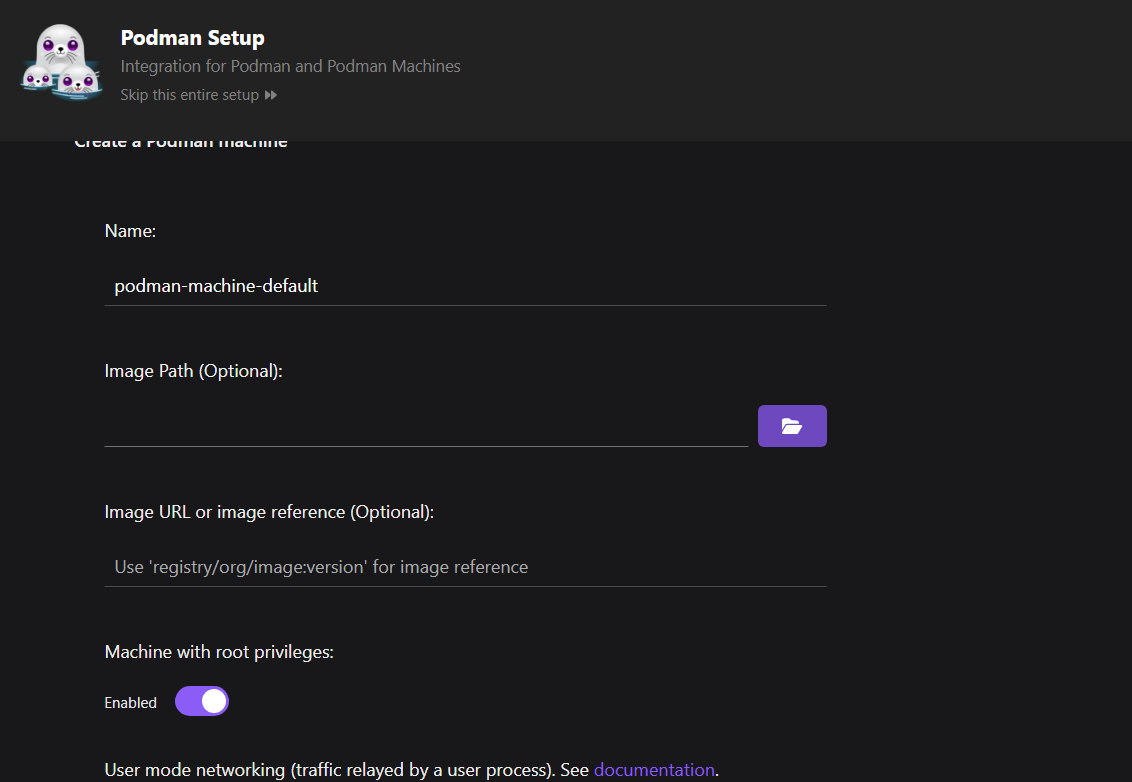
Docker की तुलना में, आपको मशीन सेट करने की आवश्यकता नहीं होती। हालांकि, Podman में, आप एक साथ विभिन्न कंटेनरों को संभालने वाली कई मशीनें प्रबंधित कर सकते हैं, जो बेहतर संसाधन प्रबंधन की अनुमति देता है।
हमारी मशीन चालू है और इमेज बनाने व कंटेनर चलाने के लिए तैयार है।
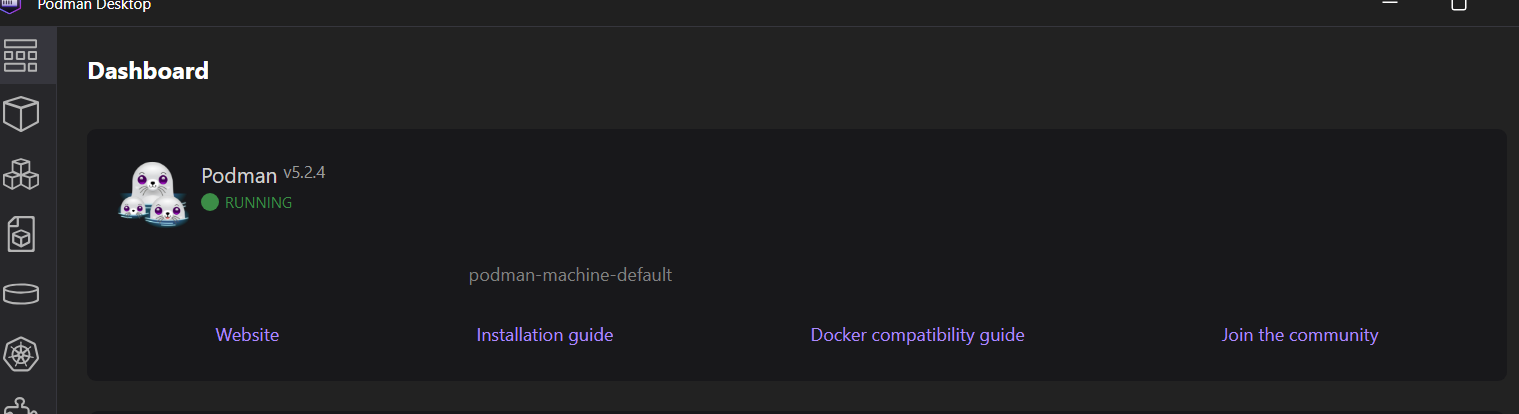
यह सत्यापित करने के लिए कि Podman सही ढंग से काम कर रहा है, हम quay.io से एक सैंपल इमेज पुल करेंगे और कंटेनर चलाएंगे।
$ podman run quay.io/podman/helloPodman मशीन ने सफलतापूर्वक इमेज पुल की और कंटेनर चलाया, तथा लॉग्स प्रदर्शित किए।
Trying to pull quay.io/podman/hello:latest...
Getting image source signatures
Copying blob sha256:81df7ff16254ed9756e27c8de9ceb02a9568228fccadbf080f41cc5eb5118a44
Copying config sha256:5dd467fce50b56951185da365b5feee75409968cbab5767b9b59e325fb2ecbc0
Writing manifest to image destination
!... Hello Podman World ...!

         .--"--.
       / -     - \
      / (O)   (O) \
   ~~~| -=(,Y,)=- |
    .---. /`  \   |~~
 ~/  o  o \~~~~.----. ~~
  | =(X)= |~  / (O (O) \
   ~~~~~~~  ~| =(Y_)=-  |
  ~~~~    ~~~|   U      |~~

Project:   https://github.com/containers/podman
Website:   https://podman.io
Desktop:   https://podman-desktop.io
Documents: https://docs.podman.io
YouTube:   https://youtube.com/@Podman
X/Twitter: @Podman_io
Mastodon: @Podman_io@fosstodon.orgइस MLOps प्रोजेक्ट में, हम मॉडल प्रशिक्षण और मूल्यांकन को स्वचालित करेंगे और Dockerfile तथा Podman का उपयोग करके मॉडल को सर्व करेंगे। यह Docker जैसा ही होगा, लेकिन हम इमेज बनाने और फिर कंटेनर चलाने के लिए Podman CLI का उपयोग करेंगे।
यदि आप इन अवधारणाओं में नए हैं, तो आप MLOps Concepts कोर्स पूरा करके बुनियादी बातें सीख सकते हैं।
मशीन लर्निंग प्रोजेक्ट सेट करने के लिए, हमें प्रशिक्षण और सर्विंग स्क्रिप्ट बनानी होगी, और Python पैकेजेज़ इंस्टॉल करने हेतु requirements.txt फ़ाइल भी बनानी होगी।
ट्रेनिंग Python स्क्रिप्ट क्रेडिट स्कोर वर्गीकरण डेटासेट को लोड करेगी, उसे प्रोसेस और एन्कोड करेगी, और मॉडल ट्रेन करेगी। हम मॉडल मूल्यांकन भी करेंगे। अंत में, हम प्रीप्रोसेसिंग और ट्रेनिंग पाइपलाइन को मॉडल के साथ pickle फॉर्मेट में सेव करेंगे।
src/train.py:
# src/train.py

import os
import pickle

import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from sklearn.compose import ColumnTransformer
from sklearn.ensemble import RandomForestClassifier
from sklearn.impute import SimpleImputer
from sklearn.metrics import (
    accuracy_score,
    classification_report,
    confusion_matrix,
    roc_auc_score,
)
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder


def load_data():
    data_path = "data/train.csv"
    df = pd.read_csv(data_path,low_memory=False)
    print("Data loaded successfully!")
    return df


def preprocess_data(df):
    # Drop unnecessary columns
    df = df.drop(columns=["ID", "Customer_ID", "SSN", "Name", "Month"])

    # Drop rows with missing values
    df = df.dropna()

    # Convert data types
    # Convert the 'Age' column to numeric, setting errors='coerce' to handle non-numeric values
    df["Age"] = pd.to_numeric(df["Age"], errors="coerce")

    # Filter the DataFrame to include only rows where 'Age' is between 1 and 60
    df = df[(df["Age"] >= 1) & (df["Age"] <= 60)]

    df["Annual_Income"] = pd.to_numeric(df["Annual_Income"], errors="coerce")
    df["Monthly_Inhand_Salary"] = pd.to_numeric(
        df["Monthly_Inhand_Salary"], errors="coerce"
    )

    # Separate features and target
    X = df.drop("Credit_Score", axis=1)
    y = df["Credit_Score"]

    print("Data preprocessed successfully!")
    return X, y


def encode_data(X):
    # Identify categorical and numerical features
    categorical_features = [
        "Occupation",
        "Credit_Mix",
        "Payment_of_Min_Amount",
        "Payment_Behaviour",
        "Type_of_Loan",
    ]
    numerical_features = X.select_dtypes(include=["int64", "float64"]).columns.tolist()

    # Define preprocessing steps
    numerical_transformer = SimpleImputer(strategy="median")

    categorical_transformer = Pipeline(
        steps=[
            ("imputer", SimpleImputer(strategy="most_frequent")),
            ("onehot", OneHotEncoder(handle_unknown="ignore")),
        ]
    )

    preprocessor = ColumnTransformer(
        transformers=[
            ("num", numerical_transformer, numerical_features),
            ("cat", categorical_transformer, categorical_features),
        ]
    )

    return preprocessor


def split_data(X, y):
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=42
    )
    return X_train, X_test, y_train, y_test


def train_model(X_train, y_train, preprocessor):
    # Create a pipeline with preprocessing and model
    clf = Pipeline(
        steps=[
            ("preprocessor", preprocessor),
            ("classifier", RandomForestClassifier(n_estimators=100)),
        ]
    )

    # Train the model
    clf.fit(X_train, y_train)

    # Return the trained model
    return clf


def evaluate_model(clf, X_test, y_test):
    # Predict and evaluate
    y_pred = clf.predict(X_test)
    acc = accuracy_score(y_test, y_pred)
    report = classification_report(y_test, y_pred, labels=["Poor", "Standard", "Good"])
    cm = confusion_matrix(y_test, y_pred, labels=["Poor", "Standard", "Good"])

    # Calculate AUC score
    y_test_encoded = y_test.replace({"Poor": 0, "Standard": 1, "Good": 2})
    y_pred_proba = clf.predict_proba(X_test)
    auc_score = roc_auc_score(y_test_encoded, y_pred_proba, multi_class="ovr")

    # Print metrics
    print("Model Evaluation Metrics:")
    print(f"Accuracy: {acc}")
    print(f"AUC Score: {auc_score}")
    print("Classification Report:")
    print(report)

    # Plot confusion matrix
    plt.figure(figsize=(8, 6))
    plt.imshow(cm, interpolation="nearest", cmap=plt.cm.Blues)
    plt.title("Confusion Matrix")
    plt.colorbar()
    tick_marks = np.arange(3)
    plt.xticks(tick_marks, ["Poor", "Standard", "Good"], rotation=45)
    plt.yticks(tick_marks, ["Poor", "Standard", "Good"])
    plt.ylabel("True label")
    plt.xlabel("Predicted label")
    plt.tight_layout()
    cm_path = os.path.join("model", "confusion_matrix.png")
    plt.savefig(cm_path)
    print(f"Confusion matrix saved to {cm_path}")


def save_model(clf):
    model_dir = "model"
    os.makedirs(model_dir, exist_ok=True)
    model_path = os.path.join(model_dir, "model.pkl")

    # Save the trained model
    with open(model_path, "wb") as f:
        pickle.dump(clf, f)
    print(f"Model saved to {model_path}")


def main():
    # Execute steps
    df = load_data()
    X, y = preprocess_data(df)
    preprocessor = encode_data(X)
    X_train, X_test, y_train, y_test = split_data(X, y)
    clf = train_model(X_train, y_train, preprocessor)
    evaluate_model(clf, X_test, y_test)
    save_model(clf)


if __name__ == "__main__":
    main()
मॉडल सर्विंग स्क्रिप्ट सेव किए गए मॉडल पाइपलाइन को मॉडल फ़ाइल से लोड करेगी, एक POST अनुरोध फ़ंक्शन बनाएगी जो उपयोगकर्ता से डिक्शनरियों की सूची लेता है, उसे DataFrame में बदलता है, मॉडल को भविष्यवाणी उत्पन्न करने के लिए देता है और फिर अनुमानित लेबल लौटाता है। हम अपने API फ़्रेमवर्क के रूप में FastAPI का उपयोग कर रहे हैं, जो कुछ ही पंक्तियों के कोड से मॉडल को सर्व करने की अनुमति देता है।
src/app.py:
# src/app.py

import pickle
from fastapi import FastAPI
from pydantic import BaseModel
import pandas as pd
import os

# Load the trained model
model_path = os.path.join("model", "model.pkl")
with open(model_path, "rb") as f:
    model = pickle.load(f)

app = FastAPI()


class InputData(BaseModel):
    data: list  # List of dictionaries representing feature values


@app.post("/predict")
def predict(input_data: InputData):
    # Convert input data to DataFrame
    X_new = pd.DataFrame(input_data.data)
    # Ensure the columns match the training data
    prediction = model.predict(X_new)
    # Return predictions
    return {"prediction": prediction.tolist()}
हमें एक requirements.txt फ़ाइल बनानी है जिसमें ऊपर बताई गई स्क्रिप्ट्स चलाने के लिए आवश्यक सभी Python पैकेज शामिल हों। यह फ़ाइल Docker कंटेनर में रनिंग एन्वायरनमेंट सेट करने के लिए उपयोग होगी, ताकि हम Python स्क्रिप्ट्स को सुचारू रूप से चला सकें।
requirements.txt:
fastapi
uvicorn[standard]
numpy
pandas
scikit-learn
pydantic
matplotlibएक “Dockerfile” बनाएँ और निम्न कोड जोड़ें।
यह Dockerfile जिन चरणों को निष्पादित करता है, वे हैं:
# Dockerfile

FROM python:3.9-slim

WORKDIR /app

# Install dependencies
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

# Copy the application code
COPY ./src/ ./src/
COPY ./data/ ./data/

# Ensure the model directory exists and is copied
RUN mkdir -p model

# Run the training script during the build
RUN python src/train.py

# Expose the port for the API
EXPOSE 8000


# Run the FastAPI app
CMD ["uvicorn", "src.app:app", "--host", "0.0.0.0", "--port", "8000"]
आपका स्थानीय वर्कस्पेस इस प्रकार व्यवस्थित होना चाहिए:
data फ़ोल्डरmodels फ़ोल्डरsrc फ़ोल्डरrequirements.txt फ़ाइल और एक Dockerfile शामिल करेंशेष फाइलें ऑटोमेशन और Git ऑपरेशंस के लिए अतिरिक्त घटक हैं।
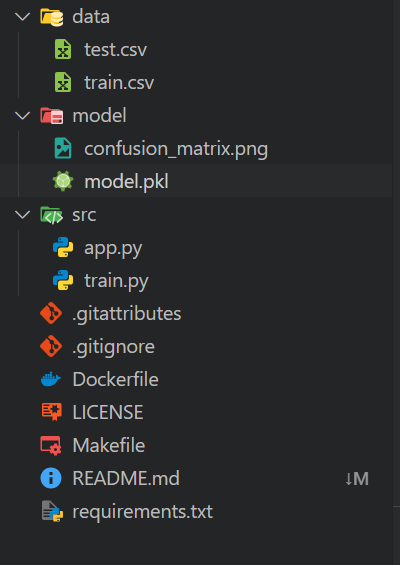
Docker इमेज बनाना सरल है: बस build कमांड को अपनी Docker इमेज का नाम और वह वर्तमान डायरेक्टरी दें जहाँ Dockerfile स्थित है।
$ podman build -t mlops_app .बिल्ड टूल Dockerfile में सभी कमांड्स को क्रमवार निष्पादित करेगा—एन्वायरनमेंट सेट करने से लेकर मशीन लर्निंग एप्लिकेशन को सर्व करने तक।
हम यह भी देख सकते हैं कि लॉग्स में मॉडल मूल्यांकन के परिणाम शामिल हैं। मॉडल की सटीकता 75% और ROC AUC स्कोर 0.89 है, जिसे औसत माना जा सकता है।
STEP 1/11: FROM python:3.9-slim
STEP 2/11: WORKDIR /app
--> Using cache 72ac9e49ae29da1ff19e118653efca17e7a489ae9e7ead917c83d942a3ea4e13
--> 72ac9e49ae29
STEP 3/11: COPY requirements.txt .
--> Using cache 3a05ca95caaf98c448c53a796714328bf9f7cff7896cce348f84a26b8d0dae61
--> 3a05ca95caaf
STEP 4/11: RUN pip install --no-cache-dir -r requirements.txt
--> Using cache 28109d1183449396a5df0006ab603dd5cf2aa2c06a810bdc6bcf0f843f855ee0
--> 28109d118344
STEP 5/11: COPY ./src/ ./src/
--> f814f699c58a
STEP 6/11: COPY ./data/ ./data/
--> 922550900cd0
STEP 7/11: RUN mkdir -p model
--> 36fc01f2d169
STEP 8/11: RUN python src/train.py
Data loaded successfully!
Data preprocessed successfully!
Data encoded successfully!
Data split successfully!
Model trained successfully!
Model Evaluation Metrics:
Accuracy: 0.7546181417149159
ROC AUC Score: 0.8897184704689612
Classification Report:
              precision    recall  f1-score   support

        Good       0.71      0.67      0.69      1769
        Poor       0.75      0.76      0.75      3403
    Standard       0.77      0.78      0.78      5709

    accuracy                           0.75     10881
   macro avg       0.74      0.74      0.74     10881
weighted avg       0.75      0.75      0.75     10881

Model saved to model/model.pkl
--> 5d4777c08580
STEP 9/11: EXPOSE 8000
--> 7bb09a613e7f
STEP 10/11: WORKDIR /app/src
--> 06b6394c2e2d
STEP 11/11: CMD ["uvicorn", "app:app", "--host", "0.0.0.0", "--port", "8000"]
COMMIT mlops-app
--> 9a7a42b03664
Successfully tagged localhost/mlops-app:latest
9a7a42b03664f1e4631330cd682cb2de26e513c5d776fa2ce2042b3bb9455e14
यदि आप Podman Desktop एप्लिकेशन खोलते हैं और “Images” टैब पर क्लिक करते हैं, तो आप देखेंगे कि आपकी mlops_app इमेज सफलतापूर्वक बनाई गई है।
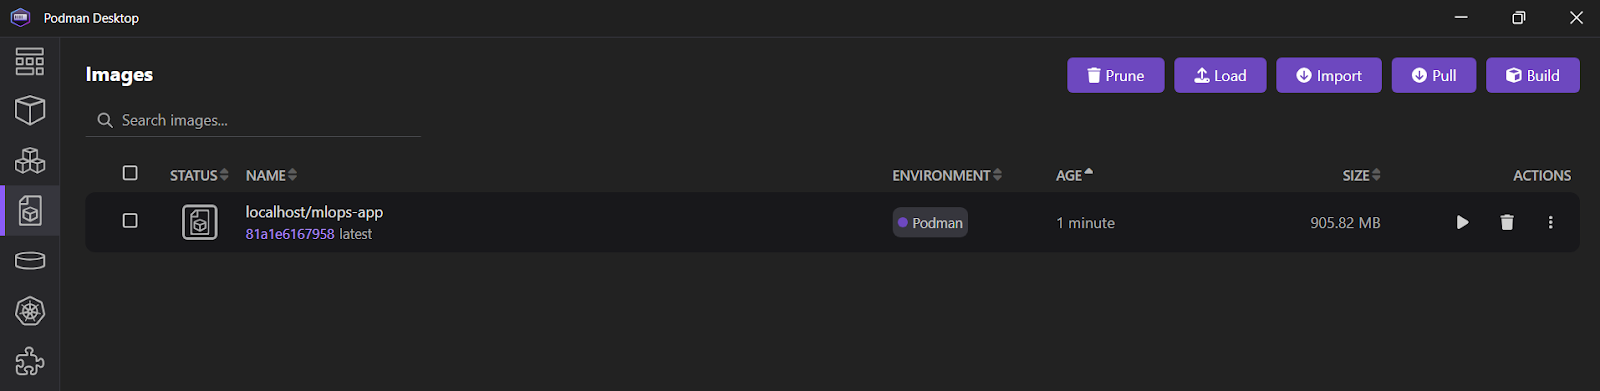
सभी प्रासंगिक Docker कमांड्स सीखने के लिए डेटा साइंस के लिए Docker चीट शीट देखें। बस पहले कमांड, docker, को podman से बदल दें।
हम run कमांड का उपयोग करके mlops-app इमेज से "mlops_container" नामक कंटेनर शुरू करेंगे। यह डिटैच्ड मोड (-d) में किया जाएगा, जिसमें कंटेनर के 8000 पोर्ट को होस्ट मशीन के 8000 पोर्ट से मैप किया जाएगा। यह सेटअप कंटेनर के बाहर से FastAPI एप्लिकेशन तक पहुँच की अनुमति देगा।
$ podman run -d --name mlops_container -p 8000:8000 mlops-app "mlops_container" के सभी लॉग्स देखने के लिए, logs कमांड का उपयोग करें।
$ podman logs -f mlops_container आउटपुट:
INFO:     Started server process [1]
INFO:     Waiting for application startup.
INFO:     Application startup complete.
INFO:     Uvicorn running on http://0.0.0.0:8000 (Press CTRL+C to quit)
INFO:     10.88.0.1:36886 - "POST /predict HTTP/1.1" 200 OK
आप Podman Desktop एप्लिकेशन खोलकर “Containers” टैब पर क्लिक करके चल रहे कंटेनरों को भी देख सकते हैं।
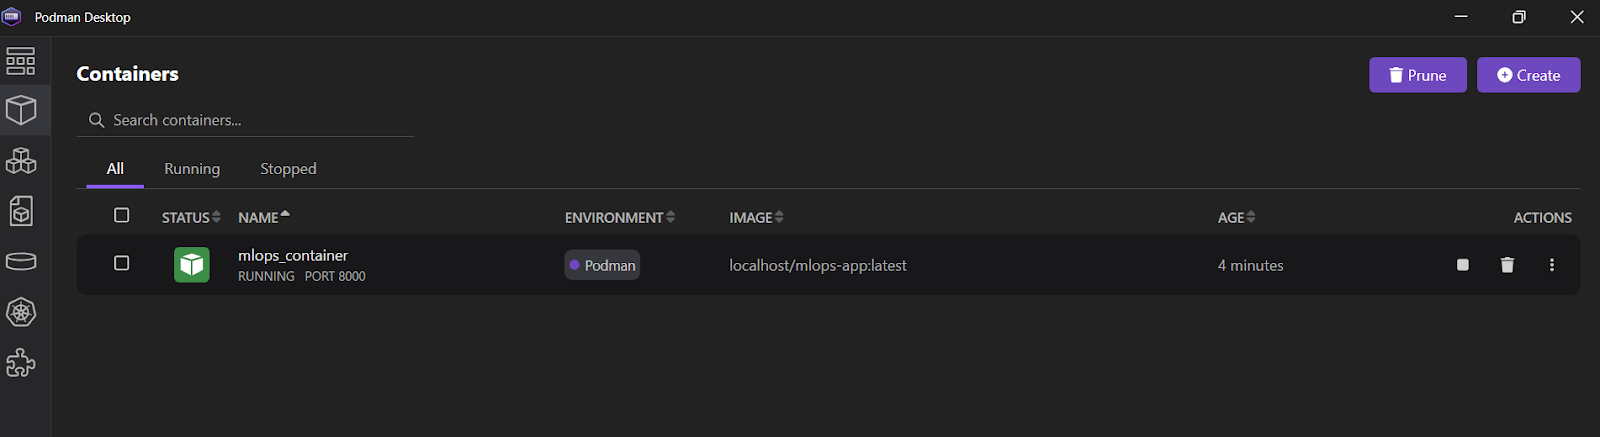
Podman Desktop एप्लिकेशन में लॉग्स देखने के लिए, “mlops_container” पर क्लिक करें और फिर “Terminal” टैब चुनें।
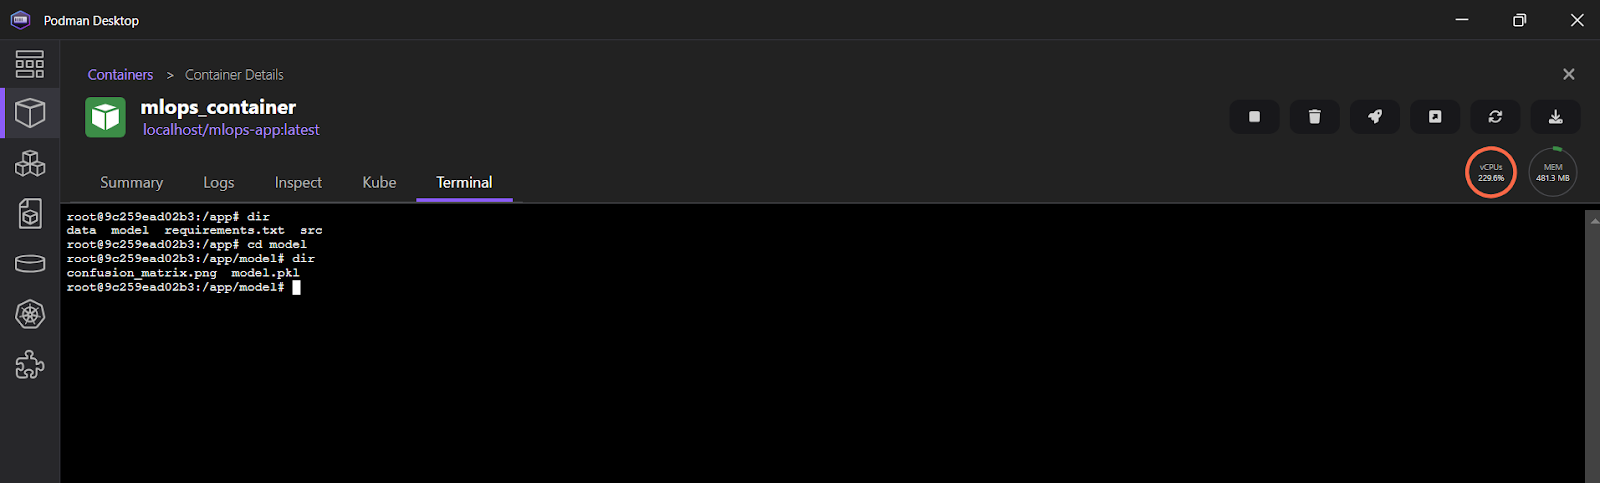
हम अब http://localhost:8000/docs पर इंटरैक्टिव Swagger UI पर जाकर परिनियोजित एप्लिकेशन का परीक्षण करेंगे। Swagger UI एक उपयोगकर्ता-अनुकूल इंटरफ़ेस प्रदान करता है जो आपको सभी उपलब्ध API एंडपॉइंट्स को एक्सप्लोर करने देता है।
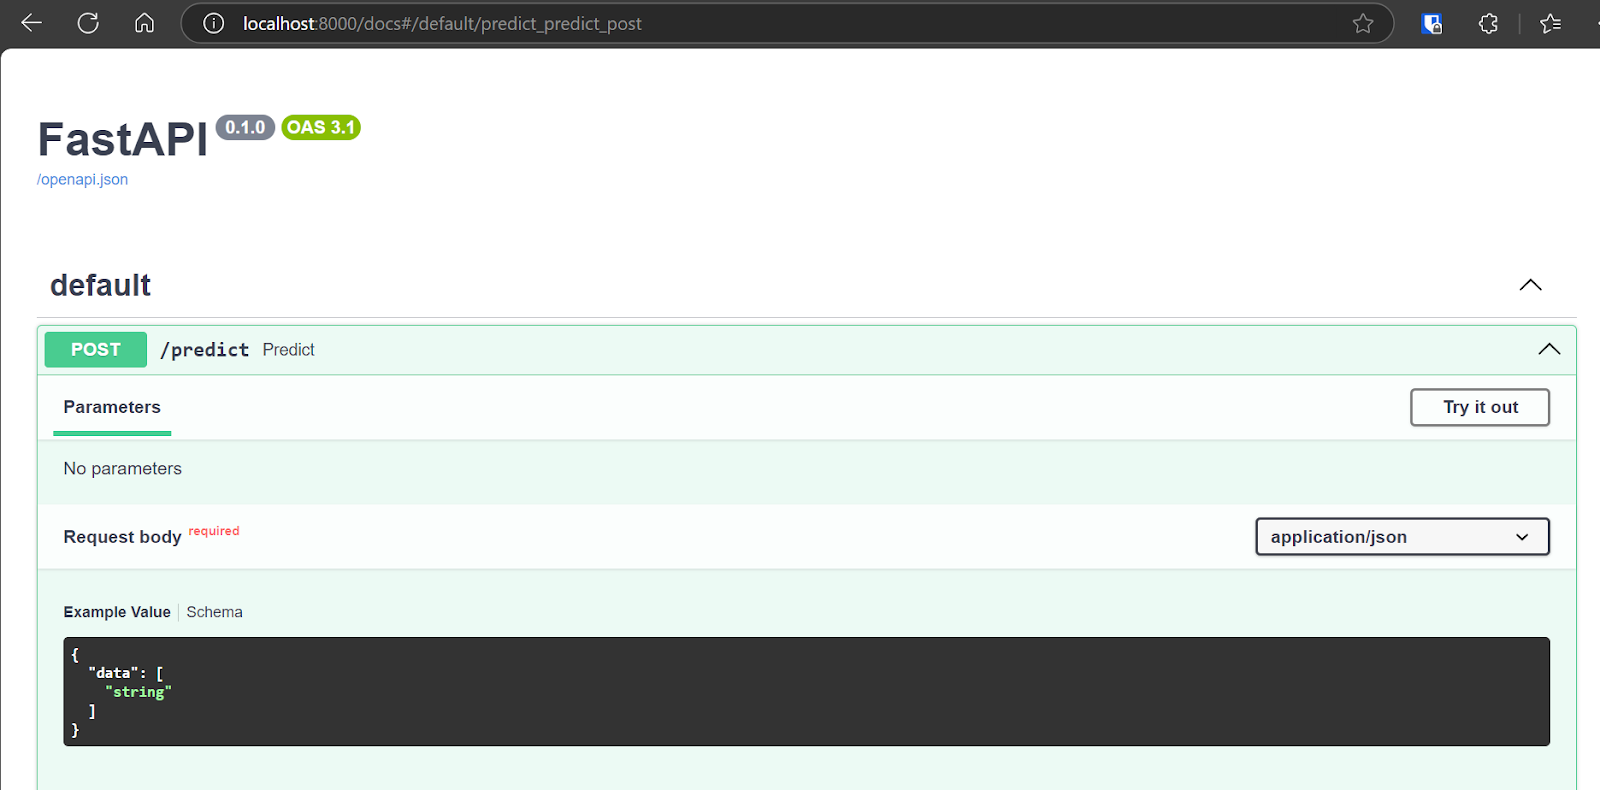
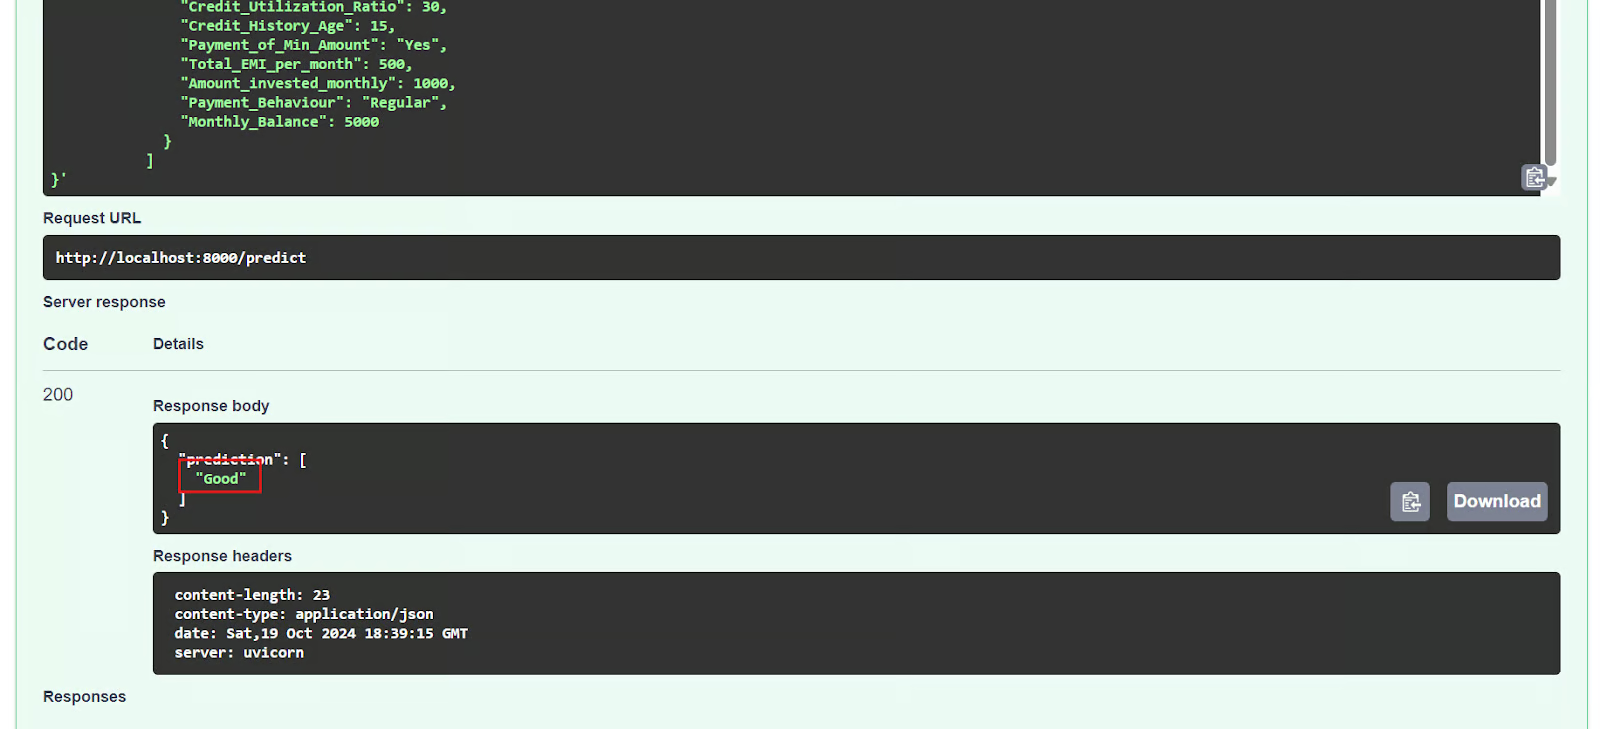
हम टर्मिनल में CURL कमांड का उपयोग करके भी API का परीक्षण कर सकते हैं।
$ curl -X POST "http://localhost:8000/predict" \
     -H "Content-Type: application/json" \
     -d '{
           "data": [
             {
               "Age": 35,
               "Occupation": "Engineer",
               "Annual_Income": 85000,
               "Monthly_Inhand_Salary": 7000,
               "Num_Bank_Accounts": 2,
               "Num_Credit_Card": 3,
               "Interest_Rate": 5,
               "Num_of_Loan": 1,
               "Type_of_Loan": "Personal Loan",
               "Delay_from_due_date": 2,
               "Num_of_Delayed_Payment": 1,
               "Changed_Credit_Limit": 15000,
               "Num_Credit_Inquiries": 2,
               "Credit_Mix": "Good",
               "Outstanding_Debt": 10000,
               "Credit_Utilization_Ratio": 30,
               "Credit_History_Age": 15,
               "Payment_of_Min_Amount": "Yes",
               "Total_EMI_per_month": 500,
               "Amount_invested_monthly": 1000,
               "Payment_Behaviour": "Regular",
               "Monthly_Balance": 5000
             }
           ]
         }'
FastAPI सर्वर सही ढंग से काम कर रहा है, उपयोगकर्ता इनपुट को सफलतापूर्वक प्रोसेस कर रहा है और सटीक भविष्यवाणी लौटा रहा है।
{"prediction":["Good"]}API के साथ प्रयोग करने के बाद, हम stop कमांड का उपयोग करके कंटेनर को रोकेंगे।
$ podman stop mlops_container इसके अलावा, हम rm कमांड का उपयोग करके कंटेनर को हटा सकते हैं, जिससे सिस्टम संसाधन मुक्त हो जाते हैं। कंटेनर को हटाने से पहले उसे रोकना आवश्यक है।
$ podman rm mlops_container "mlops-app" नामक स्थानीय रूप से संग्रहीत कंटेनर इमेज को हटाने के लिए हम rmi कमांड का उपयोग करेंगे।
$ podman rmi mlops-app यदि आपको ऊपर दिया गया कोड चलाने या अपना Docker फ़ाइल बनाने में समस्या आ रही है, तो GitHub रिपॉजिटरी kingabzpro/mlops-with-podman देखें। इसमें उपयोग गाइड और सभी आवश्यक फ़ाइलें शामिल हैं, जिनकी मदद से आप अपने सिस्टम पर कोड चला सकते हैं।
आपकी सीखने की अगली कड़ी यह है कि आप Podman के साथ 10 Docker प्रोजेक्ट आइडियाज़, जो शुरुआती से उन्नत स्तर तक हैं, बनाने की कोशिश करें। इससे आपको Podman इकोसिस्टम की बेहतर समझ हासिल होगी।
Podman कुछ उपयोग मामलों के लिए Docker का एक प्रभावशाली विकल्प प्रदान करता है, फिर भी कई डेवलपर Docker Desktop और CLI को प्राथमिकता देते रहते हैं। यह प्राथमिकता मुख्य रूप से Docker के व्यापक इंटीग्रेशन और उपयोगकर्ता-अनुकूल टूल्स के कारण है।
हालाँकि, एक सीधे-सादे MLOps प्रोजेक्ट के लिए, इंजीनियर Podman को चुन सकते हैं, जो Docker Desktop की तुलना में हल्का और आसान सेटअप प्रदान करता है।
इस ट्यूटोरियल में, हमने Podman—एक लोकप्रिय कंटेनर मैनेजमेंट टूल—की पड़ताल की, उसे Docker से तुलना की और Podman Desktop कैसे इंस्टॉल करें, यह दिखाया। हमने Podman का उपयोग करते हुए एक MLOps प्रोजेक्ट में आपका मार्गदर्शन भी किया, जिसमें Dockerfile बनाना, इमेज बनाना और कंटेनर चलाना शामिल है। Podman के साथ शुरुआत करना सीधा-सादा है, और यदि आप पहले से Docker से परिचित हैं, तो आपको यह संक्रमण सहज लगेगा।
आधुनिक MLOps फ़्रेमवर्क, तथा मशीन लर्निंग मॉडलों के लाइफसाइकल और परिनियोजन की खोज के लिए MLOps Deployment and LifeCycling कोर्स करें।
शीर्ष DataCamp पाठ्यक्रम
कोर्स
कोर्स
लर्निंग पाथ