
{count, plural, one {Khóa học} other {Khóa học}}
Các khái niệm về Large Language Models (LLMs)
{hours} giờ
112.3K
Cơ chế attention nằm ở trung tâm của các mô hình transformer. Mọi kiến trúc phổ biến như GPT, LLaMA và Mixture of Experts (MoE) đều dựa vào nó để kết nối các token và kiến tạo ý nghĩa.
Nhưng attention thì tốn kém. Việc tính toán gồm các phép nhân ma trận lớn và quan trọng hơn là khối lượng di chuyển dữ liệu khổng lồ giữa bộ nhớ GPU và các đơn vị tính toán. Khi độ dài chuỗi tăng, băng thông bộ nhớ trở thành nút thắt chính.
Do đó, tối ưu attention mang lại tác động lớn đến hiệu năng LLM, và đó chính là lúc Flash Attention xuất hiện. Trong bài viết này, tôi sẽ hướng dẫn bạn Flash Attention là gì, cách nó hoạt động và cách dùng nó với PyTorch và Hugging Face Transformers.
Nếu bạn đang tìm cách bắt đầu với LLM, tôi khuyến nghị khóa học nhập môn của chúng tôi về các khái niệm LLM.
Flash Attention là cơ chế attention đã được tối ưu cho transformer, giúp tăng tốc độ và hiệu quả bộ nhớ đáng kể trên GPU.
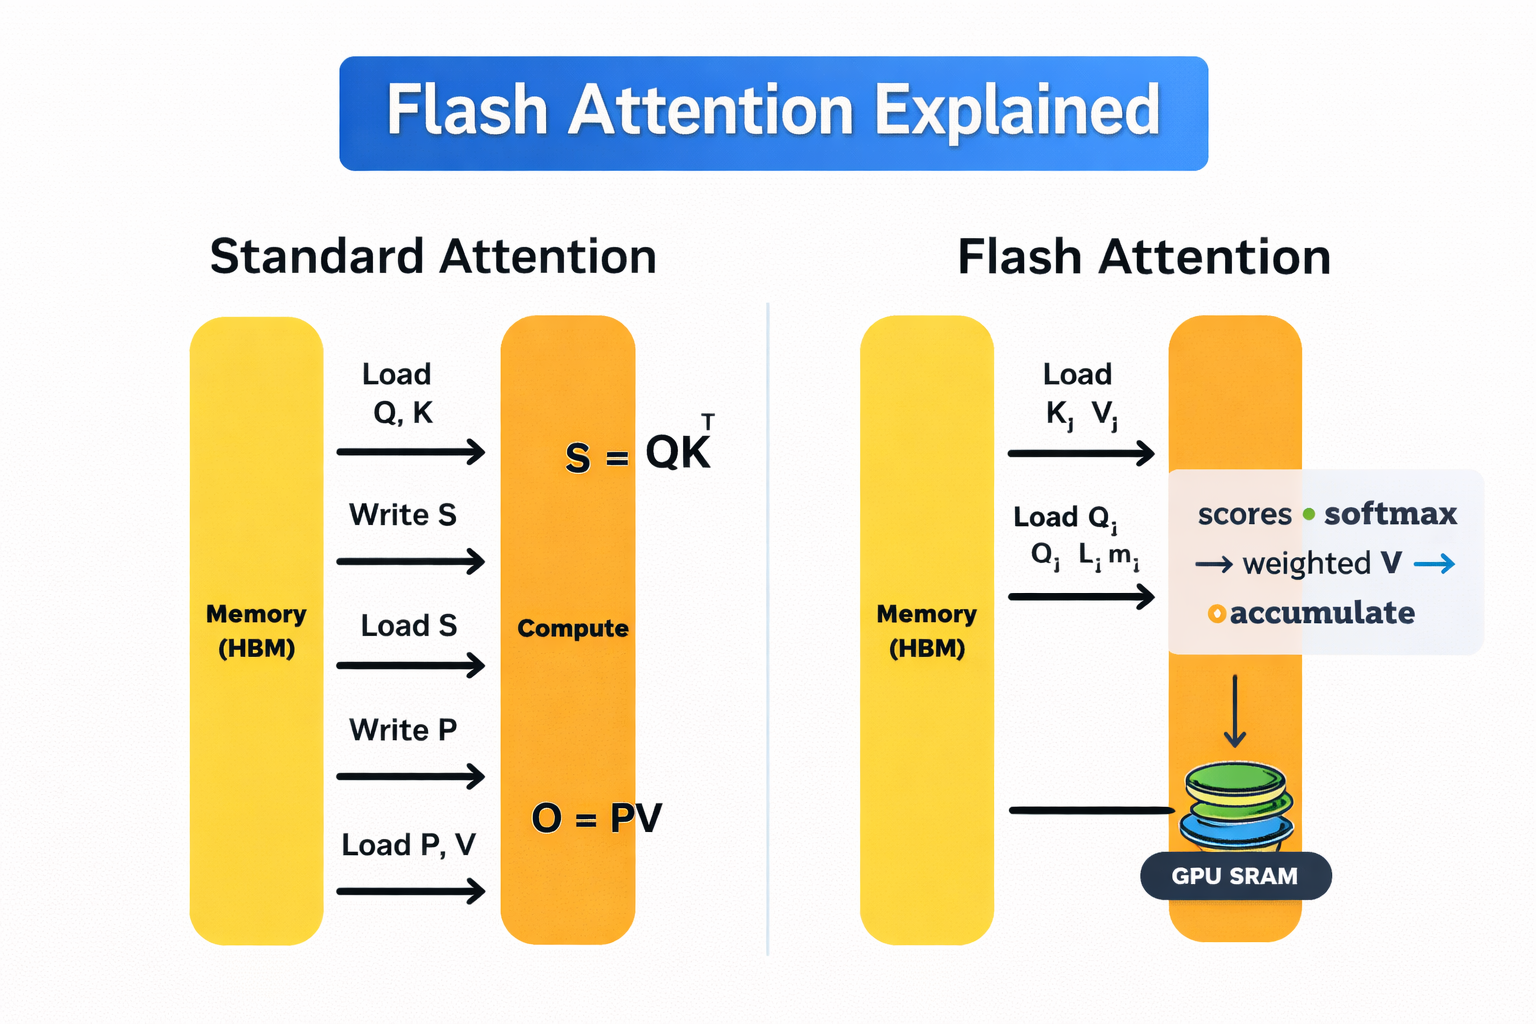
Attention tiêu chuẩn so với Flash Attention
GPU có hai loại bộ nhớ chính. Bộ nhớ băng thông cao (HBM) có dung lượng lớn nhưng tương đối chậm. SRAM trên chip cực nhanh nhưng dung lượng rất hạn chế.
Cơ chế self-attention tiêu chuẩn liên tục chuyển dữ liệu giữa hai loại này. Việc qua lại đó rất tốn kém và trở thành chi phí đáng kể khi độ dài chuỗi tăng.
Flash Attention tránh điều này bằng cách tính attention theo các ô nhỏ (tile) vừa vặn hoàn toàn trong SRAM nhanh. Mỗi tile được xử lý từ đầu đến cuối, với softmax được áp dụng dần dần, nên không cần ghi các kết quả trung gian về HBM. Do đó, ma trận attention đầy đủ không bao giờ được lưu trữ trong bộ nhớ.
Không giống các phương pháp attention thưa (sparse) hoặc tuyến tính, Flash Attention không phải là xấp xỉ. Nó cho ra kết quả toán học chính xác như self-attention tiêu chuẩn, chỉ là được thực thi theo cách tiết kiệm bộ nhớ hơn.
Flash Attention đạt được hiệu quả bằng cách thiết kế lại cách tính attention trên GPU. Cơ chế rất đơn giản: làm càng nhiều việc càng tốt trong bộ nhớ trên chip nhanh và tránh di chuyển không cần thiết tới bộ nhớ chậm.
Một cách ví von hữu ích là căn bếp. SRAM trên chip của GPU giống như mặt bàn bếp nhỏ, nhanh — nơi bạn thực sự sơ chế và nấu nướng. Bộ nhớ HBM của GPU giống như cửa hàng tạp hóa lớn ở cuối phố. Nó chứa mọi thứ bạn cần, nhưng việc đi đi về về tốn thời gian.
Nói đơn giản, attention tiêu chuẩn cứ chạy ra cửa hàng sau mỗi bước. Ngược lại, Flash Attention lên kế hoạch nấu nướng sao cho mọi thứ vừa trên mặt bàn khi bạn nấu. Hãy tìm hiểu chi tiết hơn:
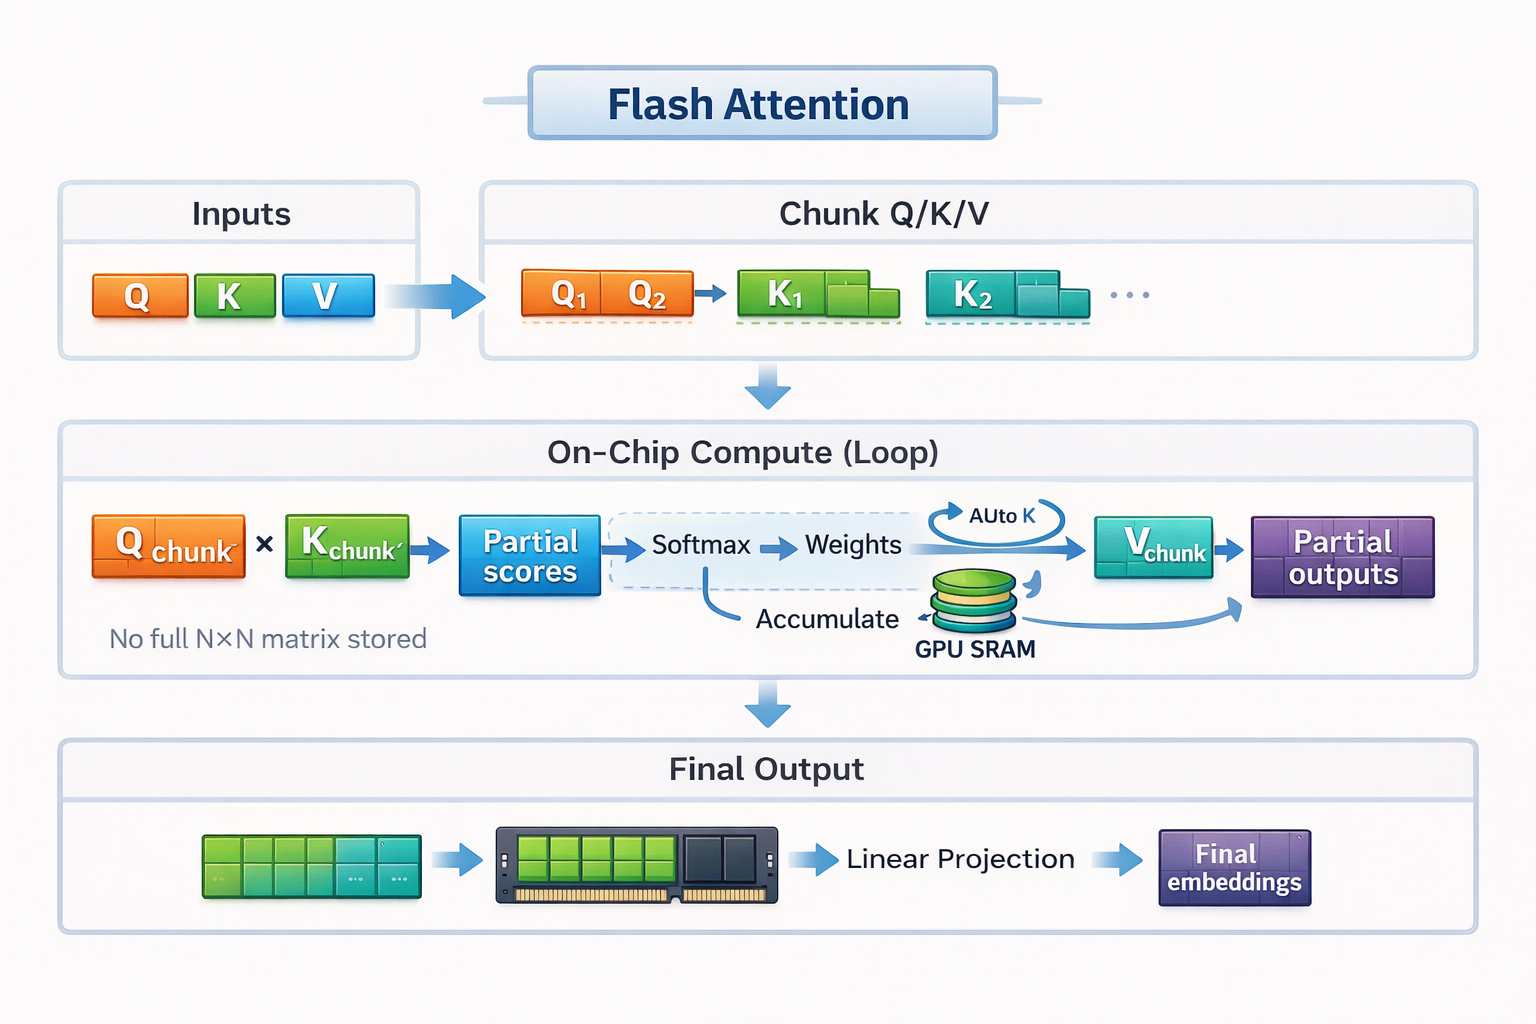
Cơ chế hoạt động của Flash Attention
Flash Attention dựa trên hai ý tưởng chủ chốt: tiling và tính toán lại (recomputation).
Tiếp tục ví dụ nấu ăn, tiling là cách Flash Attention đưa tính toán attention vừa với mặt bàn nhỏ.
Thay vì tải toàn bộ chuỗi và xây dựng một ma trận attention đầy đủ, Flash Attention chia đầu vào thành các khối nhỏ, hay tile. Mỗi tile vừa hoàn toàn trong SRAM nhanh của GPU. Flash Attention tính attention từng tile một, từ đầu đến cuối, rồi mới chuyển sang tile tiếp theo.
Trong ví dụ nhà bếp, bạn không thể đặt nguyên liệu cho cả một bữa tiệc lên mặt bàn nhỏ. Vậy nên bạn sơ chế và nấu theo mẻ. Bạn thái vài loại rau, nấu, dọn chỗ, rồi chuyển sang mẻ tiếp theo. Làm như vậy giúp bạn tránh việc phải chạy ra cửa hàng liên tục.
Cách thực thi theo từng khối cho phép Flash Attention giữ dữ liệu cục bộ, nhanh và hiệu quả, mà không bao giờ phải vật chất hóa toàn bộ ma trận attention trong bộ nhớ chậm.
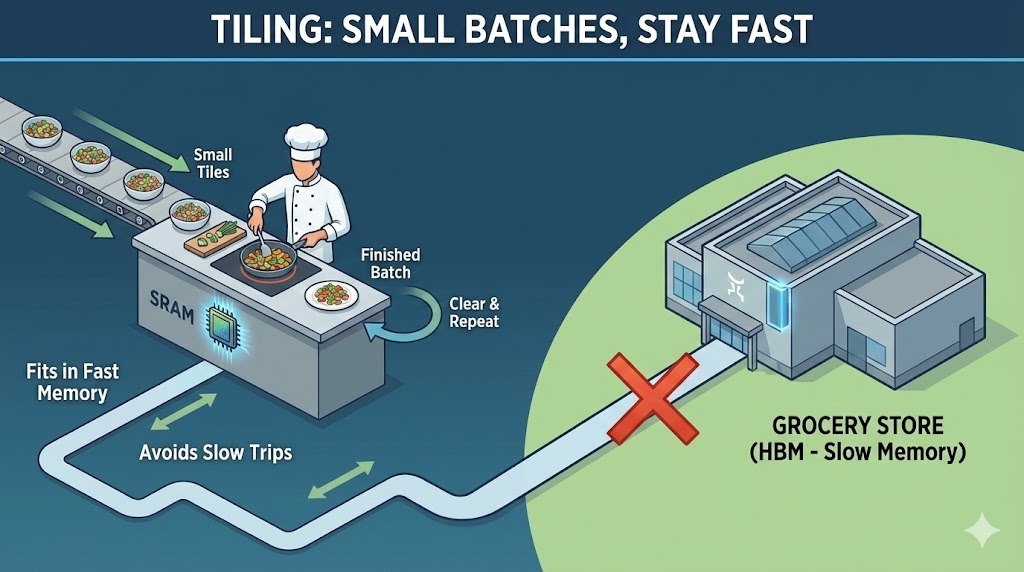
Tiling trong Flash Attention
Trong huấn luyện, attention tiêu chuẩn lưu trữ nhiều kết quả trung gian để dùng lại trong lan truyền ngược. Việc lưu trữ đó tiêu tốn bộ nhớ lớn. Flash Attention chọn cách khác. Thay vì lưu trữ các trung gian này, nó tính lại các phần nhỏ của điểm attention khi cần.
Quay lại căn bếp, giống như băm hành. Bạn có thể đi đến cửa hàng để gửi hành đã băm rồi quay lại lấy sau. Hoặc bạn có thể bỏ đi và chỉ cần băm lại củ hành mới khi đến lúc nấu. Ngạc nhiên là phương án thứ hai nhanh hơn vì tránh được việc di chuyển thường xuyên/dài hơn.
Trên các GPU hiện đại, tính toán lại theo logic tương tự vì phép tính thêm là rẻ so với di chuyển bộ nhớ. Bằng cách tính lại các giá trị nhỏ thay vì lưu và tải chúng, Flash Attention giảm đáng kể lưu lượng bộ nhớ trong khi vẫn giữ hiệu quả huấn luyện.
Kết hợp lại, tiling và tính toán lại cho phép Flash Attention giữ việc tính attention trên “mặt bàn”, giảm tối thiểu những chuyến đi đến “cửa hàng”, và khai thác tối đa điểm mạnh của phần cứng GPU hiện đại.
Flash Attention 2 (FA2), ra mắt năm 2023, là bản nâng cấp lớn so với thế hệ đầu. Nó giữ nguyên ý tưởng cốt lõi về attention chính xác và nhận thức IO, nhưng cải thiện hiệu quả trên nhiều khía cạnh quan trọng trong tải công việc thực tế.
Phiên bản đầu của Flash Attention song song hóa tính toán theo kích thước batch và số head attention. Cách này hiệu quả cho huấn luyện với batch lớn, nhưng kém lý tưởng cho suy luận, nơi batch thường nhỏ và chuỗi dài.
FA2 bổ sung song song theo chính chiều dài chuỗi. Điều này cho phép nhiều phần của tính toán attention chạy đồng thời ngay cả khi batch nhỏ. Bằng cách phân bổ công việc qua các token trong chuỗi, v2 giúp nhiều đơn vị tính toán của GPU hoạt động đồng thời hơn.
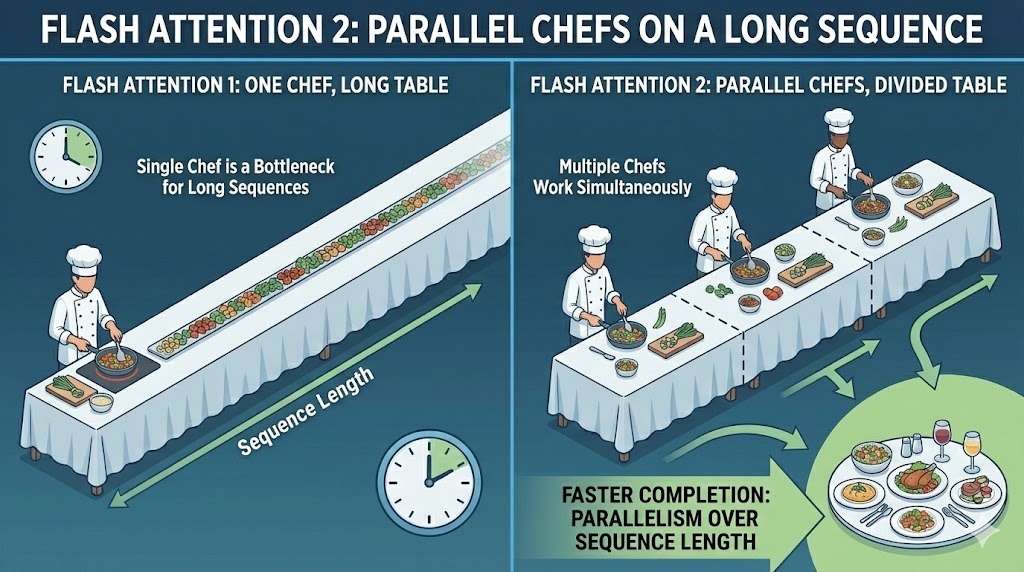
Song song theo lô trong Flash Attention 2
Lợi ích thực tế là thông lượng cao hơn và tận dụng phần cứng tốt hơn trong các kịch bản suy luận phổ biến, nơi prompt dài và batch nhỏ là chuẩn mực.
GPU cực kỳ giỏi nhân ma trận. Phần cứng chuyên dụng gọi là Tensor Cores có thể thực thi các phép nhân ma trận tổng quát (GEMM) với tốc độ rất cao.
Vấn đề là attention không chỉ có nhân ma trận: nó còn gồm các phép như scaling, masking và softmax, chạy trên các lõi GPU tiêu chuẩn và chậm hơn nhiều so với GEMM.
FA2 giảm sự mất cân đối này. Nó tái cấu trúc tính toán để tối thiểu hóa các phép dấu chấm động không phải ma trận, đặc biệt là những phép liên quan đến chuẩn hóa lại điểm attention. Phần lớn thời gian chạy được dành cho các phép nhân ma trận lớn, hiệu quả mà Tensor Cores có thể tăng tốc.
Flash Attention v1 được tối ưu quanh kích thước head 64 hoặc 128, phù hợp các mô hình như BERT và GPT-3. Khi kiến trúc mô hình tiến hóa, kích thước head tăng để hỗ trợ embedding lớn hơn và năng lực mô hình cao hơn.
FA2 mở rộng hỗ trợ tới kích thước head 256. Điều này giúp nó tương thích với các kiến trúc mới dựa vào head attention rộng hơn.
Flash Attention 3 (FA3) là tiêu chuẩn ngành hiện tại, cung cấp sức mạnh cho các mô hình tối tân như GPT-5.2. Nó xây trên nền tảng attention chính xác, nhận thức IO như các phiên bản trước, nhưng được kiến trúc riêng cho GPU NVIDIA H100 (Hopper).
Sự thay đổi then chốt là FA3 được thiết kế để tận dụng các tính năng phần cứng bất đồng bộ mới của Hopper, cho phép chồng lấp việc di chuyển bộ nhớ và tính toán mạnh mẽ hơn nhiều so với trước đây.
Ở các phiên bản trước, mọi luồng GPU (warp) theo cùng đường thực thi. FA3 thay đổi mô hình này thông qua chuyên môn hóa warp. Nó gán một trong hai vai trò riêng cho mỗi warp:
Sự tách biệt này cho phép truyền dữ liệu và tính toán diễn ra đồng thời. Trong khi warp producer nạp các tile dữ liệu kế tiếp, warp consumer bận rộn tính toán trên các tile hiện tại, cải thiện đáng kể độ trễ
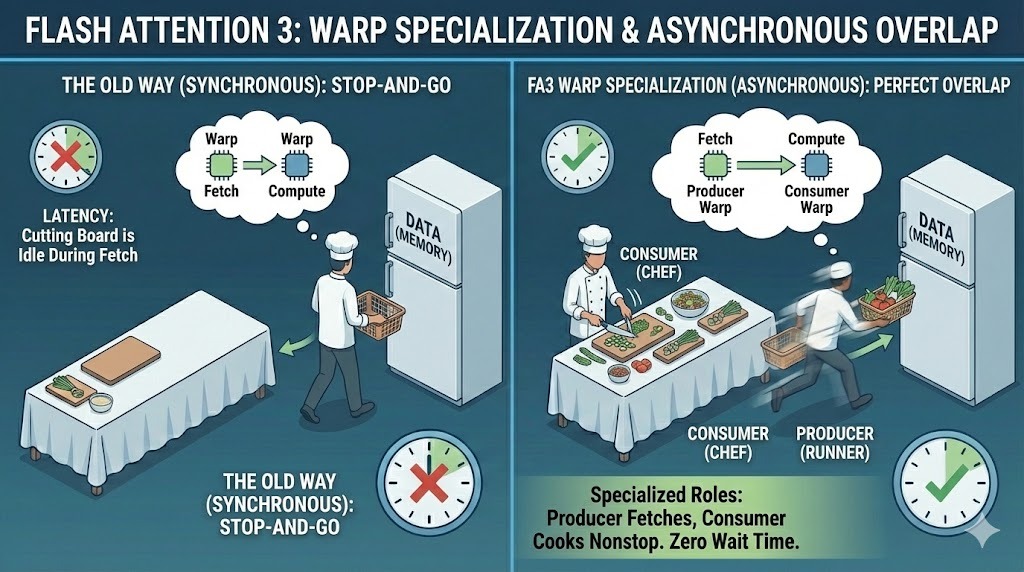
Chuyên môn hóa warp trong Flash Attention 3
Flash Attention 3 cũng giới thiệu hỗ trợ gốc cho FP8, tức độ chính xác dấu chấm động 8-bit. Các phiên bản trước chủ yếu dựa vào FP16 hoặc BF16, vốn đã giảm sử dụng bộ nhớ so với FP32 nhưng vẫn tiêu tốn băng thông đáng kể.
FP8 tiếp tục cắt giảm khoảng một nửa dấu chân bộ nhớ. Sự giảm này chuyển hóa trực tiếp thành thông lượng cao hơn và áp lực bộ nhớ thấp hơn. Trên GPU Hopper, FP8 được tăng tốc bằng phần cứng, nghĩa là FA3 có thể xử lý nhiều phép attention mỗi giây hơn mà không đánh đổi độ chính xác ở cấp độ mô hình.
Khả năng này là một lý do lớn khiến các mô hình như Gemini 3 có thể xử lý cửa sổ ngữ cảnh khổng lồ trong khi vẫn phục vụ hiệu quả cho hàng triệu người dùng.
Mảnh ghép cuối của thiết kế FA3 là việc sử dụng Tensor Memory Accelerator (TMA) của H100. TMA là phần cứng chuyên dụng xử lý sao chép bộ nhớ một cách bất đồng bộ, không chiếm dụng các lõi tính toán chính.
Flash Attention 3 dùng TMA để di chuyển các tile dữ liệu ở chế độ nền trong khi tính toán vẫn tiếp tục không gián đoạn. Bằng cách chặt chẽ chồng lấp di chuyển bộ nhớ với tính toán, FA3 có thể khai thác gần 75% hiệu năng lý thuyết tối đa của phần cứng.
Flash Attention 4 (FA4) đại diện cho bước thử nghiệm tiếp theo trong tối ưu attention. Nó được thiết kế cho GPU Blackwell B200 sắp ra mắt của NVIDIA và khám phá những gì có thể khi các kernel attention được xây dựng cho một lớp phần cứng hoàn toàn mới.
Khi kích thước mô hình tiếp tục tăng và các lần huấn luyện tiến tới quy mô nghìn tỷ tham số, ngay cả Flash Attention 3 rồi cũng sẽ chạm trần. FA4 là nỗ lực sớm nhằm gỡ bỏ các giới hạn đó bằng cách đẩy mức độ tận dụng phần cứng vượt xa mọi kernel attention trước đây.
Ở giai đoạn này, Flash Attention 4 vẫn là công nghệ nghiên cứu và tiền sản xuất. Nó cho thấy nhiều hứa hẹn, nhưng chưa được dùng trong các mô hình triển khai hoặc cấp độ sản xuất.
Một cột mốc lớn của Flash Attention 4 là hiệu năng. Đây là kernel attention đầu tiên được thiết kế để vượt 1 PFLOPS, tức một triệu tỷ phép toán dấu chấm động mỗi giây, trên một GPU đơn lẻ.
Nó nhắm tới tương lai nơi việc huấn luyện các mô hình nghìn tỷ tham số sẽ mất lượng thời gian phi thực tế để hoàn thành. Ở quy mô đó, những kém hiệu quả nhỏ cũng tích lũy thành độ trễ khổng lồ. FA4 hướng tới biến các lần huấn luyện tương lai ấy thành khả thi bằng cách khai thác hiệu năng cực hạn từ một con chip.
Để đạt hiệu năng đó, FA4 đẩy bất đồng bộ xa hơn nhiều so với các phiên bản trước. Nó mở rộng mô hình producer–consumer thành các đường ống nhiều giai đoạn rất phức tạp, nơi di chuyển dữ liệu, tính toán và đồng bộ đều vận hành độc lập.
Thay vì chồng lấp tương đối đơn giản giữa nạp và tính, FA4 quản lý thực thi bất đồng bộ sâu qua nhiều giai đoạn. Các phần khác nhau của kernel tiến triển ở tốc độ khác nhau, được điều phối bởi lập lịch ở cấp độ phần cứng chứ không theo một luồng đồng bộ duy nhất.
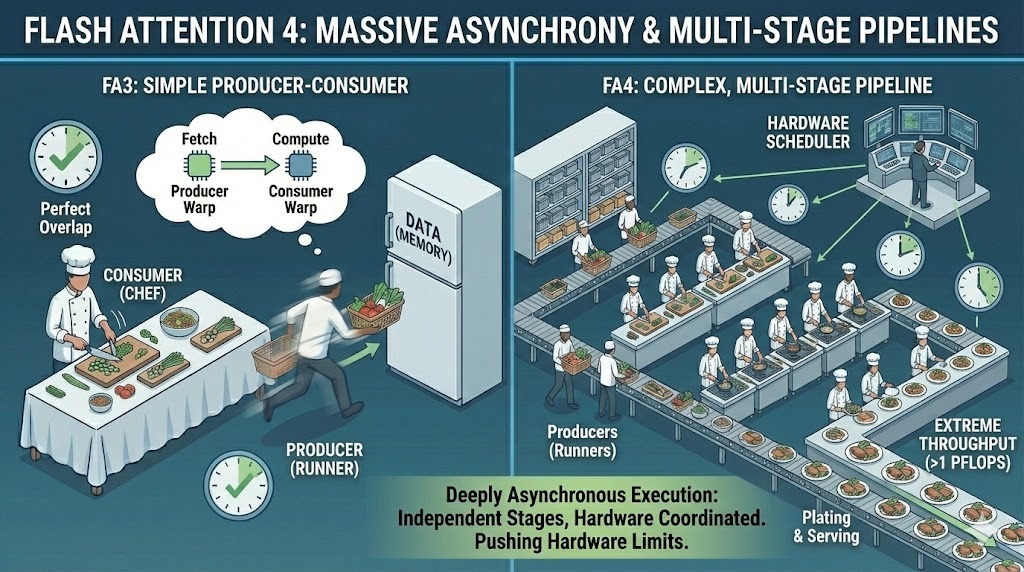
Bất đồng bộ ở quy mô lớn trong Flash Attention 4
Độ phức tạp này cũng là lý do FA4 vẫn mang tính thử nghiệm. Việc đảm bảo độ chính xác, ổn định và tích hợp ở mức này là thách thức. Cộng đồng vẫn cần thêm thời gian trước khi các đội ngũ có thể dùng nó một cách tin cậy trong các mô hình sản xuất lớn.
Hãy xem Flash Attention so sánh với cơ chế attention tiêu chuẩn ở vài khía cạnh chính.
Các benchmark liên tục cho thấy mọi phiên bản Flash Attention đều vượt self-attention tiêu chuẩn, và mức tăng lớn hơn khi độ dài chuỗi tăng.
Bài báo Flash Attention gốc báo cáo tốc độ nhanh hơn khoảng 2 đến 4× so với attention tiêu chuẩn đã tối ưu. Flash Attention 2 còn cải thiện thêm bằng cách tăng song song và bão hòa GPU tốt hơn, thường mang lại ~2× nữa trong thực tế.
Flash Attention 3 đẩy hiệu năng xa hơn nữa trên GPU Hopper, đặc biệt với FP8, đạt mức tận dụng phần cứng cao hơn nhiều so với attention tiêu chuẩn.
Attention tiêu chuẩn vật chất hóa rõ ràng toàn bộ ma trận attention N × N, dẫn đến tăng trưởng bộ nhớ bậc hai theo độ dài chuỗi. Khi N tăng, mức sử dụng bộ nhớ bùng nổ, nhanh chóng vượt quá khả năng của GPU. Flash Attention tránh hoàn toàn việc lưu ma trận này.
Bằng cách tính attention theo tile và giữ kết quả trung gian trong bộ nhớ nhanh trên chip, nó giảm sử dụng bộ nhớ xuống tuyến tính theo độ dài chuỗi với kích thước head cố định. Sự chuyển dịch từ bậc hai sang tuyến tính này gỡ bỏ nút thắt cấu trúc lớn nhất của attention tiêu chuẩn.
Việc giảm bộ nhớ đó trực tiếp cho phép cửa sổ ngữ cảnh dài hơn. Với attention tiêu chuẩn, các mô hình thường gặp lỗi hết bộ nhớ khi chuỗi đạt vài nghìn token.
Flash Attention khiến ngữ cảnh 4k và 8k token trở nên khả thi trên một GPU, và thậm chí mở khóa các cửa sổ dài hơn như 16k hoặc 32k token trên cùng thiết bị khi kết hợp với các kỹ thuật tiết kiệm bộ nhớ khác.
Đừng nhầm lẫn: Các cửa sổ hàng triệu token đạt được trong một số mô hình tiên phong hiện nay như Gemini 3 là nhờ chia chuỗi qua các cụm GPU lớn, vì chúng vượt xa dung lượng bộ nhớ của bất kỳ thiết bị đơn lẻ nào.
Việc dùng Flash Attention ngày nay đơn giản hơn nhiều so với trước. Trong hầu hết trường hợp, bạn không cần viết kernel CUDA tùy chỉnh hoặc thay đổi kiến trúc mô hình. Hỗ trợ đã có sẵn trong các công cụ phổ biến hiện nay.
Kể từ PyTorch 2.0, Flash Attention có sẵn trực tiếp qua torch.nn.functional.scaled_dot_product_attention. Khi bạn gọi hàm này, PyTorch tự động chọn backend attention nhanh nhất phù hợp phần cứng của bạn.
Trên các GPU được hỗ trợ, backend đó là Flash Attention. Về phía người dùng, trông nó giống mã attention tiêu chuẩn, nhưng bên dưới PyTorch sẽ điều phối tới kernel Flash Attention được tối ưu.
Nếu bạn dùng Hugging Face Transformers, bật Flash Attention thường chỉ là một dòng. Thiết lập attn_implementation="flash_attention_2" trong cấu hình mô hình báo cho thư viện dùng Flash Attention 2 khi có thể.
Với nhiều mô hình transformer, ngần ấy là đủ để có cả cải thiện tốc độ và bộ nhớ mà không cần đụng đến phần còn lại của mã huấn luyện hay suy luận.
Flash Attention 2 hướng tới các GPU NVIDIA hiện đại và chạy tốt nhất trên các kiến trúc Ampere, Ada và Hopper, bao gồm A100, RTX 3090, RTX 4090 và H100. Những GPU này cung cấp băng thông bộ nhớ và tính năng kiến trúc cần thiết để tận dụng trọn vẹn tiling và song song trong FA2.
Cũng cần lưu ý rằng Flash Attention v1 gốc hỗ trợ cả các GPU cũ hơn. Các card dựa trên Turing như T4 và RTX 2080 vẫn có thể dùng Flash Attention v1, dù các phiên bản mới hơn đòi hỏi phần cứng cập nhật để mở khóa toàn bộ mức tăng hiệu năng.
Trong thực tế, nếu bạn đã dùng PyTorch 2.x hoặc Hugging Face Transformers trên một GPU NVIDIA hiện đại, Flash Attention thường chỉ cách bạn một thiết lập cấu hình.
Attention tiêu chuẩn chạm bức tường cứng vì tăng trưởng bộ nhớ bậc hai khiến chuỗi dài trở nên chậm, tốn kém, hoặc đơn giản là không thể do lỗi hết bộ nhớ. Flash Attention đã thay đổi điều đó bằng cách thiết kế lại cách thực thi attention.
Bằng việc giảm sử dụng bộ nhớ từ bậc hai xuống tuyến tính theo độ dài chuỗi, Flash Attention khiến mô hình hóa ngữ cảnh dài trở nên khả thi. Những cửa sổ ngữ cảnh từng làm quá tải GPU ở vài nghìn token nay có thể mở rộng tới 4k, 8k, thậm chí trên 32k token trên cùng phần cứng.
Nếu bạn làm việc với transformer ở quy mô lớn mà chưa dùng Flash Attention, gần như chắc chắn bạn đang để lãng phí hiệu năng.
Háo hức tự xây các mô hình có thể dùng Flash Attention? Hãy tham gia khóa học của chúng tôi về các mô hình transformer với PyTorch!
Khóa học AI
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Lộ trình} other {Lộ trình}}
{count, plural, one {blog} other {blog}}
Matt Crabtree
10 phút
