
Chuyển đến nội dung chính

Kiểm định giả thuyết thật dễ hiểu

Kiểm định giả thuyết là một phương pháp thống kê dùng để đánh giá các tuyên bố về tổng thể dựa trên dữ liệu mẫu.
Đã cập nhật 5 thg 10, 2026  · 9 phút đọc

Khám phá cùng AI

ChatGPTClaudePerplexity

Kiểm định giả thuyết là một phần cốt lõi của thống kê, giúp bạn đưa ra quyết định có cơ sở trong nhiều lĩnh vực — từ y học đến kinh tế và khoa học xã hội. Bài hướng dẫn này sẽ đưa bạn đi qua các khái niệm nền tảng, các loại kiểm định, từng bước thực hiện và các ứng dụng thực tế của kiểm định giả thuyết, giúp bạn tự tin diễn giải và trình bày kết quả thống kê.

Nếu bạn sẵn sàng tìm hiểu sâu hơn về kiểm định giả thuyết, hãy chọn khóa học phù hợp với công nghệ ưa thích của bạn: Hypothesis Testing in Python, Hypothesis Testing in R, hoặc Introduction to Statistics in Google Sheets. Ngoài ra, hãy tham gia khóa Introduction to Statistics, không phụ thuộc công nghệ.

Kiểm định giả thuyết là gì?

Kiểm định giả thuyết là một quy trình thống kê dùng để kiểm tra các giả định hoặc giả thuyết về tham số của tổng thể. Quy trình bao gồm xây dựng giả thuyết không (H0) và giả thuyết đối (Ha), thu thập dữ liệu và xác định liệu bằng chứng có đủ mạnh để bác bỏ giả thuyết không hay không.

Mục đích chính của kiểm định giả thuyết là suy luận về tổng thể dựa trên một mẫu dữ liệu. Nó cho phép nhà nghiên cứu và nhà phân tích định lượng khả năng rằng những khác biệt hoặc mối quan hệ quan sát được trong dữ liệu là do ngẫu nhiên thay vì phản ánh một hiệu ứng thực sự trong tổng thể.

Các bước thực hiện kiểm định giả thuyết

Hãy cùng đi qua cách thực hiện một phép kiểm định giả thuyết, từng bước một.

Bước 1: Nêu giả thuyết

Bước đầu tiên là chuyển câu hỏi nghiên cứu của bạn thành hai giả thuyết đối nghịch:

  1. Giả thuyết không (H0): Giả định mặc định rằng không có hiệu ứng hoặc khác biệt.
  2. Giả thuyết đối (Ha): Giả thuyết cho rằng có hiệu ứng hoặc khác biệt.

Ví dụ:

  • H0: Chiều cao trung bình của nam bằng chiều cao trung bình của nữ.
  • Ha: Chiều cao trung bình của nam không bằng chiều cao trung bình của nữ.

Bước 2: Thu thập và chuẩn bị dữ liệu

Thu thập dữ liệu thông qua thí nghiệm, khảo sát hoặc nghiên cứu quan sát. Đảm bảo phương pháp thu thập dữ liệu được thiết kế để kiểm tra giả thuyết và đại diện cho tổng thể. Bước này thường bao gồm:

  • Xác định tổng thể quan tâm.
  • Chọn phương pháp lấy mẫu phù hợp.
  • Xác định kích thước mẫu.
  • Thu thập và tổ chức dữ liệu.

Bước 3: Chọn phép kiểm định thống kê phù hợp

Chọn phép kiểm định dựa trên loại dữ liệu và giả thuyết. Việc lựa chọn phụ thuộc vào các yếu tố như:

  • Loại dữ liệu (liên tục, phân loại, v.v.)
  • Phân phối dữ liệu (chuẩn, không chuẩn)
  • Kích thước mẫu
  • Số nhóm được so sánh

Các phép kiểm định thường dùng gồm:

Bước 4: Tính thống kê kiểm định và p-value

Sử dụng phần mềm thống kê hoặc công thức để tính giá trị thống kê kiểm định và p-value tương ứng. Bước này định lượng mức độ dữ liệu mẫu lệch so với giả thuyết không.

P-value là một khái niệm quan trọng trong kiểm định giả thuyết. Nó biểu thị xác suất quan sát được kết quả cực đoan như dữ liệu mẫu, giả sử giả thuyết không là đúng.

Bước 5: Đưa ra quyết định

So sánh p-value với mức ý nghĩa (α), thường đặt là 0,05. Quy tắc quyết định như sau:

  • Nếu p-value ≤ α: Bác bỏ giả thuyết không, cho thấy có bằng chứng ủng hộ giả thuyết đối.
  • Nếu p-value > α: Không bác bỏ giả thuyết không, cho thấy chưa đủ bằng chứng để ủng hộ giả thuyết đối.

Lưu ý rằng việc không bác bỏ giả thuyết không không có nghĩa là nó đúng; chỉ là chưa có đủ bằng chứng để kết luận ngược lại.

Bước 6: Trình bày phát hiện

Báo cáo kết quả, bao gồm thống kê kiểm định, p-value và kết luận. Thảo luận liệu phát hiện có ủng hộ giả thuyết ban đầu và ý nghĩa của chúng hay không. Khi trình bày kết quả, hãy cân nhắc:

  • Cung cấp bối cảnh cho nghiên cứu.
  • Nêu rõ giả thuyết.
  • Báo cáo thống kê kiểm định và p-value.
  • Diễn giải kết quả bằng ngôn ngữ dễ hiểu.
  • Thảo luận về ý nghĩa thực tiễn của phát hiện.

Các loại kiểm định giả thuyết

Kiểm định giả thuyết có thể được phân loại rộng rãi thành hai nhóm chính:

Kiểm định tham số

Kiểm định tham số giả định dữ liệu tuân theo một phân phối xác suất cụ thể, thường là phân phối chuẩn. Các phép kiểm định này thường mạnh hơn khi giả định được đáp ứng. Những kiểm định tham số phổ biến gồm:

  • t-test (một mẫu, hai mẫu độc lập, cặp ghép)
  • ANOVA (một nhân tố, hai nhân tố, lặp đo)
  • Z-test (một mẫu, hai mẫu)
  • F-test (một nhân tố, hai nhân tố)

Kiểm định phi tham số

Kiểm định phi tham số không giả định một phân phối cụ thể của dữ liệu. Chúng hữu ích khi xử lý dữ liệu thứ bậc hoặc khi các giả định của kiểm định tham số bị vi phạm. Ví dụ gồm:

  • Kiểm định Mann-Whitney U
  • Kiểm định Wilcoxon signed-rank
  • Kiểm định Kruskal-Wallis

Chọn kiểm định phù hợp

Khi chọn một phép kiểm định giả thuyết, nhà nghiên cứu cân nhắc một vài nhóm tiêu chí rộng:

  1. Phân phối dữ liệu: Xác định dữ liệu của bạn có phân phối chuẩn hay không, vì nhiều kiểm định giả định tính chuẩn.
  2. Số lượng nhóm: Xác định bạn đang so sánh bao nhiêu nhóm (ví dụ: một nhóm, hai nhóm hoặc nhiều hơn).
  3. Tính độc lập giữa các nhóm: Quyết định các nhóm của bạn là độc lập (đối tượng khác nhau) hay phụ thuộc (cùng đối tượng được đo nhiều lần).
  4. Loại dữ liệu:
    • Liên tục (ví dụ: chiều cao, cân nặng),
    • Thứ bậc (ví dụ: xếp hạng),
    • Định danh (ví dụ: các danh mục không có thứ tự).

Dựa trên các tiêu chí này, bạn có thể chọn phép kiểm định thống kê phù hợp. Chẳng hạn, nếu dữ liệu có phân phối chuẩn và bạn có hai nhóm độc lập với dữ liệu liên tục, bạn sẽ dùng t-test độc lập. Nếu dữ liệu không phân phối chuẩn, có hai nhóm độc lập và dữ liệu thứ bậc, nên dùng kiểm định Mann-Whitney U.

Để hỗ trợ lựa chọn kiểm định phù hợp, hãy cân nhắc sử dụng sơ đồ luồng kiểm định giả thuyết như một hướng dẫn tổng quát:
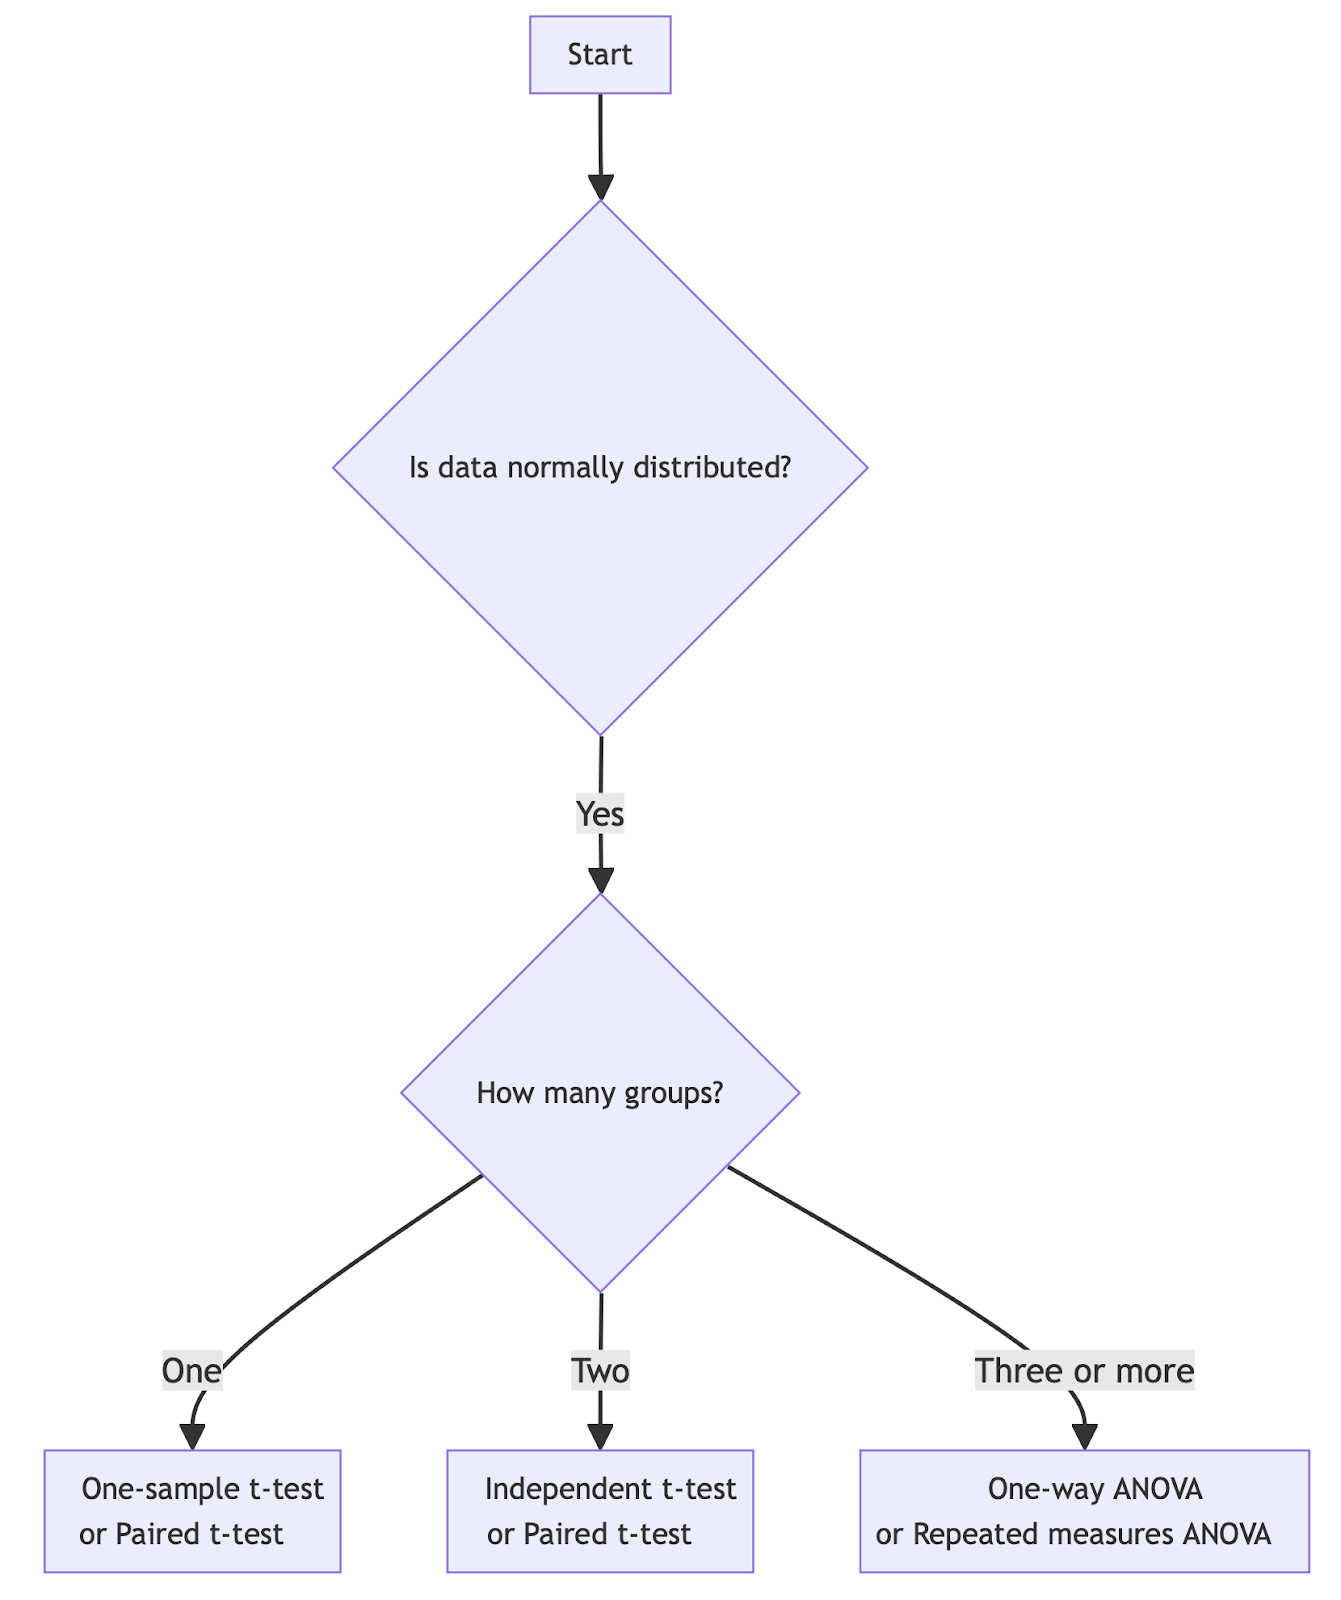
Chọn kiểm định giả thuyết phù hợp cho dữ liệu phân phối chuẩn

Chọn kiểm định giả thuyết phù hợp cho dữ liệu phân phối chuẩn. Ảnh: Tác giả.
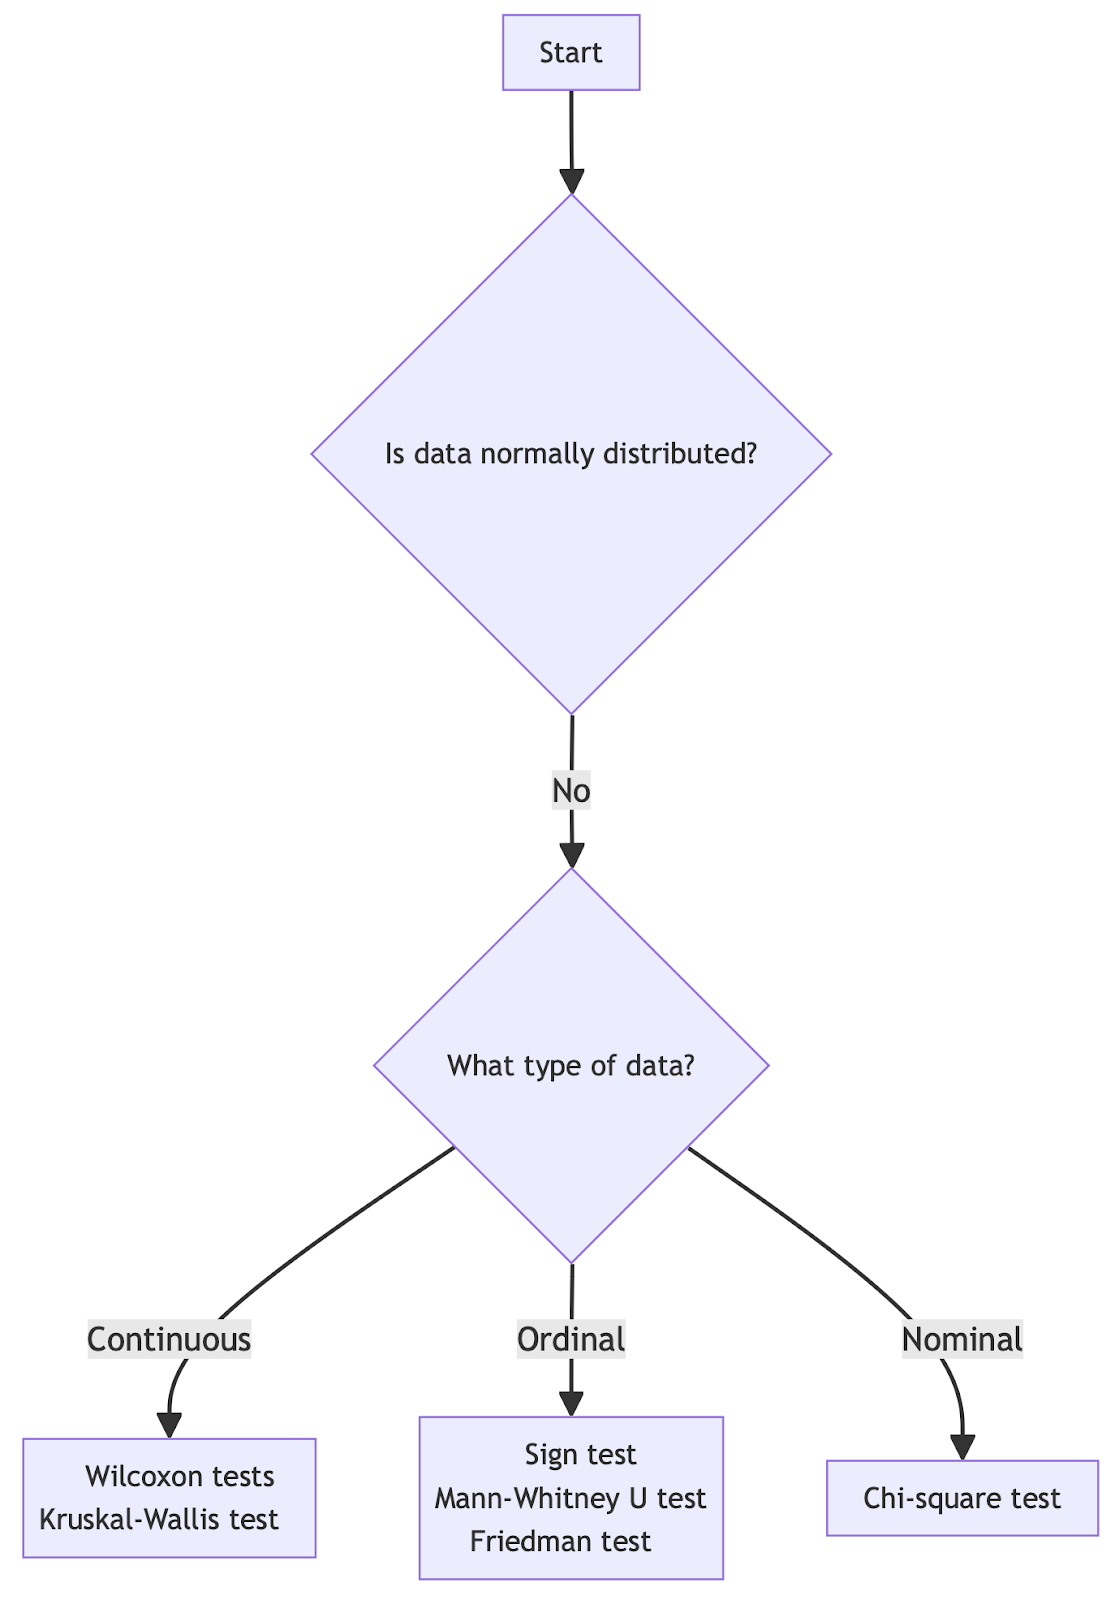
Chọn kiểm định giả thuyết phù hợp cho dữ liệu không phân phối chuẩn

Chọn kiểm định giả thuyết phù hợp cho dữ liệu không phân phối chuẩn. Ảnh: Tác giả.

Các tiếp cận hiện đại cho kiểm định giả thuyết

Bên cạnh các phương pháp kiểm định truyền thống, còn có một số cách tiếp cận hiện đại:

Kiểm định hoán vị hoặc ngẫu nhiên hóa

Các kiểm định này liên quan đến việc xáo trộn ngẫu nhiên dữ liệu quan sát nhiều lần để tạo ra phân phối các kết quả có thể có dưới giả thuyết không. Chúng đặc biệt hữu ích khi kích thước mẫu nhỏ hoặc khi các giả định của kiểm định tham số không được đáp ứng.

Bootstrapping

Bootstrapping là kỹ thuật lấy mẫu lại bằng cách lặp lại việc lấy mẫu có hoàn lại từ bộ dữ liệu gốc. Nó có thể được dùng để ước lượng phân phối lấy mẫu của một thống kê và xây dựng khoảng tin cậy.

Mô phỏng Monte Carlo

Phương pháp Monte Carlo sử dụng lấy mẫu ngẫu nhiên lặp đi lặp lại để thu được kết quả số. Trong kiểm định giả thuyết, chúng có thể dùng để ước lượng p-value cho các mô hình thống kê phức tạp hoặc khi lời giải giải tích khó thu được.

Kiểm soát sai số

Khi tiến hành kiểm định giả thuyết, tốt nhất là hiểu và kiểm soát các sai số tiềm ẩn:

Sai lầm Loại I và Loại II

  • Sai lầm Loại I: Bác bỏ giả thuyết không khi nó thực sự đúng (dương tính giả).
  • Sai lầm Loại II: Không bác bỏ giả thuyết không khi nó thực sự sai (âm tính giả).

Mức ý nghĩa (α) trực tiếp kiểm soát xác suất xảy ra Sai lầm Loại I. Giảm α làm giảm khả năng Sai lầm Loại I nhưng tăng rủi ro Sai lầm Loại II.

Để cân bằng các sai lầm này:

  1. Điều chỉnh mức ý nghĩa dựa trên hậu quả của từng loại sai lầm.
  2. Tăng kích thước mẫu để cải thiện lực kiểm định (power).
  3. Dùng kiểm định một phía khi phù hợp.

Hiệu ứng ngăn kéo hồ sơ (file drawer effect)

Hiệu ứng ngăn kéo hồ sơ đề cập đến thiên lệch công bố khi các nghiên cứu có kết quả có ý nghĩa thống kê có xu hướng được xuất bản nhiều hơn so với các nghiên cứu có kết quả không có ý nghĩa. Điều này có thể dẫn đến việc ước lượng quá mức các hiệu ứng trong tài liệu. Để giảm thiểu điều này:

  • Cân nhắc đăng ký trước nghiên cứu.
  • Công bố mọi kết quả, dù có ý nghĩa hay không.
  • Thực hiện phân tích gộp (meta-analysis) có tính đến thiên lệch công bố.
  • Giả lập dữ liệu trước.

Thuật ngữ và định nghĩa then chốt

  • Giả thuyết không (H0): Giả định mặc định rằng không có hiệu ứng hoặc khác biệt.
  • Giả thuyết đối (Ha): Giả thuyết cho rằng có hiệu ứng hoặc khác biệt.
  • P-value: Xác suất quan sát được kết quả kiểm định dưới giả thuyết không.
  • Mức ý nghĩa (α): Ngưỡng để bác bỏ giả thuyết không, thường đặt là 0,05.
  • Thống kê kiểm định: Giá trị chuẩn hóa dùng để so sánh dữ liệu quan sát với giả thuyết không.
  • Sai lầm Loại I: Bác bỏ giả thuyết không khi nó đúng (dương tính giả).
  • Sai lầm Loại II: Không bác bỏ giả thuyết không khi nó sai (âm tính giả).
  • Lực kiểm định (Statistical Power): Xác suất bác bỏ đúng một giả thuyết không sai.
  • Khoảng tin cậy: Khoảng giá trị có khả năng chứa tham số thực của tổng thể.
  • Kích thước hiệu ứng (Effect Size): Thước đo độ lớn của khác biệt hoặc mối quan hệ được kiểm định.

Kết luận

Hãy nhớ rằng kiểm định giả thuyết chỉ là một phần trong bộ công cụ suy luận thống kê. Luôn cân nhắc ý nghĩa thực tiễn của phát hiện, không chỉ ý nghĩa thống kê. Khi tích lũy kinh nghiệm, bạn sẽ phát triển trực giác về thời điểm và cách áp dụng các kỹ thuật này trong nhiều bối cảnh thực tế.

Để nâng cao chuyên môn thống kê, bạn có thể khám phá các chủ đề như How to Become a Statistician in 2024, cung cấp góc nhìn về lĩnh vực đang phát triển và các kỹ năng cần thiết để thành công. Ngoài ra, luyện tập Top 35 Statistics Interview Questions and Answers for 2024 và học khóa Practicing Statistics Interview Questions in R sẽ giúp bạn mài giũa kỹ năng và chuẩn bị cho phỏng vấn.


Vinod Chugani's photo
Author
Vinod Chugani
LinkedIn

Vinod Chugani bắt đầu sự nghiệp tại Tokyo với vai trò Trưởng bàn giao dịch bán hàng Quỹ phòng hộ trẻ nhất của JPMorgan, sau đó lập kỷ lục doanh số cá nhân tại Lehman Brothers, rồi xây dựng một doanh nghiệp phân phối điện tử tại 30 quốc gia vượt mốc doanh thu 100 triệu đô la Singapore trước khi chuyển hướng sang dữ liệu. Tốt nghiệp Kinh tế Duke và là cựu học viên NYC Data Science Academy, anh là một trong ba người nhận học bổng trong hơn 100 ứng viên cho khóa học Building AI Applications của Hugo Bowne-Anderson trên Maven. Hiện nay, anh viết cho DataCamp, KDnuggets, Machine Learning Mastery và Statology về các chủ đề từ thống kê đến AI hành động, và cố vấn cho các chuyên gia dữ liệu tại NYC Data Science Academy với hơn 1.000 buổi kèm 1-1 đã thực hiện.


Câu hỏi thường gặp

Tại sao cần kiểm soát môi trường khi tiến hành kiểm định giả thuyết?

Kiểm soát môi trường trong khi thực hiện kiểm định giả thuyết sẽ giảm thiểu các biến ngoại lai có thể ảnh hưởng đến kết quả. Việc kiểm soát này đảm bảo rằng mọi hiệu ứng quan sát được trong thí nghiệm có thể được quy kết một cách tự tin hơn cho biến độc lập đang nghiên cứu, thay vì các yếu tố ngoại lai. Nhờ đó, độ tin cậy của kết quả kiểm định được tăng cường.

Giả thuyết không là gì?

Giả thuyết không, thường ký hiệu là H0, là giả định mặc định rằng không có hiệu ứng hoặc khác biệt giữa các nhóm hay điều kiện được kiểm định. Nó đóng vai trò là phát biểu mà nhà nghiên cứu tìm cách bác bỏ thông qua phân tích thống kê. Việc bác bỏ hay không bác bỏ giả thuyết không cung cấp những hiểu biết then chốt về mối quan hệ giữa các biến.

P-value liên hệ thế nào với khoảng tin cậy trong kiểm định giả thuyết?

P-value và khoảng tin cậy đều là công cụ dùng để suy luận về tổng thể dựa trên dữ liệu mẫu. P-value cho biết xác suất quan sát được kết quả cực đoan như trong mẫu nếu giả thuyết không là đúng. Ngược lại, khoảng tin cậy cung cấp một khoảng giá trị mà trong đó tham số thực của tổng thể có khả năng nằm. Nếu khoảng tin cậy cho chênh lệch trung bình hoặc kích thước hiệu ứng không chứa giá trị vô hiệu (ví dụ: chênh lệch bằng 0), điều đó gợi ý rằng có thể bác bỏ giả thuyết không ở mức tin cậy của khoảng, phù hợp với một p-value thấp.

Sai lầm Loại I và Loại II là gì?

Sai lầm Loại I xảy ra khi giả thuyết không bị bác bỏ một cách sai lầm, về bản chất là phát hiện một hiệu ứng không tồn tại (dương tính giả). Sai lầm Loại II xảy ra khi giả thuyết không không bị bác bỏ một cách sai lầm, bỏ lỡ một hiệu ứng thực sự (âm tính giả). Cân bằng hai loại sai lầm này là điều quan trọng để phân tích thống kê vững chắc.

Kích thước mẫu ảnh hưởng thế nào đến kiểm định giả thuyết?

Kích thước mẫu ảnh hưởng trực tiếp đến lực của kiểm định giả thuyết, tức xác suất bác bỏ đúng một giả thuyết không sai (tránh Sai lầm Loại II). Mẫu lớn hơn thường cung cấp ước lượng tham số tổng thể chính xác và đáng tin cậy hơn, tăng lực kiểm định và giảm biên sai số của khoảng tin cậy.

Điều gì xảy ra nếu dữ liệu mẫu không đại diện cho tổng thể?

Nếu dữ liệu mẫu không đại diện cho tổng thể, kết quả kiểm định giả thuyết có thể bị thiên lệch và không khái quát hóa được cho tổng thể rộng hơn. Điều này có thể do phương pháp lấy mẫu sai lệch như thiên lệch chọn mẫu, không phản ánh đầy đủ sự đa dạng hoặc đặc điểm của tổng thể.

Khác biệt giữa kiểm định tham số và phi tham số là gì?

Kiểm định tham số giả định dữ liệu tuân theo một phân phối cụ thể. Kiểm định phi tham số không giả định bất kỳ phân phối cụ thể nào cho dữ liệu. Chúng được dùng khi xử lý dữ liệu thứ bậc, dữ liệu không phân phối chuẩn, hoặc khi kích thước mẫu nhỏ.

Khác biệt giữa ý nghĩa thống kê và ý nghĩa thực tiễn là gì?

Trong khi ý nghĩa thống kê cho biết khả năng một hiệu ứng xảy ra do ngẫu nhiên, thì ý nghĩa thực tiễn xem xét tác động hoặc mức độ liên quan thực sự của hiệu ứng đó trong thực tế. Một kết quả có thể có ý nghĩa thống kê nhưng không có ý nghĩa thực tiễn nếu kích thước hiệu ứng quá nhỏ để mang lại ý nghĩa trong thế giới thực.

Chủ đề
Phân tích dữ liệu
Khoa học Dữ liệu

Học kiểm định giả thuyết với DataCamp

Khóa học

Kiểm định giả thuyết trong Python

4 giờ
61.5K
Tìm hiểu cách và thời điểm sử dụng các kiểm định giả thuyết phổ biến như kiểm định t, kiểm định tỷ lệ và kiểm định chi bình phương trong Python.
Xem chi tiếtRight Arrow
Bắt Đầu Khóa Học
Xem thêmRight Arrow