
Kurs
LangChain ile LLM Uygulamaları Geliştirme
3 sa
51.2K
Bir arkadaşınıza uzun bir hikâye anlattığınızı ve tam sonuca geldiğinizde hikâyenin başını unuttuğunu fark ettiğinizi hayal edin. Bir yapay zekâ "kısa süreli belleği" tükendiğinde ve yenilerine yer açmak için kritik ayrıntıları atmak zorunda kaldığında yaşanan hayal kırıklığı tam olarak budur.
Büyük Dil Modelleri (LLM’ler) dünyasında bu dikkat süresi, bağlam penceresiyle tanımlanır.
Modeller güçlendikçe ve bağlam boyutları arttıkça, bu pencerelerin nasıl çalıştığını anlamak güvenilir ve ölçeklenebilir yapay zekâ sistemleri kurmanın anahtarı hâline gelir. Bu rehberde, bağlam pencerelerinin temellerini, bunları genişletmenin getirdiği ödünleşimleri ve etkili kullanım stratejilerini adım adım ele alacağız.
Kuramın ötesine geçip gerçek Python uygulamalarında bağlam sınırlarını nasıl yöneteceğinizi öğrenmek için LangChain ile LLM Uygulamaları Geliştirme kursumuza göz atın.
Bir yapay zekâ modelinin bağlam penceresi, yanıt üretirken çalışma belleğinde tutabileceği metin miktarını belirler. Önceki etkileşimlerdeki ayrıntıları unutmadan bir sohbetin ne kadar süre devam edebileceğini sınırlar.
Bunu insanın kısa süreli belleği gibi düşünebilirsiniz. Önceki konuşmalardan gelen bilgileri, eldeki görev için kullanmak üzere geçici olarak depolar.
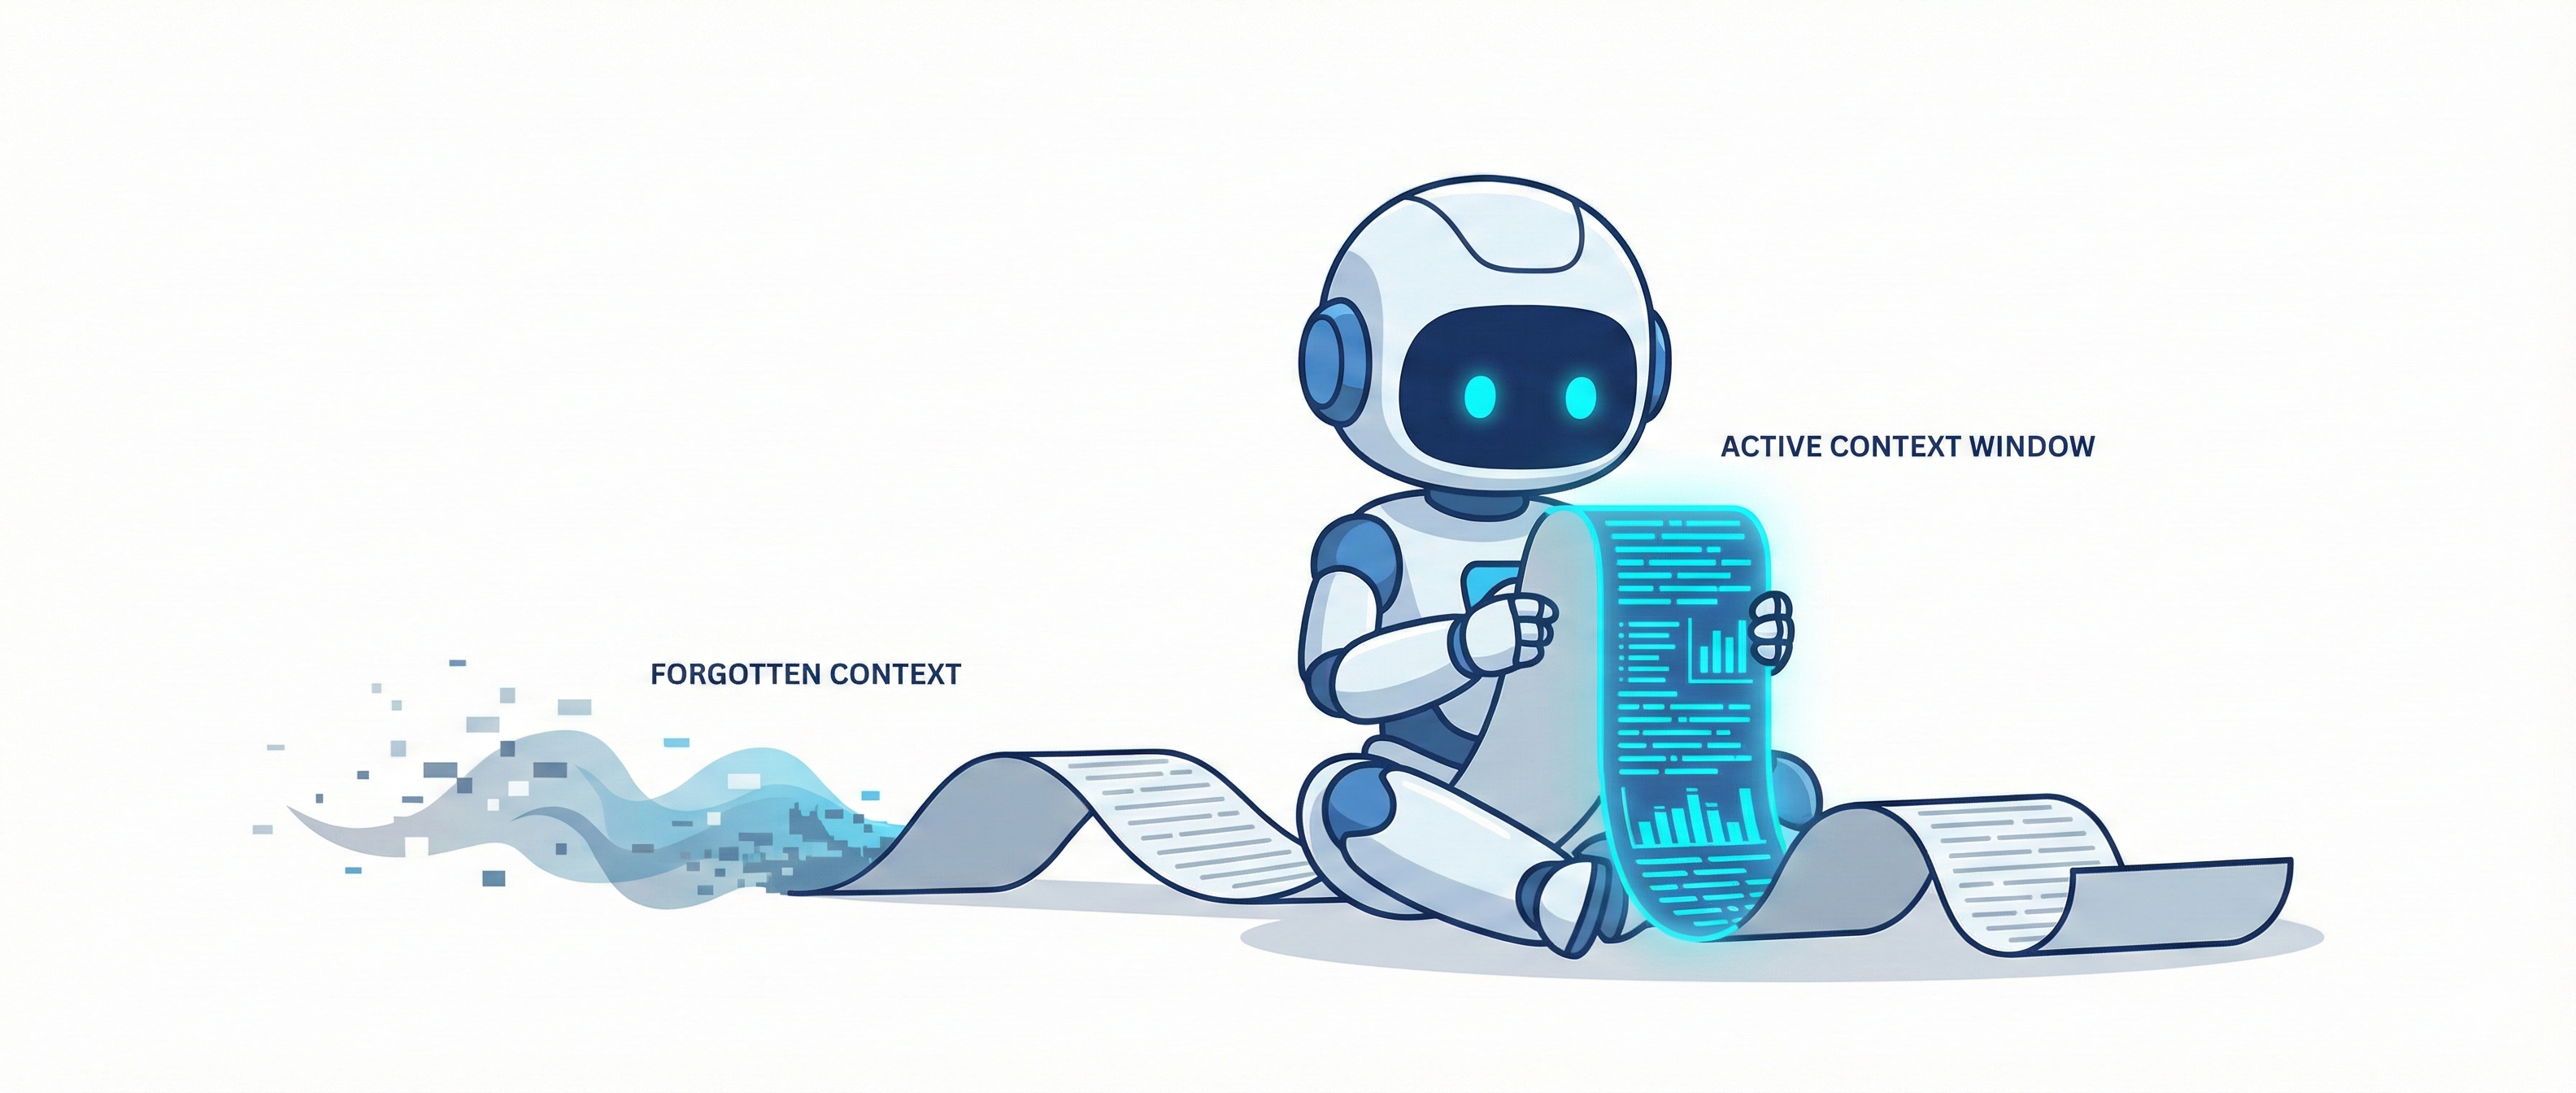
Bağlam pencereleri; akıl yürütme kalitesi, sohbetin derinliği ve modelin yanıtları etkili şekilde kişiselleştirme becerisi gibi çeşitli unsurları etkiler. Ayrıca aynı anda işleyebileceği en büyük girdi boyutunu belirler. Bir komut veya sohbet bağlamı bu sınırı aştığında, model metnin en eski kısımlarını keserek (budayarak) yer açar.
Bunun tam olarak ne anlama geldiğini daha net görmek için, yapay zekâ modelleri ve bağlam pencerelerinin temelindeki birkaç kavrama bakalım.
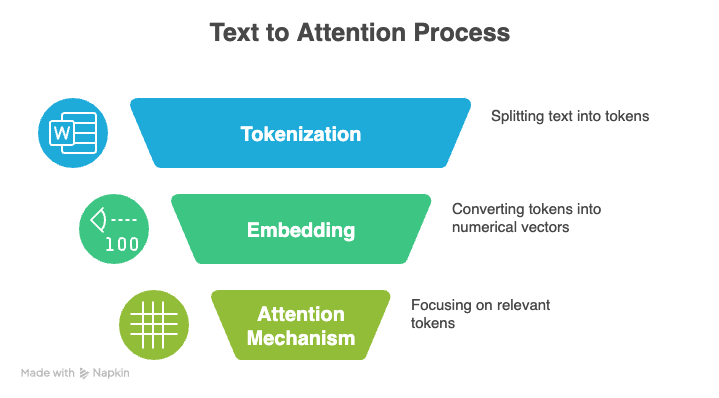
LLM’lerin temelinde üç kavram yatar: tokenleştirme, dikkat (attention) mekanizması ve konumsal kodlama.
Tokenleştirme, ham metni bir LLM’in işleyebileceği daha küçük birimler ya da jetonlar (token) dizisine dönüştürme sürecidir. Bu jetonlar, tüm sözcükleri, tekil karakterleri veya hatta hece parçalarını temsil edebilir. Bir modelin tanıdığı tüm benzersiz jetonların bütünü ise söz varlığı (vocabulary) olarak adlandırılır.
Örneğin, “Hello, world” cümlesi [“Hello”, “,”, “ world”] şeklinde tokenleştirilebilir.
Eğitim veya çıkarım sırasında her jeton benzersiz bir tamsayıya çevrilir ve model orijinal metin yerine bu sayıları okur. Sayısal diziyi analiz eder, jetonların birbirleriyle nasıl ilişkili olduğunu öğrenir ve en olası bir sonraki jetonu tahmin ederek yeni metin üretir.
Verimli tokenleştirme, bir modelin bağlam penceresine sığan bilgi miktarında büyük rol oynar. Bir tokenleştirici metni daha az jetonla temsil edebildiğinde, aynı pencereye daha fazla içerik sığar.
Yaygın kelimeleri veya ifadeleri tek bir jeton olarak temsil eden tokenleştiriciler özellikle etkilidir; çünkü jeton sayısını azaltarak modelin bağlam sınırları içinde daha uzun belgeleri işlemesine olanak tanırlar.
Sözde dikkat mekanizması, modern LLM’lerin bir diğer temelidir. Modelin çıktı üretirken girdisinin en ilgili kısımlarına odaklanmasına yardımcı olur.
Model, her jetona eşit davranmak yerine mevcut temsili diğer tüm jeton temsilleriyle karşılaştırır ve her karşılaştırmaya bir puan atar. Bu seçici ağırlıklandırma, modelin uzun dizileri işlemesini ve bağlamı daha etkili biçimde anlamasını sağlar.
Dikkat, üç bileşen etrafında inşa edilmiştir: Sorgular (Queries), Anahtarlar (Keys) ve Değerler (Values).
Sorgular: Mevcut jetonun, dizinin geri kalanında ilgili bilgiyi "aramak" için gönderdiği sinyal.
Anahtarlar: Arama sinyaliyle ne kadar iyi eşleştiğini belirleyen, dizideki her jeton için tanımlayıcı.
Değerler: Bir Sorgu ile bir Anahtar eşleştiğinde alınan ve kullanılan gerçek bilgi içeriği.
Model, sorgular ile anahtarlar arasındaki benzerlik puanlarını hesaplar, bu puanları softmax aktivasyon fonksiyonu ile ağırlıklara dönüştürür ve ardından nihai çıktıyı değerlerin ağırlıklı toplamı olarak üretir.
Öz-dikkat (self-attention), mevcut jetonu dizideki diğer tüm jetonlarla karşılaştırır. Bu, karesel bir hesaplama maliyeti yaratır: Bağlam penceresini iki katına çıkarmak, gereken işlem gücünü ve belleği dört katına çıkarır.
Bağlam pencereleri genişledikçe bu hızla pahalı hâle gelir; bu nedenle modeller, hesabı yönetilebilir tutmak için seyrek dikkat, düşük-rütbe yaklaşımı veya parçalara ayırma (chunking) gibi optimizasyonlara başvurur.
Transformerlar, modern dil modellerini çalıştıran yapılardır ve jetonların sırasını doğal olarak anlamazlar. Bunun yerine bu bilgiyi dahil etmek için konumsal kodlamaya güvenirler.
Konumsal kodlama, modelin uzaklığı ve göreli düzeni anlamasına yardımcı olmak için her jetona küçük bir sinyal ekler.
Konumsal bilginin eklenme yöntemi, modelin bir dizi içinde ilişkileri güvenilir şekilde ne kadar uzağa kadar takip edebileceğini de tanımlar; bu da bağlam penceresinin boyutunu ve etkinliğini belirler. Bazı popüler yöntemleri karşılaştıralım:
Mutlak Konumsal Gömüler: Model dizideki her konum için ayrı bir vektör öğrenir; tıpkı her jetona sabit bir adres vermek gibi. Daha kısa diziler için işe yarar; ancak model, eğitildiğinin ötesindeki konumları kaldıramaz, bu da bağlam penceresini genişletmeyi zorlaştırır.
Sinüsoidal Kodlamalar: Konumlar, her jetona konumuna bağlı benzersiz bir örüntü veren yinelenen sinüs ve kosinüs dalgalarıyla kodlanır. Mutlak gömelere kıyasla görülmemiş uzunluklara daha iyi genellenirler; ancak aşırı uzun dizilerde daha az kararlı hâle gelirler.
Göreli Konumsal Kodlamalar: Tam konumları işaretlemek yerine model, jetonlar arasındaki mesafeyi öğrenir. Daha uzun dizilere genelleştirmeye yardımcı olur; ancak genel bağlam sınırı yine de modelin mimarisi ve belleğine bağlıdır.
Döner Konumsal Gömüler (RoPE): RoPE, her jetonun vektör temsilini mutlak konumuna göre döndürerek, diğer jetonlardan uzaklığını hesaplar. Bu yöntem diziler büyüdükçe kararlı kalır ve çok daha büyük bağlam pencerelerini destekler.
ALiBi (Attention Linear Biases): ALiBi, dikkat mekanizması içinde basit, mesafeye dayalı bir önyargı uygular; böylece daha yakın jetonlar doğal olarak daha yüksek ağırlık alır. Uzun dizilere iyi ölçeklenir.
Ayrıntılı bir genel bakış için transformer’lar nasıl çalışır konulu bu eğiticiye bakmanızı öneririm.
Bağlam, pencereyi aşarsa model en eski kısımları budayabilir veya yok sayabilir; bu da önemli bağlamın kaybedilmesine yol açabilir. Bu nedenle araştırmacılar, bu sınırları zorlamak ve daha uzun bağlam pencerelerini mümkün kılmak için sürekli yeni teknikler dener.
2022’ye kadar OpenAI’ın GPT modelleri manzaraya hâkimdi. 2018’de yayımlanan ilk GPT modeli 512 jetonluk bir pencereyi destekliyordu. 2019 ve 2020’deki sonraki iki sürüm bu sınırı her seferinde ikiye katladı ve GPT-3 için 2.048 jetona ulaştı. Ardıl modeller bu sınırları genişletmeye devam ederek 1 milyon jetona kadar çıktı (GPT-4.1).
Son dönemde OpenAI, rakipleri tarafından yakalandı hatta geride bırakıldı. Google’ın Gemini 2.5 ve 3 Pro sürümleri, 1 milyon jetona kadar olan bu pencere boyutunu yakalayarak tek seferde tüm kitapları, büyük kod tabanlarını ve çok belgeli iş yüklerini işlemeyi mümkün kılıyor.
Anthropic’in Claude Sonnet 4.5 serisi şu anda beta aşamasında aynı bağlam penceresi boyutunu test ediyor ve orijinal 200.000 jetonluk boyutundan genişliyor.
Llama ve Mistral gibi açık kaynaklı model aileleri genellikle 100 bin ile 200 bin aralığına yerleşir; yerel olarak konuşlandırma veya ince ayar için pratik kalırken saygın bir uzun-bağlam performansı sunarlar.
Dikkate değer istisnalar arasında, uzun belgeler genelinde genel amaçlı akıl yürütme için tasarlanmış 1 milyon jetonluk pencereyi destekleyen Llama Maverick bulunur. Öte yandan Llama Scout, tek seferde tüm kod tabanlarını veya hukuk arşivlerini işlemek üzere özel olarak tasarlanmış devasa 10 milyon jeton kapasitesiyle sınırları daha da zorluyor.
Bununla birlikte, daha bu hafta yayımlanan GPT-5.2 stratejide bir değişime işaret etti. Sonsuz bağlamın peşinden koşmak yerine OpenAI, en yeni amiral gemisini 400.000 jetonluk bir pencereyle sınırlandırdı; ham boyutu, daha az dikkatin dağılmasını ve daha üstün akıl yürütmeyi hedefleyen "kusursuz hatırlama" için takas etti.
Bağlam penceresi boyutundaki farklılıklar, her modelin gerçek iş akışlarında nasıl performans gösterdiğini şekillendirir. Genişletilmiş bağlam pencereleri, güçlü doğruluk, tutarlılık ve uzun menzilli akıl yürütme sağlar; ancak daha fazla hesaplama ve daha dikkatli bağlam seçimi gerektirir.
Orta aralıktaki modeller verimli kalır ve yine de uzun belgeleri ve uzatılmış sohbetleri idare eder; ancak çok büyük girdiler için doğru yapıya ihtiyaç duyarlar.
Aşağıdaki kullanım durumları, büyük bağlam pencerelerine sahip modellerin güçlü yönlerinin gerçek dünyadaki uygulamalarda nasıl ortaya çıktığını gösterir.
Tüm raporları, transkriptleri, kod tabanlarını veya araştırma makalelerini tek seferde tutacak kadar alan olduğunda, bir model örüntüleri takip edebilir, uzak ayrıntıları birbirine bağlayabilir ve baştan sona tutarlı bir anlayışı sürdürebilir. Bu da birçok uygulama alanı sunar:
Hukuk: Büyük pencereler, modellerin tam sözleşmeleri analiz etmesine, birden fazla belge arasında maddeleri karşılaştırmasına ve uzun belgelerde gizli atıfları takip etmesine olanak tanır.
Sağlık: Ekipler, küçük pencerelerin kaçıracağı önemli bağlamı koruyarak uzun klinik yönergeleri, hasta geçmişlerini veya çoklu çalışma veri kümelerini gözden geçirebilir.
Araştırma: Geniş pencereli bir model, makaleleri ve literatür taramalarını tek seferde okuyabilir ve yalnızca tüm belge görünür olduğunda ortaya çıkan bağlantıları gün yüzüne çıkarabilir.
Daha büyük bağlam pencereleri, model önceki mesajları unutmadan sohbetin daha fazlasını hatırlayabildiği için sohbet tabanlı yapay zekâyı daha doğal hissettirir.
Müşteri hizmetlerinde bu, daha akıcı ve daha kişiselleştirilmiş etkileşimlere yol açar. Model, geçmiş tercihleri ve önceki konuşmaları kullanarak daha doğru ve ilgili yanıtlar verebilir.
Genişletilmiş bağlam pencereleri, metin, ses ve görseller arasında karmaşık akıl yürütmeyi destekler; çünkü modeli, bu kiplerin her birini ayrı ayrı işlemek yerine birlikte tutacak yeterli alan sağlar.
Tüm transkript, görsel kareler ve ilgili yazılı materyal tek bir pencereye sığdığında, model ayrıntıları biçimler arası karşılaştırabilir, ilişkileri takip edebilir ve bağlamın bütüncül bir anlayışını oluşturabilir.
Bu, bilginin parçalara ayrılması veya özetlenmesi gerektiğinde ortaya çıkan boşlukları ortadan kaldırır ve modelin tüm girdi kümesi üzerinde aynı anda akıl yürütmesine olanak tanır.
Geniş bağlam pencereleri güçlü yetenekler sunar; ancak girdi boyutları büyüdükçe yeni performans zorluklarını da beraberinde getirir. Gelişmiş modeller bile son derece uzun diziler boyunca kusursuz dikkati sürdürmekte zorlanır; bu nedenle model, bağlamın her bölümündeki bilgileri beklediğiniz kadar güvenilir kullanamayabilir.
Uzun bağlamlı modellerde yaygın bir sorun, “ortada kaybolma” etkisidir. Modeller, uzun bir dizinin başını ve sonunu genellikle iyi hatırlar; ancak ortalara gömülü önemli ayrıntıları sık sık kaçırır veya görmezden gelir. Bu da tam bağlam mevcutken bile daha zayıf yanıtlara yol açabilir.
Girdiyi akıllı biçimde yapılandırmak, kritik görevlerde bu sorundan kaçınmaya yardımcı olur. Bu, metni net bölümlere ayırmak veya önemli noktaları yinelemek anlamına gelir; böylece model onları gözden kaçırmaz.
Bağlam penceresi boyutunun artmasıyla maliyetler hızla yükselebilir. Eklenen her jeton, dikkat hesaplamasının boyutunu artırır; bu da çıkarım süresini, GPU bellek gereksinimlerini ve genel sistem yükünü yükseltir.
Bunu yönetmek için modele bilgi vermenin daha etkili yollarına ihtiyaç vardır. Seçimli getirme (selective retrieval), hiyerarşik parçalara ayırma veya hızlı özetler gibi teknikler, girdiyi küçük tutarak modelin aşırı yüklenmesini önlemeye yardımcı olur.
Büyük pencereler aynı zamanda güvenlik ve gizlilikle ilgili kaygıları da gündeme getirir. Modele daha fazla girdi verdiğinizde hassas verileri açığa çıkarma olasılığı artar.
Bu nedenle ekiplerin, büyük bağlam pencerelerinin yeni riskler yaratmamasını sağlamak için sağlam veri işleme kurallarına, maskeleme/karartma adımlarına ve erişim kontrollerine ihtiyacı vardır.
Birçok durumda, gereksiz veya zayıf ilişkili bilgiler model için bilişsel yükü artırır; bu da halüsinasyon ve yanlış örüntüler riskini yükseltir. Uzun girdiler ayrıca, modelin görevi anlama biçimini bozabilecek gürültü de getirir.
Uygulamada, yüksek kaliteli performans çoğu zaman özenle seçilmiş bağlamdan kaynaklanır; böylece model, yalnızca en çok bilgiye değil, doğru bilgiye maruz kalır.
Bağlam pencerelerinden en iyi şekilde yararlanmak için çeşitli yöntemler kullanılabilir. Bunlar arasında Getirme Artırmalı Üretim (RAG), bağlam mühendisliği, parçalara ayırma ve model seçimi bulunur.
Getirme Artırmalı Üretim (RAG), gerektiğinde haricî bir veritabanından ek bilgi çekip modele besleyerek çalışır.
Tüm belgeleri bağlam penceresine doldurmak yerine RAG, her şeyi ayrı ayrı depolar ve yalnızca mevcut soru için önemli parçaları getirir. Bu, bağlamı küçük tutarken modelin ihtiyaç duyduğu tüm bilgiyi sağlamaya devam eder.
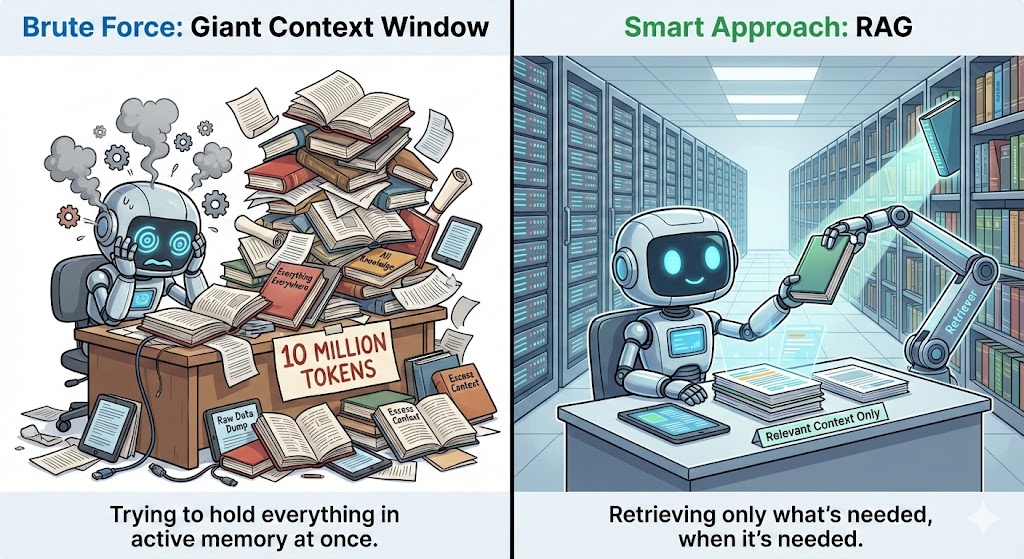
Bunu, en ilgili parçaları bulmak için gömme (embedding) veya vektör aramayı kullanarak ve bu parçaları modele temiz, yapılandırılmış bir şekilde göndererek yapar. Bu, modelin eğitim verilerinin ötesindeki ilgili ek bilgileri kullanmasını sağlayarak doğruluğu artırır.
Bağlam mühendisliği, modelleri gereksiz ayrıntılarla bunaltmak yerine onlara ilgili bilgi vermeye odaklanır. Etkili stratejiler arasında uzun belgeleri bölümlere ayırmak, düşük değerli bölümleri özetlemek ve ana noktaları vurgulamak için hafif önişleme adımları kullanmak yer alır.
Anlamsal arama, mevcut sorgu için önemli olan metni belirleyerek burada yardımcı olur. Ayrıca, modellerin bu kısımları daha iyi hatırlama eğiliminde olduğu için en kritik bilgileri bağlamın başına veya sonuna taşıyarak sonuçları iyileştirebilirsiniz.
Parçalara ayırma (chunking), uzun belgeleri daha küçük, tutarlı bölümlere böler. Amaç; içeriği konusu, yapısı veya desteklediği görev temelinde gruplamaktır.
Bu, her parçayı tutarlı tutar ve modelin dev bir metin bloğu içinde kaybolmak yerine odaklanmasına yardımcı olur. Daha fazlasını öğrenmek isterseniz, ileri düzey parçalara ayırma stratejileri hakkındaki bu makaleye göz atabilirsiniz.
Anlamsal parçalara ayırma, metni rastgele karakter sınırlarında bölmek yerine benzer anlamı paylaşan cümleleri bir araya getirir. İçeriği konu değişimleri, paragraf geçişleri veya bölüm başlıkları gibi doğal kırılma noktalarından ayırır.
Görev tabanlı parçalara ayırma ise bir adım daha ileri giderek her parçayı yanıtlamaya çalıştığınız belirli soruya göre şekillendirir. Böylece her bölüm, gerçekten o görevle ilgili bilgileri içerir.
Tam belge analizi, çoklu dosya akıl yürütmesi veya uzun süreli sohbetleri içeren görevler, 200 bin–1 milyon aralığındaki pencerelere sahip modellerden yararlanır. Özetleme, kod inceleme veya kısa biçimli soru-cevap gibi daha odaklı görevler içinse 100 bin–200 bin aralığındaki modeller genellikle hız, maliyet ve doğruluk arasında en iyi dengeyi sunar.
Daha küçük pencereler, güçlü getirme sistemleriyle eşleştirildiğinde yine de iyi performans gösterebilir. İyi bir RAG sistemi veya Model Context Protocol (MCP), gereken bilgiyi talep üzerine çekebilir; böylece modelin her şeyi belleğinde tutmasına gerek kalmaz.
Bitirmeden önce, bağlam pencereleri açısından teknolojinin nereye gittiğine bir göz atalım.
Geleceğin model mimarileri, sabit boyutlu pencereler yerine dinamik bağlam pencerelerine doğru ilerliyor.
Araştırmacılar, transformerların güçlü yönlerini yeni uzun menzilli bellek sistemleriyle harmanlayan yaklaşımları araştırıyor; böylece yalnızca dikkat mekanizmalarına dayanmak zorunda kalmadan bilgi depolayıp geri çağırabilen modeller ortaya çıkıyor.
Bu mimariler, statik bağlam pencerelerinden göreve göre büyüyen dinamik bellek katmanlarına geçerek bugünün sınırlarını aşıyor.
Bellek sistemleri de bir diğer yenilik alanı. Gelecekteki modellerin, tek bir oturumun ötesine uzanan ve zaman içinde süreklilik sağlayan bağlam farkında bellek sistemlerine daha fazla dayanması bekleniyor.
Her sohbeti sıfırdan başlıyormuş gibi ele almak yerine bu sistemler, kilit tercihleri, geçmiş kararları ve yinelenen temaları yapılandırılmış bir bellek katmanında saklar ve ilgili olduğunda geri çağırır.
Bu, kişiselleştirmeyi tepkiselden proaktife taşıyarak modelin kullanıcıları daha bütünsel şekilde anlamasını ve uzun vadeli hedefleri çok daha tutarlı biçimde desteklemesini sağlar.
Haricî getirme de evriliyor. Günümüzde RAG, bir arama motoru gibi çalışarak ilgili metni komuta dâhil ediyor. Düzeltici Getirme Artırmalı Üretim (CRAG) gibi gelişmiş sürümler çoktan ortaya çıktı; ancak bu sadece başlangıç.
Gelecekte getirme, modele kendi haricî belleği varmış gibi daha yerleşik hissi verecek. Bilgiyi otomatik olarak toplayacak, sıkıştıracak ve asgari kullanıcı müdahalesiyle yeniden yüzeye çıkaracaklar.
Kalıcı bellek, yapay zekâ ile etkileşimimizi de değiştirecek. Oturum sona erdiğinde her şeyi unutmak yerine model, günler, haftalar hatta aylar boyunca önemli ayrıntıları hatırlayacak. Sizin tarzınızı, alışkanlıklarınızı ve önceliklerinizi öğrendikçe, kendini tekrar etmenize gerek kalmadan daha kişiye özel ve faydalı yanıtlar sunabilecek.
Mem0 gibi araçlar bu yaklaşımın öncülüğünü şimdiden yapıyor; uygulamalar ile LLM’ler arasında özel bir bellek katmanı olarak görev yapıyor. Ancak ileriye dönük olarak, bu yeteneklerin haricî katmanlara dayanmak yerine doğrudan model mimarilerine daha fazla yerleştiğini görmeyi bekliyoruz.
Daha büyük pencereler güçlü yeni iş akışlarının kapısını açar; ancak bağlam aşırı yüklendiğinde dikkatle ilgili zorluklar, daha yüksek hesaplama maliyetleri ve kalite risklerini de beraberinde getirir. Bu da stratejik bağlam yönetimini zorunlu kılar.
Getirme artırma, anlamsal parçalara ayırma ve bağlam mühendisliği gibi teknikler, modellerin kapasiteleri genişledikçe odaklı, verimli ve güvenilir kalmasına yardımcı olur.
İleriye baktığımızda, en iyi LLM destekli sistemler akıllı araçları ve bağlamın akıl yürütmeyi nasıl etkilediğine dair sağlam bir anlayışı birleştirir. Bu ilkeleri uygulayarak ekipler, uzun bağlamlı modellerin faydalarını yakalayabilir ve bağlam sınırlarını daha da zorlayan bir sonraki mimari nesline hazırlanabilir.
Python temellerinizi bir üst seviyeye taşıyın the Developing Large Language Models yetkinlik yoluyla. Bu yol, sizi temel koddan kendi güçlü yapay zekâ uygulamalarınızı oluşturmaya ve ince ayar yapmaya kadar yönlendirmek üzere tasarlanmıştır.
LLM Kursları
Kurs
Program
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



