
Last chance! 50% off DataCamp Premium
Sale ends in
Model machine learning (ML) adalah implementasi berbasis komputer dari metode statistik dan probabilistik. Secara umum, model ini mengadopsi salah satu dari dua pendekatan: pemodelan generatif atau diskriminatif.
Dalam artikel ini, kami memberikan gambaran umum tentang model generatif dan diskriminatif, memperkenalkan model umum dari masing-masing jenis, menjelaskan prinsip matematis di balik kedua pendekatan, dan membahas contoh praktis dari jenis masalah yang dapat ditangani oleh masing-masing tipe model.
Diberikan sekumpulan titik data contoh, D, dan label terkaitnya, L, sebuah model generatif mempelajari distribusi probabilitas gabungan P(D, L). Model ini kemudian menggunakan distribusi dasar tersebut untuk menghasilkan data baru yang mirip dengan contoh pelatihan atau menyelesaikan masalah klasifikasi.
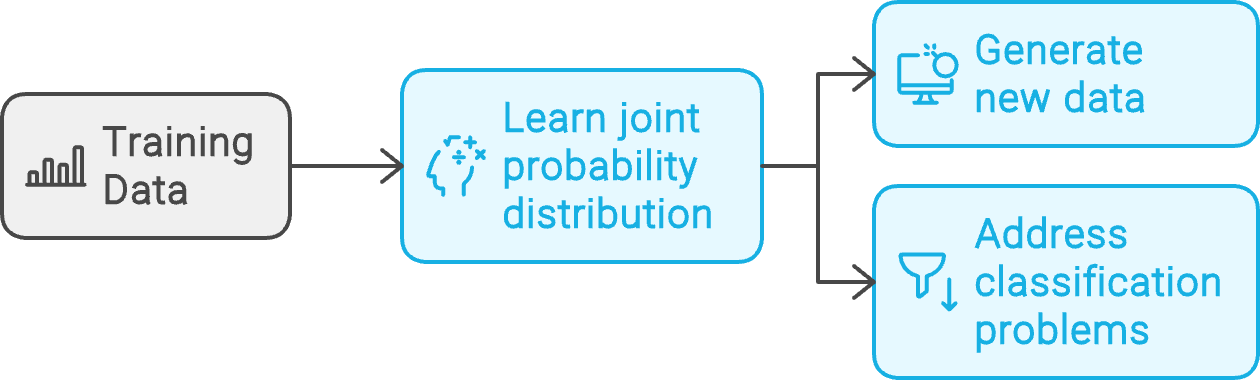
Alur kerja model generatif. Dibuat dengan napkin.ai
Bagian berikut menjelaskan dasar-dasar model generatif disertai contoh.
Model Naive Bayes didasarkan pada teorema Bayes. Teorema ini memberikan probabilitas bersyarat P(A | B) dari suatu peristiwa A ketika diketahui bahwa peristiwa B benar. Ini disebut probabilitas posterior dari A jika diberikan B.
Secara terpisah, probabilitas P(A) dari peristiwa A disebut probabilitas prior. Model Naive Bayes berasumsi bahwa A dan B adalah peristiwa independen—karena itu diberi awalan “naive”. Jika A dan B saling bergantung, teorema Bayes tradisional tidak lagi berlaku, dan model Naive Bayes bukanlah pilihan yang tepat.
Model Bayesian bersifat generatif karena memodelkan distribusi probabilitas gabungan. Proses pelatihan mempelajari probabilitas gabungan—P(A, B). Setelah dilatih, model dapat digunakan untuk memprediksi nilai A dengan probabilitas tertinggi P(A). Selain itu, model Bayesian juga dapat digunakan untuk klasifikasi karena dapat menghitung probabilitas bersyarat (menggunakan kaidah Bayes).
Untuk mempelajari penggunaan model naive Bayes secara praktis, ikuti tutorial tentang membangun model Naive Bayes menggunakan scikit-learn dan Python.
Gaussian mixture models (GMM) adalah kelas model campuran. Premis uniknya adalah bahwa data dasar menggabungkan beberapa distribusi statistik, bukan satu distribusi tunggal.
Dalam GMM, populasi diasumsikan merupakan kombinasi dari subpopulasi yang berbeda, yang masing-masing berupa distribusi Gaussian. Secara efektif, distribusi data dianalisis sebagai rataan tertimbang dari beberapa distribusi Gaussian individual.
GMM menangkap distribusi probabilitas dari dataset yang mendasari. Karena itu, GMM digunakan untuk tugas seperti analisis outlier dan klasifikasi tanpa pengawasan. Tugas-tugas ini melibatkan pembangunan model statistik populasi dengan memperlakukan dataset pelatihan sebagai sampel acak.
Kursus tentang model campuran di R membahas detail praktis GMM.
Generative adversarial network (GAN) adalah model berbasis jaringan saraf. Model ini terdiri dari dua bagian: generator dan discriminator. Jaringan generator dilatih untuk menghasilkan vektor yang mirip dengan contoh pelatihan, sementara discriminator dilatih untuk membedakan antara contoh asli dan yang dihasilkan oleh generator.
Intinya, generator dan discriminator memiliki tujuan pelatihan yang berlawanan, sehingga bersifat “adversarial”. Karena itu, kata “adversarial” digunakan dalam namanya.
Generator dan discriminator dilatih bersama dalam loop pelatihan yang sama. Seiring generator semakin baik dalam membuat contoh yang realistis, discriminator membedakan contoh asli dari yang dihasilkan. Pelatihan berlanjut hingga generator mampu menghasilkan contoh yang begitu mirip dengan data pelatihan sehingga discriminator tidak dapat membedakannya.
Setelah pelatihan, generator digunakan untuk menghasilkan data sintetis realistis yang mirip dengan contoh asli.
Hidden Markov model (HMM) bekerja dengan dataset berurutan. Proses Markov (atau rantai Markov) digunakan untuk memodelkan data berurutan. Premis model Markov adalah bahwa elemen berikutnya, xn+1, dalam urutan hanya bergantung pada elemen sebelumnya, xn, dan tidak pada elemen lain, {x1, x2, ... xn-1}, sebelumnya. Model Markov berasumsi bahwa dataset berurutan dapat direpresentasikan oleh proses Markov dengan state tersembunyi.
State ini menghasilkan elemen berikutnya dalam urutan:
Model Markov direpresentasikan dengan probabilitas transisi (berpindah dari satu state ke state lain) dan probabilitas emisi (menghasilkan elemen urutan tertentu jika diberikan state tertentu).
HMM memodelkan dataset pelatihan sebagai proses Markov. Tujuan pelatihan adalah menentukan probabilitas transisi dan emisi untuk memaksimalkan probabilitas menghasilkan urutan dalam dataset contoh. Dengan demikian, diberikan suatu urutan, model Markov terlatih dapat menghasilkan elemen-elemen berikutnya dari urutan tersebut.
Untuk mempelajari implementasinya secara praktis, ikuti tutorial tentang rantai Markov di Python.
Diberikan dataset pelatihan yang terdiri dari titik data, D, dan label terkaitnya, L, model diskriminatif mempelajari distribusi probabilitas bersyarat P(D | L). Model ini kemudian menggunakan distribusi probabilitas bersyarat ini untuk memprediksi kelas dari titik data baru.
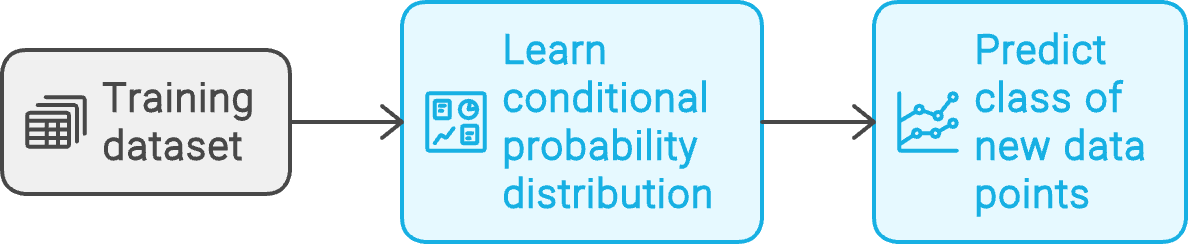
Alur kerja model diskriminatif. Dibuat dengan napkin.ai
Model diskriminatif umumnya digunakan untuk menyelesaikan masalah klasifikasi. Contoh berikut menunjukkan kasus penggunaannya.
K-nearest neighbors (KNN) adalah salah satu model machine learning yang lebih lama. Model ini didasarkan pada premis bahwa, dalam suatu distribusi titik data, item yang serupa terletak berdekatan.
Model KNN bersifat nonparametrik, tanpa parameter seperti koefisien regresi. Model ini digunakan untuk masalah klasifikasi dan regresi.
Kategori dari suatu titik data masukan sama dengan k tetangga terdekatnya. Nilai prediksi dari suatu titik data adalah nilai rata-rata dari k tetangga terdekatnya. k (jumlah tetangga terdekat yang dipertimbangkan) dapat dianggap sebagai hiperparameter model. Ini digunakan untuk menyetel perilaku model, tetapi tidak secara langsung memengaruhi keluaran model.
Regresi logistik, seperti regresi linier, mencoba memprediksi nilai variabel dependen berdasarkan satu atau lebih variabel independen. Dalam regresi linier, variabel dependen bernilai kontinu. Dalam regresi logistik, variabel dependen bernilai diskrit, seperti:
Regresi linier memprediksi nilai numerik. Dalam regresi logistik, besaran yang diprediksi adalah logaritma dari rasio odds.
Untuk suatu peristiwa A, dengan probabilitas P(A), rasio odds adalah P(A) / (1 - P(A)). Menggunakan logaritma (dari rasio odds) menghasilkan konvergensi yang lebih mulus dan lebih cepat selama proses pelatihan. Mengingat kemampuannya memisahkan masukan ke dalam kelas, model logistik digunakan untuk tujuan diskriminatif.
Untuk pengenalan yang lebih praktis tentang topik ini, lihat panduan tentang regresi logistik di Python.
Anda juga dapat mengimplementasikan regresi logistik menggunakan R, bahasa pemrograman berorientasi statistik, sebagaimana dijelaskan dalam tutorial tentang regresi logistik menggunakan R.
Support vector machines menentukan garis optimal yang memisahkan titik data dari kelas yang berbeda. Dalam bidang 2 dimensi X-Y, diberikan sekumpulan titik data dari dua kategori berbeda, SVM memprediksi sebuah garis yang (idealnya) secara bersih memisahkan titik dari satu kategori dengan kategori lainnya.
Garis ini adalah batas keputusan. Garis ini menjadi sebuah hiperbidang untuk data dengan tiga dimensi atau lebih. Titik data (dari salah satu kategori) yang terletak paling dekat dengan garis imajiner ini disebut support vector model. Titik-titik data ini paling sulit diklasifikasikan karena nilainya berdekatan.
Jarak antara garis pemisah dan support vector disebut margin. Pelatihan SVM bertujuan menemukan batas keputusan yang memaksimalkan margin ini. Dalam praktiknya, titik data memiliki lebih dari dua dimensi, dan garis pemisah tersebut adalah hiperbidang berdimensi lebih tinggi.
SVM juga digunakan untuk masalah klasifikasi multikelas.
Untuk mempelajari lebih lanjut tentang SVM, ikuti panduan membangun SVM menggunakan paket scikit-learn di Python. Selain Python, Anda juga dapat menggunakan R untuk mengimplementasikan SVM, seperti dibahas dalam panduan SVM di R.
Decision tree terdiri atas sejumlah node keputusan yang disusun dalam struktur seperti pohon.
Node paling atas adalah akar (root). Node yang menghasilkan keluaran final disebut leaf node atau terminal node. Node non-leaf di tengah disebut node internal. Keluaran dari node root diteruskan ke node perantara. Hasil (keluaran) tiap node merupakan keluaran akhir atau mengarah (bercabang) ke node lain.
Setiap node pada pohon membagi dataset berdasarkan atribut tertentu. Misalnya, decision tree untuk persetujuan aplikasi pinjaman mungkin memiliki node untuk memisahkan aplikasi berdasarkan pendapatan bersihnya.
Proses pelatihan menentukan nilai ambang yang sesuai untuk setiap keputusan. Misalnya, aplikasi dengan pendapatan bersih di bawah jumlah tertentu langsung ditolak. Sisanya diproses lebih lanjut di node berikutnya, yang mempertimbangkan atribut lain, seperti kekayaan bersih.
Untuk panduan praktik tentang decision tree, ikuti tutorial membangun decision tree menggunakan Python, atau kursus lengkap tentang machine learning dengan model berbasis pohon di Python.
Kelemahan utama decision tree adalah overfitting, yang menimbulkan masalah pada data di luar sampel. Decision forest mencoba mengatasi masalah ini. Decision forest terdiri atas banyak pohon. Berbeda dari decision tree tunggal, yang harus mempertimbangkan keseluruhan himpunan fitur, setiap pohon dalam forest hanya menemukan subset acak dari himpunan fitur. Keacakan ini membantu mengatasi varians pada dataset yang berisik.
Keluaran forest diperoleh dengan menggabungkan, misalnya dengan merata-ratakan, keluaran dari masing-masing pohon.
Untuk mempelajari cara mengimplementasikan random forest, lihat panduan menggunakan scikit-learn untuk membangun classifier random forest.
Jaringan saraf terdiri dari kelompok neuron. Setiap neuron mengimplementasikan fungsi linier yang mengalikan bobot neuron dengan vektor masukan.
Fungsi aktivasi nonlinier mengikuti fungsi linier tersebut. Fungsi aktivasi menentukan keluaran setiap neuron berdasarkan keluaran fungsi linier. Dengan demikian, jaringan saraf sederhana secara konseptual dapat dipandang sebagai serangkaian persamaan linier yang disaring oleh aktivasi nonlinier.
Lapisan input dari jaringan saraf mengalikan masukan (direpresentasikan sebagai vektor) dengan serangkaian bobot dan fungsi aktivasi. Keluaran ini diteruskan ke lapisan berikutnya, yang melakukan operasi serupa.
Lapisan tersembunyi berada di antara lapisan input dan output . Lapisan tersembunyi terakhir memasok ke lapisan keluaran. Masalah kompleks melibatkan penggunaan jaringan saraf dengan banyak lapisan tersembunyi, yang disebut deep neural networks (DNN).
Dalam masalah klasifikasi, pendekatan umum adalah memiliki jumlah neuron keluaran sebanyak jumlah kelas. Kelas yang diprediksi sesuai dengan neuron yang nilainya tertinggi. Dalam masalah regresi, satu neuron keluaran memuat keluaran yang diprediksi. Hubungan linier antar-neuron memodelkan persamaan regresi linier.
Untuk pemahaman yang lebih mendalam tentang topik ini, lihat posting blog tentang jaringan saraf.
Beberapa tugas, seperti klasifikasi, dapat diselesaikan menggunakan salah satu tipe model. Namun secara umum, model diskriminatif dan generatif sering memiliki kasus penggunaan yang unik, karena model ini mengadopsi pendekatan matematis yang berbeda. Memahami perbedaan ini dan bagaimana pengaruhnya terhadap kesesuaian masing-masing kategori model untuk berbagai masalah adalah hal yang perlu.
Model generatif memprediksi nilai berikutnya dalam sebuah urutan atau menghasilkan gambar berdasarkan teks (atau sebaliknya). Untuk melakukan tugas semacam itu, model harus mempelajari keluaran apa yang harus dihasilkan untuk berbagai masukan. Model menggunakan distribusi probabilitas gabungan dari input dan output.
Untuk memahami matematika yang mendasarinya, mari mulai dengan contoh sederhana. Perilaku satu variabel acak dijelaskan oleh fungsi kerapatan probabilitas (PDF).
PDF dari variabel acak X dapat digunakan untuk menentukan probabilitas X pada nilai berbeda. Misalnya, jika PDF dari X adalah f(x), probabilitas bahwa X berada antara A dan B diberikan oleh:

Probabilitas X di seluruh rentang adalah 1. Ini dinyatakan sebagai:

Ekspresi di atas juga dapat ditulis sebagai:
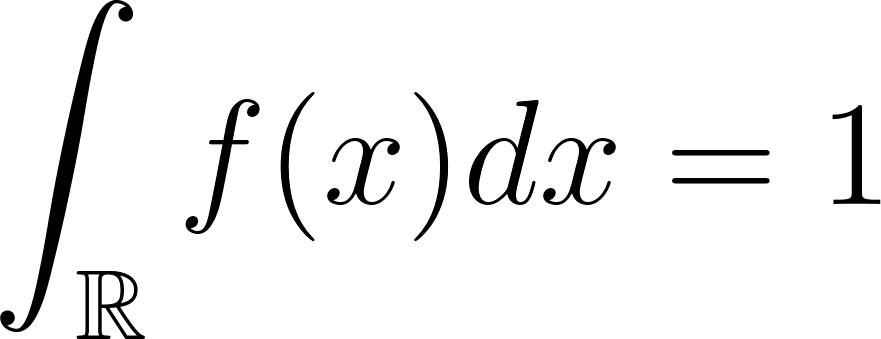
Untuk PDF gabungan dari dua variabel, X dan Y, integral di seluruh rentang adalah 1:

Distribusi probabilitas gabungan memetakan seluruh ruang probabilitas dari X dan Y. Untuk mengevaluasi probabilitas bahwa probabilitas gabungan P(X, Y) berada dalam suatu region G, integralkan PDF gabungan di atas G:

Model diskriminatif, sebaliknya, hanya berfokus pada distribusi probabilitas bersyarat. Jika diperlukan, model generatif memperkirakan probabilitas bersyarat menggunakan probabilitas marginal.
Diberikan distribusi probabilitas gabungan fXY(x,y), probabilitas marginal dari variabel acak Y pada nilai y (untuk semua nilai X) diberikan sebagai:
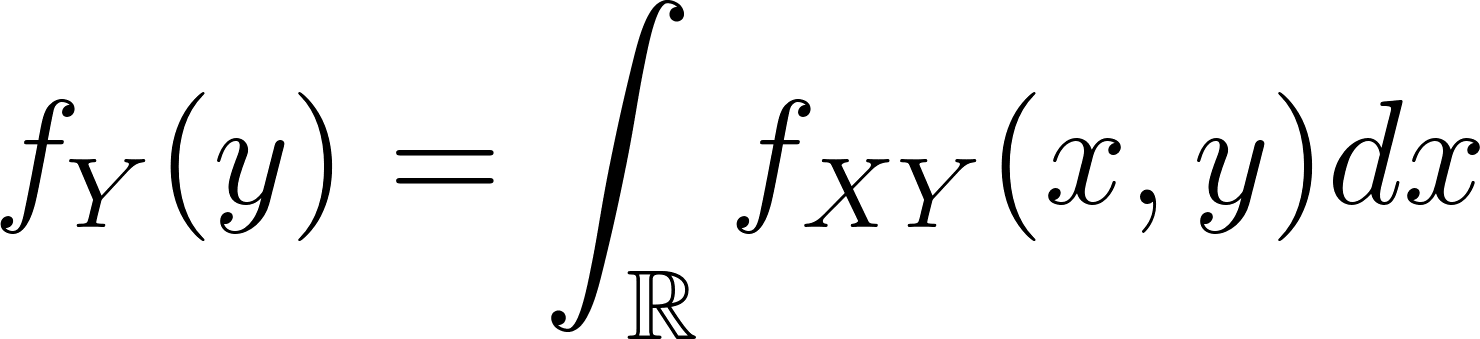
Serupa dengan kaidah Bayes, PDF bersyarat dari X kemudian diekspresikan sebagai:
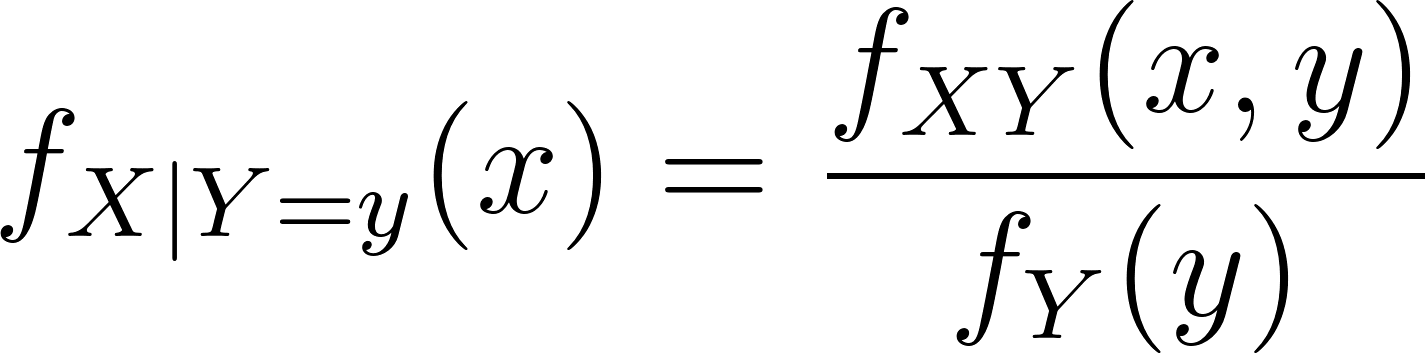
Ekspresi di atas menunjukkan versi integral dari probabilitas bersyarat, yang lebih umum ditulis sebagai:
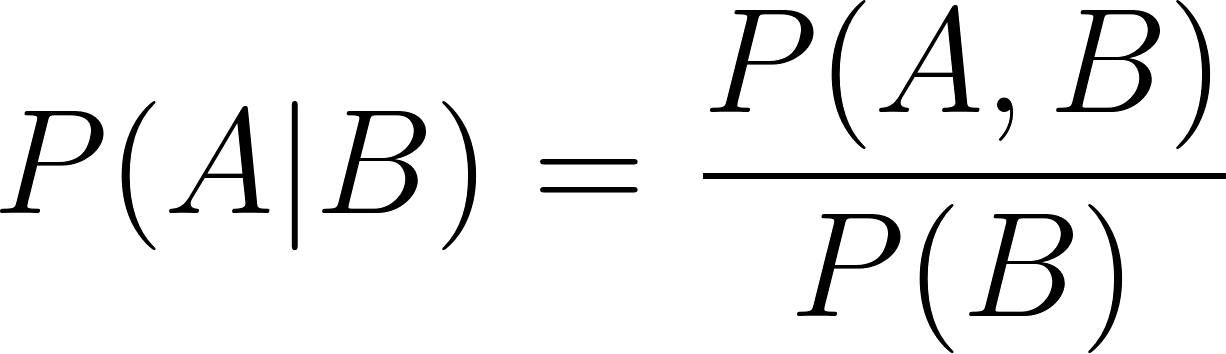
Serupa,
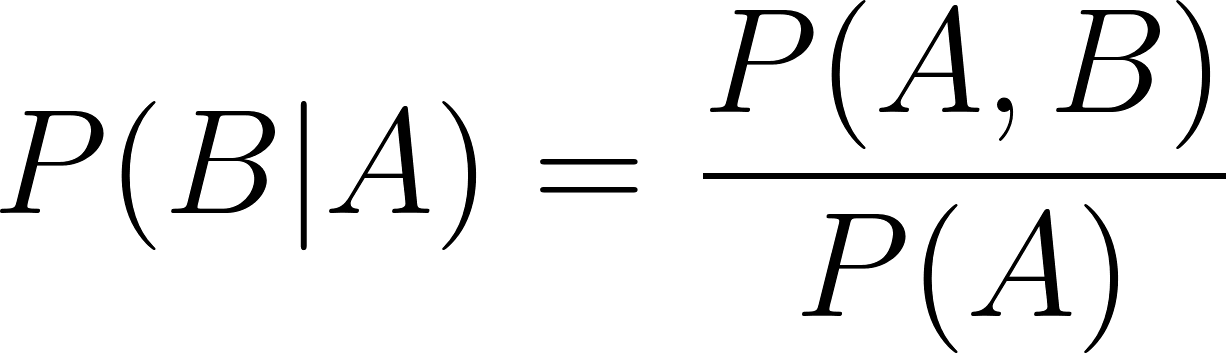
Dalam dua rumus probabilitas bersyarat di atas:
Untuk menghitung probabilitas bersyarat, model generatif mengikuti dua langkah:
Di sisi lain, model diskriminatif mengikuti satu langkah (yang lebih sederhana):
Model generatif memiliki probabilitas marginal P(A) dan P(B) serta PDF gabungan P(A, B). Dengan menggunakan ini, model dapat mengevaluasi P(A | B) atau P(B | A) dengan mudah. Inilah gagasan dasar di balik pengklasifikasi naive Bayes. Dengan demikian, model generatif dapat melakukan tugas seperti:
Hal ini membuat model generatif fleksibel dan serbaguna. Di sisi lain, model ini secara inheren melibatkan lebih banyak kompleksitas selama pelatihan karena:
Sebaliknya, model diskriminatif hanya berkaitan dengan probabilitas bersyarat. Berdasarkan dataset pelatihan, dimungkinkan untuk memperkirakan probabilitas bersyarat secara langsung tanpa memperkirakan probabilitas gabungan atau marginal.
Dengan demikian, model diskriminatif lebih sederhana untuk dilatih. Namun, model diskriminatif yang telah mempelajari probabilitas bersyarat P(A | B) hanya dapat melakukan tugas yang melibatkan probabilitas bersyarat tersebut. Model ini tidak dapat melakukan hal lain.
Model generatif cukup fleksibel untuk tugas generatif maupun diskriminatif. Selama pelatihan, model mempelajari PDF gabungan dan marginal. Selama inferensi, model harus menghitung probabilitas bersyarat menggunakan distribusi gabungan dan probabilitas marginal yang sesuai. Karena itu, inferensi pada tugas diskriminatif menjadi lebih lambat.
Model diskriminatif, di sisi lain, telah langsung (secara numerik) mempelajari probabilitas bersyarat. Mereka memperkirakan probabilitas bersyarat dalam satu langkah berdasarkan data masukan saat inferensi.
Lebih jauh lagi, karena model diskriminatif hanya berfokus pada pengestimasian satu besaran (probabilitas bersyarat), model ini cenderung lebih akurat. PDF gabungan memiliki ketidakpastian lebih banyak yang melekat dibandingkan probabilitas bersyarat sederhana. Ketidakpastian tambahan ini tercermin dalam akurasi yang relatif lebih rendah dari model generatif untuk tugas klasifikasi.
Berdasarkan pembahasan pada bagian sebelumnya, tabel di bawah ini merangkum perbedaan antara model generatif dan diskriminatif.
|
Model generatif |
Model diskriminatif |
|
|
Tujuan |
Menangkap probabilitas gabungan dan probabilitas marginal. Menggunakan kaidah Bayes untuk menghitung probabilitas bersyarat. |
Hanya menangkap probabilitas bersyarat. Tidak ada informasi tentang probabilitas gabungan atau marginal. |
|
Pembuatan data |
Dapat menghasilkan titik data baru berdasarkan dataset pelatihan. Misalnya, model yang dilatih pada digit tulisan tangan dapat menghasilkan digit sintetis baru. |
Tidak dapat menghasilkan titik data baru. Utamanya berfokus membedakan antar kategori data. |
|
Kasus penggunaan utama |
Dapat digunakan untuk tugas generatif (mis., sintesis data) dan tugas diskriminatif (mis., klasifikasi). |
Hanya dapat digunakan untuk tugas diskriminatif seperti klasifikasi atau regresi. |
|
Kinerja inferensi |
Menjalankan inferensi lebih lambat karena memerlukan komputasi kompleks. Bahkan tugas sederhana pun memerlukan perhitungan probabilitas marginal dan gabungan serta penerapan kaidah Bayes. |
Inferensi lebih cepat karena langsung menghitung probabilitas bersyarat tanpa melibatkan kaidah Bayes. |
|
Penanganan data hilang |
Lebih baik dalam menangani data yang hilang dengan memodelkan distribusi probabilitas yang mendasari, sehingga lebih mudah untuk “mengisi kekosongan”. Risiko overfitting lebih rendah. |
Kurang efektif dalam menangani data yang hilang. Risiko overfitting lebih tinggi karena model berfokus menemukan hiperbidang pemisah antar kelas. |
|
Konvergensi |
Cenderung konvergen lebih cepat dan dengan lebih sedikit contoh pelatihan namun umumnya menghasilkan galat model yang lebih tinggi, terutama dalam tugas klasifikasi, karena perhitungan probabilitas bersyarat dilakukan secara tidak langsung melalui pemodelan distribusi probabilitas gabungan. |
Umumnya membutuhkan lebih banyak data untuk dilatih dan mungkin konvergen lebih lambat. Namun, hasilnya adalah galat model lebih rendah, terutama dalam tugas klasifikasi, karena secara langsung memodelkan probabilitas bersyarat tanpa mengestimasi distribusi probabilitas gabungan. |
|
Kompleksitas model |
Biasanya lebih kompleks karena memodelkan seluruh distribusi data, termasuk interaksi antara fitur dan label. |
Umumnya lebih sederhana karena hanya perlu memodelkan batas keputusan atau hiperbidang pemisah antar kelas. |
|
Contoh model |
Naive Bayes, Hidden Markov Models (HMM), Generative Adversarial Networks (GAN), Variational Autoencoders (VAE). |
Regresi Logistik, Support Vector Machines (SVM), Jaringan Saraf, dan Decision Tree. |
|
Fleksibilitas model |
Lebih fleksibel dari sisi aplikasi (dapat menangani tugas generatif dan diskriminatif). |
Kurang fleksibel (terbatas pada tugas diskriminatif). |
|
Tingkat galat |
Tingkat galat lebih tinggi dalam tugas klasifikasi karena metode estimasi tidak langsung. |
Tingkat galat lebih rendah dalam tugas klasifikasi karena pelatihan langsung pada probabilitas bersyarat. |
Sesuai namanya, model generatif sangat cocok untuk tugas yang melibatkan pembuatan data baru yang sesuai dengan pola dalam data pelatihan.
Beberapa kasus penggunaan umum dari model ini adalah:
Untuk banyak model visi komputer, memiliki dataset gambar pelatihan yang besar sangatlah penting. Model ini perlu dilatih pada banyak variasi dari gambar atau fitur yang sama.
Memotret objek yang sama dari sudut, latar belakang, atau corak warna yang berbeda tidak selalu realistis. Banyak dataset gambar khusus tugas juga cenderung berukuran terbatas karena pembuatannya memerlukan keahlian khusus domain. Misalnya, Anda memerlukan akses ke ahli pulmonologi, laboratorium radiologi, serta pasien dan rumah sakit yang bersedia untuk membuat kumpulan gambar rontgen penyakit paru tertentu.
Dalam kasus seperti itu, opsi paling pragmatis adalah membuat dataset kecil yang sangat terkurasi dan relevan, lalu secara sintetis menghasilkan titik data baru yang mirip dengan dataset asli.
Menghasilkan gambar baru berdasarkan deskripsi teks atau menghasilkan teks baru berdasarkan beberapa masukan teks. Satu-satunya kelas model yang dapat menangani tugas seperti ini adalah model generatif.
Model pembangkitan gambar seperti DALL-E, MidJourney, dan Stable Diffusion rutin digunakan untuk menghasilkan gambar yang sesuai dengan deskripsi spesifik dan tidak melanggar hak cipta yang ada.
Demikian pula, LLM sering digunakan untuk membuat alur cerita fiksi, slogan dan tagline pemasaran, ringkasan dokumen, dan materi serupa lainnya.
Model generatif digunakan untuk tugas yang didasarkan pada distribusi probabilitas gabungan dari data yang mendasari. Memodelkan distribusi gabungan imbal hasil aset untuk memprediksi profil risiko dan imbal hasil yang diharapkan dari suatu portofolio investasi adalah hal yang lazim dalam keuangan dan manajemen risiko.
Sebagai contoh, seorang manajer investasi mungkin ingin mengetahui probabilitas harga dua saham berbeda naik atau turun pada waktu yang sama—PDF gabungan dapat menjawab pertanyaan semacam itu.
Industri jasa keuangan telah menggunakan metode statistik ini jauh sebelum istilah “model generatif” banyak diadopsi.
Masalah seperti klasifikasi tanpa pengawasan sangat cocok untuk Gaussian mixture models. Dalam masalah ini, Anda memiliki kumpulan besar titik data tetapi tidak mengetahui berapa banyak atau apa kategori yang dimiliki titik data tersebut. Masuk akal untuk mengharapkan bahwa data berasal dari kombinasi distribusi, yang dapat dimodelkan oleh GMM.
Jika jumlah dan daftar kategori telah diketahui sebelumnya, metode diskriminatif akan lebih tepat.
GMM juga berguna dalam analisis outlier (deteksi anomali, deteksi penipuan, dll.), di mana data “biasa”, seperti perilaku kelompok pelanggan yang berbeda, dapat dimodelkan sebagai kombinasi distribusi yang berbeda. Titik data anomali adalah yang berbeda secara signifikan dari pola lainnya.
Masalah yang melibatkan urutan sering diselesaikan menggunakan hidden Markov models. Salah satu contoh penggunaan sehari-hari adalah pemodelan urutan genom dan resekuensing.
HMM juga digunakan dalam pengenalan ucapan, membantu memprediksi suku kata berikutnya berdasarkan urutan suku kata sebelumnya. Pemodelan urutan juga lazim untuk aplikasi logistik seperti jadwal pengiriman paket. Demikian pula, penularan dan penyebaran penyakit menular sering dimodelkan menggunakan rantai Markov.
Secara matematis, model diskriminatif digunakan untuk aplikasi di mana hanya probabilitas bersyarat yang relevan dan bukan probabilitas gabungan. Dengan demikian, model diskriminatif biasanya digunakan untuk masalah klasifikasi dan prediksi.
Beberapa contohnya adalah:
Masalah klasifikasi terawasi, di mana kelas (kategori) telah diketahui sebelumnya. Ini adalah kasus penggunaan khas untuk KNN dan SVM.
Anda memiliki kumpulan besar titik data, seperti data perilaku pelanggan, termasuk pola pengeluaran, jumlah pembelian, frekuensi pembelian, riwayat pengembalian, dan seterusnya. Anda perlu menggunakan informasi ini untuk mengklasifikasikan daftar pelanggan ke dalam kategori berbeda, seperti pembelanja besar, pemburu diskon, pelanggan reguler, pelanggan tidak serius, dan lain-lain. Bandingkan dengan masalah klasifikasi tanpa pengawasan, di mana, seperti dibahas sebelumnya, GMM umum digunakan.
Dalam tugas prediktif seperti klasifikasi dan regresi, prioritasnya sering kali adalah kecepatan dan akurasi. Secara prinsip, model generatif juga mampu menyelesaikan masalah semacam ini.
Khususnya, model generatif lebih disukai ketika ada masalah seperti titik data yang hilang, hanya tersedia dataset terbatas untuk pelatihan, atau ketika Anda memperkirakan akan sering menambahkan kategori baru.
Namun, untuk sebagian besar kasus penggunaan standar, model generatif mengalami tingkat galat lebih tinggi dan inferensi yang lebih lambat dalam tugas prediktif karena perhitungannya melibatkan distribusi probabilitas gabungan. Oleh karena itu, untuk masalah klasifikasi dan regresi standar, di mana tersedia dataset pelatihan yang besar dan sehat, model diskriminatif menjadi pilihan yang disukai karena karakteristik kinerjanya yang lebih baik.
Model diskriminatif lebih disukai untuk tugas yang hanya berfokus pada hasil klasifikasi dan bukan pada pemodelan data yang mendasari.
Misalnya, jika Anda ingin mengategorikan rekaman audio ke dalam bahasa masing-masing, Anda tidak memerlukan model yang memahami bahasa dan tata bahasanya. Model pengenalan ucapan akan berlebihan untuk masalah klasifikasi. Cukup fokus pada batas keputusan menggunakan model diskriminatif. Jadi, Anda dapat menggunakan jaringan saraf sederhana alih-alih sebuah LLM atau regresi logistik alih-alih model Bayesian.
Keputusan bertahap, di mana tiap langkah melibatkan pilihan yang tidak ambigu, merupakan kandidat yang baik untuk decision tree. Decision tree sering digunakan sebagai penyaring awal untuk menyeleksi titik data yang memerlukan analisis lebih dalam.
Sebagai contoh, pertimbangkan deteksi penipuan, yang sering diselesaikan menggunakan model kompleks seperti GMM. Manusia hampir selalu menyelidiki transaksi berisiko tinggi, apa pun model yang digunakan. Jadi, pendekatan alternatif adalah menggunakan decision tree untuk menandai daftar transaksi yang berpotensi curang untuk penyelidikan manual lebih lanjut.
Decision tree juga digunakan dalam banyak operasi bisnis. Tujuannya adalah menentukan tindakan yang tepat berdasarkan kondisi yang telah ditentukan. Tugas seperti ini tidak memerlukan model generatif maupun model diskriminatif yang lebih kompleks seperti jaringan saraf.
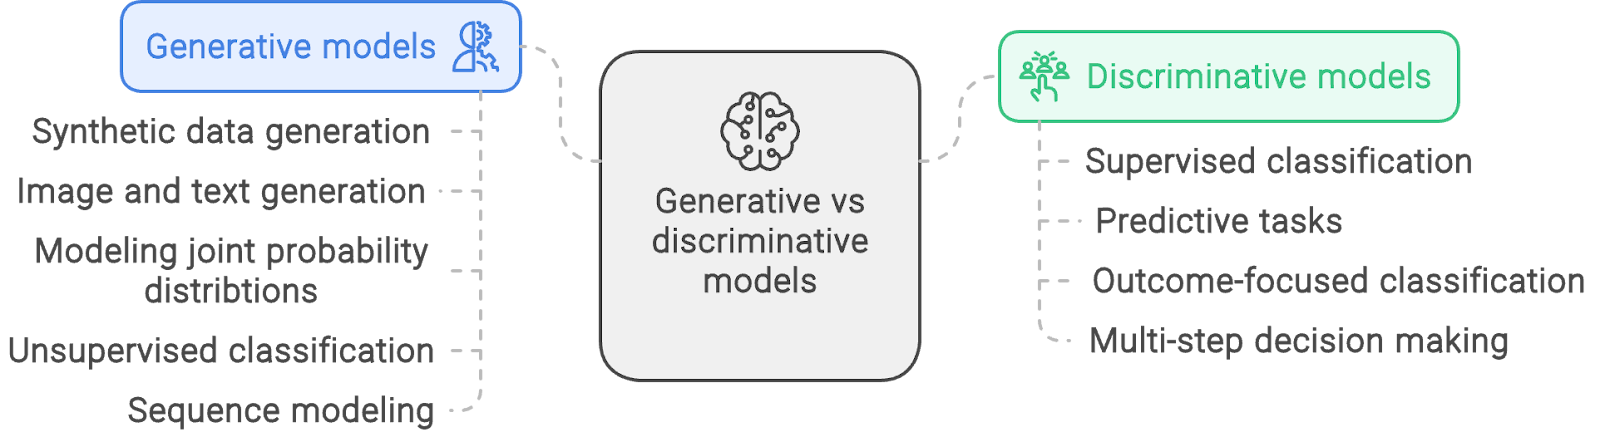
Contoh aplikasi model generatif vs. diskriminatif. Dibuat dengan napkin.ai
Artikel ini menjelaskan prinsip-prinsip dasar dan perbedaan utama antara model generatif dan diskriminatif, dua pendekatan utama dalam teknik machine learning.
Meskipun sebagian besar machine learning didasarkan pada metode probabilistik, model generatif didasarkan pada distribusi probabilitas gabungan, sementara model diskriminatif hanya menggunakan probabilitas bersyarat. Dengan demikian, kedua kelas model memiliki aplikasi dan karakteristik kinerja yang berbeda. Mengingat tersedianya beragam model, memilih alat yang tepat untuk pekerjaan menjadi hal yang esensial.
Di luar pemahaman konseptual tentang tipe model dan perbedaannya, yang lebih penting adalah membangun model sendiri. Mulailah dengan posting blog yang membahas metode pelatihan terawasi dan membangun model regresi logistik sederhana.
Pelajari lebih lanjut tentang machine learning dengan kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt




