
Last chance! 50% off DataCamp Premium
Sale ends in
I modelli di machine learning (ML) sono implementazioni su computer di metodi statistici e probabilistici. Generalmente adottano uno di due approcci: modellazione generativa o discriminativa.
In questo articolo, offriamo una panoramica dei modelli generativi e discriminativi, presentiamo i modelli più comuni di ciascun tipo, spieghiamo i principi matematici alla base di entrambi gli approcci e discutiamo esempi pratici dei tipi di problemi per cui ogni tipo di modello può essere usato.
Dato un insieme di punti dati di esempio, D, e le relative etichette, L, un modello generativo apprende la distribuzione di probabilità congiunta P(D, L). Usa poi questa distribuzione sottostante per generare nuovi dati simili agli esempi di training o per affrontare problemi di classificazione.
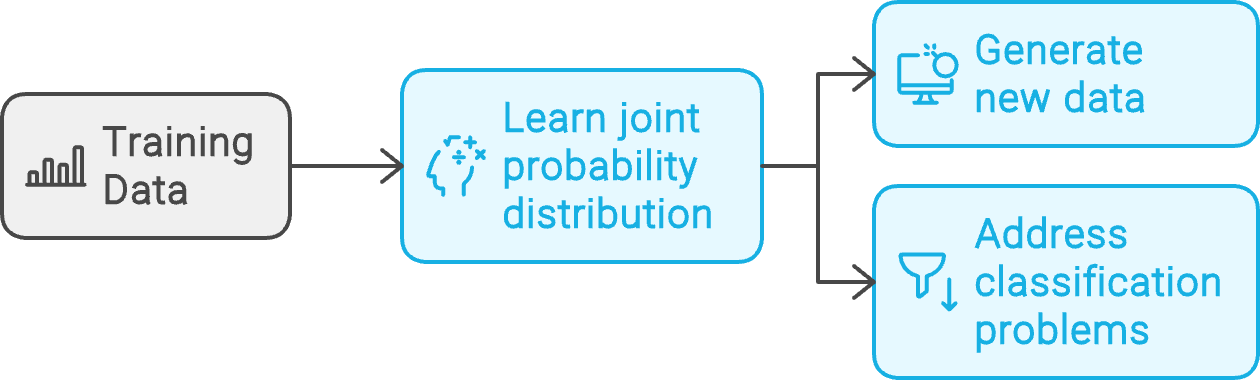
Flusso di lavoro di un modello generativo. Creato con napkin.ai
Le sezioni seguenti spiegano i fondamenti dei modelli generativi con esempi.
I modelli Naive Bayes si basano sul teorema di Bayes. Questo teorema fornisce la probabilità condizionata P(A | B) di un evento A quando si sa che l’evento B è vero. Questa è detta probabilità a posteriori di A dato B.
Singolarmente, la probabilità P(A) dell’evento A è detta probabilità a priori. I modelli Naive Bayes assumono che A e B siano eventi indipendenti - da qui il prefisso “naive”. Se A e B sono dipendenti, il teorema di Bayes classico non si applica più e i modelli Naive Bayes non sono la scelta giusta.
I modelli bayesiani sono modelli generativi perché modellano la distribuzione di probabilità congiunta. Il processo di training apprende la probabilità congiunta—P(A, B). Dopo il training, può essere usata per prevedere i valori di A con la probabilità più alta P(A). Inoltre, i modelli bayesiani possono essere usati anche per la classificazione perché possono calcolare probabilità condizionate (usando la regola di Bayes).
Per imparare a usare in pratica i modelli Naive Bayes, segui il tutorial su come costruire modelli Naive Bayes con scikit-learn e Python.
I Gaussian mixture models (GMM) sono una classe di modelli a miscela. La loro premessa unica è che i dati sottostanti combinano più distribuzioni statistiche invece di una singola distribuzione.
In un GMM, si assume che la popolazione sia una combinazione di diverse sottopopolazioni, ognuna delle quali è una distribuzione gaussiana. In pratica, la distribuzione dei dati viene analizzata come una media pesata di alcune distribuzioni gaussiane individuali.
I GMM catturano la distribuzione di probabilità del dataset sottostante. Per questo vengono usati per compiti come l’analisi degli outlier e la classificazione non supervisionata. Questi compiti prevedono la costruzione di un modello statistico della popolazione trattando il dataset di training come un campione casuale.
Il corso sui modelli a miscela in R entra nei dettagli pratici dei GMM.
Una generative adversarial network (GAN) è un modello basato su reti neurali. Consiste di due parti: un generatore e un discriminatore. La rete generatrice è addestrata a generare vettori simili agli esempi di training, mentre il discriminatore è addestrato a distinguere tra gli esempi originali e quelli generati dal generatore.
In sostanza, generatore e discriminatore hanno obiettivi di training opposti, il che li rende “avversari”. Da qui il termine “adversarial” nel nome.
Generatore e discriminatore vengono addestrati insieme nello stesso loop di training. Man mano che il generatore migliora nel creare esempi realistici, il discriminatore distingue gli esempi originali da quelli generati. L’addestramento continua finché il generatore non impara a generare esempi così simili ai dati di training che il discriminatore non riesce a distinguerli.
Dopo il training, il generatore viene usato per generare dati sintetici realistici simili agli esempi originali.
Un hidden Markov model (HMM) lavora con dataset sequenziali. I processi di Markov (o catene di Markov) vengono usati per modellare dati sequenziali. La premessa di un modello di Markov è che l’elemento successivo, xn+1, nella sequenza dipende solo dall’elemento precedente, xn, e non su nessuno degli elementi, {x1, x2, ... xn-1}, precedenti. I modelli di Markov assumono che i dataset sequenziali possano essere rappresentati da processi di Markov con stati nascosti.
Questi stati generano l’elemento successivo nella sequenza:
I modelli di Markov sono rappresentati con probabilità di transizione (passare da uno stato a un altro) e probabilità di emissione (generare un particolare elemento della sequenza dato un certo stato).
Gli HMM modellano i dataset di training come processi di Markov. L’obiettivo del training è determinare le probabilità di transizione e di emissione per massimizzare la probabilità di generare le sequenze nei dataset di esempio. Così, data una sequenza, un modello di Markov addestrato può generare gli elementi successivi della sequenza.
Per approfondire l’implementazione pratica, segui il tutorial sulle catene di Markov in Python.
Dato un dataset di training composto da punti dati, D, e le relative etichette, L, un modello discriminativo apprende la distribuzione di probabilità condizionata P(D | L). Usa poi questa distribuzione condizionata per prevedere la classe di nuovi punti dati.
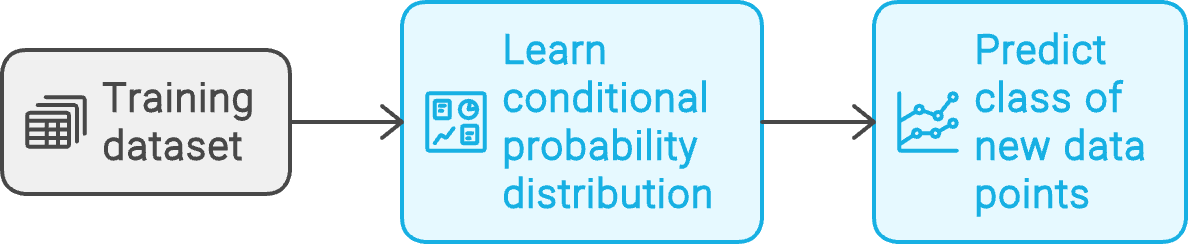
Flusso di lavoro di un modello discriminativo. Creato con napkin.ai
I modelli discriminativi sono generalmente usati per risolvere problemi di classificazione. I seguenti esempi ne mostrano i casi d’uso.
K-nearest neighbors (KNN) è uno dei modelli di machine learning più datati. Si basa sulla premessa che, data una distribuzione di punti dati, gli elementi simili si trovano in prossimità.
I modelli KNN sono non parametrici, senza parametri come coefficienti di regressione. Si usano sia per problemi di classificazione sia di regressione.
La categoria di un punto dati in input è la stessa dei suoi k vicini più prossimi. Il valore previsto di un punto dati è il valore medio dei suoi k vicini più prossimi. k (il numero di vicini da considerare) può essere considerato un iperparametro del modello. Serve a regolare il comportamento del modello, ma non influisce direttamente sull’output del modello.
La regressione logistica, come la regressione lineare, cerca di prevedere il valore di una variabile dipendente in base a una o più variabili indipendenti. Nella regressione lineare, la variabile dipendente assume valori continui. Nella regressione logistica, la variabile dipendente assume valori discreti, come:
La regressione lineare prevede valori numerici. Nella regressione logistica, la quantità prevista è il logaritmo dell’odds ratio.
Per un evento A, con probabilità P(A), il rapporto di odds è P(A) / (1 - P(A)). L’uso del logaritmo (dell’odds ratio) porta a una convergenza più fluida e rapida durante il training. Dato che sanno separare gli input in classi, i modelli logistici sono usati per scopi discriminativi.
Per un’introduzione più pratica all’argomento, consulta la guida sulla regressione logistica in Python.
Puoi anche implementare la regressione logistica usando R, un linguaggio di programmazione orientato alla statistica, come spiegato nel tutorial sulla regressione logistica in R.
Le support vector machines determinano la retta ottimale che separa punti dati di classi diverse. Nel piano X-Y a 2 dimensioni, data una collezione di punti dati di due categorie diverse, l’SVM prevede una retta che (idealmente) separa nettamente i punti di una categoria dall’altra.
Questa retta è il confine decisionale. Diventa un iperpiano per dati con tre o più dimensioni. I punti dati (di entrambe le categorie) che giacciono più vicini a questa linea immaginaria sono detti vettori di supporto del modello. Questi punti dati sono i più difficili da classificare poiché i loro valori sono vicini.
La distanza tra la retta separatrice e i vettori di supporto è detta margine. L’addestramento SVM mira a trovare il confine decisionale che massimizza questo margine. In pratica, i punti dati hanno più di due dimensioni e la retta separatrice è un iperpiano a dimensione superiore.
Le SVM sono usate anche per problemi di classificazione multiclasse.
Per saperne di più sulle SVM, segui questa guida alla costruzione di SVM con il pacchetto Python scikit-learn. Oltre a Python, puoi usare anche R per implementare le SVM, come discusso in questa guida sulle SVM in R.
Un albero decisionale è costituito da diversi nodi decisionali organizzati in una struttura ad albero.
Il nodo più alto è la radice. I nodi che portano a output finali sono detti nodi foglia o nodi terminali. I nodi intermedi non foglia sono detti nodi interni. L’output del nodo radice alimenta i nodi intermedi. Il risultato (output) di ciascun nodo è o l’output finale o conduce (ramifica) a un altro nodo.
Ogni nodo dell’albero divide il dataset lungo un particolare attributo. Per esempio, un albero decisionale per approvare domande di prestito potrebbe avere nodi per separare le domande in base al reddito netto.
Il processo di training determina il valore di soglia appropriato per ogni decisione. Per esempio, le domande con reddito netto al di sotto di un certo importo vengono respinte a priori. Le altre vengono elaborate ulteriormente in nodi successivi, che considerano altri attributi, come il patrimonio netto.
Per una guida pratica agli alberi decisionali, segui il tutorial su come costruire alberi decisionali con Python, o il corso completo su machine learning con modelli ad albero in Python.
Il principale svantaggio degli alberi decisionali è l’overfitting, che porta a problemi con dati fuori campione. Le foreste decisionali cercano di risolvere questo problema. Una foresta decisionale è composta da molti alberi. A differenza degli alberi decisionali standalone, che devono considerare l’intero set di feature, ciascun albero in una foresta trova solo un sottoinsieme casuale del set di feature. Questa casualità aiuta a gestire la varianza nei dataset rumorosi.
L’output della foresta si ottiene combinando, per esempio mediando, l’output dei singoli alberi.
Per imparare come implementare le random forest, consulta la guida su come usare scikit-learn per costruire classificatori random forest.
Una rete neurale è composta da gruppi di neuroni. Ogni neurone implementa una funzione lineare che moltiplica i pesi del neurone con il vettore di input.
Una funzione di attivazione non lineare segue la funzione lineare. La funzione di attivazione decide l’output di ciascun neurone in base all’output della funzione lineare. Pertanto, una rete neurale semplice può essere concettualmente vista come una serie di equazioni lineari filtrate da attivazioni non lineari.
Lo strato di input di una rete neurale moltiplica l’input (rappresentato come vettore) per un insieme di pesi e funzioni di attivazione. Questo output viene passato allo strato successivo, che esegue un’operazione simile.
Gli strati nascosti si trovano tra input e output layer. L’ultimo strato nascosto alimenta lo strato di output. I problemi complessi prevedono l’uso di reti neurali con molti strati nascosti, dette reti neurali profonde (DNN).
In un problema di classificazione, un approccio comune è avere tanti neuroni di output quante sono le classi. La classe prevista corrisponde al neurone con il valore più alto. In un problema di regressione, un singolo neurone di output contiene il valore previsto. Le relazioni lineari dei neuroni modellano l’equazione della regressione lineare.
Per una comprensione più approfondita dell’argomento, dai un’occhiata al post del blog sulle reti neurali.
Alcuni compiti, come la classificazione, possono essere risolti usando entrambi i tipi di modelli. In generale, però, i modelli discriminativi e generativi hanno spesso casi d’uso distinti, poiché adottano approcci matematici diversi. È necessario comprendere queste differenze e come influenzano l’idoneità di ciascuna categoria di modelli ai vari problemi.
I modelli generativi prevedono il valore successivo in una sequenza o generano un’immagine dato un testo (o viceversa). Per svolgere tali compiti, il modello deve imparare quale output generare dati input diversi. Il modello usa la distribuzione di probabilità congiunta dell’input e dell’output.
Per capire la matematica sottostante, partiamo da un esempio semplice. Il comportamento di una singola variabile casuale è descritto dalla sua funzione di densità di probabilità (PDF).
La PDF della variabile casuale X può essere usata per determinare la probabilità di X a valori diversi. Per esempio, se la PDF di X è f(x), la probabilità che X sia tra A e B è data da:

La probabilità di X sull’intero intervallo è 1. Questo si esprime come:

L’espressione sopra può anche essere scritta come:
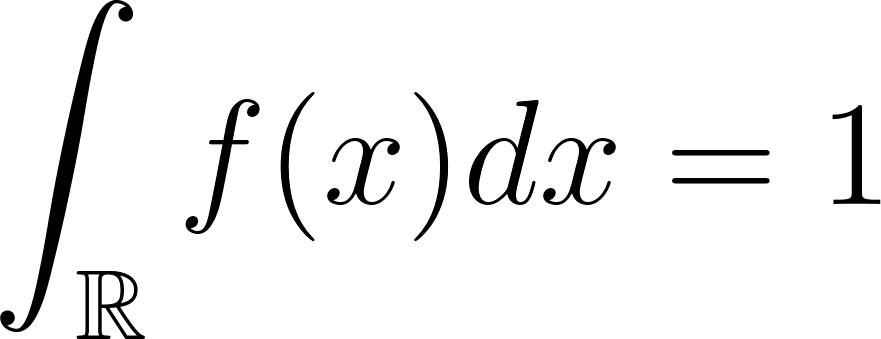
Per una PDF congiunta di due variabili, X e Y, l’integrale sull’intero intervallo è 1:

La distribuzione di probabilità congiunta mappa l’intero spazio di probabilità sia di X sia di Y. Per valutare la probabilità che la probabilità congiunta P(X, Y) cada in una regione G, integra la PDF congiunta su G:

I modelli discriminativi, invece, si concentrano solo sulla distribuzione di probabilità condizionata. I modelli generativi, se necessario, stimano la probabilità condizionata usando le probabilità marginali.
Data una distribuzione di probabilità congiunta fXY(x,y), la probabilità marginale della variabile casuale Y al valore y (per tutti i valori di X) è data da:
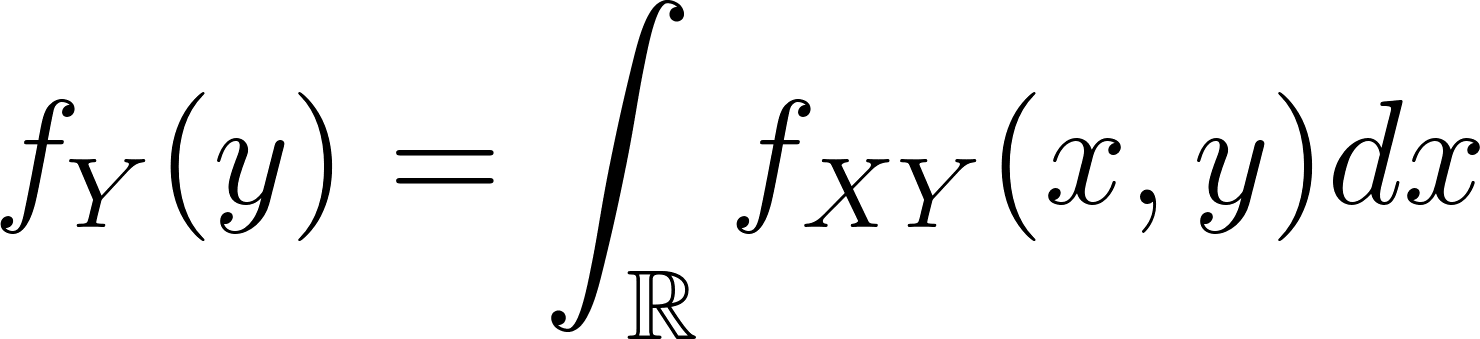
In modo analogo alla regola di Bayes, la PDF condizionata di X è quindi espressa come:
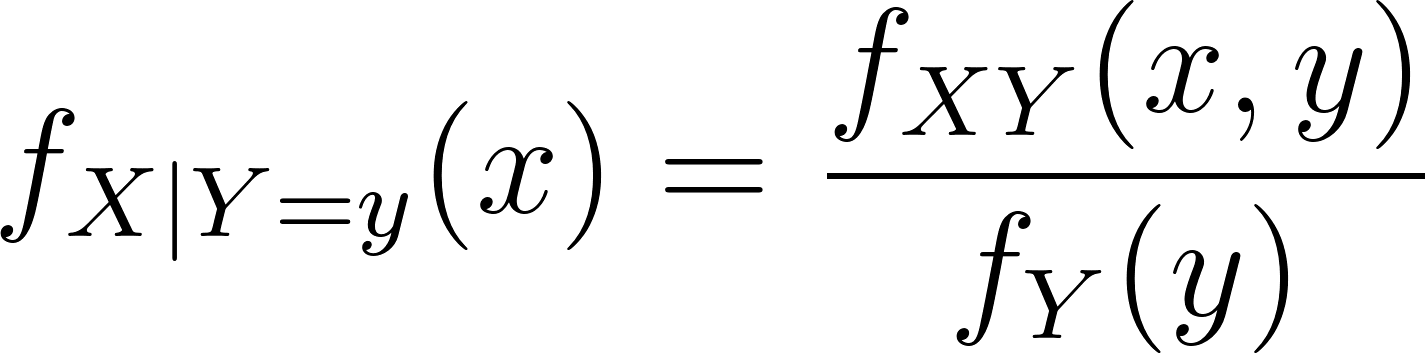
L’espressione sopra mostra la versione integrale della probabilità condizionata, più comunemente scritta come:
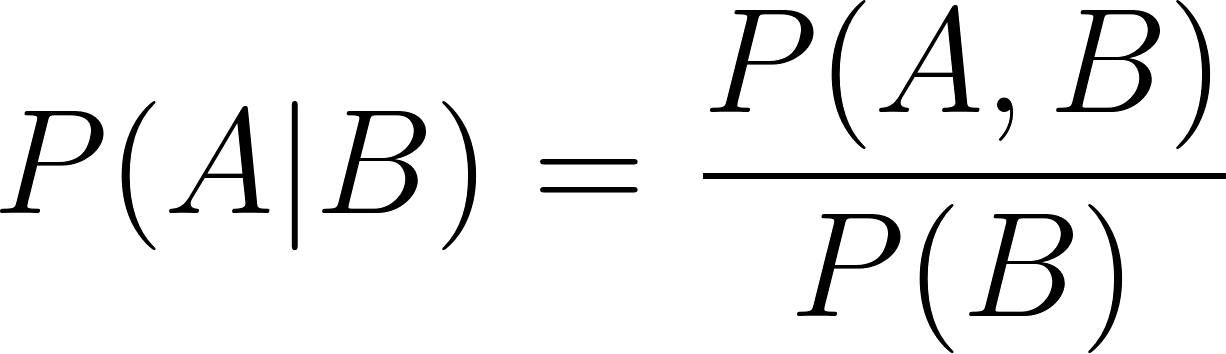
Allo stesso modo,
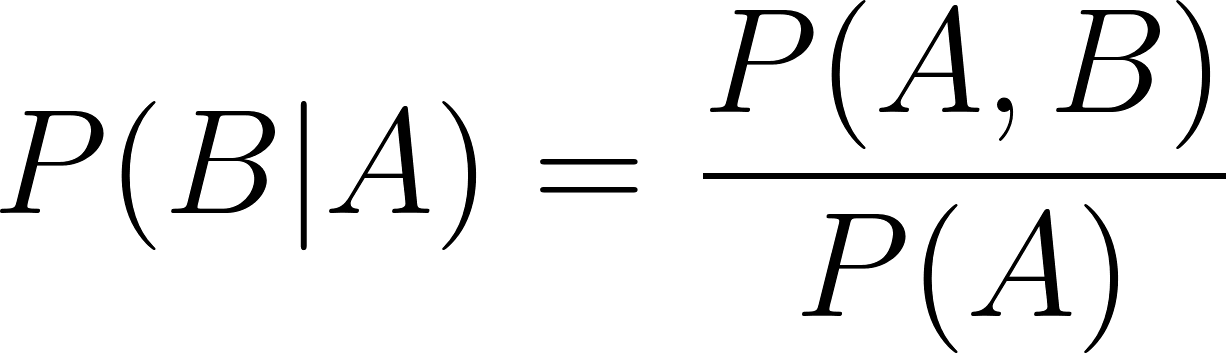
Nelle due formule di probabilità condizionata sopra:
Per calcolare una probabilità condizionata, i modelli generativi seguono due passaggi:
I modelli discriminativi, invece, seguono un singolo (e più semplice) passaggio:
Un modello generativo dispone delle marginali P(A) e P(B) e della PDF congiunta P(A, B). Usando queste, può valutare P(A | B) o P(B | A) con la stessa facilità. Questa è l’idea alla base dei classificatori Naive Bayes. Così, i modelli generativi possono svolgere compiti come:
Questo rende i modelli generativi flessibili e polivalenti. D’altra parte, comportano intrinsecamente più complessità durante il training perché:
I modelli discriminativi, invece, si occupano solo delle condizionali. In base al dataset di training, è possibile stimare direttamente le probabilità condizionate senza stimare le probabilità congiunte o marginali.
Pertanto, i modelli discriminativi sono più semplici da addestrare. Tuttavia, un modello discriminativo che ha appreso la probabilità condizionata P(A | B) può svolgere solo compiti che coinvolgono questa particolare probabilità condizionata. Non può fare altro.
I modelli generativi sono abbastanza flessibili per compiti sia generativi sia discriminativi. Durante il training, il modello apprende la PDF congiunta e le marginali. Durante l’inferenza, il modello deve calcolare la probabilità condizionata usando la distribuzione congiunta e la probabilità marginale appropriata. Di conseguenza, l’inferenza su compiti discriminativi è più lenta.
I modelli discriminativi, invece, hanno appreso direttamente (numericamente) le probabilità condizionate. Stimano la probabilità condizionata in un solo passaggio in base ai dati di input durante l’inferenza.
Inoltre, poiché i modelli discriminativi si concentrano solo sulla stima di una singola quantità (la probabilità condizionata), si osserva che sono più accurati. Una PDF congiunta incorpora più incertezza rispetto a una semplice probabilità condizionata. Questa incertezza aggiuntiva si riflette nella precisione relativamente inferiore dei modelli generativi per i compiti di classificazione.
Sulla base della discussione nelle sezioni precedenti, la tabella seguente riassume le differenze tra modelli generativi e discriminativi.
|
Modelli generativi |
Modelli discriminativi |
|
|
Obiettivo |
Catturare la probabilità congiunta e la probabilità marginale. Usare la regola di Bayes per calcolare la probabilità condizionata. |
Catturare solo la probabilità condizionata. Non ci sono informazioni sulle probabilità congiunte o marginali. |
|
Generazione di dati |
Possono generare nuovi punti dati basati sul dataset di training. Per esempio, un modello addestrato su cifre scritte a mano può generare nuove cifre false. |
Non possono generare nuovi punti dati. Sono focalizzati principalmente sul distinguere tra diverse categorie di dati. |
|
Caso d’uso primario |
Possono essere usati sia per compiti generativi (es. sintesi dei dati) sia per compiti discriminativi (es. classificazione). |
Possono essere usati solo per compiti discriminativi come classificazione o regressione. |
|
Prestazioni in inferenza |
L’inferenza è più lenta a causa della necessità di calcoli complessi. Anche compiti semplici richiedono il calcolo di probabilità marginali e congiunte e l’applicazione della regola di Bayes. |
Inferenza più veloce perché calcola direttamente la probabilità condizionata senza coinvolgere la regola di Bayes. |
|
Gestione dei dati mancanti |
Migliori nella gestione dei dati mancanti grazie alla modellazione della distribuzione di probabilità sottostante, che rende più facile “colmere le lacune”. Rischio minore di overfitting. |
Meno efficaci nella gestione dei dati mancanti. Maggior rischio di overfitting perché il modello si concentra nel trovare l’iperpiano separatore tra classi. |
|
Convergenza |
Tendono a convergere più velocemente e con meno esempi di training ma in genere producono un errore del modello più alto, soprattutto nei compiti di classificazione, a causa del calcolo indiretto della probabilità condizionata tramite la modellazione della distribuzione congiunta. |
In genere richiedono più dati per l’addestramento e possono convergere più lentamente. Tuttavia, il risultato è un errore del modello inferiore, soprattutto nei compiti di classificazione, perché modellano direttamente la probabilità condizionata senza stimare la distribuzione congiunta. |
|
Complessità del modello |
Sono tipicamente più complessi perché modellano l’intera distribuzione dei dati, incluse le interazioni tra feature ed etichette. |
Generalmente più semplici perché devono solo modellare il confine decisionale o l’iperpiano separatore tra classi. |
|
Esempi di modelli |
Naive Bayes, Hidden Markov Models (HMM), Generative Adversarial Networks (GAN), Variational Autoencoders (VAE). |
Regressione logistica, Support Vector Machines (SVM), Reti neurali e Alberi decisionali. |
|
Flessibilità del modello |
Più flessibili in termini di applicazione (possono gestire sia compiti generativi sia discriminativi). |
Meno flessibili (limitati ai compiti discriminativi). |
|
Tassi di errore |
Tassi di errore più alti nei compiti di classificazione a causa di metodi di stima indiretti. |
Tassi di errore più bassi nei compiti di classificazione grazie al training diretto sulla probabilità condizionata. |
Come suggerisce il nome, i modelli generativi sono particolarmente adatti a compiti che prevedono la generazione di nuovi dati che rispettano i pattern nei dati di training.
Alcuni casi d’uso comuni di questi modelli sono:
Per molti modelli di computer vision, disporre di un ampio dataset di immagini di training è essenziale. Questi modelli devono essere addestrati su molte varianti della stessa immagine o feature.
Scattare foto dello stesso oggetto da angolazioni, sfondi o sfumature di colore diverse non è sempre realistico. Molti dataset di immagini specifici per compito tendono anche a essere limitati in dimensione perché crearli richiede competenze di dominio. Per esempio, per creare un set di immagini di radiografie di una specifica malattia polmonare servono accesso a pneumologi, laboratori di radiologia e pazienti e ospedali consenzienti.
In questi casi, l’opzione più pragmatica è creare un dataset piccolo ma altamente curato e pertinente e poi generare sinteticamente nuovi punti dati simili al dataset originale.
Generare nuove immagini data una descrizione testuale o generare nuovo testo dato un input testuale. L’unica classe di modelli in grado di gestire tali compiti è quella dei modelli generativi.
I modelli di generazione di immagini come DALL-E, MidJourney e Stable Diffusion vengono usati di routine per generare immagini adatte a una descrizione specifica e che non violino i copyright esistenti.
Allo stesso modo, gli LLM vengono spesso usati per generare trame di storie di fantasia, slogan e tagline di marketing, riassunti di documenti e materiali simili.
I modelli generativi sono usati per compiti basati sulla distribuzione di probabilità congiunta dei dati sottostanti. Modellare la distribuzione congiunta dei rendimenti degli asset per prevedere il profilo atteso di rischio e rendimento di un portafoglio di investimento è prassi nella finanza e nel risk management.
Per esempio, un gestore di investimenti potrebbe voler conoscere la probabilità che i prezzi di due azioni diverse salgano o scendano contemporaneamente: le PDF congiunte possono rispondere a tali domande.
Il settore dei servizi finanziari usa questi metodi statistici da molto prima che il termine “modelli generativi” fosse ampiamente adottato.
Problemi come la classificazione non supervisionata sono particolarmente adatti ai Gaussian mixture models. In questi problemi, hai una vasta collezione di punti dati ma non sai a quante o a quali categorie appartengano. È ragionevole aspettarsi che i dati provengano da una combinazione di distribuzioni, che un GMM può modellare.
Se il numero e l’elenco delle categorie fossero noti in anticipo, i metodi discriminativi sarebbero più appropriati.
I GMM sono utili anche nell’analisi degli outlier (rilevamento di anomalie, frodi, ecc.), dove i dati “abituali”, come il comportamento di diversi gruppi di clienti, possono essere modellati come una combinazione di distribuzioni diverse. I punti dati anomali sono quelli che differiscono significativamente da uno qualsiasi degli altri pattern.
I problemi che coinvolgono sequenze sono spesso risolti usando modelli di Markov nascosti. Un caso d’uso quotidiano è la modellazione delle sequenze genomiche e il resequenziamento.
Gli HMM sono usati anche nel riconoscimento vocale, dove aiutano a prevedere la sillaba successiva data la sequenza delle sillabe precedenti. La modellazione di sequenze è comune anche per applicazioni logistiche come i piani di consegna dei pacchi. Analogamente, la trasmissione e la diffusione di malattie infettive vengono spesso modellate con catene di Markov.
Dal punto di vista matematico, i modelli discriminativi si usano per applicazioni in cui è rilevante solo la probabilità condizionata e non quella congiunta. Pertanto, i modelli discriminativi sono tipicamente usati per problemi di classificazione e di previsione.
Alcuni esempi:
Problemi di classificazione supervisionata, in cui le classi (categorie) sono note in anticipo. Questo è il caso d’uso per eccellenza di KNN e SVM.
Hai una vasta collezione di punti dati, come dati di comportamento dei clienti, inclusi schemi di spesa, importi di acquisto, frequenza di acquisto, storico dei resi e così via. Devi usare queste informazioni per classificare l’elenco dei clienti in categorie diverse, come grandi spender, cacciatori di affari, clienti regolari, clienti poco interessati, ecc. In contrasto con i problemi di classificazione non supervisionata, dove, come discusso prima, si usano comunemente i GMM.
Nei compiti predittivi come classificazione e regressione, la priorità è spesso velocità e accuratezza. In linea di principio, i modelli generativi sono anch’essi in grado di risolvere tali problemi.
In particolare, si preferiscono modelli generativi quando ci sono problemi come punti dati mancanti, quando è disponibile solo un dataset limitato per il training o quando ti aspetti di aggiungere nuove categorie di routine.
Tuttavia, per la maggior parte dei casi d’uso standard, i modelli generativi soffrono di tassi di errore più elevati e inferenza più lenta nei compiti predittivi perché i loro calcoli coinvolgono la distribuzione di probabilità congiunta. Pertanto, per problemi standard di classificazione e regressione, in cui è disponibile un dataset di training ampio e sano, i modelli discriminativi sono la scelta preferita grazie alle migliori caratteristiche prestazionali.
I modelli discriminativi sono preferiti per compiti che si concentrano solo sul risultato della classificazione e non sulla modellazione dei dati sottostanti.
Per esempio, se vuoi categorizzare registrazioni audio nelle rispettive lingue, non ti serve un modello che comprenda la lingua e la grammatica. Un modello di riconoscimento vocale sarebbe eccessivo per un problema di classificazione. È sufficiente concentrarsi sul confine decisionale usando un modello discriminativo. Quindi, puoi usare una semplice rete neurale invece di un LLM o la regressione logistica invece di un modello bayesiano.
Le decisioni multi-step, in cui i singoli passaggi comportano scelte non ambigue, sono buone candidate per gli alberi decisionali. Gli alberi decisionali si usano spesso come filtro preliminare per selezionare i punti dati che richiedono un’analisi più approfondita.
Per esempio, considera il rilevamento di frodi, spesso risolto con modelli complessi come i GMM. Gli esseri umani indagano quasi sempre sulle transazioni ad alto rischio, indipendentemente dal modello usato. Quindi, un approccio alternativo è usare un albero decisionale per segnalare un elenco di transazioni potenzialmente fraudolente per ulteriori indagini manuali.
Gli alberi decisionali si usano anche in molte operazioni aziendali. L’obiettivo è decidere il corso d’azione corretto in base a condizioni predefinite. Tali compiti non richiedono né modelli generativi né i modelli discriminativi più complessi come le reti neurali.
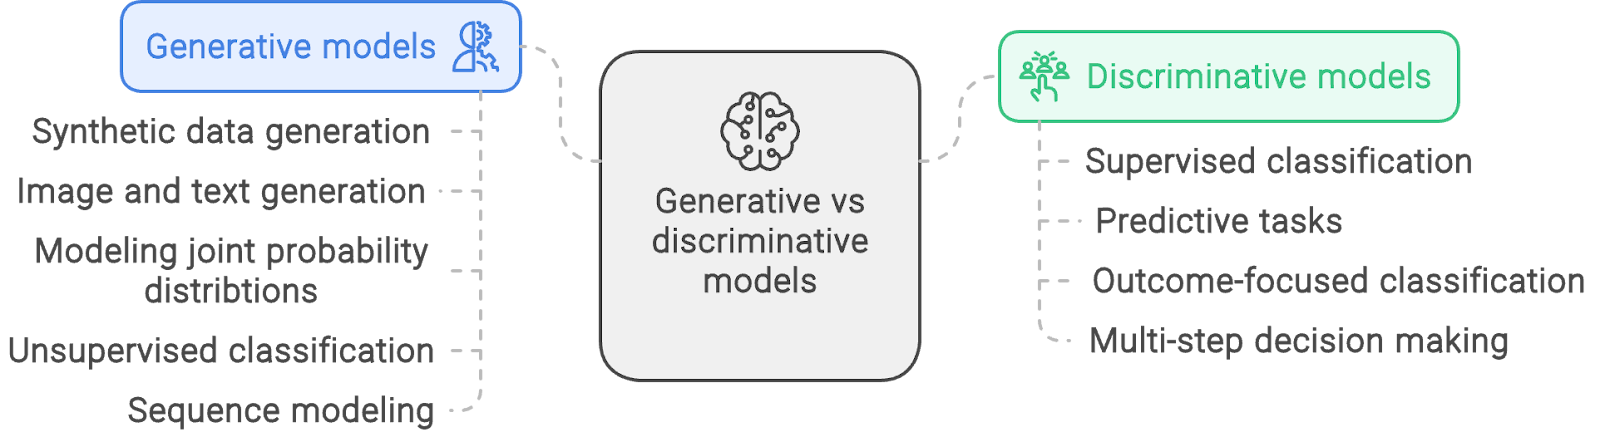
Esempi di applicazioni di modelli generativi vs. discriminativi. Creato con napkin.ai
Questo articolo ha spiegato i principi fondamentali e le principali differenze tra modelli generativi e discriminativi, i due principali approcci alle tecniche di machine learning.
Sebbene la maggior parte del machine learning si basi su metodi probabilistici, i modelli generativi si basano sulla distribuzione di probabilità congiunta, mentre i modelli discriminativi usano solo probabilità condizionate. Di conseguenza, le due classi di modelli hanno applicazioni e caratteristiche prestazionali diverse. Considerata la disponibilità di un’ampia varietà di modelli, diventa essenziale scegliere lo strumento giusto per il compito.
Oltre a una comprensione concettuale dei tipi di modelli e delle loro differenze, è ancora più importante costruire modelli in prima persona. Inizia con il post che discute i metodi di training supervisionato e la costruzione di un semplice modello di regressione logistica.
Scopri di più sul machine learning con questi corsi!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min




