Kurs
Machine Learning verstehen
2 Std.
307.9K
Machine-Learning-(ML-)Modelle sind rechnergestützte Umsetzungen statistischer und probabilistischer Verfahren. Sie verfolgen im Wesentlichen zwei Ansätze: generatives oder diskriminatives Modeling.
In diesem Artikel geben wir einen Überblick über generative und diskriminative Modelle, stellen gängige Vertreter beider Klassen vor, erläutern die mathematischen Grundlagen der Ansätze und diskutieren praxisnahe Beispiele für passende Problemstellungen.
Gegeben eine Menge von Beispieldatenpunkten D und ihren zugehörigen Labels L lernt ein generatives Modell die gemeinsame Wahrscheinlichkeitsverteilung P(D, L). Anschließend nutzt es diese zugrunde liegende Verteilung, um neue, den Trainingsbeispielen ähnliche Daten zu erzeugen oder Klassifikationsprobleme zu lösen.
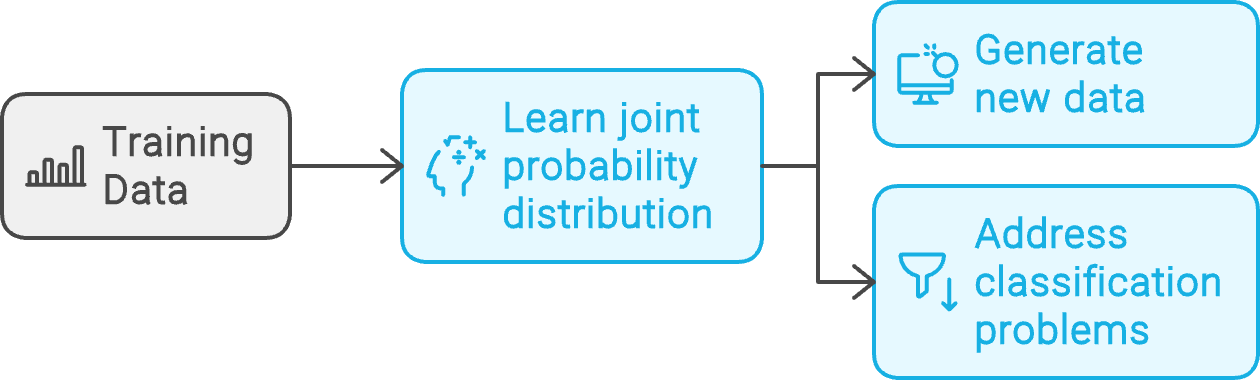
Ablauf eines generativen Modells. Erstellt mit napkin.ai
Die folgenden Abschnitte erklären die Grundlagen generativer Modelle anhand von Beispielen.
Naive-Bayes-Modelle basieren auf dem Satz von Bayes. Dieser liefert die bedingte Wahrscheinlichkeit P(A | B) eines Ereignisses A, wenn bekannt ist, dass Ereignis B zutrifft. Dies nennt man die a‑posteriori-Wahrscheinlichkeit von A gegeben B.
Für sich genommen heißt die Wahrscheinlichkeit P(A) für Ereignis A a‑priori‑Wahrscheinlichkeit. Naive Bayes nimmt an, dass A und B unabhängig sind – daher das Präfix „naiv“. Sind A und B abhängig, gilt der klassische Satz von Bayes nicht mehr, und Naive-Bayes-Modelle sind nicht die richtige Wahl.
Bayes’sche Modelle sind generativ, weil sie die gemeinsame Wahrscheinlichkeitsverteilung modellieren. Im Training wird die gemeinsame Wahrscheinlichkeit P(A, B) gelernt. Nach dem Training lassen sich die Werte von A mit höchster Wahrscheinlichkeit P(A) vorhersagen. Darüber hinaus eignen sich Bayes-Modelle dank der Bayes-Regel auch für Klassifikation, da sie bedingte Wahrscheinlichkeiten berechnen können.
Wie du Naive Bayes in der Praxis einsetzt, zeigt das Tutorial zum Aufbau von Naive-Bayes-Modellen mit scikit-learn und Python.
Gaussian Mixture Models (GMM) sind eine Klasse von Mischmodellen. Ihr zentrales Prinzip: Den Daten liegt nicht eine einzelne, sondern eine Kombination statistischer Verteilungen zugrunde.
Bei einem GMM wird angenommen, dass die Gesamtpopulation aus mehreren Unterpopulationen besteht, von denen jede normalverteilt (Gaussian) ist. Effektiv wird die Datenverteilung als gewichteter Mittelwert einiger einzelner Normalverteilungen betrachtet.
GMMs erfassen die Wahrscheinlichkeitsverteilung des Datensatzes und werden daher für Aufgaben wie Ausreißeranalyse und unüberwachte Klassifikation eingesetzt. Dabei wird die Grundgesamtheit statistisch modelliert, indem der Trainingsdatensatz als Zufallsstichprobe betrachtet wird.
Der Kurs zu Mischmodellen in R vertieft die praktische Arbeit mit GMMs.
Ein Generative Adversarial Network (GAN) ist ein neuronales Modell, bestehend aus zwei Teilen: Generator und Diskriminator. Der Generator wird darauf trainiert, Vektoren zu erzeugen, die den Trainingsbeispielen ähneln, während der Diskriminator zwischen Originalbeispielen und vom Generator erzeugten Beispielen unterscheidet.
Generator und Diskriminator verfolgen also gegensätzliche Trainingsziele, weshalb sie „adversarial“ genannt werden.
Beide Netze werden gemeinsam in demselben Trainingsloop optimiert. Je besser der Generator realistische Beispiele erzeugt, desto besser lernt der Diskriminator, diese von echten zu unterscheiden. Das Training endet, wenn der Generator Beispiele erzeugt, die dem Trainingsmaterial so ähnlich sind, dass der Diskriminator sie nicht mehr zuverlässig unterscheiden kann.
Nach dem Training wird der Generator genutzt, um realistische synthetische Daten zu erzeugen, die den Originalbeispielen ähneln.
Ein Hidden-Markov-Modell (HMM) arbeitet mit sequentiellen Datensätzen. Markov-Prozesse (oder Markov-Ketten) dienen zur Modellierung solcher Sequenzen. Die Grundannahme eines Markov-Modells lautet, dass das nächste Element xn+1 in der Sequenz nur vom vorherigen Element xn abhängt – nicht von den davorliegenden Elementen {x1, x2, ... xn-1}. Markov-Modelle nehmen an, dass Sequenzdaten mittels Markov-Prozessen mit verborgenen Zuständen darstellbar sind.
Diese Zustände erzeugen das nächste Sequenzelement:
Markov-Modelle werden über Übergangswahrscheinlichkeiten (Wechsel von einem Zustand in einen anderen) und Emissionswahrscheinlichkeiten (Erzeugung eines bestimmten Sequenzelements bei gegebenem Zustand) beschrieben.
HMMs modellieren Trainingsdaten als Markov-Prozesse. Ziel des Trainings ist es, Übergangs- und Emissionswahrscheinlichkeiten so zu bestimmen, dass die Wahrscheinlichkeit zur Erzeugung der Sequenzen in den Beispieldaten maximiert wird. Ein trainiertes Markov-Modell kann somit gegebene Sequenzen fortsetzen.
Für die praktische Umsetzung empfiehlt sich das Tutorial zu Markov-Ketten in Python.
Gegeben ein Trainingsdatensatz aus Datenpunkten D und zugehörigen Labels L lernt ein diskriminatives Modell die bedingte Wahrscheinlichkeitsverteilung P(D | L). Anschließend nutzt es diese, um die Klasse neuer Datenpunkte vorherzusagen.
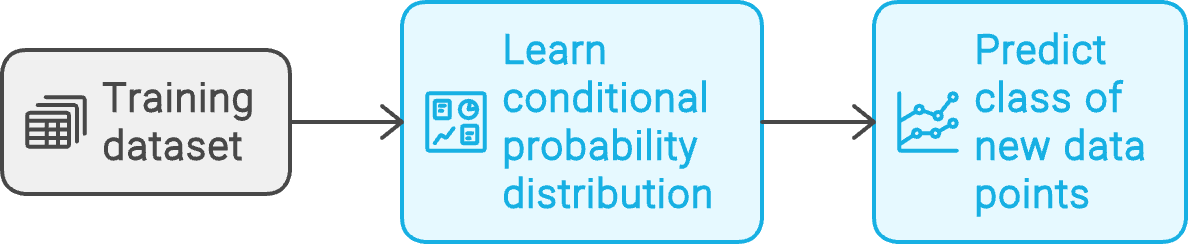
Ablauf eines diskriminativen Modells. Erstellt mit napkin.ai
Diskriminative Modelle werden in der Regel für Klassifikationsprobleme eingesetzt. Die folgenden Beispiele zeigen typische Einsatzszenarien.
K-nearest Neighbors (KNN) gehört zu den älteren ML-Modellen. Es beruht auf der Annahme, dass in einer Verteilung ähnliche Objekte nah beieinander liegen.
KNN-Modelle sind nichtparametrisch, d. h. sie besitzen keine Parameter wie Regressionskoeffizienten. Sie werden sowohl für Klassifikation als auch Regression genutzt.
Die Kategorie eines Eingabepunkts entspricht der seiner k nächsten Nachbarn. Der vorhergesagte Wert eines Datenpunkts ist der Durchschnitt seiner k nächsten Nachbarn. k (die Anzahl betrachteter Nachbarn) ist ein Hyperparameter, der das Verhalten steuert, aber nicht direkt die Modellformel verändert.
Die logistische Regression versucht – wie die lineare Regression – den Wert einer abhängigen Variable aus einer oder mehreren unabhängigen Variablen vorherzusagen. Bei linearer Regression ist die Zielvariable stetig, bei logistischer Regression nimmt sie diskrete Werte an, zum Beispiel:
Lineare Regression sagt numerische Werte vorher. In der logistischen Regression ist die vorhergesagte Größe der Logarithmus der Chancenquote (Odds Ratio).
Für ein Ereignis A mit Wahrscheinlichkeit P(A) lautet die Chancenquote P(A) / (1 - P(A)). Der Logarithmus der Odds führt im Training oft zu glatterer und schnellerer Konvergenz. Da sie Eingaben in Klassen trennt, wird die logistische Regression für diskriminative Zwecke eingesetzt.
Einen praxisnahen Einstieg bietet der Guide zur logistischen Regression in Python.
Du kannst logistische Regression auch in R, einer statistikfokussierten Programmiersprache, umsetzen – erklärt im Tutorial zur logistischen Regression in R.
Support Vector Machines bestimmen die optimale Trennlinie zwischen Datenpunkten verschiedener Klassen. In der zweidimensionalen X‑Y‑Ebene sagt die SVM für zwei Kategorien eine Linie voraus, die (idealerweise) beide sauber trennt.
Diese Linie ist die Entscheidungsgrenze. In höheren Dimensionen entspricht sie einer Hyperbene. Datenpunkte, die dieser gedachten Linie am nächsten liegen, heißen Support Vectors. Sie sind am schwersten zu klassifizieren, weil sie nahe an der Grenze liegen.
Der Abstand zwischen Trennlinie und Support Vectors heißt Margin. Das Training einer SVM zielt darauf ab, diese Margin zu maximieren. In der Praxis sind Daten hochdimensional, die Trennung erfolgt also über eine Hyperbene.
SVMs lassen sich auch für Multiklassen-Klassifikation einsetzen.
Mehr über SVMs lernst du in diesem Guide zum Aufbau von SVMs mit Python und scikit-learn. Neben Python kannst du SVMs auch in R umsetzen, siehe SVMs in R.
Ein Entscheidungsbaum besteht aus mehreren Entscheidungsknoten in Baumstruktur.
Der oberste Knoten ist die Wurzel. Knoten, die zu einem finalen Ergebnis führen, heißen Blatt- oder Endknoten. Dazwischen liegende Knoten sind innere Knoten. Die Ausgabe des Wurzelknotens fließt in die inneren Knoten. Das Ergebnis jedes Knotens ist entweder final oder führt als Verzweigung zum nächsten Knoten.
Jeder Knoten trennt den Datensatz entlang eines Merkmals. Ein Entscheidungsbaum zur Kreditvergabe könnte etwa Knoten enthalten, die Anträge nach Nettoeinkommen unterteilen.
Im Training werden passende Schwellenwerte je Entscheidung ermittelt. Beispielsweise werden Anträge unterhalb eines Nettoeinkommensschwellenwerts direkt abgelehnt. Die übrigen werden in weiteren Knoten anhand anderer Merkmale, z. B. Nettovermögen, geprüft.
Eine praktische Anleitung findest du im Tutorial zum Aufbau von Entscheidungsbäumen mit Python oder im kompletten Kurs zu Machine Learning mit baumbasierten Modellen in Python.
Der Hauptnachteil einzelner Bäume ist Overfitting, was bei neuen Daten zu Problemen führt. Entscheidungswälder adressieren dies: Ein Forest besteht aus vielen Bäumen. Anders als einzelne Bäume, die den gesamten Merkmalsraum betrachten, nutzt jeder Baum im Wald nur eine zufällige Teilmenge der Merkmale. Diese Zufälligkeit hilft, Varianz in verrauschten Datensätzen zu reduzieren.
Die Ausgabe des Waldes entsteht durch Aggregation, z. B. durch Mittelung, der Einzelausgaben der Bäume.
Wie du Random Forests implementierst, zeigt der Guide zum Random-Forest-Classifier mit scikit-learn.
Ein neuronales Netz besteht aus Gruppen von Neuronen. Jedes Neuron implementiert eine lineare Funktion, die die Gewichte des Neurons mit dem Eingabevektor multipliziert.
Darauf folgt eine nichtlineare Aktivierungsfunktion. Sie bestimmt die Ausgabe des Neurons basierend auf der linearen Voraktivierung. Ein einfaches Netz lässt sich daher konzeptionell als Kette linearer Gleichungen betrachten, die durch nichtlineare Aktivierungen „gefiltert“ werden.
Die Eingabeschicht multipliziert den Eingabevektor mit einem Satz von Gewichten und Aktivierungen. Die Ausgabe wird an die nächste Schicht weitergegeben, die ähnlich verfährt.
Verborgene Schichten liegen zwischen Ein- und Ausgabe . Die letzte verborgene Schicht speist die Ausgabeschicht. Komplexe Probleme erfordern viele verborgene Schichten, sogenannte Deep Neural Networks (DNNs).
Bei Klassifikation entspricht eine gängige Architektur der Anzahl der Klassen in der Anzahl der Ausgabeneuronen. Die vorhergesagte Klasse ist das Neuron mit dem höchsten Wert. Bei Regression liefert ein einzelnes Ausgabeneuron den Zielwert. Die linearen Beziehungen der Neuronen bilden die lineare Regressionsgleichung ab.
Für ein tieferes Verständnis lies den Blogbeitrag zu neuronalen Netzen.
Manche Aufgaben, etwa Klassifikation, lassen sich mit beiden Modelltypen lösen. Generell haben generative und diskriminative Modelle jedoch jeweils typische Anwendungsfälle, da sie unterschiedliche mathematische Ansätze verfolgen. Es ist wichtig, diese Unterschiede zu verstehen, um die Eignung für eine bestimmte Problemstellung einschätzen zu können.
Generative Modelle sagen etwa das nächste Element in einer Sequenz voraus oder erzeugen ein Bild zu einem Text (oder umgekehrt). Dafür muss das Modell lernen, welche Ausgabe es zu welchem Eingang erzeugen soll. Es nutzt die gemeinsame Wahrscheinlichkeitsverteilung von Eingabe und Ausgabe.
Zur Veranschaulichung beginnen wir mit einem einfachen Beispiel. Das Verhalten einer einzelnen Zufallsvariable wird durch ihre Wahrscheinlichkeitsdichtefunktion (PDF) beschrieben.
Mit der PDF der Zufallsvariable X lässt sich die Wahrscheinlichkeit für verschiedene Werte von X bestimmen. Ist die PDF von X f(x), ergibt sich die Wahrscheinlichkeit, dass X zwischen A und B liegt, durch:

Die Gesamtwahrscheinlichkeit von X über den gesamten Wertebereich ist 1. Das wird ausgedrückt als:

Dies lässt sich auch schreiben als:
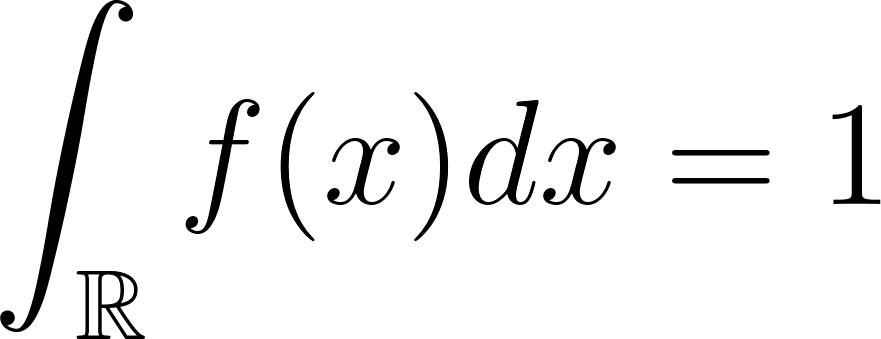
Für eine gemeinsame Dichte zweier Variablen X und Y gilt über den gesamten Bereich ebenfalls: 1.

Die gemeinsame Wahrscheinlichkeitsverteilung beschreibt den gesamten Wahrscheinlichkeitsraum von X und Y. Um die Wahrscheinlichkeit zu berechnen, dass P(X, Y) in einem Gebiet G liegt, integriert man die gemeinsame Dichte über G:

Diskriminative Modelle konzentrieren sich stattdessen ausschließlich auf die bedingte Wahrscheinlichkeitsverteilung. Generative Modelle können die bedingte Wahrscheinlichkeit bei Bedarf aus den Marginalverteilungen ableiten.
Gegeben eine gemeinsame Verteilung fXY(x,y), ergibt sich die Marginalverteilung der Zufallsvariable Y am Wert y (für alle Werte von X) als:
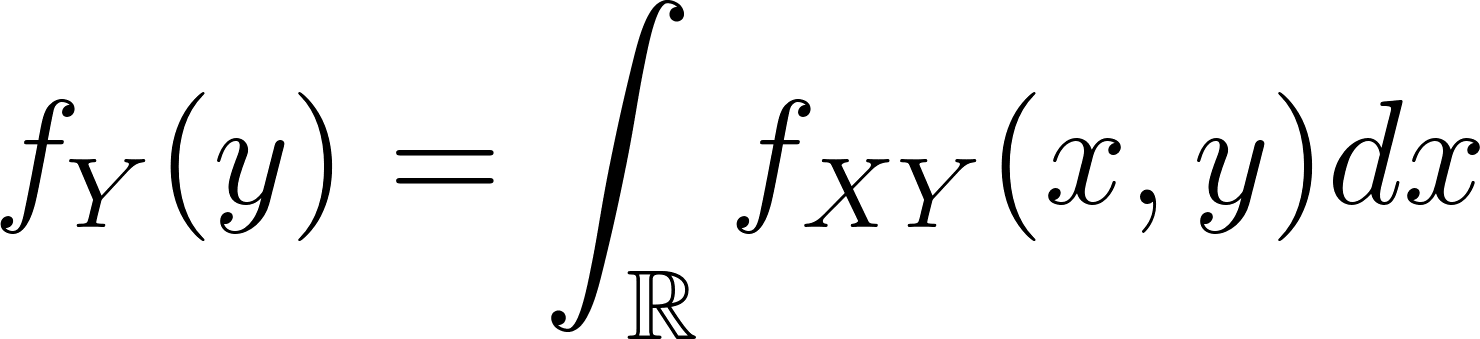
Analog zur Bayes-Regel lässt sich die bedingte Dichte von X schreiben als:
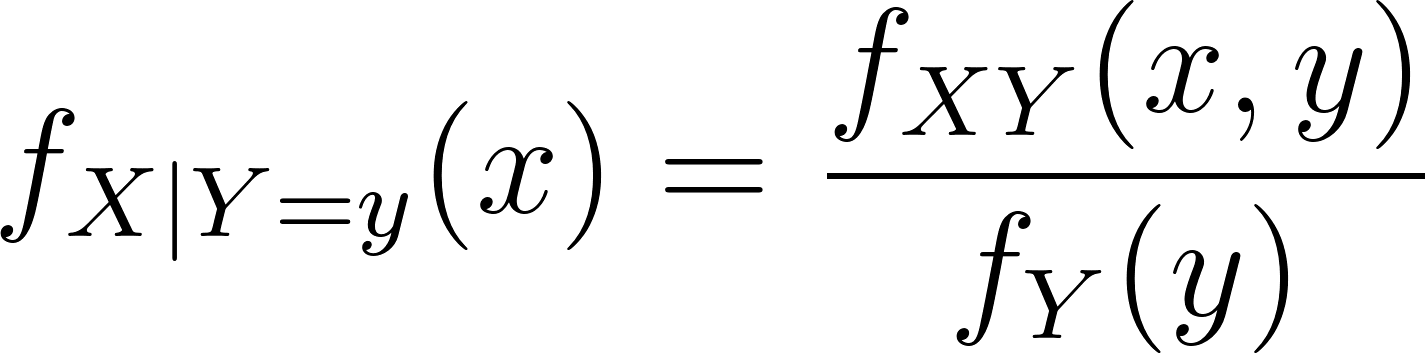
Dies ist die Integralform der bedingten Wahrscheinlichkeit, meist bekannt in der Schreibweise:
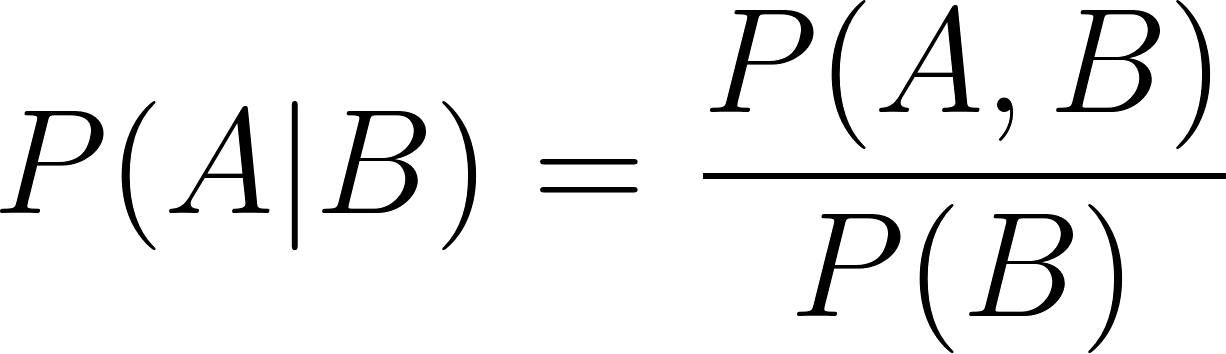
Ebenso gilt:
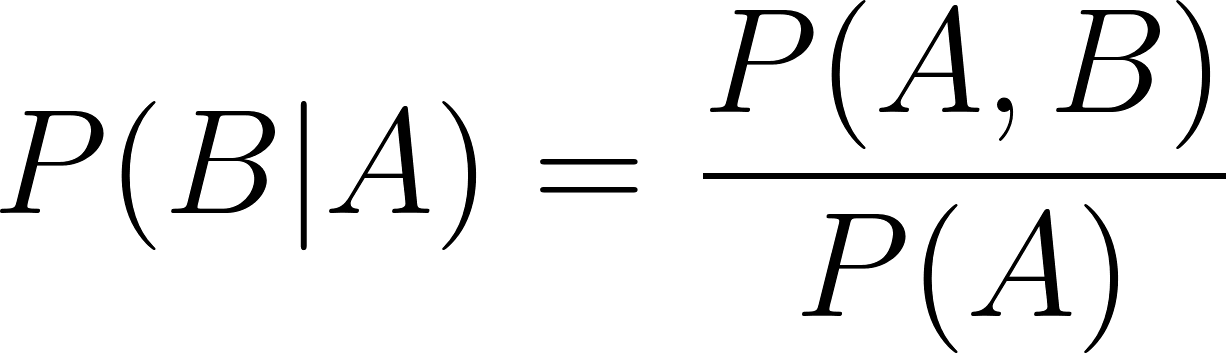
In den beiden Formeln zur bedingten Wahrscheinlichkeit gilt:
Zur Berechnung einer bedingten Wahrscheinlichkeit gehen generative Modelle in zwei Schritten vor:
Diskriminative Modelle hingegen gehen in einem (einfacheren) Schritt vor:
Ein generatives Modell verfügt über die Marginals P(A) und P(B) sowie die gemeinsame Dichte P(A, B). Damit kann es P(A | B) oder P(B | A) gleichermaßen berechnen. Das ist die Idee hinter Naive-Bayes-Klassifikatoren. Generative Modelle können daher:
Das macht generative Modelle flexibel und vielseitig. Gleichzeitig sind sie im Training komplexer, weil:
Diskriminative Modelle betrachten ausschließlich Conditionals. Auf Basis der Trainingsdaten lassen sich die bedingten Wahrscheinlichkeiten direkt schätzen – ohne gemeinsame oder marginale Wahrscheinlichkeiten zu modellieren.
Sie sind daher einfacher zu trainieren. Allerdings kann ein diskriminatives Modell, das P(A | B) gelernt hat, ausschließlich Aufgaben lösen, die genau diese bedingte Wahrscheinlichkeit betreffen.
Generative Modelle sind flexibel für generative und diskriminative Aufgaben. Während des Trainings lernen sie gemeinsame und marginale Verteilungen. In der Inferenz müssen sie für diskriminative Aufgaben die bedingte Wahrscheinlichkeit aus gemeinsamer und marginaler Verteilung ableiten – das verlangsamt die Inferenz.
Diskriminative Modelle hingegen haben die bedingten Wahrscheinlichkeiten direkt numerisch gelernt. In der Inferenz schätzen sie diese in einem Schritt aus den Eingabedaten.
Da sie sich nur auf die Schätzung einer Größe (der bedingten Wahrscheinlichkeit) konzentrieren, sind diskriminative Modelle zudem oft genauer. Eine gemeinsame Verteilung beinhaltet mehr Unsicherheit als eine einfache bedingte Wahrscheinlichkeit – diese zusätzliche Unsicherheit spiegelt sich in tendenziell geringerer Genauigkeit generativer Modelle bei Klassifikationsaufgaben wider.
Auf Basis der vorangegangenen Abschnitte fasst die folgende Tabelle die Unterschiede zwischen generativen und diskriminativen Modellen zusammen.
|
Generative Modelle |
Diskriminative Modelle |
|
|
Ziel |
Erfassen der gemeinsamen und der marginalen Wahrscheinlichkeit. Nutzung der Bayes-Regel zur Berechnung der bedingten Wahrscheinlichkeit. |
Erfassen ausschließlich der bedingten Wahrscheinlichkeit. Keine Information über gemeinsame oder marginale Wahrscheinlichkeiten. |
|
Datengenerierung |
Kann neue Datenpunkte auf Basis des Trainingsdatensatzes erzeugen. Ein auf Handschrifterkennung trainiertes Modell kann z. B. neue, künstliche Ziffern generieren. |
Kann keine neuen Datenpunkte erzeugen. Primärer Fokus liegt auf der Unterscheidung zwischen Kategorien. |
|
Hauptanwendungsfall |
Für generative Aufgaben (z. B. Datensynthese) und diskriminative Aufgaben (z. B. Klassifikation) einsetzbar. |
Nur für diskriminative Aufgaben wie Klassifikation oder Regression einsetzbar. |
|
Inferenzleistung |
Langsamere Inferenz aufgrund komplexerer Berechnungen. Selbst einfache Aufgaben erfordern Marginal‑ und Gemeinsame‑Wahrscheinlichkeiten sowie die Bayes-Regel. |
Schnellere Inferenz, da die bedingte Wahrscheinlichkeit direkt berechnet wird – ohne Bayes-Regel. |
|
Umgang mit fehlenden Daten |
Besserer Umgang mit fehlenden Werten durch Modellierung der zugrunde liegenden Verteilung – „Lücken“ lassen sich leichter schließen. Geringeres Overfitting-Risiko. |
Weniger geeignet für fehlende Daten. Höheres Overfitting-Risiko, da der Fokus auf der Trennhyperbene liegt. |
|
Konvergenz |
Konvergieren tendenziell schneller und mit weniger Trainingsbeispielen, führen aber – v. a. bei Klassifikation – häufiger zu höheren Fehlern, da die bedingte Wahrscheinlichkeit indirekt über die gemeinsame Verteilung berechnet wird. |
Benötigen meist mehr Daten und können langsamer konvergieren, erzielen aber – insbesondere bei Klassifikation – geringere Fehler, da sie die bedingte Wahrscheinlichkeit direkt modellieren. |
|
Modellkomplexität |
Typischerweise komplexer, da die gesamte Datenverteilung inklusive Interaktionen zwischen Merkmalen und Labels modelliert wird. |
In der Regel einfacher, da nur die Entscheidungsgrenze bzw. Trennhyperbene modelliert werden muss. |
|
Beispiele |
Naive Bayes, Hidden Markov Models (HMMs), Generative Adversarial Networks (GANs), Variational Autoencoders (VAEs). |
Logistische Regression, Support Vector Machines (SVMs), Neuronale Netze, Entscheidungsbäume. |
|
Modellflexibilität |
Anwendungsseitig flexibler (eignet sich für generative und diskriminative Aufgaben). |
Weniger flexibel (auf diskriminative Aufgaben beschränkt). |
|
Fehlerraten |
Höhere Fehlerraten bei Klassifikationsaufgaben durch indirekte Schätzung. |
Geringere Fehlerraten bei Klassifikationsaufgaben durch direktes Training auf die bedingte Wahrscheinlichkeit. |
Wie der Name sagt, eignen sich generative Modelle besonders für Aufgaben, bei denen neue Daten erzeugt werden sollen, die den Mustern der Trainingsdaten entsprechen.
Typische Anwendungsfälle sind:
Für viele Computer-Vision-Modelle ist ein großer Bilddatensatz entscheidend. Diese Modelle müssen mit zahlreichen Varianten desselben Objekts oder Merkmals trainiert werden.
Fotos desselben Objekts aus vielen Perspektiven, Hintergründen oder Farbtönen aufzunehmen, ist oft unrealistisch. Viele aufgabenspezifische Datensätze sind zudem klein, weil ihre Erstellung Domänenwissen erfordert. Für ein Röntgenbild-Set einer bestimmten Lungenerkrankung brauchst du z. B. Pulmolog:innen, Radiologielabore sowie Patienten- und Klinikzustimmungen.
Pragmatisch ist es dann, einen kleinen, kuratierten, relevanten Datensatz zu erstellen und anschließend synthetische Datenpunkte zu erzeugen, die dem Original ähneln.
Bilder aus Textbeschreibungen generieren oder neuen Text aus gegebenem Input erzeugen – solche Aufgaben beherrschen ausschließlich generative Modelle.
Bildgeneratoren wie DALL-E, MidJourney und Stable Diffusion werden routinemäßig genutzt, um beschreibungskonforme, rechteunproblematische Bilder zu erzeugen.
Ebenso werden LLMs häufig für fiktive Storyplots, Marketing-Slogans und -Taglines, Zusammenfassungen und ähnliche Inhalte eingesetzt.
Generative Modelle kommen zum Einsatz, wenn Aufgaben auf der gemeinsamen Verteilung der Daten basieren. Die gemeinsame Verteilung von Asset-Renditen zu modellieren, um das erwartete Risiko-/Ertragsprofil eines Portfolios abzuschätzen, ist Standard in der Finanz- und Risikosteuerung.
Ein:e Portfoliomanager:in möchte z. B. wissen, mit welcher Wahrscheinlichkeit die Kurse zweier Aktien gleichzeitig steigen oder fallen – gemeinsame Dichten beantworten solche Fragen.
Die Finanzbranche nutzt diese statistischen Methoden schon lange, bevor der Begriff „generative Modelle“ verbreitet war.
Probleme der unüberwachten Klassifikation eignen sich besonders für Gaussian Mixture Models. Du hast viele Datenpunkte, kennst aber weder Anzahl noch Art der Kategorien. Es ist plausibel, dass die Daten aus einer Kombination von Verteilungen stammen – genau das modelliert ein GMM.
Wären Anzahl und Liste der Kategorien vorab bekannt, wären diskriminative Methoden geeigneter.
GMMs sind auch hilfreich in der Ausreißeranalyse (Anomalie- oder Betrugserkennung), wenn „normales“ Verhalten – etwa unterschiedlicher Kundensegmente – als Mischung verschiedener Verteilungen modelliert werden kann. Deutlich abweichende Punkte gelten dann als Anomalien.
Sequenzaufgaben werden häufig mit Hidden-Markov-Modellen gelöst. Ein typischer Fall ist die Modellierung von Genomsequenzen und Resequenzierung.
HMMs werden auch in der Spracherkennung genutzt, um die nächste Silbe aus der vorhergehenden Sequenz vorherzusagen. Sequenzmodellierung ist ebenso gängig in der Logistik, z. B. bei Zustellplänen. Auch Ausbreitung und Übertragung von Infektionskrankheiten werden oft mit Markov-Ketten modelliert.
Mathematisch werden diskriminative Modelle dort eingesetzt, wo nur die bedingte, nicht aber die gemeinsame Wahrscheinlichkeit relevant ist. Typischerweise betrifft das Klassifikations- und Vorhersageprobleme.
Beispiele:
Überwachte Klassifikation, bei der die Klassen im Voraus bekannt sind, ist der Paradefall für KNNs und SVMs.
Du hast viele Datenpunkte – z. B. Kundenverhalten: Ausgabenmuster, Einkaufsbeträge, Kaufhäufigkeit, Rücksendehistorie usw. – und möchtest Kund:innen in Kategorien wie Vielkäufer, Schnäppchenjäger, Stammkundschaft, Wenigaktive usw. einteilen. Im Unterschied dazu werden bei unüberwachter Klassifikation – wie oben beschrieben – häufig GMMs verwendet.
Bei prädiktiven Aufgaben wie Klassifikation und Regression zählen oft Geschwindigkeit und Genauigkeit. Grundsätzlich können auch generative Modelle solche Probleme lösen.
Sie sind insbesondere sinnvoll, wenn Datenpunkte fehlen, nur wenig Trainingsdaten vorliegen oder regelmäßig neue Klassen hinzukommen.
Für Standardfälle leiden generative Modelle jedoch unter höheren Fehlerraten und langsamerer Inferenz, weil die Berechnung die gemeinsame Verteilung involviert. Für gängige Klassifikations- und Regressionsprobleme mit ausreichend guten Trainingsdaten sind diskriminative Modelle daher meist die bessere Wahl.
Wenn nur das Klassifikationsergebnis zählt und nicht die Modellierung der zugrunde liegenden Daten, sind diskriminative Modelle im Vorteil.
Möchtest du z. B. Audioaufnahmen Sprachen zuordnen, brauchst du kein Modell, das Sprache und Grammatik versteht. Ein Speech-Recognition-Modell wäre hier überdimensioniert. Eine Fokussierung auf die Entscheidungsgrenze mit einem diskriminativen Modell genügt – etwa ein einfaches neuronales Netz statt eines LLM oder eine logistische Regression statt eines Bayes’schen Modells.
Mehrstufige Entscheidungen mit klaren Auswahlkriterien eignen sich gut für Entscheidungsbäume. Oft dienen sie als Vorfilter, um Fälle für eine tiefergehende Analyse zu markieren.
In der Betrugserkennung – die häufig mit komplexen Modellen wie GMMs gelöst wird – prüfen Menschen verdächtige Transaktionen meist ohnehin. Eine Alternative ist ein Entscheidungsbaum, der potenziell betrügerische Transaktionen für die manuelle Prüfung kennzeichnet.
Entscheidungsbäume kommen auch in vielen Geschäftsprozessen zum Einsatz, um je nach Bedingungen die passende Maßnahme zu wählen. Dafür braucht es weder generative Modelle noch komplexe diskriminative Modelle wie neuronale Netze.
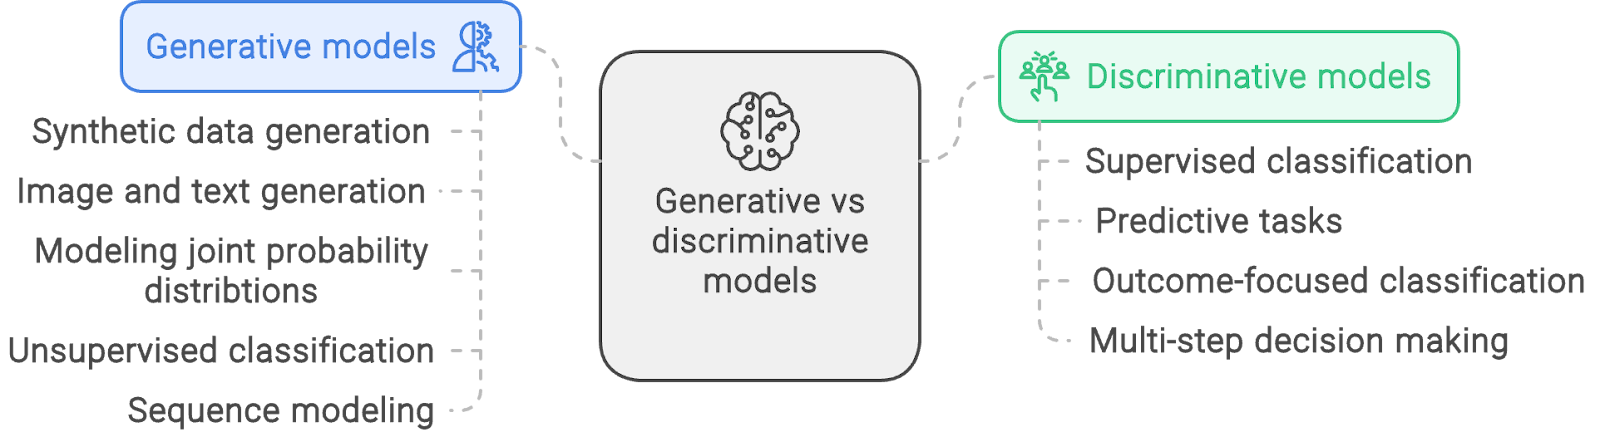
Beispielanwendungen generativer vs. diskriminativer Modelle. Erstellt mit napkin.ai
Dieser Artikel hat die Grundprinzipien und wichtigsten Unterschiede zwischen generativen und diskriminativen Modellen – den beiden großen Ansätzen im Machine Learning – erläutert.
Auch wenn die meisten ML-Methoden probabilistisch sind, arbeiten generative Modelle mit der gemeinsamen Verteilung, während diskriminative Modelle ausschließlich bedingte Wahrscheinlichkeiten nutzen. Dadurch unterscheiden sich Einsatzfelder und Leistungseigenschaften. Angesichts der Vielfalt an Modellen ist die Wahl des richtigen Werkzeugs entscheidend.
Über das konzeptionelle Verständnis hinaus ist es am wichtigsten, selbst Modelle zu bauen. Starte mit dem Blogpost zu überwachten Lernverfahren und der Implementierung einer einfachen logistischen Regression.
Vertiefe dein Machine-Learning-Wissen mit diesen Kursen!
Kurs
Kurs
Kurs