
कोर्स
Understanding Machine Learning
2 घंटा
310.9K
मशीन लर्निंग (ML) मॉडल सांख्यिकीय और प्रायिक विधियों के कंप्यूटर-आधारित कार्यान्वयन हैं। ये आम तौर पर दो में से एक दृष्टिकोण अपनाते हैं: जनरेटिव या डिस्क्रिमिनेटिव मॉडलिंग।
इस लेख में, हम जनरेटिव और डिस्क्रिमिनेटिव मॉडलों का एक अवलोकन प्रस्तुत करते हैं, प्रत्येक प्रकार के सामान्य मॉडलों का परिचय देते हैं, दोनों दृष्टिकोणों के पीछे के गणितीय सिद्धांत समझाते हैं, और उन समस्या-प्रकारों के व्यावहारिक उदाहरणों पर चर्चा करते हैं जिनके लिए प्रत्येक प्रकार के मॉडल का उपयोग किया जा सकता है।
उदाहरण डेटा बिंदुओं का एक सेट, D, और उनके संबद्ध लेबल, L, दिए जाने पर, एक जनरेटिव मॉडल संयुक्त प्रायिकता वितरण P(D, L) सीखता है। फिर यह इस अंतर्निहित वितरण का उपयोग प्रशिक्षण उदाहरणों के समान नया डेटा उत्पन्न करने या वर्गीकरण समस्याओं को हल करने के लिए करता है।
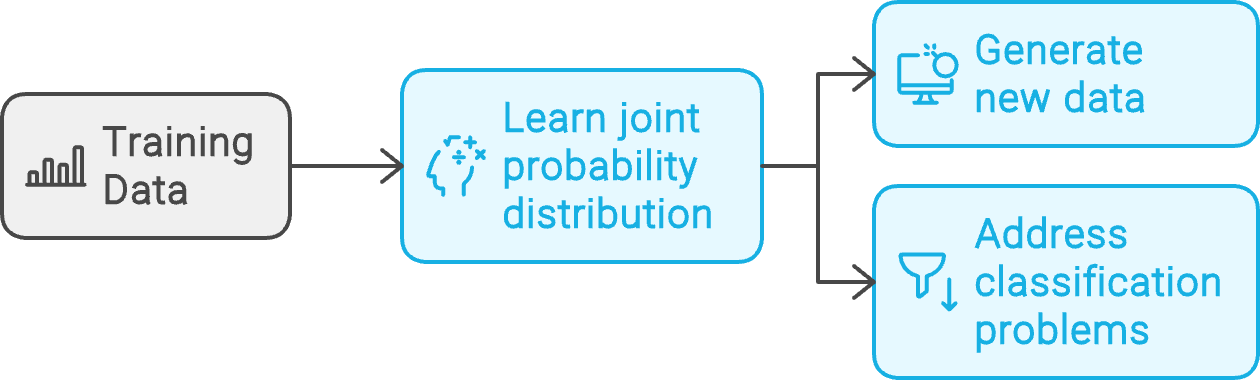
जनरेटिव मॉडल वर्कफ़्लो। napkin.ai के साथ बनाया गया
निम्नलिखित अनुभागों में उदाहरणों के साथ जनरेटिव मॉडलों की बुनियाद समझाई गई है।
नाइव बेयेज़ मॉडल बेयेज़ प्रमेय पर आधारित होते हैं। यह प्रमेय, घटना B के सत्य होने पर, घटना A की सशर्त प्रायिकता P(A | B) देता है। इसे A का B दिए जाने पर पश्च प्रायिकता कहा जाता है।
अलग से, घटना A की प्रायिकता P(A) को पूर्व प्रायिकता कहा जाता है। नाइव बेयेज़ मॉडल मानते हैं कि A और B स्वतंत्र घटनाएँ हैं — इसलिए उपसर्ग “नाइव”। यदि A और B परस्पर निर्भर हों, तो पारंपरिक बेयेज़ प्रमेय लागू नहीं होता और नाइव बेयेज़ मॉडल उपयुक्त नहीं रहते।
बेयेज़ियन मॉडल जनरेटिव होते हैं क्योंकि वे संयुक्त प्रायिकता वितरण का मॉडल बनाते हैं। प्रशिक्षण प्रक्रिया संयुक्त प्रायिकता—P(A, B)—सीखती है। प्रशिक्षण के बाद, इसका उपयोग उन A के मानों की भविष्यवाणी करने के लिए किया जा सकता है जिनकी प्रायिकता P(A) सर्वाधिक हो। इसके अलावा, बेयेज़ियन मॉडलों का उपयोग वर्गीकरण के लिए भी किया जा सकता है क्योंकि वे सशर्त प्रायिकताएँ (बेयेज़ नियम का उपयोग करके) गणना कर सकते हैं।
व्यवहार में नाइव बेयेज़ मॉडल का उपयोग करना सीखने के लिए, scikit-learn और Python के साथ नाइव बेयेज़ मॉडल बनाने पर ट्यूटोरियल का पालन करें।
गौसियन मिक्सचर मॉडल (GMM) मिक्सचर मॉडलों का एक वर्ग है। इनका अनूठा आधार यह है कि अंतर्निहित डेटा एकल वितरण के बजाय सांख्यिकीय वितरणों के संयोजन से बना होता है।
GMM में, जनसंख्या को विभिन्न उप-जनसंख्याओं के संयोजन के रूप में माना जाता है, जिनमें से प्रत्येक एक गौसियन वितरण होता है। प्रभावी रूप से, डेटा वितरण का विश्लेषण कुछ व्यक्तिगत गौसियन वितरणों के भारित औसत के रूप में किया जाता है।
GMM अंतर्निहित डेटासेट के प्रायिकता वितरण को कैप्चर करते हैं। इसलिए, इनका उपयोग आउटलायर विश्लेषण और अनसुपरवाइज्ड वर्गीकरण जैसे कार्यों के लिए किया जाता है। ये कार्य प्रशिक्षण डेटासेट को एक रैंडम सैंपल मानकर जनसंख्या का सांख्यिकीय मॉडल बनाना शामिल करते हैं।
R में मिक्सचर मॉडल पर कोर्स GMMs के व्यवहारिक विवरण में जाता है।
जनरेटिव एडवरसैरियल नेटवर्क (GAN) एक न्यूरल नेटवर्क-आधारित मॉडल है। इसमें दो भाग होते हैं: जेनरेटर और डिस्क्रिमिनेटर। जेनरेटर नेटवर्क को प्रशिक्षण उदाहरणों के समान वेक्टर उत्पन्न करने के लिए प्रशिक्षित किया जाता है, जबकि डिस्क्रिमिनेटर को मूल उदाहरणों और जेनरेटर द्वारा उत्पन्न उदाहरणों के बीच अंतर करने के लिए प्रशिक्षित किया जाता है।
मूल रूप से, जेनरेटर और डिस्क्रिमिनेटर के प्रशिक्षण लक्ष्य एक-दूसरे के विपरीत होते हैं, जो उन्हें एडवरसैरियल बनाते हैं। इसलिए नाम में “एडवरसैरियल” शब्द प्रयोग होता है।
जेनरेटर और डिस्क्रिमिनेटर को एक ही प्रशिक्षण लूप में साथ प्रशिक्षित किया जाता है। जैसे-जैसे जेनरेटर यथार्थपूर्ण उदाहरण बनाने में बेहतर होता जाता है, डिस्क्रिमिनेटर मूल और जेनरेट किए गए उदाहरणों में अंतर बताता है। प्रशिक्षण तब तक चलता है जब तक जेनरेटर ऐसे उदाहरण बनाना न सीख ले जो प्रशिक्षण डेटा से इतने समान हों कि डिस्क्रिमिनेटर उनमें भेद न कर सके।
प्रशिक्षण के बाद, जेनरेटर का उपयोग मूल उदाहरणों के समान यथार्थपूर्ण सिंथेटिक डेटा बनाने के लिए किया जाता है।
हिडन मार्कोव मॉडल (HMM) अनुक्रमिक डेटासेट के साथ काम करता है। मार्कोव प्रक्रियाओं (या मार्कोव श्रृंखलाओं) का उपयोग अनुक्रमिक डेटा का मॉडल बनाने के लिए किया जाता है। मार्कोव मॉडल का आधार यह है कि अनुक्रम का अगला तत्व, xn+1, केवल पिछले तत्व xn पर निर्भर करता है, उससे पहले के किसी भी तत्व {x1, x2, ... xn-1} पर नहीं। मार्कोव मॉडल मानते हैं कि अनुक्रमिक डेटासेट को छिपी हुई अवस्थाओं वाली मार्कोव प्रक्रियाओं द्वारा दर्शाया जा सकता है।
ये अवस्थाएँ अनुक्रम में अगला तत्व उत्पन्न करती हैं:
मार्कोव मॉडल को ट्रांज़िशन प्रायिकताओं (एक अवस्था से दूसरी में जाना) और एमिशन प्रायिकताओं (किसी विशिष्ट अवस्था के दिए जाने पर किसी विशिष्ट अनुक्रम तत्व का उत्पन्न होना) के साथ दर्शाया जाता है।
HMM प्रशिक्षण डेटासेट को मार्कोव प्रक्रियाओं के रूप में मॉडल करते हैं। प्रशिक्षण का लक्ष्य उन ट्रांज़िशन और एमिशन प्रायिकताओं का निर्धारण करना है जो उदाहरण डेटासेट में अनुक्रमों को उत्पन्न करने की प्रायिकता को अधिकतम करें। इस प्रकार, किसी अनुक्रम के दिए जाने पर, एक प्रशिक्षित मार्कोव मॉडल उस अनुक्रम के उत्तरवर्ती तत्व उत्पन्न कर सकता है।
उनके व्यवहारिक कार्यान्वयन के बारे में जानने के लिए, Python में मार्कोव चेन पर ट्यूटोरियल देखें।
डेटा बिंदुओं D और उनके संबद्ध लेबल L से बने एक प्रशिक्षण डेटासेट के दिए जाने पर, एक डिस्क्रिमिनेटिव मॉडल सशर्त प्रायिकता वितरण P(D | L) सीखता है। फिर यह इस सशर्त प्रायिकता वितरण का उपयोग नए डेटा बिंदुओं के वर्ग की भविष्यवाणी करने के लिए करता है।
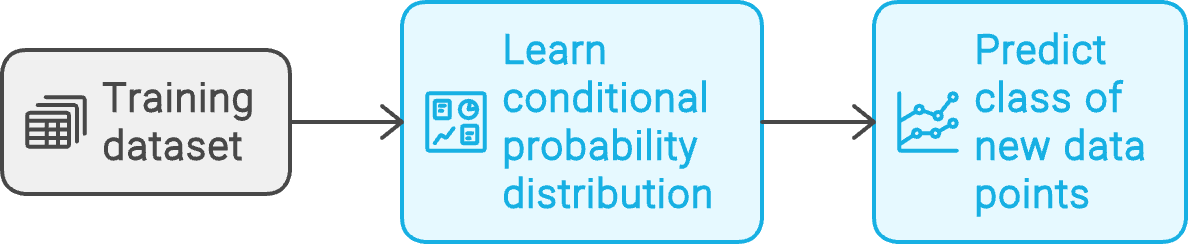
डिस्क्रिमिनेटिव मॉडल वर्कफ़्लो। napkin.ai के साथ बनाया गया
डिस्क्रिमिनेटिव मॉडल आम तौर पर वर्गीकरण समस्याओं को हल करने के लिए उपयोग किए जाते हैं। निम्नलिखित उदाहरण उनके उपयोग मामलों को दर्शाते हैं।
K-निकटतम पड़ोसी (KNN) पुराने मशीन लर्निंग मॉडलों में से एक है। यह इस आधार पर है कि, डेटा बिंदुओं के वितरण के दिए जाने पर, समान आइटम निकटता में स्थित होते हैं।
KNN मॉडल नॉनपैरामेट्रिक होते हैं, जिनमें प्रतिगमन गुणांक जैसी पैरामीटर नहीं होते। इनका उपयोग वर्गीकरण और प्रतिगमन दोनों समस्याओं के लिए किया जाता है।
किसी इनपुट डेटा बिंदु की श्रेणी उसके k निकटतम पड़ोसियों के समान होती है। किसी डेटा बिंदु के पूर्वानुमानित मान उसके k निकटतम पड़ोसियों के औसत मान के बराबर होता है। k (विचार करने वाले निकटतम पड़ोसियों की संख्या) को मॉडल का हाइपरपैरामीटर माना जा सकता है। इसका उपयोग मॉडल के व्यवहार को ट्यून करने के लिए किया जाता है, लेकिन यह सीधे मॉडल के आउटपुट को प्रभावित नहीं करता।
लॉजिस्टिक रिग्रेशन, रैखिक रिग्रेशन की तरह, एक या अधिक स्वतंत्र चर के आधार पर आश्रित चर का मान अनुमानित करने की कोशिश करता है। रैखिक रिग्रेशन में आश्रित चर सतत मान लेता है। लॉजिस्टिक रिग्रेशन में, आश्रित चर अविच्छिन्न मान लेता है, जैसे:
रैखिक रिग्रेशन संख्यात्मक मानों की भविष्यवाणी करता है। लॉजिस्टिक रिग्रेशन में, पूर्वानुमानित मात्रा ऑड्स रेशियो का लघुगणक होती है।
घटना A की प्रायिकता P(A) होने पर, ऑड्स रेशियो P(A) / (1 - P(A)) होता है। ऑड्स रेशियो का लघुगणक लेने से प्रशिक्षण प्रक्रिया के दौरान अधिक स्मूद और तेज़ अभिसरण मिलता है। इनपुट को वर्गों में विभाजित करने की क्षमता के कारण, लॉजिस्टिक मॉडल डिस्क्रिमिनेटिव उद्देश्यों के लिए उपयोग किए जाते हैं।
इस विषय का अधिक हस्त-परिचय पाने के लिए, Python में लॉजिस्टिक रिग्रेशन पर गाइड देखें।
आप सांख्यिकी-उन्मुख प्रोग्रामिंग भाषा R का उपयोग करके भी लॉजिस्टिक रिग्रेशन लागू कर सकते हैं, जैसा कि R में लॉजिस्टिक रिग्रेशन पर ट्यूटोरियल में समझाया गया है।
सपोर्ट वेक्टर मशीनें विभिन्न वर्गों के डेटा बिंदुओं को अलग करने वाली इष्टतम रेखा निर्धारित करती हैं। 2-आयामी X-Y तल में, दो विभिन्न श्रेणियों के डेटा बिंदुओं के संग्रह के दिए जाने पर, SVM एक ऐसी रेखा का पूर्वानुमान करता है जो (आदर्श रूप से) एक श्रेणी के बिंदुओं को दूसरी से साफ़-साफ़ अलग कर दे।
यह रेखा निर्णय सीमा कहलाती है। तीन या अधिक आयामों वाले डेटा के लिए यह एक हाइपरप्लेन बन जाती है। इस काल्पनिक रेखा के सबसे पास (किसी भी श्रेणी से) स्थित डेटा बिंदु मॉडल के सपोर्ट वेक्टर कहलाते हैं। इन डेटा बिंदुओं का वर्गीकृत करना सबसे कठिन होता है क्योंकि इनके मान पास-पास होते हैं।
अलग करने वाली रेखा और सपोर्ट वेक्टर के बीच की दूरी को मार्जिन कहा जाता है। SVM प्रशिक्षण का उद्देश्य उस निर्णय सीमा को खोजना है जो इस मार्जिन को अधिकतम करे। व्यवहार में, डेटा बिंदुओं के दो से अधिक आयाम होते हैं और अलग करने वाली रेखा उच्च-आयामी हाइपरप्लेन होती है।
SVM का उपयोग मल्टी-क्लास वर्गीकरण समस्याओं के लिए भी किया जाता है।
SVM के बारे में अधिक जानने के लिए, Python scikit-learn पैकेज का उपयोग कर SVM बनाने पर यह गाइड देखें। Python के अलावा, आप R का उपयोग करके भी SVM लागू कर सकते हैं, जैसा कि R में SVM पर इस गाइड में चर्चा की गई है।
एक डिसीजन ट्री कई निर्णय नोड्स से बना होता है जो पेड़ जैसी संरचना में संगठित होते हैं।
सबसे ऊपर का नोड रूट कहलाता है। जो नोड अंतिम आउटपुट देते हैं उन्हें लीफ नोड या टर्मिनल नोड कहते हैं। मध्यवर्ती गैर-लीफ नोड्स को इंटरनल नोड्स कहते हैं। रूट नोड से निकला आउटपुट मध्यवर्ती नोड्स में जाता है। प्रत्येक नोड का परिणाम (आउटपुट) या तो अंतिम आउटपुट होता है या किसी अन्य नोड की ओर (ब्रांच होकर) ले जाता है।
ट्री का प्रत्येक नोड किसी विशिष्ट गुण के आधार पर डेटासेट को विभाजित करता है। उदाहरण के लिए, ऋण आवेदन स्वीकृति के लिए एक डिसीजन ट्री में ऐसे नोड्स हो सकते हैं जो शुद्ध आय के आधार पर आवेदनों को अलग करें।
प्रशिक्षण प्रक्रिया प्रत्येक निर्णय के लिए उपयुक्त थ्रेशोल्ड मान निर्धारित करती है। उदाहरण के लिए, जिन आवेदनों की शुद्ध आय एक निश्चित राशि से कम है, उन्हें सीधे अस्वीकार कर दिया जाता है। बाकी को आगे के नोड्स में संसाधित किया जाता है, जो शुद्ध संपत्ति जैसे अन्य गुणों पर विचार करते हैं।
डिसीजन ट्री के लिए हस्त-मार्गदर्शिका हेतु, Python का उपयोग करके डिसीजन ट्री बनाने पर ट्यूटोरियल या Python में ट्री-आधारित मॉडलों के साथ मशीन लर्निंग पर पूरा कोर्स देखें।
डिसीजन ट्री की मुख्य कमी ओवरफिटिंग है, जो आउट-ऑफ-सैंपल डेटा समस्याओं की ओर ले जाती है। डिसीजन फॉरेस्ट इस समस्या को हल करने की कोशिश करते हैं। एक डिसीजन फॉरेस्ट में कई ट्री होते हैं। स्टैंडअलोन डिसीजन ट्री के विपरीत, जिन्हें पूरे फीचर सेट पर विचार करना पड़ता है, फॉरेस्ट में प्रत्येक ट्री केवल फीचर सेट के एक रैंडम सबसेट को देखता है। यह रैंडमनैस शोरयुक्त डेटासेट में वैरिएंस को संभालने में मदद करती है।
फॉरेस्ट का आउटपुट, उदाहरण के लिए, व्यक्तिगत ट्री के आउटपुट का औसत लेकर, संयोजित करके प्राप्त किया जाता है।
रैंडम फॉरेस्ट को लागू करना सीखने के लिए, scikit-learn का उपयोग कर रैंडम फॉरेस्ट क्लासिफायर बनाने पर गाइड देखें।
एक न्यूरल नेटवर्क न्यूरॉनों के समूहों से बना होता है। प्रत्येक न्यूरॉन एक रैखिक फ़ंक्शन लागू करता है जो न्यूरॉन के वेट्स को इनपुट वेक्टर से गुणा करता है।
रैखिक फ़ंक्शन के बाद एक गैर-रैखिक सक्रियण फ़ंक्शन आता है। सक्रियण फ़ंक्शन रैखिक फ़ंक्शन के आउटपुट के आधार पर प्रत्येक न्यूरॉन का आउटपुट निर्धारित करता है। इस प्रकार, एक सरल न्यूरल नेटवर्क को वैचारिक रूप से गैर-रैखिक सक्रियणों द्वारा फ़िल्टर की गई रैखिक समीकरणों की श्रृंखला के रूप में देखा जा सकता है।
न्यूरल नेटवर्क की इनपुट लेयर इनपुट (जिसे एक वेक्टर के रूप में दर्शाया जाता है) को वेट्स और सक्रियण फ़ंक्शनों के एक सेट से गुणा करती है। यह आउटपुट अगली लेयर को पास किया जाता है, जो समान ऑपरेशन करती है।
हिडन लेयर इनपुट और आउटपुट लेयरों के बीच होती हैं। अंतिम हिडन लेयर आउटपुट लेयर में फीड करती है। जटिल समस्याओं में कई हिडन लेयर वाले न्यूरल नेटवर्क का उपयोग होता है, जिन्हें डीप न्यूरल नेटवर्क (DNNs) कहा जाता है।
वर्गीकरण समस्या में, एक सामान्य तरीका यह है कि आउटपुट न्यूरॉनों की संख्या वर्गों की संख्या के बराबर हो। पूर्वानुमानित वर्ग वह होता है जिसका न्यूरॉन मान सबसे अधिक हो। प्रतिगमन समस्या में, एक अकेला आउटपुट न्यूरॉन पूर्वानुमानित आउटपुट रखता है। न्यूरॉनों के रैखिक संबंध रैखिक रिग्रेशन समीकरण का मॉडल बनाते हैं।
विषय की गहरी समझ के लिए, न्यूरल नेटवर्क पर ब्लॉग पोस्ट देखें।
कुछ कार्य, जैसे वर्गीकरण, किसी भी मॉडल प्रकार से हल किए जा सकते हैं। हालांकि, सामान्यतः, डिस्क्रिमिनेटिव और जनरेटिव मॉडलों के अक्सर अलग-अलग उपयोग मामले होते हैं, क्योंकि ये मॉडल भिन्न गणितीय दृष्टिकोण अपनाते हैं। इन अंतरों को समझना और वे कैसे विभिन्न समस्याओं के लिए किसी भी श्रेणी के मॉडलों की उपयुक्तता को प्रभावित करते हैं, आवश्यक है।
जनरेटिव मॉडल अनुक्रम में अगला मान भविष्यवाणी करते हैं या किसी टेक्स्ट के दिए जाने पर छवि (या इसके विपरीत) जनरेट करते हैं। ऐसे कार्य करने के लिए, मॉडल को सीखना होता है कि अलग-अलग इनपुट के दिए जाने पर कौन-सा आउटपुट जनरेट करना है। मॉडल इनपुट और आउटपुट के संयुक्त प्रायिकता वितरण का उपयोग करता है।
अंतर्निहित गणित समझने के लिए, एक सरल उदाहरण से शुरू करें। एक एकल यादृच्छिक चर का व्यवहार उसके प्रायिकता घनत्व फलन (PDF) से वर्णित होता है।
यादृच्छिक चर X का PDF, f(x), अलग-अलग मानों पर X की प्रायिकता निर्धारित करने में उपयोग हो सकता है। उदाहरण के लिए, यदि X का PDF f(x) है, तो X के A और B के बीच होने की प्रायिकता इस प्रकार दी जाती है:

पूरे रेंज पर X की प्रायिकता 1 होती है। इसे इस प्रकार व्यक्त किया जाता है:

ऊपर के व्यंजक को इस रूप में भी लिखा जा सकता है:
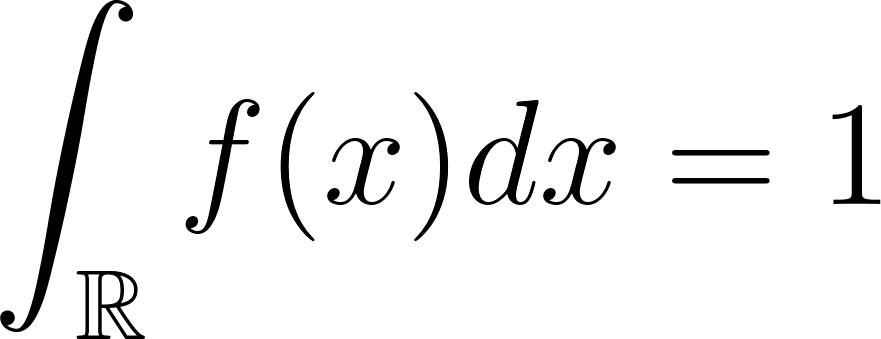
दो चर X और Y के संयुक्त PDF के लिए, पूरे रेंज पर समाकल 1 होता है:

संयुक्त प्रायिकता वितरण X और Y दोनों के पूरे प्रायिकता स्पेस का मानचित्रण करता है। यह आकलन करने के लिए कि संयुक्त प्रायिकता P(X, Y) किसी क्षेत्र G में आती है या नहीं, संयुक्त PDF का G पर समाकलन करें:

इसके विपरीत, डिस्क्रिमिनेटिव मॉडल केवल सशर्त प्रायिकता वितरण पर ध्यान केंद्रित करते हैं। आवश्यकता पड़ने पर, जनरेटिव मॉडल मार्जिनल प्रायिकताओं का उपयोग करके सशर्त प्रायिकता का अनुमान लगाते हैं।
संयुक्त प्रायिकता वितरण fXY(x,y) के दिए जाने पर, यादृच्छिक चर Y का मान y (सभी X के मानों के लिए) पर मार्जिनल प्रायिकता इस प्रकार दी जाती है:
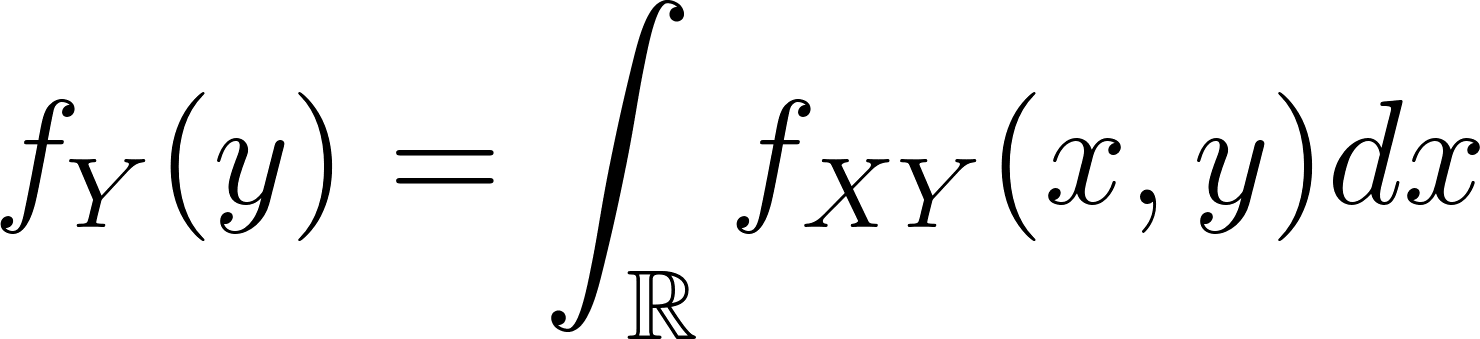
बेयेज़ नियम के समान, तब X का सशर्त PDF इस प्रकार अभिव्यक्त होता है:
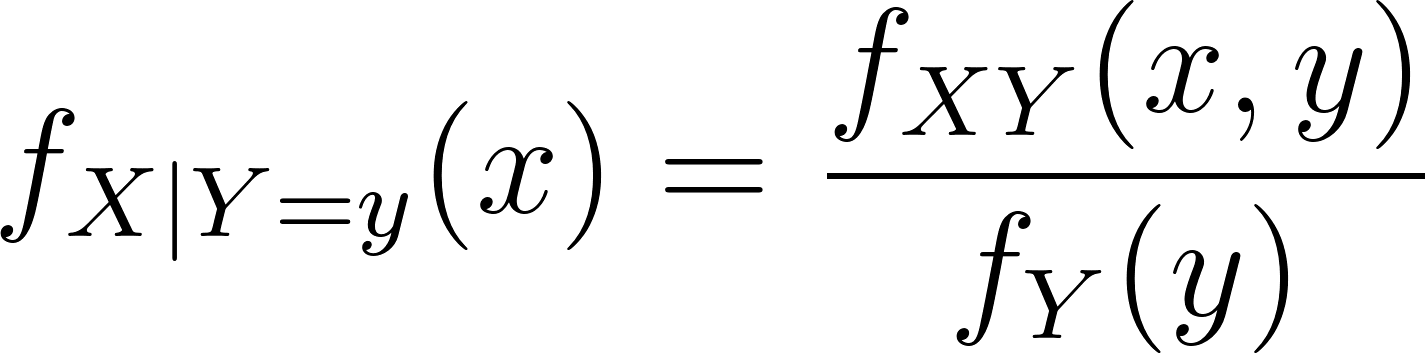
ऊपर का व्यंजक सशर्त प्रायिकता का समाकल रूप दिखाता है, जिसे आमतौर पर इस तरह लिखा जाता है:
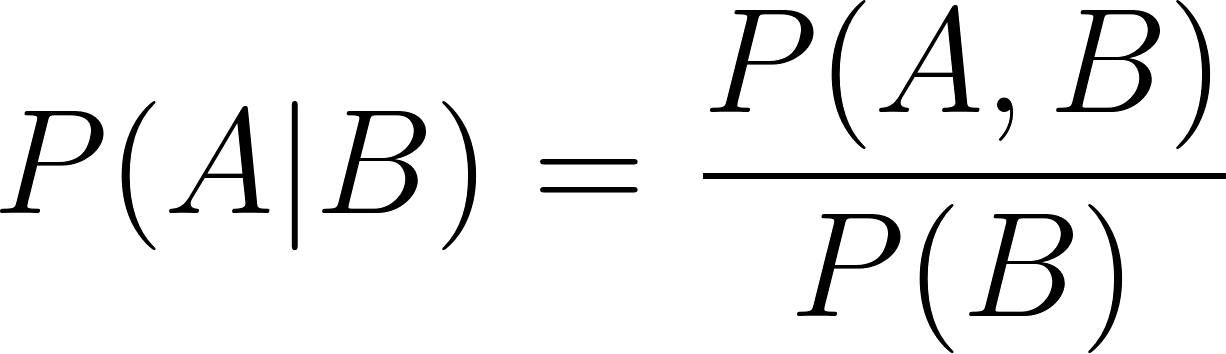
इसी प्रकार,
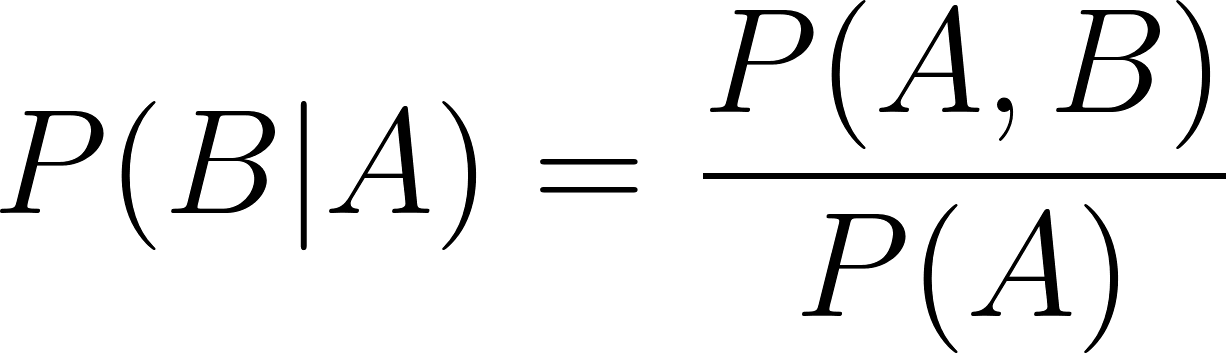
ऊपर दी गई दो सशर्त प्रायिकता सूत्रों में:
किसी सशर्त प्रायिकता की गणना करने के लिए, जनरेटिव मॉडल दो चरण अपनाते हैं:
दूसरी ओर, डिस्क्रिमिनेटिव मॉडल एक एकल (और सरल) चरण अपनाते हैं:
एक जनरेटिव मॉडल के पास मार्जिनल्स P(A) और P(B) तथा संयुक्त PDF P(A, B) होता है। इनके उपयोग से यह समान सरलता से P(A | B) या P(B | A) का आकलन कर सकता है। यही नाइव बेयेज़ क्लासिफायर के पीछे का मूल विचार है। इस प्रकार, जनरेटिव मॉडल ये कार्य कर सकते हैं:
यह जनरेटिव मॉडलों को लचीला और बहुउद्देश्यीय बनाता है। दूसरी ओर, प्रशिक्षण के दौरान इनमें स्वभावतः अधिक जटिलता शामिल होती है क्योंकि:
इसके विपरीत, डिस्क्रिमिनेटिव मॉडल केवल कंडीशनल्स तक सीमित होते हैं। प्रशिक्षण डेटासेट के आधार पर, बिना संयुक्त या मार्जिनल प्रायिकताओं का अनुमान लगाए सीधे सशर्त प्रायिकताओं का अनुमान लगाया जा सकता है।
इस प्रकार, डिस्क्रिमिनेटिव मॉडल प्रशिक्षित करने में सरल होते हैं। हालांकि, एक डिस्क्रिमिनेटिव मॉडल जिसने सशर्त प्रायिकता P(A | B) सीख ली है, केवल इसी विशेष सशर्त प्रायिकता से जुड़े कार्य कर सकता है। वह अन्य कुछ नहीं कर सकता।
जनरेटिव मॉडल जनरेटिव और डिस्क्रिमिनेटिव दोनों कार्यों के लिए पर्याप्त रूप से लचीले होते हैं। प्रशिक्षण के दौरान, मॉडल संयुक्त PDF और मार्जिनल सीखता है। इन्फरेंस के दौरान, मॉडल को संयुक्त वितरण और उपयुक्त मार्जिनल प्रायिकता का उपयोग करते हुए सशर्त प्रायिकता की गणना करनी पड़ती है। इसलिए, डिस्क्रिमिनेटिव कार्यों पर इन्फरेंस धीमा होता है।
इसके विपरीत, डिस्क्रिमिनेटिव मॉडल ने सीधे (सांख्यिकीय रूप से) सशर्त प्रायिकताएँ सीखी होती हैं। वे इन्फरेंस के दौरान इनपुट डेटा के आधार पर एक ही चरण में सशर्त प्रायिकता का आकलन करते हैं।
इसके अलावा, क्योंकि डिस्क्रिमिनेटिव मॉडल केवल एक मात्रा (सशर्त प्रायिकता) के अनुमान पर केंद्रित होते हैं, इन्हें अधिक सटीक पाया गया है। संयुक्त PDF में एक सरल सशर्त प्रायिकता की तुलना में अधिक अनिश्चितता निहित होती है। यह अतिरिक्त अनिश्चितता वर्गीकरण कार्यों के लिए जनरेटिव मॉडलों की अपेक्षाकृत कम सटीकता में परिलक्षित होती है।
पिछले अनुभागों में हुई चर्चा के आधार पर, नीचे दी गई तालिका जनरेटिव और डिस्क्रिमिनेटिव मॉडलों के बीच के अंतरों का सार प्रस्तुत करती है।
|
जनरेटिव मॉडल |
डिस्क्रिमिनेटिव मॉडल |
|
|
उद्देश्य |
संयुक्त प्रायिकता और मार्जिनल प्रायिकता को कैप्चर करना। सशर्त प्रायिकता की गणना के लिए बेयेज़ नियम का उपयोग करना। |
केवल सशर्त प्रायिकता को कैप्चर करना। संयुक्त या मार्जिनल प्रायिकताओं की जानकारी नहीं होती। |
|
डेटा जनरेशन |
प्रशिक्षण डेटासेट के आधार पर नए डेटा बिंदु जनरेट कर सकते हैं। उदाहरण के लिए, हस्तलिखित अंकों पर प्रशिक्षित मॉडल नए, नकली अंक बना सकता है। |
नए डेटा बिंदु जनरेट नहीं कर सकते। मुख्यतः विभिन्न डेटा श्रेणियों में भेद करने पर केंद्रित। |
|
प्राथमिक उपयोग मामला |
जनरेटिव कार्यों (जैसे, डेटा सिंथेसिस) और डिस्क्रिमिनेटिव कार्यों (जैसे, वर्गीकरण) दोनों के लिए उपयोग किए जा सकते हैं। |
केवल वर्गीकरण या प्रतिगमन जैसे डिस्क्रिमिनेटिव कार्यों के लिए उपयोग किए जा सकते हैं। |
|
इन्फरेंस प्रदर्शन |
जटिल गणनाओं की आवश्यकता के कारण इन्फरेंस चलाना धीमा होता है। सरल कार्यों के लिए भी मार्जिनल और संयुक्त प्रायिकताओं की गणना और बेयेज़ नियम लागू करना पड़ता है। |
तेज़ इन्फरेंस क्योंकि यह बेयेज़ नियम में गए बिना सीधे सशर्त प्रायिकता की गणना करता है। |
|
लापता डेटा संभालना |
अंतर्निहित प्रायिकता वितरण का मॉडल बनाकर लापता डेटा संभालने में बेहतर, जिससे “खाली जगहें” भरना आसान हो जाता है। ओवरफिटिंग का जोखिम कम। |
लापता डेटा संभालने में कम प्रभावी। ओवरफिटिंग का जोखिम अधिक क्योंकि मॉडल वर्गों के बीच अलग करने वाले हाइपरप्लेन को खोजने पर केंद्रित होता है। |
|
अभिसरण |
ये कम प्रशिक्षण उदाहरणों के साथ तेज़ी से अभिसरण करने की प्रवृत्ति रखते हैं, लेकिन सामान्यतः उच्च मॉडल त्रुटि देते हैं, विशेषकर वर्गीकरण कार्यों में, क्योंकि सशर्त प्रायिकता का अप्रत्यक्ष रूप से संयुक्त प्रायिकता वितरण मॉडलिंग के माध्यम से आकलन किया जाता है। |
इन्हें सामान्यतः प्रशिक्षण के लिए अधिक डेटा की आवश्यकता होती है और अभिसरण धीमा हो सकता है। फिर भी, परिणामस्वरूप मॉडल त्रुटि कम होती है, खासकर वर्गीकरण कार्यों में, क्योंकि ये संयुक्त प्रायिकता वितरण का अनुमान लगाए बिना सीधे सशर्त प्रायिकता का मॉडल बनाते हैं। |
|
मॉडल जटिलता |
आम तौर पर अधिक जटिल होते हैं क्योंकि ये संपूर्ण डेटा वितरण, जिसमें फीचर्स और लेबल के बीच अंतःक्रियाएँ शामिल हैं, का मॉडल बनाते हैं। |
आम तौर पर अधिक सीधे-सादे होते हैं क्योंकि इन्हें केवल वर्गों के बीच निर्णय सीमा या अलग करने वाला हाइपरप्लेन मॉडल करना होता है। |
|
मॉडलों के उदाहरण |
नाइव बेयेज़, हिडन मार्कोव मॉडल (HMMs), जनरेटिव एडवरसैरियल नेटवर्क (GANs), वैरिएशनल ऑटोएन्कोडर्स (VAEs)। |
लॉजिस्टिक रिग्रेशन, सपोर्ट वेक्टर मशीन (SVMs), न्यूरल नेटवर्क, और डिसीजन ट्री। |
|
मॉडल लचीलापन |
एप्लीकेशन की दृष्टि से अधिक लचीले (जनरेटिव और डिस्क्रिमिनेटिव दोनों कार्य संभाल सकते हैं)। |
कम लचीले (डिस्क्रिमिनेटिव कार्यों तक सीमित)। |
|
त्रुटि दर |
अप्रत्यक्ष अनुमान विधियों के कारण वर्गीकरण कार्यों में उच्च त्रुटि दर। |
सशर्त प्रायिकता पर सीधे प्रशिक्षण के कारण वर्गीकरण कार्यों में कम त्रुटि दर। |
जैसा कि नाम से स्पष्ट है, जनरेटिव मॉडल उन कार्यों के लिए विशिष्ट रूप से उपयुक्त होते हैं जिनमें प्रशिक्षण डेटा में मौजूद पैटर्न के अनुरूप नया डेटा जनरेट करना शामिल है।
इन मॉडलों के कुछ सामान्य उपयोग मामले हैं:
कई कंप्यूटर विज़न मॉडलों के लिए, प्रशिक्षण छवियों का बड़ा डेटासेट होना आवश्यक है। इन मॉडलों को एक ही छवि या फीचर के कई वैरिएंट्स पर प्रशिक्षित करने की आवश्यकता होती है।
एक ही वस्तु की विभिन्न कोणों, पृष्ठभूमियों या रंगों के शेड्स से तस्वीरें लेना हमेशा व्यावहारिक नहीं होता। कई टास्क-विशिष्ट इमेज डेटासेट भी आकार में सीमित रहते हैं क्योंकि उन्हें बनाने के लिए डोमेन-विशिष्ट कौशल की आवश्यकता होती है। उदाहरण के लिए, किसी विशिष्ट फेफड़ों की बीमारी के एक्स-रे के इमेज सेट बनाने के लिए आपको पल्मोनोलॉजिस्ट, रेडियोलॉजी लैब, और सहमति देने वाले मरीजों व अस्पतालों तक पहुँच चाहिए।
ऐसे मामलों में, सबसे व्यावहारिक विकल्प एक छोटा लेकिन उच्च-क्यूरेटेड और प्रासंगिक डेटासेट बनाना और फिर मूल डेटासेट के समान सिंथेटिक रूप से नए डेटा बिंदु जनरेट करना होता है।
किसी टेक्स्ट विवरण के दिए जाने पर नई छवियाँ जनरेट करना या कुछ इनपुट टेक्स्ट के दिए जाने पर नया पाठ जनरेट करना। ऐसे कार्यों को संभालने वाली एकमात्र मॉडल श्रेणी जनरेटिव मॉडल हैं।
DALL-E, DALL-E, MidJourney, और Stable Diffusion जैसे इमेज जनरेशन मॉडल नियमित रूप से ऐसी छवियाँ बनाने के लिए उपयोग किए जाते हैं जो किसी विशिष्ट विवरण के अनुरूप हों और मौजूदा कॉपीराइट का उल्लंघन न करें।
इसी प्रकार, LLMs का उपयोग अक्सर काल्पनिक कहानी प्लॉट, मार्केटिंग स्लोगन और टैगलाइन, दस्तावेज़ सारांश और अन्य समान सामग्री जनरेट करने के लिए किया जाता है।
जनरेटिव मॉडल का उपयोग उन कार्यों के लिए किया जाता है जो अंतर्निहित डेटा के संयुक्त प्रायिकता वितरण पर आधारित होते हैं। किसी निवेश पोर्टफोलियो की अपेक्षित जोखिम और रिटर्न प्रोफ़ाइल का पूर्वानुमान लगाने के लिए एसेट रिटर्न्स के संयुक्त वितरण का मॉडल बनाना वित्त और जोखिम प्रबंधन में मानक है।
उदाहरण के लिए, कोई निवेश प्रबंधक यह जानना चाह सकता है कि दो अलग-अलग शेयरों की कीमतें एक ही समय पर बढ़ने या गिरने की प्रायिकता क्या है — संयुक्त PDFs ऐसे प्रश्नों का उत्तर दे सकते हैं।
वित्तीय सेवाओं का उद्योग इन सांख्यिकीय विधियों का उपयोग उस समय से करता आया है जब “जनरेटिव मॉडल” शब्द व्यापक रूप से अपनाया नहीं गया था।
अनसुपरवाइज्ड वर्गीकरण जैसी समस्याएँ गौसियन मिक्सचर मॉडलों के लिए विशिष्ट रूप से उपयुक्त होती हैं। इन समस्याओं में आपके पास डेटा बिंदुओं का एक बड़ा संग्रह होता है, लेकिन यह नहीं पता होता कि वे कितनी या किन श्रेणियों से संबंधित हैं। यह मानना उचित है कि डेटा कई वितरणों के संयोजन से आता है, जिसे GMM मॉडल कर सकता है।
यदि श्रेणियों की संख्या और सूची पहले से ज्ञात होती, तो डिस्क्रिमिनेटिव विधियाँ अधिक उपयुक्त होतीं।
GMM आउटलायर विश्लेषण (एनॉमली डिटेक्शन, फ्रॉड डिटेक्शन, आदि) में भी सहायक होते हैं, जहाँ “सामान्य” डेटा, जैसे अलग-अलग ग्राहक समूहों का व्यवहार, विभिन्न वितरणों के संयोजन के रूप में मॉडल किया जा सकता है। असामान्य डेटा बिंदु वे होते हैं जो अन्य किसी भी पैटर्न से काफ़ी भिन्न होते हैं।
अनुक्रमों से जुड़ी समस्याएँ अक्सर हिडन मार्कोव मॉडल का उपयोग करके हल की जाती हैं। एक रोज़मर्रा का उपयोग मामला जीनोम अनुक्रमों का मॉडलिंग और री-सीक्वेंसिंग है।
HMM का उपयोग वाक् पहचान में भी होता है, जहाँ वे पूर्ववर्ती अक्षरांशों के अनुक्रम के दिए जाने पर अगले अक्षरांश की भविष्यवाणी करने में मदद करते हैं। अनुक्रम मॉडलिंग लॉजिस्टिक्स अनुप्रयोगों जैसे पैकेज डिलीवरी शेड्यूल में भी मानक है। इसी प्रकार, संक्रामक रोगों का प्रसार और संचरण अक्सर मार्कोव चेन का उपयोग करके मॉडल किया जाता है।
गणितीय रूप से, डिस्क्रिमिनेटिव मॉडल उन अनुप्रयोगों के लिए उपयोग किए जाते हैं जहाँ केवल सशर्त प्रायिकता प्रासंगिक होती है, न कि संयुक्त प्रायिकता। इसलिए, डिस्क्रिमिनेटिव मॉडल आमतौर पर वर्गीकरण और पूर्वानुमान (प्रेडिक्शन) समस्याओं के लिए उपयोग किए जाते हैं।
कुछ उदाहरण हैं:
सुपरवाइज्ड वर्गीकरण समस्याएँ, जहाँ वर्ग (श्रेणियाँ) पहले से ज्ञात होते हैं। यह KNN और SVMs के लिए आदर्श उपयोग मामला है।
आपके पास ग्राहक व्यवहार डेटा जैसा डेटा बिंदुओं का बड़ा संग्रह है, जिसमें खर्च के पैटर्न, खरीद राशि, खरीद आवृत्ति, रिटर्न इतिहास आदि शामिल हैं। आपको इस जानकारी का उपयोग ग्राहकों को अलग-अलग श्रेणियों में वर्गीकृत करने के लिए करना है, जैसे हाई स्पेंडर, बार्गेन हंटर, रेगुलर कस्टमर, नॉन-सीरियस कस्टमर आदि। इसकी तुलना अनसुपरवाइज्ड वर्गीकरण समस्याओं से करें, जहाँ, जैसा पहले चर्चा की गई, GMM का आमतौर पर उपयोग होता है।
वर्गीकरण और प्रतिगमन जैसे प्रेडिक्टिव कार्यों में प्राथमिकता अक्सर गति और सटीकता होती है। सैद्धांतिक रूप से, जनरेटिव मॉडल भी ऐसे कार्यों को हल करने में सक्षम हैं।
विशेष रूप से, जब लापता डेटा बिंदुओं जैसी समस्याएँ हों, प्रशिक्षण के लिए केवल सीमित डेटासेट उपलब्ध हो, या आप नियमित रूप से नई श्रेणियाँ जोड़ने की अपेक्षा करें, तब जनरेटिव मॉडल को वरीयता दी जाती है।
हालाँकि, अधिकांश मानक उपयोग मामलों में, जनरेटिव मॉडलों को प्रेडिक्टिव कार्यों में उच्च त्रुटि दर और धीमे इन्फरेंस से जूझना पड़ता है क्योंकि उनकी गणना में संयुक्त प्रायिकता वितरण शामिल होता है। इसलिए, मानक वर्गीकरण और प्रतिगमन समस्याओं के लिए, जहाँ प्रशिक्षण हेतु बड़ा और स्वस्थ डेटासेट उपलब्ध है, बेहतर प्रदर्शन गुणों के कारण डिस्क्रिमिनेटिव मॉडल पसंदीदा विकल्प होते हैं।
वे कार्य जो केवल वर्गीकरण के परिणाम पर केंद्रित हों और अंतर्निहित डेटा का मॉडल बनाने पर नहीं, उनके लिए डिस्क्रिमिनेटिव मॉडल वांछनीय होते हैं।
उदाहरण के लिए, यदि आप ऑडियो रिकॉर्डिंग्स को उनकी भाषाओं में वर्गीकृत करना चाहते हैं, तो आपको ऐसी मॉडल की आवश्यकता नहीं जो भाषा और व्याकरण को समझे। वर्गीकरण समस्या के लिए वाक् पहचान मॉडल अत्यधिक होगा। निर्णय सीमा पर केंद्रित होना पर्याप्त है, जो डिस्क्रिमिनेटिव मॉडल से होता है। इसलिए, आप LLM के बजाय एक सरल न्यूरल नेटवर्क या बेयेज़ियन मॉडल के बजाय लॉजिस्टिक रिग्रेशन का उपयोग कर सकते हैं।
बहु-चरणीय निर्णय, जहाँ व्यक्तिगत चरणों में अस्पष्टता रहित विकल्प शामिल हों, डिसीजन ट्री के लिए अच्छे उम्मीदवार हैं। डिसीजन ट्री का अक्सर एक प्रारंभिक फ़िल्टर के रूप में उपयोग किया जाता है ताकि गहन विश्लेषण की आवश्यकता वाले डेटा बिंदुओं की शॉर्टलिस्ट बनाई जा सके।
उदाहरण के लिए, फ्रॉड डिटेक्शन पर विचार करें, जिसे अक्सर GMM जैसे जटिल मॉडलों से हल किया जाता है। मनुष्य लगभग हमेशा उच्च-जोखिम वाले लेनदेन की जाँच करते हैं, चाहे उपयोग किया गया मॉडल कोई भी हो। इसलिए, एक वैकल्पिक दृष्टिकोण है कि डिसीजन ट्री का उपयोग करके संभावित धोखाधड़ी वाले लेनदेन की सूची को आगे की मैनुअल जाँच के लिए फ़्लैग किया जाए।
डिसीजन ट्री का उपयोग कई व्यावसायिक संचालन में भी होता है। लक्ष्य पूर्वनिर्धारित शर्तों के आधार पर सही कार्यपद्धति तय करना होता है। ऐसे कार्यों के लिए न तो जनरेटिव मॉडल चाहिए और न ही न्यूरल नेटवर्क जैसे अधिक जटिल डिस्क्रिमिनेटिव मॉडल।
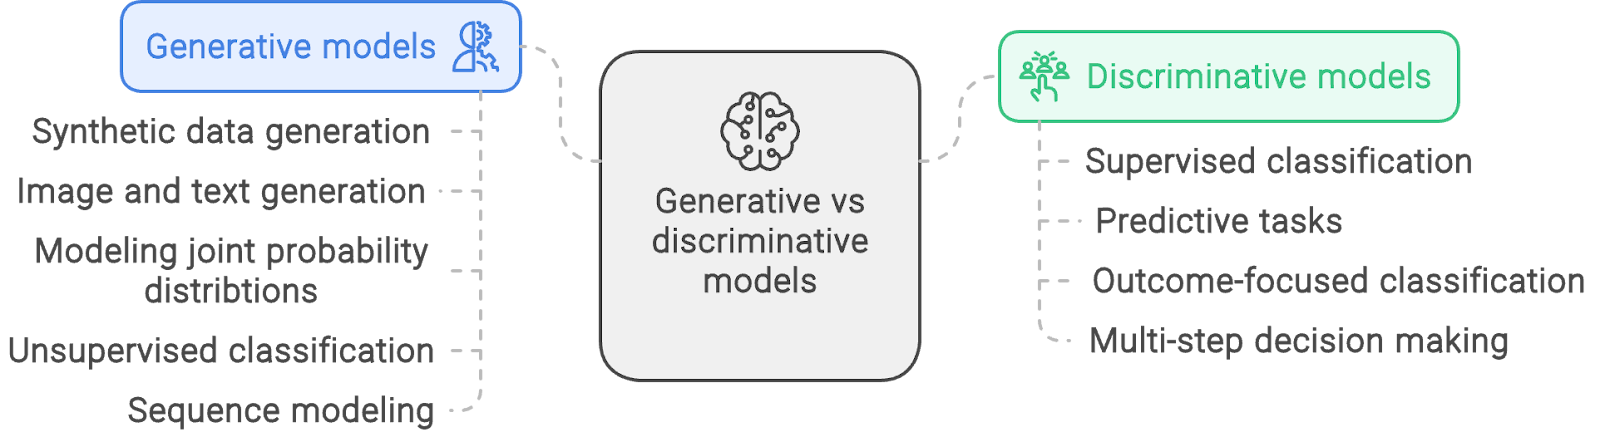
जनरेटिव बनाम डिस्क्रिमिनेटिव मॉडलों के उदाहरण अनुप्रयोग। napkin.ai के साथ बनाया गया
इस लेख ने जनरेटिव और डिस्क्रिमिनेटिव मॉडलों—मशीन लर्निंग तकनीकों के दो प्रमुख दृष्टिकोणों—के मौलिक सिद्धांतों और मुख्य अंतरों को समझाया।
यद्यपि अधिकांश मशीन लर्निंग प्रायिक विधियों पर आधारित है, जनरेटिव मॉडल संयुक्त प्रायिकता वितरण पर आधारित होते हैं, जबकि डिस्क्रिमिनेटिव मॉडल केवल सशर्त प्रायिकताओं का उपयोग करते हैं। इस प्रकार, दोनों मॉडल श्रेणियों के अलग-अलग अनुप्रयोग और प्रदर्शन विशेषताएँ होती हैं। मॉडलों की व्यापक विविधता की उपलब्धता को देखते हुए, कार्य के लिए सही उपकरण चुनना आवश्यक हो जाता है।
मॉडल प्रकारों और उनके अंतरों की वैचारिक समझ से आगे बढ़कर, स्वयं मॉडल बनाना अधिक महत्वपूर्ण है। सुपरवाइज्ड प्रशिक्षण विधियों पर ब्लॉग पोस्ट और एक सरल लॉजिस्टिक रिग्रेशन मॉडल बनाने से शुरुआत करें।
इन पाठ्यक्रमों के साथ मशीन लर्निंग के बारे में और जानें!
कोर्स
कोर्स
कोर्स