Khóa học
Tìm hiểu Machine Learning
2 giờ
313.7K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleCác mô hình học máy (ML) là những triển khai trên máy tính của các phương pháp thống kê và xác suất. Chúng thường theo một trong hai hướng tiếp cận: mô hình hóa sinh (generative) hoặc mô hình hóa phân biệt (discriminative).
Trong bài viết này, chúng tôi cung cấp tổng quan về mô hình sinh và mô hình phân biệt, giới thiệu các mô hình phổ biến của mỗi loại, giải thích các nguyên lý toán học đằng sau cả hai cách tiếp cận và thảo luận các ví dụ thực tiễn về các dạng bài toán mà mỗi loại mô hình có thể được sử dụng.
Với một tập các điểm dữ liệu ví dụ, D, và các nhãn đi kèm, L, một mô hình sinh học phân phối xác suất chung P(D, L). Sau đó, nó sử dụng phân phối cơ bản này để sinh dữ liệu mới tương tự các ví dụ huấn luyện hoặc giải quyết các bài toán phân loại.
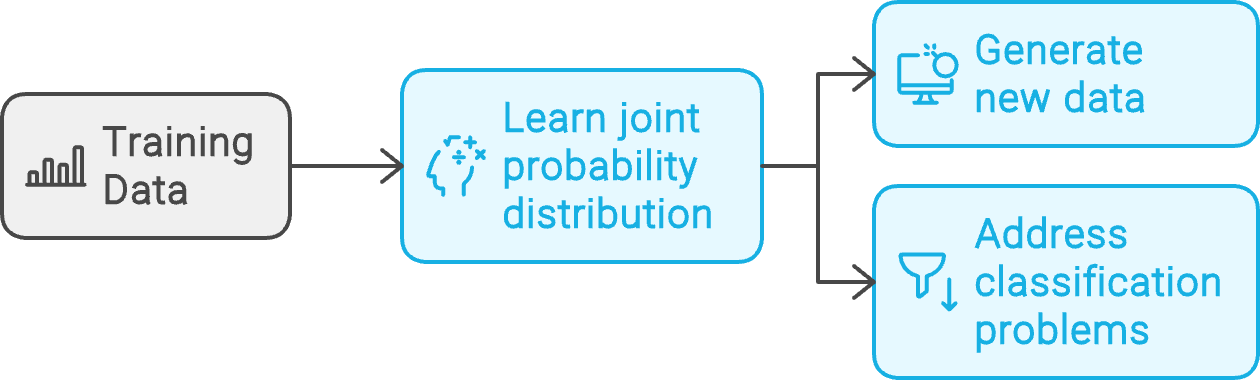
Quy trình làm việc của mô hình sinh. Tạo bằng napkin.ai
Các phần sau giải thích những điều cơ bản của mô hình sinh kèm ví dụ.
Mô hình Naive Bayes dựa trên định lý Bayes. Định lý này cho biết xác suất có điều kiện P(A | B) của một biến cố A khi biết rằng biến cố B là đúng. Đây được gọi là xác suất hậu nghiệm của A cho trước B.
Riêng lẻ, xác suất P(A) của biến cố A được gọi là xác suất tiên nghiệm. Mô hình Naive Bayes giả định rằng A và B là các biến cố độc lập - do đó tiền tố “naive”. Nếu A và B phụ thuộc nhau, định lý Bayes truyền thống không còn áp dụng, và mô hình Naive Bayes không phải lựa chọn phù hợp.
Các mô hình Bayes là mô hình sinh vì chúng mô hình hóa phân phối xác suất chung. Quá trình huấn luyện học phân phối chung—P(A, B). Sau khi huấn luyện, có thể dùng để dự đoán các giá trị của A với xác suất cao nhất P(A). Hơn nữa, các mô hình Bayes cũng có thể dùng cho phân loại vì chúng có thể tính các xác suất có điều kiện (sử dụng quy tắc Bayes).
Để học cách dùng mô hình naive Bayes trong thực hành, hãy theo dõi hướng dẫn về xây dựng mô hình Naive Bayes bằng scikit-learn và Python.
Mô hình hỗn hợp Gaussian (GMM) là một lớp của mô hình hỗn hợp. Tiền đề độc đáo của chúng là dữ liệu cơ bản kết hợp nhiều phân phối thống kê thay vì một phân phối duy nhất.
Trong GMM, giả định quần thể là sự kết hợp của các quần thể con khác nhau, mỗi quần thể con là một phân phối Gaussian. Thực chất, phân phối dữ liệu được phân tích như một trung bình có trọng số của một vài phân phối Gaussian riêng lẻ.
GMM nắm bắt phân phối xác suất của bộ dữ liệu cơ bản. Do đó, chúng được sử dụng cho các tác vụ như phân tích ngoại lệ và phân loại không giám sát. Những tác vụ này liên quan đến việc xây dựng mô hình thống kê của quần thể bằng cách coi tập dữ liệu huấn luyện như một mẫu ngẫu nhiên.
Khóa học về mô hình hỗn hợp trong R đi sâu vào chi tiết thực hành của GMM.
Mạng đối sinh (GAN) là một mô hình dựa trên mạng nơ-ron. Nó gồm hai phần: bộ sinh (generator) và bộ phân biệt (discriminator). Mạng sinh được huấn luyện để tạo ra các vector giống với các ví dụ huấn luyện, trong khi bộ phân biệt được huấn luyện để phân biệt giữa các ví dụ gốc và các ví dụ do bộ sinh tạo ra.
Về bản chất, bộ sinh và bộ phân biệt có mục tiêu huấn luyện đối nghịch, khiến chúng mang tính “đối kháng”. Vì vậy, từ “adversarial” xuất hiện trong tên gọi.
Bộ sinh và bộ phân biệt được huấn luyện cùng nhau trong cùng một vòng lặp huấn luyện. Khi bộ sinh ngày càng giỏi tạo ra các ví dụ chân thực, bộ phân biệt vẫn phân biệt được ví dụ gốc với ví dụ sinh. Việc huấn luyện tiếp tục cho đến khi bộ sinh học cách tạo ra các ví dụ đủ giống dữ liệu huấn luyện để bộ phân biệt không thể phân biệt được.
Sau khi huấn luyện, bộ sinh được dùng để tạo dữ liệu tổng hợp chân thực tương tự các ví dụ gốc.
Mô hình Markov ẩn (HMM) làm việc với các bộ dữ liệu tuần tự. Các quá trình Markov (hoặc chuỗi Markov) được dùng để mô hình hóa dữ liệu tuần tự. Tiền đề của một mô hình Markov là phần tử kế tiếp, xn+1, trong chuỗi chỉ phụ thuộc vào phần tử liền trước, xn, chứ không phụ thuộc vào bất kỳ phần tử nào trước đó, {x1, x2, ... xn-1}. Mô hình Markov giả định rằng các bộ dữ liệu tuần tự có thể được biểu diễn bằng các quá trình Markov với những trạng thái ẩn.
Các trạng thái này sinh ra phần tử kế tiếp trong chuỗi:
Mô hình Markov được biểu diễn với xác suất chuyển trạng thái (chuyển từ trạng thái này sang trạng thái khác) và xác suất phát xạ (sinh ra một phần tử chuỗi cụ thể cho trước một trạng thái cụ thể).
HMM mô hình hóa các tập dữ liệu huấn luyện như các quá trình Markov. Mục tiêu huấn luyện là xác định các xác suất chuyển trạng thái và phát xạ để tối đa hóa xác suất sinh ra các chuỗi trong tập ví dụ. Do đó, với một chuỗi cho trước, mô hình Markov đã huấn luyện có thể sinh ra các phần tử kế tiếp của chuỗi.
Để tìm hiểu cách triển khai thực tế, hãy theo dõi hướng dẫn về chuỗi Markov trong Python.
Với một tập dữ liệu huấn luyện gồm các điểm dữ liệu, D, và các nhãn đi kèm, L, một mô hình phân biệt học phân phối xác suất có điều kiện P(D | L). Sau đó, nó dùng phân phối xác suất có điều kiện này để dự đoán lớp của các điểm dữ liệu mới.
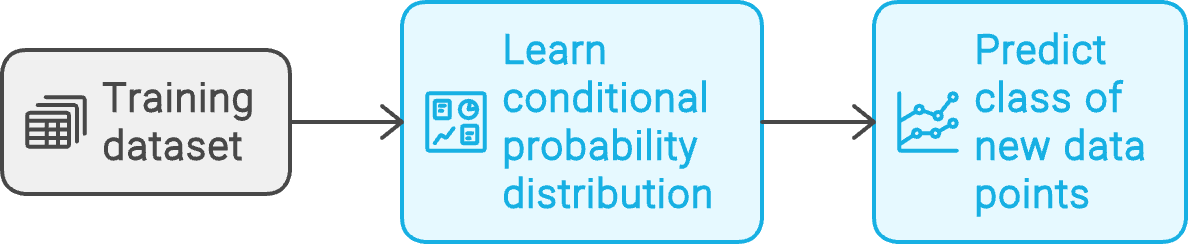
Quy trình làm việc của mô hình phân biệt. Tạo bằng napkin.ai
Mô hình phân biệt thường được dùng để giải các bài toán phân loại. Các ví dụ sau minh họa trường hợp sử dụng của chúng.
K láng giềng gần nhất (KNN) là một trong những mô hình học máy lâu đời. Nó dựa trên tiền đề rằng, với một phân bố các điểm dữ liệu, các mục tương tự nằm gần nhau.
Các mô hình KNN là phi tham số, không có các tham số như hệ số hồi quy. Chúng được dùng cho cả bài toán phân loại và hồi quy.
Hạng mục của một điểm dữ liệu đầu vào trùng với hạng mục của k láng giềng gần nhất của nó. Giá trị dự đoán của một điểm dữ liệu là giá trị trung bình của k láng giềng gần nhất. k (số láng giềng cần xét) có thể được xem là siêu tham số của mô hình. Nó dùng để điều chỉnh hành vi mô hình, nhưng không trực tiếp ảnh hưởng đến đầu ra của mô hình.
Hồi quy logistic, giống hồi quy tuyến tính, cố gắng dự đoán giá trị của biến phụ thuộc dựa trên một hoặc nhiều biến độc lập. Trong hồi quy tuyến tính, biến phụ thuộc nhận giá trị liên tục. Trong hồi quy logistic, biến phụ thuộc nhận giá trị rời rạc, chẳng hạn:
Hồi quy tuyến tính dự đoán giá trị số. Trong hồi quy logistic, đại lượng dự đoán là logarit của tỉ số odds.
Với một biến cố A, có xác suất P(A), tỉ số odds là P(A) / (1 - P(A)). Sử dụng logarit (của tỉ số odds) giúp hội tụ mượt mà hơn và nhanh hơn trong quá trình huấn luyện. Nhờ khả năng phân tách đầu vào thành các lớp, các mô hình logistic được dùng cho mục đích phân biệt.
Để có phần giới thiệu thực hành hơn về chủ đề này, hãy tham khảo hướng dẫn về hồi quy logistic trong Python.
Bạn cũng có thể triển khai hồi quy logistic bằng R, một ngôn ngữ lập trình định hướng thống kê, như giải thích trong hướng dẫn về hồi quy logistic dùng R.
Máy vector hỗ trợ xác định đường tối ưu phân tách các điểm dữ liệu của những lớp khác nhau. Trên mặt phẳng 2 chiều X-Y, với một tập hợp các điểm dữ liệu thuộc hai hạng mục khác nhau, SVM dự đoán một đường (lý tưởng) phân tách gọn gàng các điểm của một hạng mục khỏi hạng mục kia.
Đường này là ranh giới quyết định. Nó trở thành siêu phẳng với dữ liệu có ba chiều trở lên. Các điểm dữ liệu (từ mỗi hạng mục) nằm gần đường tưởng tượng này nhất được gọi là vector hỗ trợ của mô hình. Đây là những điểm khó phân loại nhất vì giá trị của chúng gần nhau.
Khoảng cách giữa đường phân tách và các vector hỗ trợ được gọi là biên (margin). Huấn luyện SVM nhằm tìm ranh giới quyết định tối đa hóa biên này. Trên thực tế, các điểm dữ liệu có nhiều hơn hai chiều, và đường phân tách là một siêu phẳng ở không gian chiều cao hơn.
SVM cũng được dùng cho các bài toán phân loại đa lớp.
Để tìm hiểu thêm về SVM, hãy theo hướng dẫn xây dựng SVM bằng gói scikit-learn của Python. Bên cạnh Python, bạn cũng có thể dùng R để triển khai SVM, như bàn trong hướng dẫn về SVM trong R.
Một cây quyết định gồm nhiều nút quyết định được tổ chức theo cấu trúc dạng cây.
Nút cao nhất là gốc. Các nút dẫn đến đầu ra cuối cùng được gọi là nút lá hoặc nút cuối. Các nút trung gian không phải lá được gọi là nút nội bộ. Đầu ra từ nút gốc đi vào các nút trung gian. Kết quả (đầu ra) của mỗi nút hoặc là đầu ra cuối cùng, hoặc dẫn (nhánh) tới một nút khác.
Mỗi nút của cây tách tập dữ liệu theo một thuộc tính cụ thể. Ví dụ, một cây quyết định phê duyệt hồ sơ vay có thể có các nút để phân loại hồ sơ theo thu nhập ròng.
Quá trình huấn luyện xác định ngưỡng phù hợp cho mỗi quyết định. Ví dụ, các hồ sơ có thu nhập ròng dưới một mức nhất định sẽ bị từ chối ngay. Phần còn lại được xử lý tiếp ở các nút kế tiếp, nơi xem xét các thuộc tính khác, như tài sản ròng.
Để có hướng dẫn thực hành về cây quyết định, hãy theo dõi hướng dẫn về xây dựng cây quyết định bằng Python, hoặc khóa học đầy đủ về học máy với các mô hình dựa trên cây trong Python.
Nhược điểm chính của cây quyết định là quá khớp (overfitting), dẫn đến vấn đề với dữ liệu ngoài mẫu. Rừng quyết định cố gắng giải quyết vấn đề này. Một rừng quyết định gồm nhiều cây. Không giống cây quyết định độc lập, vốn phải xem xét toàn bộ tập đặc trưng, mỗi cây trong rừng chỉ tìm một tập con ngẫu nhiên của đặc trưng. Tính ngẫu nhiên này giúp xử lý phương sai trong các tập dữ liệu nhiễu.
Đầu ra của rừng thu được bằng cách kết hợp, ví dụ như lấy trung bình, đầu ra của các cây riêng lẻ.
Để học cách triển khai rừng ngẫu nhiên, tham khảo hướng dẫn về dùng scikit-learn để xây dựng bộ phân loại rừng ngẫu nhiên.
Một mạng nơ-ron gồm các nhóm nơ-ron. Mỗi nơ-ron triển khai một hàm tuyến tính nhân trọng số của nơ-ron với vector đầu vào.
Một hàm kích hoạt phi tuyến theo sau hàm tuyến tính. Hàm kích hoạt quyết định đầu ra của mỗi nơ-ron dựa trên đầu ra của hàm tuyến tính. Do đó, một mạng nơ-ron đơn giản về mặt khái niệm có thể được xem như một chuỗi các phương trình tuyến tính được lọc qua các kích hoạt phi tuyến.
Lớp đầu vào của mạng nơ-ron nhân đầu vào (biểu diễn dưới dạng vector) với một tập trọng số và các hàm kích hoạt. Đầu ra này được truyền đến lớp tiếp theo, lớp này thực hiện thao tác tương tự.
Các lớp ẩn nằm giữa lớp đầu vào và lớp đầu ra. Lớp ẩn cuối cùng đưa vào lớp đầu ra. Các bài toán phức tạp liên quan đến việc sử dụng mạng nơ-ron với nhiều lớp ẩn, được gọi là mạng nơ-ron sâu (DNN).
Trong một bài toán phân loại, cách tiếp cận phổ biến là có số nơ-ron đầu ra bằng số lớp. Lớp dự đoán tương ứng với nơ-ron có giá trị cao nhất. Trong một bài toán hồi quy, một nơ-ron đầu ra duy nhất chứa kết quả dự đoán. Các quan hệ tuyến tính của nơ-ron mô hình hóa phương trình hồi quy tuyến tính.
Để hiểu sâu hơn về chủ đề này, hãy xem bài viết blog về mạng nơ-ron.
Một số tác vụ, như phân loại, có thể được giải bằng cả hai loại mô hình. Tuy nhiên, nhìn chung, mô hình phân biệt và mô hình sinh thường có các trường hợp sử dụng riêng, do hai loại này áp dụng các cách tiếp cận toán học khác nhau. Cần hiểu các khác biệt này và cách chúng ảnh hưởng đến sự phù hợp của mỗi nhóm mô hình với từng vấn đề.
Mô hình sinh dự đoán giá trị kế tiếp trong một chuỗi hoặc sinh ảnh từ văn bản (hoặc ngược lại). Để làm các tác vụ như vậy, mô hình phải học sẽ sinh đầu ra nào khi nhận các đầu vào khác nhau. Mô hình sử dụng phân phối xác suất chung của đầu vào và đầu ra.
Để hiểu toán học nền tảng, hãy bắt đầu với ví dụ đơn giản. Hành vi của một biến ngẫu nhiên đơn được mô tả bởi hàm mật độ xác suất (PDF).
PDF của biến ngẫu nhiên X có thể được dùng để xác định xác suất của X tại các giá trị khác nhau. Ví dụ, nếu PDF của X là f(x), xác suất để X nằm giữa A và B được cho bởi:

Xác suất của X trên toàn bộ miền là 1. Điều này được diễn đạt như sau:

Biểu thức trên cũng có thể được viết là:
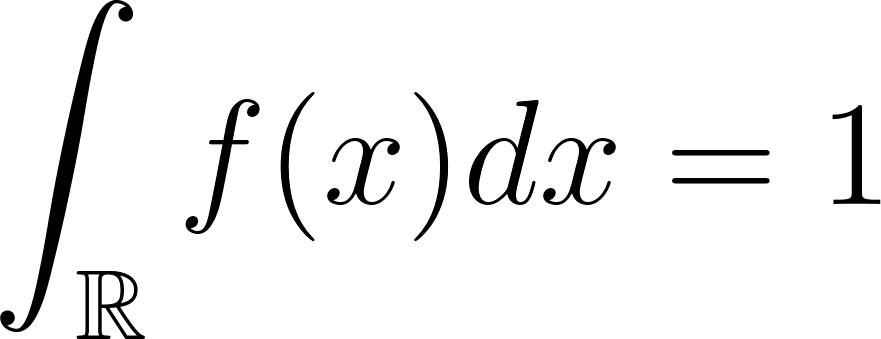
Với PDF chung của hai biến, X và Y, tích phân trên toàn bộ miền bằng 1:

Phân phối xác suất chung ánh xạ toàn bộ không gian xác suất của cả X và Y. Để đánh giá xác suất rằng xác suất chung P(X, Y) rơi vào một vùng G, tích phân PDF chung trên G:

Ngược lại, mô hình phân biệt chỉ tập trung vào phân phối xác suất có điều kiện. Mô hình sinh, nếu cần, ước lượng xác suất có điều kiện bằng cách dùng các xác suất biên.
Với một phân phối xác suất chung fXY(x,y), xác suất biên của biến ngẫu nhiên Y tại giá trị y (với mọi giá trị của X) được cho bởi:
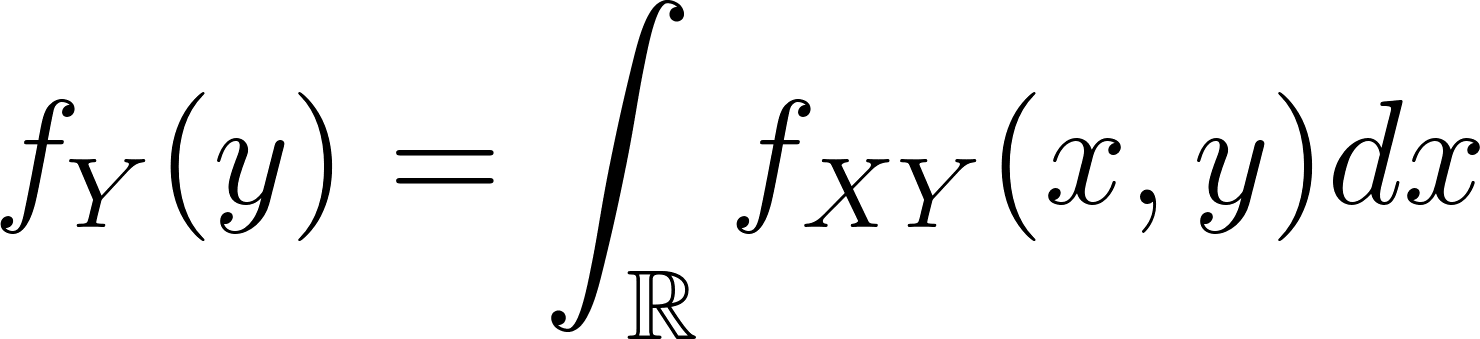
Tương tự quy tắc Bayes, PDF có điều kiện của X được biểu diễn như sau:
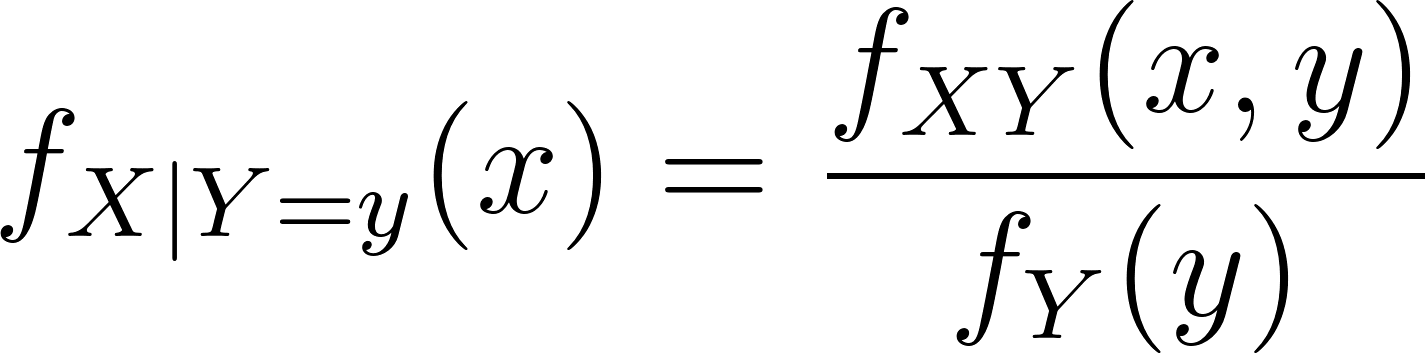
Biểu thức trên cho thấy dạng tích phân của xác suất có điều kiện, dạng thường được viết là:
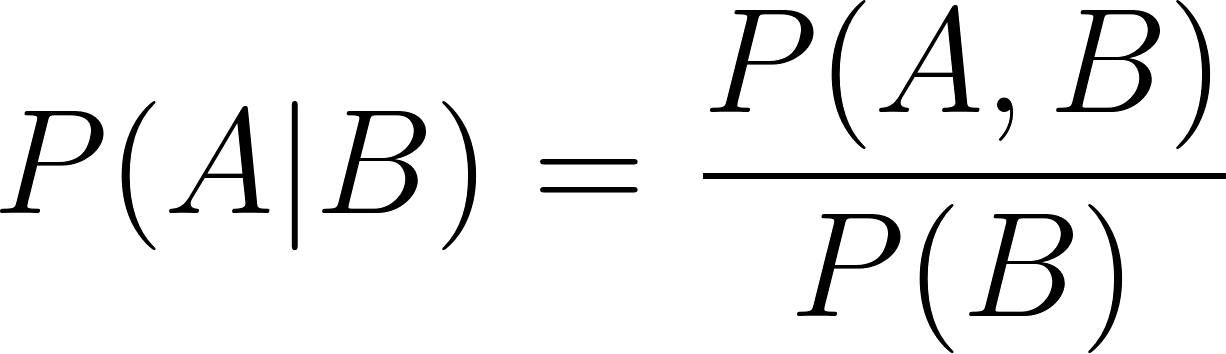
Tương tự,
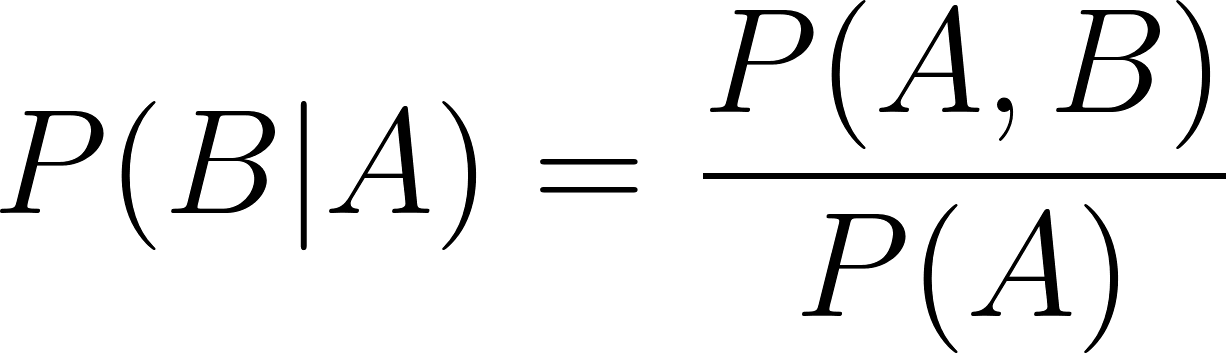
Trong hai công thức xác suất có điều kiện trên:
Để tính một xác suất có điều kiện, mô hình sinh theo hai bước:
Ngược lại, mô hình phân biệt theo một bước duy nhất (và đơn giản hơn):
Một mô hình sinh có các xác suất biên P(A) và P(B) và PDF chung P(A, B). Dựa vào đó, nó có thể đánh giá P(A | B) hoặc P(B | A) một cách dễ dàng như nhau. Đây là ý tưởng nền tảng của các bộ phân loại naive Bayes. Vì thế, mô hình sinh có thể thực hiện các tác vụ như:
Điều này khiến mô hình sinh linh hoạt và đa dụng. Ở chiều ngược lại, chúng vốn dĩ liên quan đến nhiều phức tạp hơn trong huấn luyện vì:
Trong khi đó, mô hình phân biệt chỉ quan tâm đến các xác suất có điều kiện. Dựa trên tập dữ liệu huấn luyện, có thể ước lượng trực tiếp xác suất có điều kiện mà không cần ước lượng các xác suất chung hay biên.
Do đó, mô hình phân biệt đơn giản hơn để huấn luyện. Tuy nhiên, một mô hình phân biệt đã học xác suất có điều kiện P(A | B) chỉ có thể thực hiện các tác vụ liên quan đến chính xác suất có điều kiện này. Nó không thể làm gì khác.
Mô hình sinh linh hoạt cho cả tác vụ sinh và phân biệt. Trong huấn luyện, mô hình học PDF chung và các xác suất biên. Trong suy luận, mô hình phải tính xác suất có điều kiện bằng phân phối chung và xác suất biên thích hợp. Do đó, suy luận trên các tác vụ phân biệt sẽ chậm hơn.
Ngược lại, mô hình phân biệt đã học trực tiếp (theo số) các xác suất có điều kiện. Trong suy luận, chúng ước lượng xác suất có điều kiện trong một bước dựa trên dữ liệu đầu vào.
Hơn nữa, vì mô hình phân biệt chỉ tập trung ước lượng một đại lượng (xác suất có điều kiện), chúng thường được quan sát là chính xác hơn. Một PDF chung chứa nhiều bất định hơn so với một xác suất có điều kiện đơn giản. Sự bất định gia tăng này phản ánh ở độ chính xác thấp hơn tương đối của các mô hình sinh trong các bài toán phân loại.
Dựa trên thảo luận ở các phần trước, bảng dưới đây tóm tắt sự khác biệt giữa mô hình sinh và mô hình phân biệt.
|
Mô hình sinh |
Mô hình phân biệt |
|
|
Mục tiêu |
Nắm bắt xác suất chung và xác suất biên. Dùng quy tắc Bayes để tính xác suất có điều kiện. |
Chỉ nắm bắt xác suất có điều kiện. Không có thông tin về xác suất chung hoặc biên. |
|
Sinh dữ liệu |
Có thể sinh điểm dữ liệu mới dựa trên tập huấn luyện. Ví dụ, một mô hình được huấn luyện trên chữ số viết tay có thể sinh các chữ số giả mới. |
Không thể sinh điểm dữ liệu mới. Chủ yếu tập trung phân biệt giữa các hạng mục dữ liệu khác nhau. |
|
Trường hợp sử dụng chính |
Có thể dùng cho cả tác vụ sinh (ví dụ, tổng hợp dữ liệu) và tác vụ phân biệt (ví dụ, phân loại). |
Chỉ có thể dùng cho các tác vụ phân biệt như phân loại hoặc hồi quy. |
|
Hiệu năng suy luận |
Chạy suy luận chậm hơn do cần tính toán phức tạp. Ngay cả tác vụ đơn giản cũng cần tính các xác suất biên và chung và áp dụng quy tắc Bayes. |
Suy luận nhanh hơn vì trực tiếp tính xác suất có điều kiện mà không cần dùng quy tắc Bayes. |
|
Xử lý dữ liệu thiếu |
Tốt hơn trong xử lý dữ liệu thiếu bằng cách mô hình hóa phân phối xác suất cơ bản, giúp “lấp chỗ trống” dễ dàng hơn. Nguy cơ quá khớp thấp hơn. |
Kém hiệu quả hơn trong xử lý dữ liệu thiếu. Nguy cơ quá khớp cao hơn vì mô hình tập trung tìm siêu phẳng phân tách giữa các lớp. |
|
Hội tụ |
Có xu hướng hội tụ nhanh hơn và với ít ví dụ huấn luyện hơn nhưng thường dẫn đến lỗi mô hình cao hơn, đặc biệt trong các tác vụ phân loại, do việc tính gián tiếp xác suất có điều kiện thông qua mô hình hóa phân phối xác suất chung. |
Thường cần nhiều dữ liệu hơn để huấn luyện và có thể hội tụ chậm hơn. Tuy nhiên, kết quả là lỗi mô hình thấp hơn, đặc biệt trong các tác vụ phân loại, vì chúng trực tiếp mô hình hóa xác suất có điều kiện mà không cần ước lượng phân phối xác suất chung. |
|
Độ phức tạp mô hình |
Thường phức tạp hơn vì mô hình hóa toàn bộ phân phối dữ liệu, bao gồm tương tác giữa đặc trưng và nhãn. |
Thường đơn giản hơn vì chỉ cần mô hình hóa ranh giới quyết định hoặc siêu phẳng phân tách giữa các lớp. |
|
Ví dụ mô hình |
Naive Bayes, Mô hình Markov ẩn (HMM), Mạng đối sinh (GAN), Bộ tự mã biến phân (VAE). |
Hồi quy Logistic, Máy Vector Hỗ trợ (SVM), Mạng Nơ-ron và Cây Quyết định. |
|
Tính linh hoạt mô hình |
Linh hoạt hơn về ứng dụng (có thể xử lý cả tác vụ sinh và phân biệt). |
Kém linh hoạt hơn (giới hạn ở các tác vụ phân biệt). |
|
Tỷ lệ lỗi |
Tỷ lệ lỗi cao hơn trong các tác vụ phân loại do phương pháp ước lượng gián tiếp. |
Tỷ lệ lỗi thấp hơn trong các tác vụ phân loại do được huấn luyện trực tiếp trên xác suất có điều kiện. |
Đúng như tên gọi, mô hình sinh đặc biệt phù hợp với các tác vụ tạo dữ liệu mới khớp với các khuôn mẫu trong dữ liệu huấn luyện.
Một số trường hợp sử dụng phổ biến của các mô hình này là:
Với nhiều mô hình thị giác máy tính, việc có một tập lớn ảnh huấn luyện là thiết yếu. Các mô hình này cần được huấn luyện trên nhiều biến thể của cùng một hình ảnh hoặc đặc trưng.
Chụp ảnh cùng một vật thể từ nhiều góc, phông nền hoặc sắc độ màu khác nhau không phải lúc nào cũng khả thi. Nhiều tập dữ liệu ảnh theo tác vụ cụ thể cũng thường hạn chế về kích thước vì việc tạo ra chúng đòi hỏi kỹ năng chuyên môn theo lĩnh vực. Ví dụ, bạn cần tiếp cận các bác sĩ phổi, phòng X-quang, và bệnh nhân cùng bệnh viện đồng ý để tạo tập ảnh X-quang của một bệnh phổi cụ thể.
Trong những trường hợp như vậy, lựa chọn thực tế nhất là tạo một tập dữ liệu nhỏ nhưng được giám tuyển kỹ và phù hợp, sau đó sinh tổng hợp các điểm dữ liệu mới tương tự tập gốc.
Sinh ảnh mới từ mô tả văn bản hoặc sinh văn bản mới từ một đoạn đầu vào. Chỉ có lớp mô hình sinh mới có thể xử lý các tác vụ như vậy.
Các mô hình sinh ảnh như DALL-E, MidJourney, và Stable Diffusion thường xuyên được dùng để tạo ảnh phù hợp mô tả cụ thể và không vi phạm bản quyền hiện có.
Tương tự, LLM thường được dùng để tạo cốt truyện hư cấu, khẩu hiệu và tagline marketing, tóm tắt tài liệu, và các nội dung tương tự khác.
Mô hình sinh được dùng cho các tác vụ dựa trên phân phối xác suất chung của dữ liệu cơ bản. Mô hình hóa phân phối chung của lợi suất tài sản để dự đoán hồ sơ rủi ro và lợi nhuận kỳ vọng của danh mục đầu tư là thông lệ trong tài chính và quản trị rủi ro.
Ví dụ, một nhà quản lý đầu tư có thể muốn biết xác suất giá của hai cổ phiếu khác nhau cùng tăng hoặc cùng giảm—các PDF chung có thể trả lời những câu hỏi như vậy.
Ngành dịch vụ tài chính đã sử dụng các phương pháp thống kê này từ lâu trước khi thuật ngữ “mô hình sinh” được sử dụng rộng rãi.
Các bài toán như phân loại không giám sát đặc biệt phù hợp với mô hình hỗn hợp Gaussian. Trong những bài toán này, bạn có một tập lớn các điểm dữ liệu nhưng không biết có bao nhiêu hay các hạng mục gì mà các điểm dữ liệu thuộc về. Kỳ vọng hợp lý là dữ liệu đến từ sự kết hợp của các phân phối, điều mà GMM có thể mô hình hóa.
Nếu số lượng và danh sách các hạng mục đã biết trước, các phương pháp phân biệt sẽ phù hợp hơn.
GMM cũng hữu ích trong phân tích ngoại lệ (phát hiện bất thường, gian lận, v.v.), nơi dữ liệu “thông thường”, như hành vi của các nhóm khách hàng khác nhau, có thể được mô hình hóa như sự kết hợp của các phân phối khác nhau. Những điểm dữ liệu bất thường là những điểm khác biệt đáng kể so với bất kỳ mẫu nào khác.
Các bài toán liên quan đến chuỗi thường được giải bằng mô hình Markov ẩn. Một trường hợp sử dụng thường gặp là mô hình hóa trình tự hệ gen và tái sắp xếp trình tự.
HMM cũng được dùng trong nhận dạng giọng nói, nơi chúng giúp dự đoán âm tiết tiếp theo dựa trên chuỗi âm tiết trước đó. Mô hình hóa chuỗi cũng phổ biến trong các ứng dụng logistics như lịch giao nhận hàng. Tương tự, sự lây truyền và lan rộng của bệnh truyền nhiễm thường được mô hình hóa bằng chuỗi Markov.
Về mặt toán học, mô hình phân biệt dùng cho các ứng dụng mà chỉ xác suất có điều kiện là liên quan, còn xác suất chung thì không. Vì vậy, mô hình phân biệt thường được dùng cho các bài toán phân loại và dự đoán.
Một số ví dụ:
Các bài toán phân loại có giám sát, nơi các lớp (hạng mục) được biết trước. Đây là trường hợp sử dụng điển hình của KNN và SVM.
Bạn có một tập lớn các điểm dữ liệu, như dữ liệu hành vi khách hàng, gồm mẫu chi tiêu, số tiền mua hàng, tần suất mua, lịch sử trả hàng, v.v. Bạn cần dùng thông tin này để phân loại danh sách khách hàng vào các hạng mục khác nhau, như chi tiêu cao, săn hàng giảm giá, khách hàng thường xuyên, khách hàng không nghiêm túc, v.v. Trái ngược với bài toán phân loại không giám sát, như đã thảo luận trước đó, GMM thường được dùng.
Trong các tác vụ dự đoán như phân loại và hồi quy, ưu tiên thường là tốc độ và độ chính xác. Về nguyên tắc, mô hình sinh cũng có thể giải các bài toán như vậy.
Đặc biệt, mô hình sinh được ưu tiên khi có các vấn đề như thiếu dữ liệu, khi chỉ có tập dữ liệu hạn chế để huấn luyện, hoặc khi bạn kỳ vọng thường xuyên bổ sung các hạng mục mới.
Tuy nhiên, với hầu hết các trường hợp tiêu chuẩn, mô hình sinh chịu tỷ lệ lỗi cao hơn và suy luận chậm hơn trong các tác vụ dự đoán vì tính toán của chúng liên quan đến phân phối xác suất chung. Do đó, với các bài toán phân loại và hồi quy tiêu chuẩn, nơi có sẵn một tập dữ liệu lớn và lành mạnh để huấn luyện, mô hình phân biệt là lựa chọn ưu tiên vì đặc tính hiệu năng tốt hơn.
Mô hình phân biệt được ưa chuộng cho các tác vụ chỉ tập trung vào kết quả phân loại chứ không phải mô hình hóa dữ liệu cơ bản.
Ví dụ, nếu bạn muốn phân loại bản ghi âm theo ngôn ngữ tương ứng, bạn không cần một mô hình hiểu ngôn ngữ và ngữ pháp. Một mô hình nhận dạng giọng nói sẽ quá mức cần thiết cho một bài toán phân loại. Chỉ cần tập trung vào ranh giới quyết định bằng một mô hình phân biệt là đủ. Vậy nên, bạn có thể dùng một mạng nơ-ron đơn giản thay vì một LLM hoặc hồi quy logistic thay vì một mô hình Bayes.
Các quyết định nhiều bước, nơi từng bước liên quan đến các lựa chọn rõ ràng, là ứng viên tốt cho cây quyết định. Cây quyết định thường được dùng như bộ lọc sơ bộ để rút gọn danh sách các điểm dữ liệu cần phân tích sâu hơn.
Ví dụ, hãy xét phát hiện gian lận, thường được giải bằng các mô hình phức tạp như GMM. Con người hầu như luôn điều tra các giao dịch rủi ro cao, bất kể mô hình sử dụng. Vì vậy, một cách tiếp cận thay thế là dùng một cây quyết định để gắn cờ danh sách các giao dịch có khả năng gian lận để điều tra thủ công thêm.
Cây quyết định cũng được dùng trong nhiều hoạt động kinh doanh. Mục tiêu là quyết định hành động đúng dựa trên các điều kiện được xác định trước. Những tác vụ như vậy không cần các mô hình sinh cũng như các mô hình phân biệt phức tạp hơn như mạng nơ-ron.
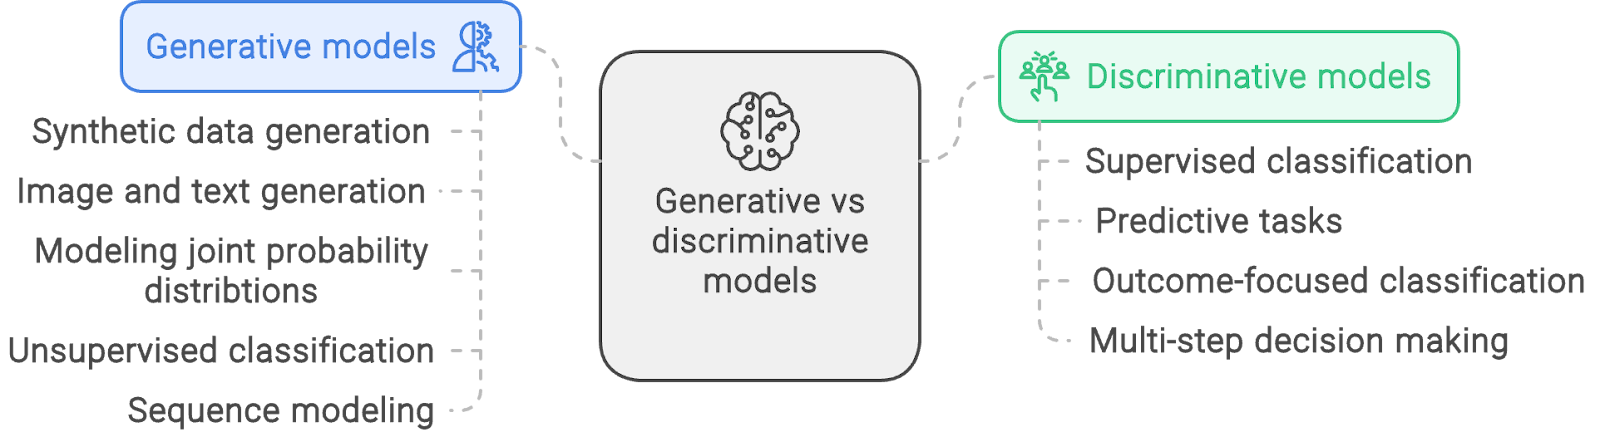
Ví dụ ứng dụng của mô hình sinh vs. mô hình phân biệt. Tạo bằng napkin.ai
Bài viết này đã giải thích các nguyên lý cơ bản và khác biệt chính giữa mô hình sinh và mô hình phân biệt, hai cách tiếp cận chủ đạo của các kỹ thuật học máy.
Dù phần lớn học máy dựa trên các phương pháp xác suất, mô hình sinh dựa trên phân phối xác suất chung, trong khi mô hình phân biệt chỉ dùng các xác suất có điều kiện. Do đó, hai lớp mô hình có ứng dụng và đặc tính hiệu năng khác nhau. Xét đến sự phong phú của các mô hình, việc chọn đúng công cụ cho công việc trở nên thiết yếu.
Vượt ra ngoài hiểu biết khái niệm về các loại mô hình và sự khác biệt của chúng, điều quan trọng hơn là tự xây dựng mô hình. Bắt đầu với bài viết blog bàn về các phương pháp huấn luyện có giám sát và xây dựng một mô hình hồi quy logistic đơn giản.
Tìm hiểu thêm về học máy với các khóa học này!
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
