Kurs
Machine Learning'i Anlamak
2 sa
313.8K
Alıştırma and program your progress.
Google Ile Devam EdinMakine öğrenimi (ML) modelleri, istatistiksel ve olasılıksal yöntemlerin bilgisayar tabanlı uygulamalarıdır. Genellikle iki yaklaşımdan birini benimserler: üretici veya ayrıştırıcı modelleme.
Bu yazıda, üretici ve ayrıştırıcı modellere genel bir bakış sunuyor, her türün yaygın modellerini tanıtıyor, her iki yaklaşımın arkasındaki matematiksel ilkeleri açıklıyor ve her model türünün kullanılabileceği problem türlerine ilişkin pratik örnekleri tartışıyoruz.
Bir örnek veri noktaları kümesi, D, ve bunlara karşılık gelen etiketler, L, verildiğinde bir üretici model ortak olasılık dağılımı P(D, L)’yi öğrenir. Ardından bu temel dağılımı, eğitim örneklerine benzer yeni veriler üretmek veya sınıflandırma problemlerini ele almak için kullanır.
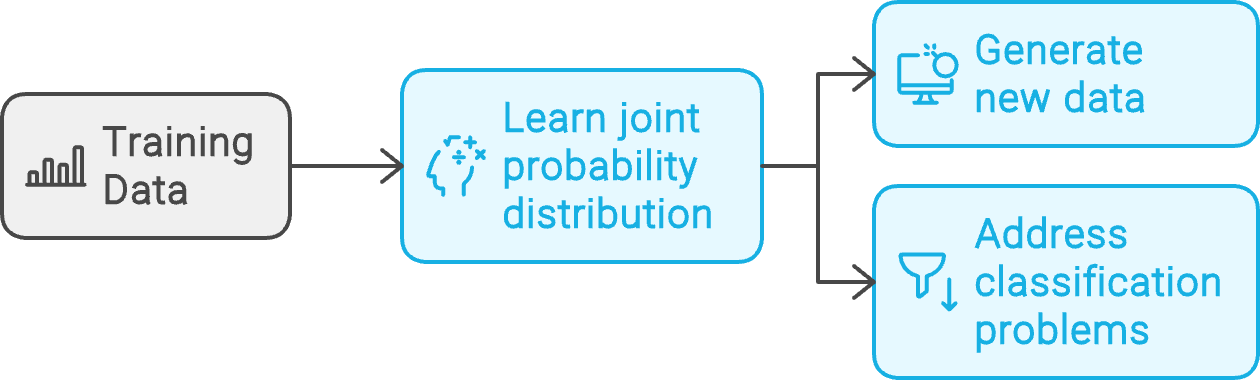
Üretici model iş akışı. napkin.ai ile oluşturuldu
Aşağıdaki bölümler, örneklerle birlikte üretici modellerin temel ilkelerini açıklar.
Naive Bayes modelleri Bayes teoremine dayanır. Bu teorem, olay A’nın koşullu olasılığını, P(A | B), olay B’nin doğru olduğu bilindiğinde verir. Bu, B verildiğinde A’nın ardıl olasılığı olarak adlandırılır.
Tek başına, A olayının P(A) olasılığı öncül olasılık olarak adlandırılır. Naive Bayes modelleri, A ve B’nin bağımsız olaylar olduğunu varsayar — bu nedenle “naive” (saf) öneki kullanılır. A ve B bağımlıysa, geleneksel Bayes teoremi artık geçerli değildir ve Naive Bayes modelleri doğru seçim olmaz.
Bayesçi modeller, ortak olasılık dağılımını modelledikleri için üretici modellerdir. Eğitim süreci ortak olasılığı, P(A, B)’yi öğrenir. Eğitimden sonra, en yüksek P(A) olasılığına sahip A değerlerini tahmin etmek için kullanılabilir. Ayrıca Bayesçi modeller, koşullu olasılıkları (Bayes kuralını kullanarak) hesaplayabildikleri için sınıflandırma amacıyla da kullanılabilir.
Naive Bayes modellerini pratikte kullanmayı öğrenmek için, scikit-learn ve Python ile Naive Bayes modelleri oluşturma eğitimini izleyin.
Gauss karışım modelleri (GMM), bir sınıf karışım modelidir. Benzersiz önermeleri, temel verilerin tek bir dağılım yerine istatistiksel dağılımların birleşiminden oluştuğudur.
Bir GMM’de, popülasyonun farklı alt popülasyonların birleşimi olduğu varsayılır ve her biri bir Gauss dağılımıdır. Etkili biçimde, veri dağılımı birkaç bireysel Gauss dağılımının ağırlıklı ortalaması olarak analiz edilir.
GMM’ler, temel veri kümesinin olasılık dağılımını yakalar. Bu nedenle aykırı değer analizi ve gözetimsiz sınıflandırma gibi görevlerde kullanılırlar. Bu görevler, eğitim veri kümesini rastgele bir örneklem olarak ele alarak popülasyonun istatistiksel bir modelini kurmayı içerir.
R’da karışım modelleri dersi, GMM’lerin pratik ayrıntılarına girer.
Üretici çekişmeli ağ (GAN), sinir ağı tabanlı bir modeldir. İki bölümden oluşur: bir üretici ve bir ayrıştırıcı. Üretici ağ, eğitim örneklerine benzer vektörler üretmek üzere, ayrıştırıcı ise orijinal örneklerle üreticinin ürettiklerini ayırt etmek üzere eğitilir.
Özünde, üretici ve ayrıştırıcının eğitim hedefleri birbirine zıttır; bu onları çekişmeli yapar. Bu nedenle adında “çekişmeli” kelimesi kullanılır.
Üretici ve ayrıştırıcı aynı eğitim döngüsünde birlikte eğitilir. Üretici gerçekçi örnekler üretmede geliştikçe, ayrıştırıcı orijinal örnekleri üretilenlerden ayırt eder. Eğitim, üretici eğitim verilerine o kadar benzer örnekler üretmeyi öğrenene kadar devam eder ki ayrıştırıcı onları ayırt edemez.
Eğitimden sonra, üretici orijinal örneklere benzer gerçekçi sentetik veriler üretmek için kullanılır.
Bir gizli Markov modeli (HMM) sıralı veri kümeleriyle çalışır. Markov süreçleri (veya Markov zincirleri), sıralı verileri modellemek için kullanılır. Bir Markov modelinin önermesi, dizideki bir sonraki öğe olan xn+1’in yalnızca önceki öğe xn’e bağlı olduğu ve ondan önce gelen {x1, x2, ... xn-1}’den herhangi birine bağlı olmadığıdır. Markov modelleri, sıralı veri kümelerinin gizli durumlara sahip Markov süreçleriyle temsil edilebileceğini varsayar.
Bu durumlar dizideki bir sonraki öğeyi üretir:
Markov modelleri, geçiş olasılıkları (bir durumdan diğerine geçiş) ve yayım (emisyon) olasılıkları (belirli bir durum verildiğinde belirli bir dizi öğesinin üretilmesi) ile temsil edilir.
HMM’ler, eğitim veri kümelerini Markov süreçleri olarak modeller. Eğitimin hedefi, örnek veri kümelerindeki dizileri üretme olasılığını en üst düzeye çıkaracak geçiş ve yayım olasılıklarını belirlemektir. Dolayısıyla, bir dizi verildiğinde, eğitilmiş bir Markov modeli dizinin ardışık öğelerini üretebilir.
Pratik uygulamalarını öğrenmek için Python’da Markov zincirleri hakkındaki eğitimi izleyin.
Veri noktalarından oluşan bir eğitim veri kümesi, D, ve bunlara karşılık gelen etiketler, L, verildiğinde bir ayrıştırıcı model, koşullu olasılık dağılımını P(D | L) öğrenir. Ardından bu koşullu olasılık dağılımını, yeni veri noktalarının sınıfını tahmin etmek için kullanır.
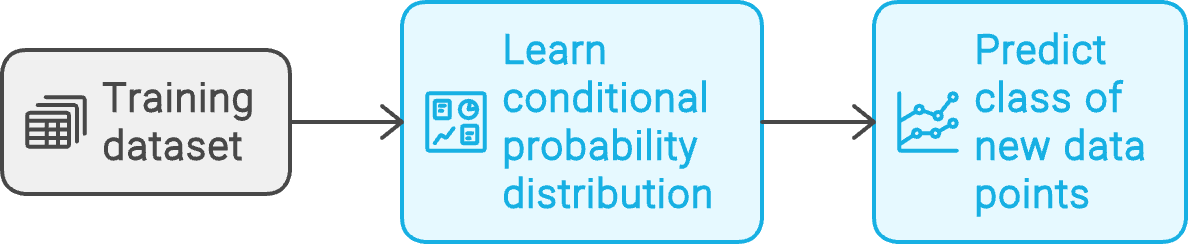
Ayrıştırıcı model iş akışı. napkin.ai ile oluşturuldu
Ayrıştırıcı modeller genellikle sınıflandırma problemlerini çözmek için kullanılır. Aşağıdaki örnekler kullanım alanlarını göstermektedir.
K-en yakın komşu (KNN), daha eski makine öğrenimi modellerinden biridir. Bir veri noktaları dağılımında benzer öğelerin birbirine yakın konumlandığı önermesine dayanır.
KNN modelleri, regresyon katsayıları gibi parametreleri olmayan parametrik olmayan modellerdir. Hem sınıflandırma hem regresyon problemleri için kullanılırlar.
Bir girdi veri noktasının kategorisi, k en yakın komşusununkiyle aynıdır. Bir veri noktasının tahmin edilen değeri, k en yakın komşusunun ortalama değeridir. k (dikkate alınacak en yakın komşu sayısı) modelin bir hiperparametresi olarak düşünülebilir. Modelin davranışını ayarlamak için kullanılır, ancak doğrudan modelin çıktısını etkilemez.
Lojistik regresyon, doğrusal regresyona benzer şekilde, bir veya daha fazla bağımsız değişkene dayanarak bağımlı değişkenin değerini tahmin etmeye çalışır. Doğrusal regresyonda bağımlı değişken sürekli değerler alır. Lojistik regresyonda bağımlı değişken aşağıdaki gibi ayrık değerler alır:
Doğrusal regresyon sayısal değerler tahmin eder. Lojistik regresyonda tahmin edilen büyüklük, bahis oranının (odds) logaritmasıdır.
Olasılığı P(A) olan bir A olayı için, bahis oranı P(A) / (1 - P(A))’dir. Logaritmanın (bahis oranının logaritması) kullanımı, eğitim sürecinde daha pürüzsüz ve daha hızlı yakınsamaya yol açar. Girdileri sınıflara ayırma yetenekleri sayesinde lojistik modeller ayrıştırıcı amaçlarla kullanılır.
Daha uygulamalı bir giriş için, Python’da lojistik regresyon rehberine bakın.
Ayrıca, istatistik odaklı bir programlama dili olan R kullanarak da lojistik regresyon uygulayabilirsiniz; bunun için R ile lojistik regresyon eğitimini inceleyin.
Destek vektör makineleri, farklı sınıflardaki veri noktalarını ayıran en uygun doğruyu belirler. 2 boyutlu X-Y düzleminde, iki farklı kategoriye ait veri noktaları verildiğinde, SVM ideal olarak bir kategorinin noktalarını diğerinden temiz biçimde ayıran bir doğruyu tahmin eder.
Bu doğru, karar sınırıdır. Üç veya daha fazla boyutlu verilerde bir hiper düzleme dönüşür. Bu hayali doğruya (her iki kategoriden) en yakın olan veri noktaları modelin destek vektörleri olarak adlandırılır. Bu veri noktaları, değerleri birbirine yakın olduğundan sınıflandırılması en zor olanlardır.
Ayırıcı doğru ile destek vektörleri arasındaki mesafeye marj denir. SVM eğitimi bu marjı en üst düzeye çıkaran karar sınırını bulmayı amaçlar. Pratikte, veri noktaları ikiden fazla boyuta sahiptir ve ayırıcı doğru daha yüksek boyutlu bir hiper düzlemdir.
SVM’ler çok sınıflı sınıflandırma problemleri için de kullanılır.
SVM’ler hakkında daha fazla bilgi için, Python scikit-learn paketiyle SVM oluşturma rehberini izleyin. Python’un yanı sıra, R’de SVM’ler rehberinde tartışıldığı gibi R’yi de kullanabilirsiniz.
Bir karar ağacı, ağaç benzeri bir yapıda düzenlenmiş birkaç karar düğümünden oluşur.
En üstteki düğüm köktür. Nihai çıktılara götüren düğümler yaprak düğümler veya terminal düğümler olarak adlandırılır. Ara yaprak olmayan düğümler dahili düğümlerdir. Kök düğümün çıktısı ara düğümlere beslenir. Her düğümün sonucu (çıktı) ya nihai çıktıdır ya da başka bir düğüme (dal) götürür.
Ağacın her düğümü, veri kümesini belirli bir öznitelik boyunca böler. Örneğin, kredi başvurularını onaylamaya yönelik bir karar ağacı, başvuruları net gelire göre ayıran düğümlere sahip olabilir.
Eğitim süreci, her karar için uygun eşik değerini belirler. Örneğin, belirli bir tutarın altındaki net gelire sahip başvurular doğrudan reddedilir. Diğerleri ise net servet gibi başka öznitelikleri dikkate alan sonraki düğümlerde daha ileri işlemden geçer.
Karar ağaçlarına yönelik uygulamalı bir rehber için Python kullanarak karar ağaçları oluşturma eğitimini veya Python’da ağaç tabanlı modellerle makine öğrenimi konulu kapsamlı dersi izleyin.
Karar ağaçlarının başlıca dezavantajı, örneklem dışı veri problemlerine yol açan aşırı uyumdur (overfitting). Karar ormanları bu sorunu çözmeye çalışır. Bir karar ormanı birçok ağaçtan oluşur. Bağımsız karar ağaçlarının tüm öznitelik kümesini dikkate alması gerekirken, bir ormandaki her ağaç öznitelik kümesinin yalnızca rastgele bir alt kümesini kullanır. Bu rastgelelik, gürültülü veri kümelerindeki varyansla başa çıkmaya yardımcı olur.
Ormanın çıktısı, örneğin bireysel ağaçların çıktılarının ortalaması alınarak birleştirilerek elde edilir.
Rastgele ormanları nasıl uygulayacağınızı öğrenmek için, scikit-learn kullanarak rastgele orman sınıflandırıcıları oluşturma rehberine bakın.
Bir sinir ağı, nöron gruplarından oluşur. Her nöron, nöronun ağırlıklarını girdi vektörüyle çarpan doğrusal bir işlev uygular.
Doğrusal işlevi, doğrusal olmayan bir aktivasyon işlevi izler. Aktivasyon işlevi, doğrusal işlevin çıktısına göre her nöronun çıktısına karar verir. Bu nedenle, basit bir sinir ağı kavramsal olarak doğrusal olmayan aktivasyonlarla süzülen bir dizi doğrusal denklem olarak görülebilir.
Bir sinir ağının girdi katmanı, girdiyi (bir vektör olarak temsil edilir) bir dizi ağırlık ve aktivasyon işleviyle çarpar. Bu çıktı, benzer bir işlemi gerçekleştiren bir sonraki katmana iletilir.
Gizli katmanlar girdi ve çıktı katmanları arasında bulunur. Son gizli katman, çıktı katmanına beslenir. Karmaşık problemler, derin sinir ağları (DNN) olarak adlandırılan çok sayıda gizli katmana sahip sinir ağları kullanılarak çözülür.
Bir sınıflandırma probleminde, yaygın bir yaklaşım, sınıf sayısı kadar çıktı nöronu bulundurmaktır. Tahmin edilen sınıf, değeri en yüksek olan nörona karşılık gelir. Bir regresyon probleminde, tek bir çıktı nöronu tahmin edilen çıktıyı içerir. Nöronların doğrusal ilişkileri, doğrusal regresyon denklemini modellemektedir.
Konuyu daha derinlemesine anlamak için sinir ağları hakkındaki blog yazısına göz atın.
Sınıflandırma gibi bazı görevler her iki model türüyle de çözülebilir. Ancak genel olarak, bu modeller farklı matematiksel yaklaşımlar benimsediğinden üretici ve ayrıştırıcı modellerin sıklıkla kendilerine özgü kullanım alanları vardır. Bu farklılıkları ve bunların, çeşitli problemler için her iki model kategorisinin uygunluğunu nasıl etkilediğini anlamak gerekir.
Üretici modeller, bir dizideki bir sonraki değeri tahmin eder veya bir metin verildiğinde görsel üretir (ya da tersi). Bu tür görevleri yapabilmek için modelin, farklı girdiler verildiğinde hangi çıktının üretileceğini öğrenmesi gerekir. Model, girdinin ve çıktının ortak olasılık dağılımını kullanır.
Temel matematiği anlamak için basit bir örnekle başlayalım. Tek bir rassal değişkenin davranışı, olasılık yoğunluk fonksiyonu (PDF) ile tanımlanır.
Rassal değişken X’in PDF’si, X’in farklı değerlerdeki olasılığını belirlemek için kullanılabilir. Örneğin, X’in PDF’si f(x) ise, X’in A ile B arasında yer alma olasılığı şöyledir:

Tüm aralık boyunca X’in olasılığı 1’dir. Bu şu şekilde ifade edilir:

Yukarıdaki ifade şu şekilde de yazılabilir:
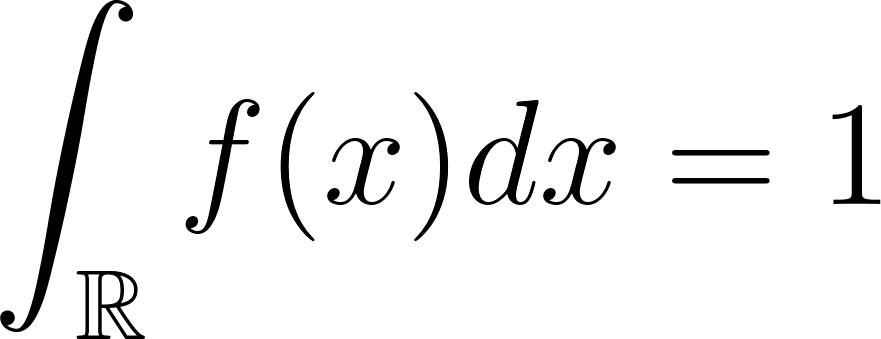
İki değişkenin, X ve Y, ortak PDF’si için, tüm aralık üzerindeki integral 1’dir:

Ortak olasılık dağılımı, hem X hem de Y’nin tüm olasılık uzayını eşler. Ortak olasılığın P(X, Y) bir G bölgesine düşme olasılığını değerlendirmek için, ortak PDF’yi G üzerinde tümleştirin:

Ayrıştırıcı modeller ise yalnızca koşullu olasılık dağılımına odaklanır. Üretici modeller gerekirse koşullu olasılığı, marjinal olasılıkları kullanarak tahmin eder.
Bir ortak olasılık dağılımı fXY(x,y) verildiğinde, rassal değişken Y’nin y değerindeki marjinal olasılığı (X’in tüm değerleri için) şu şekilde verilir:
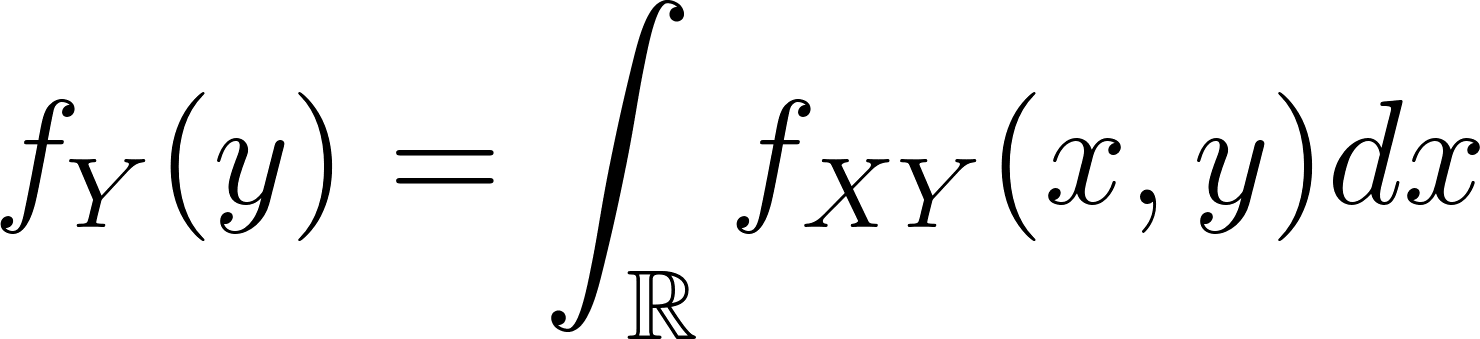
Bayes kuralına benzer şekilde, X’in koşullu PDF’si şu şekilde ifade edilir:
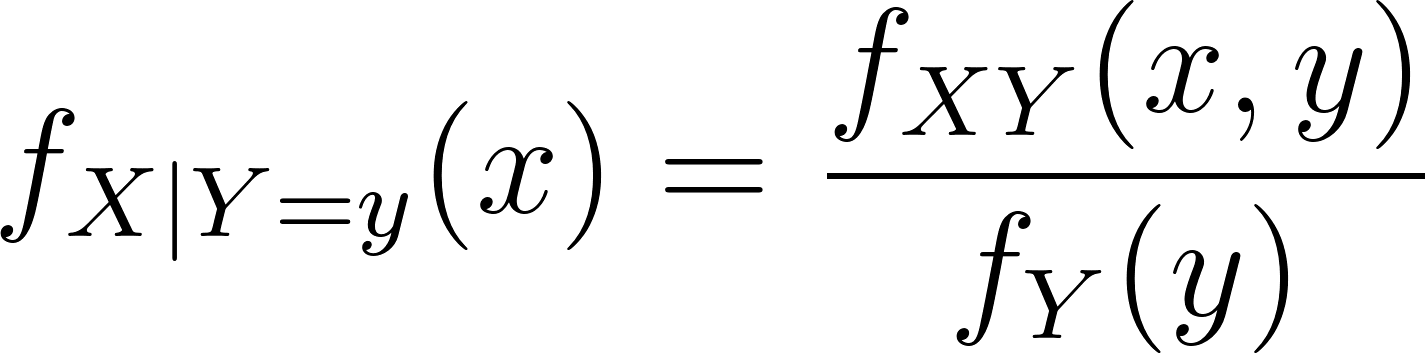
Yukarıdaki ifade, koşullu olasılığın integral sürümünü gösterir; bu daha yaygın olarak şöyle yazılır:
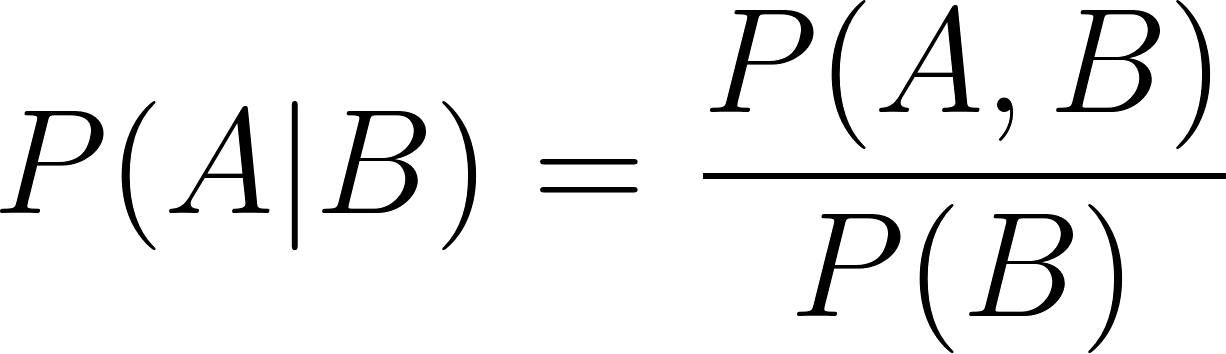
Benzer şekilde,
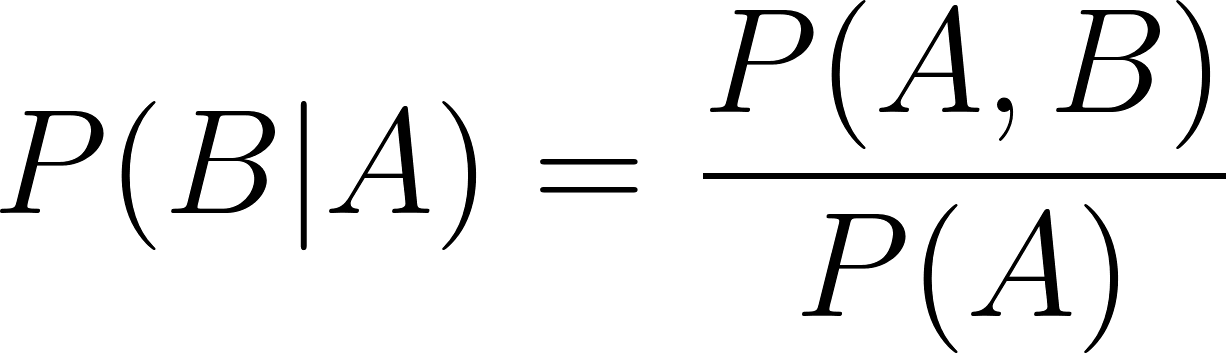
Yukarıdaki iki koşullu olasılık formülünde:
Bir koşullu olasılığı hesaplamak için üretici modeller iki adımı izler:
Öte yandan, ayrıştırıcı modeller tek (ve daha basit) bir adımı izler:
Bir üretici model, P(A) ve P(B) marjinallerine ve ortak PDF’ye P(A, B) sahiptir. Bunları kullanarak P(A | B) veya P(B | A)’yı aynı kolaylıkla değerlendirebilir. Bu, naive Bayes sınıflandırıcılarının temel fikridir. Böylece üretici modeller şu görevleri yapabilir:
Bu durum, üretici modelleri esnek ve çok amaçlı kılar. Öte yandan, eğitim sırasında doğası gereği daha fazla karmaşıklık içerirler çünkü:
Ayrıştırıcı modeller ise yalnızca koşullarla ilgilenir. Eğitim veri kümesine dayanarak, ortak veya marjinal olasılıkları tahmin etmeden koşullu olasılıkları doğrudan tahmin etmek mümkündür.
Dolayısıyla ayrıştırıcı modellerin eğitimi daha basittir. Ancak, P(A | B) koşullu olasılığını öğrenmiş bir ayrıştırıcı model yalnızca bu belirli koşullu olasılığı içeren görevleri yerine getirebilir. Başka bir şey yapamaz.
Üretici modeller hem üretici hem ayrıştırıcı görevler için yeterince esnektir. Eğitim sırasında model ortak PDF’yi ve marjinalleri öğrenir. Çıkarım sırasında model, koşullu olasılığı ortak dağılım ve uygun marjinal olasılığı kullanarak hesaplamak zorundadır. Bu nedenle, ayrıştırıcı görevlerde çıkarım daha yavaştır.
Ayrıştırıcı modeller ise koşullu olasılıkları doğrudan (sayısal olarak) öğrenmiştir. Çıkarım sırasında girdiye dayanarak koşullu olasılığı tek adımda tahmin ederler.
Ayrıca, ayrıştırıcı modeller yalnızca tek bir niceliği (koşullu olasılığı) tahmin etmeye odaklandığından, daha doğru oldukları gözlemlenmiştir. Bir ortak PDF, basit bir koşullu olasılıktan daha fazla belirsizlik içerir. Bu ek belirsizlik, üretici modellerin sınıflandırma görevlerindeki nispeten daha düşük doğruluğuna yansır.
Önceki bölümlerdeki tartışmaya dayanarak, aşağıdaki tablo üretici ve ayrıştırıcı modeller arasındaki farkları özetlemektedir.
|
Üretici modeller |
Ayrıştırıcı modeller |
|
|
Amaç |
Ortak olasılık ve marjinal olasılığı yakalamak. Koşullu olasılığı hesaplamak için Bayes kuralını kullanmak. |
Yalnızca koşullu olasılığı yakalamak. Ortak veya marjinal olasılıklara dair bilgi yoktur. |
|
Veri üretimi |
Eğitim veri kümesine dayanarak yeni veri noktaları üretebilir. Örneğin, el yazısı rakamlarla eğitilmiş bir model yeni, sahte rakamlar üretebilir. |
Yeni veri noktaları üretemez. Temel olarak farklı veri kategorilerini ayırt etmeye odaklanır. |
|
Birincil kullanım alanı |
Hem üretici (örn. veri sentezi) hem ayrıştırıcı (örn. sınıflandırma) görevler için kullanılabilir. |
Yalnızca sınıflandırma veya regresyon gibi ayrıştırıcı görevlerde kullanılabilir. |
|
Çıkarım performansı |
Karmaşık hesaplamalar gerektiğinden çıkarım çalıştırmak daha yavaştır. Basit görevlerde bile marjinal ve ortak olasılıkların hesaplanması ve Bayes kuralının uygulanması gerekir. |
Bayes kuralına başvurmadan koşullu olasılığı doğrudan hesapladığı için daha hızlı çıkarım. |
|
Eksik veriyle başa çıkma |
Temel olasılık dağılımını modelleyerek eksik verilerle başa çıkmada daha iyidir; “boşlukları doldurmak” daha kolaydır. Aşırı uyum riski daha düşüktür. |
Eksik verilerle başa çıkmada daha az etkilidir. Model sınıflar arasındaki ayırıcı hiper düzlemi bulmaya odaklandığı için aşırı uyum riski daha yüksektir. |
|
Yakınsama |
Genellikle daha hızlı ve daha az eğitim örneğiyle yakınsarlar ancak özellikle sınıflandırma görevlerinde, koşullu olasılığın ortak olasılık dağılımını modelleme yoluyla dolaylı hesaplanması nedeniyle genelde daha yüksek model hatasıyla sonuçlanırlar. |
Genellikle daha fazla veriye ihtiyaç duyar ve daha yavaş yakınsalar da özellikle sınıflandırma görevlerinde, ortak olasılık dağılımını tahmin etmeden koşullu olasılığı doğrudan modelledikleri için daha düşük model hatası elde edilir. |
|
Model karmaşıklığı |
Genellikle daha karmaşıktırlar çünkü etiketler ve öznitelikler arasındaki etkileşimler de dahil olmak üzere tüm veri dağılımını modelleyebilirler. |
Genellikle daha yalındır çünkü yalnızca sınıflar arasındaki karar sınırını veya ayırıcı hiper düzlemi modellemeleri gerekir. |
|
Model örnekleri |
Naive Bayes, Gizli Markov Modelleri (HMM), Üretici Çekişmeli Ağlar (GAN), Değişken Otomatik Kodlayıcılar (VAE). |
Lojistik Regresyon, Destek Vektör Makineleri (SVM), Sinir Ağları ve Karar Ağaçları. |
|
Model esnekliği |
Uygulama açısından daha esnektir (hem üretici hem ayrıştırıcı görevleri ele alabilir). |
Daha az esnektir (ayrıştırıcı görevlerle sınırlıdır). |
|
Hata oranları |
Dolaylı tahmin yöntemleri nedeniyle sınıflandırma görevlerinde daha yüksek hata oranları. |
Koşullu olasılık üzerinde doğrudan eğitim nedeniyle sınıflandırma görevlerinde daha düşük hata oranları. |
Adından da anlaşılacağı üzere üretici modeller, eğitim verilerindeki kalıplara uyan yeni veriler üretmeyi içeren görevlere benzersiz şekilde uygundur.
Bu modellerin bazı yaygın kullanım alanları şunlardır:
Birçok bilgisayarlı görü modeli için büyük bir eğitim görselleri veri kümesine sahip olmak esastır. Bu modellerin, aynı görselin veya özelliğin birçok varyantı üzerinde eğitilmesi gerekir.
Aynı nesnenin fotoğraflarını farklı açılardan, arka planlardan veya renk tonlarından çekmek her zaman gerçekçi değildir. Ayrıca, birçok göreve özel görsel veri kümesi, oluşturulmaları alan becerileri gerektirdiğinden boyut olarak sınırlı olma eğilimindedir. Örneğin, belirli bir akciğer hastalığının röntgenlerinden oluşan bir görsel seti oluşturmak için göğüs hastalıkları uzmanlarına, radyoloji laboratuvarlarına ve rıza veren hasta ve hastanelere erişmeniz gerekir.
Bu tür durumlarda, en pragmatik seçenek, küçük ama son derece seçilmiş ve ilgili bir veri kümesi oluşturmak ve ardından orijinal veri kümesine benzer sentetik olarak yeni veri noktaları üretmektir.
Bir metin açıklaması verildiğinde yeni görseller üretmek veya bazı girdiler verildiğinde yeni metin üretmek. Bu tür görevleri ele alabilen tek model sınıfı üretici modellerdir.
DALL-E, MidJourney ve Stable Diffusion gibi görsel üretim modelleri, belirli bir açıklamaya uyan ve mevcut telif haklarını ihlal etmeyen görseller üretmek için rutin olarak kullanılır.
Benzer şekilde, YDK’lar (LLM’ler) sıklıkla kurgu hikâye kurguları, pazarlama sloganları ve etiketleri, belge özetleri ve benzeri materyaller üretmek için kullanılır.
Üretici modeller, temel verilerin ortak olasılık dağılımına dayalı görevlerde kullanılır. Bir yatırım portföyünün beklenen risk ve getiri profilini tahmin etmek için varlık getirilerinin ortak dağılımını modellemek, finansta ve risk yönetiminde standarttır.
Örneğin bir yatırım yöneticisi, iki farklı hissenin fiyatlarının aynı anda yükselme veya düşme olasılığını bilmek isteyebilir — ortak PDF’ler bu tür soruları yanıtlayabilir.
Finansal hizmetler sektörü, “üretici modeller” terimi yaygınlaşmadan çok önce bu istatistiksel yöntemleri kullanıyordu.
Gözetimsiz sınıflandırma gibi problemler, Gauss karışım modellerine özgü şekilde uygundur. Bu problemler, geniş bir veri noktaları koleksiyonuna sahip olup veri noktalarının kaç veya hangi kategorilere ait olduğunu bilmediğiniz durumlardır. Verinin bir dağılım kombinasyonundan geldiğini beklemek mantıklıdır; bunu bir GMM modelleyebilir.
Kategori sayısı ve listesi önceden bilinseydi, ayrıştırıcı yöntemler daha uygun olurdu.
GMM’ler, farklı müşteri gruplarının davranışı gibi “alışılmış” verilerin farklı dağılımların birleşimi olarak modellenebildiği aykırı değer analizinde (anomali tespiti, dolandırıcılık tespiti vb.) de faydalıdır. Anomaliler, diğer kalıplardan herhangi birinden önemli ölçüde farklı olan veri noktalarıdır.
Dizileri içeren problemler sıklıkla gizli Markov modelleriyle çözülür. Yaygın bir kullanım alanı genom dizilerinin modellenmesi ve yeniden dizilemedir.
HMM’ler konuşma tanımada da kullanılır; burada önceki hecelerin dizisi verildiğinde bir sonraki heceyi tahmin etmeye yardımcı olurlar. Dizi modelleme, paket teslimat programları gibi lojistik uygulamalarda da yaygındır. Benzer şekilde, bulaşıcı hastalıkların iletimi ve yayılımı sıklıkla Markov zincirleri kullanılarak modellenir.
Matematiksel olarak, ayrıştırıcı modeller, yalnızca koşullu olasılığın ilgili olduğu, ortak olasılığın ilgili olmadığı uygulamalarda kullanılır. Bu nedenle ayrıştırıcı modeller tipik olarak sınıflandırma ve tahmin problemlerinde kullanılır.
Bazı örnekler şunlardır:
Sınıfların (kategorilerin) önceden bilindiği gözetimli sınıflandırma problemleri. Bu, KNN ve SVM’lerin başat kullanım alanıdır.
Harcamalar, satın alma tutarları, satın alma sıklığı, iade geçmişi vb. dahil olmak üzere müşteri davranış verilerinden oluşan geniş bir veri noktaları koleksiyonunuz var. Bu bilgiyi, müşterileri yüksek harcayanlar, pazarlık avcıları, düzenli müşteriler, ciddi olmayan müşteriler vb. gibi farklı kategorilere sınıflandırmak için kullanmanız gerekiyor. Daha önce tartışıldığı gibi, GMM’lerin yaygın olarak kullanıldığı gözetimsiz sınıflandırma problemleriyle bunu karşılaştırın.
Sınıflandırma ve regresyon gibi öngörücü görevlerde öncelik genellikle hız ve doğruluktur. İlke olarak üretici modeller de bu tür problemleri çözebilir.
Özellikle, eksik veri noktaları gibi sorunlar olduğunda, eğitim için yalnızca sınırlı bir veri kümesi mevcut olduğunda veya düzenli olarak yeni kategoriler eklemeniz beklendiğinde üretici modeller tercih edilir.
Bununla birlikte, çoğu standart kullanım durumunda, üretici modeller, hesaplamaları ortak olasılık dağılımını içerdiğinden, öngörücü görevlerde daha yüksek hata oranları ve daha yavaş çıkarım dezavantajına sahiptir. Bu nedenle, eğitim için büyük ve sağlıklı bir veri kümesinin mevcut olduğu standart sınıflandırma ve regresyon problemleri için, daha iyi performans özellikleri nedeniyle ayrıştırıcı modeller tercih edilir.
Yalnızca sınıflandırmanın sonucuna odaklanan ve temel verileri modellemeyi gerektirmeyen görevlerde ayrıştırıcı modeller tercih edilir.
Örneğin, ses kayıtlarını ilgili dillerine göre kategorize etmek istiyorsanız, dili ve dilbilgisini anlayan bir modele ihtiyacınız yoktur. Bir sınıflandırma problemi için konuşma tanıma modeli aşırıya kaçar. Ayrıştırıcı bir modeli kullanarak karar sınırına odaklanmak yeterlidir. Bu nedenle bir YDK yerine basit bir sinir ağı ya da Bayesçi bir model yerine lojistik regresyon kullanabilirsiniz.
Bireysel adımların net seçimler içerdiği çok adımlı kararlar, karar ağaçları için iyi adaylardır. Karar ağaçları, daha derin analiz gerektiren veri noktalarını kısa listeye almak için sıklıkla ön filtre olarak kullanılır.
Örneğin, sıklıkla GMM gibi karmaşık modellerle çözülen dolandırıcılık tespitini düşünün. Hangi model kullanılırsa kullanılsın, insanlar yüksek riskli işlemleri neredeyse her zaman inceler. Bu nedenle alternatif bir yaklaşım, daha ileri manuel inceleme için potansiyel olarak sahte işlemler listesini işaretlemek üzere bir karar ağacı kullanmaktır.
Karar ağaçları birçok iş operasyonunda da kullanılır. Amaç, önceden belirlenmiş koşullara dayanarak doğru eylem yoluna karar vermektir. Bu tür görevler ne üretici modellere ne de sinir ağları gibi daha karmaşık ayrıştırıcı modellere ihtiyaç duyar.
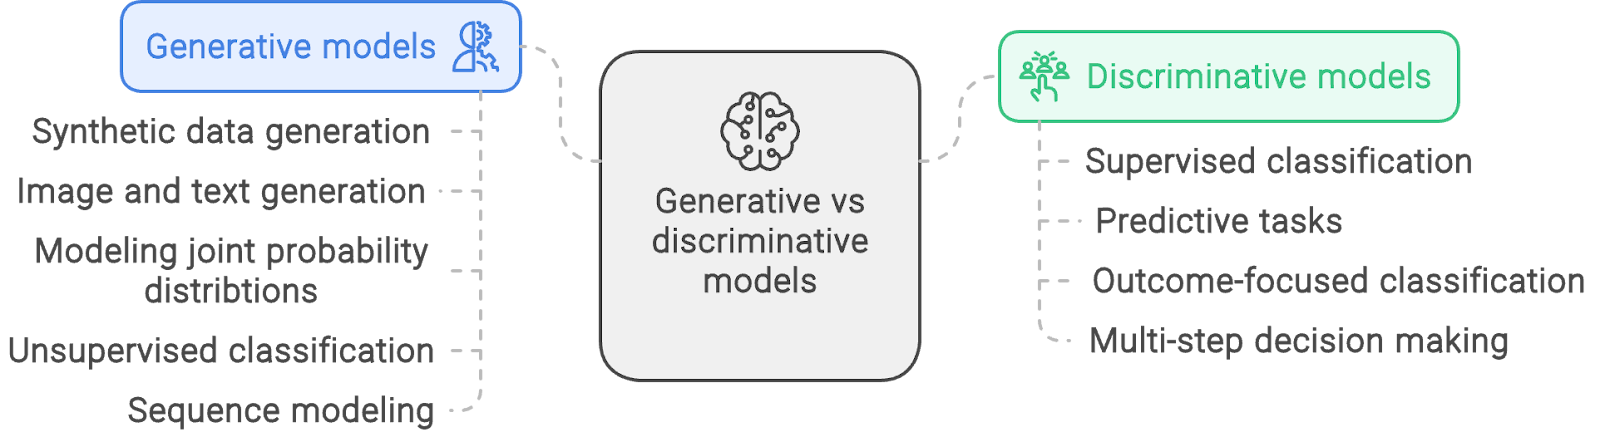
Üretici ve ayrıştırıcı modellere örnek uygulamalar. napkin.ai ile oluşturuldu
Bu makale, makine öğrenimi tekniklerinin iki ana yaklaşımı olan üretici ve ayrıştırıcı modellerin temel ilkelerini ve başlıca farklarını açıkladı.
Çoğu makine öğrenimi olasılıksal yöntemlere dayansa da, üretici modeller ortak olasılık dağılımına, ayrıştırıcı modeller ise yalnızca koşullu olasılıklara dayanır. Dolayısıyla bu iki model sınıfının farklı uygulamaları ve performans özellikleri vardır. Çok çeşitli modellerin mevcut olduğu düşünüldüğünde, işe uygun doğru aracı seçmek esastır.
Model türleri ve aralarındaki farkları kavramsal olarak anlamanın ötesinde, asıl önemli olan bizzat modeller inşa etmektir. Gözetimli eğitim yöntemlerini ve basit bir lojistik regresyon modelinin nasıl kurulacağını anlatan blog yazısıyla başlayın.
Bu kurslarla makine öğrenimi hakkında daha fazlasını öğrenin!
Kurs
Kurs
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



