Cours
Comprendre le Machine Learning
2 h
308.2K
Les modèles d’apprentissage automatique (ML) sont des implémentations informatiques de méthodes statistiques et probabilistes. Ils adoptent généralement l’une de deux approches : la modélisation générative ou discriminative.
Dans cet article, nous proposons un aperçu des modèles génératifs et discriminatifs, présentons les modèles courants de chaque type, expliquons les principes mathématiques qui les sous-tendent et illustrons des exemples concrets des types de problèmes pour lesquels chaque famille de modèles est adaptée.
Étant donné un ensemble d’exemples de données, D, et leurs étiquettes associées, L, un modèle génératif apprend la distribution de probabilité conjointe P(D, L). Il utilise ensuite cette distribution sous-jacente pour générer de nouvelles données similaires aux exemples d’entraînement ou pour résoudre des problèmes de classification.
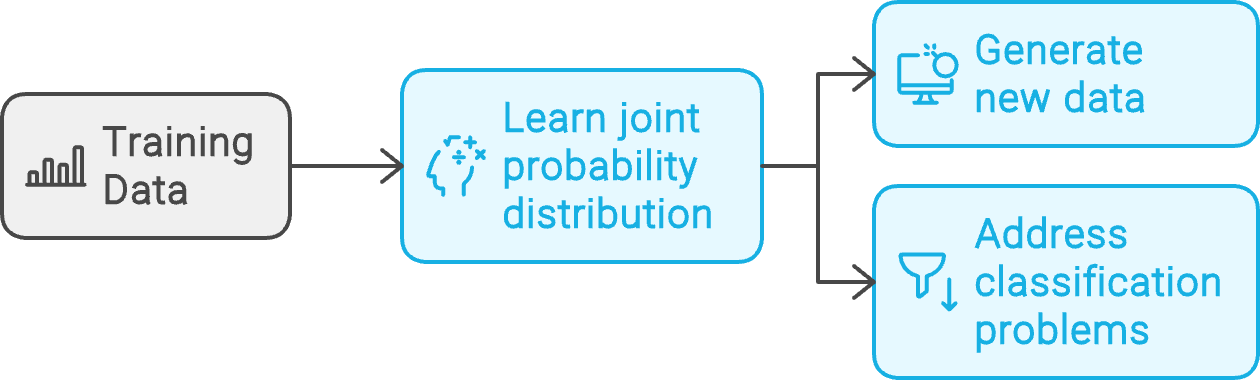
Flux de travail d’un modèle génératif. Créé avec napkin.ai
Les sections suivantes expliquent les fondamentaux des modèles génératifs avec des exemples.
Les modèles de Bayes naïf reposent sur le théorème de Bayes. Ce théorème donne la probabilité conditionnelle P(A | B) d’un événement A sachant que l’événement B est vrai. Il s’agit de la probabilité a posteriori de A sachant B.
Individuellement, la probabilité P(A) de l’événement A est appelée probabilité a priori. Les modèles de Bayes naïf supposent que A et B sont des événements indépendants — d’où le préfixe « naïf ». Si A et B sont dépendants, le théorème de Bayes classique ne s’applique plus et les modèles de Bayes naïf ne sont pas adaptés.
Les modèles bayésiens sont génératifs car ils modélisent la distribution de probabilité conjointe. L’entraînement apprend la probabilité conjointe — P(A, B). Après entraînement, on peut prédire les valeurs de A avec la probabilité la plus élevée P(A). En outre, les modèles bayésiens peuvent aussi être utilisés pour la classification puisqu’ils permettent de calculer des probabilités conditionnelles (via la règle de Bayes).
Pour apprendre à utiliser Bayes naïf en pratique, suivez le tutoriel sur la création de modèles Naive Bayes avec scikit-learn et Python.
Les modèles de mélanges gaussiens (GMM) appartiennent à la famille des modèles de mélange. Leur idée clé est que les données sous-jacentes résultent d’une combinaison de distributions statistiques plutôt que d’une seule distribution.
Dans un GMM, la population est supposée être une combinaison de sous-populations, chacune suivant une loi gaussienne. Concrètement, la distribution des données est analysée comme une moyenne pondérée de plusieurs distributions gaussiennes élémentaires.
Les GMM capturent la distribution de probabilité du jeu de données sous-jacent. Ils sont donc utilisés pour des tâches comme l’analyse d’anomalies et la classification non supervisée. Ces tâches consistent à construire un modèle statistique de la population en considérant le jeu d’entraînement comme un échantillon aléatoire.
Le cours sur les modèles de mélange en R explore en détail la mise en pratique des GMM.
Un réseau antagoniste génératif (GAN) est un modèle basé sur des réseaux de neurones. Il comporte deux parties : un générateur et un discriminateur. Le réseau générateur est entraîné à produire des vecteurs similaires aux exemples d’entraînement, tandis que le discriminateur est entraîné à distinguer les exemples originaux de ceux générés par le générateur.
En substance, le générateur et le discriminateur poursuivent des objectifs opposés, ce qui les rend antagonistes. D’où le terme « adversarial » dans l’appellation.
Le générateur et le discriminateur sont entraînés conjointement dans la même boucle d’entraînement. À mesure que le générateur s’améliore pour créer des exemples réalistes, le discriminateur affine sa capacité à distinguer les originaux des synthétiques. L’entraînement se poursuit jusqu’à ce que le générateur produise des exemples si proches des données d’apprentissage que le discriminateur n’arrive plus à les différencier.
Après entraînement, on utilise le générateur pour produire des données synthétiques réalistes, proches des exemples d’origine.
Un modèle de Markov caché (HMM) traite des jeux de données séquentiels. Les processus de Markov (ou chaînes de Markov) servent à modéliser des données séquentielles. Le postulat d’un modèle de Markov est que le prochain élément, xn+1, d’une séquence ne dépend que de l’élément précédent, xn, et pas des éléments antérieurs {x1, x2, ... xn-1}. Les modèles de Markov supposent que les jeux séquentiels peuvent être représentés par des processus de Markov à états cachés.
Ces états génèrent le prochain élément de la séquence :
Les modèles de Markov sont décrits par des probabilités de transition (passage d’un état à un autre) et des probabilités d’émission (génération d’un élément donné de la séquence pour un état donné).
Les HMM modélisent les jeux d’entraînement comme des processus de Markov. L’objectif de l’entraînement est d’estimer les probabilités de transition et d’émission qui maximisent la probabilité de générer les séquences des jeux d’exemples. Ainsi, étant donnée une séquence, un modèle de Markov entraîné peut générer les éléments successifs de la séquence.
Pour leur mise en œuvre pratique, suivez le tutoriel sur les chaînes de Markov en Python.
Étant donné un jeu d’entraînement composé de points de données, D, et de leurs étiquettes associées, L, un modèle discriminatif apprend la distribution de probabilité conditionnelle P(D | L). Il utilise ensuite cette distribution conditionnelle pour prédire la classe de nouveaux points de données.
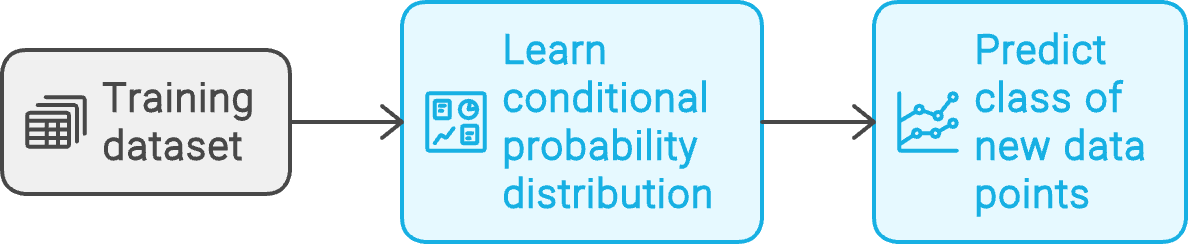
Flux de travail d’un modèle discriminatif. Créé avec napkin.ai
Les modèles discriminatifs servent généralement à résoudre des problèmes de classification. Les exemples suivants illustrent leurs cas d’usage.
K-nearest neighbors (KNN) est l’un des modèles historiques du machine learning. Il repose sur l’idée que, dans une distribution de points de données, les éléments similaires se trouvent à proximité les uns des autres.
Les modèles KNN sont non paramétriques, sans paramètres tels que des coefficients de régression. Ils sont utilisés pour des tâches de classification comme de régression.
La catégorie d’un point d’entrée correspond à celle de ses k plus proches voisins. La valeur prédite d’un point est la moyenne des valeurs de ses k plus proches voisins. k (le nombre de voisins pris en compte) est un hyperparamètre du modèle. Il sert à ajuster le comportement du modèle sans influer directement sur sa sortie.
Comme la régression linéaire, la régression logistique cherche à prédire la valeur d’une variable dépendante à partir d’une ou plusieurs variables indépendantes. En régression linéaire, la variable dépendante est continue. En régression logistique, elle prend des valeurs discrètes, par exemple :
La régression linéaire prédit des valeurs numériques. En régression logistique, la quantité prédite est le logarithme du rapport de cotes (odds).
Pour un événement A, de probabilité P(A), le rapport de cotes vaut P(A) / (1 - P(A)). L’utilisation du logarithme (du rapport de cotes) favorise une convergence plus douce et plus rapide pendant l’entraînement. Étant donné leur capacité à séparer les entrées en classes, les modèles logistiques sont utilisés à des fins discriminatives.
Pour une introduction pratique, consultez le guide sur la régression logistique en Python.
Vous pouvez aussi implémenter une régression logistique en R, un langage orienté statistique, comme expliqué dans le tutoriel sur la régression logistique en R.
Les machines à vecteurs de support déterminent la droite optimale séparant des points de données de classes différentes. Dans le plan X‑Y à 2 dimensions, pour un ensemble de points appartenant à deux catégories, le SVM calcule une droite qui (idéalement) sépare nettement les points d’une catégorie de ceux de l’autre.
Cette droite est la frontière de décision. Elle devient un hyperplan lorsque les données ont trois dimensions ou plus. Les points (de chaque catégorie) qui sont les plus proches de cette ligne imaginaire sont appelés vecteurs de support du modèle. Ce sont les plus difficiles à classer car leurs valeurs sont proches.
La distance entre la ligne séparatrice et les vecteurs de support est appelée la marge. L’entraînement d’un SVM vise à trouver la frontière de décision qui maximise cette marge. En pratique, les points ont plus de deux dimensions et la frontière est un hyperplan de dimension supérieure.
Les SVM s’emploient aussi pour des problèmes de classification multiclasse.
Pour en savoir plus sur les SVM, suivez ce guide sur la création de SVM avec scikit-learn en Python. Outre Python, vous pouvez aussi utiliser R, comme expliqué dans ce guide sur les SVM en R.
Un arbre de décision est constitué de plusieurs nœuds de décision organisés en structure arborescente.
Le nœud au sommet est la racine. Les nœuds menant à des sorties finales sont appelés feuilles ou nœuds terminaux. Les nœuds intermédiaires non terminaux sont dits internes. La sortie du nœud racine alimente les nœuds intermédiaires. Le résultat de chaque nœud est soit la sortie finale, soit redirigé (branche) vers un autre nœud.
Chaque nœud de l’arbre segmente le jeu de données selon un attribut particulier. Par exemple, un arbre de décision pour l’approbation de demandes de prêt peut comporter des nœuds qui séparent les dossiers selon le revenu net.
Le processus d’entraînement détermine le seuil approprié à chaque décision. Par exemple, les demandes dont le revenu net est inférieur à un certain montant sont rejetées d’emblée. Les autres sont traitées dans les nœuds suivants, qui examinent d’autres attributs, comme le patrimoine net.
Pour un guide pratique, consultez le tutoriel sur la construction d’arbres de décision en Python, ou le cours complet sur le machine learning avec des modèles à base d’arbres en Python.
Le principal inconvénient des arbres de décision est le surapprentissage, qui dégrade les performances hors échantillon. Les forêts de décision cherchent à résoudre ce problème. Une forêt de décision regroupe de nombreux arbres. Contrairement à un arbre isolé, qui doit considérer l’ensemble des variables, chaque arbre d’une forêt ne voit qu’un sous-ensemble aléatoire des variables. Cette part d’aléa aide à traiter la variance des jeux de données bruités.
La sortie de la forêt s’obtient en combinant, par exemple en moyennant, les sorties des arbres individuels.
Pour apprendre à implémenter des random forests, reportez-vous au guide sur l’utilisation de scikit-learn pour construire des classificateurs random forest.
Un réseau de neurones est composé de groupes de neurones. Chaque neurone implémente une fonction linéaire qui multiplie les poids du neurone par le vecteur d’entrée.
Une fonction d’activation non linéaire suit cette fonction linéaire. L’activation décide de la sortie de chaque neurone en fonction de la sortie de la fonction linéaire. Ainsi, un réseau de neurones simple peut se voir comme une suite d’équations linéaires filtrées par des activations non linéaires.
La couche d’entrée multiplie l’entrée (représentée en vecteur) par un ensemble de poids et d’activations. Cette sortie est transmise à la couche suivante, qui effectue une opération similaire.
Les couches cachées se situent entre les couches d’entrée et de sortie . La dernière couche cachée alimente la couche de sortie. Les problèmes complexes mobilisent des réseaux profonds, ou deep neural networks (DNN).
En classification, une approche courante consiste à avoir autant de neurones de sortie que de classes. La classe prédite correspond au neurone ayant la valeur la plus élevée. En régression, un seul neurone de sortie porte la valeur prédite. Les relations linéaires des neurones modélisent l’équation de régression linéaire.
Pour approfondir, consultez le billet de blog sur les réseaux de neurones.
Certaines tâches, comme la classification, peuvent être résolues par l’un ou l’autre type de modèle. En général toutefois, modèles discriminatifs et génératifs ont souvent des cas d’usage distincts, car ils reposent sur des approches mathématiques différentes. Comprendre ces différences et leur impact sur la pertinence de chaque famille de modèles selon les problèmes est indispensable.
Les modèles génératifs prédisent la prochaine valeur d’une séquence ou génèrent une image à partir d’un texte (et inversement). Pour y parvenir, le modèle doit apprendre quelle sortie produire selon l’entrée. Il utilise la distribution de probabilité conjointe de l’entrée et de la sortie.
Pour comprendre les bases mathématiques, partons d’un exemple simple. Le comportement d’une variable aléatoire est décrit par sa fonction de densité de probabilité (PDF).
La PDF de la variable aléatoire X permet de déterminer la probabilité de X à différentes valeurs. Par exemple, si la PDF de X est f(x), la probabilité que X soit entre A et B est donnée par :

La probabilité de X sur tout son domaine vaut 1. Cela s’écrit :

L’expression ci‑dessus peut aussi s’écrire :
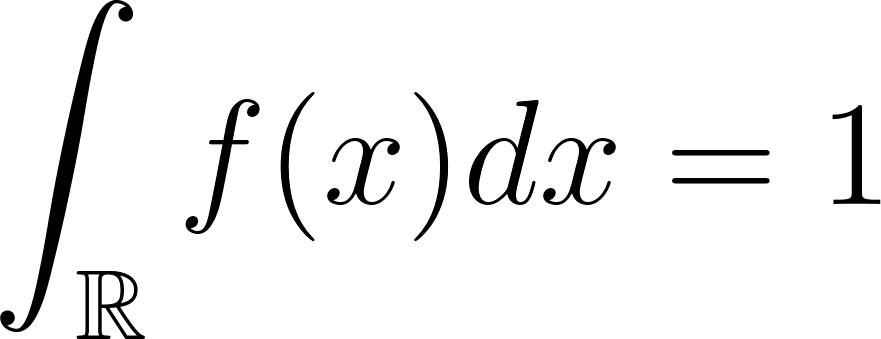
Pour une PDF conjointe de deux variables, X et Y, l’intégrale sur tout le domaine vaut 1 :

La distribution de probabilité conjointe couvre tout l’espace de probabilité de X et Y. Pour évaluer la probabilité que la conjointe P(X, Y) tombe dans une région G, intégrez la PDF conjointe sur G :

Les modèles discriminatifs, eux, se concentrent uniquement sur la distribution de probabilité conditionnelle. Les modèles génératifs, si nécessaire, estiment la probabilité conditionnelle à partir des probabilités marginales.
Étant donnée une distribution conjointe fXY(x,y), la probabilité marginale de la variable aléatoire Y en y (pour toutes les valeurs de X) est donnée par :
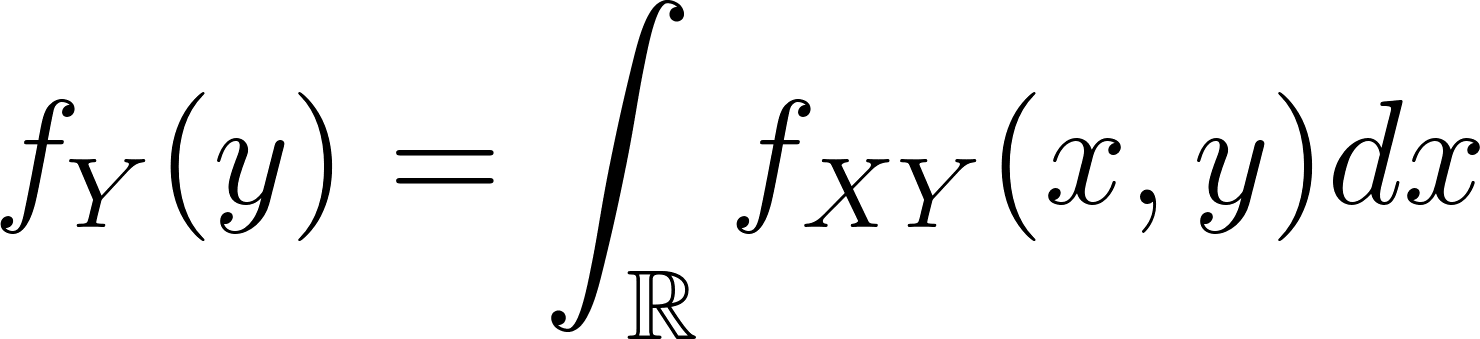
Comme pour la règle de Bayes, la PDF conditionnelle de X s’exprime alors :
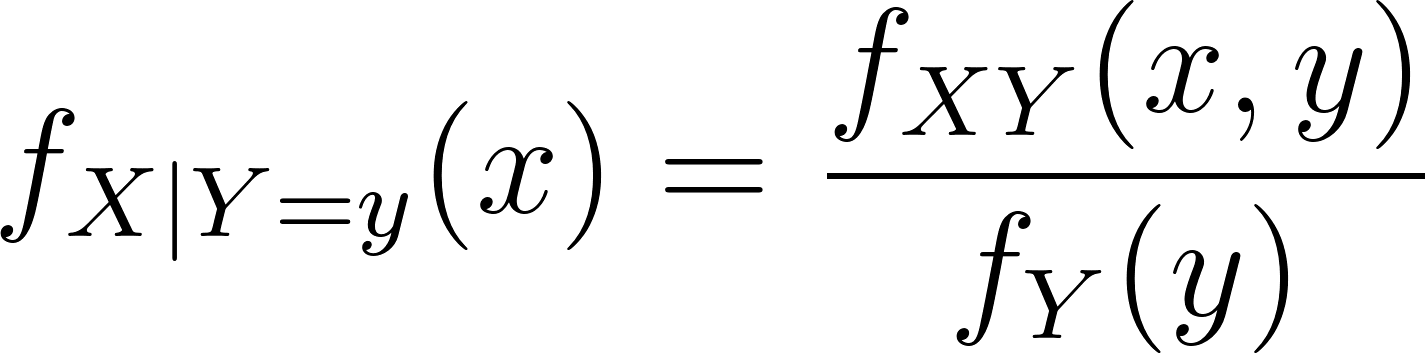
Cette expression correspond à la version intégrale de la probabilité conditionnelle, plus souvent écrite :
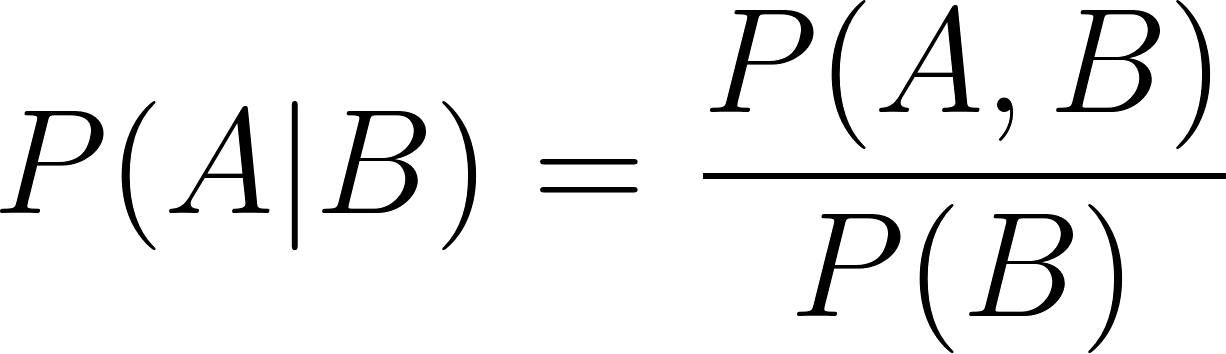
De même,
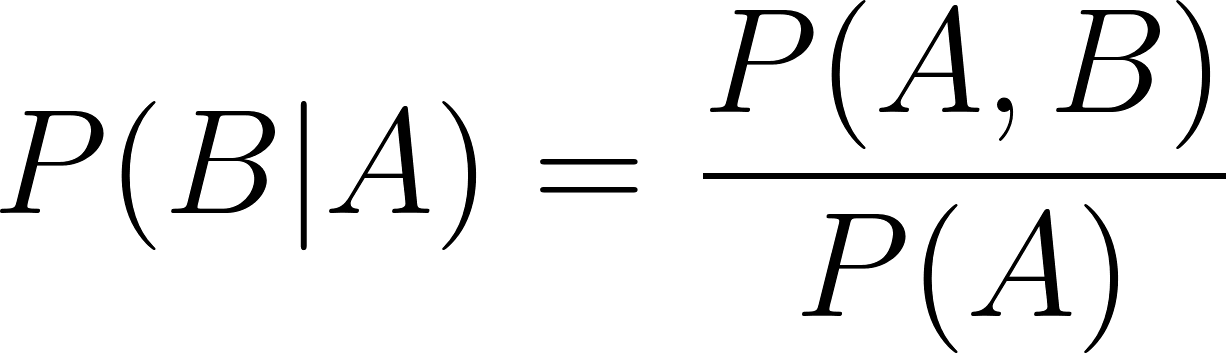
Dans les deux formules de probabilité conditionnelle ci‑dessus :
Pour calculer une probabilité conditionnelle, les modèles génératifs suivent deux étapes :
À l’inverse, les modèles discriminatifs suivent une seule étape (plus simple) :
Un modèle génératif dispose des marginales P(A) et P(B) ainsi que de la PDF conjointe P(A, B). À partir de celles‑ci, il peut évaluer P(A | B) ou P(B | A) aussi aisément. C’est l’idée sous‑jacente des classificateurs de Bayes naïf. Les modèles génératifs peuvent donc :
Cela rend les modèles génératifs flexibles et polyvalents. En contrepartie, ils impliquent davantage de complexité à l’entraînement car :
Les modèles discriminatifs, eux, ne s’occupent que des conditionnelles. À partir du jeu d’entraînement, on peut estimer directement les probabilités conditionnelles, sans estimer les probabilités conjointes ni marginales.
Ainsi, les modèles discriminatifs sont plus simples à entraîner. Toutefois, un modèle discriminatif ayant appris P(A | B) ne peut réaliser que des tâches impliquant cette probabilité conditionnelle particulière. Il ne peut rien faire d’autre.
Les modèles génératifs sont assez souples pour des tâches génératives comme discriminatives. À l’entraînement, le modèle apprend la PDF conjointe et les marginales. En inférence, il doit calculer la probabilité conditionnelle à partir de la conjointe et de la marginale appropriée. L’inférence sur des tâches discriminatives est donc plus lente.
Les modèles discriminatifs, eux, ont appris directement (numériquement) les probabilités conditionnelles. Ils estiment la probabilité conditionnelle en une seule étape à partir de l’entrée lors de l’inférence.
En outre, parce qu’ils se concentrent uniquement sur l’estimation d’une quantité (la probabilité conditionnelle), ils sont généralement plus précis. Une PDF conjointe comporte plus d’incertitude qu’une simple probabilité conditionnelle. Cette incertitude supplémentaire se traduit par une précision relativement moindre des modèles génératifs pour les tâches de classification.
À partir des éléments précédents, le tableau ci‑dessous résume les différences entre modèles génératifs et discriminatifs.
|
Modèles génératifs |
Modèles discriminatifs |
|
|
Objectif |
Capturer la probabilité conjointe et les probabilités marginales. Utiliser la règle de Bayes pour calculer la probabilité conditionnelle. |
Capturer uniquement la probabilité conditionnelle. Aucune information sur les probabilités conjointes ou marginales. |
|
Génération de données |
Peuvent générer de nouveaux points de données à partir du jeu d’entraînement. Par exemple, un modèle entraîné sur des chiffres manuscrits peut créer de nouveaux chiffres « faux ». |
Ne peuvent pas générer de nouveaux points de données. Se concentrent principalement sur la distinction entre différentes catégories de données. |
|
Cas d’usage principal |
Peuvent être utilisés à la fois pour des tâches génératives (ex. synthèse de données) et discriminatives (ex. classification). |
Ne s’appliquent qu’aux tâches discriminatives comme la classification ou la régression. |
|
Performance en inférence |
Inférence plus lente du fait de calculs complexes. Même des tâches simples requièrent le calcul des marginales, de la conjointe et l’application de la règle de Bayes. |
Inférence plus rapide car la probabilité conditionnelle est calculée directement, sans recourir à la règle de Bayes. |
|
Gestion des données manquantes |
Meilleure gestion des valeurs manquantes grâce à la modélisation de la distribution sous-jacente, ce qui facilite le « comblement des trous ». Risque de surapprentissage plus faible. |
Moins efficaces pour gérer les données manquantes. Risque de surapprentissage plus élevé car le modèle se concentre sur la recherche de l’hyperplan séparateur. |
|
Convergence |
Tendent à converger plus vite et avec moins d’exemples d’entraînement mais aboutissent généralement à une erreur modèle plus élevée, notamment en classification, du fait du calcul indirect des probabilités conditionnelles via la modélisation conjointe. |
Requièrent généralement plus de données et peuvent converger plus lentement. En contrepartie, l’erreur modèle est plus faible, surtout en classification, car ils modélisent directement la probabilité conditionnelle sans estimer la conjointe. |
|
Complexité du modèle |
Typiquement plus complexes car ils modélisent l’ensemble de la distribution des données, y compris les interactions entre variables et étiquettes. |
Généralement plus simples car ils n’ont qu’à modéliser la frontière de décision ou l’hyperplan séparateur entre classes. |
|
Exemples de modèles |
Naive Bayes, modèles de Markov cachés (HMM), Generative Adversarial Networks (GAN), Variational Autoencoders (VAE). |
Régression logistique, Support Vector Machines (SVM), réseaux de neurones, arbres de décision. |
|
Flexibilité du modèle |
Plus flexibles en termes d’applications (peuvent traiter des tâches génératives et discriminatives). |
Moins flexibles (limités aux tâches discriminatives). |
|
Taux d’erreur |
Taux d’erreur plus élevés en classification à cause des méthodes d’estimation indirectes. |
Taux d’erreur plus faibles en classification grâce à l’entraînement direct sur la probabilité conditionnelle. |
Comme leur nom l’indique, les modèles génératifs sont particulièrement adaptés aux tâches qui consistent à générer de nouvelles données respectant les motifs présents dans les données d’entraînement.
Parmi les cas d’usage fréquents :
Pour de nombreux modèles de vision par ordinateur, disposer d’un large jeu d’images d’entraînement est essentiel. Ces modèles doivent être entraînés sur de nombreuses variantes d’une même image ou caractéristique.
Photographier un même objet sous différents angles, arrière‑plans ou nuances n’est pas toujours réaliste. Beaucoup de jeux d’images spécifiques à une tâche sont aussi limités en taille car leur création exige des compétences métiers. Par exemple, il faut mobiliser des pneumologues, des services de radiologie et des patients et hôpitaux consentants pour constituer un jeu de radiographies d’une pathologie pulmonaire donnée.
Dans ces cas, l’option la plus pragmatique consiste à créer un petit jeu très soigné et pertinent, puis à générer de façon synthétique de nouveaux points proches du jeu d’origine.
Générer de nouvelles images à partir d’une description textuelle ou générer du texte à partir d’un texte d’entrée. La seule classe de modèles capable de réaliser ces tâches est celle des modèles génératifs.
Des modèles de génération d’images comme DALL-E, MidJourney et Stable Diffusion sont régulièrement utilisés pour produire des images conformes à une description précise sans enfreindre les droits d’auteur existants.
De même, les LLM sont souvent mobilisés pour générer des intrigues de fiction, des slogans et accroches marketing, des résumés de documents, et d’autres contenus similaires.
Les modèles génératifs servent aux tâches fondées sur la distribution conjointe des données. En finance et en gestion des risques, modéliser la distribution conjointe des rendements d’actifs pour prédire le profil rendement/risque attendu d’un portefeuille est courant.
Par exemple, un gérant peut vouloir connaître la probabilité que les cours de deux actions montent ou baissent simultanément — les PDF conjointes apportent ces réponses.
Les services financiers utilisent ces méthodes statistiques bien avant que le terme « modèles génératifs » ne soit largement adopté.
Les problèmes de classification non supervisée se prêtent particulièrement aux mélanges gaussiens. Vous disposez d’un grand volume de points de données sans connaître le nombre ni la nature des catégories sous‑jacentes. Il est raisonnable de supposer que les données proviennent d’une combinaison de distributions, qu’un GMM peut modéliser.
Si le nombre et la liste des catégories étaient connus à l’avance, des méthodes discriminatives seraient plus appropriées.
Les GMM sont aussi utiles pour l’analyse d’anomalies (détection d’anomalies, de fraude, etc.), où les comportements « usuels », comme ceux de différents segments clients, peuvent être modélisés comme une combinaison de distributions. Les points anormaux sont ceux qui s’écartent nettement de l’ensemble des autres motifs.
Les problèmes impliquant des séquences sont souvent résolus à l’aide de modèles de Markov cachés. Un cas d’usage courant est la modélisation et le re‑séquençage du génome.
Les HMM sont aussi employés en reconnaissance vocale, pour prédire la syllabe suivante compte tenu des syllabes précédentes. La modélisation de séquences est également fréquente en logistique, par exemple pour planifier la livraison de colis. De même, la transmission et la propagation de maladies infectieuses sont souvent modélisées avec des chaînes de Markov.
Mathématiquement, les modèles discriminatifs s’emploient lorsque seule la probabilité conditionnelle est pertinente, et non la conjointe. Ils sont donc typiquement utilisés pour des problèmes de classification et de prédiction.
Exemples :
Problèmes de classification supervisée, où les classes (catégories) sont connues à l’avance. C’est le cas d’usage emblématique des KNN et des SVM.
Vous disposez d’un vaste ensemble de données comportementales clients : habitudes de dépense, montants d’achat, fréquence d’achat, historique de retours, etc. Vous devez classer les clients en catégories — gros dépensiers, chasseurs de bonnes affaires, réguliers, peu engagés, etc. À l’inverse, pour des problèmes non supervisés, comme évoqué plus haut, on utilisera plutôt des GMM.
En classification et régression, la priorité va souvent à la vitesse et à la précision. En principe, les modèles génératifs peuvent aussi résoudre ces problèmes.
Ils sont notamment préférés en cas de données manquantes, de jeu d’entraînement limité, ou si vous anticipez l’ajout régulier de nouvelles catégories.
Cependant, pour la plupart des cas standard, les modèles génératifs souffrent de taux d’erreur plus élevés et d’une inférence plus lente en prédiction, car leurs calculs impliquent la probabilité conjointe. Ainsi, pour des problèmes classiques de classification et de régression, lorsqu’un large jeu d’entraînement de qualité est disponible, les modèles discriminatifs sont à privilégier pour leurs meilleures performances.
Les modèles discriminatifs sont préférables lorsque l’objectif est uniquement le résultat de la classification, sans modéliser les données sous‑jacentes.
Par exemple, si vous souhaitez catégoriser des enregistrements audio par langue, vous n’avez pas besoin d’un modèle qui « comprenne » la langue et sa grammaire. Un modèle de reconnaissance vocale serait disproportionné pour une tâche de classification. Il suffit de se concentrer sur la frontière de décision avec un modèle discriminatif. Vous pouvez donc utiliser un petit réseau de neurones au lieu d’un LLM, ou une régression logistique plutôt qu’un modèle bayésien.
Les décisions multi‑étapes, où chaque étape implique des choix non ambigus, sont de bons candidats pour les arbres de décision. Ceux‑ci servent souvent de filtre préliminaire pour présélectionner les points à analyser plus finement.
Par exemple, la détection de fraude est souvent résolue par des modèles complexes comme les GMM. Les transactions à haut risque sont presque toujours examinées par des humains, quel que soit le modèle. Une autre approche consiste donc à utiliser un arbre de décision pour signaler une liste de transactions potentiellement frauduleuses en vue d’un examen manuel.
Les arbres de décision sont aussi utilisés dans de nombreux processus métier. L’objectif est de choisir la bonne action selon des conditions prédéfinies. Ces tâches ne nécessitent ni modèles génératifs ni modèles discriminatifs plus complexes comme les réseaux de neurones.
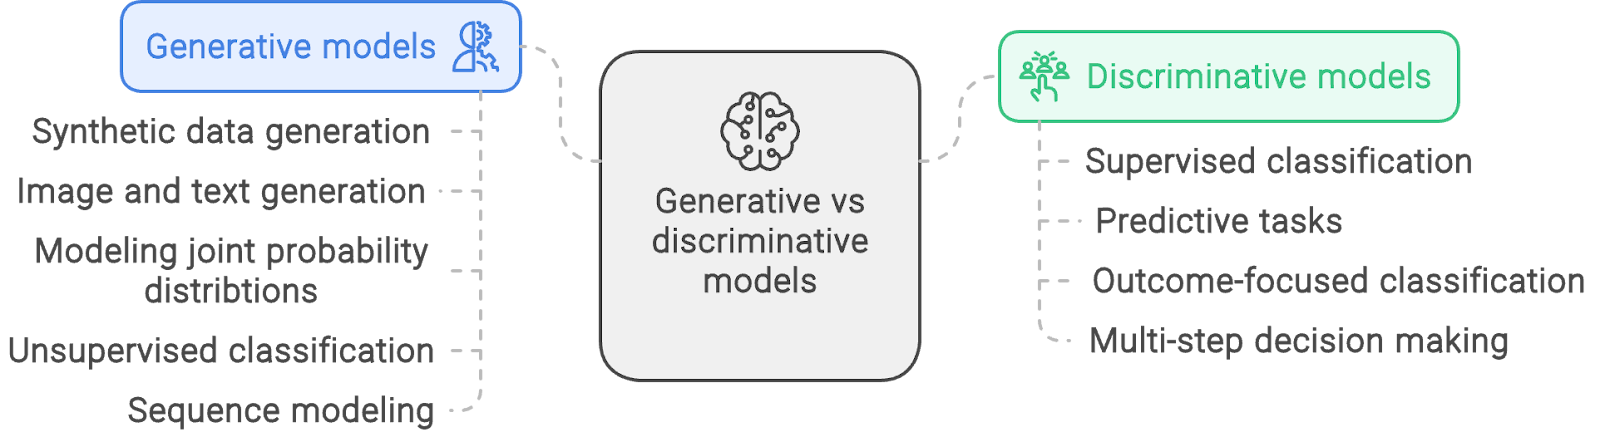
Exemples d’applications des modèles génératifs vs discriminatifs. Créé avec napkin.ai
Cet article a expliqué les principes fondamentaux et les principales différences entre les modèles génératifs et discriminatifs, les deux grandes approches des techniques d’apprentissage automatique.
Même si la plupart des méthodes de ML sont probabilistes, les modèles génératifs s’appuient sur la distribution conjointe, tandis que les modèles discriminatifs n’utilisent que des probabilités conditionnelles. Ces deux classes ont donc des applications et des performances différentes. Vu la variété des modèles disponibles, choisir le bon outil pour la tâche est essentiel.
Au‑delà d’une compréhension conceptuelle des types de modèles et de leurs différences, le plus important est de pratiquer. Commencez par le billet de blog sur les méthodes d’apprentissage supervisé et la construction d’un simple modèle de régression logistique.
Approfondissez le machine learning avec ces cours !
Cours
Cours
Cours