
为什么要使用机器学习模型?
如今,许多大型组织都在使用某种形式的预测建模来最大化收益并推动业务增长。
机器学习在不同领域有多种应用场景。例如,Netflix 和 Spotify 等订阅制平台会根据用户在应用中的行为来推荐内容。
推荐系统能为这些公司直接创造业务价值,因为更好的用户体验会提升用户继续订阅平台的可能性。这是无监督机器学习模型的一个例子。
类似地,某移动服务提供商可能利用机器学习分析用户情绪,并根据市场需求优化其产品方案。这是有监督机器学习模型的一个例子。
所有机器学习模型都可分为监督式与无监督式。两者最大的区别在于:监督式算法需要带标签的输入与输出训练数据,而无监督模型可以处理原始的、未标注的数据集。
监督式机器学习模型还可以进一步分为回归与分类算法,本文稍后将详细说明。
机器学习回归模型
回归算法用于通过自变量(x)预测连续的结果变量(y)。
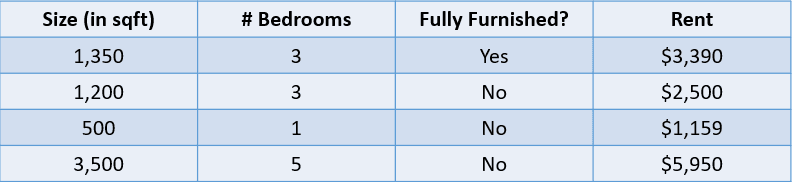
例如,请看下表:
图片由作者提供
在此示例中,我们希望根据房屋面积、卧室数量以及是否精装修来预测房租。因变量“Rent”是数值型,因此这是一个回归问题。
像上述这样拥有多个输入变量的问题称为多元回归问题。
回归评估指标
数据科学初学者常见的误解是用准确率这类指标来评估回归模型。准确率是用于评估分类模型性能的指标,本文后面将详细说明。
另一方面,回归模型通常使用 MAE(平均绝对误差)、MSE(均方误差)和 RMSE(均方根误差)等指标进行评估。
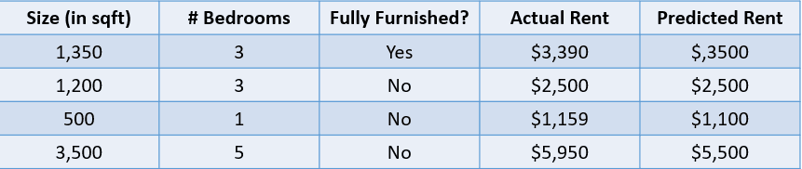
让我们为上面的房价问题加入预测值,并用几种回归指标来评估这些预测:
图片由作者提供
1. 平均绝对误差(MAE):
平均绝对误差计算所有真实值与预测值差值的绝对值之和,并除以观测总数。以下是 MAE 的计算公式:
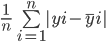
让我们用该公式计算上述数值的平均绝对误差:
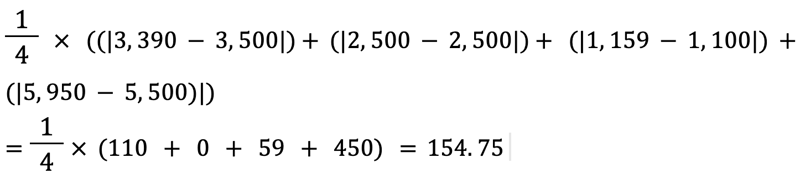
真实房价与预测房价之间的平均绝对误差约为 155 美元。
2. 均方误差(MSE):
模型的均方误差计算公式与平均绝对误差类似:
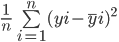
注意,平均绝对误差计算真实值与预测值之间的平均绝对距离,而均方误差计算二者之间的平均平方距离。
让我们计算上述真实值与预测值之间的 MSE:
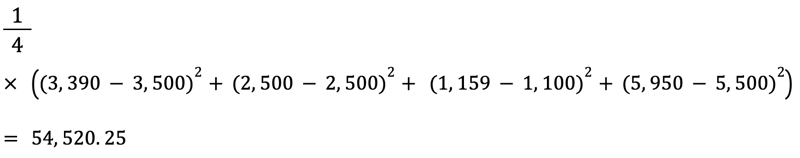
3. 均方根误差(RMSE):
估计量的 RMSE 是其均方误差的平方根。与 MSE 相比,计算 RMSE 的一个优势在于,误差以与我们所预测变量相同的单位给出。
例如,此处 RMSE 为 √54,520.25 = 233.5。该数值易于解释,因为它以房价为单位,而均方误差则不是。
现在您已理解回归的概念,让我们看看不同类型的回归模型:
简单线性回归
线性回归是一种用线性方式来建模因变量与一个或多个自变量之间关系的方法。该算法通过找到一条最能拟合数据的直线来完成建模。
下面是简单线性回归模型如何工作的直观示意:
图片由作者提供
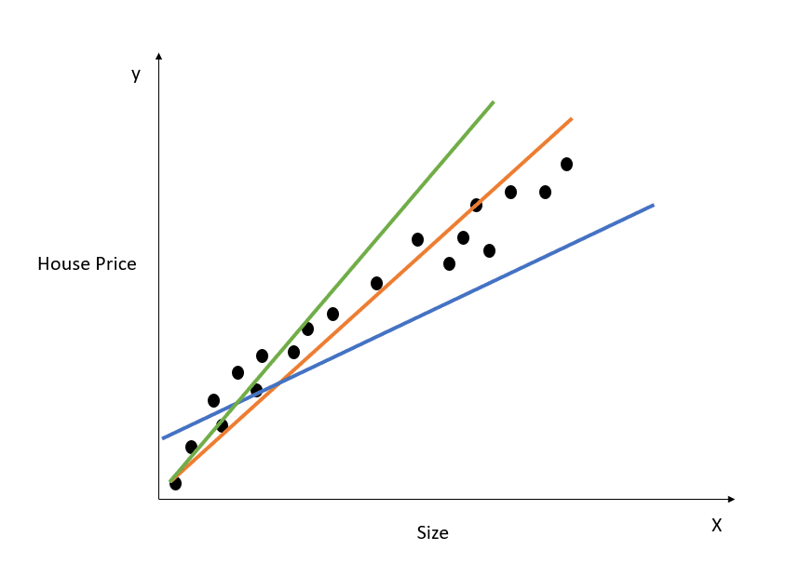
上图展示了房价与面积之间的关系。线性回归模型将拟合一条最能描述这种关系的直线。针对不同面积的房价预测将落在这条最优拟合线上。
请注意图中画了三条直线。哪一条才是“最佳拟合线”?
最佳拟合线
仅从图中观察,我们可以看到橙色的线最接近所有数据点。因此,直观上可以认为它是“最佳拟合线”。
下面是在线性回归中如何找到最佳拟合线的更正式解释:
直线的方程是 y=mx+c。其中,m 表示斜率,c 表示 y 轴截距。由于 m 和 c 有无穷多种可能取值,因此可以画出无穷多条直线。
最佳拟合线(也称最小二乘回归线)通过最小化真实值与预测值之间平方距离之和来确定:

您可以阅读 Essentials of Linear Regression in Python 教程,更深入理解线性回归模型及其实现。
岭回归(Ridge Regression)
岭回归是上述线性回归模型的扩展。该技术用于尽可能减小回归模型的系数。
简单线性回归模型的一个问题是,其系数可能会很大,从而使模型对输入更敏感,导致过拟合。
让我们用一个简单示例来理解过拟合的概念:
图片由作者提供
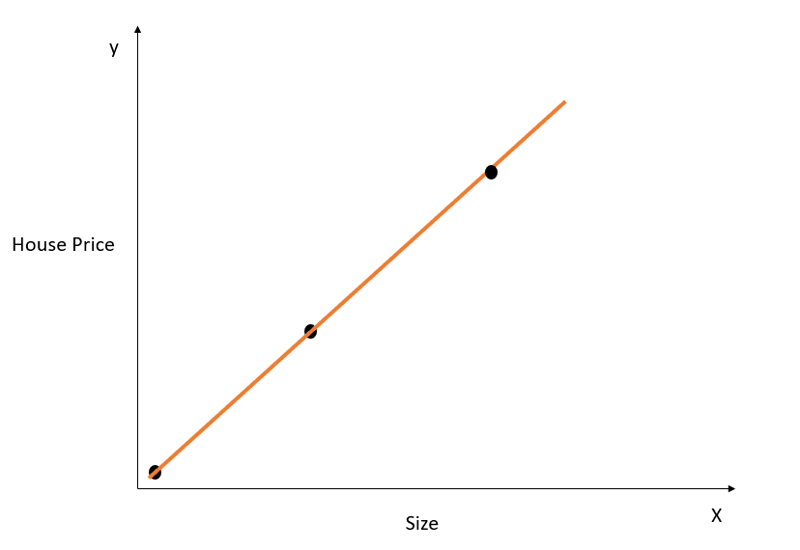
在上图中,最佳拟合线完美刻画了 X 与 y 的关系,真实值与预测值之间的平方距离之和为 0。回想该直线方程为 y=mx+c。
尽管这条直线对训练数据拟合得完美,但很可能无法很好地泛化到测试数据。这种现象称为过拟合,您可以阅读这篇关于过拟合的文章了解更多。
简单来说,过于复杂的模型会捕捉训练数据中一些并不反映真实世界的细微差异。该模型在训练数据上表现极佳,但在训练集之外的数据集上表现不佳。
具有较大系数的线性回归模型更易过拟合。
岭回归是一种正则化技术,它通过在损失函数中加入额外代价来惩罚较大的系数,从而迫使算法选择较小的系数。
如前一节所示,以下是我们希望在简单线性回归中最小化的误差:
在岭回归中,该等式会稍作改变,并在上述误差上加入一个惩罚项:
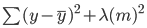
注意,这里有一个系数(lambda)与模型系数相乘。由于该模型只有一个变量,因此只有一个系数带有惩罚项;若有多个自变量,lambda 将与系数平方和相乘。
该惩罚项会惩罚模型选择较大的系数。其目的在于收缩系数值,使对结果贡献较小的变量的系数接近 0。这可以降低模型方差,帮助缓解过拟合。
岭回归中 lambda 的最优取值是什么?
可以看到,当 lambda 为 0 时不会产生任何影响,惩罚项被消除。lambda 值越大,收缩惩罚越强,模型系数越接近于 0。
选择 lambda 值时,应在模型简单性与对训练数据的良好拟合之间权衡。较大的 lambda 值会带来更简单、泛化性更强的模型,但过大又有欠拟合风险;相反,lambda 接近 0 则可能导致模型过于复杂。
Lasso 回归
Lasso 回归是线性回归的另一种扩展,通过在代价函数中加入惩罚项来收缩模型系数。
以下是 Lasso 回归中需要最小化的误差:
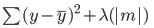
可以看到,该等式与岭回归类似,不过这里不是将 lambda 乘以系数的平方,而是乘以系数的绝对值。
岭回归与 Lasso 回归最大的区别在于:岭回归中系数会向 0 收缩,但不会真正变为 0;而在 Lasso 回归中,系数可能被收缩到 0。
如果某个自变量的系数变为 0,那么该特征可以从模型中删除。这会减少特征空间并提升算法的可解释性,这是 Lasso 回归最大的优势。
因此,Lasso 回归还可作为一种特征选择技术,因为重要性较低的变量可能会被收缩到系数为 0,并被完全移除。
如何在 Python 中构建回归模型
您可以使用 Scikit-Learn 构建线性回归、岭回归和 Lasso 回归模型:
1. 线性回归
from sklearn.linear_model import LinearRegression
lr_model = LinearRegression()在训练数据集上拟合模型:
lr_model.fit(X_train,y_train)2. 岭回归
from sklearn.linear_model import Ridge
model = Ridge(alpha=1.0)定义模型时可通过“alpha”参数配置 lambda 项。
3. Lasso 回归
from sklearn.linear_model import Lasso
model = Lasso(alpha=1.0)如果您想进一步了解线性模型及其在 Python 中的构建方式,请学习我们的 Introduction to Linear Modeling in Python 课程。
机器学习分类模型
我们使用分类算法通过自变量(x)来预测离散的结果(y)。在这种情况下,因变量总是某个类别或标签。
例如,根据风险因素预测患者是否可能患上心脏病就是一个分类问题:
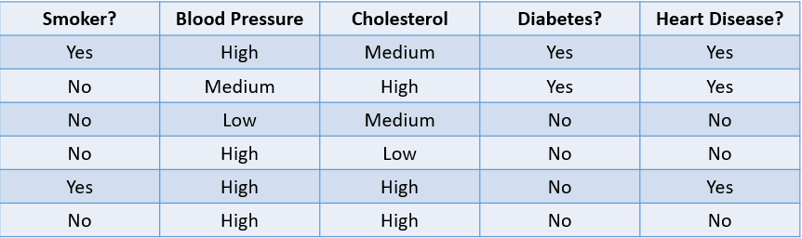
图片由作者提供
上表展示了一个包含四个自变量和一个因变量(心脏病)的分类问题。由于只有两个可能的结果(Yes 和 No),这称为二元分类问题。
其他二元分类问题的例子包括判断邮件是否为垃圾邮件、客户流失预测,以及决定是否向某人发放贷款。
多类分类问题则指具有三个或更多可能结果的任务,例如天气预报或区分不同动物物种。
分类评估指标
评估分类模型的方法有很多。尽管准确率最常用,但并不总是最可靠。
让我们基于下表来看看评估分类算法的常用方法:
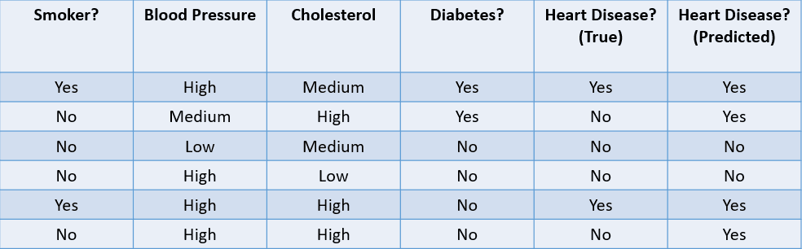
图片由作者提供
1. 准确率(Accuracy):准确率是模型做出正确预测的比例。
准确率的计算公式为:
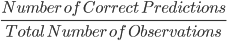
在本例中,准确率为 4/6,即 0.67。
2. 精确率(Precision):精确率用于衡量模型正类预测的质量。其定义为:
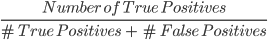
上述模型的精确率为 2/4,即 0.5。
3. 召回率(Recall):召回率用于衡量模型识别正类的能力。其定义为:
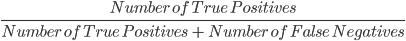
上述模型的召回率为 2/2,即 1。
让我们用一个简单示例来理解精确率与召回率的区别:
某种罕见且致命的疾病只影响少部分人群。医院数据库中 95% 的患者没有该疾病,只有 5% 有。如果我们构建一个总是预测“没人患病”的模型,其训练准确率将达到 95%。尽管准确率很高,但这并不是一个好模型,因为它无法识别出真正患病的患者。
这时就需要引入精确率与召回率等指标。精确率(又称特异性)反映模型正确识别未患病人群的能力;召回率(又称灵敏度)则反映模型识别患病人群的能力。
“良好”的精确率与召回率是相对的,取决于具体应用场景。
在该疾病预测场景中,我们总是希望找出所有患病者,即使这会带来一定的误报风险。此时我们会让模型的召回率高于精确率。
另一方面,如果我们要构建一个防止恶意行为者进入电商网站的模型,则可能更看重精确率,因为误封合法用户会导致销量下降。
我们常使用 F1-Score 来计算分类器精确率与召回率的调和平均。简单说,F1-Score 将精确率与召回率合并为一个指标,通过计算它们的平均值来反映综合表现。
AUC(曲线下面积)是另一个常用来衡量分类模型性能的指标。算法的 AUC 反映其区分正负类的能力。
若想进一步了解 AUC 等指标及其计算方法,请学习 Datacamp 的 Supervised Learning in R 课程。
接下来,我们看看不同类型的分类模型及其工作原理:
逻辑回归
逻辑回归是一种简单的分类模型,用于预测某事件发生的概率。
下面是逻辑回归模型工作方式的一个示例:
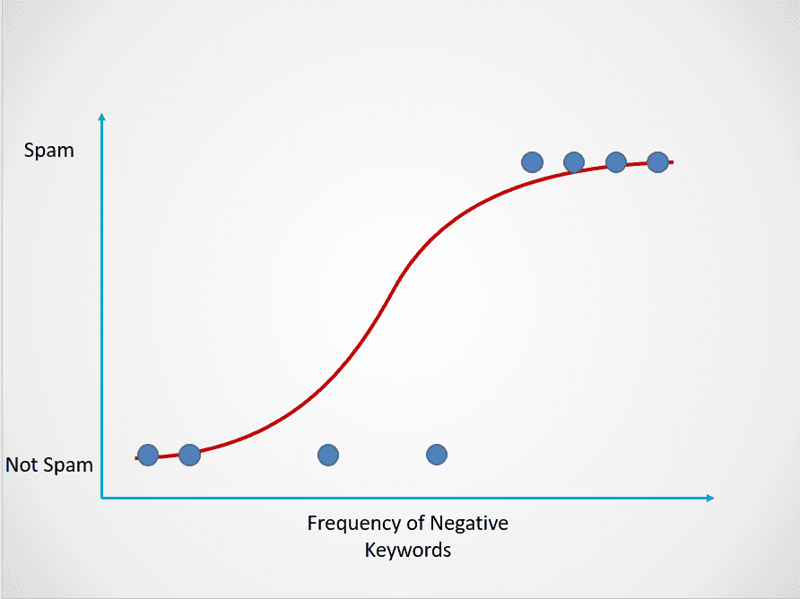
图片由作者提供
上图展示了一个将邮件数据映射为“两类”(“Spam”和“Not Spam”)的逻辑函数,依据是文本中负面关键词的出现频率。
请注意,与线性回归不同,逻辑回归通过一条 S 形曲线建模。这就是逻辑函数,其公式如下:
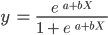
线性函数没有上下界,而逻辑函数的取值范围在 0 到 1 之间。模型输出一个介于 0 与 1 之间的概率,据此确定数据点所属的类别。
在该垃圾邮件示例中,如果文本几乎不包含可疑关键词,那么其为垃圾邮件的概率会很低,接近 0;相反,若包含许多可疑关键词,则概率会很高,接近 1。
随后,这个概率会被转化为分类结果:
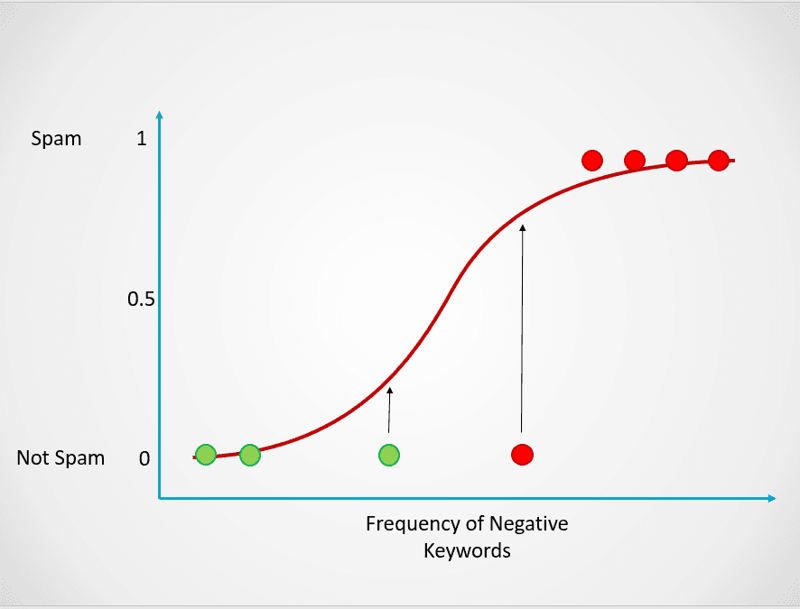
图片由作者提供
所有红色点的垃圾邮件概率均 ≥ 0.5,因此被分类为垃圾邮件,逻辑回归模型将返回分类结果 1。绿色点的垃圾邮件概率 < 0.5,被模型分类为“Not Spam”,返回分类结果 0。
对于上述二元分类问题,逻辑回归的默认阈值为 0.5,即概率大于 0.5 的数据点会被自动标注为 1。您可以根据具体场景手动调整该阈值以获得更好的表现。
回忆一下,在线性回归中,我们通过最小化预测值与真实值之间平方误差之和来找到最佳拟合线。而在逻辑回归中,系数是通过极大似然估计而非最小二乘法来估计的。
阅读Python 逻辑回归教程,了解极大似然估计的概念及逻辑回归的工作方式。
K 近邻(K-Nearest Neighbors)
KNN 是一种分类算法,它根据与待分类数据点最近的邻居所属的类别来进行分类。
下面通过一个简单示例演示 K 近邻模型的工作方式:
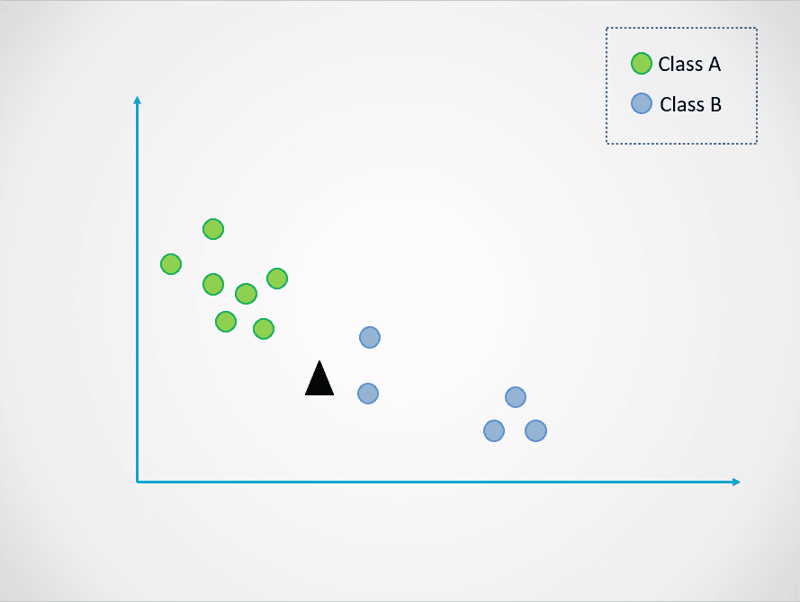
图片由作者提供
图中有两类数据点——A 与 B。黑色三角形表示一个需要被归入其中一类的新数据点。
K 近邻算法的工作流程如下:
- 步骤 1:模型首先存储所有训练数据。
- 步骤 2:随后计算新数据点与数据集中所有点之间的距离。
- 步骤 3:根据这些数据点与新点的距离进行排序。
- 步骤 4:根据“k”的取值,将新数据点分配给其最近邻居所占多数的那个类别。
在上图中,k 的取值为 1。这意味着我们只看与黑色三角形最近的一个邻居,并将该数据点分配给该邻居所属的类别。新数据点最近的是蓝色点,因此被分配到 B 类。
现在我们调整 k 的取值,试试 k=3 和 k=7:
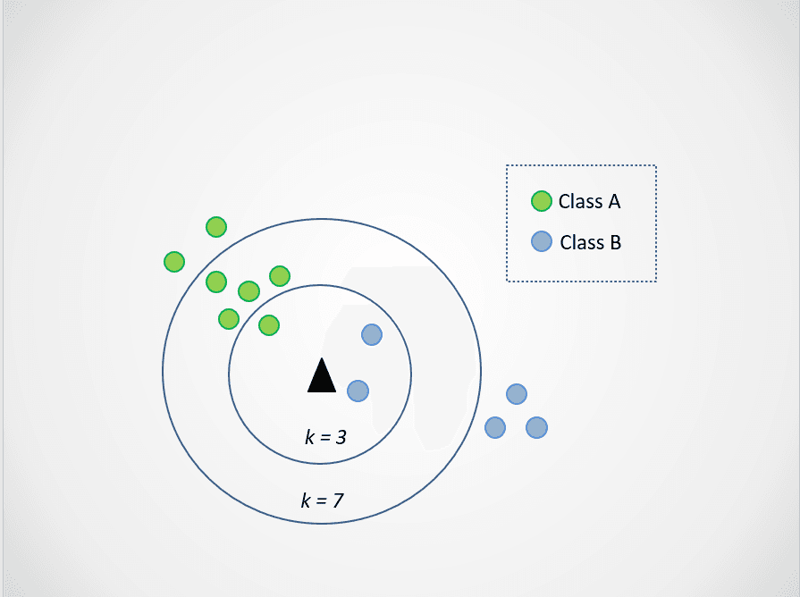
图片由作者提供
注意,当选择 k=3 时,新数据点处于两类之间。这时我们选取多数类。两个最近邻是蓝色,一个最近邻是绿色,因此数据点仍被分配到蓝色点所在的 B 类。
而当 k=7 时,情况发生变化。此时两个最近邻是蓝色,七个是绿色。在这种情况下,数据点将被分配到绿色的 A 类。
不同的 k 值会影响新点被分配到的类别。
选得过小可能会对噪声与异常值敏感;选得过大又可能忽略样本较少的类别。
如果您想进一步了解 K 近邻算法以及如何选择最优 “k” 值,请阅读这篇 KNN 教程。
在 Python 中构建分类模型
以下是一些使用 Scikit-Learn 在 Python 中构建分类模型的代码片段:
1. 逻辑回归
from sklearn.linear_model import LogisticRegression
log_reg = LogisticRegression()2. K 近邻
from sklearn.neighbors import KNeighborsClassifier
knn = KNeighborsClassifier()机器学习中的树模型
树模型是通过构建树状结构来进行预测的监督式机器学习算法,可用于分类与回归问题。
本节我们将介绍两种最常用的树模型:决策树与随机森林。
决策树
决策树是最简单的树模型。该模型通过基于特定参数不断对数据集进行划分,直至得出最终决策。
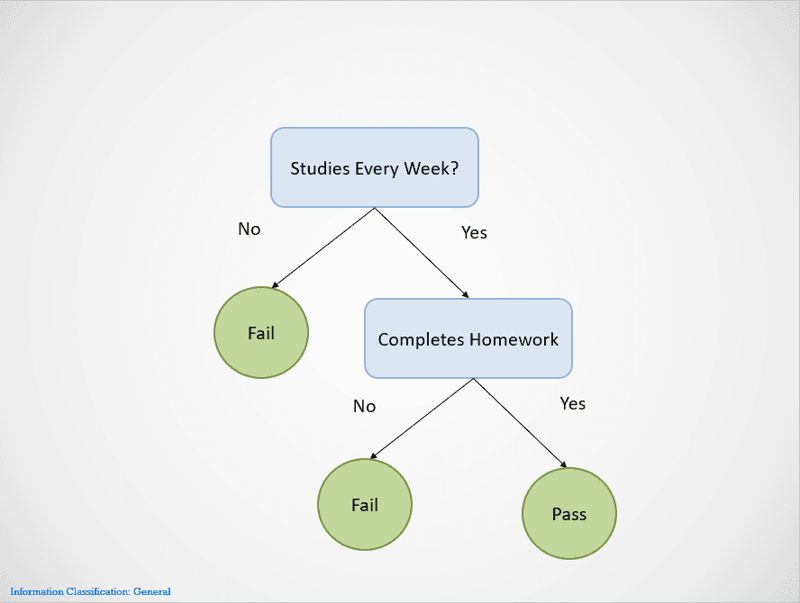
下面是一个演示决策树算法工作方式的简单示例:
图片由作者提供
决策树会在不同节点上进行划分,直到得到结果。
在该示例中,如果学生没有每周学习,则“Fail”。如果每周学习但不完成作业,结果仍然是“Fail”。只有每周学习并完成所有作业,才会“Pass”。
注意,上图的决策树首先在变量“每周学习吗?”上进行划分。如果答案是“No”,则停止划分并判定学生会不及格。
决策树首先选择在哪个变量上划分,取决于一种称为熵(entropy)的度量;当达到“纯划分”(即所有数据点都属于同一类)时停止继续划分。
构建决策树的方法有多种。树需要依次决定先、后、再之后在哪些特征上进行划分。这一结构基于信息增益(information gain)来构建。最佳决策树是信息增益最高的那棵。
若想了解关于决策树、熵与信息增益等指标的更多细节,请参阅这篇 Python 决策树分类文章。
决策树最大的优势之一是高度可解释。我们可以很容易地从结果向回推断,理解它是如何基于训练数据得出最终结论的。
不过,如果任其生长,决策树也非常容易过拟合。这是因为它会努力在训练数据上实现完美划分,从而难以很好地泛化到外部数据。
随机森林算法可以缓解决策树的这一缺点。
随机森林
随机森林是一种树模型,它能帮助我们缓解使用决策树时出现的一些问题,其中之一就是过拟合。随机森林将多个决策树模型的预测结果进行组合,并返回一个单一输出。
其流程分两步:
- 步骤 1:首先,对数据集的行与变量进行有放回的随机抽样。随后在每个数据样本上分别构建并训练多棵决策树。
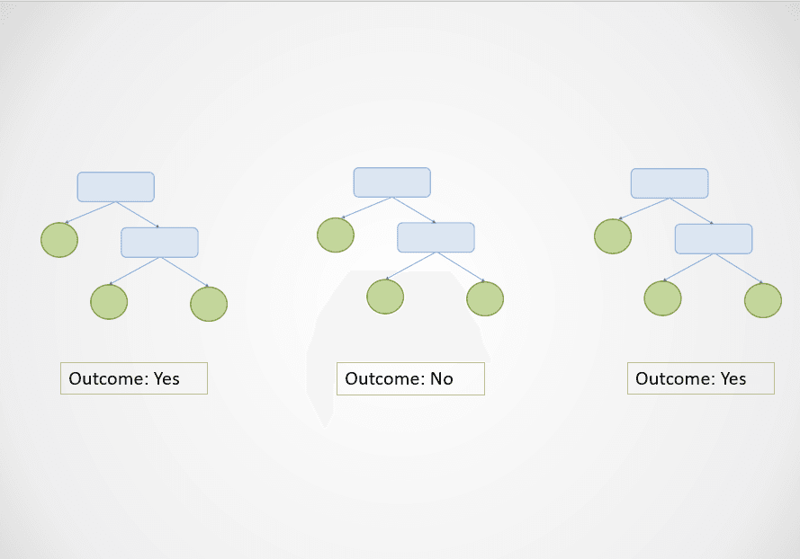
- 步骤 2:接着,将所有决策树的预测结果进行聚合,得到单一输出。例如,如果训练了 3 棵决策树,其中 2 棵预测“Yes”,1 棵预测“No”,那么随机森林的最终结果为“Yes”。
在回归问题中,最终输出为所有决策树预测值的平均。
下面是展示随机森林工作机制的简单示意图:
图片由作者提供
上图中,第一与第三棵决策树预测“Yes”,第二棵预测“No”。
由于这是分类任务,取多数类。此例中有 2/3 的树预测“Yes”,因此随机森林的最终输出为“Yes”。
随机森林的一大优势是泛化能力强,因为它融合了多棵在特征子集上训练得到的决策树的输出。
此外,单棵决策树的输出可能因训练数据的微小变化而剧烈波动,而随机森林通过多次对训练数据进行抽样,能避免该问题。
在 Python 中构建树模型
运行以下代码即可使用 Scikit-Learn 构建树模型:
1. 决策树
# classification
from sklearn.tree import DecisionTreeClassifier
clf = DecisionTreeClassifier()
# regression
from sklearn.tree import DecisionTreeRegressor
dt_reg = DecisionTreeRegressor()2. 随机森林
# classification
from sklearn.ensemble import RandomForestClassifier
rf_clf = RandomForestClassifier()
# regression
from sklearn.ensemble import RandomForestRegressor
rf_reg = RandomForestRegressor()机器学习中的聚类
到目前为止,我们已经探讨了用于解决分类与回归问题的监督式机器学习模型。接下来,我们将介绍一种常见的无监督学习方法——聚类。
通俗地说,聚类就是将相似的对象归为一组,同时与其他组区分开来。该技术有多种业务应用场景,如在视频流媒体平台上为具有相似观看偏好的用户推荐影片、异常检测以及客户细分。
本节我们将考察一种称为 K-Means 的聚类算法——它是最简单且最受欢迎的无监督学习模型之一。
K-Means 聚类
K-Means 聚类是一种无监督学习技术,用于在数据中将相似对象分组。
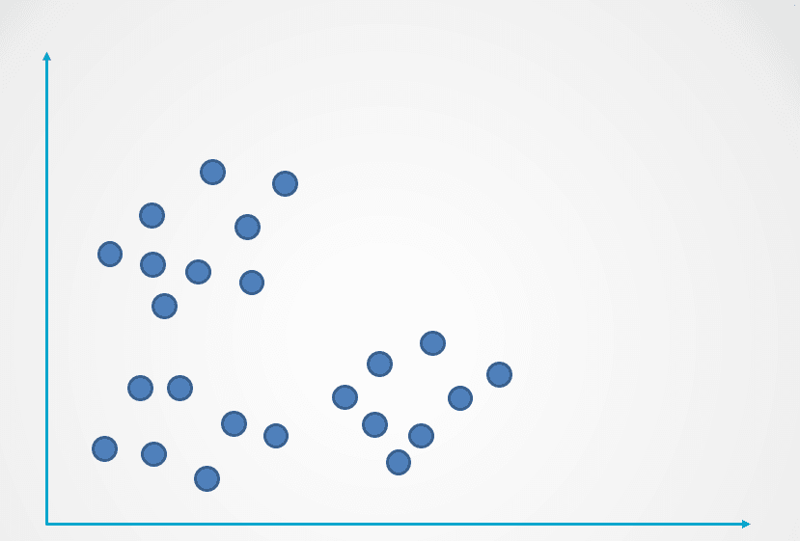
下面是 K-Means 聚类算法的工作示例:
图片由作者提供
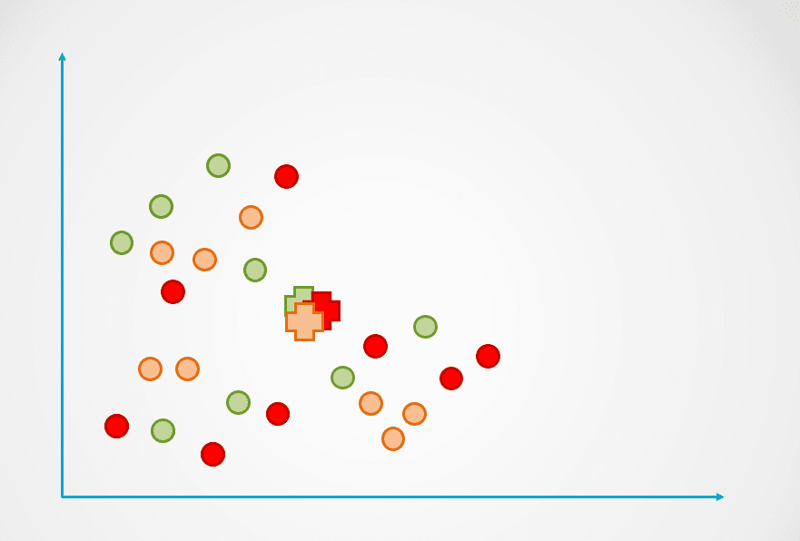
步骤 1:上图由尚未分组的无标签观测组成。初始时,每个观测会被随机分配到一个簇中,然后为每个簇计算一个质心。
图中 “+” 符号即代表这些质心:
图片由作者提供
步骤 2:接下来,计算每个数据点到各质心的距离,并将每个点分配给最近的质心:
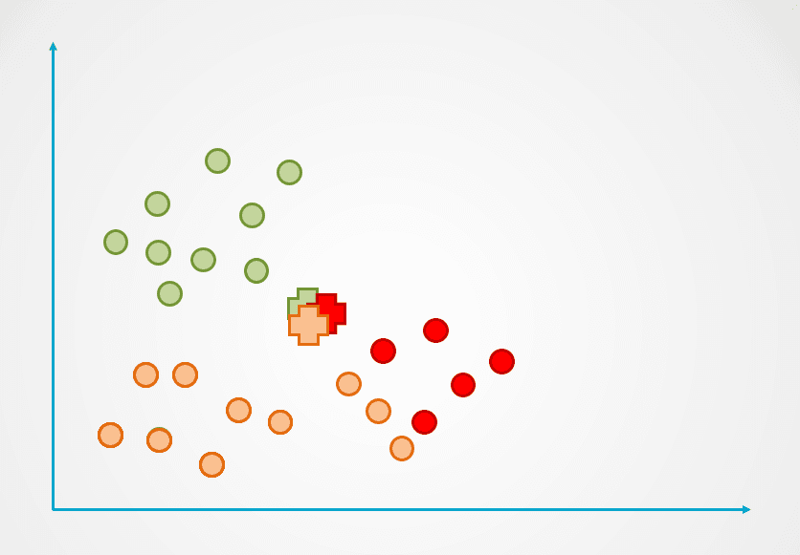
图片由作者提供
步骤 3:然后重新计算新簇的质心,并据此重新分配数据点。
步骤 4:重复该过程,直到数据点不再被重新分配:
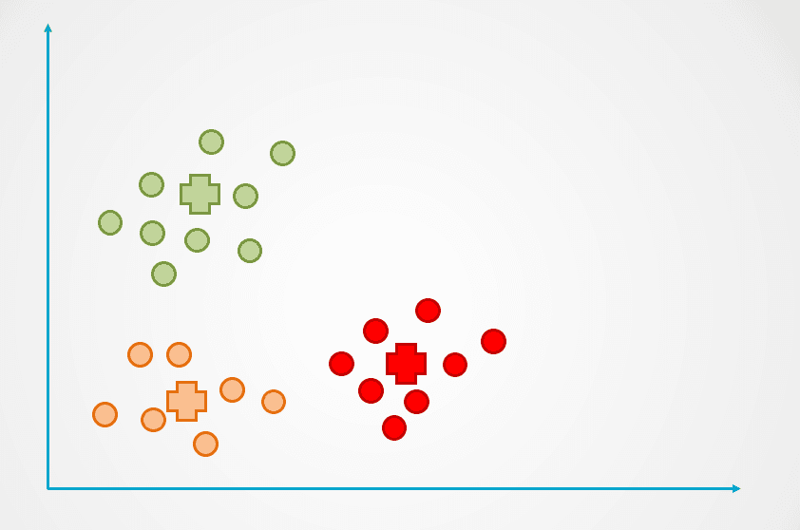
图片由作者提供
可以看到,上述示例中最终形成了三个簇。簇的数量在 K-Means 算法中记为 “k”,需要我们自行确定。
选择 K 值的方法有多种,其中最常用的是肘部法。该方法通过绘制不同簇数量下的误差曲线图,并选择曲线拐点对应的簇数作为 “k”。
在我们的 K-Means clustering in Python 教程中了解更多关于肘部法与 K-Means 聚类原理的内容。
在 Python 中构建 K-Means 聚类模型
from sklearn.cluster import KMeans
kmeans = KMeans(n_clusters = 3, init='k-means++')n_clusters 参数用于指定算法中的簇数量 “k”。
机器学习模型详解——下一步
如果您完整跟进了本文的所有内容,恭喜您!您已经了解了一些最常用的监督式与无监督式机器学习模型与算法,以及它们如何应用于各种预测建模问题。
要成为数据科学家,您需要理解不同类型的机器学习模型如何工作,并将其用于解决问题。例如,如果您希望模型可解释且计算成本低,构建决策树可能更合适;而如果目标是获得更强的泛化能力,则可以选择构建随机森林。
同时,学会评估机器学习模型也很重要。“好”的模型因场景而异并高度依赖您的用例。例如,在分类问题中,仅有高准确率并不代表模型优秀。作为数据科学家,您需要结合精确率、召回率与 F1-Score 等指标,才能更全面地评估模型表现。
如果您希望在本文所涉概念之上进一步深入理解机器学习模型,请学习 Machine Learning Scientist with Python 职业路径。该课程将讲解机器学习模型的工作原理及其在 Python 中的实现,您还将学习归一化、去相关与特征选择等数据准备技术。
机器学习模型是能够在未见过的数据集上识别模式或进行预测的算法。不同于基于规则的程序,这些模型无需显式编写规则,并且可以随着新数据进入系统而不断演进。
本文将带您了解可通过机器学习解决的不同类型问题;随后,您将认识数据科学家最常用来解决业务问题的八种机器学习算法。
读完本文后,您将熟悉这些模型背后的理论与数学直觉,并了解如何在 Python 中使用 Scikit-Learn 库来实现它们。
我们将用通俗易懂的语言解释复杂的机器学习概念。本文适合没有深厚数学或统计背景的数据科学入门者阅读。