

机器学习中的特征类型
在深入不同的特征工程技术之前,先来了解可用的特征类型。
数值特征
顾名思义,数值特征用数字表示数据,属于连续的定量变量。例如身高、年龄和薪资等。
类别特征
类别列只能包含离散特征。例如,性别列属于类别列,因为它只有少数几种类型。出生月份也是一个例子,因为取值必须在一月到十二月之间。
类别变量还可进一步分为二元与非二元。二元变量有两种可能类别,而非二元特征可以有多个类别。
文本与时间序列特征
文本列仅包含文本数据。例如零售数据集中的商品评价或商品描述列。
另一方面,时间序列特征表示随时间变化的数据,例如每周销量或一年内的股价波动。
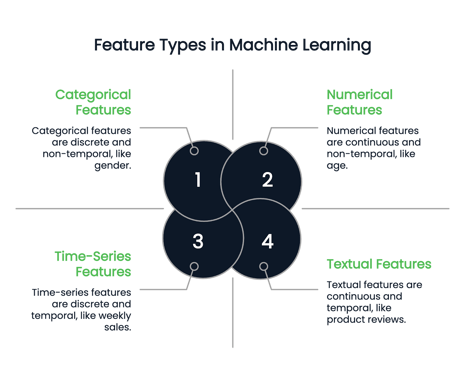
图片来源:作者
特征工程技术
特征工程提供了多种强大的技术,可将原始列转换为理想的特征。这里我们讨论一些常用方法。
处理缺失值
缺失值会扭曲模型性能,因此正确处理至关重要。主要有两种方法:
- 插补(Imputation):使用可用信息填充缺失值。例如,您可以用均值、众数或中位数替换缺失值。
- 删除(Deletion):删除含有缺失值的行。当缺失数据占数据集大小的比例小于 10% 时,该方法最为合适。
要获取处理缺失数据的深入指南,请阅读这篇《处理缺失数据的技术》教程或学习这门《用 Python 处理缺失数据》课程。
处理异常值
异常值是与其余数据点显著不同的异常数值。例如,在一个薪资数据集中,大多数观测在 $90K 到 $120K 之间,而 $400K 或 $10K 的薪资就是异常值。
- 替换:可以用该列的统计量(如最大值或最小值)替换异常值。
- 变换:应用对数或平方根等变换以降低其影响。
- 稳健模型:使用对异常值不敏感的模型。决策树、梯度提升和岭回归受异常值影响较小。
- 删除:如果以上方法都无效,最后可以从数据集中删除这些异常值。
对类别变量进行编码
机器学习模型无法直接处理类别变量,因此必须将其转换为数值表示。下面讨论几种常见的编码技术。
- 独热编码(One-hot encoding):将类别特征中的每个类别表示为单独的一列,如果样本属于该类别则取值为 1,其他列为 0。下面的示例做了说明。
考虑一个包含以下类别特征的数据集:
|
Name |
Gender |
|
John |
Male |
|
Rachel |
Female |
|
Emma |
Female |
使用独热编码,我们为 Gender 特征中的每个可能类别创建单独的列:
|
Name |
Female |
Male |
|
John |
0 |
1 |
|
Richale |
1 |
0 |
|
Emma |
1 |
0 |
由于 John 为 Male,所以“Male”列取值为1,“Female”列为0。同理,Rachel 和 Emma 为 Female,“Female”列为1,“Male”列为0。
要查看关于 Python 中独热编码的完整教程,请参阅这篇《独热编码教程》。
- 标签编码(Label encoding):为类别特征中的每个类别分配唯一的数值。该方法适用于有序数据(类别有意义的顺序),但用于无序类别变量时可能引发问题,因为模型可能会误解这些数值具有某种内在排序。
考虑一个包含类别取值的 Location 列的数据集:
|
Location |
Encoded value |
|
New York |
1 |
|
California |
2 |
|
Texas |
3 |
|
California |
2 |
|
Texas |
3 |
每个唯一的地点被分配了不同的数值。然而,由于 California(2)并不天然“介于” New York(1)与 Texas(3)之间,在无序数据上使用标签编码可能导致模型做出误导性的假设。在这种情况下,通常更倾向于使用独热编码,以避免暗示类别之间不存在的数值关系。
- 有序编码(Ordinal encoding):类似于标签编码,但专用于类别值有意义顺序的情形。它会根据类别的等级顺序进行映射,确保数值越大对应的类别等级越高。
考虑一个包含以下类别的 Education level 列:
|
Education level |
Encoded value |
|
UG (Undergraduate) |
1 |
|
PG (Postgraduate) |
2 |
|
PhD |
3 |
由于 PhD 的教育层级高于 PG,而 PG 又高于 UG,所分配的数值反映了这种排序。
- 目标编码(Target encoding):将每个类别值替换为其对应目标变量取值的平均值。目标变量是模型试图预测的因变量。该技术在处理高基数类别特征(即具有大量唯一值)时特别有用,因为它有助于在保留相关信息的同时降低维度。
考虑一个数据集,其中 Location 为类别特征,Target variable 表示某个数值结果:
|
Location |
Target variable |
|
New York |
2 |
|
California |
3 |
|
Texas |
5 |
|
California |
1 |
|
Texas |
4 |
要对 Location 列进行编码,我们计算每个唯一类别的 Target variable 的均值:
- California: (3 + 1) / 2 = 2
- Texas: (5 + 4) / 2 = 4.5
- New York: 只有一个值(2),因此仍为 2
|
Location |
Encoded value |
|
New York |
2 |
|
California |
2 |
|
Texas |
4.5 |
|
California |
2 |
|
Texas |
4.5 |
如果您在寻找处理类别数据的更全面指南,这篇《类别数据处理教程》将提供更多见解。
特征缩放
特征缩放可确保数值特征落在一个标准化范围内,防止某些特征因数值较大而主导学习过程。
依赖距离计算的机器学习模型(如线性回归、K 近邻和神经网络)在特征尺度差异很大时会受到影响。
例如,考虑一个员工数据集,包含以下特征:
- 年龄范围为 20 到 60
- 收入范围为 $30,000 到 $150,000
由于收入的数值远大于年龄,模型可能仅因其尺度更大而赋予收入更高的重要性,而不是因为它更相关。
以下是一些常用技术:
- 归一化(最小-最大缩放):将所有特征值缩放到 0 与 1 之间。对每个数据点减去该列最小值,再除以该列的范围(最大值减最小值)。公式如下:
Scaled value =( datapoint - min(column))/(max(column) - min(column))
- 标准化(Z 分数缩放):将所有特征转换为均值为 0、标准差为 1。做法是从该列的每个数据点中减去该列的均值,再将差值除以该特征的标准差。
Scaled value =( datapoint - mean(column))/(std(column))
关于归一化与标准化的详细对比,请参阅这篇《归一化 vs. 标准化指南》。
创建新特征
从现有数据中创建新的、有意义的特征,可以为模型提供更具逻辑性的洞察。
例如,在房价预测数据集中,如果您分别拥有 length 和 breadth 两列,可以派生出一个新特征:area = length * breath,它可能与目标变量 price 直接相关。将该 area 特征输入模型,有助于更容易发现潜在模式。
特征选择
特征选择通过移除不必要的列,仅保留相关特征。专注于信息量最大的特征有助于防止过拟合、降低计算复杂度并提升模型性能。常见方法包括:
- 过滤法(Filter):基于统计性质选择重要特征。例如,我们可以使用相关性热力图删除携带相同信息的特征。其他技术包括卡方检验、方差分析(ANOVA)以及信息增益方法。
- 包裹法(Wrapper):通过对不同特征子集反复训练预测模型来选择特征,并选取能优化模型性能的最佳子集。前向选择、后向选择和递归特征消除都属于此类方法。
用 Python 进行特征工程:实践示例
通过动手实现,能够更好地理解特征工程。
“房价预测”是一个大型的真实数据集,包含 81 列。我之所以选择它,是因为其中特征多样,能帮助您更好地以实操方式理解特征工程技术。
入门步骤:
- 从 Kaggle 下载数据集。
- 将其加载到 Pandas DataFrame 中进行分析与特征工程。
处理类别缺失值
以下代码识别数据集中的类别列,并用最常见的类别替换其缺失值:
import pandas as pd
# Load dataset (replace 'your_file.csv' with the actual file name)
df = pd.read_csv('your_file.csv')
# Select categorical columns
categorical_cols = df.select_dtypes(include=['object']).columns
# Replace missing values with the most frequent category (mode)
for col in categorical_cols:
mode = df[col].mode()[0] # Get the most common value
df[col].fillna(mode, inplace=True) # Fill missing values处理数值缺失值
我们通过用均值或中位数替换来处理数值型缺失值。对于统计分布较为理想的数据,均值更常用;当某列存在异常值时,中位数更合适。因此我们将检查是否存在异常值并据此决定方法。
为可视化潜在异常值,我们可以使用箱线图来识别极端值。下面是用于检测选定数值列中异常值的 Python 实现:
import pandas as pd
import matplotlib.pyplot as plt
import numpy as np
features = ['LotFrontage', 'MasVnrArea', 'GarageYrBlt']
# Plot box plots
df[features]=np.log(df[features])
df[features].boxplot(figsize=(8, 4))
plt.title('Box Plot for Outlier Detection')
plt.ylabel('Values')
plt.xticks(rotation=45)
plt.show()输出:
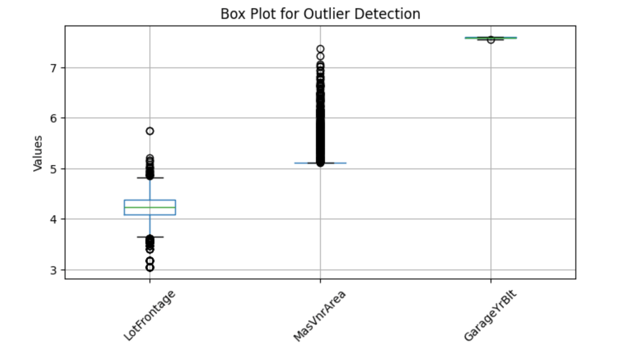
以上箱线图显示在须状线之外的点——这些即为异常值。因此,我们用中位数替换缺失值。
用中位数替换空值的代码:
import pandas as pd
# Select numerical columns
numerical_columns = df.select_dtypes(include=['number']).columns
for col in numerical_columns:
median = df[col].median()
df[col].fillna(median, inplace=True) # Replace nulls with median创建新特征
YearBuilt、YearRemodAdd、GarageYrBlt 和 YrSold 等列包含年份(如 2001、1976),这些绝对年份本身并不会直接影响目标变量。虽然它们可能不会直接影响房价,但我们可以通过计算房屋或翻修在售出时的“年限”来获得更有用的洞察。
例如,与其直接使用 YearBuilt,我们可以创建一个新特征:House Age=YrSold−YearBuilt
创建这些新特征的代码:
# Get columns that contain 'Yr' or 'Year'
year_columns = [feature for feature in numerical_columns if 'Yr' in feature or 'Year' in feature]
# Convert year values into age-related features
for col in year_columns:
df[col] = df['YrSold'] - df[col]特征变换
在机器学习中,偏态分布的数值特征会对假设正态分布的模型(如线性回归)带来负面影响。为此,我们应用对数变换。
在进行对数变换前,我们必须先识别偏态特征。但要排除包含 0 的列,因为 0 的对数未定义。
以下是用于识别偏态列的 Python 实现:
import pandas as pd
# Get numerical columns
numerical_columns = df.select_dtypes(include=['number']).columns
# Identify columns containing zeros
numerical_0s = df.loc[:, (df == 0).any()].select_dtypes(include=['number']).columns
# Remove columns that contain zeros from consideration
numerical_columns = numerical_columns.difference(numerical_0s)
# Calculate skewness for the remaining numerical columns
skewness = df[numerical_columns].skew()
# Set threshold for skewness (e.g., absolute value > 1 indicates high skewness)
skewed_columns = skewness[abs(skewness) > 1]
# Display skewed columns
print("Skewed Columns:")
print(skewed_columns)输出:
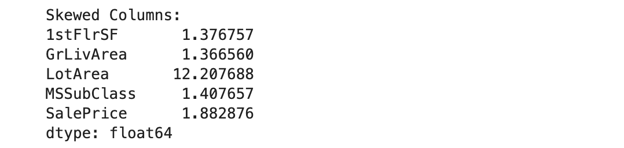
我们将使用对数正态分布将这五个偏态列转换为高斯分布:
import numpy as np
# The list of highly skewed features identified earlier
skew_features = ['LotFrontage', 'LotArea', '1stFlrSF', 'GrLivArea', 'SalePrice']
# Apply log transformation to each skewed feature
for col in skew_features:
df[col] = np.log(df[col])将类别特征转换为数值
前文我们讨论了多种编码技术;在本例中,我们将应用目标编码。
# Select categorical variables
categorical_columns = df.select_dtypes(include=['object', 'category']).columns
# Apply target encoding
for col in categorical_columns:
# Compute mean SalePrice for each category
labels_ordered = df.groupby([col])['SalePrice'].mean().sort_values().index
# Assign numerical values based on target variable mean
labels_ordered = {x: i for i, x in enumerate(labels_ordered, 0)}
# Map encoded values back to the dataframe
df[col] = df[col].map(labels_ordered)在上述代码中,目标变量为 SalePrice,因此我们按每个类别列分组并计算各组的平均 SalePrice,再将这些均值分配回该列中对应的类别取值。
我们的数据集现在已准备好用于机器学习!
如果您想强化对监督学习概念以及模型如何利用工程化特征的理解,这门《使用 Scikit-Learn 的监督学习》课程是一个极佳资源。
特征工程的工具与库
本节将介绍实现特征工程最常用的 Python 库与自动化工具。
Pandas
Pandas 是处理结构化数据使用最广泛的 Python 框架。它可执行诸多特征工程步骤,如变换、数据聚合与特征提取。Pandas 也使数据清洗与处理变得容易。
如果您是 pandas 新手,这门《使用 pandas 进行数据处理》课程是很好的起点。
Scikit-Learn
Scikit-learn 是功能强大的机器学习库,提供多种特征工程工具。它包含将类别变量转换为数值变量的方法,如 OneHotEncoder 和 LabelEncoder。它也提供特征缩放方法,如 StandardScaler 和 Minmaxscaler。
Feature-Engine
Feature-engine 是一个开源的 Python 库,提供多种变换器以简化特征工程。这些变换器是面向特定任务的专用工具,如缺失数据插补、异常值处理、特征选择与离散化。它与 scikit-learn 完全兼容,可作为超参数调优的输入组件。
自动化特征工程工具
- Featuretools:Featuretools 是一个用于自动化特征工程的开源库。该框架主要用于从关系型数据库创建新特征。它依赖 DFS(Deep Feature Synthesis,深度特征合成)算法,基于变换与聚合操作构建新特征。
- TSFresh:TSFresh,即基于可扩展假设检验的时间序列特征提取,专为从时间序列数据中提取有意义特征而设计。该库通过进行假设检验来选择对预测具有统计显著性的特征。
- Autofeat:这个 Autofeat 库自动化特征选择、创建与变换,以提升线性模型精度。例如,该库提供
fit_transform()方法来替代fit(),可同时在输入数据上执行拟合与变换操作。此外,还提供FeatureSelector与AutoFeatLight模型用于特征选择与缩放。
特征工程最佳实践
要高效实施特征工程,请关注以下最佳实践。
了解您的数据
理解每个特征的含义与重要性,将大大简化特征选择或提取等技术的实施。我建议您对数据及相关领域知识进行研究,以便更有效地进行特征工程。
开展探索性数据分析(EDA)
使用 Pandas 与 Matplotlib 等 Python 库开展全面的探索性数据分析,包括统计信息、可视化与相关性分析,以发现数据中的模式与潜在关系。
创建交互特征
创建交互特征涉及识别现有特征之间的关系并据此派生新特征。例如,在房价预测中,通过用当前年份减去建造年份计算房屋年龄,可揭示诸如“随着时间推移房价下降”等趋势。
提前选定模型
不同的机器学习模型需要不同的特征工程步骤。例如,线性或多元回归、SVM 和 KNN 等模型通常受益于特征标准化,而该技术对基于树的模型帮助不大。
因此,提前决定您的模型,有助于为您的用例构建高效的特征工程流水线。
结语
特征工程是构建机器学习解决方案不可或缺的一部分,使您能够以最高效的方式利用特征。数据科学家或机器学习工程师在处理任何数据集时都会开展这一过程。如果您是数据从业者或正在朝这个方向努力,掌握本文提及的所有技术将有助于推动您的职业发展!
若想更深入地探索这些技术,欢迎查看 DataCamp 的《面向机器学习的特征工程》与《面向 NLP 的特征工程》课程。R 语言程序员也可学习《R 语言特征工程》课程。
FAQs
特征工程与特征选择有何不同?
特征工程涉及创建新特征或转换现有特征以提升模型性能。另一方面,特征选择是指选择最相关的特征并舍弃不相关或冗余特征,以防止过拟合并降低模型复杂度。
特征工程可以自动化吗?
可以!诸如 FeatureTools、Auto-sklearn、H2O.ai 等 AutoML 库,以及 Google 的 AutoML Tables 等自动化特征工程工具,能够自动创建和转换特征,从而节省时间与精力。不过,领域知识对于解读与选择最佳特征仍然至关重要。
特征工程如何影响模型可解释性?
特征工程对可解释性的影响取决于所用技术,既可能提升也可能降低。例如:
- 创建有意义的特征(例如用“House Age”替代“YearBuilt”)能提升可解释性。
- 应用 PCA(主成分分析)等变换可能降低可解释性,但能提升模型性能。
特征工程是否取决于机器学习模型的类型?
会的!不同模型受益于不同的特征工程技术:
- 线性模型(如线性回归、逻辑回归)——需要特征缩放,且常常受益于多项式特征变换。
- 基于树的模型(如决策树、随机森林、XGBoost)——可良好处理未缩放的数据,通常更受益于特征选择而非变换。
- 深度学习模型——偏好原始特征,且嵌入层等变换有助于处理类别数据。
什么是特征交叉,何时应使用?
特征交叉是将两个或多个特征组合,创建能捕捉它们交互的新特征的过程。示例:
- 与其分别使用“Age”和“Income”,不如创建“收入与年龄比(Income-to-Age Ratio)”,以捕捉不同年龄段的财务稳定性。
- 当变量之间的关系以非线性方式影响目标变量时,可使用特征交叉。
如何评估某个特征是否提升了模型性能?
您可以通过以下方法评估特征是否提升模型性能:
- 置换重要性(Permutation Importance)——衡量对特征进行洗牌对模型准确率的影响。
- 基于树模型的特征重要性——许多模型(如随机森林)提供内置的特征重要性评分。
- 交叉验证性能——比较包含与不包含某特征时的模型准确率。
什么是交互特征工程?
交互特征工程是基于现有特征之间的交互创建新特征。这可以包括:
- 乘积(乘法特征):组合两个特征(例如“Height × Weight”用于 BMI)。
- 比率:用一个特征除以另一个(例如“每平方英尺价格”)。
- 多项式特征:将特征进行幂次变换(例如“Age²”用于非线性关系)。
如何处理高基数的类别变量?
对于具有大量唯一值的类别变量(如邮编、用户 ID):
- 目标编码:用目标变量的均值替换类别。
- 嵌入层(用于深度学习):学习类别的低维表示。
- 哈希编码:使用哈希函数将类别分配到桶中。

Srujana 是一名自由职业技术写作者,拥有计算机科学四年制学位。她擅长撰写各类主题的内容,包括数据科学、云计算、开发、编程、安全等众多领域。她热爱经典文学,也喜欢探索新的旅行目的地。
特征工程的核心是选择或创建能提升模型性能的关键特征。无论使用何种机器学习算法,您很可能都要依赖特征工程技术来完成数据准备。
本文将探讨特征工程及其方法,并通过一个动手实践的房价预测示例来理解如何应用这些方法。
什么是机器学习中的特征工程?
我还记得曾在工作中为一项时效运输项目构建模型,以提升准时交付率。我们没有训练复杂的集成模型,而是使用了简单的回归算法,并从现有数据中提取了三个额外特征。
仅凭这一做法,我们就把准时交付率从 48% 提高到了 56%。考虑到数据量有一千万条,这是一项巨大的提升。这正是特征工程(如特征提取)能带来的差异!
简单来说,特征工程就是从现有数据中选择合适的特征。
以一个包含温度、地点、月份、年份和日期等列的天气数据集为例。由于月份列已经提供了季节性信息,日期列可能对捕捉季节趋势并无显著价值。删除日期列可以在不影响天气预测准确性的情况下,降低数据集的维度。