
Corso
La verifica delle ipotesi è una parte fondamentale della statistica che ti aiuta a prendere decisioni informate in un'ampia gamma di campi: dalla medicina all'economia fino alle scienze sociali. Questa guida ti accompagnerà attraverso i concetti chiave, i tipi, i passaggi e le applicazioni reali della verifica delle ipotesi, così da interpretare e presentare con sicurezza i tuoi risultati statistici.
Se sei pronto a saperne di più sulla verifica delle ipotesi, scegli il corso che corrisponde alla tua tecnologia preferita: Hypothesis Testing in Python, Hypothesis Testing in R o Introduction to Statistics in Google Sheets. Segui anche il corso Introduction to Statistics, che è agnostico rispetto alla tecnologia.
Che cos'è la verifica delle ipotesi?
La verifica delle ipotesi è una procedura statistica utilizzata per testare assunzioni o ipotesi su un parametro di popolazione. Comporta la formulazione di un'ipotesi nulla (H0) e di un'ipotesi alternativa (Ha), la raccolta dei dati e la valutazione se l'evidenza sia sufficientemente forte da rifiutare l'ipotesi nulla.
Lo scopo principale della verifica delle ipotesi è trarre inferenze su una popolazione basandosi su un campione di dati. Consente a ricercatori e analisti di quantificare la probabilità che le differenze o le relazioni osservate nei dati siano avvenute per caso, piuttosto che riflettere un effetto reale nella popolazione.
Passaggi della verifica delle ipotesi
Vediamo come eseguire un test d'ipotesi, un passo alla volta.
Passaggio 1: Definisci le tue ipotesi
Il primo passo è trasformare la tua domanda di ricerca in due ipotesi contrapposte:
- Ipotesi nulla (H0): l'assunzione di default che non ci sia alcun effetto o differenza.
- Ipotesi alternativa (Ha): l'ipotesi secondo cui esiste un effetto o una differenza.
Per esempio:
- H0: L'altezza media degli uomini è uguale all'altezza media delle donne.
- Ha: L'altezza media degli uomini non è uguale all'altezza media delle donne.
Passaggio 2: Raccogli e prepara i dati
Raccogli i dati tramite esperimenti, sondaggi o studi osservazionali. Assicurati che il metodo di raccolta sia progettato per testare l'ipotesi ed è rappresentativo della popolazione. Questo passaggio spesso include:
- Definire la popolazione di interesse.
- Selezionare un metodo di campionamento appropriato.
- Determinare la dimensione del campione.
- Raccogliere e organizzare i dati.
Passaggio 3: Scegli il test statistico appropriato
Seleziona un test statistico in base al tipo di dati e all'ipotesi. La scelta dipende da fattori come:
- Tipo di dato (continuo, categorico, ecc.)
- Distribuzione dei dati (normale, non normale)
- Dimensione del campione
- Numero di gruppi confrontati
Tra i test più comuni troviamo:
-
t-test (per confrontare le medie)
-
test chi-quadro (per dati categorici)
-
ANOVA (per confrontare le medie di più gruppi)
Passaggio 4: Calcola la statistica del test e il p-value
Usa software statistici o formule per calcolare la statistica del test e il p-value corrispondente. Questo passaggio quantifica quanto i dati campionari si discostano dall'ipotesi nulla.
Il p-value è un concetto importante nella verifica delle ipotesi. Rappresenta la probabilità di osservare risultati estremi quanto quelli del campione, assumendo vera l'ipotesi nulla.
Passaggio 5: Prendi una decisione
Confronta il p-value con il livello di significatività (α), in genere fissato a 0,05. La regola decisionale è la seguente:
- Se p-value ≤ α: rifiuta l'ipotesi nulla, suggerendo che l'evidenza supporta l'ipotesi alternativa.
- Se p-value > α: non rifiutare l'ipotesi nulla, indicando che l'evidenza a supporto dell'ipotesi alternativa è insufficiente.
È importante notare che non rifiutare l'ipotesi nulla non significa dimostrarne la verità; indica solo che non ci sono prove sufficienti per concludere il contrario.
Passaggio 6: Presenta i tuoi risultati
Riporta i risultati, inclusi la statistica del test, il p-value e la conclusione. Discuti se i risultati supportano l'ipotesi iniziale e le loro implicazioni. Quando presenti i risultati, considera di:
- Fornire il contesto dello studio.
- Indicare chiaramente le ipotesi.
- Riportare la statistica del test e il p-value.
- Interpretare i risultati in linguaggio semplice.
- Discutere la significatività pratica dei risultati.
Tipi di test d'ipotesi
I test d'ipotesi possono essere ampiamente suddivisi in due categorie principali:
Test parametrici
I test parametrici assumono che i dati seguano una specifica distribuzione di probabilità, tipicamente la normale. Questi test sono in genere più potenti quando le assunzioni sono rispettate. Tra i test parametrici più comuni ci sono:
- t-test (a un campione, campioni indipendenti, campioni appaiati)
- ANOVA (a una via, a due vie, misure ripetute)
- Z-test (a un campione, a due campioni)
- F-test (a una via, a due vie)
Test non parametrici
I test non parametrici non assumono una distribuzione specifica dei dati. Sono utili quando si lavora con dati ordinali o quando le assunzioni dei test parametrici sono violate. Esempi includono:
- Test di Mann-Whitney U
- Test dei ranghi con segno di Wilcoxon
- Test di Kruskal-Wallis
Selezionare il test appropriato
Quando si sceglie un test d'ipotesi, i ricercatori considerano alcune categorie generali:
- Distribuzione dei dati: verifica se i tuoi dati sono normalmente distribuiti, poiché molti test assumono la normalità.
- Numero di gruppi: identifica quanti gruppi stai confrontando (ad es., un gruppo, due gruppi o più).
- Indipendenza dei gruppi: stabilisci se i tuoi gruppi sono indipendenti (soggetti diversi) o dipendenti (stessi soggetti misurati più volte).
- Tipo di dato:
- Continuo (ad es., altezza, peso),
- Ordinale (ad es., graduatorie),
- Nominale (ad es., categorie senza ordine).
In base a queste categorie, puoi selezionare il test statistico appropriato. Per esempio, se i tuoi dati sono normalmente distribuiti e hai due gruppi indipendenti con dati continui, useresti un t-test per campioni indipendenti. Se i tuoi dati non sono normalmente distribuiti con due gruppi indipendenti e dati ordinali, è consigliato un test di Mann-Whitney U.
Per aiutarti a scegliere il test appropriato, considera di usare un diagramma di flusso dei test d'ipotesi come guida generale:
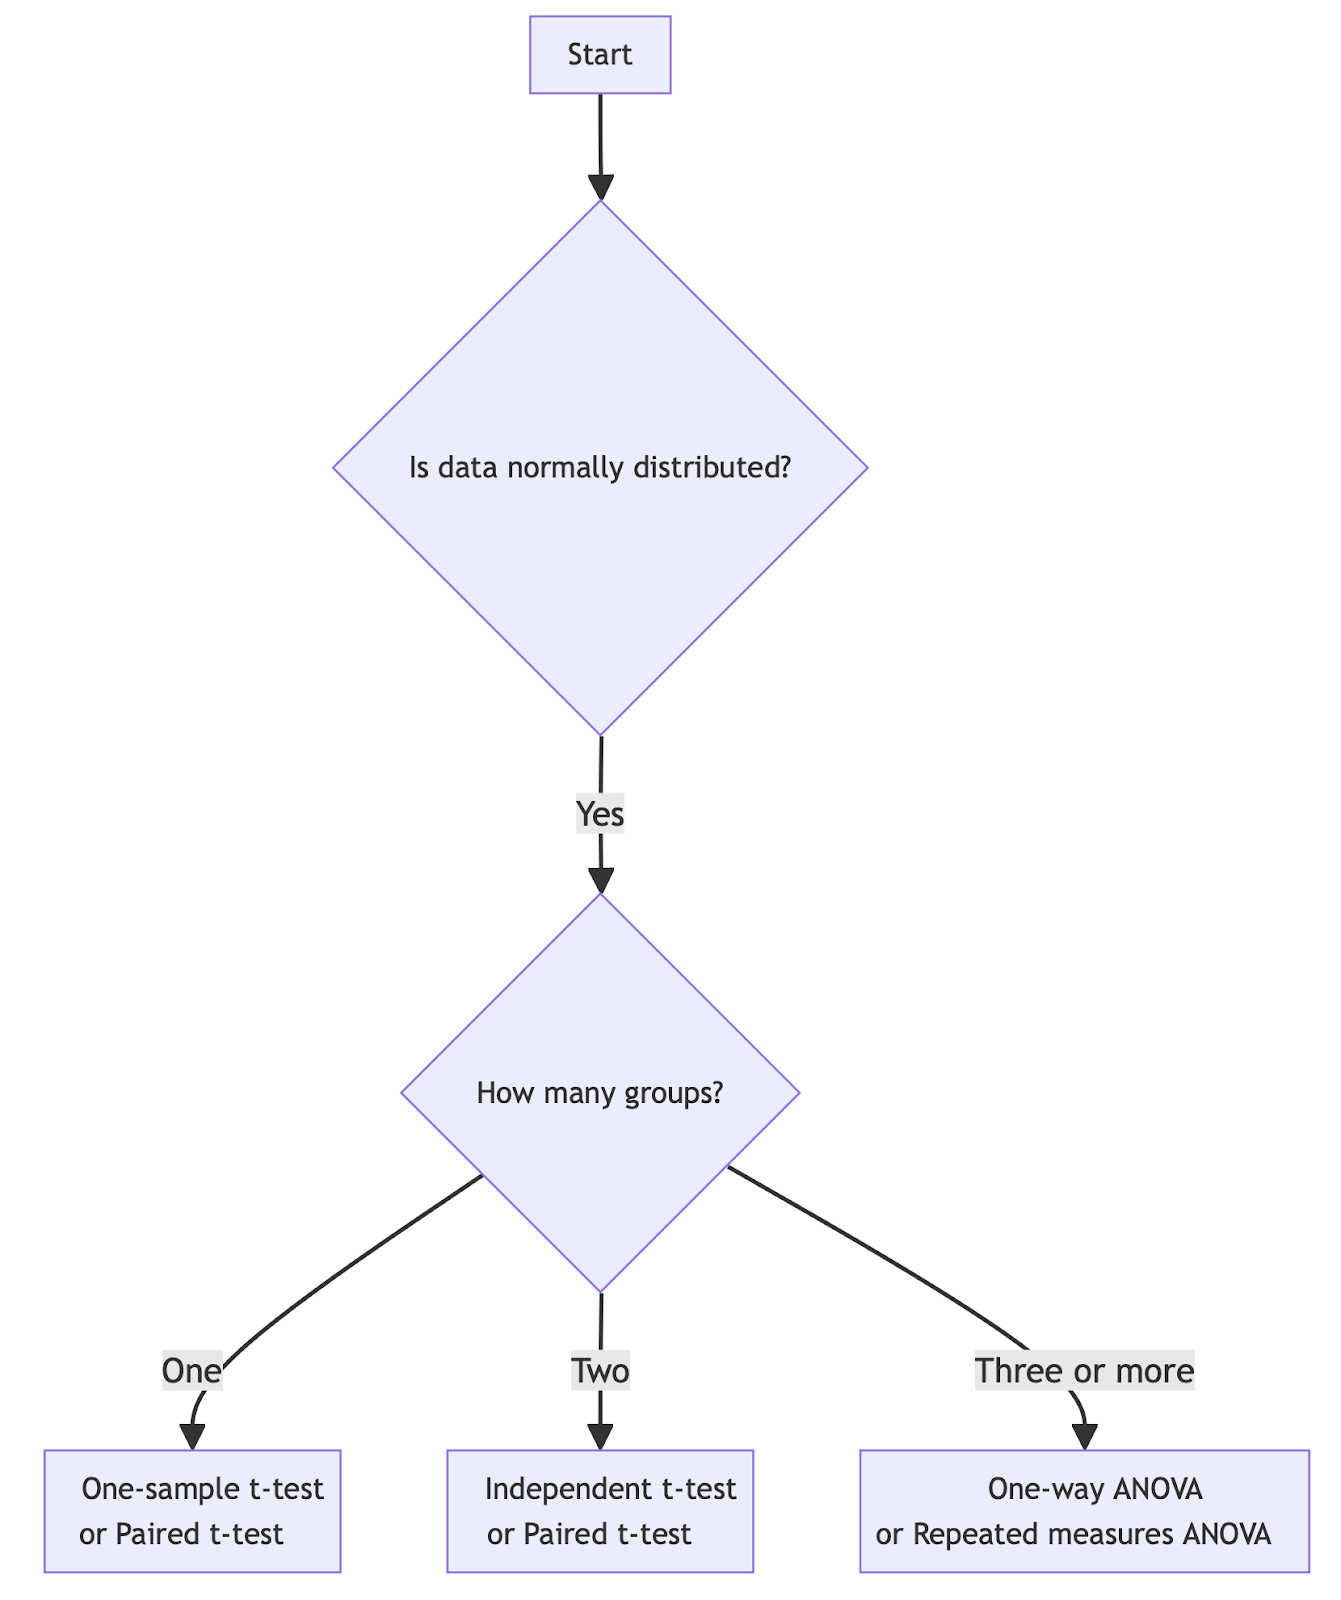
Scelta del test d'ipotesi giusto per dati normalmente distribuiti. Immagine dell'autore.
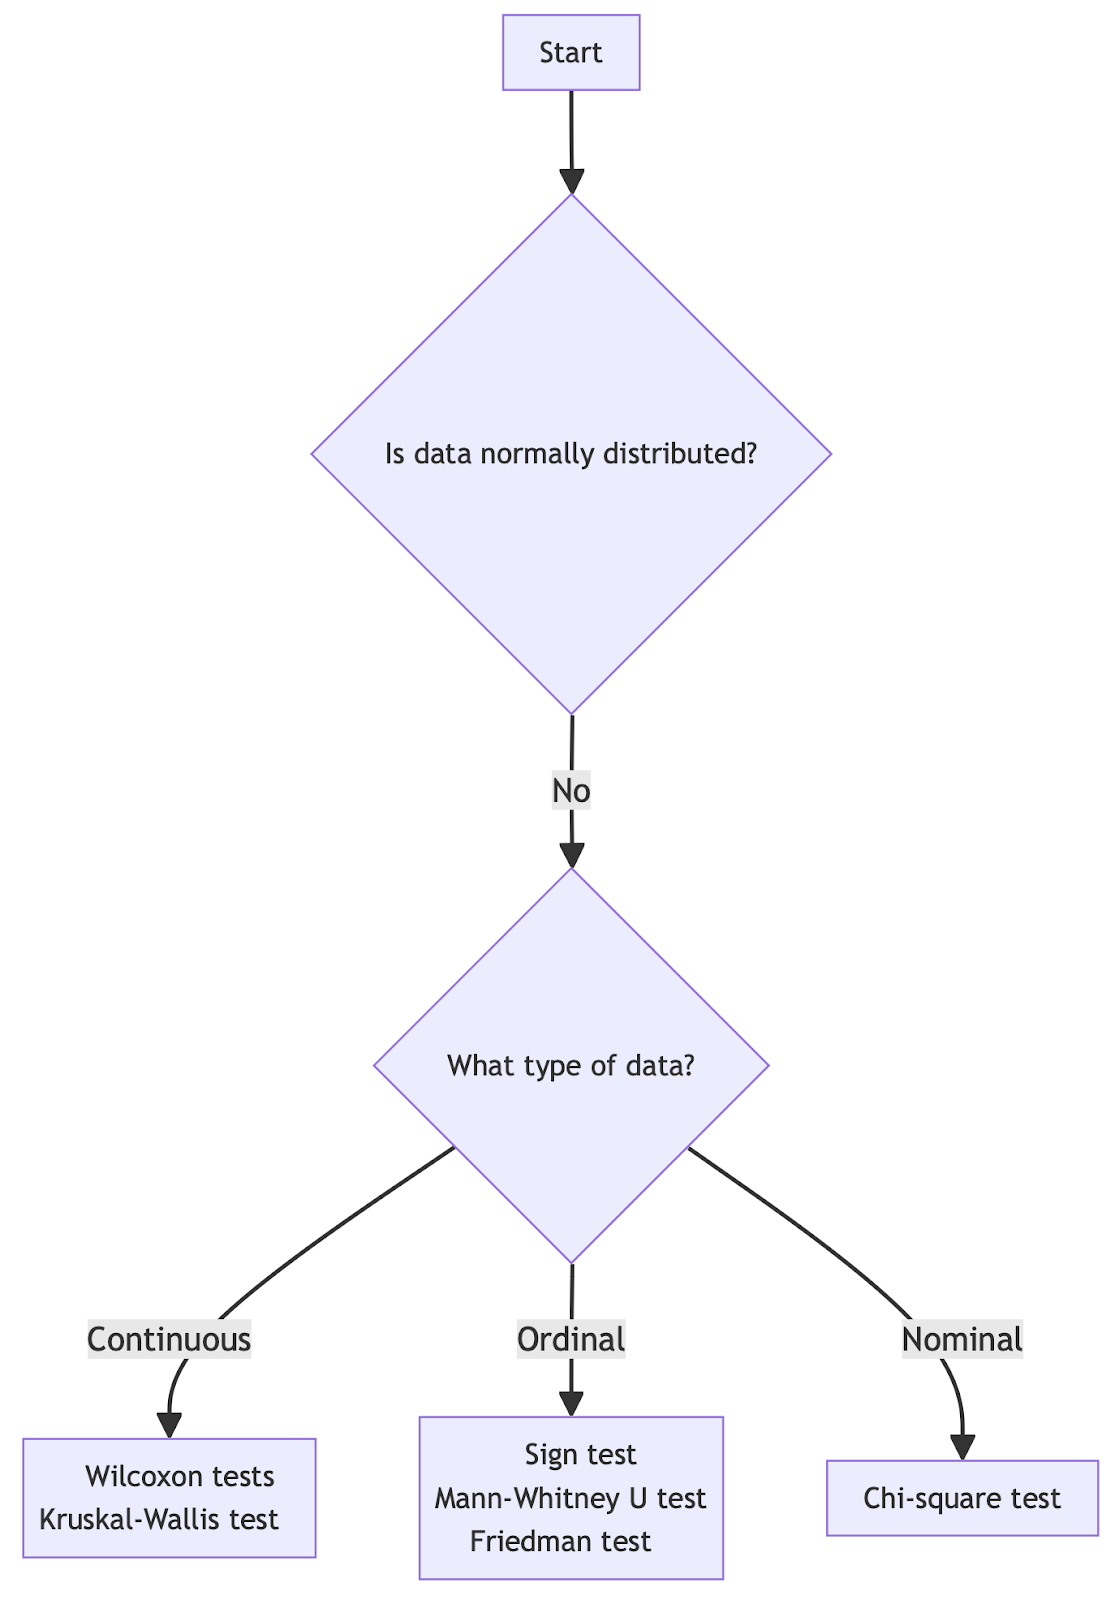
Scelta del test d'ipotesi giusto per dati non normalmente distribuiti. Immagine dell'autore.
Approcci moderni alla verifica delle ipotesi
Oltre ai metodi tradizionali di verifica delle ipotesi, esistono diversi approcci moderni:
Test di permutazione o randomizzazione
Questi test prevedono il rimescolamento casuale dei dati osservati molte volte per creare una distribuzione degli esiti possibili sotto l'ipotesi nulla. Sono particolarmente utili con campioni di piccole dimensioni o quando le assunzioni dei test parametrici non sono rispettate.
Bootstrapping
Il bootstrapping è una tecnica di ricampionamento che consiste nel campionare ripetutamente con reinserimento dal dataset originale. Può essere usata per stimare la distribuzione campionaria di una statistica e costruire intervalli di confidenza.
Simulazione Monte Carlo
I metodi Monte Carlo utilizzano campionamento casuale ripetuto per ottenere risultati numerici. Nella verifica delle ipotesi, possono essere usati per stimare p-value per modelli statistici complessi o quando è difficile ottenere soluzioni analitiche.
Controllare gli errori
Quando conduci test d'ipotesi, è bene comprendere e controllare i potenziali errori:
Errori di Tipo I e Tipo II
- Errore di Tipo I: rifiutare l'ipotesi nulla quando è in realtà vera (falso positivo).
- Errore di Tipo II: non rifiutare l'ipotesi nulla quando è in realtà falsa (falso negativo).
Il livello di significatività (α) controlla direttamente la probabilità di un errore di Tipo I. Ridurre α diminuisce la probabilità di errori di Tipo I ma aumenta il rischio di errori di Tipo II.
Per bilanciare questi errori:
- Regola il livello di significatività in base alle conseguenze di ciascun tipo di errore.
- Aumenta la dimensione del campione per migliorare la potenza del test.
- Usa test unilaterali quando appropriato.
Il file drawer effect
Il file drawer effect si riferisce al bias di pubblicazione per cui gli studi con risultati significativi hanno maggiori probabilità di essere pubblicati rispetto a quelli con risultati non significativi. Questo può portare a una sovrastima degli effetti in letteratura. Per mitigarlo:
- Prendi in considerazione la preregistrazione degli studi.
- Pubblica tutti i risultati, significativi o meno.
- Conduci meta-analisi che tengano conto del bias di pubblicazione.
- Simula i dati in anticipo.
Glossario di termini chiave e definizioni
- Ipotesi nulla (H0): l'assunzione di default che non ci sia alcun effetto o differenza.
- Ipotesi alternativa (Ha): l'ipotesi secondo cui esiste un effetto o una differenza.
- P-value: la probabilità di osservare i risultati del test sotto l'ipotesi nulla.
- Livello di significatività (α): la soglia per rifiutare l'ipotesi nulla, comunemente fissata a 0,05.
- Statistica del test: un valore standardizzato usato per confrontare i dati osservati con l'ipotesi nulla.
- Errore di Tipo I: rifiutare un'ipotesi nulla vera (falso positivo).
- Errore di Tipo II: non rifiutare un'ipotesi nulla falsa (falso negativo).
- Potenza statistica: la probabilità di rifiutare correttamente un'ipotesi nulla falsa.
- Intervallo di confidenza: un intervallo di valori che probabilmente contiene il vero parametro di popolazione.
- Dimensione dell'effetto: una misura dell'entità della differenza o della relazione in esame.
Conclusione
Ricorda che la verifica delle ipotesi è solo una parte della cassetta degli attrezzi dell'inferenza statistica. Considera sempre la significatività pratica dei tuoi risultati, non solo quella statistica. Con l'esperienza, svilupperai la capacità di capire quando e come applicare queste tecniche in vari scenari reali.
Per approfondire le tue competenze statistiche, potresti esplorare temi come How to Become a Statistician in 2024, che offre spunti sull'evoluzione del campo e sulle competenze necessarie per avere successo. Inoltre, esercitarti con le Top 35 Statistics Interview Questions and Answers for 2024 e seguire il nostro corso Practicing Statistics Interview Questions in R può aiutarti a affinare le tue abilità e prepararti ai colloqui.
Vinod Chugani ha iniziato la sua carriera a Tokyo come il più giovane Head dell'Hedge Fund Sales Desk di JPMorgan e in seguito ha stabilito un record personale di vendite a Lehman Brothers, poi ha costruito un'attività di distribuzione di elettronica in 30 paesi superando i 100 milioni di SG$ di fatturato prima di passare ai dati. Laureato in Economia alla Duke e diplomato alla NYC Data Science Academy, è stato uno dei tre beneficiari di borsa di studio su oltre 100 candidati per il corso Building AI Applications di Hugo Bowne-Anderson su Maven. Oggi scrive per DataCamp, KDnuggets, Machine Learning Mastery e Statology su argomenti che vanno dalla statistica all'AI agentica, e fa da mentor a professionisti dei dati alla NYC Data Science Academy con oltre 1.000 sessioni one-to-one all'attivo.
Domande frequenti
Perché è importante controllare l'ambiente quando si conduce un test d'ipotesi?
Controllare l'ambiente durante un test d'ipotesi riduce al minimo le variabili esterne che potrebbero influenzare i risultati. Questo controllo assicura che eventuali effetti osservati nell'esperimento possano essere attribuiti con maggiore sicurezza alla variabile indipendente in studio, piuttosto che a fattori estranei. In questo modo, si rafforza la validità dei risultati del test.
Che cos'è un'ipotesi nulla?
L'ipotesi nulla, spesso indicata come H0, è l'assunzione di default che non ci sia alcun effetto o differenza tra i gruppi o le condizioni testate. Funziona come un'affermazione che il ricercatore cerca di confutare o annullare tramite analisi statistica. Rifiutare o non rifiutare l'ipotesi nulla fornisce indicazioni chiave sulla relazione tra le variabili.
In che modo il p-value è collegato agli intervalli di confidenza nella verifica delle ipotesi?
Il p-value e gli intervalli di confidenza sono entrambi strumenti per trarre inferenze sulla popolazione a partire dai dati campionari. Un p-value indica la probabilità di osservare risultati estremi quanto quelli del campione se l'ipotesi nulla è vera. Gli intervalli di confidenza, invece, forniscono un intervallo di valori entro il quale è probabile che cada il vero parametro di popolazione. Se un intervallo di confidenza per una differenza di medie o per una dimensione dell'effetto non include il valore nullo (ad es., differenza zero), suggerisce che l'ipotesi nulla può essere rifiutata al livello di confidenza dell'intervallo, in linea con un p-value basso.
Qual è la differenza tra errori di Tipo I e di Tipo II?
Un errore di Tipo I si verifica quando l'ipotesi nulla viene rifiutata erroneamente, rilevando di fatto un effetto che non c'è (falso positivo). Un errore di Tipo II si verifica quando l'ipotesi nulla non viene rifiutata erroneamente, perdendo un effetto reale (falso negativo). Bilanciare questi errori è cruciale per un'analisi statistica solida.
In che modo la dimensione del campione influisce sulla verifica delle ipotesi?
La dimensione del campione influisce direttamente sulla potenza di un test d'ipotesi, ovvero la probabilità di rifiutare correttamente un'ipotesi nulla falsa (evitando un errore di Tipo II). Campioni più grandi forniscono in genere stime più accurate e affidabili dei parametri di popolazione, aumentano la potenza del test e riducono il margine di errore negli intervalli di confidenza.
Cosa succede se i miei dati campionari non sono rappresentativi della popolazione?
Se i dati campionari non sono rappresentativi della popolazione, i risultati del test d'ipotesi possono essere distorti e non generalizzabili all'intera popolazione. Ciò può derivare da metodi di campionamento difettosi come il bias di selezione, che potrebbero non catturare tutta la diversità o le caratteristiche della popolazione.
Qual è la differenza tra test parametrici e non parametrici?
I test parametrici assumono che i dati seguano una specifica distribuzione. I test non parametrici non assumono alcuna distribuzione specifica per i dati. Si usano in situazioni con dati ordinali, dati non normalmente distribuiti o campioni di piccole dimensioni.
Qual è la differenza tra significatività statistica e significatività pratica?
Mentre la significatività statistica ci dice la probabilità che un effetto si verifichi per caso, la significatività pratica riguarda l'impatto reale o la rilevanza di tale effetto in termini pratici. Un risultato può essere statisticamente significativo senza essere praticamente significativo se la dimensione dell'effetto è troppo piccola per avere conseguenze nel mondo reale.



