
Weiter zum Inhalt

Hypothesentests leicht gemacht

Hypothesentests sind ein statistisches Verfahren, mit dem Aussagen über Grundgesamtheiten anhand von Stichprobendaten bewertet werden.
Aktualisiert 18. Sept. 2026  · 9 Min. lesen

Mit KI erkunden

ChatGPTClaudePerplexity

Hypothesentests sind ein zentraler Bestandteil der Statistik und helfen dir, fundierte Entscheidungen in vielen Bereichen zu treffen – von der Medizin über die Wirtschaft bis zu den Sozialwissenschaften. Dieser Leitfaden führt dich durch die Kernkonzepte, Testarten, Schritte und Praxisbeispiele von Hypothesentests, damit du statistische Ergebnisse sicher interpretieren und präsentieren kannst.

Wenn du tiefer einsteigen willst, wähle den Kurs für deine bevorzugte Technologie: Hypothesis Testing in Python, Hypothesis Testing in R oder Introduction to Statistics in Google Sheets. Außerdem empfehlen wir unseren technologieunabhängigen Kurs Introduction to Statistics.

What is Hypothesis Testing?

Ein Hypothesentest ist ein statistisches Verfahren, mit dem Annahmen oder Hypothesen über einen Populationsparameter geprüft werden. Dabei formulierst du eine Nullhypothese (H0) und eine Alternativhypothese (Ha), erhebst Daten und prüfst, ob die Evidenz ausreicht, um die Nullhypothese zu verwerfen.

Das Hauptziel von Hypothesentests ist es, aus Stichprobendaten Rückschlüsse auf die Grundgesamtheit zu ziehen. So lässt sich quantifizieren, wie wahrscheinlich beobachtete Unterschiede oder Zusammenhänge rein zufällig entstanden sind – oder ob sie auf einen echten Effekt in der Population hindeuten.

Steps of Hypothesis Testing

Gehen wir die Schritte eines Hypothesentests der Reihe nach durch.

Step 1: State your hypotheses

Formuliere deine Forschungsfrage als zwei konkurrierende Hypothesen:

  1. Nullhypothese (H0): Ausgangsannahme, dass kein Effekt bzw. kein Unterschied besteht.
  2. Alternativhypothese (Ha): Annahme, dass ein Effekt bzw. ein Unterschied besteht.

Zum Beispiel:

  • H0: Die durchschnittliche Körpergröße von Männern entspricht der von Frauen.
  • Ha: Die durchschnittliche Körpergröße von Männern unterscheidet sich von der von Frauen.

Step 2: Collect and prepare data

Erhebe Daten über Experimente, Umfragen oder Beobachtungsstudien. Achte darauf, dass die Erhebung geeignet ist, die Hypothese zu prüfen, und die Grundgesamtheit gut abbildet. Häufig umfasst dieser Schritt:

  • Definition der interessierenden Population.
  • Auswahl einer geeigneten Stichprobenmethode.
  • Festlegung des Stichprobenumfangs.
  • Erfassung und Aufbereitung der Daten.

Step 3: Choose the appropriate statistical test

Wähle den passenden statistischen Test entsprechend Datentyp und Hypothese. Die Auswahl hängt u. a. ab von:

  • Datentyp (stetig, kategorial usw.)
  • Verteilung der Daten (normalverteilt, nicht normalverteilt)
  • Stichprobengröße
  • Anzahl der zu vergleichenden Gruppen

Häufige Tests sind:

Step 4: Calculate the test statistic and p-value

Berechne mit Statistiksoftware oder Formeln die Teststatistik und den zugehörigen p-Wert. So quantifizierst du, wie stark die Stichprobe von der Nullhypothese abweicht.

Der p-Wert ist ein zentrales Konzept: Er gibt die Wahrscheinlichkeit an, Ergebnisse mindestens so extrem wie in der Stichprobe zu beobachten, sofern die Nullhypothese gilt.

Step 5: Make a decision

Vergleiche den p-Wert mit dem vorab festgelegten Signifikanzniveau (α), üblicherweise 0,05. Entscheidungsregel:

  • Wenn p-Wert ≤ α: Verwirf die Nullhypothese – die Evidenz spricht für die Alternativhypothese.
  • Wenn p-Wert > α: Nullhypothese beibehalten – die Evidenz reicht nicht aus, um die Alternativhypothese zu stützen.

Wichtig: Die Nullhypothese nicht zu verwerfen bedeutet nicht, dass sie wahr ist – nur, dass die Evidenz für das Gegenteil nicht ausreicht.

Step 6: Present your findings

Berichte die Ergebnisse inklusive Teststatistik, p-Wert und Fazit. Erläutere, ob die Befunde die Ausgangshypothese stützen und was sie praktisch bedeuten. Achte beim Präsentieren darauf:

  • Den Kontext der Studie zu skizzieren.
  • Die Hypothesen klar zu benennen.
  • Teststatistik und p-Wert anzugeben.
  • Die Ergebnisse verständlich zu interpretieren.
  • Die praktische Relevanz zu diskutieren.

Types of Hypothesis Tests

Hypothesentests lassen sich grob in zwei Haupttypen einteilen:

Parametric tests

Parametrische Tests setzen eine bestimmte Wahrscheinlichkeitsverteilung der Daten voraus, typischerweise die Normalverteilung. Sind die Annahmen erfüllt, sind sie meist besonders aussagekräftig. Beispiele:

  • t-Tests (Einstichproben-, unabhängige Stichproben-, gepaarte Stichproben)
  • ANOVA (einfaktoriell, zweifaktoriell, Messwiederholung)
  • Z-Tests (Ein- und Zwei-Stichproben)
  • F-Tests (einfaktoriell, zweifaktoriell)

Non-parametric tests

Nichtparametrische Tests setzen keine spezifische Verteilung voraus. Sie eignen sich für ordinale Daten, bei Verletzung parametrischer Annahmen oder kleinen Stichproben. Beispiele:

  • Mann-Whitney-U-Test
  • Wilcoxon-Vorzeichen-Rang-Test
  • Kruskal-Wallis-Test

Selecting the appropriate test

Bei der Testwahl berücksichtigen Forschende typischerweise Folgendes:

  1. Datenverteilung: Sind die Daten normalverteilt? Viele Tests setzen Normalität voraus.
  2. Anzahl der Gruppen: Wie viele Gruppen vergleichst du (z. B. eine, zwei oder mehr)?
  3. Unabhängigkeit der Gruppen: Sind die Gruppen unabhängig (verschiedene Personen) oder abhängig (gleiche Personen mehrfach gemessen)?
  4. Datentyp:
    • Stetig (z. B. Größe, Gewicht),
    • Ordinal (z. B. Rangfolgen),
    • Nominal (z. B. ungeordnete Kategorien).

Auf Basis dieser Kriterien wählst du den passenden Test. Sind deine Daten normalverteilt und du vergleichst zwei unabhängige Gruppen mit stetigen Daten, verwendest du einen unabhängigen t-Test. Sind die Daten nicht normalverteilt, die Gruppen unabhängig und die Daten ordinal, empfiehlt sich der Mann-Whitney-U-Test.

Zur Auswahl des passenden Tests kann ein Flussdiagramm für Hypothesentests als grobe Orientierungshilfe dienen:
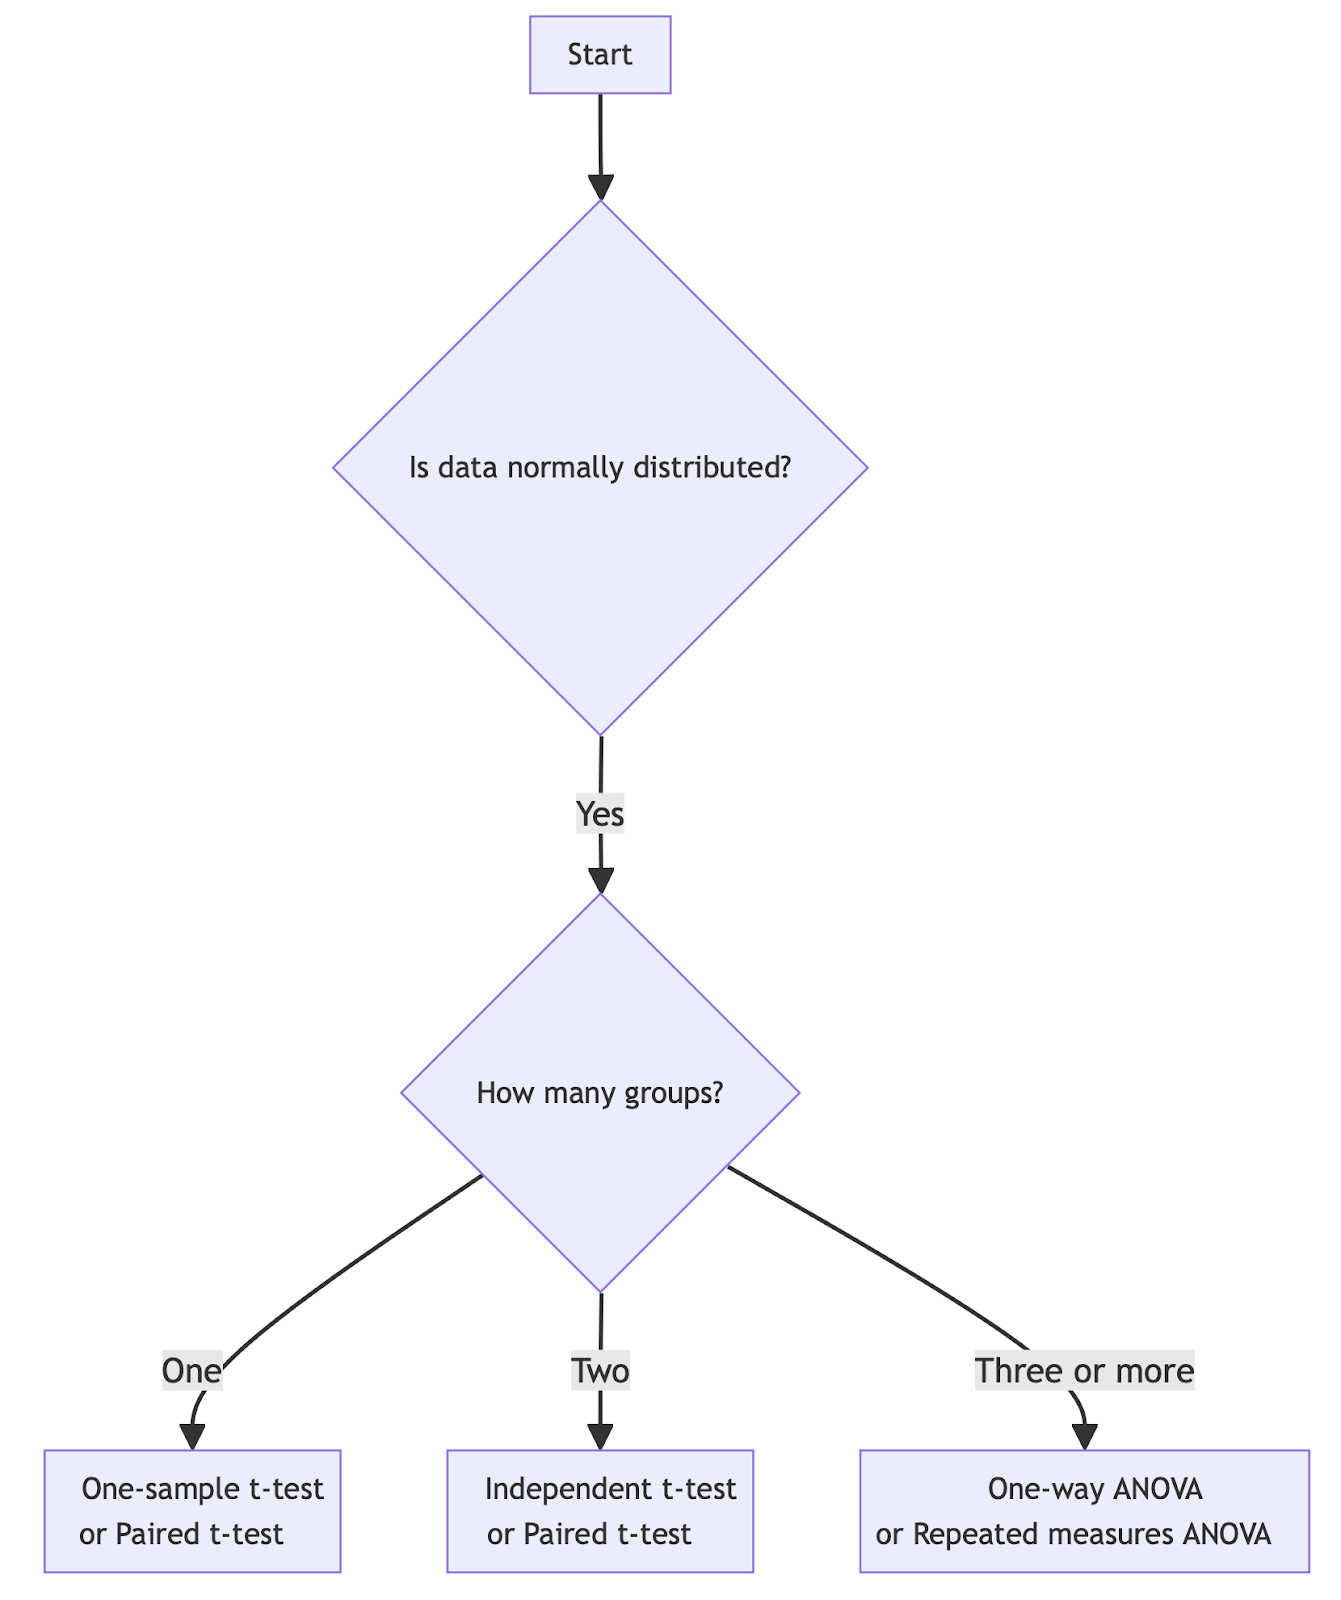
Choosing the right hypothesis test for normally distributed data

Die richtige Testwahl für normalverteilte Daten. Bild: Autorin/Autor.
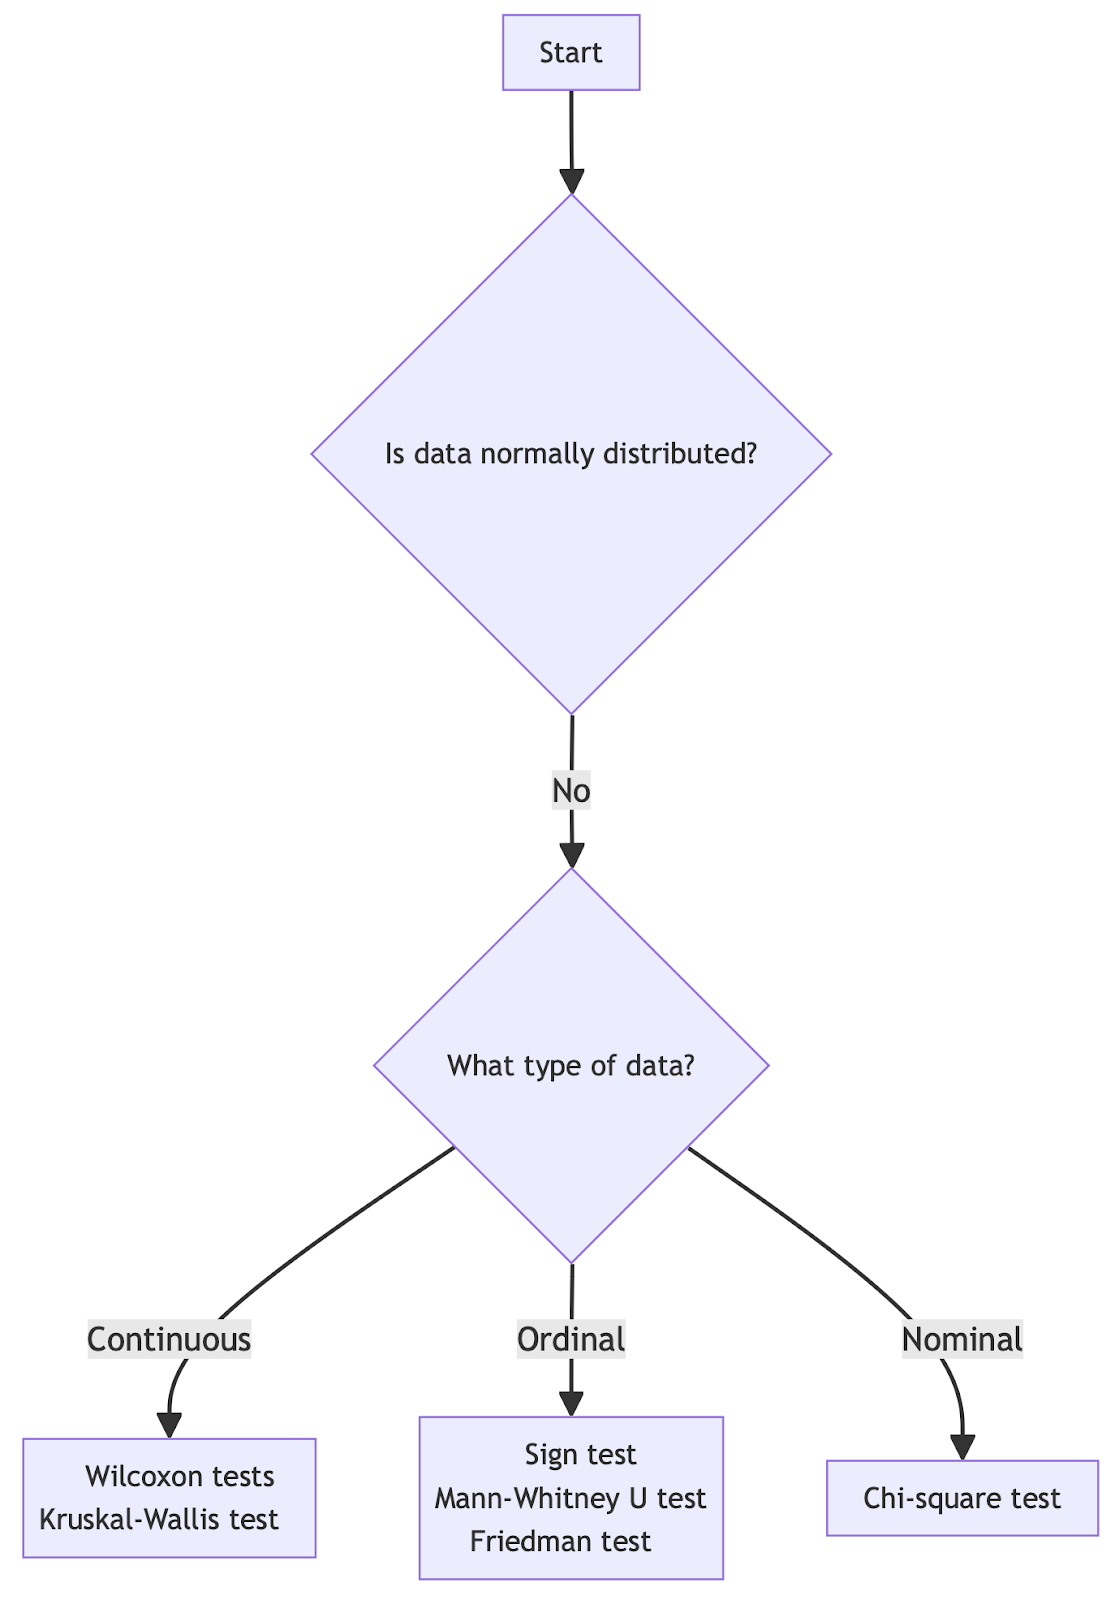
Choosing the right hypothesis test for non-normally distributed data

Die richtige Testwahl für nicht normalverteilte Daten. Bild: Autorin/Autor.

Modern Approaches to Hypothesis Testing

Neben klassischen Methoden gibt es mehrere moderne Ansätze:

Permutation or randomization tests

Bei Permutations- bzw. Randomisierungstests werden die beobachteten Daten vielfach zufällig durchmischt, um eine Verteilung möglicher Ergebnisse unter der Nullhypothese zu erzeugen. Das ist besonders bei kleinen Stichproben oder verletzten Annahmen parametrischer Tests hilfreich.

Bootstrapping

Bootstrapping ist eine Resampling-Technik: Wiederholtes Ziehen mit Zurücklegen aus dem Originaldatensatz, um die Stichprobenverteilung einer Statistik zu schätzen und Konfidenzintervalle zu bilden.

Monte Carlo simulation

Monte-Carlo-Verfahren nutzen wiederholtes Zufallsstichprobenziehen, um numerische Ergebnisse zu erhalten. In Hypothesentests lassen sich so p-Werte für komplexe Modelle schätzen, wenn analytische Lösungen schwer zugänglich sind.

Controlling for Errors

Beim Durchführen von Hypothesentests solltest du potenzielle Fehlerarten verstehen und steuern:

Type I and Type II errors

  • Fehler 1. Art: Verwerfen einer wahren Nullhypothese (falsch positiv).
  • Fehler 2. Art: Beibehalten einer falschen Nullhypothese (falsch negativ).

Das Signifikanzniveau (α) steuert direkt die Wahrscheinlichkeit eines Fehlers 1. Art. Ein kleineres α senkt dessen Risiko, erhöht aber das Risiko für Fehler 2. Art.

Zur Balance der Fehler:

  1. Signifikanzniveau je nach Konsequenzen der Fehlerarten anpassen.
  2. Stichprobengröße erhöhen, um die Teststärke zu verbessern.
  3. Einseitige Tests verwenden, wenn fachlich begründet.

The file drawer effect

Der File-Drawer-Effekt beschreibt den Publikationsbias, wonach Studien mit signifikanten Ergebnissen häufiger veröffentlicht werden als solche ohne Signifikanz. Dadurch können Effekte in der Literatur überschätzt werden. Zur Abmilderung:

  • Studien präregistrieren.
  • Alle Ergebnisse publizieren – ob signifikant oder nicht.
  • Metaanalysen durchführen, die Publikationsbias berücksichtigen.
  • Daten im Vorfeld simulieren.

Glossary of Key Terms and Definitions

  • Nullhypothese (H0): Ausgangsannahme, dass kein Effekt bzw. kein Unterschied besteht.
  • Alternativhypothese (Ha): Annahme, dass ein Effekt bzw. ein Unterschied besteht.
  • p-Wert: Wahrscheinlichkeit, die Testergebnisse unter der Nullhypothese zu beobachten.
  • Signifikanzniveau (α): Schwelle zum Verwerfen der Nullhypothese, häufig 0,05.
  • Teststatistik: Standardisierte Kennzahl zum Vergleich der Beobachtung mit der Nullhypothese.
  • Fehler 1. Art: Verwerfen einer wahren Nullhypothese (falsch positiv).
  • Fehler 2. Art: Beibehalten einer falschen Nullhypothese (falsch negativ).
  • Teststärke (Power): Wahrscheinlichkeit, eine falsche Nullhypothese korrekt zu verwerfen.
  • Konfidenzintervall: Wertebereich, der den wahren Populationsparameter mit hoher Wahrscheinlichkeit enthält.
  • Effektstärke: Maß für die Größe des untersuchten Unterschieds oder Zusammenhangs.

Conclusion

Denk daran: Hypothesentests sind nur ein Werkzeug im Kasten der statistischen Inferenz. Beurteile neben statistischer Signifikanz immer auch die praktische Relevanz deiner Befunde. Mit wachsender Erfahrung entwickelst du ein Gespür dafür, wann und wie du diese Techniken in realen Szenarien sinnvoll einsetzt.

Um deine Statistikkompetenz weiter auszubauen, lohnt sich ein Blick auf How to Become a Statistician in 2024 mit Einblicken in das sich wandelnde Berufsfeld und die dafür nötigen Kompetenzen. Außerdem helfen dir die Top 35 Statistics Interview Questions and Answers for 2024 sowie unser Kurs Practicing Statistics Interview Questions in R, deine Fähigkeiten zu schärfen und dich auf Interviews vorzubereiten.

Lass dich für deine Traumrolle als Datenanalyst zertifizieren

Unsere Zertifizierungsprogramme helfen dir, dich von anderen abzuheben und potenziellen Arbeitgebern zu beweisen, dass deine Fähigkeiten für den Job geeignet sind.

Hol Dir Deine Zertifizierung
Timeline mobile.png

Vinod Chugani's photo
Author
Vinod Chugani
LinkedIn

Vinod Chugani startete seine Karriere in Tokio als jüngster Head of Hedge Fund Sales Desk bei JPMorgan und stellte später bei Lehman Brothers einen individuellen Verkaufsrekord auf, baute danach ein Elektronikvertriebsunternehmen in 30 Ländern auf über 100 Mio. SG$ Umsatz aus und wechselte anschließend in die Datenwelt. Als Economics-Absolvent der Duke University und Alumni der NYC Data Science Academy war er einer von drei Stipendiaten unter mehr als 100 Bewerbenden für Hugo Bowne-Andersons Kurs "Building AI Applications" auf Maven. Heute schreibt er für DataCamp, KDnuggets, Machine Learning Mastery und Statology über Themen von Statistik bis agentischer KI und coacht Datenprofis an der NYC Data Science Academy mit über 1.000 Eins-zu-eins-Sessions.


Frequently Asked Questions

Why is it important to control the environment when conducting a hypothesis test?

Wenn du die Rahmenbedingungen eines Hypothesentests kontrollierst, minimierst du externe Einflüsse, die die Ergebnisse verfälschen könnten. So lassen sich beobachtete Effekte eher der unabhängigen Variable zuordnen statt Störfaktoren. Das stärkt die Aussagekraft und Gültigkeit der Testergebnisse.

What is a null hypothesis?

Die Nullhypothese, häufig als H0 bezeichnet, ist die Ausgangsannahme, dass kein Effekt oder Unterschied zwischen den getesteten Gruppen bzw. Bedingungen besteht. Sie ist die Aussage, die Forschende durch statistische Analyse zu widerlegen versuchen. Das Verwerfen oder Beibehalten der Nullhypothese liefert zentrale Erkenntnisse über Zusammenhänge zwischen Variablen.

How does the p-value relate to confidence intervals in hypothesis testing?

p-Wert und Konfidenzintervalle sind Werkzeuge, um aus Stichproben auf die Population zu schließen. Der p-Wert gibt die Wahrscheinlichkeit an, Ergebnisse so extrem wie in der Stichprobe zu beobachten, falls die Nullhypothese gilt. Konfidenzintervalle liefern dagegen einen Wertebereich, in dem der wahre Populationsparameter vermutlich liegt. Enthält ein Konfidenzintervall für eine Mitteldifferenz oder Effektstärke den Nullwert (z. B. null Differenz) nicht, spricht das für das Verwerfen der Nullhypothese auf dem entsprechenden Konfidenzniveau und deckt sich mit einem kleinen p-Wert.

What are Type I and Type II errors?

Ein Fehler 1. Art liegt vor, wenn eine wahre Nullhypothese fälschlich verworfen wird – es wird also ein nicht vorhandener Effekt "entdeckt" (falsch positiv). Ein Fehler 2. Art tritt auf, wenn eine falsche Nullhypothese fälschlich beibehalten wird – ein realer Effekt bleibt unentdeckt (falsch negativ). Diese Balance ist entscheidend für belastbare Analysen.

How does sample size affect hypothesis testing?

Die Stichprobengröße beeinflusst direkt die Teststärke, also die Wahrscheinlichkeit, eine falsche Nullhypothese korrekt zu verwerfen (Fehler 2. Art zu vermeiden). Größere Stichproben liefern in der Regel präzisere Schätzungen, erhöhen die Power und verkleinern die Fehlerspanne von Konfidenzintervallen.

What if my sample data is not representative of the population?

Ist die Stichprobe nicht repräsentativ für die Grundgesamtheit, können die Testergebnisse verzerrt sein und sich nicht verallgemeinern lassen. Ursache sind oft fehlerhafte Auswahlverfahren wie Selektionsbias, die die Vielfalt bzw. Merkmale der Population nicht angemessen abbilden.

What is the difference between parametric vs. non-parametric tests?

Parametrische Tests setzen eine bestimmte Verteilung der Daten voraus. Nichtparametrische Tests treffen keine solche Annahme. Sie kommen zum Einsatz bei ordinalen Daten, nicht normalverteilten Daten oder kleinen Stichproben.

What is the difference between statistical significance and practical significance?

Statistische Signifikanz beschreibt die Wahrscheinlichkeit, dass ein Effekt nicht zufällig ist. Praktische Signifikanz bewertet dagegen, ob der Effekt groß genug ist, um in der Praxis relevant zu sein. Ein Ergebnis kann statistisch signifikant sein, ohne praktische Bedeutung zu haben, wenn die Effektstärke sehr klein ist.

Themen
Datenanalyse
Datenwissenschaft

Learn Hypothesis Testing with DataCamp

Kurs

Hypothesentests in Python

4 Std.
61K
Dieser Kurs erklärt, wie und wann du gängige Hypothesentests wie t-Tests, Proportionentests und Chi-Quadrat-Tests in Python anwenden kannst.
Details anzeigenRight Arrow
Kurs Starten
Mehr anzeigenRight Arrow