
Accéder au contenu principal

Les tests d'hypothèses en toute simplicité

Le test d'hypothèse est une méthode statistique qui permet d'évaluer des affirmations sur des populations à partir de données d'échantillon.
Actualisé 19 sept. 2026  · 9 min lire

Explorer avec l’IA

ChatGPTClaudePerplexity

Le test d'hypothèse est un pilier des statistiques qui vous aide à prendre des décisions éclairées dans de nombreux domaines : de la médecine à l'économie, en passant par les sciences sociales. Ce guide vous présente les concepts clés, les types de tests, les étapes et des applications concrètes, afin que vous puissiez interpréter et présenter vos résultats statistiques en toute confiance.

Prêt à aller plus loin ? Choisissez le cours adapté à votre technologie de prédilection : Hypothesis Testing in Python, Hypothesis Testing in R ou Introduction to Statistics in Google Sheets. Vous pouvez aussi suivre notre cours Introduction to Statistics, indépendant de toute technologie.

Qu'est-ce qu'un test d'hypothèse ?

Le test d'hypothèse est une procédure statistique qui sert à vérifier des suppositions ou hypothèses sur un paramètre de population. Il consiste à formuler une hypothèse nulle (H0) et une hypothèse alternative (Ha), à collecter des données, puis à déterminer si les preuves sont suffisantes pour rejeter l'hypothèse nulle.

L'objectif principal est d'inférer des conclusions sur une population à partir d'un échantillon. Le test d'hypothèse permet d'estimer la probabilité que les différences ou relations observées dans les données soient dues au hasard, plutôt qu'à un effet réel dans la population.

Les étapes d'un test d'hypothèse

Voyons comment mener un test d'hypothèse, étape par étape.

Étape 1 : formuler vos hypothèses

Commencez par transformer votre question de recherche en deux hypothèses concurrentes :

  1. Hypothèse nulle (H0) : c'est l'affirmation par défaut selon laquelle il n'y a pas d'effet ni de différence.
  2. Hypothèse alternative (Ha) : elle postule l'existence d'un effet ou d'une différence.

Par exemple :

  • H0 : la taille moyenne des hommes est égale à la taille moyenne des femmes.
  • Ha : la taille moyenne des hommes n'est pas égale à la taille moyenne des femmes.

Étape 2 : collecter et préparer les données

Recueillez des données via des expériences, des enquêtes ou des études observationnelles. Assurez-vous que la méthode de collecte permet de tester l'hypothèse et qu'elle est représentative de la population. Cette étape inclut souvent :

  • Définir la population d'intérêt.
  • Choisir une méthode d'échantillonnage adaptée.
  • Déterminer la taille d'échantillon.
  • Collecter et organiser les données.

Étape 3 : choisir le test statistique approprié

Sélectionnez un test statistique en fonction du type de données et de votre hypothèse. Le choix dépend notamment :

  • Du type de données (continues, catégorielles, etc.)
  • De la distribution des données (normale, non normale)
  • De la taille d'échantillon
  • Du nombre de groupes comparés

Parmi les tests courants :

Étape 4 : calculer la statistique de test et la p-valeur

Utilisez un logiciel statistique ou des formules pour calculer la statistique de test et la p-valeur associée. Cette étape quantifie dans quelle mesure les données de l'échantillon s'écartent de l'hypothèse nulle.

La p-valeur est un concept central en test d'hypothèse. Elle représente la probabilité d'observer des résultats au moins aussi extrêmes que ceux de l'échantillon, en supposant que l'hypothèse nulle est vraie.

Étape 5 : prendre une décision

Comparez la p-valeur au seuil de significativité (α), généralement fixé à 0,05. Règle de décision :

  • Si p-valeur ≤ α : rejetez l'hypothèse nulle, ce qui indique des preuves en faveur de l'hypothèse alternative.
  • Si p-valeur > α : ne rejetez pas l'hypothèse nulle, ce qui suggère des preuves insuffisantes pour soutenir l'hypothèse alternative.

Important : ne pas rejeter l'hypothèse nulle ne prouve pas qu'elle est vraie ; cela signifie simplement que les preuves sont insuffisantes pour conclure le contraire.

Étape 6 : présenter vos résultats

Communiquez les résultats, y compris la statistique de test, la p-valeur et la conclusion. Indiquez si les constats confirment l'hypothèse initiale et quelles en sont les implications. Lors de la présentation, pensez à :

  • Fournir le contexte de l'étude.
  • Énoncer clairement les hypothèses.
  • Rapporter la statistique de test et la p-valeur.
  • Interpréter les résultats en langage simple.
  • Discuter la portée pratique des résultats.

Types de tests d'hypothèse

On distingue deux grandes familles de tests d'hypothèse :

Tests paramétriques

Les tests paramétriques supposent que les données suivent une loi de probabilité spécifique, généralement la loi normale. Lorsque ces hypothèses sont vérifiées, ils sont en général plus puissants. Parmi les tests paramétriques fréquents :

  • tests t (échantillon unique, échantillons indépendants, appariés)
  • ANOVA (à un facteur, à deux facteurs, mesures répétées)
  • tests Z (un échantillon, deux échantillons)
  • tests F (à un facteur, à deux facteurs)

Tests non paramétriques

Les tests non paramétriques ne supposent pas de distribution particulière. Ils sont utiles avec des données ordinales, des distributions non normales ou de petits échantillons. Exemples :

  • test de Mann-Whitney U
  • test des rangs signés de Wilcoxon
  • test de Kruskal-Wallis

Choisir le bon test

Pour sélectionner un test d'hypothèse, on considère plusieurs dimensions :

  1. Distribution des données : vérifier si les données suivent une loi normale, car de nombreux tests en dépendent.
  2. Nombre de groupes : préciser si vous comparez un, deux ou plusieurs groupes.
  3. Indépendance des groupes : déterminer si les groupes sont indépendants (sujets différents) ou dépendants (mêmes sujets mesurés plusieurs fois).
  4. Type de données :
    • Continues (ex. : taille, poids),
    • Ordinales (ex. : classements),
    • Nominales (ex. : catégories sans ordre).

Selon ces critères, choisissez le test approprié. Par exemple, si vos données sont normales, avec deux groupes indépendants et des mesures continues, utilisez un test t pour échantillons indépendants. Si les données ne sont pas normales, avec deux groupes indépendants et des données ordinales, privilégiez le test de Mann-Whitney U.

Pour vous aider, utilisez un organigramme de sélection des tests d'hypothèse comme guide général :
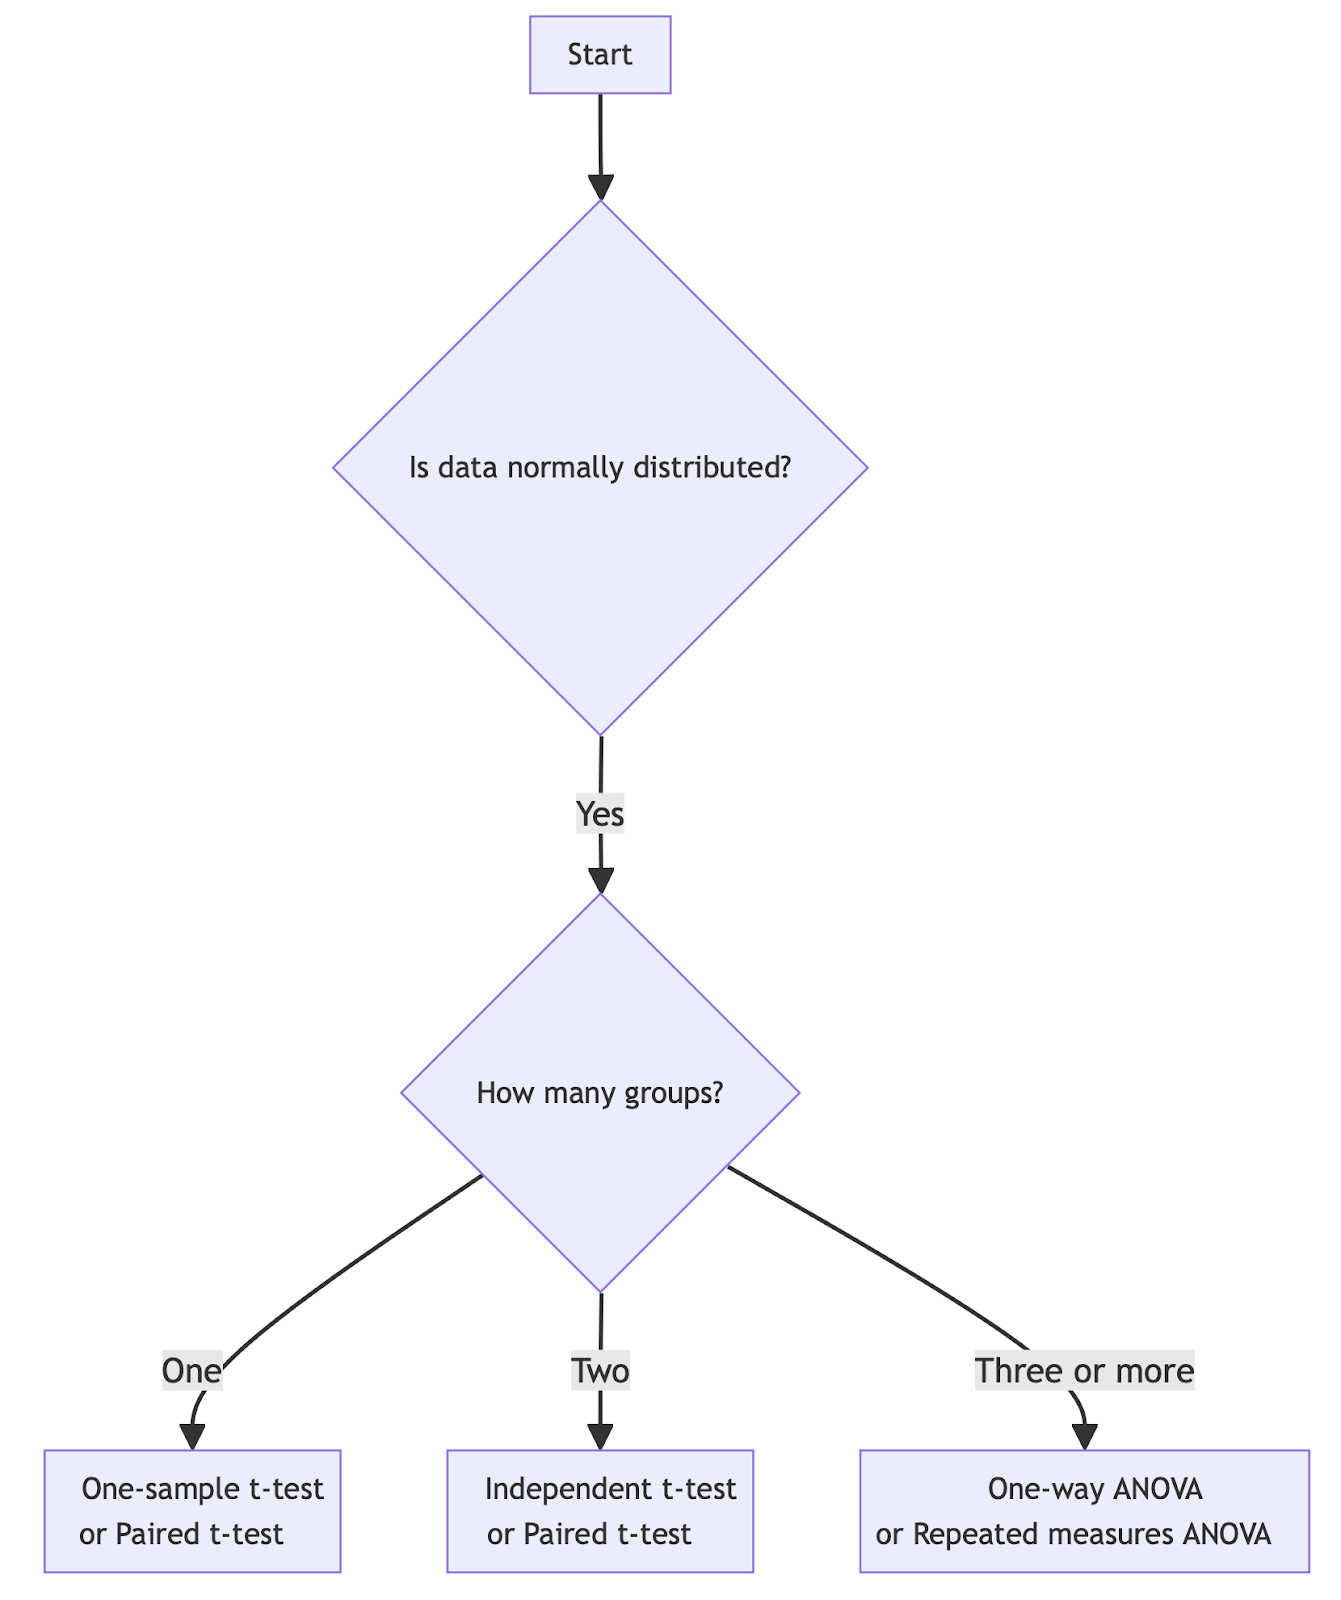
Choisir le bon test d'hypothèse pour des données normalement distribuées

Choisir le bon test d'hypothèse pour des données normalement distribuées. Image de l'auteur.
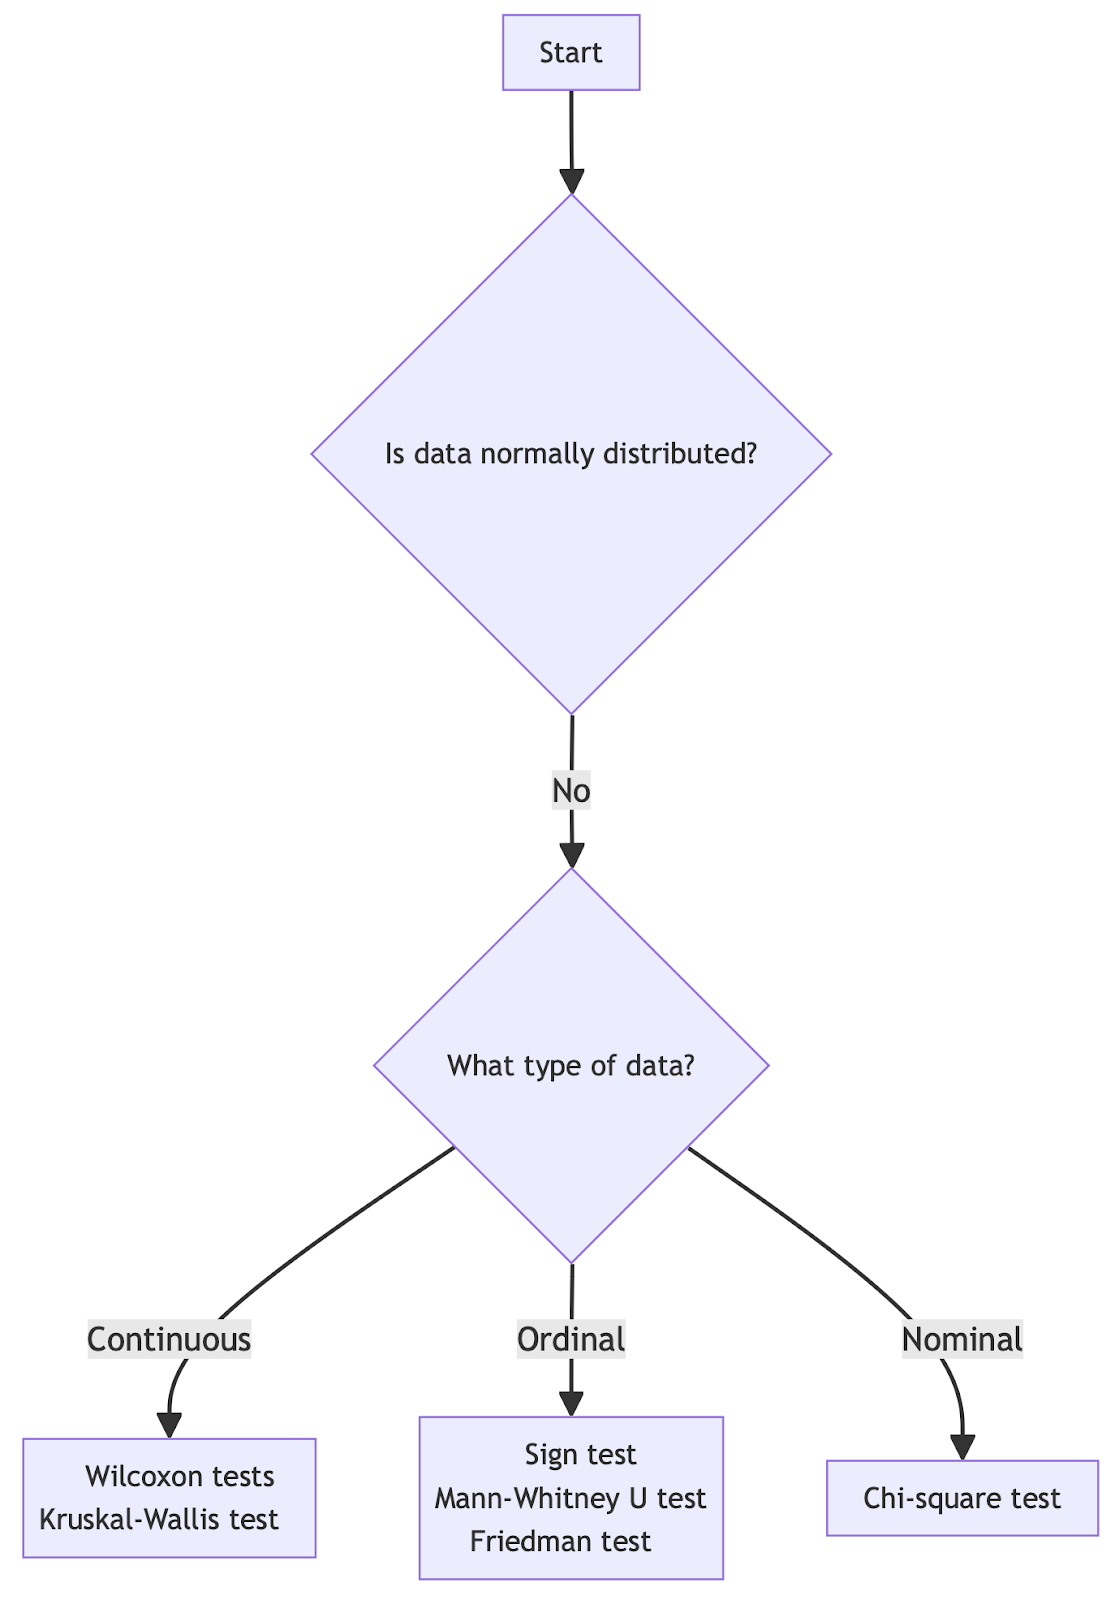
Choisir le bon test d'hypothèse pour des données non normalement distribuées

Choisir le bon test d'hypothèse pour des données non normalement distribuées. Image de l'auteur.

Approches modernes des tests d'hypothèse

En complément des méthodes traditionnelles, plusieurs approches modernes existent :

Tests par permutation ou randomisation

Ces tests consistent à réarranger aléatoirement les données observées de nombreuses fois pour créer une distribution des résultats possibles sous l'hypothèse nulle. Ils sont particulièrement utiles avec de petits échantillons ou lorsque les hypothèses des tests paramétriques ne sont pas respectées.

Bootstrapping

Le bootstrapping est une technique de rééchantillonnage qui consiste à tirer de façon répétée, avec remise, des échantillons à partir du jeu de données initial. Elle permet d'estimer la distribution d'échantillonnage d'une statistique et de construire des intervalles de confiance.

Simulation de Monte Carlo

Les méthodes de Monte Carlo utilisent des tirages aléatoires répétés pour obtenir des résultats numériques. En test d'hypothèse, elles servent à estimer des p-valeurs pour des modèles complexes ou lorsque les solutions analytiques sont difficiles à obtenir.

Maîtriser les erreurs

Lors de tests d'hypothèse, il est essentiel de comprendre et de contrôler les erreurs potentielles :

Erreurs de type I et de type II

  • Erreur de type I : rejet à tort de l'hypothèse nulle (faux positif).
  • Erreur de type II : non-rejet à tort de l'hypothèse nulle alors qu'elle est fausse (faux négatif).

Le seuil de significativité (α) contrôle directement la probabilité d'erreur de type I. Diminuer α réduit ce risque mais augmente celui d'erreur de type II.

Pour équilibrer ces erreurs :

  1. Ajustez α selon les conséquences de chaque type d'erreur.
  2. Augmentez la taille d'échantillon pour améliorer la puissance du test.
  3. Utilisez des tests unilatéraux lorsque c'est pertinent.

File drawer effect

Le « file drawer effect » désigne un biais de publication : les études aux résultats significatifs sont plus susceptibles d'être publiées que celles aux résultats non significatifs. Cela peut conduire à surestimer les effets dans la littérature. Pour y remédier :

  • Envisagez l'enregistrement préalable des études.
  • Publiez tous les résultats, qu'ils soient significatifs ou non.
  • Réalisez des méta-analyses tenant compte du biais de publication.
  • Simulez les données en amont.

Glossaire : termes et définitions clés

  • Hypothèse nulle (H0) : affirmation par défaut d'absence d'effet ou de différence.
  • Hypothèse alternative (Ha) : hypothèse d'existence d'un effet ou d'une différence.
  • P-valeur : probabilité d'observer les résultats du test sous l'hypothèse nulle.
  • Seuil de significativité (α) : seuil de rejet de l'hypothèse nulle, couramment 0,05.
  • Statistique de test : valeur standardisée comparant les données observées à l'hypothèse nulle.
  • Erreur de type I : rejet à tort d'une hypothèse nulle vraie (faux positif).
  • Erreur de type II : non-rejet à tort d'une hypothèse nulle fausse (faux négatif).
  • Puissance statistique : probabilité de rejeter correctement une hypothèse nulle fausse.
  • Intervalle de confiance : plage de valeurs contenant vraisemblablement le paramètre réel de la population.
  • Taille d'effet : mesure de l'ampleur de la différence ou de la relation testée.

Conclusion

Gardez à l'esprit que le test d'hypothèse n'est qu'un outil parmi d'autres en inférence statistique. Considérez toujours la portée pratique de vos résultats, et pas uniquement la significativité statistique. Avec l'expérience, vous saurez quand et comment appliquer ces techniques dans des contextes réels variés.

Pour approfondir vos compétences en statistiques, explorez par exemple How to Become a Statistician in 2024, qui présente l'évolution du métier et les compétences clés. Entraînez-vous également avec les Top 35 Statistics Interview Questions and Answers for 2024 et notre cours Practicing Statistics Interview Questions in R pour perfectionner vos compétences et préparer vos entretiens.

Obtenez une certification pour le poste d'analyste de données de vos rêves

Nos programmes de certification vous aident à vous démarquer et à prouver aux employeurs potentiels que vos compétences sont adaptées à l'emploi.

Obtenez Votre Certification
Timeline mobile.png

Vinod Chugani's photo
Author
Vinod Chugani
LinkedIn

Vinod Chugani a débuté sa carrière à Tokyo comme plus jeune responsable du desk ventes hedge funds de JPMorgan, puis a signé un record de ventes individuel chez Lehman Brothers, avant de développer une activité de distribution d’électronique présente dans 30 pays, dépassant les 100 millions SG$ de chiffre d’affaires, puis de se tourner vers la data. Diplômé en économie de Duke et ancien élève de la NYC Data Science Academy, il a fait partie des trois lauréats de bourse sur plus de 100 candidatures pour le cours Building AI Applications de Hugo Bowne-Anderson sur Maven. Aujourd’hui, il écrit pour DataCamp, KDnuggets, Machine Learning Mastery et Statology, sur des sujets allant des statistiques à l’IA agentique, et accompagne des professionnels de la data à la NYC Data Science Academy, avec plus de 1 000 séances individuelles à son actif.


Questions fréquentes

Pourquoi est-il important de contrôler l'environnement lors d'un test d'hypothèse ?

Contrôler l'environnement pendant un test d'hypothèse minimise les variables externes susceptibles d'influer sur les résultats. Ce contrôle garantit que les effets observés peuvent être attribués avec plus de certitude à la variable indépendante étudiée, plutôt qu'à des facteurs parasites. La validité des conclusions s'en trouve renforcée.

Qu'est-ce qu'une hypothèse nulle ?

L'hypothèse nulle, souvent notée H0, est l'affirmation par défaut selon laquelle il n'existe pas d'effet ni de différence entre les groupes ou conditions testés. C'est l'énoncé que le chercheur cherche à réfuter par l'analyse statistique. Rejeter ou ne pas rejeter H0 apporte des informations clés sur la relation entre les variables.

Quel est le lien entre p-valeur et intervalles de confiance en test d'hypothèse ?

La p-valeur et les intervalles de confiance sont deux outils pour inférer sur la population à partir d'un échantillon. La p-valeur indique la probabilité d'observer des résultats aussi extrêmes que ceux de l'échantillon si l'hypothèse nulle est vraie. Les intervalles de confiance fournissent une plage de valeurs dans laquelle le paramètre de population a de fortes chances de se situer. Si l'intervalle de confiance d'une différence de moyennes ou d'une taille d'effet n'inclut pas la valeur nulle (par ex. : différence égale à zéro), cela suggère que l'hypothèse nulle peut être rejetée au niveau de confiance considéré, ce qui concorde avec une p-valeur faible.

Quelles sont les erreurs de type I et de type II ?

L'erreur de type I survient lorsque l'on rejette à tort l'hypothèse nulle, c'est-à-dire que l'on détecte un effet inexistant (faux positif). L'erreur de type II se produit lorsque l'on ne rejette pas à tort une hypothèse nulle fausse, manquant un effet réel (faux négatif). Trouver le bon équilibre entre ces erreurs est essentiel pour une analyse robuste.

Quel est l'impact de la taille d'échantillon sur un test d'hypothèse ?

La taille d'échantillon influence directement la puissance d'un test d'hypothèse, c'est-à-dire la probabilité de rejeter correctement une hypothèse nulle fausse (éviter une erreur de type II). Des échantillons plus grands fournissent en général des estimations plus précises et fiables des paramètres de population, augmentent la puissance du test et réduisent la marge d'erreur des intervalles de confiance.

Que se passe-t-il si mon échantillon n'est pas représentatif de la population ?

Si l'échantillon n'est pas représentatif de la population, les résultats du test d'hypothèse risquent d'être biaisés et peu généralisables. Cela peut provenir de méthodes d'échantillonnage défaillantes, comme un biais de sélection, qui ne reflètent pas la diversité ou les caractéristiques de la population.

Quelle est la différence entre tests paramétriques et non paramétriques ?

Les tests paramétriques supposent une distribution spécifique des données. Les tests non paramétriques ne font pas cette hypothèse. Ils sont utilisés, par exemple, avec des données ordinales, des distributions non normales ou de petites tailles d'échantillon.

Quelle est la différence entre significativité statistique et significativité pratique ?

La significativité statistique renseigne sur la probabilité qu'un effet soit dû au hasard, tandis que la significativité pratique s'intéresse à l'impact réel ou à la pertinence de cet effet. Un résultat peut être statistiquement significatif sans être pertinent en pratique si la taille d'effet est trop faible pour avoir une conséquence concrète.

Sujets
Analyse des données
Science des données

Apprenez les tests d'hypothèse avec DataCamp

Cours

Tests d'hypothèses en Python

4 h
61K
Apprenez quand et comment utiliser les tests d’hypothèse courants en Python : t-tests, tests de proportion et tests du khi-deux.
Afficher les détailsRight Arrow
Commencer Le Cours
Voir plusRight Arrow