
मुख्य सामग्री पर जाएं

हाइपोथिसिस टेस्टिंग समझें—आसान तरीके से

हाइपोथिसिस टेस्टिंग एक सांख्यिकीय विधि है जिसका उपयोग नमूना डेटा के आधार पर जनसंख्या के बारे में दावों का मूल्यांकन करने के लिए किया जाता है।
अपडेट किया गया 24 सित॰ 2026  · 9 मि॰ पढ़ें

AI के साथ खोजें

ChatGPTClaudePerplexity

हाइपोथिसिस टेस्टिंग सांख्यिकी का एक प्रमुख हिस्सा है जो चिकित्सा से लेकर अर्थशास्त्र और सामाजिक विज्ञान तक, विभिन्न क्षेत्रों में सूचित निर्णय लेने में आपकी मदद करता है। यह मार्गदर्शिका आपको हाइपोथिसिस टेस्टिंग की मूल अवधारणाओं, प्रकारों, चरणों और वास्तविक जीवन के उपयोगों से परिचित कराएगी, ताकि आप अपने सांख्यिकीय निष्कर्षों की आत्मविश्वास से व्याख्या और प्रस्तुति कर सकें।

यदि आप हाइपोथिसिस टेस्टिंग के बारे में अधिक सीखने के लिए तैयार हैं, तो अपनी पसंदीदा तकनीक के अनुसार कोर्स चुनें: Hypothesis Testing in Python, Hypothesis Testing in R, या Introduction to Statistics in Google Sheets। साथ ही, हमारा Introduction to Statistics कोर्स भी करें, जो तकनीक-निरपेक्ष है।

हाइपोथिसिस टेस्टिंग क्या है?

हाइपोथिसिस टेस्टिंग एक सांख्यिकीय प्रक्रिया है जिसका उपयोग किसी जनसंख्या पैरामीटर के बारे में मान्यताओं या परिकल्पनाओं का परीक्षण करने के लिए किया जाता है। इसमें शून्य परिकल्पना (H0) और वैकल्पिक परिकल्पना (Ha) बनाना, डेटा एकत्र करना, और यह निर्धारण करना शामिल है कि शून्य परिकल्पना को अस्वीकार करने के लिए प्रमाण पर्याप्त रूप से मजबूत हैं या नहीं।

हाइपोथिसिस टेस्टिंग का मुख्य उद्देश्य नमूना डेटा के आधार पर जनसंख्या के बारे में निष्कर्ष निकालना है। यह शोधकर्ताओं और विश्लेषकों को यह मापने में सक्षम बनाता है कि डेटा में देखे गए अंतर या संबंध संयोगवश हुए हैं या वास्तव में जनसंख्या में किसी वास्तविक प्रभाव को दर्शाते हैं।

हाइपोथिसिस टेस्टिंग के चरण

आइए एक-एक करके देखें कि हाइपोथिसिस टेस्ट कैसे किया जाता है।

चरण 1: अपनी परिकल्पनाएँ बताएं

पहला कदम है अपने शोध प्रश्न को दो प्रतिस्पर्धी परिकल्पनाओं में रूपांतरित करना:

  1. शून्य परिकल्पना (H0): यह डिफ़ॉल्ट मान्यता है कि कोई प्रभाव या अंतर नहीं है।
  2. वैकल्पिक परिकल्पना (Ha): यह परिकल्पना है कि कोई प्रभाव या अंतर मौजूद है।

उदाहरण के लिए:

  • H0: पुरुषों की औसत लंबाई महिलाओं की औसत लंबाई के बराबर है।
  • Ha: पुरुषों की औसत लंबाई महिलाओं की औसत लंबाई के बराबर नहीं है।

चरण 2: डेटा एकत्र करें और तैयार करें

प्रयोगों, सर्वेक्षणों या प्रेक्षणात्मक अध्ययनों के माध्यम से डेटा एकत्र करें। सुनिश्चित करें कि डेटा संग्रह विधि परिकल्पना की जाँच के लिए उपयुक्त है और जनसंख्या का प्रतिनिधित्व करती है। इस चरण में आम तौर पर शामिल होता है:

  • रुचि वाली जनसंख्या को परिभाषित करना।
  • उपयुक्त सैंपलिंग विधि का चयन करना।
  • नमूना आकार निर्धारित करना।
  • डेटा एकत्रित करना और व्यवस्थित करना।

चरण 3: उपयुक्त सांख्यिकीय परीक्षण चुनें

डेटा के प्रकार और परिकल्पना के आधार पर कोई सांख्यिकीय परीक्षण चुनें। चयन इन कारकों पर निर्भर करता है:

  • डेटा प्रकार (सतत, श्रेणीय, आदि)
  • डेटा का वितरण (सामान्य, असामान्य)
  • नमूना आकार
  • तुलना किए जा रहे समूहों की संख्या

सामान्य परीक्षणों में शामिल हैं:

चरण 4: टेस्ट स्टैटिस्टिक और p-वैल्यू की गणना करें

सांख्यिकीय सॉफ़्टवेयर या सूत्रों का उपयोग करके टेस्ट स्टैटिस्टिक और संबंधित p-वैल्यू की गणना करें। यह चरण मापता है कि नमूना डेटा शून्य परिकल्पना से कितना विचलित है।

p-वैल्यू हाइपोथिसिस टेस्टिंग में एक महत्वपूर्ण अवधारणा है। यह उस संभावना का प्रतिनिधित्व करती है कि शून्य परिकल्पना सत्य मानते हुए, नमूना डेटा जितने चरम परिणाम देखे जाएँ।

चरण 5: निर्णय लें

p-वैल्यू की तुलना पूर्वनिर्धारित सार्थकता स्तर (α) से करें, जो आमतौर पर 0.05 रखा जाता है। निर्णय नियम इस प्रकार है:

  • यदि p-वैल्यू ≤ α: शून्य परिकल्पना अस्वीकार करें, जिससे वैकल्पिक परिकल्पना के समर्थन में साक्ष्य का संकेत मिलता है।
  • यदि p-वैल्यू > α: शून्य परिकल्पना अस्वीकार करने में असफल, अर्थात वैकल्पिक परिकल्पना का समर्थन करने के लिए अपर्याप्त साक्ष्य।

यह ध्यान रखना महत्वपूर्ण है कि शून्य परिकल्पना को अस्वीकार करने में असफल होना इसका सत्य होना सिद्ध नहीं करता; इसका अर्थ केवल इतना है कि विपरीत निष्कर्ष निकालने के लिए पर्याप्त साक्ष्य नहीं हैं।

चरण 6: अपने निष्कर्ष प्रस्तुत करें

परिणामों की रिपोर्ट करें, जिनमें टेस्ट स्टैटिस्टिक, p-वैल्यू, और निष्कर्ष शामिल हों। बताएं कि क्या निष्कर्ष प्रारंभिक परिकल्पना का समर्थन करते हैं और उनके निहितार्थ क्या हैं। परिणाम प्रस्तुत करते समय, इन बातों पर विचार करें:

  • अध्ययन का संदर्भ देना।
  • परिकल्पनाओं को स्पष्ट रूप से बताना।
  • टेस्ट स्टैटिस्टिक और p-वैल्यू की रिपोर्ट करना।
  • परिणामों की सरल भाषा में व्याख्या करना।
  • निष्कर्षों के व्यावहारिक महत्व पर चर्चा करना।

हाइपोथिसिस टेस्ट के प्रकार

हाइपोथिसिस टेस्ट को व्यापक रूप से दो मुख्य प्रकारों में वर्गीकृत किया जा सकता है:

पैरामीट्रिक टेस्ट

पैरामीट्रिक टेस्ट मानते हैं कि डेटा किसी विशिष्ट प्रायिकता वितरण का अनुसरण करता है, आमतौर पर सामान्य वितरण। जब मान्यताएँ पूरी होती हैं, तो ये परीक्षण आमतौर पर अधिक शक्तिशाली होते हैं। सामान्य पैरामीट्रिक परीक्षणों में शामिल हैं:

  • t-टेस्ट (वन-सैंपल, स्वतंत्र सैंपल, पेयर्ड सैंपल)
  • ANOVA (वन-वे, टू-वे, रिपीटेड मेजर्स)
  • Z-टेस्ट (वन-सैंपल, टू-सैंपल)
  • F-टेस्ट (वन-वे, टू-वे)

नॉन-पैरामीट्रिक टेस्ट

नॉन-पैरामीट्रिक टेस्ट डेटा के किसी विशिष्ट वितरण को नहीं मानते। ये क्रमबद्ध (ordinal) डेटा के साथ या तब उपयोगी होते हैं जब पैरामीट्रिक परीक्षणों की मान्यताएँ भंग होती हैं। उदाहरणों में शामिल हैं:

  • Mann-Whitney U टेस्ट
  • Wilcoxon साइन-रैंक टेस्ट
  • Kruskal-Wallis टेस्ट

उपयुक्त परीक्षण का चयन

हाइपोथिसिस टेस्ट चुनते समय, शोधकर्ता कुछ व्यापक श्रेणियों पर विचार करते हैं:

  1. डेटा वितरण: जाँचें कि आपका डेटा सामान्य रूप से वितरित है या नहीं, क्योंकि कई परीक्षण सामान्यता मानते हैं।
  2. समूहों की संख्या: निर्धारित करें कि आप कितने समूहों की तुलना कर रहे हैं (जैसे, एक, दो, या अधिक)।
  3. समूहों की स्वतंत्रता: तय करें कि आपके समूह स्वतंत्र हैं (अलग-अलग विषय) या निर्भर हैं (उसी विषयों को कई बार मापा गया)।
  4. डेटा प्रकार:
    • सतत (उदा., लंबाई, वजन),
    • क्रमबद्ध (उदा., रैंकिंग),
    • नाममात्र (उदा., बिना क्रम वाली श्रेणियाँ)।

इन श्रेणियों के आधार पर, आप उपयुक्त सांख्यिकीय परीक्षण चुन सकते हैं। उदाहरण के लिए, यदि आपका डेटा सामान्य रूप से वितरित है और आपके पास सतत डेटा वाले दो स्वतंत्र समूह हैं, तो आप इंडिपेंडेंट t-टेस्ट का उपयोग करेंगे। यदि आपका डेटा सामान्य रूप से वितरित नहीं है, दो स्वतंत्र समूह हैं और क्रमबद्ध डेटा है, तो Mann-Whitney U टेस्ट सुझाया जाता है।

उपयुक्त परीक्षण चुनने में मदद के लिए, एक हाइपोथिसिस टेस्ट फ्लो चार्ट को सामान्य मार्गदर्शक के रूप में देखें:
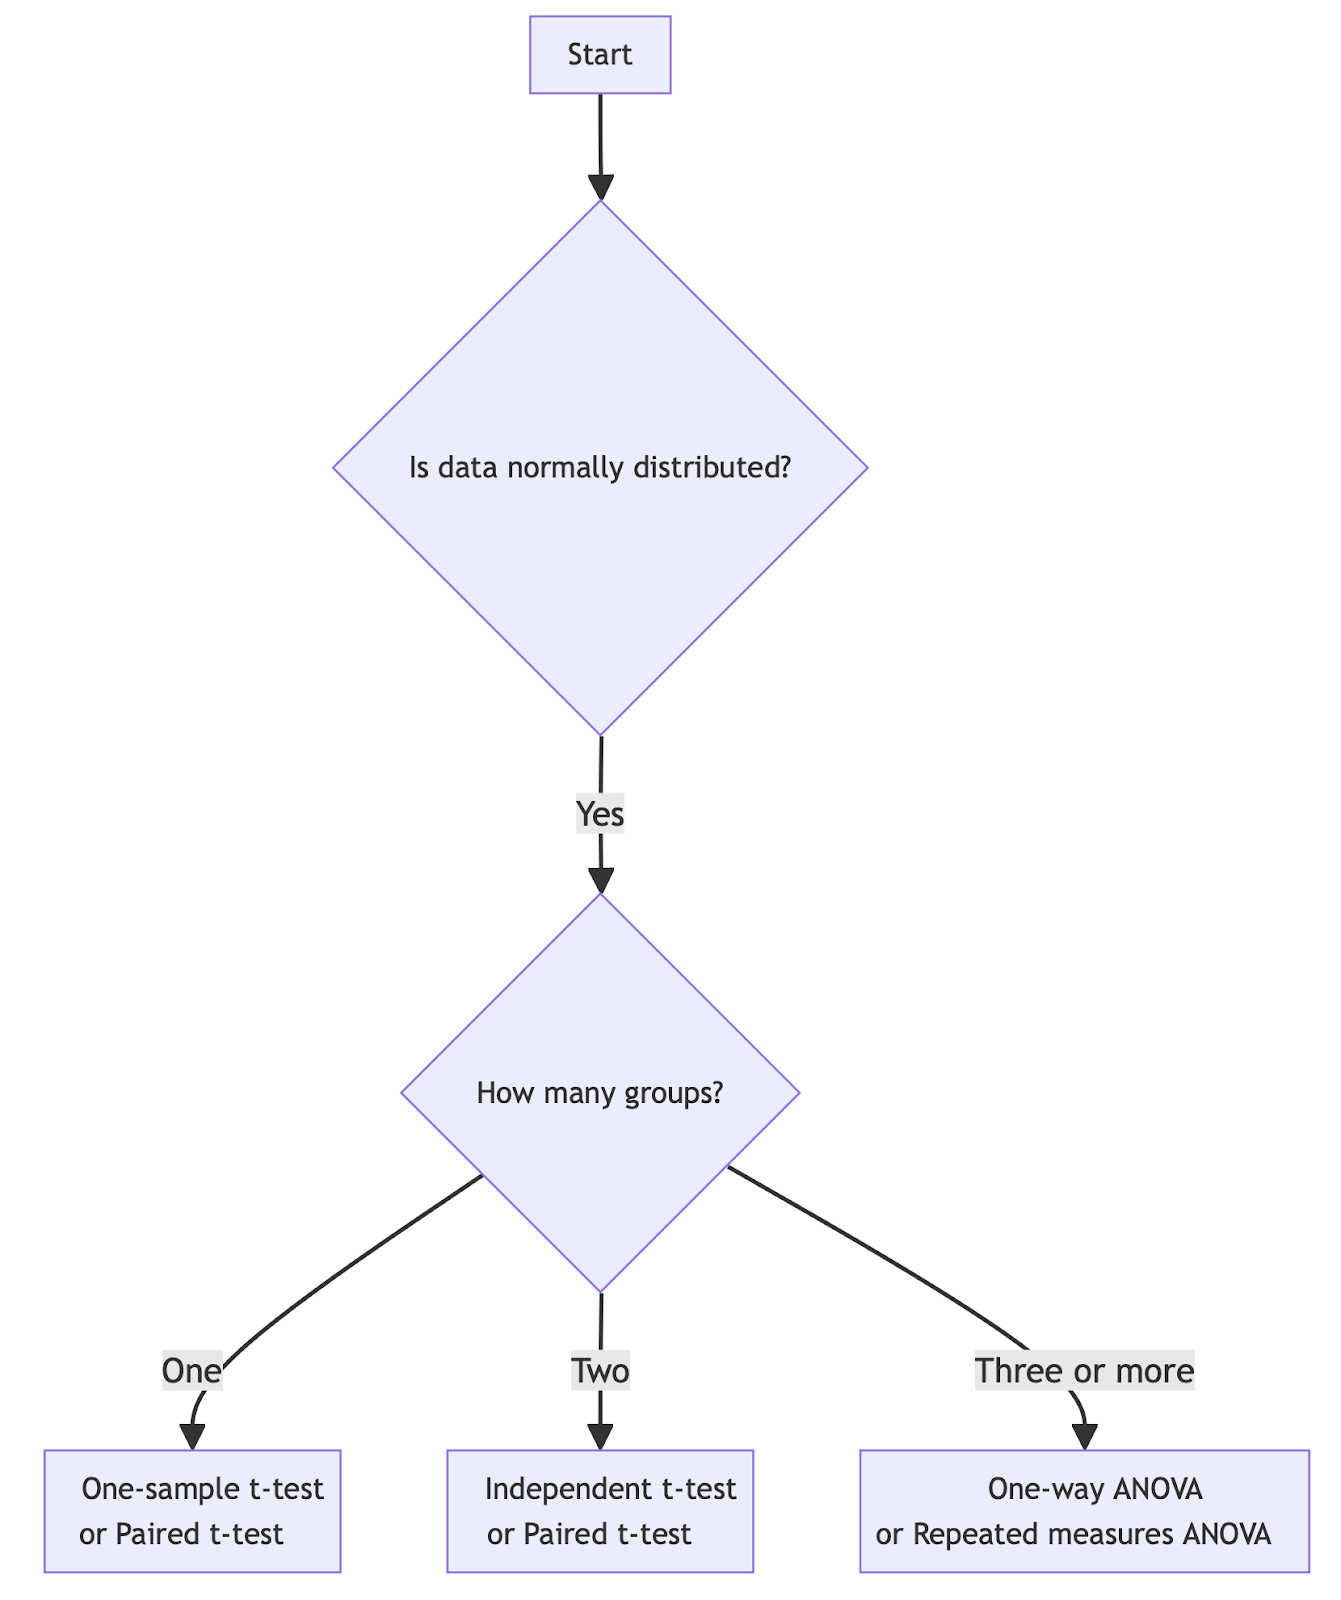
सामान्य रूप से वितरित डेटा के लिए सही हाइपोथिसिस टेस्ट चुनना

सामान्य रूप से वितरित डेटा के लिए सही हाइपोथिसिस टेस्ट चुनना। चित्र: लेखक।
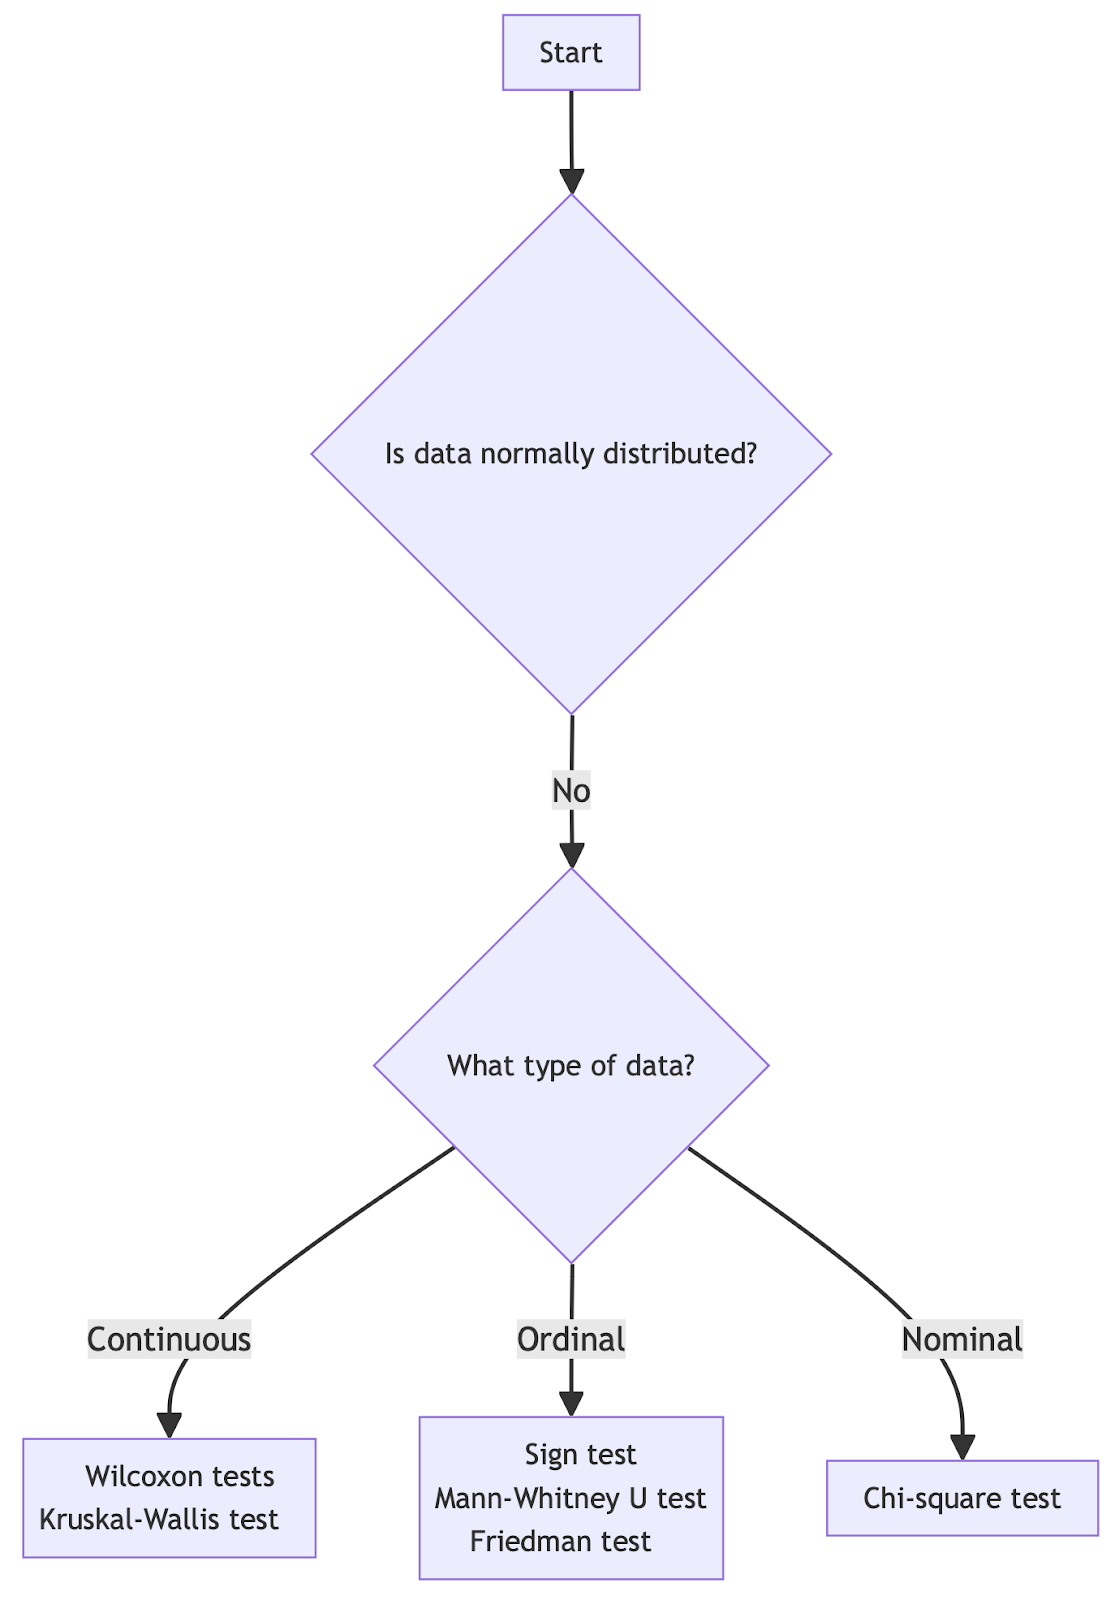
गैर-सामान्य रूप से वितरित डेटा के लिए सही हाइपोथिसिस टेस्ट चुनना

गैर-सामान्य रूप से वितरित डेटा के लिए सही हाइपोथिसिस टेस्ट चुनना। चित्र: लेखक।

हाइपोथिसिस टेस्टिंग के आधुनिक दृष्टिकोण

पारंपरिक विधियों के अलावा, कई आधुनिक दृष्टिकोण भी हैं:

परम्यूटेशन या रैंडमाइज़ेशन टेस्ट

इन परीक्षणों में देखे गए डेटा को कई बार यादृच्छिक रूप से शफल किया जाता है ताकि शून्य परिकल्पना के अंतर्गत संभावित परिणामों का वितरण बनाया जा सके। ये विशेष रूप से छोटे नमूना आकारों के साथ या जब पैरामीट्रिक परीक्षणों की मान्यताएँ पूरी नहीं होतीं, तब उपयोगी होते हैं।

बूटस्ट्रैपिंग

बूटस्ट्रैपिंग एक पुनः-नमूना तकनीक है जिसमें मूल डेटासेट से बार-बार प्रतिस्थापन के साथ सैंपल लिया जाता है। इसका उपयोग किसी स्टैटिस्टिक के सैंपलिंग वितरण का अनुमान लगाने और कॉन्फिडेंस इंटरवल बनाने के लिए किया जा सकता है।

मोंटे कार्लो सिमुलेशन

Monte Carlo विधियाँ संख्यात्मक परिणाम प्राप्त करने के लिए बार-बार यादृच्छिक सैंपलिंग का उपयोग करती हैं। हाइपोथिसिस टेस्टिंग में, इनका उपयोग जटिल सांख्यिकीय मॉडलों के लिए p-वैल्यू का अनुमान लगाने या तब किया जा सकता है जब विश्लेषणात्मक समाधान पाना कठिन हो।

त्रुटियों को नियंत्रित करना

हाइपोथिसिस टेस्ट करते समय संभावित त्रुटियों को समझना और नियंत्रित करना सर्वोत्तम होता है:

प्रकार-I और प्रकार-II त्रुटियाँ

  • प्रकार-I त्रुटि: जब शून्य परिकल्पना वास्तव में सत्य हो और उसे अस्वीकार कर दिया जाए (फॉल्स पॉज़िटिव)।
  • प्रकार-II त्रुटि: जब शून्य परिकल्पना वास्तव में असत्य हो और उसे अस्वीकार न किया जाए (फॉल्स नेगेटिव)।

सार्थकता स्तर (α) सीधे प्रकार-I त्रुटि की संभावना को नियंत्रित करता है। α को घटाने से प्रकार-I त्रुटि की संभावना कम होती है, पर प्रकार-II त्रुटि का जोखिम बढ़ सकता है।

इन त्रुटियों में संतुलन के लिए:

  1. प्रत्येक त्रुटि प्रकार के परिणामों के आधार पर सार्थकता स्तर समायोजित करें।
  2. परीक्षण की शक्ति बढ़ाने के लिए नमूना आकार बढ़ाएँ।
  3. जहाँ उपयुक्त हो, वन-टेल्ड टेस्ट का उपयोग करें।

फाइल ड्रावर प्रभाव

फाइल ड्रावर प्रभाव उस प्रकाशन पक्षपात को संदर्भित करता है जहाँ सार्थक (significant) परिणामों वाले अध्ययन, गैर-सार्थक परिणामों वाले अध्ययनों की तुलना में अधिक प्रकाशित होते हैं। इससे साहित्य में प्रभावों का अधिक आंकलन हो सकता है। इसे कम करने के लिए:

  • अध्ययनों का पूर्व-पंजीकरण करने पर विचार करें।
  • सभी परिणाम प्रकाशित करें, चाहे वे सार्थक हों या न हों।
  • प्रकाशन पक्षपात का हिसाब रखने वाले मेटा-विश्लेषण करें।
  • पहले से डेटा का सिमुलेशन करें।

प्रमुख शब्दावली और परिभाषाएँ

  • शून्य परिकल्पना (H0): डिफ़ॉल्ट मान्यता कि कोई प्रभाव या अंतर नहीं है।
  • वैकल्पिक परिकल्पना (Ha): परिकल्पना कि कोई प्रभाव या अंतर मौजूद है।
  • p-वैल्यू: शून्य परिकल्पना के अंतर्गत परीक्षण परिणामों के अवलोकन की संभावना।
  • सार्थकता स्तर (α): शून्य परिकल्पना को अस्वीकार करने की दहलीज, जो सामान्यतः 0.05 होती है।
  • टेस्ट स्टैटिस्टिक: एक मानकीकृत मान जो देखे गए डेटा की तुलना शून्य परिकल्पना से करने के लिए उपयोग होता है।
  • प्रकार-I त्रुटि: सत्य शून्य परिकल्पना को अस्वीकार करना (फॉल्स पॉज़िटिव)।
  • प्रकार-II त्रुटि: असत्य शून्य परिकल्पना को अस्वीकार करने में विफल रहना (फॉल्स नेगेटिव)।
  • सांख्यिकीय शक्ति: असत्य शून्य परिकल्पना को सही ढंग से अस्वीकार करने की संभावना।
  • कॉन्फिडेंस इंटरवल: मानों की वह सीमा जिसमें वास्तविक जनसंख्या पैरामीटर होने की संभावना है।
  • इफेक्ट साइज: परीक्षण किए जा रहे अंतर या संबंध की परिमाण का माप।

निष्कर्ष

याद रखें कि हाइपोथिसिस टेस्टिंग, सांख्यिकीय अनुमान टूलकिट का मात्र एक हिस्सा है। अपने निष्कर्षों के केवल सांख्यिकीय महत्व ही नहीं, बल्कि व्यावहारिक महत्व पर भी हमेशा विचार करें। अनुभव के साथ, आप विभिन्न वास्तविक जीवन परिदृश्यों में इन तकनीकों को कब और कैसे लागू करना है, यह समझने लगेंगे।

अपनी सांख्यिकीय विशेषज्ञता को और निखारने के लिए, आप How to Become a Statistician in 2024 जैसे विषयों का अन्वेषण कर सकते हैं, जो इस विकसित होते क्षेत्र और सफलता के लिए आवश्यक कौशलों पर अंतर्दृष्टि प्रदान करता है। इसके अतिरिक्त, Top 35 Statistics Interview Questions and Answers for 2024 का अभ्यास करना और हमारा Practicing Statistics Interview Questions in R कोर्स करना आपकी कौशल धार तेज करने और साक्षात्कार की तैयारी में मदद करेगा।


Vinod Chugani's photo
Author
Vinod Chugani
LinkedIn

विनोद चुगानी ने टोक्यो में जेपीमॉर्गन के सबसे कम उम्र के हेज फंड सेल्स डेस्क हेड के रूप में अपना करियर शुरू किया और बाद में लेहमन ब्रदर्स में व्यक्तिगत बिक्री का रिकॉर्ड बनाया, फिर 30 देशों में फैला एक इलेक्ट्रॉनिक्स डिस्ट्रीब्यूशन व्यवसाय बनाया, जिसकी आय SG$100 मिलियन से आगे बढ़ी, इसके बाद उन्होंने डेटा की ओर रुख किया। ड्यूक में अर्थशास्त्र के स्नातक और NYC डेटा साइंस अकादमी के पूर्व छात्र, वे मेवन पर ह्यूगो बोव्न-एंडरसन के Building AI Applications कोर्स के लिए 100+ आवेदनों में से तीन छात्रवृत्ति प्राप्तकर्ताओं में से एक थे। आज, वे DataCamp, KDnuggets, Machine Learning Mastery, और Statology के लिए सांख्यिकी से लेकर एजेंटिक एआई तक के विषयों पर लिखते हैं, और NYC डेटा साइंस अकादमी में डेटा प्रोफेशनलों को मेंटर करते हैं, उनके नाम पर 1,000 से अधिक एक-से-एक सत्र हैं।


अक्सर पूछे जाने वाले प्रश्न

हाइपोथिसिस टेस्ट करते समय वातावरण को नियंत्रित करना क्यों महत्वपूर्ण है?

हाइपोथिसिस टेस्ट के दौरान वातावरण को नियंत्रित करना उन बाहरी चर को न्यूनतम करता है जो परिणामों को प्रभावित कर सकते हैं। यह नियंत्रण सुनिश्चित करता है कि प्रयोग में देखे गए किसी भी प्रभाव को अधिक विश्वास के साथ अध्ययन किए जा रहे स्वतंत्र चर के कारण माना जा सके, न कि अन्य कारकों के कारण। इस तरह परीक्षण परिणामों की वैधता मजबूत होती है।

शून्य परिकल्पना क्या है?

शून्य परिकल्पना, जिसे अक्सर H0 के रूप में प्रदर्शित किया जाता है, एक डिफ़ॉल्ट मान्यता है कि परीक्षण किए जा रहे समूहों या शर्तों के बीच कोई प्रभाव या अंतर नहीं है। यह वह कथन है जिसे शोधकर्ता सांख्यिकीय विश्लेषण के माध्यम से गलत सिद्ध या निरस्त करना चाहते हैं। शून्य परिकल्पना को अस्वीकार करना या अस्वीकार करने में विफल रहना, चरों के बीच संबंधों पर प्रमुख अंतर्दृष्टि प्रदान करता है।

हाइपोथिसिस टेस्टिंग में p-वैल्यू का कॉन्फिडेंस इंटरवल से क्या संबंध है?

p-वैल्यू और कॉन्फिडेंस इंटरवल, दोनों का उपयोग नमूना डेटा के आधार पर जनसंख्या के बारे में निष्कर्ष निकालने के लिए किया जाता है। p-वैल्यू यह दर्शाती है कि यदि शून्य परिकल्पना सत्य है, तो नमूने में देखे गए जितने चरम परिणाम देखने की क्या संभावना है। दूसरी ओर, कॉन्फिडेंस इंटरवल उन मानों की एक सीमा प्रदान करते हैं जिसके भीतर वास्तविक जनसंख्या पैरामीटर के होने की संभावना है। यदि औसत अंतर या इफेक्ट साइज के लिए कॉन्फिडेंस इंटरवल में शून्य मान (उदा., शून्य अंतर) शामिल नहीं है, तो यह इंगित करता है कि दिए गए कॉन्फिडेंस स्तर पर शून्य परिकल्पना को अस्वीकार किया जा सकता है, जो कम p-वैल्यू के अनुरूप है।

प्रकार-I और प्रकार-II त्रुटियाँ क्या हैं?

प्रकार-I त्रुटि तब होती है जब शून्य परिकल्पना को गलत तरीके से अस्वीकार कर दिया जाता है, यानी अस्तित्वहीन प्रभाव का पता चलना (फॉल्स पॉज़िटिव)। प्रकार-II त्रुटि तब होती है जब शून्य परिकल्पना को गलत तरीके से अस्वीकार नहीं किया जाता, यानी वास्तविक प्रभाव छूट जाना (फॉल्स नेगेटिव)। इन त्रुटियों का संतुलन, ठोस सांख्यिकीय विश्लेषण के लिए अत्यंत महत्वपूर्ण है।

हाइपोथिसिस टेस्टिंग पर नमूना आकार का क्या प्रभाव होता है?

नमूना आकार सीधे हाइपोथिसिस टेस्ट की शक्ति को प्रभावित करता है, जो असत्य शून्य परिकल्पना को सही ढंग से अस्वीकार करने (प्रकार-II त्रुटि से बचने) की संभावना है। बड़े नमूना आकार आमतौर पर जनसंख्या पैरामीटर के अधिक सटीक और विश्वसनीय अनुमान प्रदान करते हैं, परीक्षण की शक्ति बढ़ाते हैं, और कॉन्फिडेंस इंटरवल में त्रुटि-सीमा को घटाते हैं।

अगर मेरा नमूना डेटा जनसंख्या का प्रतिनिधित्व नहीं करता तो क्या होगा?

यदि नमूना डेटा जनसंख्या का प्रतिनिधि नहीं है, तो हाइपोथिसिस टेस्ट के परिणाम पक्षपाती हो सकते हैं और व्यापक जनसंख्या पर लागू नहीं हो पाएँगे। यह चयन पक्षपात जैसे त्रुटिपूर्ण सैंपलिंग तरीकों का परिणाम हो सकता है, जो जनसंख्या की पूरी विविधता या विशेषताओं को समाहित नहीं करते।

पैरामीट्रिक बनाम नॉन-पैरामीट्रिक परीक्षणों में क्या अंतर है?

पैरामीट्रिक टेस्ट मानते हैं कि डेटा किसी विशिष्ट वितरण का अनुसरण करता है। नॉन-पैरामीट्रिक टेस्ट डेटा के लिए किसी विशिष्ट वितरण को नहीं मानते। इनका उपयोग तब किया जाता है जब क्रमबद्ध डेटा से निपटना हो, डेटा सामान्य रूप से वितरित न हो, या नमूना आकार छोटे हों।

सांख्यिकीय सार्थकता और व्यावहारिक सार्थकता में क्या अंतर है?

जहाँ सांख्यिकीय सार्थकता हमें बताती है कि कोई प्रभाव संयोग से होने की कितनी संभावना है, वहीं व्यावहारिक सार्थकता वास्तविक जीवन की शर्तों में उस प्रभाव के वास्तविक प्रभाव या प्रासंगिकता को संबोधित करती है। यदि इफेक्ट साइज वास्तविक दुनिया में अर्थपूर्ण होने के लिए बहुत छोटा हो, तो परिणाम सांख्यिकीय रूप से सार्थक होते हुए भी व्यावहारिक रूप से सार्थक न हो सकता है।

विषय
डेटा विश्लेषण
डेटा साइंस

DataCamp के साथ हाइपोथिसिस टेस्टिंग सीखें

कोर्स

Python में Hypothesis Testing

4 घंटा
61.7K
Python में t-tests, proportion tests, और chi-square tests जैसे common hypothesis tests का उपयोग कब और कैसे करें, सीखें।
विवरण देखेंRight Arrow
पाठ्यक्रम शुरू करें

कोर्स

Google Sheets में Statistics परिचय

4 घंटा
48.3K
स्प्रेडशीट्स का उपयोग करके सांख्यिकीय तकनीकों का लाभ उठाना सीखें, ताकि आप अपने डेटा के साथ अधिक प्रभावी ढंग से काम कर सकें और उससे अंतर्दृष्टि निकाल सकें।
और देखेंRight Arrow