कोर्स
Llama 3 के साथ काम करना
2 घंटा
15.6K
Llama Stack एक फ़्रेमवर्क है जिसे Meta के Llama मॉडलों पर बने जनरेटिव AI ऐप्लिकेशन के विकास और परिनियोजन को सुव्यवस्थित करने के लिए बनाया गया है। यह इन्फ़रेंस, सेफ़्टी, मेमोरी मैनेजमेंट और एजेंट क्षमताओं जैसे कार्यों के लिए मानकीकृत API और कॉम्पोनेंट्स का एक संग्रह उपलब्ध कराकर यह लक्ष्य हासिल करता है।
इसके लक्ष्य और लाभ इस प्रकार हैं:
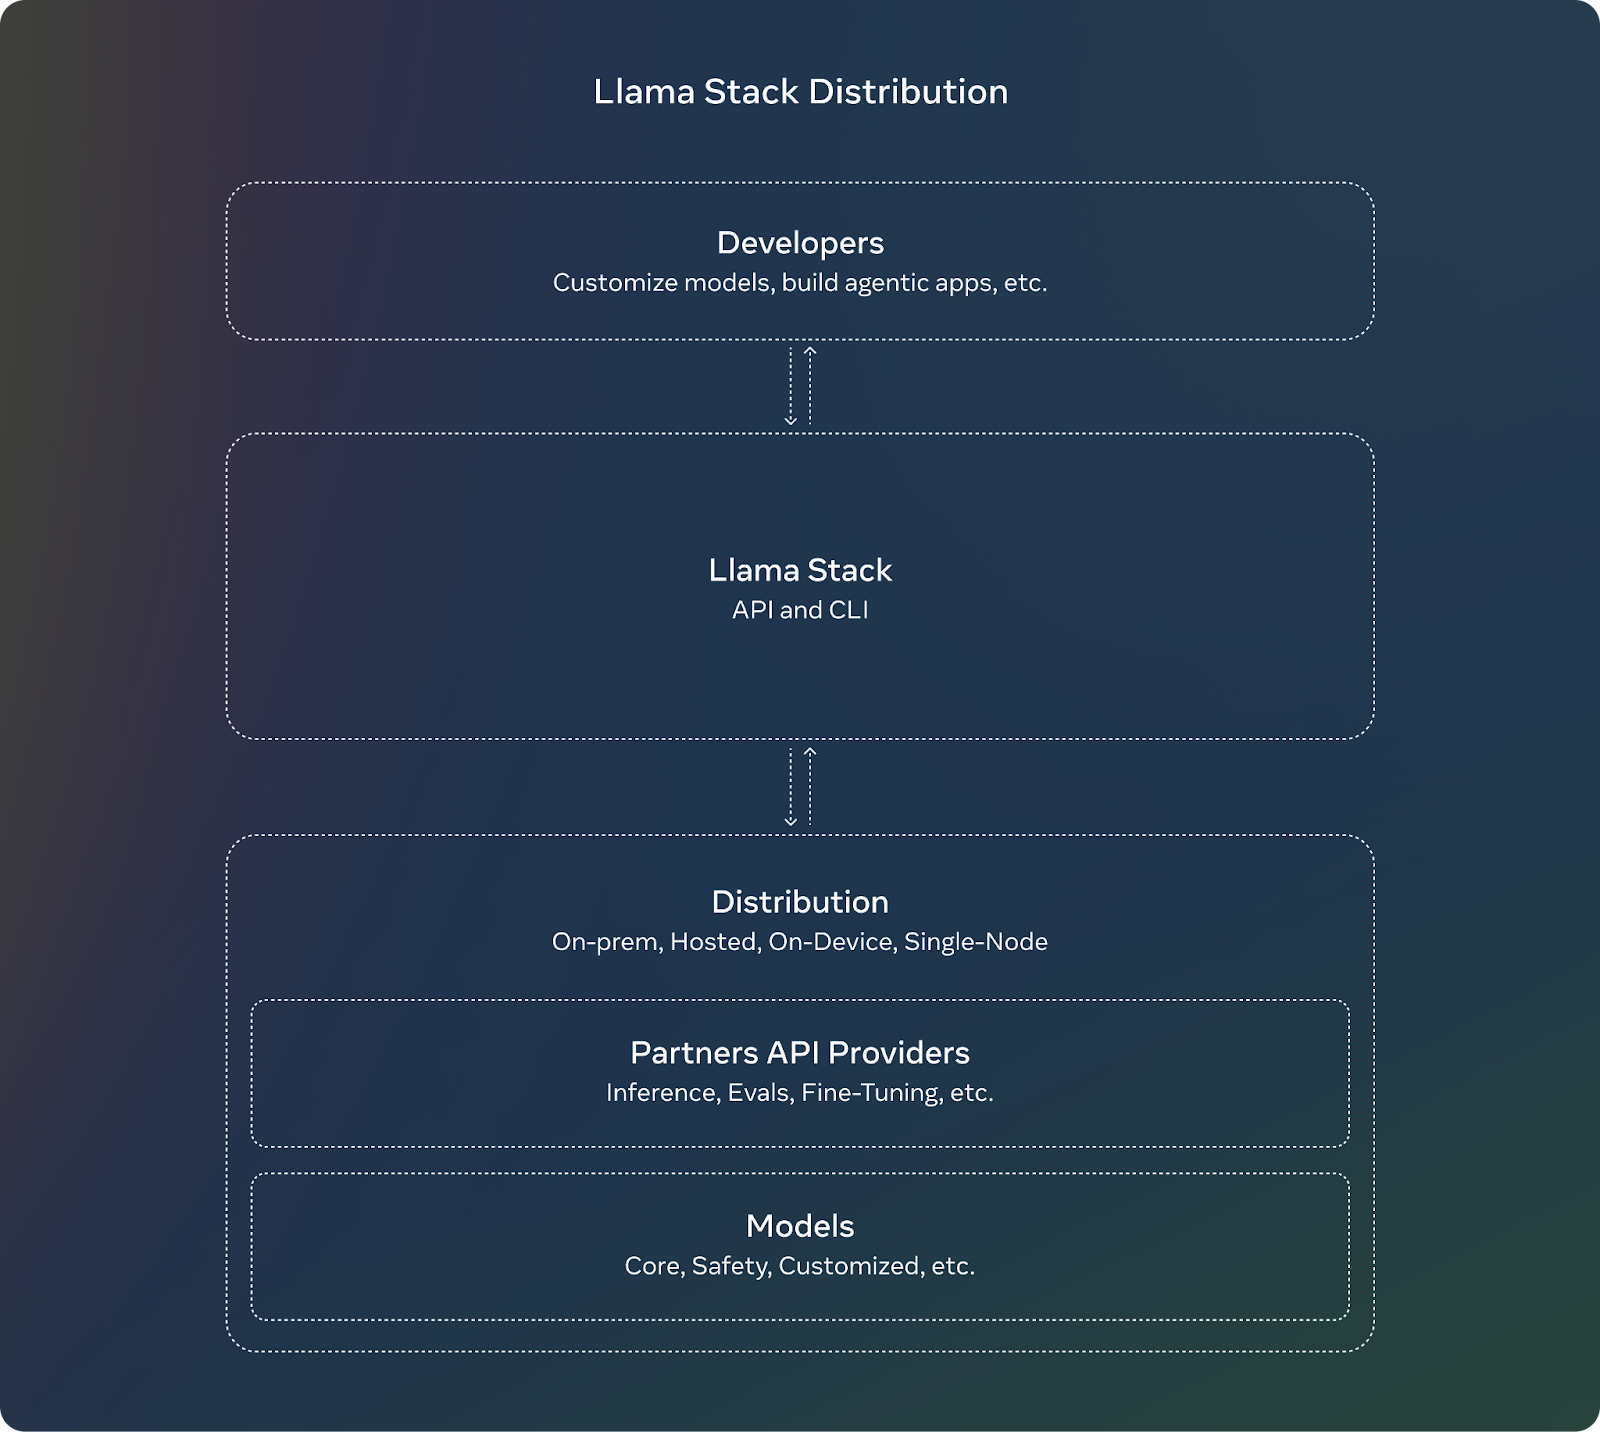
स्रोत: Meta AI
Llama Stack कई API के साथ आता है, जिनमें से प्रत्येक जनरेटिव AI ऐप्लिकेशन बनाने के विशिष्ट कार्यों को लक्षित करता है।
Inference API पाठ निर्माण या मल्टी-मॉडल Llama वेरिएंट्स को प्रॉम्प्ट करने को संभालता है। इसकी प्रमुख विशेषताएँ:
API विभिन्न कॉन्फ़िगरेशन परिभाषित करता है, जो डेवलपर्स को अपनी ऐप्लिकेशन आवश्यकताओं के आधार पर मॉडल व्यवहार नियंत्रित करने देते हैं (उदा., FP8 या BF16 क्वांटाइज़ेशन)।
Safety API AI मॉडलों के जिम्मेदार परिनियोजन के लिए बनाया गया है, जो सामग्री का मॉडरेशन करता है और हानिकारक या संभावित रूप से पक्षपाती आउटपुट को फ़िल्टर करता है। यह उल्लंघन स्तरों (उदा., INFO, WARN, ERROR) को परिभाषित करने और उपयोगकर्ताओं को क्रियात्मक संदेश लौटाने के लिए कॉन्फ़िगर किया जा सकता है।
Memory API पिछली बातचीत को सहेजने और संदर्भित करने की क्षमता देता है ताकि प्रसंग-सचेत, अधिक सुसंगत वार्तालाप हो सकें। मेमोरी कॉन्फ़िगरेशनों की विविधता डेवलपर्स को ऐप्लिकेशन की ज़रूरतों के आधार पर स्टोरेज प्रकार चुनने का विकल्प देती है। इसकी प्रमुख विशेषताएँ:
Agentic API LLMs को बाहरी टूल्स और फ़ंक्शनों का उपयोग करने में सक्षम बनाता है, जिससे वे वेब सर्च, कोड निष्पादन, या मेमोरी पुनर्प्राप्ति जैसे कार्य कर सकें। API डेवलपर्स को विशिष्ट टूल्स और लक्ष्यों के साथ एजेंट्स कॉन्फ़िगर करने देता है। यह मल्टी-टर्न इंटरैक्शन का समर्थन करता है जहाँ प्रत्येक टर्न में कई चरण होते हैं। इसकी प्रमुख विशेषताएँ:
यहाँ अन्य API हैं जो Llama Stack प्रदान करता है:
हम Llama Stack पर एक सैंपल प्रोजेक्ट लागू करेंगे ताकि इस फ़्रेमवर्क के सामान्य विचार और क्षमताओं से परिचित हो सकें।
शुरू करने से पहले, कृपया ध्यान दें कि:
आइए Llama कमांड-लाइन इंटरफ़ेस (CLI) सेटअप करने से शुरू करें।
Llama Stack वितरण प्रबंधित करने, मॉडल इंस्टॉल करने और परिवेश कॉन्फ़िगर करने के लिए एक कमांड-लाइन इंटरफ़ेस (CLI) प्रदान करता है। यहाँ इंस्टॉलेशन चरण दिए गए हैं:
a. वर्चुअल एनवायरनमेंट बनाएँ और सक्रिय करें:
conda create -n llama_stack python=3.10
conda activate llama_stack
b. Llama Stack रिपॉज़िटरी को क्लोन करें:
git clone <https://github.com/meta-llama/llama-stack.git>
cd llama-stack
c. आवश्यक डिपेंडेंसीज़ इंस्टॉल करें:
pip install llama-stack
pip install -r requirements.txtDocker कंटेनर Llama Stack सर्वर और एजेंट API प्रदाताओं के परिनियोजन को सरल बनाते हैं। आसान सेटअप के लिए प्री-बिल्ट Docker इमेज उपलब्ध हैं:
docker pull llamastack/llamastack-local-gpu
llama stack build
llama stack configure llamastack-local-gpu
ये कमांड Docker इमेज को पुल करते हैं, उसे बिल्ड करते हैं और स्टैक को कॉन्फ़िगर करते हैं।
आइए Llama Stack API का उपयोग करके एक बुनियादी चैटबॉट बनाएँ। हमें ये चरण अपनाने होंगे:
हम सर्वर को पोर्ट 5000 पर चलाएँगे। API के साथ काम करने से पहले सुनिश्चित करें कि सर्वर चल रहा है:
llama stack run local-gpu --port 5000Llama Stack इंस्टॉल करने के बाद, आप इसके API से इंटरैक्ट करने के लिए क्लाइंट कोड का उपयोग कर सकते हैं। उपयोगकर्ता इनपुट के आधार पर प्रतिक्रियाएँ जनरेट करने के लिए Inference API का उपयोग करें:
from llama_stack_client import LlamaStackClient
client = LlamaStackClient(base_url="<http://localhost:5000>")
user_input = "Hello! How are you?"
response = client.inference.chat_completion(
    model="Llama3.1-8B-Instruct",
    messages=[{"role": "user", "content": user_input}],
    stream=False
)
print("Bot:", response.text)
नोट: अपने सेटअप में उपलब्ध वास्तविक मॉडल नाम से "Llama3.1-8B-Instruct" को बदलें।
प्रतिक्रियाओं का मॉडरेशन करने और उन्हें उपयुक्त बनाए रखने के लिए Safety API लागू करें:
safety_response = client.safety.run_shield(
    messages=[{"role": "assistant", "content": response.text}],
    shield_type="llama_guard",
    params={}
)
if safety_response.violation:
    print("Unsafe content detected.")
else:
print("Bot:", response.text)बातचीत के इतिहास को सहेजकर और पुनर्प्राप्त करके चैटबॉट की संदर्भ-जागरूकता बनाएँ:
### building a memory bank that can be used to store and retrieve context.
bank = client.memory.create_memory_bank(
    name="chat_memory",
    config=VectorMemoryBankConfig(
        type="vector",
        embedding_model="all-MiniLM-L6-v2",
        chunk_size_in_tokens=512,
        overlap_size_in_tokens=64,
    )
)हम API को और भी संयोजित करके एक सुदृढ़ चैटबॉट बना सकते हैं:
सभी चरण पूरे करने के बाद पूर्ण कोड यह है:
import uuid
client = LlamaStackClient(base_url="<http://localhost:5000>")
### create a memory bank at the start
bank = client.memory.create_memory_bank(
    name="chat_memory",
    config=VectorMemoryBankConfig(
        type="vector",
        embedding_model="all-MiniLM-L6-v2",
        chunk_size_in_tokens=512,
        overlap_size_in_tokens=64,
    )
)
def get_bot_response(user_input):
    ### retrieving conversation history
    query_response = client.memory.query_documents(
        bank_id=bank.bank_id,
        query=[user_input],
        params={"max_chunks": 10}
    )
    history = [chunk.content for chunk in query_response.chunks]
    ### preparing messages with history
    messages = [{"role": "user", "content": user_input}]
    if history:
        messages.insert(0, {"role": "system", "content": "\\n".join(history)})

    ### generate response
    response = client.inference.chat_completion(
        model="llama-2-7b-chat",
        messages=messages,
        stream=False
    )
    bot_response = response.text
    ### safety check
    safety_response = client.safety.run_shield(
        messages=[{"role": "assistant", "content": bot_response}],
        shield_type="llama_guard",
        params={}
    )
    if safety_response.violation:
        return "I'm sorry, but I can't assist with that request."
    ### memory storing
    documents = [
        MemoryBankDocument(
            document_id=str(uuid.uuid4()),
            content=user_input,
            mime_type="text/plain"
        ),
        MemoryBankDocument(
            document_id=str(uuid.uuid4()),
            content=bot_response,
            mime_type="text/plain"
        )
    ]
    client.memory.insert_documents(
        bank_id=bank.bank_id,
        documents=documents
    )
    return bot_response
### putting all together
while True:
    user_input = input("You: ")
    if user_input.lower() == "bye":
        break
    bot_response = get_bot_response(user_input)
print("Bot:", bot_response)कुछ उदाहरण देखने और Llama Stack का उपयोग करके अपने ऐप्लिकेशन के कार्यान्वयन की शुरुआत करने के लिए, Meta ने llama-stack-apps रिपॉज़िटरी उपलब्ध कराई है, जहाँ आप कुछ उदाहरण ऐप्लिकेशन देख सकते हैं। फ़्रेमवर्क को ज़रूर देखें और उससे परिचित हों।
एक ओपन-सोर्स प्रोजेक्ट के रूप में, Llama Stack समुदाय के योगदान पर निर्भर है। API तेज़ी से विकसित हो रहे हैं, और प्रोजेक्ट डेवलपर्स से फ़ीडबैक और भागीदारी का स्वागत करता है, जो प्लेटफ़ॉर्म के भविष्य को आकार देने में मदद करता है। यदि आप Llama Stack को आज़माते हैं, तो अपना प्रोजेक्ट उदाहरण के रूप में साझा करना या डॉ큐मेंटेशन में योगदान देना अन्य डेवलपर्स की भी मदद कर सकता है।
पूरे लेख में, हमने चरण-दर-चरण निर्देशों के साथ Llama Stack शुरू करने का तरीका देखा।
जैसे-जैसे आप अपने AI ऐप्लिकेशन परिनियोजित करते हैं, नवीनतम अपडेट और सुधारों के लिए Llama Stack रिपॉज़िटरी पर नज़र बनाए रखें।
Llama इकोसिस्टम के बारे में अधिक जानने के लिए, निम्न संसाधन देखें:
इन कोर्सों के साथ AI सीखें!
कोर्स
कोर्स
कोर्स