{count, plural, one {Corso} other {Corsi}}
Lavorare con Llama 3
{hours} ore
15.6K
Llama Stack è un framework pensato per semplificare lo sviluppo e la distribuzione di applicazioni di IA generativa costruite sopra i modelli Llama di Meta. Lo fa fornendo una raccolta di API e componenti standardizzati per attività come inferenza, sicurezza, gestione della memoria e capacità agentiche.
Ecco obiettivi e vantaggi:
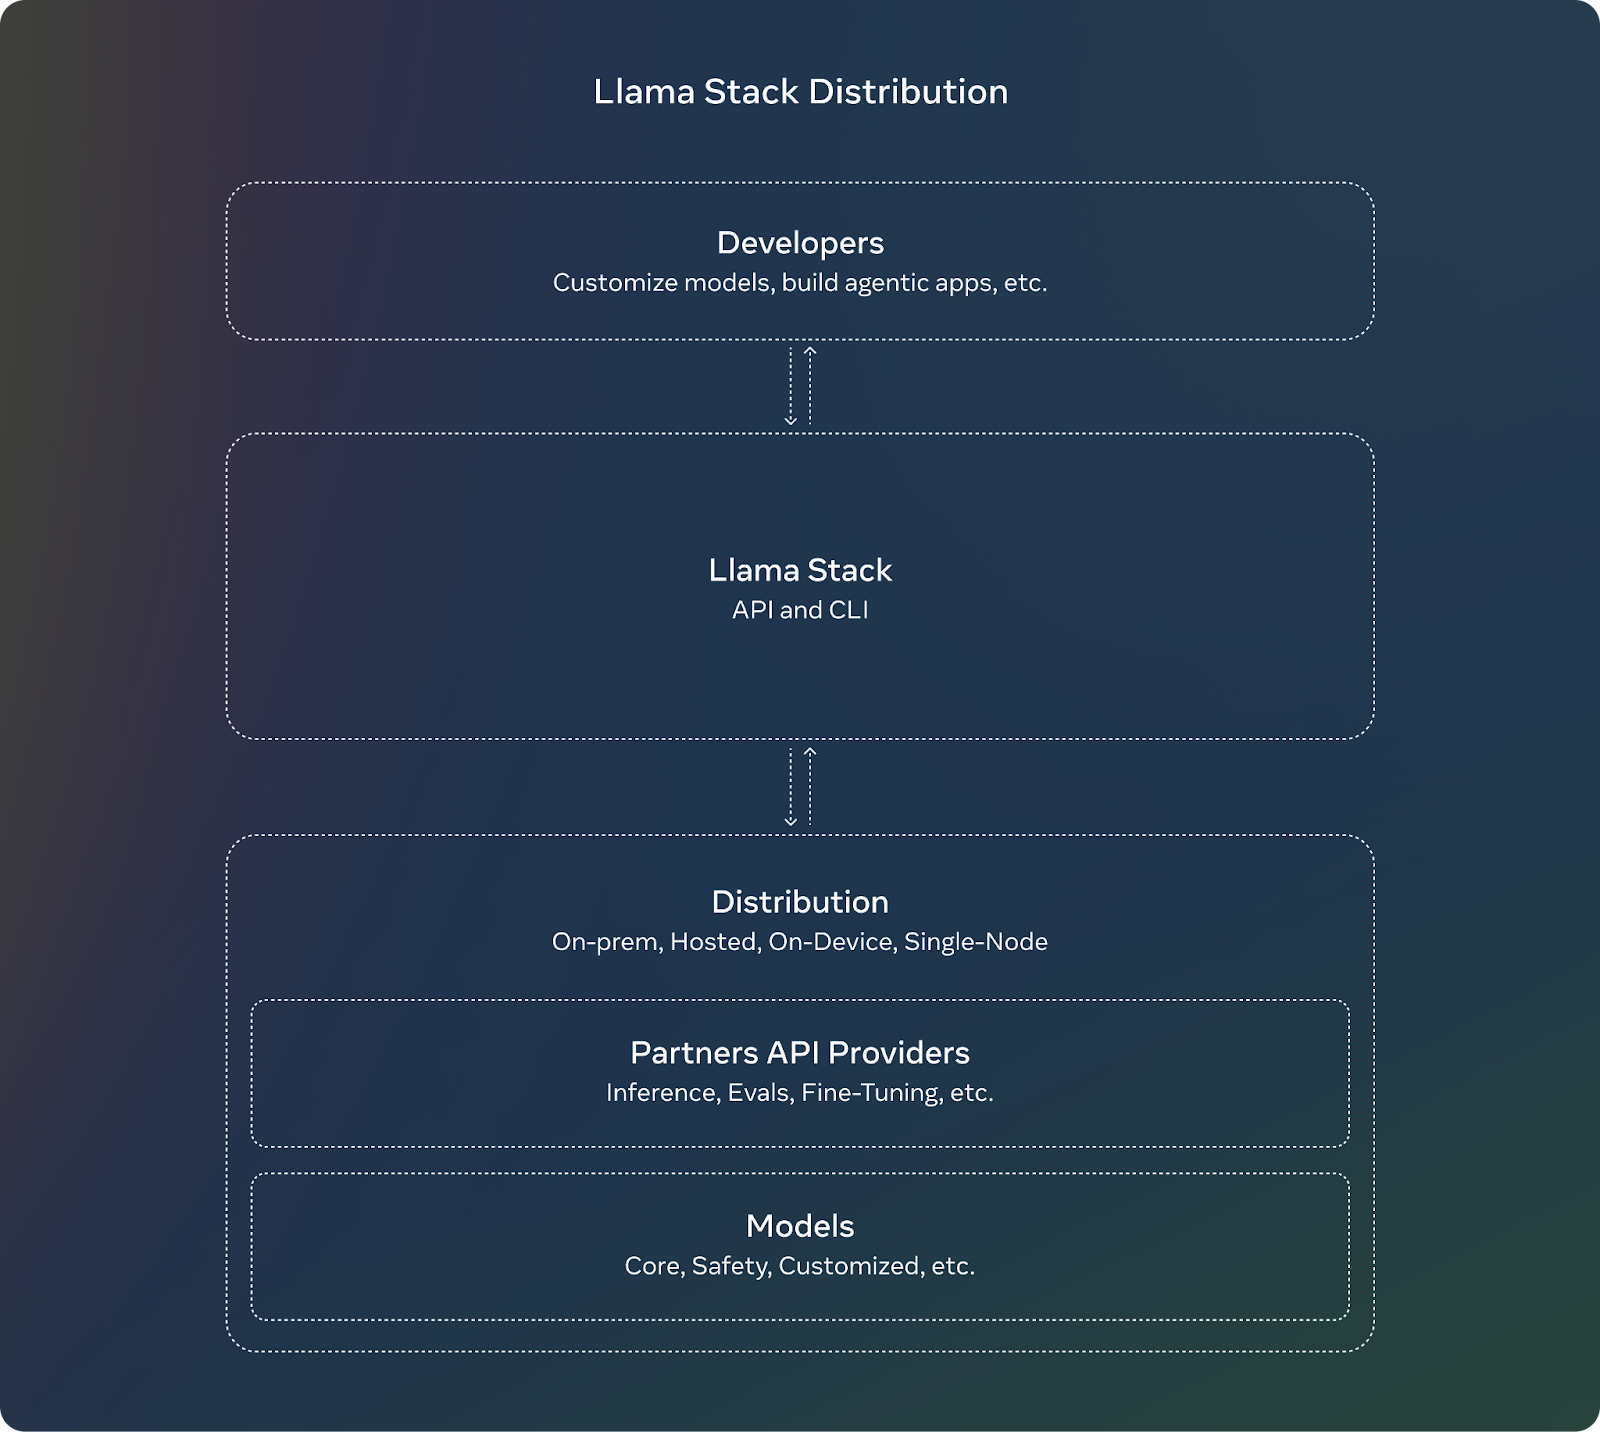
Fonte: Meta AI
Llama Stack include diverse API, ciascuna mirata a uno specifico insieme di attività nella costruzione di un'applicazione di IA generativa.
L'Inference API gestisce la generazione di testo o il prompting multimodale delle varianti di Llama. Le sue caratteristiche principali sono:
L'API definisce varie configurazioni che consentono agli sviluppatori di controllare il comportamento del modello (ad es. quantizzazione FP8 o BF16) in base ai requisiti dell'applicazione.
La Safety API è pensata per la distribuzione responsabile dei modelli di IA tramite moderazione dei contenuti e filtraggio di output dannosi o potenzialmente faziosi. È configurabile per definire livelli di violazione (ad es. INFO, WARN, ERROR) e per restituire messaggi azionabili agli utenti.
La Memory API offre la possibilità di conservare e richiamare interazioni passate e creare conversazioni più coerenti e consapevoli del contesto. La varietà di configurazioni di memoria dà agli sviluppatori l'opzione di scegliere i tipi di archiviazione in base alle esigenze dell'applicazione. Le sue caratteristiche principali sono:
La Agentic API abilita gli LLM a usare strumenti e funzioni esterni, consentendo loro di svolgere attività come ricerca sul web, esecuzione di codice o recupero della memoria. L'API permette agli sviluppatori di configurare agent con strumenti e obiettivi specifici. Supporta interazioni multi-turno in cui ogni turno è composto da più passaggi. Le sue caratteristiche principali sono:
Ecco le altre API offerte da Llama Stack:
Implementeremo un progetto di esempio su Llama Stack per familiarizzare con l'idea generale e le capacità di questo framework.
Prima di iniziare, tieni presente che:
Iniziamo configurando la CLI (Command-Line Interface) di Llama.
Llama Stack fornisce un'interfaccia a riga di comando (CLI) per gestire distribuzioni, installare modelli e configurare ambienti. Ecco i passaggi di installazione necessari:
a. Crea e attiva un ambiente virtuale:
conda create -n llama_stack python=3.10
conda activate llama_stack
b. Clona il repository Llama Stack:
git clone <https://github.com/meta-llama/llama-stack.git>
cd llama-stack
c. Installa le dipendenze richieste:
pip install llama-stack
pip install -r requirements.txtI container Docker semplificano la distribuzione del server Llama Stack e dei provider dell'Agent API. Sono disponibili immagini Docker precompilate per una configurazione semplice:
docker pull llamastack/llamastack-local-gpu
llama stack build
llama stack configure llamastack-local-gpu
Questi comandi scaricano l'immagine Docker, la compilano e configurano lo stack.
Costruiamo un chatbot di base usando le API di Llama Stack. Ecco i passaggi da seguire:
Eseguiremo il server sulla porta 5000. Assicurati che il server sia in esecuzione prima di lavorare con le API:
llama stack run local-gpu --port 5000Dopo aver installato Llama Stack, puoi usare del client code per interagire con le sue API. Usa l'Inference API per generare risposte basate sull'input dell'utente:
from llama_stack_client import LlamaStackClient
client = LlamaStackClient(base_url="<http://localhost:5000>")
user_input = "Hello! How are you?"
response = client.inference.chat_completion(
    model="Llama3.1-8B-Instruct",
    messages=[{"role": "user", "content": user_input}],
    stream=False
)
print("Bot:", response.text)
Nota: sostituisci "Llama3.1-8B-Instruct" con il nome effettivo del modello disponibile nella tua configurazione.
Implementa la Safety API per moderare le risposte e garantire che siano appropriate:
safety_response = client.safety.run_shield(
    messages=[{"role": "assistant", "content": response.text}],
    shield_type="llama_guard",
    params={}
)
if safety_response.violation:
    print("Unsafe content detected.")
else:
print("Bot:", response.text)Crea la consapevolezza del contesto del chatbot memorizzando e recuperando la cronologia della conversazione:
### building a memory bank that can be used to store and retrieve context.
bank = client.memory.create_memory_bank(
    name="chat_memory",
    config=VectorMemoryBankConfig(
        type="vector",
        embedding_model="all-MiniLM-L6-v2",
        chunk_size_in_tokens=512,
        overlap_size_in_tokens=64,
    )
)Possiamo combinare ulteriormente le API per costruire un chatbot robusto:
Ecco il codice completo dopo aver coperto tutti i passaggi:
import uuid
client = LlamaStackClient(base_url="<http://localhost:5000>")
### create a memory bank at the start
bank = client.memory.create_memory_bank(
    name="chat_memory",
    config=VectorMemoryBankConfig(
        type="vector",
        embedding_model="all-MiniLM-L6-v2",
        chunk_size_in_tokens=512,
        overlap_size_in_tokens=64,
    )
)
def get_bot_response(user_input):
    ### retrieving conversation history
    query_response = client.memory.query_documents(
        bank_id=bank.bank_id,
        query=[user_input],
        params={"max_chunks": 10}
    )
    history = [chunk.content for chunk in query_response.chunks]
    ### preparing messages with history
    messages = [{"role": "user", "content": user_input}]
    if history:
        messages.insert(0, {"role": "system", "content": "\\n".join(history)})

    ### generate response
    response = client.inference.chat_completion(
        model="llama-2-7b-chat",
        messages=messages,
        stream=False
    )
    bot_response = response.text
    ### safety check
    safety_response = client.safety.run_shield(
        messages=[{"role": "assistant", "content": bot_response}],
        shield_type="llama_guard",
        params={}
    )
    if safety_response.violation:
        return "I'm sorry, but I can't assist with that request."
    ### memory storing
    documents = [
        MemoryBankDocument(
            document_id=str(uuid.uuid4()),
            content=user_input,
            mime_type="text/plain"
        ),
        MemoryBankDocument(
            document_id=str(uuid.uuid4()),
            content=bot_response,
            mime_type="text/plain"
        )
    ]
    client.memory.insert_documents(
        bank_id=bank.bank_id,
        documents=documents
    )
    return bot_response
### putting all together
while True:
    user_input = input("You: ")
    if user_input.lower() == "bye":
        break
    bot_response = get_bot_response(user_input)
print("Bot:", bot_response)Per vedere alcuni esempi e avviare rapidamente la tua implementazione di applicazioni usando Llama Stack, Meta ha messo a disposizione il repository llama-stack-apps dove puoi consultare alcune applicazioni di esempio. Assicurati di dare un'occhiata e familiarizzare con il framework.
In quanto progetto open-source, Llama Stack vive dei contributi della community. Le API si evolvono rapidamente e il progetto è aperto a feedback e partecipazione da parte degli sviluppatori, contribuendo a plasmare il futuro della piattaforma. Se provi Llama Stack, puoi aiutare altri sviluppatori condividendo il tuo progetto come esempio o contribuendo alla documentazione.
In questo articolo abbiamo visto come iniziare con Llama Stack tramite istruzioni passo passo.
Man mano che procedi nella distribuzione delle tue applicazioni di IA, ricorda di tenere d'occhio il repository Llama Stack per gli ultimi aggiornamenti e miglioramenti.
Per saperne di più sull'ecosistema Llama, consulta le seguenti risorse:
Impara l'IA con questi corsi!
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min



