Khóa học
Làm việc với Llama 3
2 giờ
15.8K
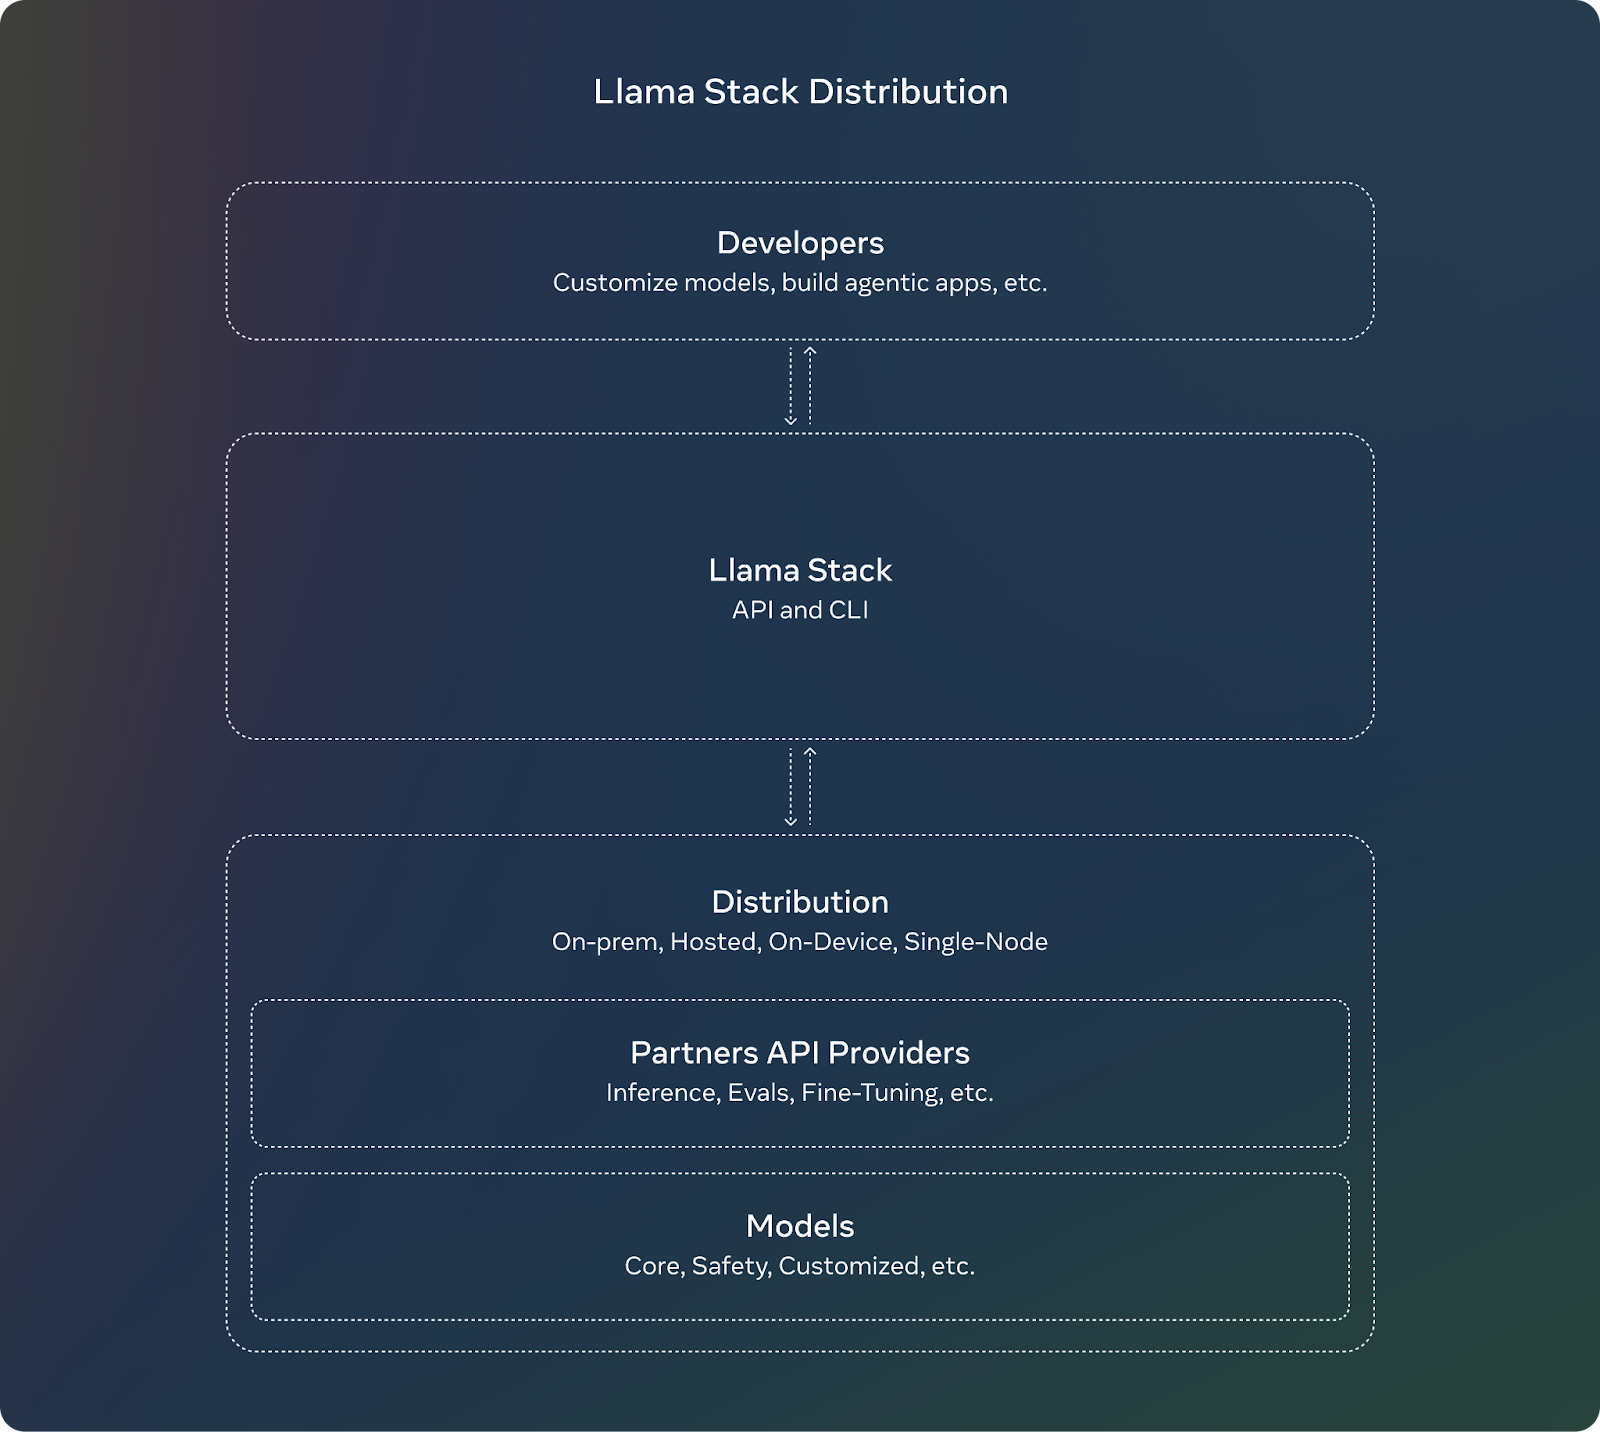
Llama Stack là một framework được xây dựng để tối ưu quy trình phát triển và triển khai các ứng dụng AI tạo sinh dựa trên các mô hình Llama của Meta. Nó đạt được điều này bằng cách cung cấp tập hợp API và thành phần tiêu chuẩn hóa cho các tác vụ như suy luận, an toàn, quản lý bộ nhớ và năng lực agent.
Các mục tiêu và lợi ích:
Nguồn: Meta AI
Llama Stack đi kèm nhiều API, mỗi API nhắm đến một nhóm tác vụ cụ thể khi xây dựng ứng dụng AI tạo sinh.
Inference API xử lý sinh văn bản hoặc nhắc lệnh các biến thể Llama đa phương thức. Các đặc điểm chính:
API định nghĩa nhiều cấu hình cho phép nhà phát triển kiểm soát hành vi mô hình (ví dụ, lượng tử hóa FP8 hoặc BF16) dựa trên yêu cầu ứng dụng.
Safety API được xây dựng nhằm triển khai AI có trách nhiệm thông qua kiểm duyệt nội dung và lọc các đầu ra gây hại hoặc tiềm ẩn thiên lệch. Có thể cấu hình mức độ vi phạm (ví dụ: INFO, WARN, ERROR) và trả về thông điệp có thể hành động cho người dùng.
Memory API trao khả năng lưu giữ và tham chiếu tương tác trước đó để tạo hội thoại mạch lạc hơn và nhận biết ngữ cảnh. Nhiều cấu hình bộ nhớ cho phép lựa chọn kiểu lưu trữ theo nhu cầu ứng dụng. Các đặc điểm chính:
Agentic API cho phép LLM sử dụng công cụ và hàm bên ngoài, từ đó thực hiện các tác vụ như tìm kiếm web, chạy mã hoặc truy xuất bộ nhớ. API cho phép nhà phát triển cấu hình agent với công cụ và mục tiêu cụ thể. Hỗ trợ tương tác nhiều lượt, mỗi lượt gồm nhiều bước. Các đặc điểm chính:
Các API khác mà Llama Stack cung cấp:
Chúng ta sẽ triển khai một dự án mẫu trên Llama Stack để làm quen với ý tưởng chung và năng lực của framework này.
Trước khi bắt đầu, lưu ý rằng:
Hãy bắt đầu với việc thiết lập giao diện dòng lệnh (CLI) của Llama.
Llama Stack cung cấp giao diện dòng lệnh (CLI) để quản lý bản phân phối, cài đặt mô hình và cấu hình môi trường. Các bước cài đặt như sau:
a. Tạo và kích hoạt môi trường ảo:
conda create -n llama_stack python=3.10
conda activate llama_stack
b. Clone kho Llama Stack:
git clone <https://github.com/meta-llama/llama-stack.git>
cd llama-stack
c. Cài đặt các phụ thuộc cần thiết:
pip install llama-stack
pip install -r requirements.txtDocker giúp đơn giản hóa việc triển khai máy chủ Llama Stack và các nhà cung cấp Agent API. Ảnh Docker dựng sẵn có sẵn để thiết lập dễ dàng:
docker pull llamastack/llamastack-local-gpu
llama stack build
llama stack configure llamastack-local-gpu
Các lệnh này tải ảnh Docker, build và cấu hình stack.
Hãy xây dựng một chatbot cơ bản bằng các API của Llama Stack. Các bước thực hiện:
Chúng ta sẽ chạy máy chủ trên cổng 5000. Hãy đảm bảo máy chủ đang chạy trước khi làm việc với API:
llama stack run local-gpu --port 5000Sau khi cài đặt Llama Stack, bạn có thể dùng mã client để tương tác với các API. Dùng Inference API để sinh phản hồi dựa trên đầu vào người dùng:
from llama_stack_client import LlamaStackClient
client = LlamaStackClient(base_url="<http://localhost:5000>")
user_input = "Hello! How are you?"
response = client.inference.chat_completion(
    model="Llama3.1-8B-Instruct",
    messages=[{"role": "user", "content": user_input}],
    stream=False
)
print("Bot:", response.text)
Lưu ý: Thay "Llama3.1-8B-Instruct" bằng tên mô hình thực tế có trong thiết lập của bạn.
Triển khai Safety API để kiểm duyệt phản hồi và đảm bảo chúng phù hợp:
safety_response = client.safety.run_shield(
    messages=[{"role": "assistant", "content": response.text}],
    shield_type="llama_guard",
    params={}
)
if safety_response.violation:
    print("Unsafe content detected.")
else:
print("Bot:", response.text)Tạo khả năng nhận biết ngữ cảnh cho chatbot bằng cách lưu và truy xuất lịch sử hội thoại:
### building a memory bank that can be used to store and retrieve context.
bank = client.memory.create_memory_bank(
    name="chat_memory",
    config=VectorMemoryBankConfig(
        type="vector",
        embedding_model="all-MiniLM-L6-v2",
        chunk_size_in_tokens=512,
        overlap_size_in_tokens=64,
    )
)Chúng ta có thể kết hợp thêm các API để xây chatbot vững chắc hơn:
Dưới đây là mã hoàn chỉnh sau khi thực hiện tất cả các bước:
import uuid
client = LlamaStackClient(base_url="<http://localhost:5000>")
### create a memory bank at the start
bank = client.memory.create_memory_bank(
    name="chat_memory",
    config=VectorMemoryBankConfig(
        type="vector",
        embedding_model="all-MiniLM-L6-v2",
        chunk_size_in_tokens=512,
        overlap_size_in_tokens=64,
    )
)
def get_bot_response(user_input):
    ### retrieving conversation history
    query_response = client.memory.query_documents(
        bank_id=bank.bank_id,
        query=[user_input],
        params={"max_chunks": 10}
    )
    history = [chunk.content for chunk in query_response.chunks]
    ### preparing messages with history
    messages = [{"role": "user", "content": user_input}]
    if history:
        messages.insert(0, {"role": "system", "content": "\\n".join(history)})

    ### generate response
    response = client.inference.chat_completion(
        model="llama-2-7b-chat",
        messages=messages,
        stream=False
    )
    bot_response = response.text
    ### safety check
    safety_response = client.safety.run_shield(
        messages=[{"role": "assistant", "content": bot_response}],
        shield_type="llama_guard",
        params={}
    )
    if safety_response.violation:
        return "I'm sorry, but I can't assist with that request."
    ### memory storing
    documents = [
        MemoryBankDocument(
            document_id=str(uuid.uuid4()),
            content=user_input,
            mime_type="text/plain"
        ),
        MemoryBankDocument(
            document_id=str(uuid.uuid4()),
            content=bot_response,
            mime_type="text/plain"
        )
    ]
    client.memory.insert_documents(
        bank_id=bank.bank_id,
        documents=documents
    )
    return bot_response
### putting all together
while True:
    user_input = input("You: ")
    if user_input.lower() == "bye":
        break
    bot_response = get_bot_response(user_input)
print("Bot:", bot_response)Để xem một số ví dụ và bắt đầu nhanh việc triển khai ứng dụng dùng Llama Stack, Meta đã cung cấp kho llama-stack-apps nơi bạn có thể tham khảo một số ứng dụng mẫu. Hãy kiểm tra và làm quen với framework.
Là một dự án mã nguồn mở, Llama Stack sống nhờ vào sự đóng góp của cộng đồng. Các API đang phát triển nhanh chóng và dự án sẵn sàng đón nhận phản hồi, sự tham gia của nhà phát triển để định hình tương lai nền tảng. Nếu bạn thử Llama Stack, việc chia sẻ dự án của mình như một ví dụ hoặc đóng góp tài liệu sẽ giúp ích cho cộng đồng.
Xuyên suốt bài viết, chúng ta đã tìm hiểu cách bắt đầu với Llama Stack qua các bước hướng dẫn cụ thể.
Khi tiến tới triển khai ứng dụng AI, hãy chú ý theo dõi kho Llama Stack để cập nhật những cải tiến mới nhất.
Để tìm hiểu thêm về hệ sinh thái Llama, hãy xem các tài nguyên sau:
Học AI với các khóa học này!
Khóa học
Khóa học
Khóa học