{count, plural, one {Kurs} other {Kurs}}
Llama 3 ile Çalışmak
{hours} sa
15.6K
Llama Stack, Meta’nın Llama modelleri üzerine inşa edilen üretken yapay zekâ uygulamalarının geliştirilmesini ve dağıtımını kolaylaştırmak için oluşturulmuş bir çerçevedir. Bunu, çıkarım, güvenlik, bellek yönetimi ve ajan yetenekleri gibi görevler için standartlaştırılmış API’ler ve bileşenler sunarak başarır.
İşte hedefleri ve faydaları:
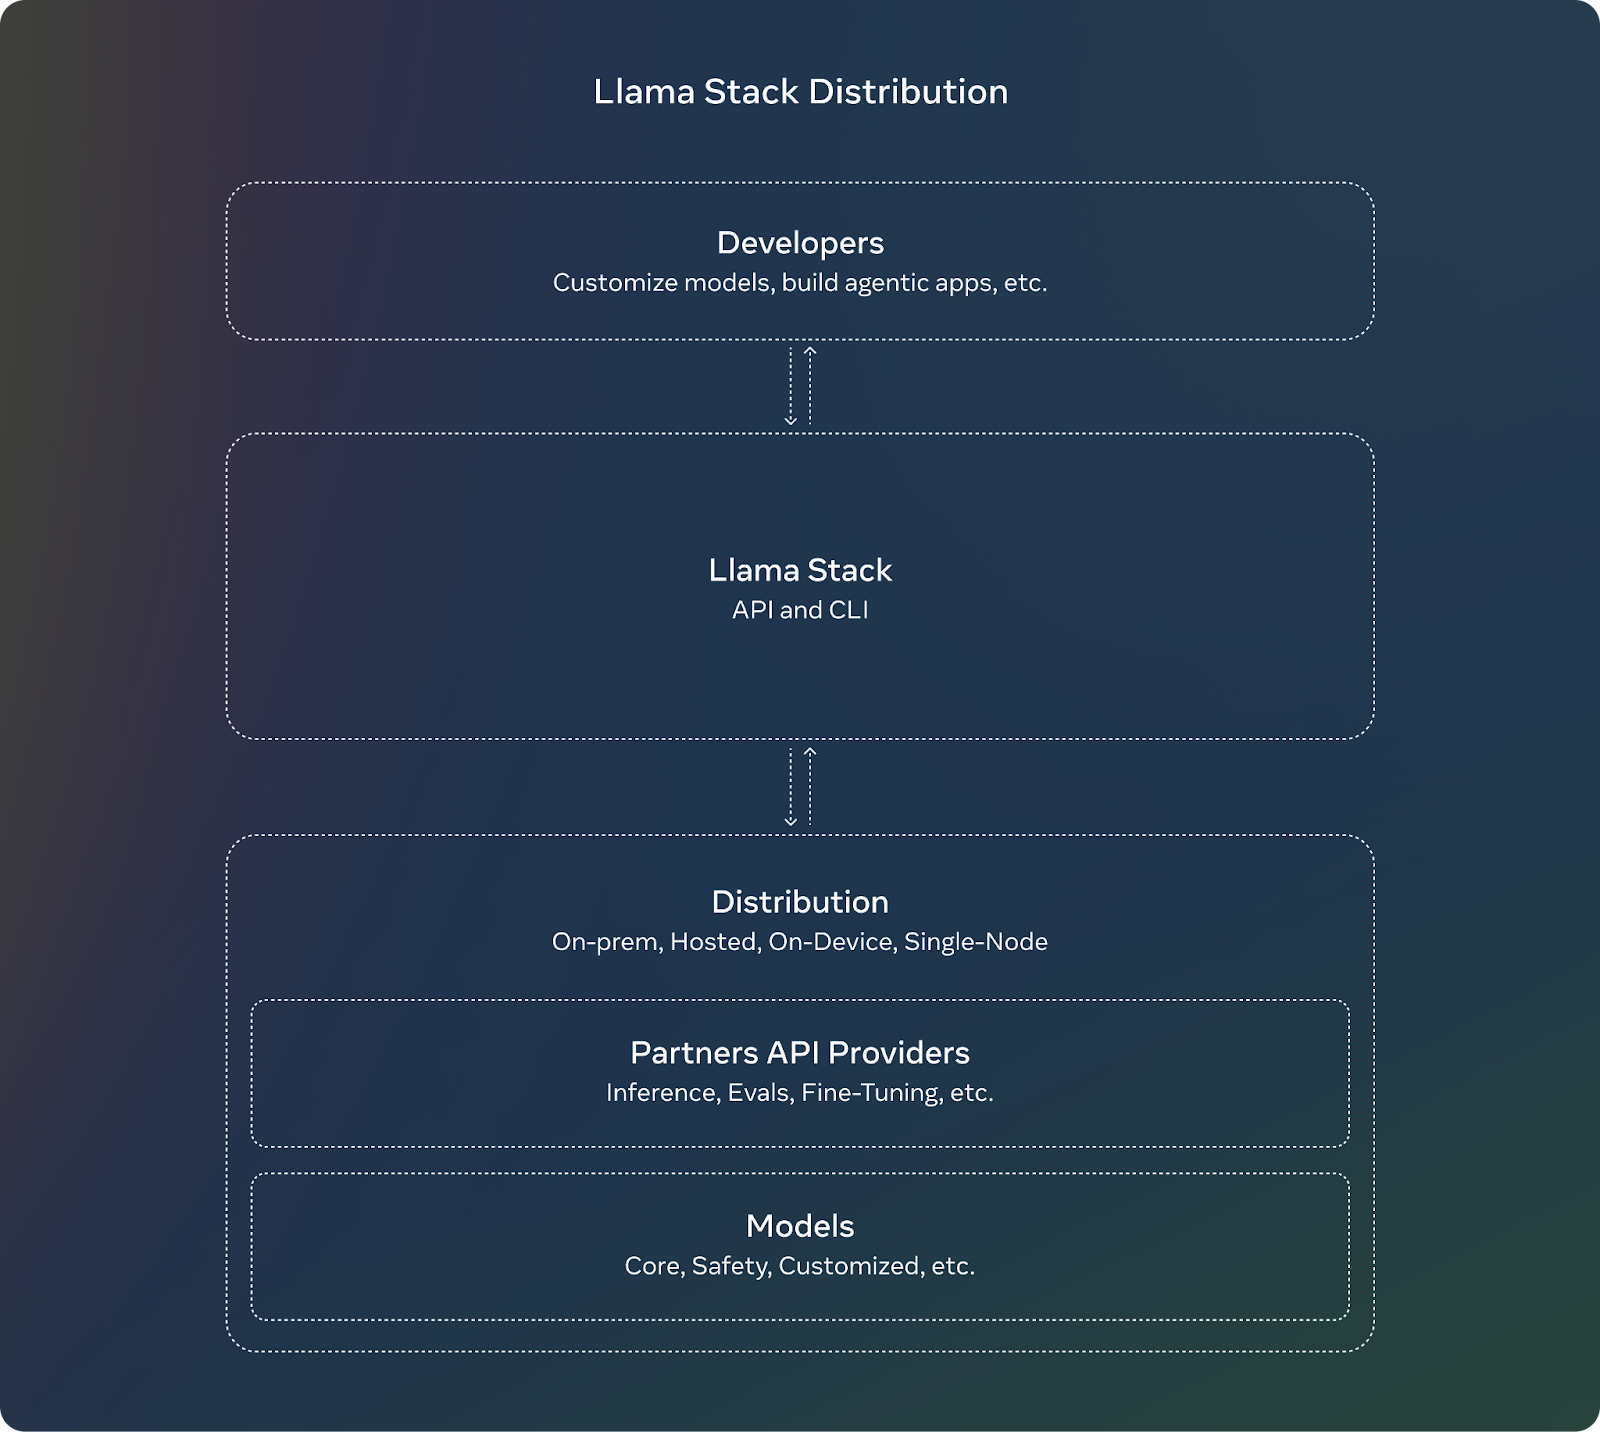
Kaynak: Meta AI
Llama Stack, üretken yapay zekâ uygulaması geliştirirken belirli görev kümelerini hedefleyen çeşitli API’lerle birlikte gelir.
Çıkarım API’si, metin üretimi ya da çok modlu Llama varyantlarını yönlendirir. Temel özellikleri şunlardır:
API, geliştiricilerin uygulama gereksinimlerine göre model davranışını kontrol etmesini sağlayan çeşitli yapılandırmalar tanımlar (ör. FP8 veya BF16 kuantizasyonu gibi).
Güvenlik API’si, içerikleri denetleyerek ve zararlı ya da potansiyel önyargılı çıktıları filtreleyerek yapay zekâ modellerinin sorumlu biçimde dağıtımı için geliştirilmiştir. İhlal düzeylerini (ör. INFO, WARN, ERROR) tanımlayacak şekilde yapılandırılabilir ve kullanıcılara uygulanabilir iletiler döndürebilir.
Bellek API’si geçmiş etkileşimleri koruma ve onlara atıfta bulunma olanağı sunarak bağlamsal farkındalığı olan, daha tutarlı konuşmalar oluşturmayı sağlar. Çeşitli bellek yapılandırmaları, geliştiricilere uygulama ihtiyaçlarına göre depolama türlerini seçme imkânı verir. Temel özellikleri şunlardır:
Ajan API’si, LLM’lerin harici araçlar ve işlevler kullanmasını sağlayarak web araması, kod yürütme veya bellek getirme gibi görevleri yerine getirmelerine olanak tanır. API, geliştiricilerin belirli araçlar ve hedeflerle ajanlar yapılandırmasına izin verir. Her turu birden çok adımdan oluşan çok turlu etkileşimleri destekler. Temel özellikleri şunlardır:
Llama Stack’in sunduğu diğer API’ler şunlardır:
Bu çerçevenin genel fikrine ve yeteneklerine aşina olmak için Llama Stack üzerinde örnek bir proje uygulayacağız.
Başlamadan önce lütfen şunlara dikkat edin:
Llama komut satırı arayüzünü (CLI) kurarak başlayalım.
Llama Stack, dağıtımları yönetmek, modelleri kurmak ve ortamları yapılandırmak için bir Komut Satırı Arayüzü (CLI) sağlar. Atmamız gereken kurulum adımları şunlardır:
a. Sanal bir ortam oluşturun ve etkinleştirin:
conda create -n llama_stack python=3.10
conda activate llama_stack
b. Llama Stack deposunu klonlayın:
git clone <https://github.com/meta-llama/llama-stack.git>
cd llama-stack
c. Gerekli bağımlılıkları kurun:
pip install llama-stack
pip install -r requirements.txtDocker konteynerleri, Llama Stack sunucusunun ve ajan API sağlayıcılarının dağıtımını basitleştirir. Kolay kurulum için önceden oluşturulmuş Docker imajları mevcuttur:
docker pull llamastack/llamastack-local-gpu
llama stack build
llama stack configure llamastack-local-gpu
Bu komutlar Docker imajını çeker, derler ve yığını yapılandırır.
Llama Stack API’lerini kullanarak temel bir sohbet botu oluşturalım. İzlememiz gereken adımlar şunlardır:
Sunucuyu 5000 numaralı portta çalıştıracağız. API’lerle çalışmadan önce sunucunun çalıştığından emin olun:
llama stack run local-gpu --port 5000Llama Stack’i kurduktan sonra, API’leriyle etkileşime geçmek için istemci kodunu kullanabilirsiniz. Kullanıcı girdisine dayalı yanıtlar üretmek için Çıkarım API’sini kullanın:
from llama_stack_client import LlamaStackClient
client = LlamaStackClient(base_url="<http://localhost:5000>")
user_input = "Hello! How are you?"
response = client.inference.chat_completion(
    model="Llama3.1-8B-Instruct",
    messages=[{"role": "user", "content": user_input}],
    stream=False
)
print("Bot:", response.text)
Not: Kurulumunuzda mevcut olan gerçek model adıyla "Llama3.1-8B-Instruct" ifadesini değiştirin.
Yanıtları denetlemek ve uygun olmalarını sağlamak için Güvenlik API’sini uygulayın:
safety_response = client.safety.run_shield(
    messages=[{"role": "assistant", "content": response.text}],
    shield_type="llama_guard",
    params={}
)
if safety_response.violation:
    print("Unsafe content detected.")
else:
print("Bot:", response.text)Sohbet botunun bağlam farkındalığını, konuşma geçmişini depolayıp geri çağırarak oluşturun:
### building a memory bank that can be used to store and retrieve context.
bank = client.memory.create_memory_bank(
    name="chat_memory",
    config=VectorMemoryBankConfig(
        type="vector",
        embedding_model="all-MiniLM-L6-v2",
        chunk_size_in_tokens=512,
        overlap_size_in_tokens=64,
    )
)API’leri daha da birleştirerek sağlam bir sohbet botu oluşturabiliriz:
Tüm adımları tamamladıktan sonra tam kod aşağıdadır:
import uuid
client = LlamaStackClient(base_url="<http://localhost:5000>")
### create a memory bank at the start
bank = client.memory.create_memory_bank(
    name="chat_memory",
    config=VectorMemoryBankConfig(
        type="vector",
        embedding_model="all-MiniLM-L6-v2",
        chunk_size_in_tokens=512,
        overlap_size_in_tokens=64,
    )
)
def get_bot_response(user_input):
    ### retrieving conversation history
    query_response = client.memory.query_documents(
        bank_id=bank.bank_id,
        query=[user_input],
        params={"max_chunks": 10}
    )
    history = [chunk.content for chunk in query_response.chunks]
    ### preparing messages with history
    messages = [{"role": "user", "content": user_input}]
    if history:
        messages.insert(0, {"role": "system", "content": "\\n".join(history)})

    ### generate response
    response = client.inference.chat_completion(
        model="llama-2-7b-chat",
        messages=messages,
        stream=False
    )
    bot_response = response.text
    ### safety check
    safety_response = client.safety.run_shield(
        messages=[{"role": "assistant", "content": bot_response}],
        shield_type="llama_guard",
        params={}
    )
    if safety_response.violation:
        return "I'm sorry, but I can't assist with that request."
    ### memory storing
    documents = [
        MemoryBankDocument(
            document_id=str(uuid.uuid4()),
            content=user_input,
            mime_type="text/plain"
        ),
        MemoryBankDocument(
            document_id=str(uuid.uuid4()),
            content=bot_response,
            mime_type="text/plain"
        )
    ]
    client.memory.insert_documents(
        bank_id=bank.bank_id,
        documents=documents
    )
    return bot_response
### putting all together
while True:
    user_input = input("You: ")
    if user_input.lower() == "bye":
        break
    bot_response = get_bot_response(user_input)
    print("Bot:", bot_response)
Llama Stack kullanarak uygulama geliştirmenize örnekler görmek ve hızlı bir başlangıç yapmak için Meta, örnek uygulamalara göz atabileceğiniz llama-stack-apps deposunu sağlamıştır. Çerçeveyi mutlaka inceleyin ve kendinizi aşina kılın.
Bir açık kaynak projesi olarak Llama Stack, topluluk katkılarıyla yaşar. API’ler hızla evrilmektedir ve proje, geliştiricilerden gelen geri bildirim ve katılımlara açıktır; bu da platformun geleceğinin şekillenmesine yardımcı olur. Llama Stack’i denerseniz, projenizi bir örnek olarak paylaşmanız veya belgelere katkıda bulunmanız diğer geliştiricilere yardımcı olabilir.
Bu makale boyunca, Llama Stack’e adım adım yönergelerle nasıl başlanacağını inceledik.
AI uygulamalarınızı dağıtmaya ilerlerken, en son güncellemeler ve iyileştirmeler için Llama Stack deposunu takip etmeyi unutmayın.
Llama ekosistemi hakkında daha fazla bilgi için aşağıdaki kaynaklara göz atın:
Bu kurslarla yapay zekâyı öğrenin!
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {blog} other {blog}}
Abid Ali Awan
14 dk.
{count, plural, one {blog} other {blog}}
Dario Radečić
15 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Kurtis Pykes
8 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Adel Nehme



