कोर्स
Excel में Data Analysis
3 घंटा
153.8K
डेटा की व्याख्या करते समय, केंद्रीय प्रवृत्ति के सही माप का चयन आपकी विश्लेषण को सफल या असफल बना सकता है। सबसे आम मेट्रिक्स में मीन और मीडियन शामिल हैं—दो दिखने में सरल अवधारणाएँ, जिनका डेटा व्याख्या में गहरा प्रभाव होता है। जहाँ मीन हमें अंकगणितीय औसत देता है, वहीं मीडियन सॉर्ट किए गए मानों के सेट का मध्य बिंदु होता है, ताकि आधे प्रेक्षण उसके प्रत्येक ओर हों। लेकिन कौन सा अधिक विश्वसनीय है? जवाब अक्सर आपके डेटा के वितरण, आउटलायर्स की मौजूदगी, और उस कहानी पर निर्भर करता है जिसे आप बताना चाहते हैं।
इस लेख में, मैं मीन और मीडियन के बीच के अंतर, उनकी खूबियाँ और सीमाएँ, और अलग-अलग परिस्थितियों में सही विकल्प कैसे चुनें, यह समझाऊँगा। मैं यह भी दिखाऊँगा कि तिरछे (skewed) वितरण और आउटलायर्स इन मापों को कैसे प्रभावित करते हैं—समझ को आसान बनाने के लिए व्यावहारिक उदाहरणों और विज़ुअल्स के साथ। हम कुछ उन्नत विचारों की ओर भी एक झलक डालेंगे।
मीन और मीडियन के बीच के अंतर को पूरी तरह समझने के लिए, आइए दोनों मापों को अलग-अलग देखें और उनकी प्रमुख विशेषताओं पर प्रकाश डालें।
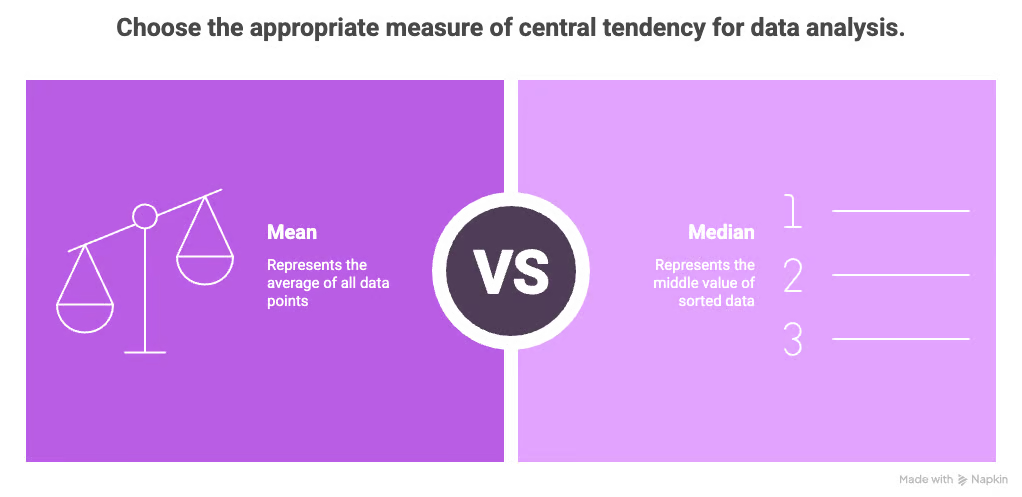
मीन को डेटा का “संतुलन बिंदु” (या द्रव्यमान केंद्र) माना जा सकता है। यह डेटासेट के सभी डेटा बिंदुओं को ध्यान में रखता है और एक एकल मान देता है जो औसत का प्रतिनिधित्व करता है। अधिक सटीक रूप से, मीन की गणना डेटासेट के सभी मानों को जोड़कर और फिर मानों की संख्या से भाग देकर की जाती है।
मीडियन वह मध्य मान है जब डेटा को क्रमबद्ध किया जाता है। मीन के विपरीत, यह आउटलायर्स के प्रति अधिक मज़बूत होता है और तिरछे डेटा के लिए केंद्रीय प्रवृत्ति का बेहतर माप देता है।
मोड केंद्रीय प्रवृत्ति का एक और माप है, जो डेटासेट में सबसे अधिक बार आने वाले मान का प्रतिनिधित्व करता है। एक उदाहरण देखें:
3, 3, 6, 8, 9यहाँ, मोड 3 है क्योंकि यह दो बार आता है, जबकि अन्य सभी मान केवल एक बार आते हैं।
परिभाषा पढ़ना एक बात है, गणना करना दूसरी। इस खंड में, मैं हर माप को निकालने के चरण बताऊँगा और उनके संगणनात्मक (computational) अंतर पर प्रकाश डालूँगा।
मीन किसी डेटासेट का अंकगणितीय औसत होता है और इसे इस प्रकार निकाला जाता है:
यह प्रक्रिया एक सामान्य समीकरण के रूप में इस प्रकार दर्शाई जा सकती है:
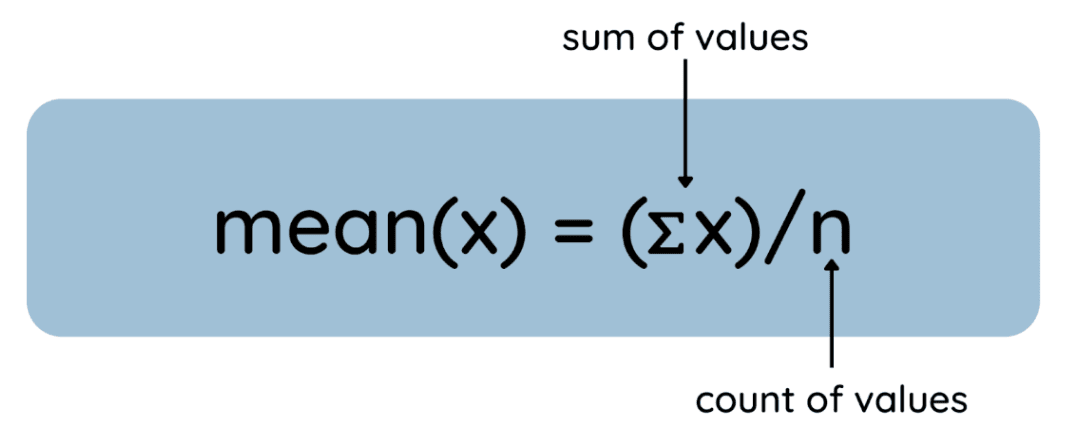
मीन कैसे निकालें। चित्र: लेखक
एक उदाहरण के लिए, परीक्षा अंकों का यह डेटासेट देखें:
78, 85, 92, 88, 70मीन स्कोर है 82.6.
मीडियन वह मध्य मान है जब डेटासेट को आरोही क्रम में सजाया जाता है। इसे इस तरह निकालें:
और ये चरण समीकरणों के रूप में इस प्रकार हैं:
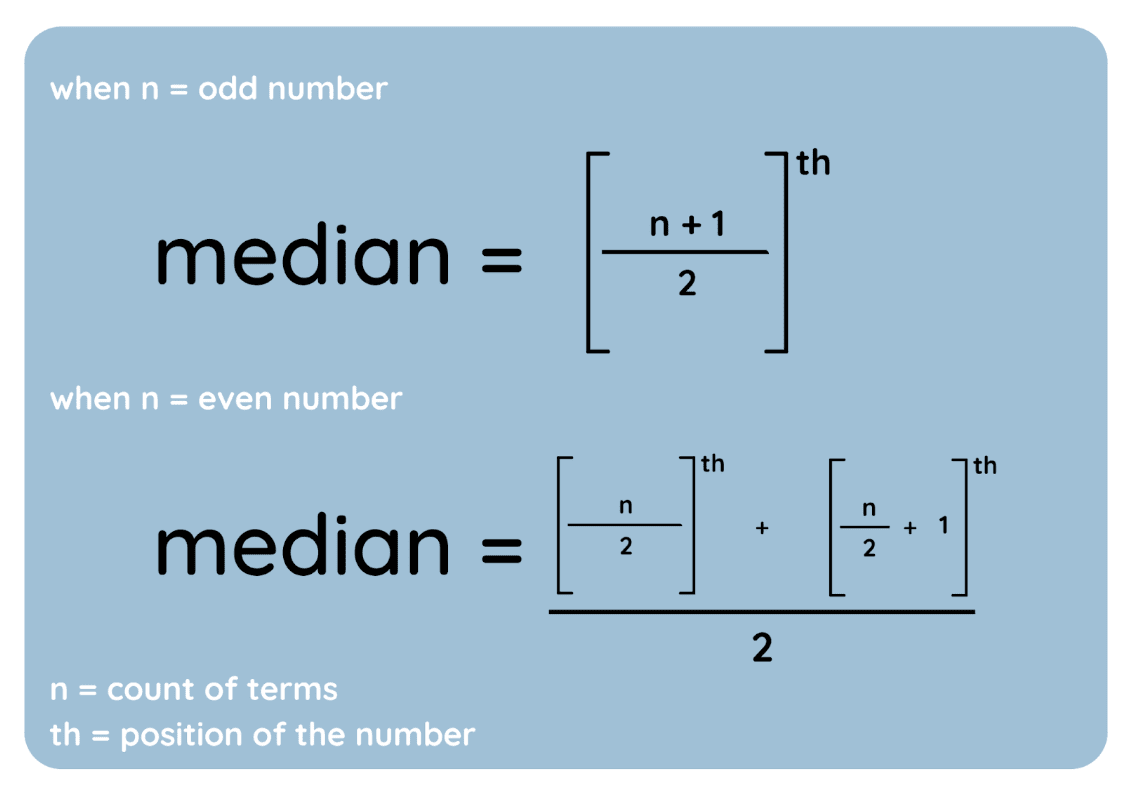
मीडियन का सूत्र। चित्र: लेखक
मैंने प्रक्रिया को दिखाने के लिए एक विज़ुअल भी बनाया है।
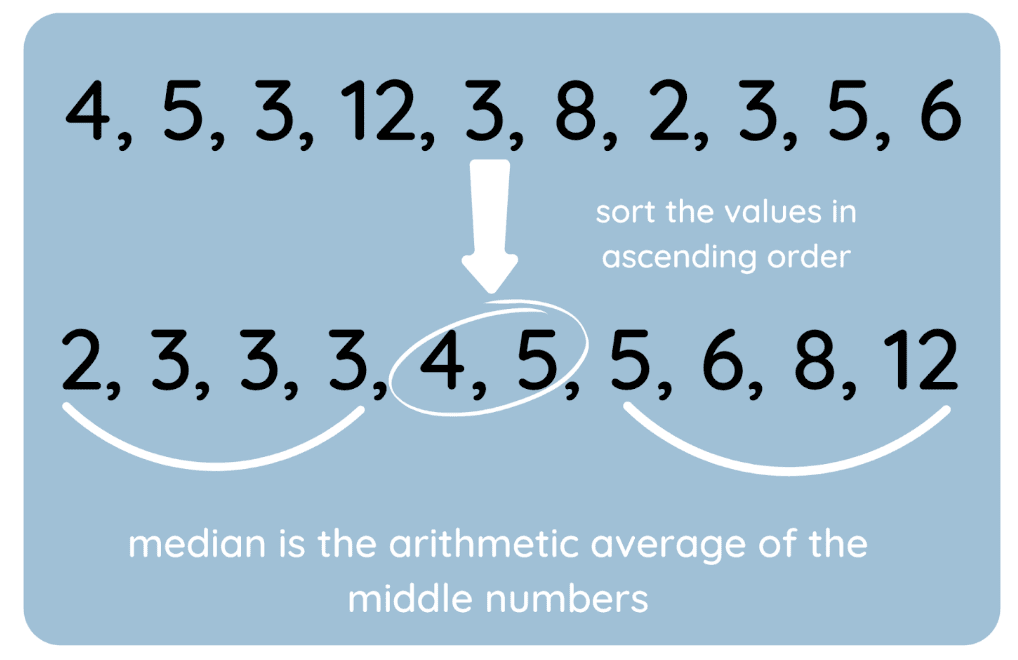
मीडियन कैसे निकालें। चित्र: लेखक
यहाँ विषम संख्या वाले मानों का एक उदाहरण डेटासेट है:
70, 78, 85, 88, 92मीडियन है 85.
अब एक और उदाहरण देखें, जिसमें मानों की संख्या सम है:
70, 78, 85, 88मीडियन है 81.5.
हालाँकि मीन और मीडियन दोनों किसी डेटासेट के केंद्र का वर्णन करते हैं, आउटलायर्स और तिरछे वितरणों की उपस्थिति में उनका व्यवहार काफी अलग होता है। इस अंतर को समझना डेटा की सही व्याख्या करने और भ्रामक निष्कर्षों से बचने के लिए बहुत महत्वपूर्ण है।
आउटलायर्स वे मान होते हैं जो बाकी डेटा की तुलना में काफी अधिक या कम होते हैं। वे मीन को बहुत प्रभावित कर सकते हैं, लेकिन मीडियन पर उनका बहुत कम या कोई प्रभाव नहीं पड़ता।
आइए मासिक आय (हज़ारों में) का एक डेटासेट देखें:
3, 3.5, 4, 4.5, 5, 6, 50यहाँ मीन आय 10.85k है, जो 50k जैसे चरम मान से काफी तिरछी हो गई है।
दूसरी ओर, मीडियन मान 4.5k है, जो, मेरा कहना है, इस समूह की आय का कहीं अधिक सामान्य प्रतिनिधित्व करता है।
तिरछे (गैर-सममित) वितरणों में डेटा का प्रतिनिधित्व करने में भी मीन और मीडियन अलग होते हैं।
उदाहरण के लिए, दाएँ-तिरछे वितरणों में (जैसे, आय या मकान की कीमतें), अधिकांश मान निचले सिरे पर समूहित होते हैं, और कुछ चरम मान दाएँ तरफ पूँछ खींचते हैं।
आय पर विचार करें:
30k, 35k, 40k, 45k, 50k, 100k, 200kयह बात याद रखने योग्य है कि मीन या मीडियन का उपयोग करने से पहले अपने डेटा के वितरण की जाँच करना हमेशा महत्वपूर्ण है। हिस्टोग्राम और बॉक्स प्लॉट जैसे टूल तिरछेपन को देखने और आउटलायर्स की पहचान करने में मदद कर सकते हैं। हम इन्हें आगे कवर करेंगे। साथ ही, मैं कहना चाहता हूँ कि मीन और मीडियन के अंतर की जाँच तिरछेपन का आकलन करने का एक तरीका है।
डेटा का विश्लेषण करते समय, मीन या मीडियन का उपयोग करना आपके डेटासेट की विशेषताओं और जिन अंतर्दृष्टियों की आपको तलाश है, उन पर निर्भर करता है। नीचे एक त्वरित संदर्भ तालिका है जो आपके चयन में मदद करेगी:
| मीन का उपयोग करें जब | मीडियन का उपयोग करें जब |
|---|---|
| डेटा वितरण लगभग सामान्य (सममित) हो। | डेटा अत्यधिक तिरछा हो (जैसे, आय, संपत्ति के मूल्य)। |
| आउटलायर्स न्यूनतम हों या विश्लेषण के लिए प्रासंगिक न हों। | आउटलायर्स मौजूद हों और उन्हें शामिल करने पर परिणाम विकृत हो सकते हों। |
| आपको ऐसा माप चाहिए जो हर डेटा बिंदु के प्रति संवेदनशील हो, जैसे प्रेडिक्टिव मॉडलिंग में या कुल निकालते समय। | आप “आम” मान को प्रतिबिंबित करना चाहते हैं, न कि डेटासेट के “गणितीय केंद्र” को। |
एक व्यावहारिक सुझाव जो वास्तव में मदद करेगा: अपने डेटा का दृश्य विश्लेषण (जैसे, हिस्टोग्राम या बॉक्स प्लॉट) से शुरुआत करें ताकि सममिति, तिरछापन, और आउटलायर्स की उपस्थिति जाँची जा सके। इससे तय करने में मदद मिलेगी कि आपके परिदृश्य में मीन बेहतर है या मीडियन।
विज़ुअलाइज़ेशन अलग-अलग डेटासेट में मीन और मीडियन के व्यवहार को समझने के लिए शक्तिशाली उपकरण हैं। ये साफ़ दिखाते हैं कि ये माप आउटलायर्स और तिरछे वितरणों पर कैसे प्रतिक्रिया देते हैं, जिससे बेहतर डेटा-आधारित निर्णय लेने में मदद मिलती है।
हज़ारों में आय का एक छोटा डेटासेट कल्पना करें:
30, 35, 40, 45, 50, 55, 1000निम्नलिखित बार चार्ट दिखाता है कि एक अकेला चरम मान मीन को कितनी तेजी से प्रभावित कर सकता है, जबकि मीडियन अपेक्षाकृत स्थिर रहता है। इस मामले में, अधिकांश डेटा बिंदु 30 और 55 के बीच समूहित हैं, लेकिन आउटलायर (1000) की उपस्थिति मीन को ऊपर खींचती है।
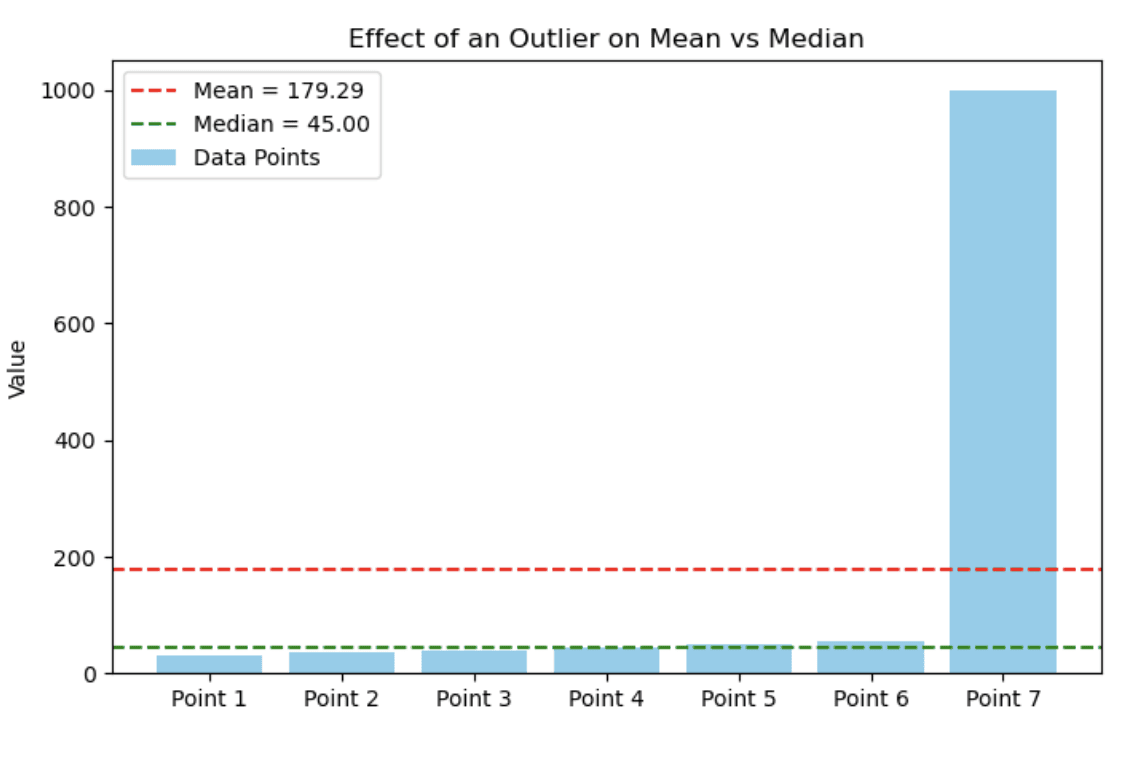
आउटलायर का मीन बनाम मीडियन पर प्रभाव दिखाता बार चार्ट। चित्र: लेखक
दाएँ-तिरछे वितरण (जैसे आय या मकान की कीमतें) में, मीन अक्सर उच्च मानों की लंबी पूँछ की ओर खिंच जाता है, जबकि मीडियन “आम” डेटा बिंदु के करीब रहता है। ऐसे मामलों में मीडियन केंद्रीय प्रवृत्ति का बेहतर माप होता है।
नीचे दिया हिस्टोग्राम एक सिम्युलेटेड आय-वितरण दिखाता है, जहाँ तिरछेपन के कारण मीन (लाल डैश्ड रेखा) मीडियन (हरी डैश्ड रेखा) से काफ़ी बड़ा है।
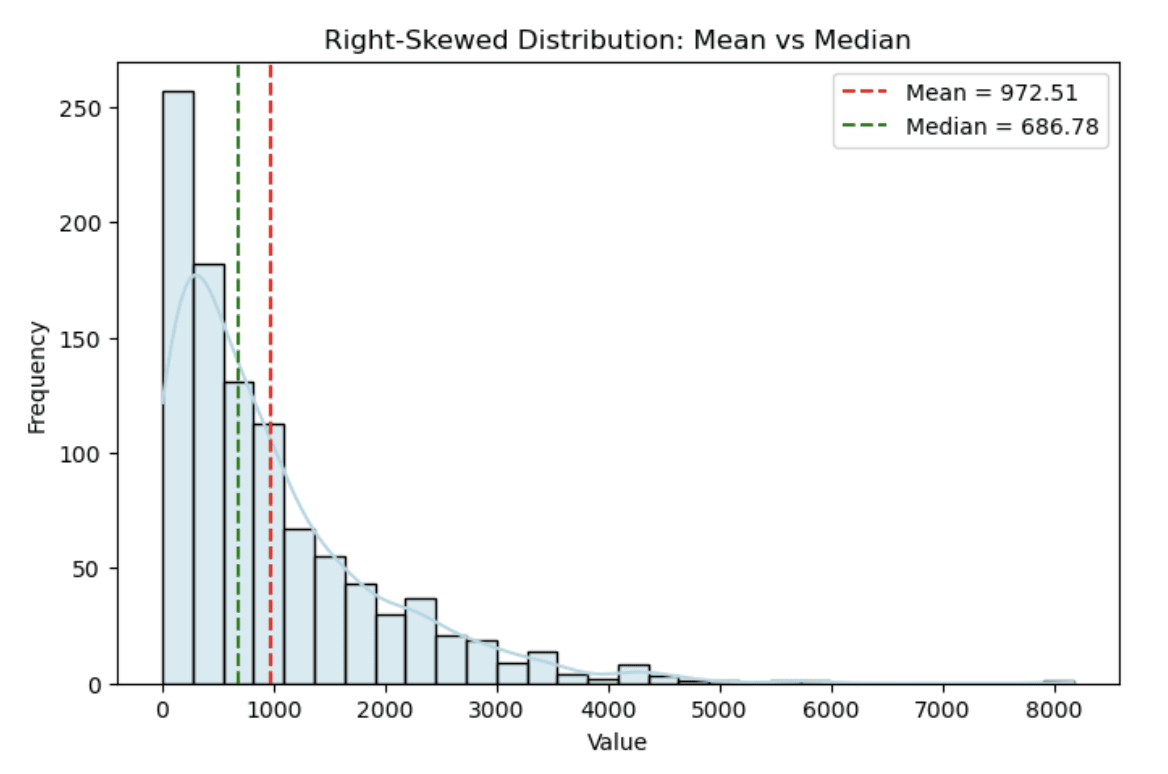
दाएँ-तिरछा वितरण दिखाता हिस्टोग्राम। चित्र: लेखक
आप देख सकते हैं कि दाएँ तिरछापन पूँछ को खींचता है, जिससे मीन और मीडियन के बीच स्पष्ट अंतर बनता है।
बॉक्स प्लॉट मीडियन पर आउटलायर्स के प्रभाव को देखने का उत्कृष्ट तरीका है। नीचे, हम दो समूहों की तुलना करते हैं: एक में आउटलायर्स हैं और एक में नहीं। मीडियन (बॉक्स के अंदर की ऊर्ध्वाधर रेखा) चरम मानों की उपस्थिति में भी स्थिर रहता है, लेकिन डेटा की समग्र सीमा आउटलायर से काफ़ी प्रभावित होती है।
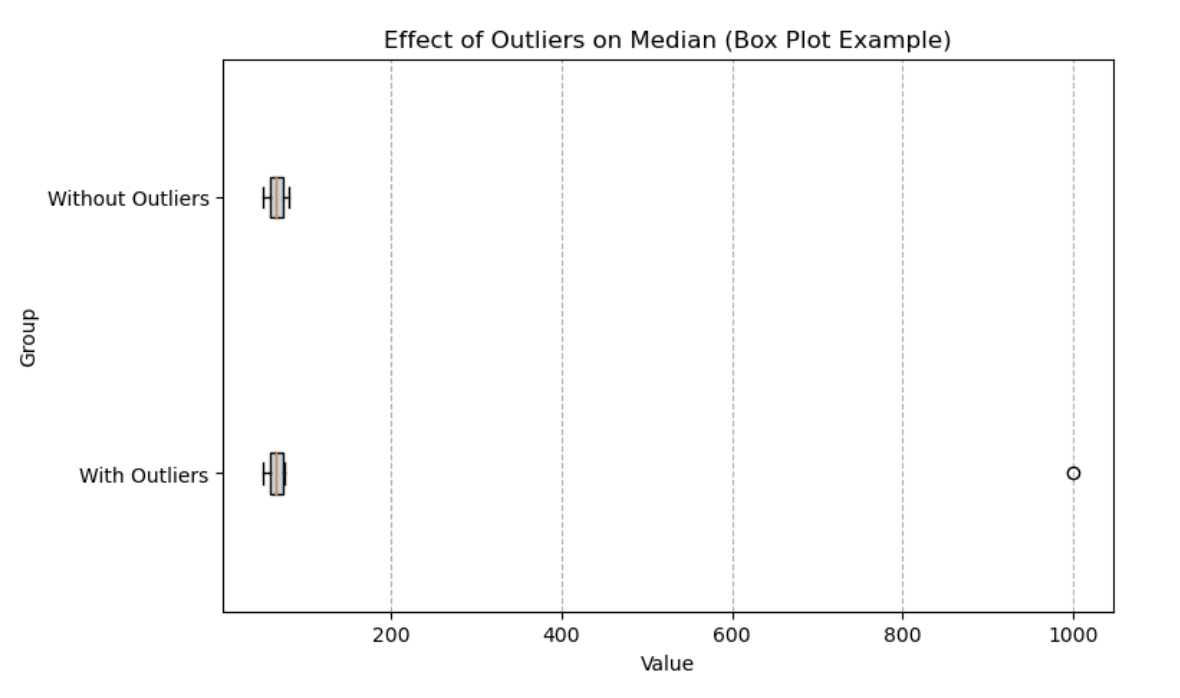
मीडियन पर आउटलायर्स का प्रभाव दिखाता बॉक्स प्लॉट। चित्र: लेखक
ये विज़ुअलाइज़ेशन दिखाते हैं कि मीन और मीडियन अलग-अलग डेटा विशेषताओं पर कैसे प्रतिक्रिया देते हैं, और कब किस माप का उपयोग करना चाहिए, इस पर स्पष्टता प्रदान करते हैं। चाहे तिरछे डेटा का विश्लेषण हो, आउटलायर-प्रवण डेटासेट हों, या समूहों की तुलना करनी हो—ऐसे विज़ुअल सहायक जटिल संबंधों को बहुत आसान बना देते हैं।
यदि आप और गहराई से सीखने के इच्छुक हैं, तो अब कुछ उन्नत विचारों पर नज़र डालते हैं।
यदि आप डेटा साइंटिस्ट हैं और आपको अपने डेटा में खाली जगहें भरनी हैं, तो आपको किसी इम्प्यूटेशन विधि को चुनना पड़ सकता है। अब आप सोच रहे होंगे, व्यवहार में मीन बनाम मीडियन इम्प्यूटेशन में क्या अंतर है?
जैसा कि आप अनुमान लगा सकते हैं, मीन इम्प्यूटेशन उपलब्ध डेटा के औसत से मिसिंग वैल्यूज़ को बदल देता है, जो कि हमने कहा, चरम मानों से तिरछा हो सकता है। दूसरी ओर, मीडियन इम्प्यूटेशन मिसिंग वैल्यूज़ को डेटासेट के मध्य मान से बदलता है।
एक उपयोगी thumb rule यह है कि अपने डेटा के वितरण को देखें। यदि आपका डेटा तिरछा है और बहुत सारी मिसिंग वैल्यूज़ हैं, और आपने मीन इम्प्यूटेशन का उपयोग किया, तो आप अपने डेटा के वितरण को बदल भी सकते थे!
लेकिन यह भी याद रखें कि एकल-मूल्य इम्प्यूटेशन (मीन या मीडियन) विचरण को घटा सकता है और चरों के बीच संबंधों को कमजोर कर सकता है। यदि missingness पर्याप्त है, तो अनिश्चितता और संरचना को बेहतर संरक्षित करने के लिए multiple imputation या मॉडल-आधारित इम्प्यूटेशन पर विचार करें।
कई पैरामीट्रिक विधियों में मीन (और वैरिएंस) केंद्रीय पैरामीटर होते हैं। उदाहरण के लिए, सिंपल लीनियर रिग्रेशन मॉडल मानता है कि त्रुटियाँ मीन के चारों ओर सामान्य रूप से वितरित होती हैं। जब आपका डेटा सामान्यता के अनुमानों को पूरा करता है, तो सैंपल मीन एक स्वाभाविक आकलक होता है और पैरामीट्रिक ढाँचों में अच्छी तरह फिट बैठता है।
अब, मीडियन का उपयोग अक्सर रोबस्ट और नॉन-पैरामीट्रिक सेटिंग्स में होता है, और जब डेटा तिरछा हो या आउटलायर्स हों, तब यह सामान्य पसंद है। कई परीक्षण, जैसे Mann–Whitney टेस्ट, रैंक-आधारित होते हैं और औसतों के बजाय वितरणों की तुलना करते हैं (अनुमानों के तहत अक्सर इसे लोकेशन शिफ्ट के रूप में व्याख्यायित किया जाता है) और वे हमेशा मीडियन के अंतर का परीक्षण नहीं करते।
इतना कहना काफी है कि मीन बनाम मीडियन के भेद को समझना केवल डेटा का सही वर्णन करने के लिए नहीं, बल्कि हाइपोथेसिस परीक्षण में भी महत्वपूर्ण है।
यह तय करते समय कि मीन या मीडियन का उपयोग करें, एक महत्वपूर्ण सवाल यह है कि किसी दिए गए डेटासेट के लिए हमारी सांख्यिकीय माप कितनी स्थिर हैं। बूटस्ट्रैपिंग एक विकल्प है जो हमें मूल डेटा से बार-बार पुन:नमूना (with replacement) लेकर मीन और मीडियन दोनों के सैम्पलिंग वितरण का प्रायोगिक अनुमान लगाने देता है।
आप मीन और मीडियन की स्थिरता में अंतर को प्रायोगिक रूप से उजागर कर सकते हैं। आप किसी डेटासेट में कुछ आउटलायर्स जोड़ सकते हैं और फिर बूटस्ट्रैप प्रक्रिया दोबारा चला सकते हैं—इससे आप दृश्य रूप से दिखा पाएँगे कि मीन का वितरण मीडियन की तुलना में अधिक नाटकीय रूप से खिसकता है। साथ ही, बूटस्ट्रैपिंग यह ठोस बनाता है कि यथार्थवादी परिस्थितियों में आपके कॉन्फिडेंस इंटरवल कितने बड़े या छोटे हो सकते हैं। और जानने के लिए हमारे बूटस्ट्रैप विधियों पर ट्यूटोरियल को पढ़ें।
अब एक वैकल्पिक लेकिन उतना ही सही परिभाषा दें: मीन वह मान है जो डेटा से वर्ग विचलनों (squared deviations) के योग को न्यूनतम करता है, जबकि मीडियन वह मान है जो परिमित (absolute) विचलनों के योग को न्यूनतम करता है।
इस समीकरण पर नज़र डालें:
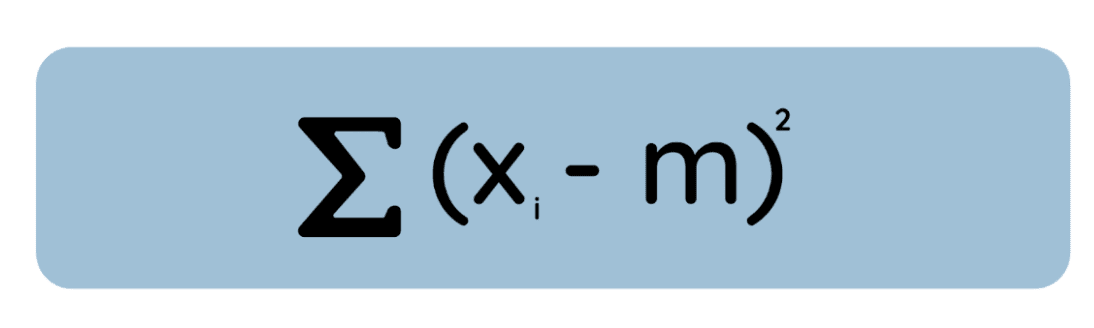
यदि आप इस समीकरण का अवकलन के सापेक्ष लें, उसे शून्य के बराबर रखें, और हल करें, तो पाएँगे कि न्यूनतम करने वाला मान बस अंकगणितीय मीन है। यह इसलिए महत्वपूर्ण है क्योंकि कई सांख्यिकीय विधियों, जैसे OLS रिग्रेशन, में हम गणितीय सुविधा और सामान्य रूप से वितरित त्रुटियों के अनुमानों के अनुरूप होने के लिए वर्ग त्रुटियों को न्यूनतम करते हैं।
अब एक अलग विचार करें: प्रत्येक विचलन का वर्ग करने के बजाय, हम m और प्रत्येक डेटा बिंदु के बीच की परिमित त्रुटि मापें:
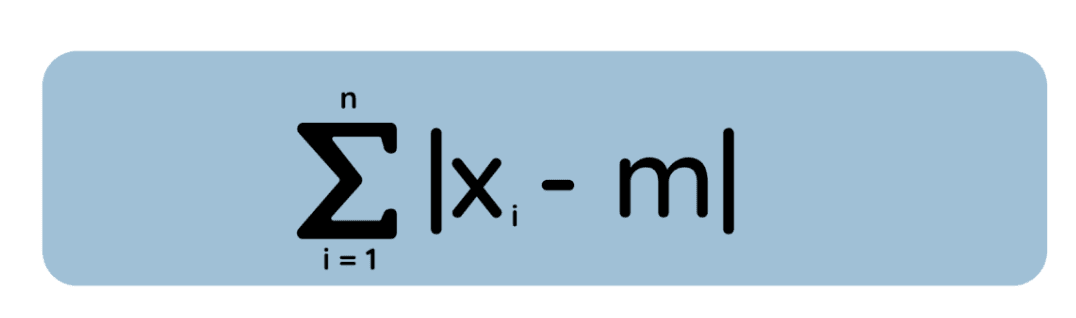
यहाँ हम ऐसा m खोजना चाहते हैं जो इस कुल परिमित विचलन को न्यूनतम करे। साबित किया जा सकता है (absolute loss के अवकलन का विश्लेषण कर या ज्यामितीय तर्क से) कि समाधान डेटासेट का मीडियन है। (और जब प्रेक्षणों की संख्या सम हो, तो दो मध्य बिंदुओं के बीच का कोई भी मान कुल परिमित विचलन को न्यूनतम करता है—अर्थात न्यूनकारक अद्वितीय न भी हो।)
सहज रूप से, यदि मीडियन के बाएँ है, तो दाएँ ओर अधिक डेटा बिंदु होते हैं, जो उसे उधर खिसकाने का “खींचाव” देते हैं। केवल मीडियन पर ही बाएँ और दाएँ से खिंचाव संतुलित होता है, जिससे कुल परिमित दूरी न्यूनतम होती है।
अंत में, मैं कहूँगा कि बड़े पैमाने पर मीन संगणनात्मक रूप से सरल है। इसका मतलब है कि आप इसे डेटा स्ट्रीम होते समय क्रमिक रूप से निकाल सकते हैं, सॉर्ट करने की ज़रूरत नहीं।
व्यवहार में मीडियन अक्सर सॉर्टिंग द्वारा निकाला जाता है, जो बड़े पैमाने पर महँगा हो सकता है। लेकिन मीडियन को स्वभावतः पूर्ण सॉर्ट की ज़रूरत नहीं (सेलेक्शन एल्गोरिदम मौजूद हैं), और बहुत बड़े या स्ट्रीमिंग डेटासेट के लिए, अनुमानित क्वांटाइल स्केच एल्गोरिदम सामान्यतः मीडियन का कुशल अनुमान लगाने के लिए उपयोग किए जाते हैं। हमारा Concepts in Computer Science कोर्स इन बातों को सीखने के लिए एक बेहतरीन संसाधन है।
जैसा कि आपने देखा, मीन किसी डेटासेट का अंकगणितीय औसत है, जो इसे चरम मानों के प्रति संवेदनशील बनाता है, जबकि मीडियन क्रमबद्ध डेटासेट का मध्य मान दर्शाता है। सही चुनाव बहुत फर्क ला सकता है, लेकिन यह कहते हुए भी, वास्तविक दुनिया के विश्लेषणों में अक्सर बेहतर होता है कि मीन और मीडियन दोनों को मोड, स्टैंडर्ड डिविएशन और पर्सेंटाइल्स जैसे अतिरिक्त आँकड़ों के साथ रिपोर्ट किया जाए। यह सबसे अच्छा तरीका है क्योंकि यह समग्र तस्वीर देता है।
यदि आप सांख्यिकीय अवधारणाओं में और गहराई तक जाना चाहते हैं, तो कई क्षेत्र हैं जिन पर ध्यान देना चाहिए। शुरुआत करें मीन के उन्नत रूपों से, जैसे ट्रिम्ड मीन, जियोमेट्रिक मीन, और वेटेड मीन, जिनका अपना-अपना उद्देश्य है। साथ ही, हमारा तकनीक-अज्ञेय Introduction to Statistics कोर्स भी मैं करने की सलाह दूँगा।
फिर, सच में अधिक विशेषज्ञ बनने के लिए, आप एक टूल चुनकर उसमें महारत हासिल करना चाहेंगे। हमारा Introduction to Statistics in R कोर्स और Statistician in R करियर ट्रैक, यदि आप R का उपयोग करना चाहते हैं—जो डेटा साइंस और सांख्यिकी के लिए लोकप्रिय भाषा है—तो दोनों बहुत जानकारीपूर्ण शुरुआती बिंदु हैं। यदि आप स्प्रेडशीट्स और Python जैसी प्रोग्रामिंग भाषा के साथ काम करना पसंद करते हैं, तो हमारा Introduction to Statistics in Google Sheets कोर्स और Introduction to Statistics in Python कोर्स फ़ॉर्मूलों और शक्तिशाली लाइब्रेरियों का उपयोग करते हुए सांख्यिकीय विश्लेषण का व्यावहारिक दृष्टिकोण प्रदान करते हैं।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स