
Last chance! 50% off DataCamp Premium
Sale ends in
Jumlah kuadrat adalah ukuran statistik yang kompleks dan berperan penting dalam analisis regresi. Ukuran ini menggambarkan keragaman variabel dependen dan dapat diuraikan menjadi tiga komponen—yaitu jumlah kuadrat total (SST), jumlah kuadrat regresi (SSR), dan jumlah kuadrat galat (SSE)—yang bersama-sama membantu menilai kinerja model regresi.
Pada artikel ini, kita akan membahas ketiga komponen jumlah kuadrat, serta R-kuadrat. Pertama, kami akan memberikan gambaran masing-masing jumlah kuadrat secara terpisah. Selanjutnya, kita akan meninjau hubungan matematis di antara ketiganya. Terakhir, kita akan mengeksplorasi kaitan SST, SSR, dan SSE dengan R-kuadrat, metrik evaluasi model yang penting.
Mari mulai dengan mendefinisikan apa itu SST, SSR, dan SSE, bagaimana masing-masing ukuran merefleksikan keragaman total, dan bagaimana masing-masing membantu mengevaluasi kecocokan (goodness of fit) model regresi. Selain itu, kita akan melihat seperti apa masing-masing jumlah kuadrat pada regresi linear sederhana dengan satu variabel dependen dan satu variabel independen.
Jika saat meninjau definisi Anda ingin mengulang statistik tanpa harus menulis kode, lihat kursus kami, Introduction to Statistics. Untuk kursus statistik pengantar yang berbasis pada teknologi tertentu, kami memiliki beberapa opsi, termasuk Introduction to Statistics in Google Sheets, Introduction to Statistics in Python, dan Introduction to Statistics in R.
Jumlah kuadrat total (SST) adalah jumlah dari kuadrat selisih antara setiap nilai variabel dependen teramati dan mean variabel tersebut. Istilah lain untuk ini adalah total sum of squares (TSS).
Jumlah kuadrat total merepresentasikan keragaman total pada variabel dependen, termasuk bagian keragaman yang dijelaskan dan yang tidak dijelaskan oleh model regresi. Secara alamiah, SST merefleksikan sebaran keseluruhan nilai-nilai individual variabel dependen teramati dari nilai meannya.
Berikut adalah rumus matematis untuk menghitung SST:
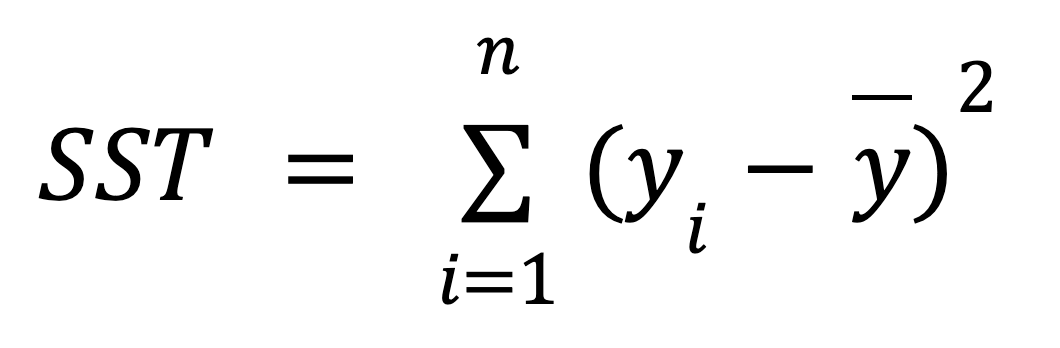
dengan:
Plot berikut untuk regresi linear sederhana menunjukkan makna rumus di atas secara grafis:
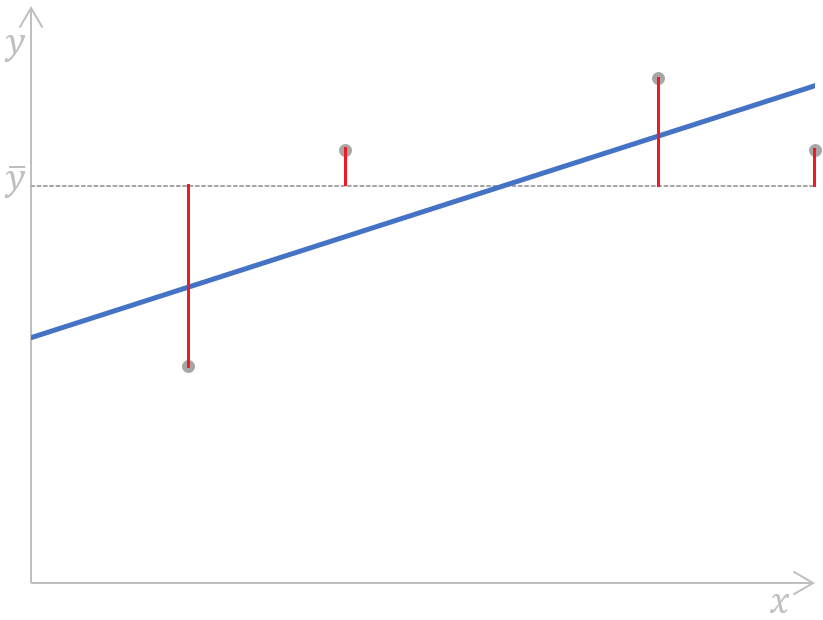
Menghitung jumlah kuadrat total untuk regresi linear sederhana. Gambar oleh Penulis
Seperti yang terlihat, jarak (segmen merah pada plot) antara nilai mean (garis putus-putus abu-abu) dari variabel dependen teramati dan setiap nilainya (titik abu-abu) diukur, dikuadratkan, lalu dijumlahkan. Selain itu, plot ini jelas menunjukkan bahwa SST tidak bergantung pada model regresi; SST hanya bergantung pada nilai y yang teramati dan mean variabel dependen teramati.
Jumlah kuadrat regresi (SSR) adalah jumlah dari kuadrat selisih antara setiap nilai variabel dependen yang diprediksi oleh model regresi untuk setiap titik data variabel independen dan mean variabel dependen teramati. Istilah lain untuk metrik ini meliputi: regression sum of squares, sum of squares due to regression, dan explained sum of squares. Bahkan ada singkatan lain untuk ini—ESS.
Jumlah kuadrat regresi menangkap porsi dari keragaman total pada variabel dependen yang dijelaskan oleh model regresi (karena itu salah satu istilah alternatifnya—explained sum of squares). Kita juga dapat memandangnya sebagai galat yang berkurang akibat model regresi.
Untuk menghitung SSR, kita menggunakan rumus berikut:
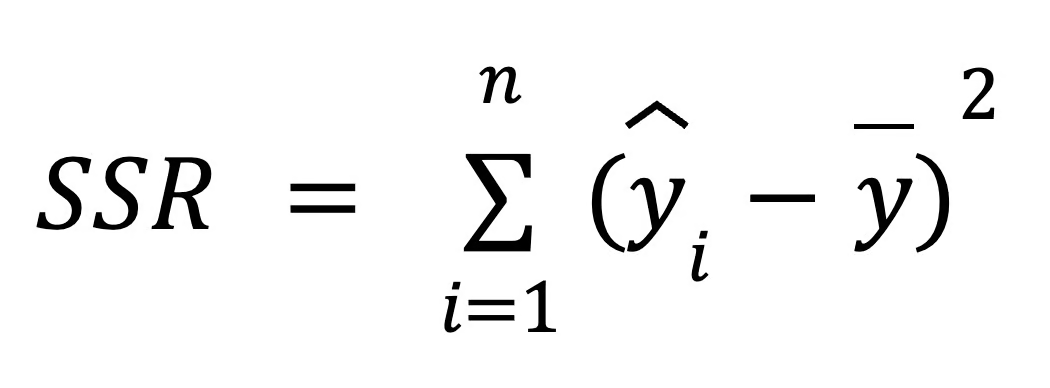
dengan:
Kita dapat mengilustrasikan rumus ini pada plot regresi linear sederhana berikut:
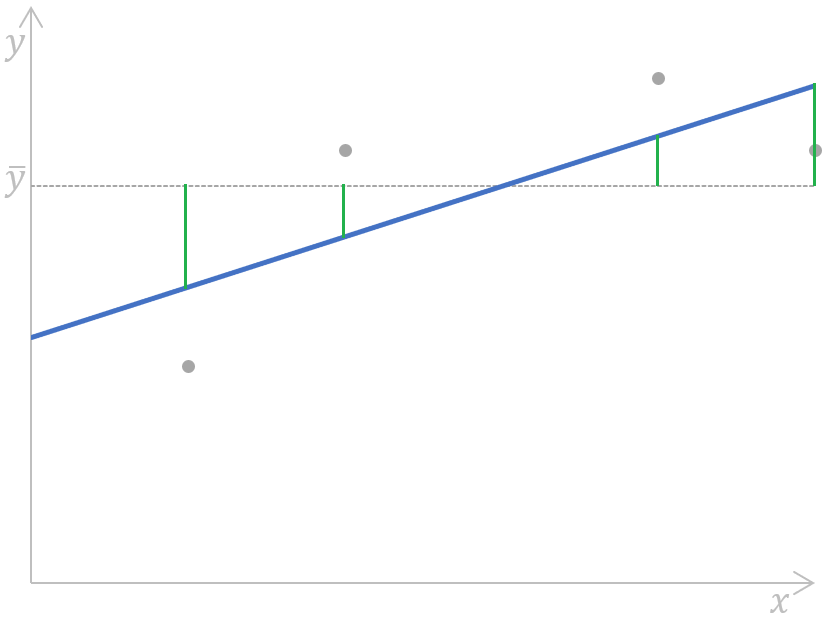 Menghitung jumlah kuadrat regresi untuk regresi linear sederhana. Gambar oleh Penulis
Secara sederhana, jarak (segmen hijau pada plot) antara nilai mean (garis putus-putus abu-abu) dari variabel dependen teramati dan setiap nilai variabel dependen yang diprediksi oleh model regresi (garis biru) untuk tiap titik data variabel independen diukur, dikuadratkan, lalu dijumlahkan.
Dalam analisis regresi, SSR berkontribusi untuk mengukur kecocokan model regresi dengan membantu menentukan seberapa baik model memprediksi titik data. Kita akan memperoleh gambaran yang lebih jelas nanti dalam tutorial ini ketika membahas hubungan antara ketiga metrik jumlah kuadrat.
Jumlah kuadrat galat (SSE) adalah jumlah dari kuadrat selisih antara setiap nilai variabel dependen teramati dan nilai variabel dependen yang diprediksi oleh model regresi untuk titik data variabel independen yang sama. Dengan kata lain, metrik ini mengukur perbedaan antara nilai aktual dan nilai prediksi variabel dependen.
Jumlah kuadrat galat juga disebut error sum of squares, residual sum of squares, sum of squares residual, atau unexplained sum of squares. Selain SSE, metrik ini juga dapat disingkat sebagai RSS, ESS, atau bahkan SSR—dalam kasus terakhir, ini mudah tertukar dengan SSR yang sebelumnya dibahas yang merupakan singkatan dari jumlah kuadrat regresi.
Jumlah kuadrat galat merefleksikan sisa galat, atau keragaman yang tidak terjelaskan, yaitu porsi keragaman total pada variabel dependen yang tidak dapat dijelaskan oleh model regresi (itulah sebabnya juga disebut unexplained sum of squares).
Kita dapat menggunakan rumus berikut untuk menghitung SSE:
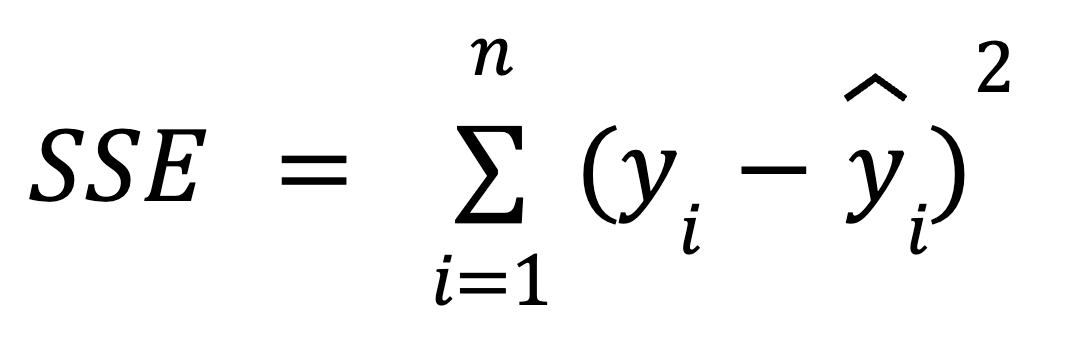
dengan:
Secara grafis, rumus ini dapat ditampilkan sebagai berikut:
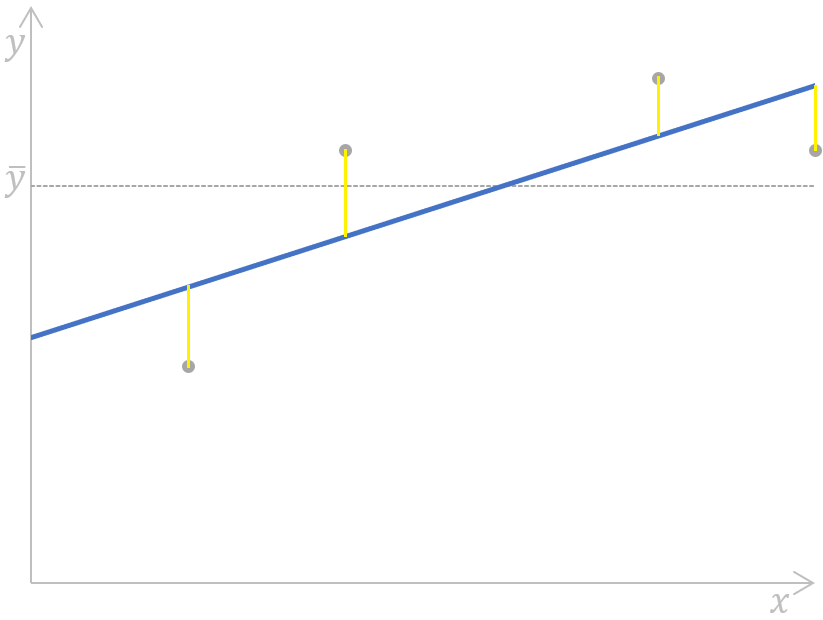 Menghitung jumlah kuadrat galat untuk regresi linear sederhana. Gambar oleh Penulis
Di sini, jarak (segmen kuning pada plot) untuk setiap pasangan nilai aktual-prediksi variabel dependen diukur, dikuadratkan, lalu dijumlahkan.
Dalam analisis regresi, meminimalkan SSE adalah kunci untuk meningkatkan akurasi model regresi, dan kita akan membangun intuisi tentang hal ini pada bab berikutnya.
Kami juga memiliki kumpulan tutorial berbasis teknologi untuk membantu Anda menguasai keterampilan membangun model regresi linear dan logistik sederhana, termasuk Essentials of Linear Regression in Python, How to Do Linear Regression in R, dan Linear Regression in Excel: A Comprehensive Guide For Beginners.
Hubungan matematis antara SST, SSR, dan SSE diekspresikan dengan rumus berikut:
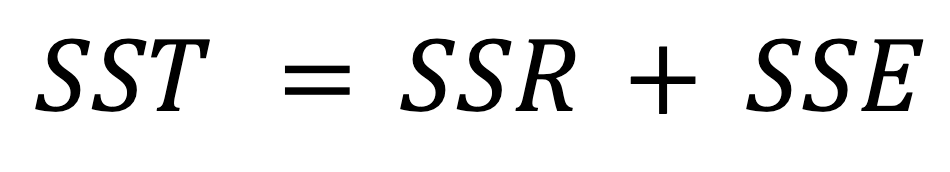
Sebelumnya, kami menyebutkan bahwa keragaman total (SST) terdiri dari keragaman yang dijelaskan (SSR) dan keragaman yang tidak dijelaskan (SSE), yang tercermin dalam rumus di atas.
Seperti yang telah kita lihat, SST tidak bergantung pada model regresi, sementara dua metrik lainnya bergantung. Ini berarti bahwa peningkatan akurasi model berkaitan dengan perubahan pada SSR atau SSE—khususnya, dengan meminimalkan SSE dan, karenanya, memaksimalkan SSR. Dari rumus di atas, kita dapat mengatakan bahwa semakin kecil SSE, semakin dekat SSR ke SST; sehingga, semakin baik model regresi kita menyesuaikan nilai-nilai variabel dependen yang teramati.
Jika SSE sama dengan 0, SSR akan bertepatan dengan SST, yang berarti semua nilai variabel dependen teramati dijelaskan secara sempurna oleh model regresi, yakni semuanya tepat berada pada garis regresi. Dalam skenario dunia nyata, ini tidak akan terjadi, tetapi kita harus berupaya meminimalkan SSE untuk mendapatkan model regresi yang lebih andal.
Karena SST merepresentasikan keragaman total dalam data, ketika kita menyesuaikan model regresi, kita menguraikan keragaman total ini menjadi dua bagian: SSR dan SSE. Uraian ini menarik secara geometris karena mencerminkan teorema Pythagoras dalam ruang berdimensi tinggi. Ini karena keragaman total dipartisi menjadi dua komponen ortogonal: keragaman yang dijelaskan oleh model dan galat yang tidak terjelaskan. Interpretasi ini masuk akal karena regresi pada dasarnya adalah tentang memproyeksikan data ke ruang ber-dimensi lebih rendah, yaitu ruang yang direntang oleh prediktor kita. Ikuti Linear Algebra for Data Science in R kami untuk mempelajari lebih lanjut konsep seperti subruang.
Dalam regresi ridge dan lasso, dekomposisi SST menjadi SSR dan SSE tidak mengikuti hubungan yang sama. Ini karena baik ridge maupun lasso menambahkan istilah regularisasi, atau penalti, pada fungsi biayanya masing-masing, yang mengubah hubungan tersebut. Pada versi regresi yang diregularisasi, SST tetap terdefinisi dengan baik, tetapi keragaman yang dijelaskan dan keragaman residual tidak lagi dijumlahkan menjadi SST karena adanya istilah regularisasi. Baca Regularization in R Tutorial: Ridge, Lasso and Elastic Net untuk mempelajari lebih lanjut.
R-kuadrat, juga dikenal sebagai koefisien determinasi, adalah ukuran statistik penting untuk mengevaluasi kualitas kecocokan model regresi dan, karenanya, daya prediksinya. Ukuran ini merepresentasikan proporsi keragaman pada variabel dependen yang dapat dijelaskan oleh variabel independen. R-kuadrat dapat dihitung dengan menguadratkan koefisien korelasi r, dan juga dapat dihitung menurut rumus berikut:
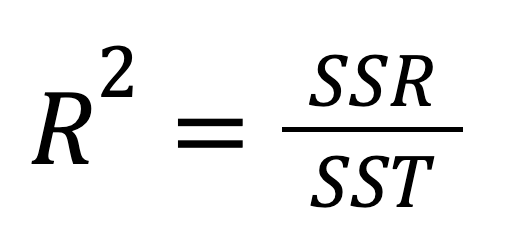
Atau, sebagai alternatif:
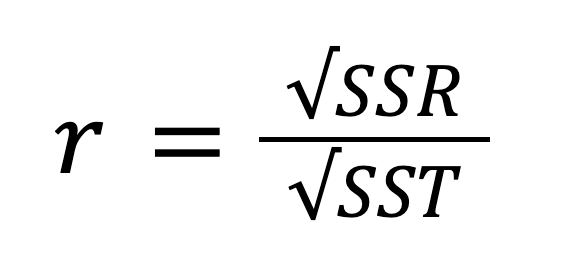
Mempertimbangkan hubungan antara SST, SSR, dan SSE, rumus di atas dapat dituliskan ulang sebagai:
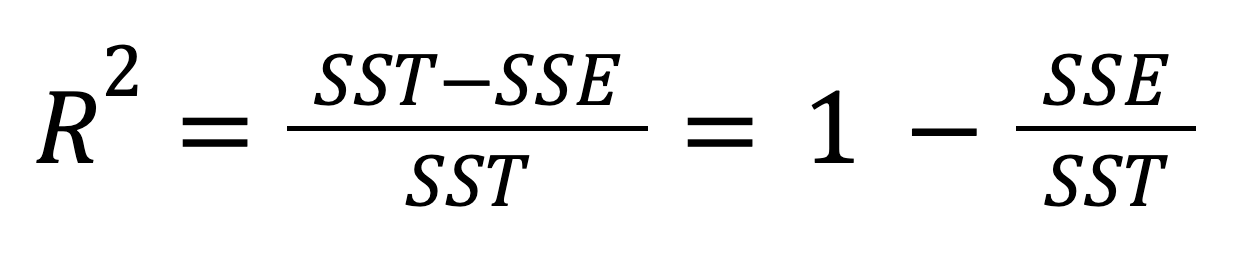
Nilai R-kuadrat berada pada rentang 0 hingga 1, inklusif. Jika R2 = 0, artinya model regresi kita sama sekali tidak menjelaskan porsi keragaman pada variabel dependen. Sebaliknya, jika R2 = 1, artinya model regresi kita menjelaskan seluruh keragaman pada variabel dependen secara sempurna. Dalam praktik, hampir mustahil menemui nilai ekstrem ini—kemungkinan besar, pada kasus nyata, kita akan melihat sesuatu di antara keduanya.
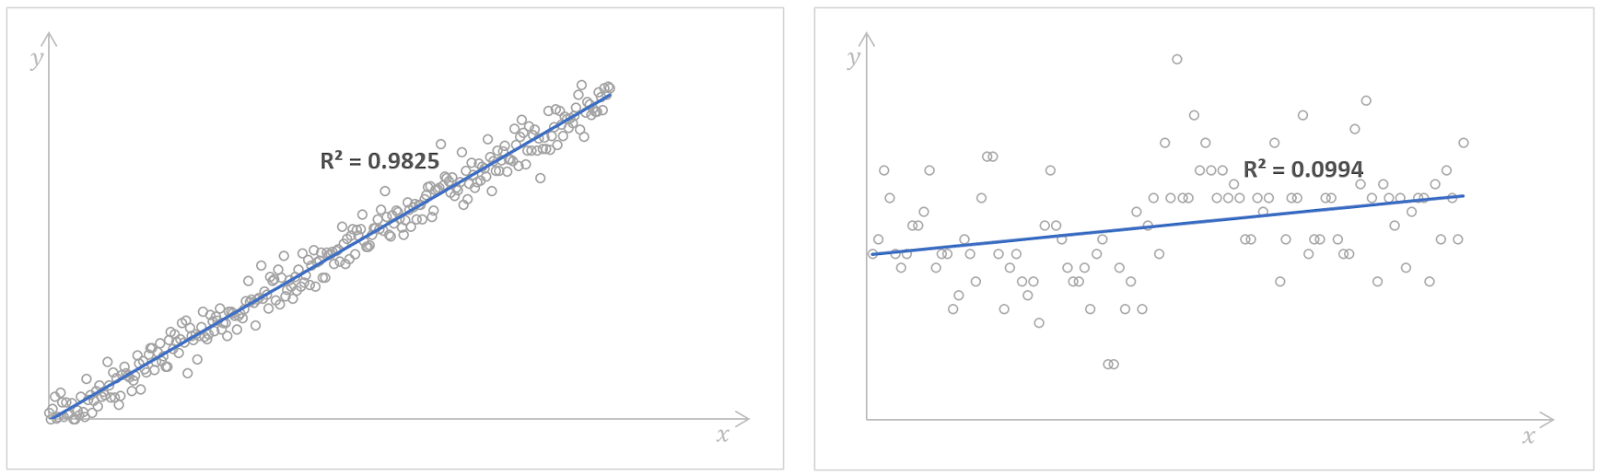
Model regresi dengan nilai R-kuadrat tinggi (kiri) dan rendah (kanan). Sumber: Kaggle Number of Books Read dan Kaggle Possum Regression. Gambar oleh Penulis.
Nilai R-kuadrat yang tinggi menunjukkan kinerja model yang baik, artinya variabel dependen dapat diprediksi oleh variabel independen dengan akurasi tinggi. Namun, tidak ada aturan baku mengenai nilai R-kuadrat yang dianggap cukup baik. Hal ini bergantung pada masing-masing kasus, kebutuhan presisi model regresi, dan seberapa besar keragaman yang kita perkirakan ada dalam data. Sering kali, hal ini juga bergantung pada domain yang terkait dengan analisis regresi kita. Misalnya, dalam bidang sains, kita akan mengupayakan nilai R-kuadrat lebih dari 0,8, sementara dalam ilmu sosial, nilai 0,3 bisa saja sudah cukup baik.
Sebagai catatan akhir, dalam regresi linear berganda, yaitu regresi dengan lebih dari satu variabel independen, kita sering mempertimbangkan adjusted R-squared, yang merupakan perluasan dari R-kuadrat dan memperhitungkan jumlah prediktor serta ukuran sampel.
Saat ini kita dapat dengan mudah dan cepat menghitung SST, SSR, dan SSE di sebagian besar perangkat lunak statistik dan bahasa pemrograman, namun tetap penting untuk benar-benar memahami maknanya, keterkaitannya, dan khususnya signifikansinya dalam analisis regresi. Pemahaman tentang hubungan antara ketiga komponen keragaman dan R-kuadrat membantu analis data dan ilmuwan data meningkatkan kinerja model dengan meminimalkan SSE sekaligus memaksimalkan SSR, sehingga mereka dapat membuat keputusan yang tepat tentang model regresinya.
Untuk membangun landasan statistik yang kuat dan mempelajari teknik statistik yang andal dengan bekerja menggunakan data dunia nyata, pertimbangkan jalur keterampilan yang lengkap dan ramah pemula berikut: Statistics Fundamentals in Python dan Statistics Fundamentals in R. Terakhir, jika Anda tertarik dengan cara koefisien regresi dihitung, lihat Normal Equation for Linear Regression Tutorial dan QR Decomposition in Machine Learning: A Detailed Guide kami.
Belajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



