
Corso
Introduzione alla regressione con statsmodels in Python
4 ore
62.6K
La somma dei quadrati è una misura statistica complessa che svolge un ruolo essenziale nell'analisi di regressione. Descrive la variabilità della variabile dipendente e può essere scomposta in tre componenti—somma totale dei quadrati (SST), somma dei quadrati della regressione (SSR) e somma dei quadrati degli errori (SSE)—che insieme aiutano a valutare le prestazioni di un modello di regressione.
In questo articolo parleremo delle tre componenti della somma dei quadrati, oltre che dell'R-quadro. Per prima cosa daremo una panoramica di ciascuna somma dei quadrati separatamente. Poi considereremo la relazione matematica tra di esse. Infine, esploreremo il legame tra SST, SSR e SSE e l'R-quadro, una metrica chiave per la valutazione dei modelli.
Iniziamo definendo cosa sono SST, SSR e SSE, come ciascuna misura riflette la variabilità totale e in che modo ognuna di esse aiuta a valutare la bontà dell'adattamento di un modello di regressione. Inoltre, vedremo come appare ciascuna somma dei quadrati in una semplice regressione lineare con una variabile dipendente e una indipendente.
Se, mentre passiamo alle definizioni, vuoi ripassare statistica senza scrivere codice, dai un'occhiata al nostro corso Introduction to Statistics. Per corsi introduttivi di statistica ancorati a una tecnologia specifica, abbiamo varie opzioni, tra cui Introduction to Statistics in Google Sheets, Introduction to Statistics in Python e Introduction to Statistics in R.
La somma totale dei quadrati (SST) è la somma delle differenze al quadrato tra ciascun valore della variabile dipendente osservata e la media di tale variabile. È nota anche come somma totale dei quadrati (TSS).
La somma totale dei quadrati rappresenta la variabilità totale della variabile dipendente, includendo sia le porzioni di variabilità spiegata sia quella non spiegata dal modello di regressione. Per sua natura, la SST riflette la dispersione complessiva dei singoli valori della variabile dipendente osservata rispetto al suo valore medio.
Di seguito è riportata la formula matematica per calcolare la SST:
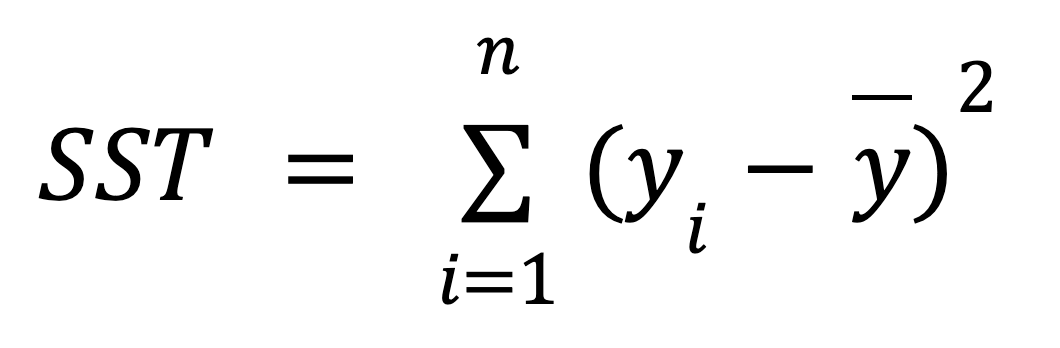
dove:
Il seguente grafico per una semplice regressione lineare mostra graficamente il significato della formula sopra:
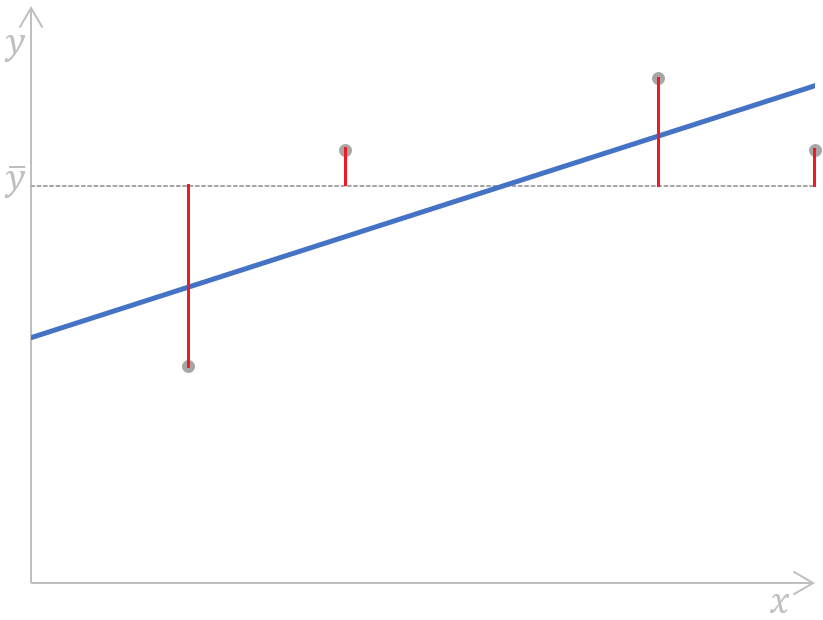
Calcolo della somma totale dei quadrati per una semplice regressione lineare. Immagine dell'autrice
Come possiamo vedere, le distanze (i segmenti rossi nel grafico) tra il valore medio (la linea tratteggiata grigia) della variabile dipendente osservata e ciascun valore (i punti grigi) di tale variabile vengono misurate, elevate al quadrato e sommate. Inoltre, questo grafico mostra chiaramente che la SST non dipende dal modello di regressione; dipende solo dai valori y osservati e dalla media della variabile dipendente osservata.
La somma dei quadrati della regressione (SSR) è la somma delle differenze al quadrato tra ciascun valore della variabile dipendente predetto da un modello di regressione per ciascun punto dati della variabile indipendente e la media della variabile dipendente osservata. Altri termini per questa metrica includono: somma dei quadrati della regressione, somma dei quadrati dovuta alla regressione e somma dei quadrati spiegata. Esiste persino un'altra abbreviazione—ESS.
La somma dei quadrati della regressione cattura la porzione della variabilità totale della variabile dipendente spiegata dal modello di regressione (da cui uno dei suoi termini alternativi—somma dei quadrati spiegata). Possiamo anche pensarla come l'errore ridotto grazie al modello di regressione.
Per calcolare la SSR, usiamo la seguente formula:
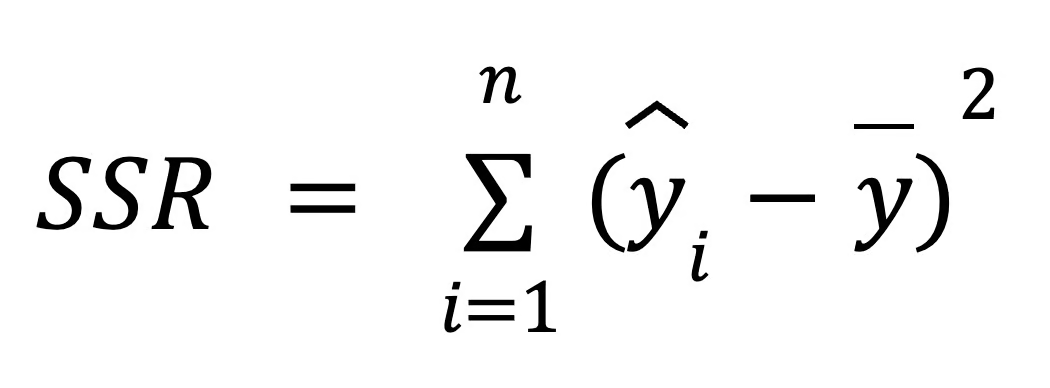
dove:
Possiamo illustrare questa formula con il seguente grafico di semplice regressione lineare:
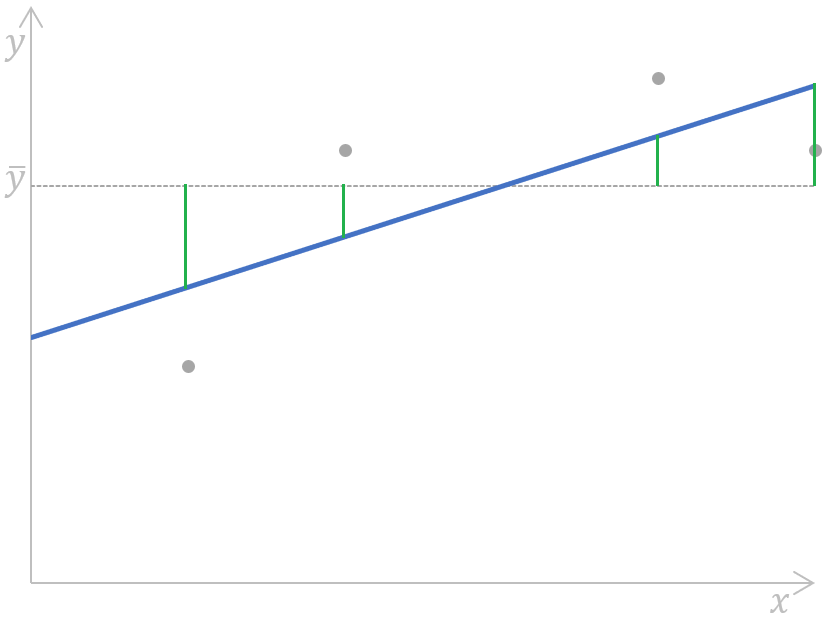 Calcolo della somma dei quadrati della regressione per una semplice regressione lineare. Immagine dell'autrice
In parole povere, le distanze (i segmenti verdi nel grafico) tra il valore medio (la linea tratteggiata grigia) della variabile dipendente osservata e ciascun valore della variabile dipendente predetto da un modello di regressione (la linea blu) per ciascun punto dati della variabile indipendente vengono misurate, elevate al quadrato e sommate.
Nell'analisi di regressione, la SSR contribuisce a misurare l'adattamento di un modello di regressione aiutando a determinare quanto bene il modello predice i punti dati. Avremo un quadro più chiaro di come ciò avvenga più avanti in questo tutorial quando discuteremo la relazione tra le tre metriche della somma dei quadrati.
La somma dei quadrati degli errori (SSE) è la somma delle differenze al quadrato tra ciascun valore della variabile dipendente osservata e il valore della variabile dipendente predetto da un modello di regressione per lo stesso punto dati della variabile indipendente. In altre parole, questa metrica misura la differenza tra valori effettivi e predetti della variabile dipendente.
La somma dei quadrati degli errori è chiamata anche somma dei quadrati degli errori, somma dei quadrati residua, somma dei quadrati dei residui o somma dei quadrati non spiegata. Oltre a SSE, può essere abbreviata come RSS, ESS o persino SSR—in quest'ultimo caso, può essere facilmente confusa con la SSR discussa in precedenza, che sta per somma dei quadrati della regressione.
La somma dei quadrati degli errori riflette l'errore residuo, o variabilità non spiegata, ovvero la porzione della variabilità totale della variabile dipendente che non può essere spiegata dal modello di regressione (per questo è anche chiamata somma dei quadrati non spiegata).
Possiamo usare la seguente formula per calcolare la SSE:
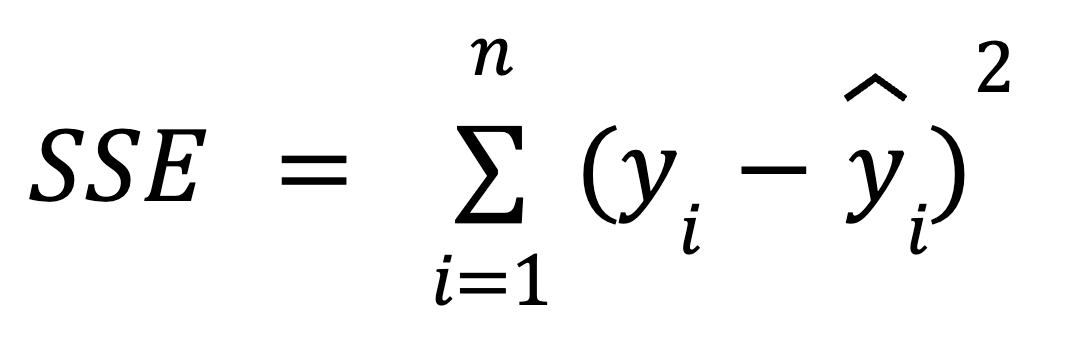
dove:
Graficamente, questa formula può essere rappresentata così:
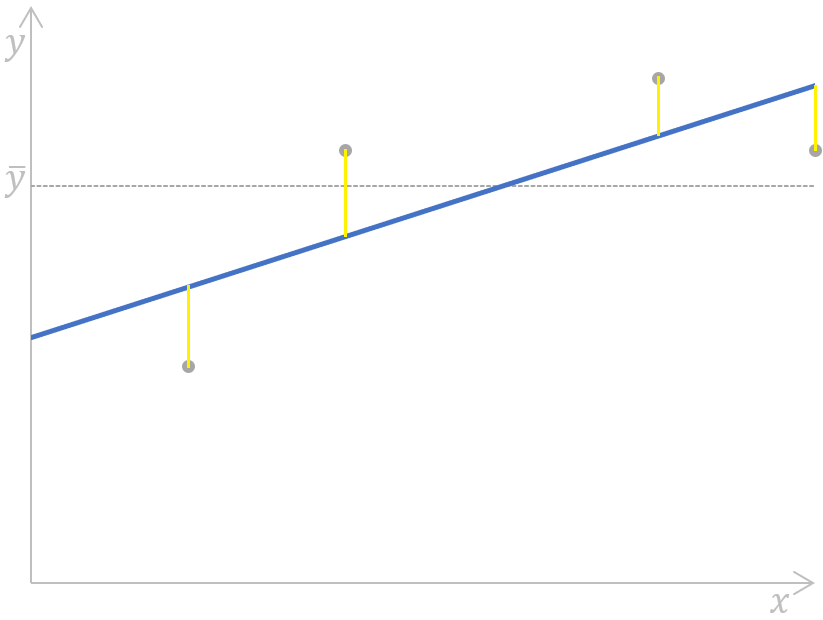 Calcolo della somma dei quadrati degli errori per una semplice regressione lineare. Immagine dell'autrice
Qui, le distanze (i segmenti gialli nel grafico) per ciascuna coppia di valori effettivi-predetti della variabile dipendente vengono misurate, elevate al quadrato e sommate.
Nell'analisi di regressione, minimizzare la SSE è fondamentale per migliorare l'accuratezza del modello di regressione, e nella prossima sezione costruiremo l'intuizione su questo punto.
Abbiamo anche una raccolta di tutorial specifici per tecnologia per aiutarti ad acquisire le competenze necessarie a costruire modelli di regressione lineare e logistica, tra cui Essentials of Linear Regression in Python, How to Do Linear Regression in R e Linear Regression in Excel: A Comprehensive Guide For Beginners.
La relazione matematica tra SST, SSR e SSE è espressa dalla seguente formula:
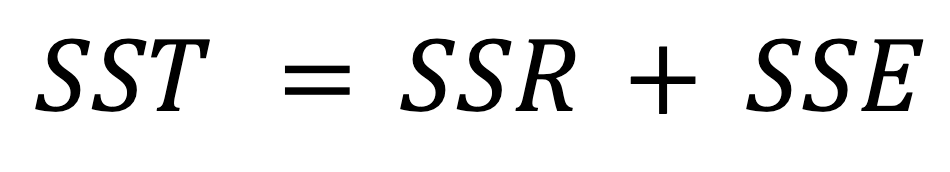
In precedenza, abbiamo menzionato che la variabilità totale (SST) è composta sia dalla variabilità spiegata (SSR) sia da quella non spiegata (SSE), come riflesso nella formula sopra.
Come visto prima, la SST non dipende dal modello di regressione, mentre le altre due metriche sì. Ciò significa che migliorare l'accuratezza del modello è legato a cambiamenti nella SSR o nella SSE—in particolare, minimizzando la SSE e, quindi, massimizzando la SSR. Dalla formula sopra, possiamo dire che quanto più piccola è la SSE, tanto più la SSR si avvicina alla SST; di conseguenza, migliore è l'adattamento del nostro modello di regressione ai valori osservati della variabile dipendente.
Se la SSE fosse pari a 0, la SSR coinciderebbe con la SST, il che significherebbe che tutti i valori osservati della variabile dipendente sono perfettamente spiegati dal modello di regressione, cioè tutti si troverebbero esattamente sulla linea di regressione. Nella pratica, questo non accade, ma dovremmo puntare a minimizzare la SSE per avere un modello di regressione più affidabile.
Poiché la SST rappresenta la variabilità totale nei dati, quando adattiamo un modello di regressione scomponiamo questa variabilità totale in due parti: SSR e SSE. Questa scomposizione è interessante dal punto di vista geometrico perché riflette il teorema di Pitagora in uno spazio ad alta dimensionalità. Questo perché la variabilità totale è suddivisa in due componenti ortogonali: la variabilità spiegata dal modello e l'errore non spiegato. Questa interpretazione ha senso perché la regressione consiste essenzialmente nel proiettare i dati in uno spazio a dimensionalità inferiore, che è lo spazio generato dai nostri predittori. Segui il nostro Linear Algebra for Data Science in R per saperne di più su concetti come i sottospazi.
Nella regressione ridge e lasso, la scomposizione della SST in SSR e SSE non segue la stessa relazione. Questo perché sia ridge che lasso aggiungono termini di regolarizzazione, o penalizzazioni, alle rispettive funzioni di costo, alterando la relazione. Nel caso di versioni regolarizzate della regressione, la SST è ancora ben definita, ma la variabilità spiegata e quella residua non sommano più a SST a causa del termine di regolarizzazione. Leggi il nostro Regularization in R Tutorial: Ridge, Lasso and Elastic Net per saperne di più.
L'R-quadro, noto anche come coefficiente di determinazione, è una misura statistica importante per valutare la qualità dell'adattamento di un modello di regressione e, quindi, il suo potere predittivo. Rappresenta la quota della variabilità della variabile dipendente che può essere spiegata dalla variabile indipendente. L'R-quadro può essere calcolato elevando al quadrato il coefficiente di correlazione r, e può anche essere calcolato secondo questa formula:
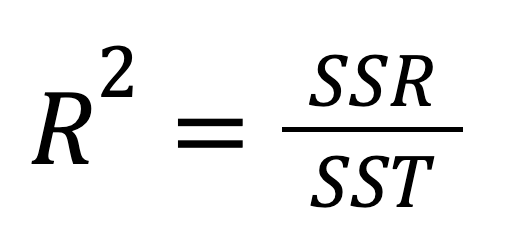
Oppure, in alternativa:
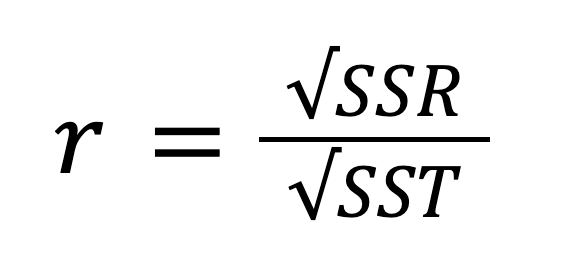
Considerando la relazione tra SST, SSR e SSE, la formula sopra può essere riscritta come:
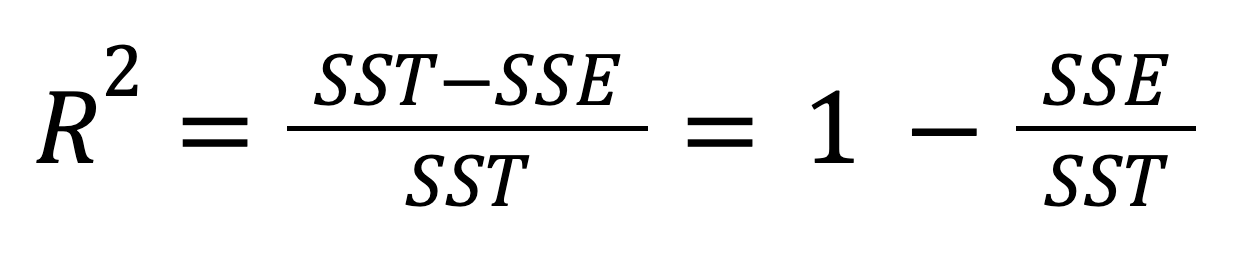
Il valore dell'R-quadro può andare da 0 a 1, inclusi. Se R2 = 0, significa che il nostro modello di regressione non spiega affatto alcuna porzione della variabilità della variabile dipendente. Se invece R2 = 1, significa che il nostro modello di regressione spiega perfettamente l'intera variabilità della variabile dipendente. In pratica, è quasi impossibile incontrare questi valori estremi—nei casi reali, con ogni probabilità, vedremo qualcosa nel mezzo.
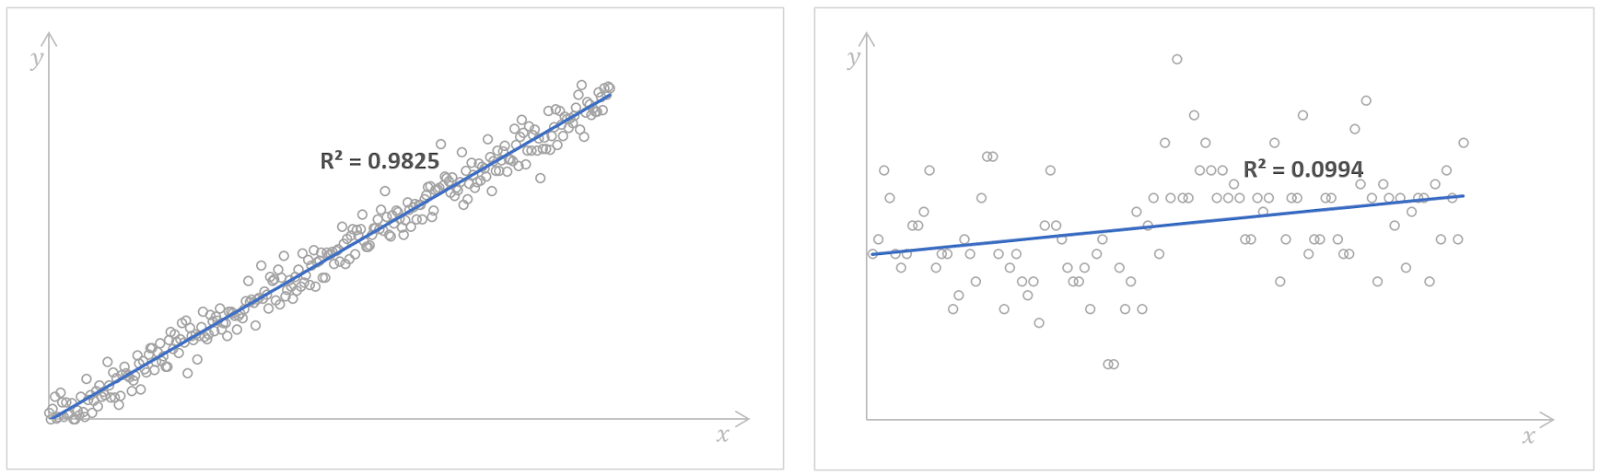
Modelli di regressione con valori di R-quadro alti (a sinistra) e bassi (a destra). Fonte: Kaggle Number of Books Read e Kaggle Possum Regression. Immagine dell'autrice.
Un valore alto di R-quadro indica buone prestazioni del modello, ovvero che la variabile dipendente può essere predetta dalla variabile indipendente con elevata accuratezza. Tuttavia, non esiste una regola generale su quale valore di R-quadro debba essere considerato sufficientemente buono. Dipende da ogni singolo caso, dai requisiti di precisione del modello di regressione e da quanta variabilità ci aspettiamo di vedere nei dati. Spesso dipende anche dal dominio a cui è legata la nostra analisi di regressione. Ad esempio, nei campi scientifici cercheremmo un R-quadro superiore a 0,8, mentre nelle scienze sociali un valore di 0,3 potrebbe essere già sufficiente.
Come nota finale, va detto che nella regressione lineare multipla, cioè con più di una variabile indipendente, spesso si considera invece l'R-quadro aggiustato, un'estensione dell'R-quadro che tiene conto del numero di predittori e della dimensione del campione.
Sebbene oggi possiamo calcolare facilmente e rapidamente SST, SSR e SSE nella maggior parte dei software statistici e dei linguaggi di programmazione, vale comunque la pena capire davvero cosa significano, come sono interconnessi e, in particolare, la loro importanza nell'analisi di regressione. La comprensione del rapporto tra le tre componenti della variabilità e l'R-quadro aiuta analisti e data scientist a migliorare le prestazioni del modello minimizzando la SSE e massimizzando la SSR, così da prendere decisioni informate sui propri modelli di regressione.
Per costruire solide basi di statistica e imparare tecniche statistiche potenti lavorando con dati reali, considera questi percorsi di competenze completi e adatti ai principianti: Statistics Fundamentals in Python e Statistics Fundamentals in R. Infine, se ti interessa come vengono calcolati i coefficienti di regressione, dai un'occhiata ai nostri tutorial Normal Equation for Linear Regression e QR Decomposition in Machine Learning: A Detailed Guide.
Impara con DataCamp
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min



