
Last chance! 50% off DataCamp Premium
Sale ends in
De som van kwadraten is een complexe statistische maatstaf die een essentiële rol speelt in regressieanalyse. Ze beschrijft de variabiliteit van de afhankelijke variabele en kan worden opgesplitst in drie componenten—de totale som van kwadraten (SST), de regressiesom van kwadraten (SSR) en de foutsom van kwadraten (SSE)—die samen helpen om de prestaties van een regressiemodel te beoordelen.
In dit artikel bespreken we de drie componenten van de som van kwadraten, evenals de R-kwadraat. We geven eerst een overzicht van elk van de sommen van kwadraten afzonderlijk. Vervolgens bekijken we de wiskundige relatie ertussen. Tot slot verkennen we de link tussen SST, SSR en SSE en R-kwadraat, een belangrijke maatstaf voor modelbeoordeling.
Laten we beginnen met het definiëren van wat de SST, SSR en SSE zijn, hoe elke maat de totale variabiliteit weergeeft en hoe elk helpt om de kwaliteit van de fit van een regressiemodel te evalueren. Daarnaast bekijken we hoe elke som van kwadraten eruitziet bij een eenvoudige lineaire regressie met één afhankelijke en één onafhankelijke variabele.
Als je tijdens het doornemen van de definities statistiek wilt herhalen zonder te coderen, bekijk dan onze cursus Introduction to Statistics. Voor inleidende statistiekcursussen rond een specifieke technologie hebben we opties zoals Introduction to Statistics in Google Sheets, Introduction to Statistics in Python en Introduction to Statistics in R.
De totale som van kwadraten (SST) is de som van de gekwadrateerde verschillen tussen elke waarneming van de afhankelijke variabele en het gemiddelde van die variabele. Dit staat ook bekend als de total sum of squares (TSS).
De totale som van kwadraten vertegenwoordigt de totale variabiliteit in de afhankelijke variabele, inclusief zowel het door het regressiemodel verklaarde als het onverklaarde deel van de variabiliteit. Van nature weerspiegelt de SST de algehele spreiding van individuele waarden van de geobserveerde afhankelijke variabele ten opzichte van haar gemiddelde.
Hieronder staat de wiskundige formule voor het berekenen van de SST:
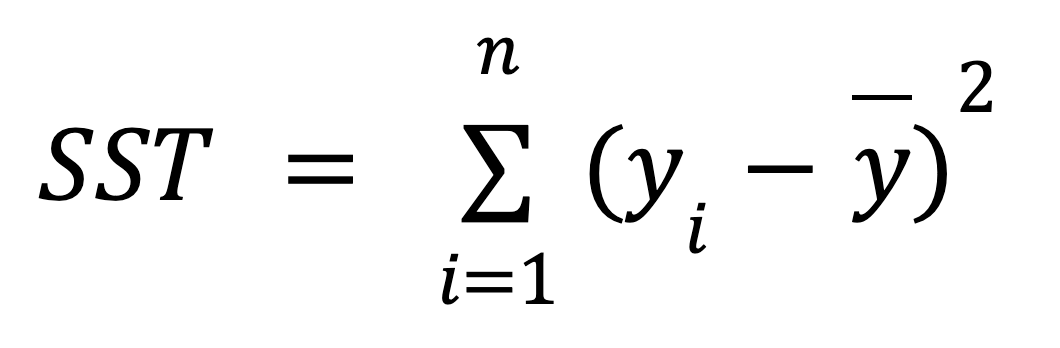
waarbij:
De volgende grafiek voor een eenvoudige lineaire regressie laat de betekenis van bovenstaande formule grafisch zien:
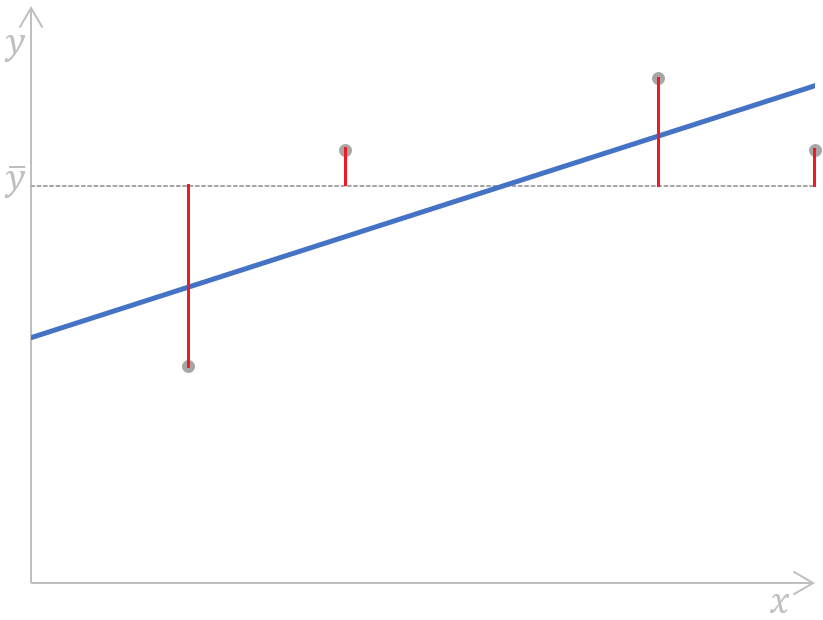
De totale som van kwadraten berekenen voor een eenvoudige lineaire regressie. Afbeelding door de auteur
Zoals we zien, worden de afstanden (de rode segmenten in de grafiek) tussen de gemiddelde waarde (de grijze stippellijn) van de geobserveerde afhankelijke variabele en elke waarde (de grijze punten) van die variabele gemeten, gekwadrateerd en opgeteld. Daarnaast laat deze grafiek duidelijk zien dat de SST niet afhangt van het regressiemodel; ze hangt alleen af van de geobserveerde y-waarden en het gemiddelde van de geobserveerde afhankelijke variabele.
De regressiesom van kwadraten (SSR) is de som van de gekwadrateerde verschillen tussen elke door een regressiemodel voorspelde waarde van de afhankelijke variabele voor elk datapunt van de onafhankelijke variabele en het gemiddelde van de geobserveerde afhankelijke variabele. Andere termen voor deze maatstaf zijn: regressiesom van kwadraten, som van kwadraten door regressie en verklaarde som van kwadraten. Er is zelfs nog een afkorting voor—ESS.
De regressiesom van kwadraten vangt het deel van de totale variabiliteit in de afhankelijke variabele dat door het regressiemodel wordt verklaard (vandaar een van de alternatieve termen—verklaarde som van kwadraten). Je kunt het ook zien als de fout die door het regressiemodel is verminderd.
Om de SSR te berekenen, gebruiken we de volgende formule:
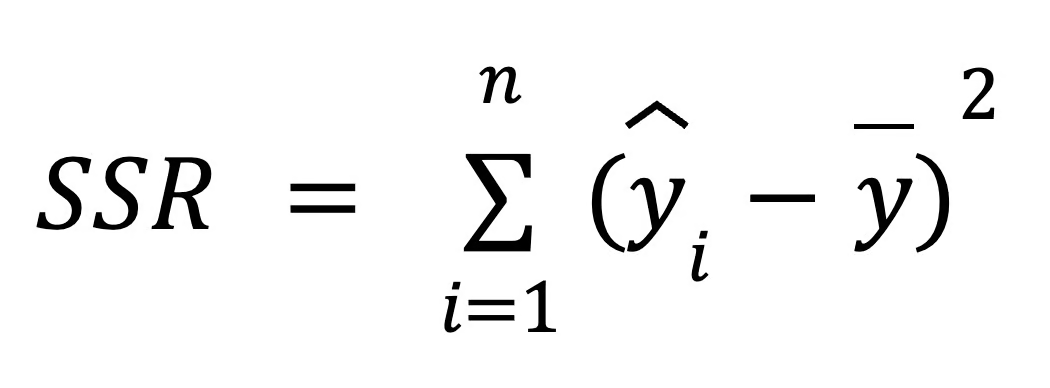
waarbij:
We kunnen deze formule illustreren in de volgende grafiek van een eenvoudige lineaire regressie:
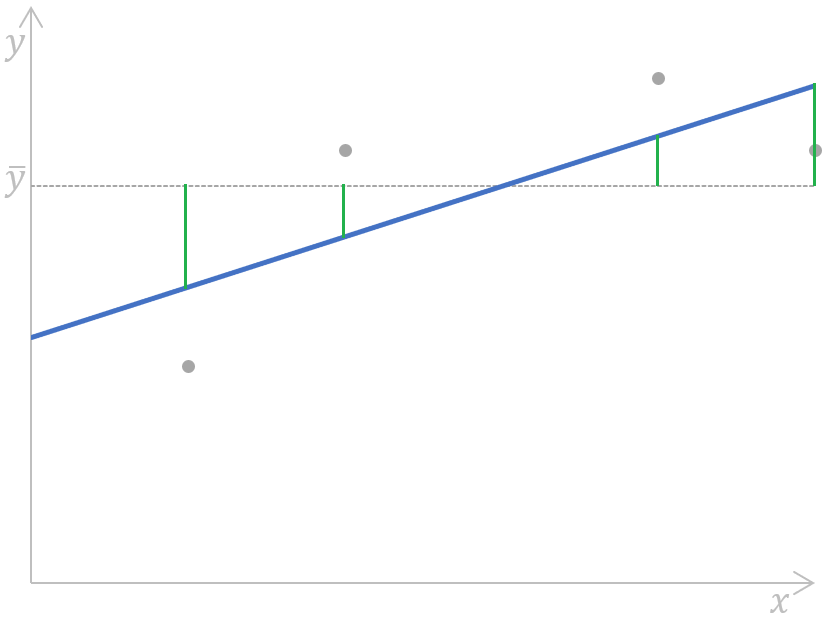 De regressiesom van kwadraten berekenen voor een eenvoudige lineaire regressie. Afbeelding door de auteur
Kort gezegd worden de afstanden (de groene segmenten in de grafiek) tussen de gemiddelde waarde (de grijze stippellijn) van de geobserveerde afhankelijke variabele en elke door een regressiemodel voorspelde waarde van de afhankelijke variabele (de blauwe lijn) voor elk datapunt van de onafhankelijke variabele gemeten, gekwadrateerd en opgeteld.
In regressieanalyse draagt de SSR bij aan het meten van de fit van een regressiemodel door te helpen bepalen hoe goed het model datapunten voorspelt. Later in deze tutorial wordt dit duidelijker wanneer we de relatie tussen de drie som-van-kwadraten-maatstaven bespreken.
De foutsom van kwadraten (SSE) is de som van de gekwadrateerde verschillen tussen elke waarde van de geobserveerde afhankelijke variabele en de waarde van de afhankelijke variabele die door een regressiemodel wordt voorspeld voor hetzelfde datapunt van de onafhankelijke variabele. Met andere woorden: deze maatstaf meet het verschil tussen werkelijke en voorspelde waarden van de afhankelijke variabele.
De foutsom van kwadraten wordt ook wel error sum of squares, residual sum of squares, som van residuen of onverklaarde som van kwadraten genoemd. Naast SSE wordt soms ook RSS, ESS of zelfs SSR gebruikt—in dat laatste geval kan het makkelijk verward worden met de eerder besproken SSR, die staat voor regressiesom van kwadraten.
De foutsom van kwadraten weerspiegelt de overblijvende fout, of onverklaarde variabiliteit: het deel van de totale variabiliteit in de afhankelijke variabele dat niet door het regressiemodel wordt verklaard (daarom heet het ook wel de onverklaarde som van kwadraten).
We kunnen de volgende formule gebruiken om de SSE te berekenen:
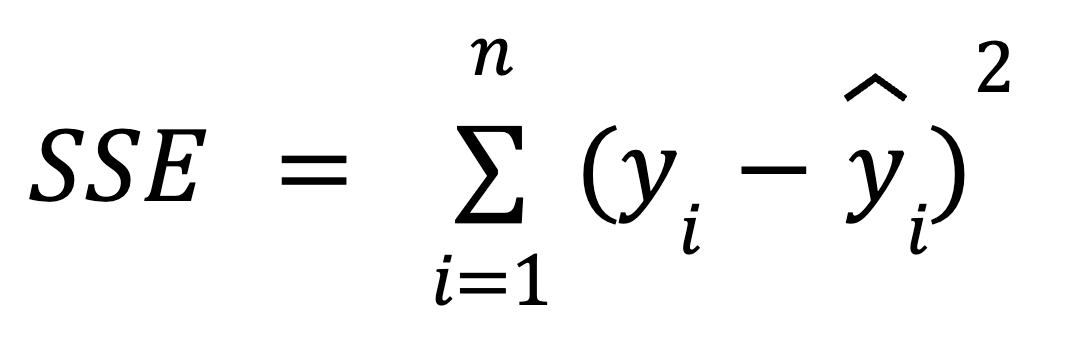
waarbij:
Grafisch kan deze formule als volgt worden weergegeven:
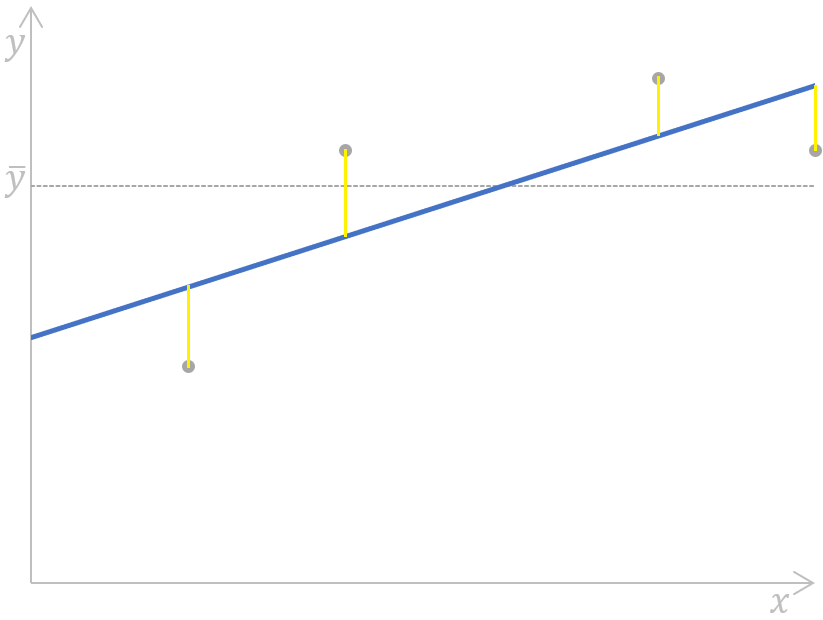 De foutsom van kwadraten berekenen voor een eenvoudige lineaire regressie. Afbeelding door de auteur
Hier worden de afstanden (de gele segmenten in de grafiek) voor elk paar werkelijke-voorspelde waarden van de afhankelijke variabele gemeten, gekwadrateerd en opgeteld.
In regressieanalyse is het minimaliseren van de SSE cruciaal om de nauwkeurigheid van het regressiemodel te verbeteren, en in het volgende hoofdstuk bouwen we hier gevoel bij op.
We hebben ook een verzameling technologietutorials om je te helpen de vaardigheden op te doen die nodig zijn om eenvoudige lineaire en logistische regressiemodellen te bouwen, waaronder Essentials of Linear Regression in Python, How to Do Linear Regression in R en Linear Regression in Excel: A Comprehensive Guide For Beginners.
De wiskundige relatie tussen de SST, SSR en SSE wordt uitgedrukt door de volgende formule:
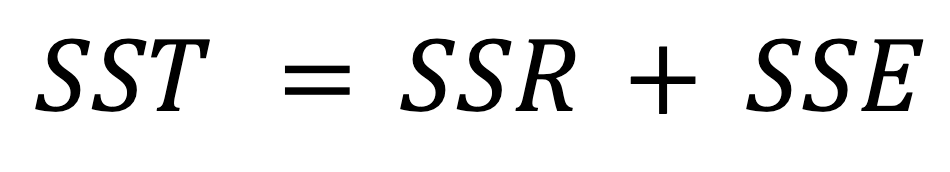
Eerder noemden we dat de totale variabiliteit (SST) bestaat uit zowel de verklaarde variabiliteit (SSR) als de onverklaarde variabiliteit (SSE), wat in bovenstaande formule wordt weerspiegeld.
Zoals we eerder zagen, hangt de SST niet af van het regressiemodel, terwijl de andere twee maatstaven dat wel doen. Dit betekent dat het verbeteren van de nauwkeurigheid van het model te maken heeft met veranderingen in de SSR of SSE—concreet door de SSE te minimaliseren en daarmee de SSR te maximaliseren. Uit de bovenstaande formule volgt dat hoe kleiner de SSE, hoe dichter de SSR bij de SST ligt; dus hoe beter ons regressiemodel past bij de geobserveerde waarden van de afhankelijke variabele.
Als de SSE gelijk zou zijn aan 0, zou de SSR samenvallen met de SST, wat zou betekenen dat alle geobserveerde waarden van de afhankelijke variabele perfect worden verklaard door het regressiemodel, oftewel: ze liggen exact op de regressielijn. In praktijksituaties gebeurt dit niet, maar we moeten wel streven naar het minimaliseren van de SSE om een betrouwbaarder regressiemodel te krijgen.
Omdat de SST de totale variabiliteit in de data vertegenwoordigt, splitsen we bij het fitten van een regressiemodel deze totale variabiliteit op in twee delen: SSR en SSE. Deze ontbinding is geometrisch interessant omdat ze de stelling van Pythagoras weerspiegelt in een hoog-dimensionale ruimte. Dat komt doordat de totale variabiliteit wordt opgedeeld in twee orthogonale componenten: de door het model verklaarde variabiliteit en de onverklaarde fout. Deze interpretatie is logisch omdat regressie in wezen neerkomt op het projecteren van data op een lager-dimensionale ruimte, namelijk de ruimte die wordt opgespannen door onze predictoren. Volg onze cursus Linear Algebra for Data Science in R om meer te leren over concepten zoals deelruimten.
Bij ridge- en lasso-regressie volgt de ontbinding van SST in SSR en SSE niet dezelfde relatie. Dat komt omdat zowel ridge als lasso regularisatietermen, of straffen, toevoegen aan hun respectieve kostenfuncties, wat de relatie verandert. Bij geregulariseerde versies van regressie is de SST nog steeds goed gedefinieerd, maar de verklaarde variabiliteit en de residuele variabiliteit zijn samen niet langer gelijk aan SST vanwege de regularisatieterm. Lees onze Regularization in R Tutorial: Ridge, Lasso and Elastic Net voor meer informatie.
R-kwadraat, ook wel de determinatiecoëfficiënt genoemd, is een belangrijke statistische maatstaf om de kwaliteit van de fit van een regressiemodel en dus de voorspellende kracht te evalueren. Het geeft het aandeel weer van de variabiliteit in de afhankelijke variabele dat kan worden verklaard door de onafhankelijke variabele. R-kwadraat kan worden berekend door de correlatiecoëfficiënt r te kwadrateren, en kan ook als volgt worden berekend:
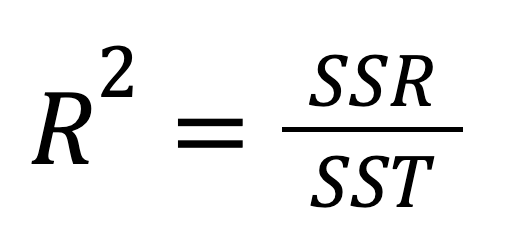
Of, alternatief:
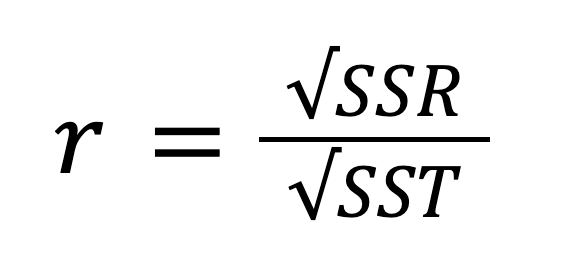
Gezien de relatie tussen SST, SSR en SSE kan bovenstaande formule worden herschreven als:
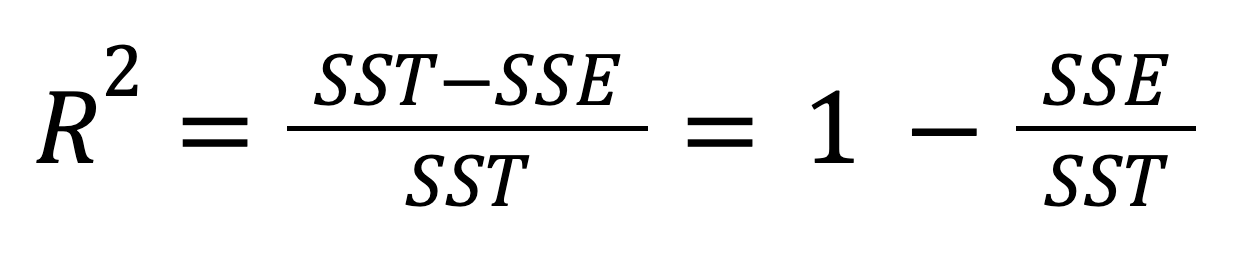
De waarde van R-kwadraat ligt tussen 0 en 1, inclusief. Als R2 = 0, betekent dit dat ons regressiemodel helemaal geen deel van de variabiliteit in de afhankelijke variabele verklaart. Als R2 = 1, betekent dit dat ons regressiemodel de volledige variabiliteit in de afhankelijke variabele perfect verklaart. In de praktijk kom je deze extreme waarden bijna nooit tegen—in realistische gevallen zien we meestal iets daartussenin.
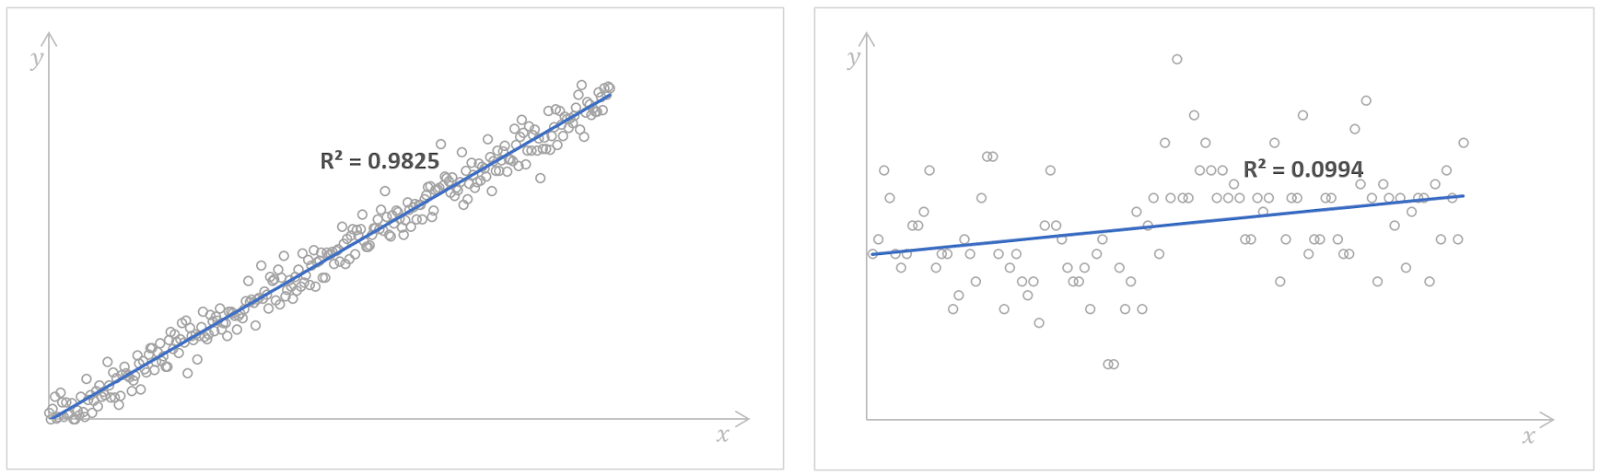
Regressiemodellen met hoge (links) en lage (rechts) R-kwadraatwaarden. Bron: Kaggle Number of Books Read en Kaggle Possum Regression. Afbeelding door de auteur.
Een hoge R-kwadraatwaarde duidt op goede modelprestaties, wat betekent dat de afhankelijke variabele met hoge nauwkeurigheid kan worden voorspeld op basis van de onafhankelijke variabele. Er is echter geen vuistregel voor welke R-kwadraatwaarde als goed genoeg moet worden beschouwd. Het hangt af van het specifieke geval, de eisen aan de precisie van een regressiemodel en hoeveel variabiliteit we in de data verwachten. Vaak hangt het ook af van het domein waarop onze regressieanalyse betrekking heeft. In wetenschappelijke velden zoeken we bijvoorbeeld naar een R-kwadraat groter dan 0,8, terwijl in de sociale wetenschappen een waarde van 0,3 al goed genoeg kan zijn.
Tot slot merken we op dat we bij meervoudige lineaire regressie, dus regressie met meer dan één onafhankelijke variabele, vaak in plaats daarvan de gecorrigeerde R-kwadraat gebruiken, een uitbreiding op R-kwadraat die rekening houdt met het aantal voorspellers en de steekproefgrootte.
Hoewel we tegenwoordig in de meeste statistische software en programmeertalen de SST, SSR en SSE eenvoudig en snel kunnen berekenen, is het nog steeds de moeite waard om echt te begrijpen wat ze betekenen, hoe ze samenhangen en met name hun betekenis in regressieanalyse. Inzicht in de relatie tussen de drie componenten van de variabiliteit en R-kwadraat helpt data-analisten en data scientists om de modelprestaties te verbeteren door de SSE te minimaliseren en de SSR te maximaliseren, zodat ze weloverwogen beslissingen over hun regressiemodellen kunnen nemen.
Wil je een sterke basis in statistiek opbouwen en krachtige statistische technieken leren door met real-world data te werken? Overweeg dan deze uitgebreide en beginnersvriendelijke skill tracks: Statistics Fundamentals in Python en Statistics Fundamentals in R. Ben je tot slot benieuwd hoe de regressiecoëfficiënten worden berekend? Bekijk dan onze Normal Equation for Linear Regression Tutorial en QR Decomposition in Machine Learning: A Detailed Guide.
Leer met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min


