Kareler toplamı, regresyon analizinde temel bir rol oynayan karmaşık bir istatistiksel ölçüdür. Bağımlı değişkendeki değişkenliği tanımlar ve üç bileşene ayrılabilir: toplam kareler toplamı (SST), regresyon kareler toplamı (SSR) ve hata kareler toplamı (SSE). Bu üçü birlikte bir regresyon modelinin performansını değerlendirmeye yardımcı olur.
Bu yazıda, kareler toplamının üç bileşenini ve ayrıca R-kareyi ele alacağız. Önce her bir kareler toplamına ayrı ayrı genel bir bakış sunacağız. Ardından, aralarındaki matematiksel ilişkiyi inceleyeceğiz. Son olarak, SST, SSR ve SSE’nin, önemli bir model değerlendirme metriği olan R-kare ile bağlantısını keşfedeceğiz.
SST, SSR ve SSE nedir?
SST, SSR ve SSE’nin ne olduğunu, her bir ölçütün toplam değişkenliği nasıl yansıttığını ve her birinin bir regresyon modelinin uyum kalitesini değerlendirmeye nasıl yardımcı olduğunu tanımlayarak başlayalım. Ayrıca, biri bağımlı diğeri bağımsız olmak üzere tek değişkenli basit doğrusal regresyon üzerinde her bir kareler toplamının nasıl göründüğüne bakacağız.
Tanımları incelerken, kodlama olmadan istatistikleri gözden geçirmek isterseniz, Introduction to Statistics kursumuza göz atın. Belirli bir teknolojiye dayalı giriş düzeyi istatistik kursları için Introduction to Statistics in Google Sheets, Introduction to Statistics in Python ve Introduction to Statistics in R gibi seçeneklerimiz var.
Toplam kareler toplamı (SST)
Toplam kareler toplamı (SST), gözlenen bağımlı değişkenin her bir değerinin bu değişkenin ortalamasından farklarının kareleri toplamıdır. Toplam kareler toplamı (TSS) olarak da bilinir.
Toplam kareler toplamı, regresyon modeli tarafından açıklanan ve açıklanamayan değişkenlik bölümlerini de kapsayarak, bağımlı değişkendeki toplam değişkenliği temsil eder. Doğası gereği, SST gözlenen bağımlı değişkenin tekil değerlerinin ortalamasından genel saçılımını yansıtır.
Aşağıda SST’yi hesaplamanın matematiksel formülü yer almaktadır:
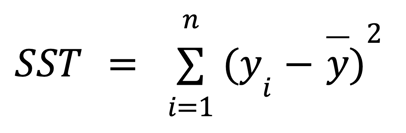
burada:
- yi, n veri noktasının her biri için gözlenen bağımlı değişkenin değeridir.
- ȳ, gözlenen bağımlı değişkenin ortalama değeridir.
Aşağıdaki basit doğrusal regresyon grafiği yukarıdaki formülün anlamını görsel olarak gösterir:
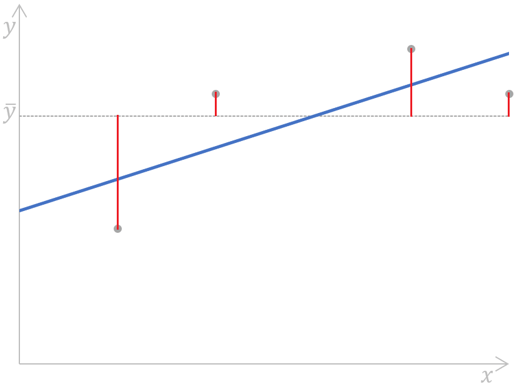
Basit doğrusal regresyon için toplam kareler toplamının hesaplanması. Görsel: Yazar
Gördüğümüz gibi, gözlenen bağımlı değişkenin ortalama değeri (gri kesikli çizgi) ile bu değişkenin her bir değeri (gri noktalar) arasındaki mesafeler (grafikteki kırmızı parçalar) ölçülür, kareleri alınır ve toplanır. Ayrıca bu grafik, SST’nin regresyon modeline bağlı olmadığını; yalnızca gözlenen y-değerlerine ve gözlenen bağımlı değişkenin ortalamasına bağlı olduğunu açıkça gösterir.
Regresyon kareler toplamı (SSR)
Regresyon kareler toplamı (SSR), bir regresyon modeli tarafından tahmin edilen bağımlı değişkenin her bir değeri ile gözlenen bağımlı değişkenin ortalaması arasındaki farkların kareleri toplamıdır. Bu metrik için diğer adlar şunlardır: regresyon kareler toplamı, regresyona bağlı kareler toplamı ve açıklanan kareler toplamı. Hatta başka bir kısaltması daha vardır: ESS.
Regresyon kareler toplamı, regresyon modeli tarafından açıklanan bağımlı değişkendeki toplam değişkenlik payını yakalar (bu nedenle alternatif adlarından biri açıklanan kareler toplamıdır). Bunu, regresyon modeli sayesinde azalan hata olarak da düşünebiliriz.
SSR’yi hesaplamak için aşağıdaki formülü kullanırız:
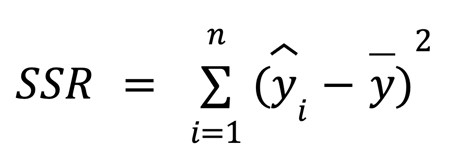
burada:
- yi, bağımsız değişkenin n veri noktasının her biri için bir regresyon modeli tarafından tahmin edilen bağımlı değişken değeridir,
- ȳ gözlenen bağımlı değişkenin ortalama değeridir.
Bu formülü aşağıdaki basit doğrusal regresyon grafiğiyle görselleştirebiliriz:
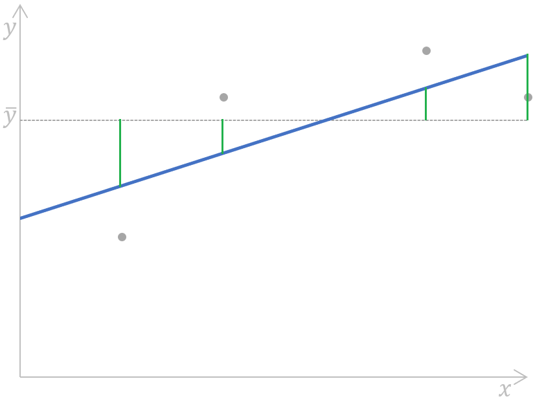 Basit doğrusal regresyon için regresyon kareler toplamının hesaplanması. Görsel: Yazar
Kısaca, gözlenen bağımlı değişkenin ortalama değeri (gri kesikli çizgi) ile bağımsız değişkenin her veri noktası için bir regresyon modeli tarafından tahmin edilen bağımlı değişken değerleri (mavi çizgi) arasındaki mesafeler (grafikteki yeşil parçalar) ölçülür, kareleri alınır ve toplanır.
Regresyon analizinde, SSR modelin veri noktalarını ne kadar iyi tahmin ettiğini belirlemeye yardımcı olarak bir regresyon modelinin uyumunu ölçmeye katkıda bulunur. Kareler toplamının üç metriği arasındaki ilişkiyi tartışırken bu durumun nasıl gerçekleştiğini daha net göreceğiz.
Hata kareler toplamı (SSE)
Hata kareler toplamı (SSE), gözlenen bağımlı değişkenin her bir değeri ile aynı bağımsız değişken veri noktası için bir regresyon modeli tarafından tahmin edilen bağımlı değişken değeri arasındaki farkların kareleri toplamıdır. Başka bir deyişle, bu metrik bağımlı değişkenin gerçek ve tahmin edilen değerleri arasındaki farkı ölçer.
Hata kareler toplamı; hata kareler toplamı, artık kareler toplamı, artıkların kareler toplamı veya açıklanamayan kareler toplamı olarak da adlandırılır. SSE’ye ek olarak RSS, ESS ve hatta SSR olarak da kısaltılabilir—son durumda, regresyon kareler toplamını ifade eden ve daha önce tartıştığımız SSR ile kolayca karıştırılabilir.
Hata kareler toplamı, kalan hatayı veya açıklanamayan değişkenliği yansıtır; yani, regresyon modeli tarafından açıklanamayan, bağımlı değişkendeki toplam değişkenliğin bölümüdür (bu nedenle açıklanamayan kareler toplamı olarak da adlandırılır).
SSE’yi hesaplamak için aşağıdaki formülü kullanabiliriz:
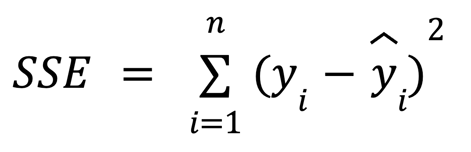
burada:
- yi, bağımsız değişkenin n veri noktasının her biri için bağımlı değişkenin gerçek değeridir.
- ŷ, bağımsız değişkenin n veri noktasının her biri için bağımlı değişkenin tahmin edilen değeridir.
Bu formül grafiksel olarak şu şekilde gösterilebilir:
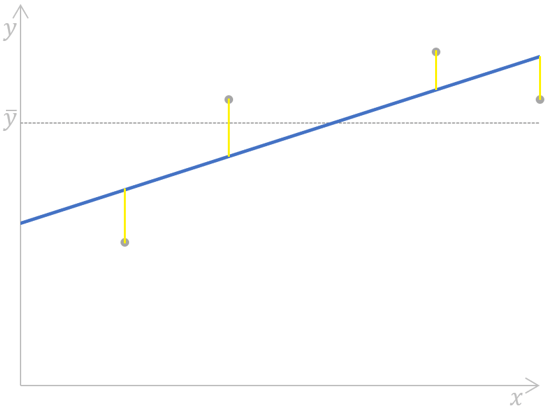 Basit doğrusal regresyon için hata kareler toplamının hesaplanması. Görsel: Yazar
Burada, bağımlı değişkenin her bir gerçek-tahmin çifti için mesafeler (grafikteki sarı parçalar) ölçülür, kareleri alınır ve toplanır.
Regresyon analizinde SSE’yi en aza indirmek, regresyon modelinin doğruluğunu artırmanın anahtarıdır; bir sonraki bölümde bununla ilgili içgörü oluşturacağız.
Ayrıca, basit doğrusal ve lojistik regresyon modelleri kurmak için gereken becerileri kazanmanıza yardımcı olacak teknolojiye özel öğreticiler koleksiyonumuz da var: Essentials of Linear Regression in Python, How to Do Linear Regression in R ve Linear Regression in Excel: A Comprehensive Guide For Beginners.
SST, SSR ve SSE Arasındaki Matematiksel İlişki
SST, SSR ve SSE arasındaki matematiksel ilişki aşağıdaki formülle ifade edilir:
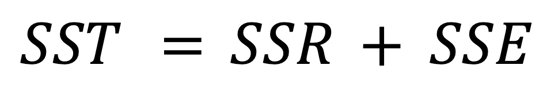
Daha önce, toplam değişkenliğin (SST) hem açıklanan değişkenlikten (SSR) hem de açıklanamayan değişkenlikten (SSE) oluştuğunu söylemiştik; bu durum yukarıdaki formülde yansıtılmaktadır.
Daha önce gördüğümüz gibi, SST regresyon modeline bağlı değildir, oysa diğer iki metrik bağlıdır. Bu, modelin doğruluğunu artırmanın SSR veya SSE’deki değişimlerle ilişkili olduğu anlamına gelir—özellikle, SSE’yi en aza indirerek ve dolayısıyla SSR’yi en yükseğe çıkararak. Yukarıdaki formülden, SSE ne kadar küçükse SSR’nin SST’ye o kadar yaklaştığını; dolayısıyla, regresyon modelimizin bağımlı değişkenin gözlenen değerlerine o kadar iyi uyduğunu söyleyebiliriz.
Eğer SSE 0’a eşit olsaydı, SSR SST ile çakışırdı; bu da bağımlı değişkenin tüm gözlenen değerlerinin regresyon modeli tarafından mükemmel şekilde açıklandığı, yani hepsinin tam olarak regresyon çizgisi üzerinde bulunduğu anlamına gelirdi. Gerçek dünyada bu olmaz, ancak daha güvenilir bir regresyon modeli için SSE’yi en aza indirmeyi hedeflemeliyiz.
Geometrik yorum
SST verideki toplam değişkenliği temsil ettiğinden, bir regresyon modeli uyarladığımızda bu toplam değişkenliği iki parçaya ayırırız: SSR ve SSE. Bu ayrışım, yüksek boyutlu bir uzayda Pisagor teoremini yansıttığı için geometrik olarak ilginçtir. Bunun nedeni, toplam değişkenliğin iki dik bileşene ayrılmasıdır: model tarafından açıklanan değişkenlik ve açıklanamayan hata. Bu yorum anlamlıdır çünkü regresyon özünde veriyi, öngörücülerin oluşturduğu daha düşük boyutlu bir uzaya yansıtmaktır. Altuzaylar gibi kavramlar hakkında daha fazla bilgi edinmek için Linear Algebra for Data Science in R kursumuzu alın.
SST, SSR + SSE’ye eşit olmadığında
Ridge ve lasso regresyonda, SST’nin SSR ve SSE’ye ayrıştırılması aynı ilişkiyi izlemez. Bunun nedeni, hem ridge hem de lasso’nun maliyet fonksiyonlarına düzenlileştirme terimleri, yani cezalar eklemesi ve bu durumun ilişkiyi değiştirmesidir. Düzenlileştirilmiş regresyon sürümlerinde SST hâlâ iyi tanımlıdır, ancak düzenlileştirme terimi nedeniyle açıklanan değişkenlik ile artık değişkenlik artık SST’yi toplamsal olarak vermez. Daha fazla bilgi için Regularization in R Tutorial: Ridge, Lasso and Elastic Net yazımızı okuyun.
Kareler Toplamı ve R-Kare
Belirleme katsayısı olarak da bilinen R-kare, bir regresyon modelinin uyum kalitesini ve dolayısıyla öngörü gücünü değerlendirmek için önemli bir istatistiksel ölçüdür. Bağımlı değişkendeki değişkenliğin bağımsız değişken tarafından açıklanabilen payını temsil eder. R-kare, korelasyon katsayısı r’nin karesi alınarak hesaplanabilir ve ayrıca şu formüle göre de hesaplanabilir:
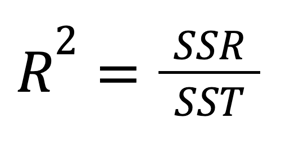
Ya da alternatif olarak:
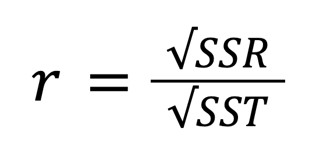
SST, SSR ve SSE arasındaki ilişkiyi dikkate alarak, yukarıdaki formül şu şekilde yeniden yazılabilir:
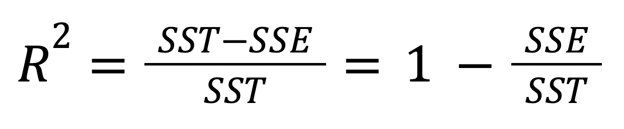
R-karenin değeri 0 ile 1 arasında (uç değerler dahil) olabilir. Eğer R2 = 0 ise, regresyon modelimizin bağımlı değişkendeki değişkenliğin hiçbir bölümünü açıklamadığı anlamına gelir. Buna karşılık, R2 = 1 ise, modelimizin bağımlı değişkendeki tüm değişkenliği mükemmel şekilde açıkladığı anlamına gelir. Pratikte bu uç değerlere rastlamak neredeyse imkânsızdır—gerçek dünyada büyük olasılıkla bu iki değerin arasında bir şey göreceğiz.
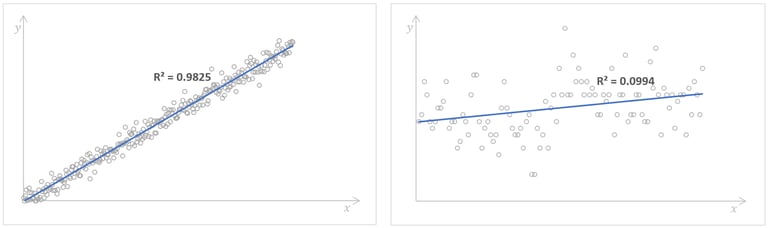
R-kare değeri yüksek (solda) ve düşük (sağda) regresyon modelleri. Kaynak: Kaggle Number of Books Read ve Kaggle Possum Regression. Görsel: Yazar.
Yüksek bir R-kare değeri, iyi bir model performansına işaret eder; yani bağımlı değişken, bağımsız değişken tarafından yüksek doğrulukla tahmin edilebilir. Ancak, hangi R-kare değerinin yeterince iyi sayılacağına dair genel bir kural yoktur. Bu, her özel duruma, bir regresyon modelinin hassasiyet gereksinimlerine ve veride ne kadar değişkenlik beklediğimize bağlıdır. Çoğu zaman, regresyon analizimizin ilişkili olduğu alana da bağlıdır. Örneğin, fen bilimlerinde R-kare değerinin 0,8’in üzerinde olmasını isterken, sosyal bilimlerde 0,3 değeri bile yeterli olabilir.
Son bir not olarak, birden fazla bağımsız değişkenli çoklu doğrusal regresyonda, genellikle öngörücü sayısını ve örneklem büyüklüğünü dikkate alan düzeltilmiş R-kareyi kullanırız.
Sonuç
Günümüzde SST, SSR ve SSE’yi çoğu istatistik yazılımında ve programlama dilinde kolayca ve hızlıca hesaplayabilsek de, bunların ne anlama geldiğini, birbirleriyle bağlantılarını ve özellikle regresyon analizindeki önemlerini gerçekten anlamak hâlâ değerlidir. Değişkenliğin üç bileşeni ile R-kare arasındaki ilişkiyi kavramak, veri analistlerinin ve veri bilimcilerinin SSE’yi en aza indirip SSR’yi en yükseğe çıkararak model performansını iyileştirmelerine ve regresyon modelleri hakkında bilinçli kararlar vermelerine yardımcı olur.
İstatistikte sağlam bir temel oluşturmak ve gerçek dünya verileriyle çalışarak güçlü istatistiksel teknikler öğrenmek için şu kapsamlı ve başlangıç dostu yetkinlik yollarını değerlendirin: Statistics Fundamentals in Python ve Statistics Fundamentals in R. Son olarak, regresyon katsayılarının nasıl hesaplandığını merak ediyorsanız, Normal Equation for Linear Regression Tutorial ve QR Decomposition in Machine Learning: A Detailed Guide içeriklerimize göz atın.





Kareler toplamı, regresyon analizinde temel bir rol oynayan karmaşık bir istatistiksel ölçüdür. Bağımlı değişkendeki değişkenliği tanımlar ve üç bileşene ayrılabilir: toplam kareler toplamı (SST), regresyon kareler toplamı (SSR) ve hata kareler toplamı (SSE). Bu üçü birlikte bir regresyon modelinin performansını değerlendirmeye yardımcı olur.
Bu yazıda, kareler toplamının üç bileşenini ve ayrıca R-kareyi ele alacağız. Önce her bir kareler toplamına ayrı ayrı genel bir bakış sunacağız. Ardından, aralarındaki matematiksel ilişkiyi inceleyeceğiz. Son olarak, SST, SSR ve SSE’nin, önemli bir model değerlendirme metriği olan R-kare ile bağlantısını keşfedeceğiz.
SST, SSR ve SSE nedir?
SST, SSR ve SSE’nin ne olduğunu, her bir ölçütün toplam değişkenliği nasıl yansıttığını ve her birinin bir regresyon modelinin uyum kalitesini değerlendirmeye nasıl yardımcı olduğunu tanımlayarak başlayalım. Ayrıca, biri bağımlı diğeri bağımsız olmak üzere tek değişkenli basit doğrusal regresyon üzerinde her bir kareler toplamının nasıl göründüğüne bakacağız.
Tanımları incelerken, kodlama olmadan istatistikleri gözden geçirmek isterseniz, Introduction to Statistics kursumuza göz atın. Belirli bir teknolojiye dayalı giriş düzeyi istatistik kursları için Introduction to Statistics in Google Sheets, Introduction to Statistics in Python ve Introduction to Statistics in R gibi seçeneklerimiz var.
Toplam kareler toplamı (SST)
Toplam kareler toplamı (SST), gözlenen bağımlı değişkenin her bir değerinin bu değişkenin ortalamasından farklarının kareleri toplamıdır. Toplam kareler toplamı (TSS) olarak da bilinir.
Toplam kareler toplamı, regresyon modeli tarafından açıklanan ve açıklanamayan değişkenlik bölümlerini de kapsayarak, bağımlı değişkendeki toplam değişkenliği temsil eder. Doğası gereği, SST gözlenen bağımlı değişkenin tekil değerlerinin ortalamasından genel saçılımını yansıtır.
Aşağıda SST’yi hesaplamanın matematiksel formülü yer almaktadır:
burada:
Aşağıdaki basit doğrusal regresyon grafiği yukarıdaki formülün anlamını görsel olarak gösterir:
Basit doğrusal regresyon için toplam kareler toplamının hesaplanması. Görsel: Yazar
Gördüğümüz gibi, gözlenen bağımlı değişkenin ortalama değeri (gri kesikli çizgi) ile bu değişkenin her bir değeri (gri noktalar) arasındaki mesafeler (grafikteki kırmızı parçalar) ölçülür, kareleri alınır ve toplanır. Ayrıca bu grafik, SST’nin regresyon modeline bağlı olmadığını; yalnızca gözlenen y-değerlerine ve gözlenen bağımlı değişkenin ortalamasına bağlı olduğunu açıkça gösterir.
Regresyon kareler toplamı (SSR)
Regresyon kareler toplamı (SSR), bir regresyon modeli tarafından tahmin edilen bağımlı değişkenin her bir değeri ile gözlenen bağımlı değişkenin ortalaması arasındaki farkların kareleri toplamıdır. Bu metrik için diğer adlar şunlardır: regresyon kareler toplamı, regresyona bağlı kareler toplamı ve açıklanan kareler toplamı. Hatta başka bir kısaltması daha vardır: ESS.
Regresyon kareler toplamı, regresyon modeli tarafından açıklanan bağımlı değişkendeki toplam değişkenlik payını yakalar (bu nedenle alternatif adlarından biri açıklanan kareler toplamıdır). Bunu, regresyon modeli sayesinde azalan hata olarak da düşünebiliriz.
SSR’yi hesaplamak için aşağıdaki formülü kullanırız:
burada:
Bu formülü aşağıdaki basit doğrusal regresyon grafiğiyle görselleştirebiliriz:
Kısaca, gözlenen bağımlı değişkenin ortalama değeri (gri kesikli çizgi) ile bağımsız değişkenin her veri noktası için bir regresyon modeli tarafından tahmin edilen bağımlı değişken değerleri (mavi çizgi) arasındaki mesafeler (grafikteki yeşil parçalar) ölçülür, kareleri alınır ve toplanır.
Regresyon analizinde, SSR modelin veri noktalarını ne kadar iyi tahmin ettiğini belirlemeye yardımcı olarak bir regresyon modelinin uyumunu ölçmeye katkıda bulunur. Kareler toplamının üç metriği arasındaki ilişkiyi tartışırken bu durumun nasıl gerçekleştiğini daha net göreceğiz.
Hata kareler toplamı (SSE)
Hata kareler toplamı (SSE), gözlenen bağımlı değişkenin her bir değeri ile aynı bağımsız değişken veri noktası için bir regresyon modeli tarafından tahmin edilen bağımlı değişken değeri arasındaki farkların kareleri toplamıdır. Başka bir deyişle, bu metrik bağımlı değişkenin gerçek ve tahmin edilen değerleri arasındaki farkı ölçer.
Hata kareler toplamı; hata kareler toplamı, artık kareler toplamı, artıkların kareler toplamı veya açıklanamayan kareler toplamı olarak da adlandırılır. SSE’ye ek olarak RSS, ESS ve hatta SSR olarak da kısaltılabilir—son durumda, regresyon kareler toplamını ifade eden ve daha önce tartıştığımız SSR ile kolayca karıştırılabilir.
Hata kareler toplamı, kalan hatayı veya açıklanamayan değişkenliği yansıtır; yani, regresyon modeli tarafından açıklanamayan, bağımlı değişkendeki toplam değişkenliğin bölümüdür (bu nedenle açıklanamayan kareler toplamı olarak da adlandırılır).
SSE’yi hesaplamak için aşağıdaki formülü kullanabiliriz:
burada:
Bu formül grafiksel olarak şu şekilde gösterilebilir:
Burada, bağımlı değişkenin her bir gerçek-tahmin çifti için mesafeler (grafikteki sarı parçalar) ölçülür, kareleri alınır ve toplanır.
Regresyon analizinde SSE’yi en aza indirmek, regresyon modelinin doğruluğunu artırmanın anahtarıdır; bir sonraki bölümde bununla ilgili içgörü oluşturacağız.
Ayrıca, basit doğrusal ve lojistik regresyon modelleri kurmak için gereken becerileri kazanmanıza yardımcı olacak teknolojiye özel öğreticiler koleksiyonumuz da var: Essentials of Linear Regression in Python, How to Do Linear Regression in R ve Linear Regression in Excel: A Comprehensive Guide For Beginners.
SST, SSR ve SSE Arasındaki Matematiksel İlişki
SST, SSR ve SSE arasındaki matematiksel ilişki aşağıdaki formülle ifade edilir:
Daha önce, toplam değişkenliğin (SST) hem açıklanan değişkenlikten (SSR) hem de açıklanamayan değişkenlikten (SSE) oluştuğunu söylemiştik; bu durum yukarıdaki formülde yansıtılmaktadır.
Daha önce gördüğümüz gibi, SST regresyon modeline bağlı değildir, oysa diğer iki metrik bağlıdır. Bu, modelin doğruluğunu artırmanın SSR veya SSE’deki değişimlerle ilişkili olduğu anlamına gelir—özellikle, SSE’yi en aza indirerek ve dolayısıyla SSR’yi en yükseğe çıkararak. Yukarıdaki formülden, SSE ne kadar küçükse SSR’nin SST’ye o kadar yaklaştığını; dolayısıyla, regresyon modelimizin bağımlı değişkenin gözlenen değerlerine o kadar iyi uyduğunu söyleyebiliriz.
Eğer SSE 0’a eşit olsaydı, SSR SST ile çakışırdı; bu da bağımlı değişkenin tüm gözlenen değerlerinin regresyon modeli tarafından mükemmel şekilde açıklandığı, yani hepsinin tam olarak regresyon çizgisi üzerinde bulunduğu anlamına gelirdi. Gerçek dünyada bu olmaz, ancak daha güvenilir bir regresyon modeli için SSE’yi en aza indirmeyi hedeflemeliyiz.
Geometrik yorum
SST verideki toplam değişkenliği temsil ettiğinden, bir regresyon modeli uyarladığımızda bu toplam değişkenliği iki parçaya ayırırız: SSR ve SSE. Bu ayrışım, yüksek boyutlu bir uzayda Pisagor teoremini yansıttığı için geometrik olarak ilginçtir. Bunun nedeni, toplam değişkenliğin iki dik bileşene ayrılmasıdır: model tarafından açıklanan değişkenlik ve açıklanamayan hata. Bu yorum anlamlıdır çünkü regresyon özünde veriyi, öngörücülerin oluşturduğu daha düşük boyutlu bir uzaya yansıtmaktır. Altuzaylar gibi kavramlar hakkında daha fazla bilgi edinmek için Linear Algebra for Data Science in R kursumuzu alın.
SST, SSR + SSE’ye eşit olmadığında
Ridge ve lasso regresyonda, SST’nin SSR ve SSE’ye ayrıştırılması aynı ilişkiyi izlemez. Bunun nedeni, hem ridge hem de lasso’nun maliyet fonksiyonlarına düzenlileştirme terimleri, yani cezalar eklemesi ve bu durumun ilişkiyi değiştirmesidir. Düzenlileştirilmiş regresyon sürümlerinde SST hâlâ iyi tanımlıdır, ancak düzenlileştirme terimi nedeniyle açıklanan değişkenlik ile artık değişkenlik artık SST’yi toplamsal olarak vermez. Daha fazla bilgi için Regularization in R Tutorial: Ridge, Lasso and Elastic Net yazımızı okuyun.
Kareler Toplamı ve R-Kare
Belirleme katsayısı olarak da bilinen R-kare, bir regresyon modelinin uyum kalitesini ve dolayısıyla öngörü gücünü değerlendirmek için önemli bir istatistiksel ölçüdür. Bağımlı değişkendeki değişkenliğin bağımsız değişken tarafından açıklanabilen payını temsil eder. R-kare, korelasyon katsayısı r’nin karesi alınarak hesaplanabilir ve ayrıca şu formüle göre de hesaplanabilir:
Ya da alternatif olarak:
SST, SSR ve SSE arasındaki ilişkiyi dikkate alarak, yukarıdaki formül şu şekilde yeniden yazılabilir:
R-karenin değeri 0 ile 1 arasında (uç değerler dahil) olabilir. Eğer R2 = 0 ise, regresyon modelimizin bağımlı değişkendeki değişkenliğin hiçbir bölümünü açıklamadığı anlamına gelir. Buna karşılık, R2 = 1 ise, modelimizin bağımlı değişkendeki tüm değişkenliği mükemmel şekilde açıkladığı anlamına gelir. Pratikte bu uç değerlere rastlamak neredeyse imkânsızdır—gerçek dünyada büyük olasılıkla bu iki değerin arasında bir şey göreceğiz.
R-kare değeri yüksek (solda) ve düşük (sağda) regresyon modelleri. Kaynak: Kaggle Number of Books Read ve Kaggle Possum Regression. Görsel: Yazar.
Yüksek bir R-kare değeri, iyi bir model performansına işaret eder; yani bağımlı değişken, bağımsız değişken tarafından yüksek doğrulukla tahmin edilebilir. Ancak, hangi R-kare değerinin yeterince iyi sayılacağına dair genel bir kural yoktur. Bu, her özel duruma, bir regresyon modelinin hassasiyet gereksinimlerine ve veride ne kadar değişkenlik beklediğimize bağlıdır. Çoğu zaman, regresyon analizimizin ilişkili olduğu alana da bağlıdır. Örneğin, fen bilimlerinde R-kare değerinin 0,8’in üzerinde olmasını isterken, sosyal bilimlerde 0,3 değeri bile yeterli olabilir.
Son bir not olarak, birden fazla bağımsız değişkenli çoklu doğrusal regresyonda, genellikle öngörücü sayısını ve örneklem büyüklüğünü dikkate alan düzeltilmiş R-kareyi kullanırız.
Sonuç
Günümüzde SST, SSR ve SSE’yi çoğu istatistik yazılımında ve programlama dilinde kolayca ve hızlıca hesaplayabilsek de, bunların ne anlama geldiğini, birbirleriyle bağlantılarını ve özellikle regresyon analizindeki önemlerini gerçekten anlamak hâlâ değerlidir. Değişkenliğin üç bileşeni ile R-kare arasındaki ilişkiyi kavramak, veri analistlerinin ve veri bilimcilerinin SSE’yi en aza indirip SSR’yi en yükseğe çıkararak model performansını iyileştirmelerine ve regresyon modelleri hakkında bilinçli kararlar vermelerine yardımcı olur.
İstatistikte sağlam bir temel oluşturmak ve gerçek dünya verileriyle çalışarak güçlü istatistiksel teknikler öğrenmek için şu kapsamlı ve başlangıç dostu yetkinlik yollarını değerlendirin: Statistics Fundamentals in Python ve Statistics Fundamentals in R. Son olarak, regresyon katsayılarının nasıl hesaplandığını merak ediyorsanız, Normal Equation for Linear Regression Tutorial ve QR Decomposition in Machine Learning: A Detailed Guide içeriklerimize göz atın.