
कोर्स
Python में statsmodels के साथ Regression परिचय
4 घंटा
63K
सम ऑफ़ स्क्वेर्स एक जटिल सांख्यिकीय माप है जो रिग्रेशन विश्लेषण में अहम भूमिका निभाता है। यह आश्रित चर की विचरणशीलता का वर्णन करता है और इसे तीन घटकों—सम ऑफ़ स्क्वेर्स टोटल (SST), सम ऑफ़ स्क्वेर्स रिग्रेशन (SSR), और सम ऑफ़ स्क्वेर्स एरर (SSE)—में विभाजित किया जा सकता है, जो मिलकर रिग्रेशन मॉडल के प्रदर्शन का आकलन करने में मदद करते हैं।
इस लेख में, हम सम ऑफ़ स्क्वेर्स के तीन घटकों और R-स्क्वेयर्ड पर चर्चा करेंगे। पहले, हम प्रत्येक सम ऑफ़ स्क्वेर्स का अलग-अलग अवलोकन देंगे। अगला, हम उनके बीच के गणितीय संबंध पर विचार करेंगे। अंत में, हम SST, SSR, और SSE का R-स्क्वेयर्ड—एक प्रमुख मॉडल मूल्यांकन मीट्रिक—से संबंध देखेंगे।
आइए शुरुआत करते हैं यह परिभाषित करने से कि SST, SSR, और SSE क्या हैं, प्रत्येक माप कुल विचरणशीलता को कैसे दर्शाता है, और वे प्रत्येक रिग्रेशन मॉडल के गुडनेस ऑफ़ फ़िट का मूल्यांकन करने में कैसे मदद करते हैं। साथ ही, हम यह भी देखेंगे कि एक सरल रैखिक रिग्रेशन जिसमें एक आश्रित और एक स्वतंत्र चर है, उस पर प्रत्येक सम ऑफ़ स्क्वेर्स कैसा दिखता है।
यदि परिभाषाओं के दौरान आप बिना कोडिंग के सांख्यिकी की समीक्षा करना चाहते हैं, तो हमारा कोर्स Introduction to Statistics देखें। किसी विशेष तकनीक पर आधारित प्रारंभिक सांख्यिकी कोर्स के लिए, हमारे पास विकल्प हैं: Introduction to Statistics in Google Sheets, Introduction to Statistics in Python, और Introduction to Statistics in R।
सम ऑफ़ स्क्वेर्स टोटल (SST) देखे गए आश्रित चर के प्रत्येक मान और उस चर के औसत के बीच वर्गांतरों का योग है। इसे टोटल सम ऑफ़ स्क्वेर्स (TSS) भी कहा जाता है।
सम ऑफ़ स्क्वेर्स टोटल आश्रित चर में कुल विचरणशीलता का प्रतिनिधित्व करता है, जिसमें रिग्रेशन मॉडल द्वारा समझाई गई और न समझाई गई दोनों तरह की विचरणशीलता शामिल है। अपनी प्रकृति से, SST देखे गए आश्रित चर के व्यक्तिगत मूल्यों का उसके औसत से समग्र प्रकीर्णन दिखाता है।
SST की गणना के लिए गणितीय सूत्र नीचे दिया गया है:
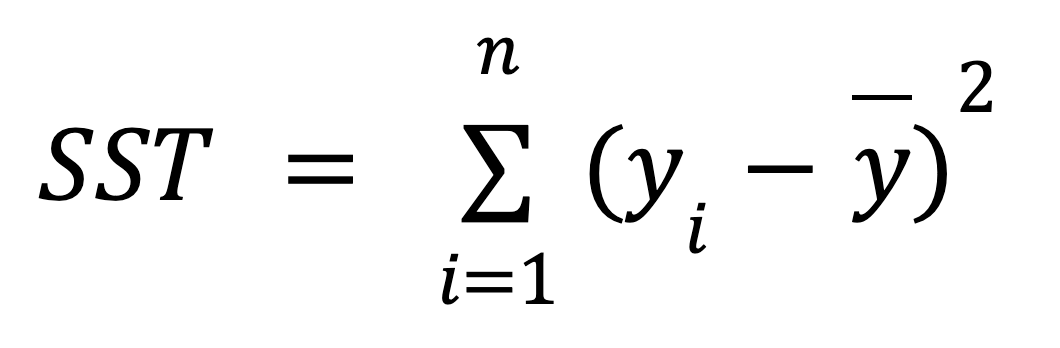
जहाँ:
एक सरल रैखिक रिग्रेशन के लिए नीचे दिया गया प्लॉट उपरोक्त सूत्र का अर्थ ग्राफ़िक रूप से दिखाता है:
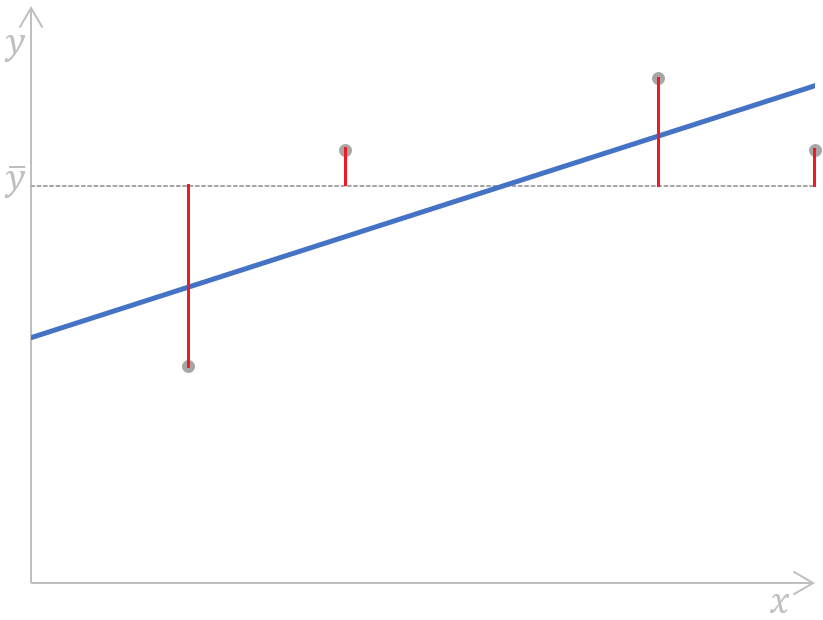
सरल रैखिक रिग्रेशन के लिए टोटल सम ऑफ़ स्क्वेर्स की गणना। चित्र: लेखक
जैसा कि हम देखते हैं, देखे गए आश्रित चर के औसत मान (धूसर डैश्ड रेखा) और उस चर के प्रत्येक मान (धूसर बिंदु) के बीच की दूरियाँ (प्लॉट पर लाल खंड) मापी जाती हैं, वर्ग की जाती हैं, और जोड़ी जाती हैं। साथ ही, यह प्लॉट स्पष्ट रूप से दिखाता है कि SST रिग्रेशन मॉडल पर निर्भर नहीं करता; यह केवल देखे गए y-मूल्यों और आश्रित चर के औसत पर निर्भर करता है।
सम ऑफ़ स्क्वेर्स रिग्रेशन (SSR) स्वतंत्र चर के प्रत्येक डाटा बिंदु के लिए किसी रिग्रेशन मॉडल द्वारा अनुमानित आश्रित चर के प्रत्येक मान और देखे गए आश्रित चर के औसत के बीच वर्गांतरों का योग है। इस मीट्रिक के अन्य नाम हैं: रिग्रेशन सम ऑफ़ स्क्वेर्स, सम ऑफ़ स्क्वेर्स ड्यू टू रिग्रेशन, और एक्स्प्लेंड सम ऑफ़ स्क्वेर्स। इसके लिए एक और संक्षेप भी है—ESS.
सम ऑफ़ स्क्वेर्स रिग्रेशन आश्रित चर में कुल विचरणशीलता के उस हिस्से को कैप्चर करता है जिसे रिग्रेशन मॉडल समझाता है (इसीलिए इसका एक वैकल्पिक नाम—explaned sum of squares—प्रचलित है)। हम इसे रिग्रेशन मॉडल के कारण घटी हुई त्रुटि के रूप में भी देख सकते हैं।
SSR की गणना के लिए हम निम्न सूत्र का उपयोग करते हैं:
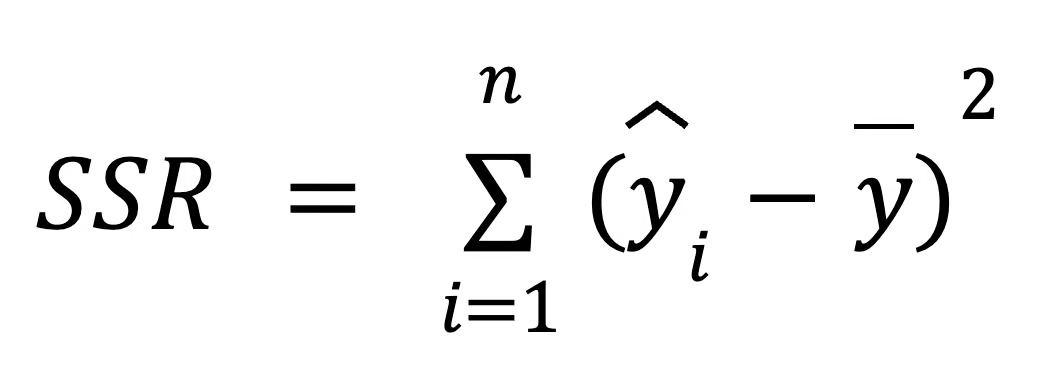
जहाँ:
हम इस सूत्र को निम्न सरल रैखिक रिग्रेशन प्लॉट पर दर्शा सकते हैं:
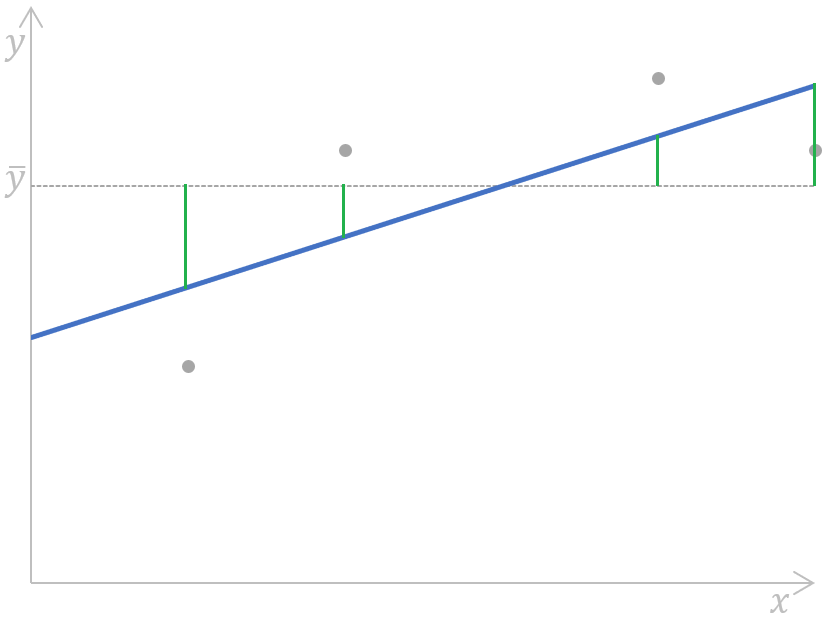 सरल रैखिक रिग्रेशन के लिए सम ऑफ़ स्क्वेर्स रिग्रेशन की गणना। चित्र: लेखक
सरल शब्दों में, देखे गए आश्रित चर के औसत मान (धूसर डैश्ड रेखा) और स्वतंत्र चर के प्रत्येक डाटा बिंदु के लिए रिग्रेशन मॉडल द्वारा अनुमानित आश्रित चर के प्रत्येक मान (नीली रेखा) के बीच की दूरियाँ (प्लॉट पर हरे खंड) मापी जाती हैं, वर्ग की जाती हैं, और जोड़ी जाती हैं।
रिग्रेशन विश्लेषण में, SSR मॉडल के फ़िट को मापने में योगदान देता है क्योंकि यह बताने में मदद करता है कि मॉडल डाटा बिंदुओं की कितनी अच्छी भविष्यवाणी करता है। यह कैसे होता है, इसका स्पष्ट चित्र हमें आगे इस ट्यूटोरियल में तब मिलेगा जब हम सम ऑफ़ स्क्वेर्स की तीनों मीट्रिक्स के संबंध पर चर्चा करेंगे।
सम ऑफ़ स्क्वेर्स एरर (SSE) देखे गए आश्रित चर के प्रत्येक मान और स्वतंत्र चर के उसी डाटा बिंदु के लिए रिग्रेशन मॉडल द्वारा अनुमानित आश्रित चर के मान के बीच वर्गांतरों का योग है। दूसरे शब्दों में, यह मीट्रिक आश्रित चर के वास्तविक और अनुमानित मूल्यों के बीच का अंतर मापती है।
सम ऑफ़ स्क्वेर्स एरर को एरर सम ऑफ़ स्क्वेर्स, रेजिडुअल सम ऑफ़ स्क्वेर्स, सम ऑफ़ स्क्वेर्स रेजिडुअल, या अनएक्स्प्लेंड सम ऑफ़ स्क्वेर्स भी कहा जाता है। SSE के अलावा, इसे RSS, ESS, या यहाँ तक कि SSR के रूप में भी संक्षेपित किया जा सकता है—अंतिम मामले में, यह आसानी से पहले चर्चा किए गए SSR (सम ऑफ़ स्क्वेर्स रिग्रेशन) से भ्रमित हो सकता है।
सम ऑफ़ स्क्वेर्स एरर शेष त्रुटि, या न समझाई गई विचरणशीलता को दर्शाता है, जो आश्रित चर में कुल विचरणशीलता का वह हिस्सा है जिसे रिग्रेशन मॉडल समझा नहीं पाता (इसीलिए इसे unexplained sum of squares भी कहते हैं)।
SSE की गणना के लिए हम निम्न सूत्र का उपयोग कर सकते हैं:
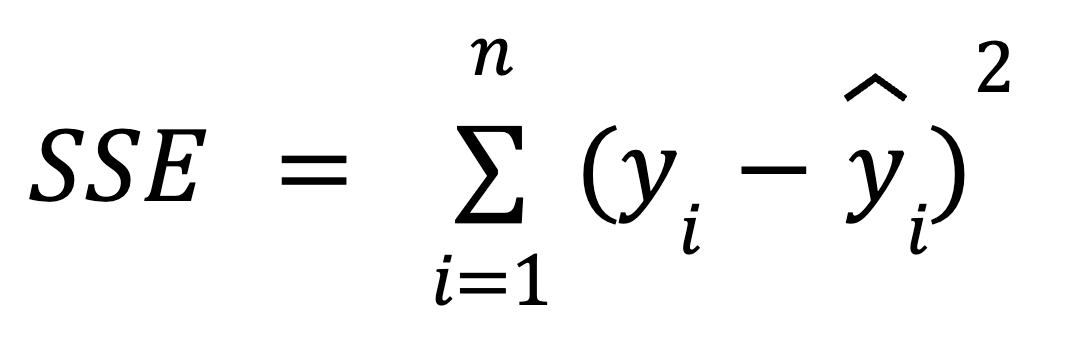
जहाँ:
ग्राफ़िक रूप से, इस सूत्र को इस प्रकार दिखाया जा सकता है:
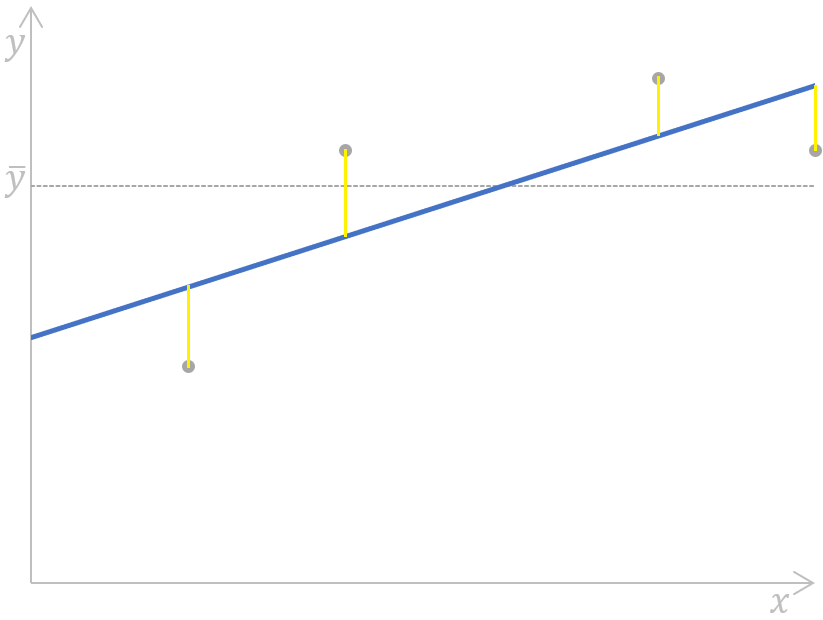 सरल रैखिक रिग्रेशन के लिए सम ऑफ़ स्क्वेर्स एरर की गणना। चित्र: लेखक
यहाँ, आश्रित चर के प्रत्येक वास्तविक-अनुमानित मानों की जोड़ी के लिए दूरियाँ (प्लॉट पर पीले खंड) मापी जाती हैं, वर्ग की जाती हैं, और जोड़ी जाती हैं।
रिग्रेशन विश्लेषण में, SSE को न्यूनतम करना रिग्रेशन मॉडल की सटीकता सुधारने की कुंजी है, और हम अगले अध्याय में इसके बारे में सहज समझ विकसित करेंगे।
हमारे पास तकनीक-विशिष्ट ट्यूटोरियल्स का संग्रह भी है, जो आपको सरल रैखिक और लॉजिस्टिक रिग्रेशन मॉडल बनाने के लिए आवश्यक कौशल विकसित करने में मदद करेगा, जैसे Essentials of Linear Regression in Python, How to Do Linear Regression in R, और Linear Regression in Excel: A Comprehensive Guide For Beginners।
SST, SSR, और SSE के बीच का गणितीय संबंध निम्न सूत्र से व्यक्त होता है:
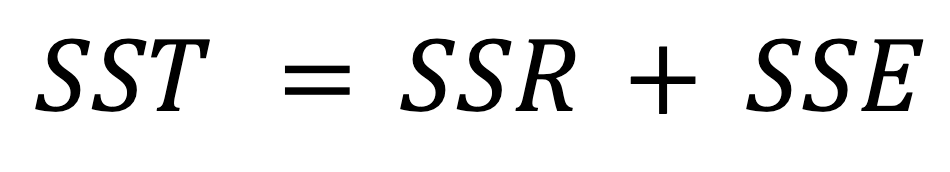
पहले, हमने उल्लेख किया था कि कुल विचरणशीलता (SST) समझाई गई विचरणशीलता (SSR) और न समझाई गई विचरणशीलता (SSE) दोनों से मिलकर बनी होती है, जो ऊपर दिए गए सूत्र में परिलक्षित है।
जैसा कि हमने पहले देखा, SST रिग्रेशन मॉडल पर निर्भर नहीं करता, जबकि अन्य दो मीट्रिक्स निर्भर करते हैं। इसका अर्थ है कि मॉडल की सटीकता में सुधार SSR या SSE में बदलावों से संबंधित है—विशेष रूप से, SSE को न्यूनतम करके और इस प्रकार SSR को अधिकतम करके। ऊपर दिए गए सूत्र से, हम कह सकते हैं कि SSE जितना छोटा होगा, SSR उतना ही SST के निकट होगा; अतः, हमारा रिग्रेशन मॉडल आश्रित चर के देखे गए मूल्यों पर उतना ही बेहतर फ़िट होगा।
यदि SSE शून्य के बराबर हो, तो SSR SST के साथ मेल खा जाएगा, जिसका अर्थ होगा कि आश्रित चर के सभी देखे गए मान रिग्रेशन मॉडल द्वारा पूर्णतः समझाए जाते हैं, अर्थात वे सभी ठीक रिग्रेशन रेखा पर स्थित होंगे। वास्तविक दुनिया के परिदृश्यों में यह नहीं होता, पर हमें अधिक विश्वसनीय रिग्रेशन मॉडल के लिए SSE को न्यूनतम करने का लक्ष्य रखना चाहिए।
चूँकि SST डेटा में कुल विचरणशीलता का प्रतिनिधित्व करता है, जब हम एक रिग्रेशन मॉडल फिट करते हैं, तो हम इस कुल विचरणशीलता को दो भागों में विभाजित करते हैं: SSR और SSE। यह विघटन ज्यामितीय रूप से रोचक है क्योंकि यह उच्च-आयामी स्थान में पाइथागोरस के प्रमेय को दर्शाता है। ऐसा इसलिए है क्योंकि कुल विचरणशीलता दो लम्बवत घटकों में विभाजित होती है: मॉडल द्वारा समझाई गई विचरणशीलता और न समझाया गया त्रुटि भाग। यह व्याख्या सार्थक है क्योंकि रिग्रेशन मूलतः डेटा को निम्न-आयामी स्थान पर प्रोजेक्ट करने के बारे में है, जो हमारे प्रेडिक्टर्स द्वारा व्याप्त स्थान है। उप-अंतरिक्ष जैसे अवधारणाओं के बारे में अधिक जानने के लिए हमारा Linear Algebra for Data Science in R लें।
रिज और लैसो रिग्रेशन में, SST का SSR और SSE में विघटन वही संबंध नहीं मानता। इसका कारण यह है कि रिज और लैसो दोनों अपनी-अपनी कॉस्ट फ़ंक्शंस में रेग्युलराइज़ेशन टर्म्स या पेनल्टी जोड़ते हैं, जो इस संबंध को बदल देते हैं। रेग्युलराइज़्ड रिग्रेशन के मामले में, SST अब भी सुव्यक्त है, लेकिन समझाई गई और अवशिष्ट विचरणशीलता रेग्युलराइज़ेशन टर्म के कारण अब SST के बराबर नहीं जुड़ती। अधिक जानने के लिए हमारा Regularization in R Tutorial: Ridge, Lasso and Elastic Net पढ़ें।
R-स्क्वेयर्ड, जिसे गुणांक निर्धारण (coefficient of determination) भी कहा जाता है, रिग्रेशन मॉडल के फ़िट की गुणवत्ता और इस प्रकार उसकी पूर्वानुमान शक्ति का आकलन करने के लिए एक महत्वपूर्ण सांख्यिकीय माप है। यह आश्रित चर में उस विचरणशीलता के अनुपात को दर्शाता है जिसे स्वतंत्र चर द्वारा समझाया जा सकता है। R-स्क्वेयर्ड को सहसंबंध गुणांक r का वर्ग लेकर निकाला जा सकता है, और इसे इस सूत्र के अनुसार भी निकाला जा सकता है:
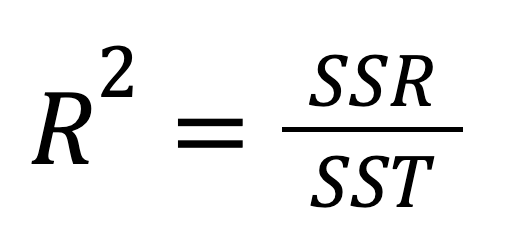
या, वैकल्पिक रूप से:
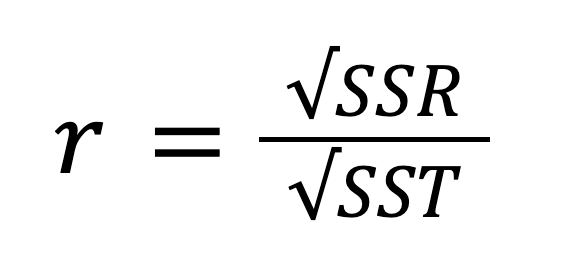
SST, SSR, और SSE के संबंध को ध्यान में रखते हुए, ऊपर दिए गए सूत्र को इस रूप में लिखा जा सकता है:
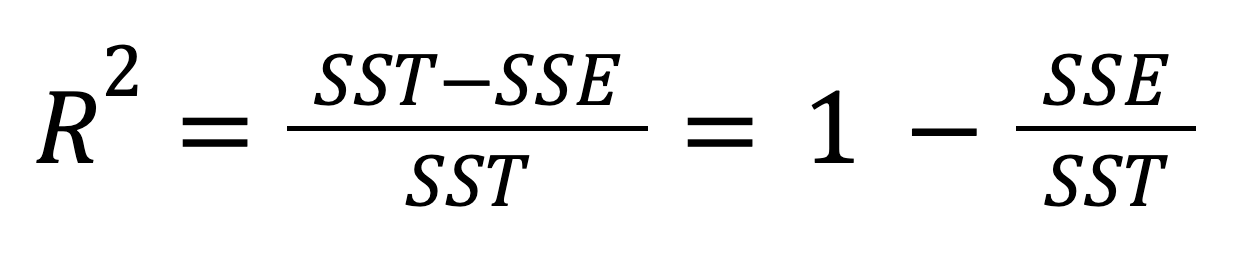
R-स्क्वेयर्ड का मान 0 से 1 तक, सम्मिलित, हो सकता है। यदि R2 = 0 है, तो इसका अर्थ है कि हमारा रिग्रेशन मॉडल आश्रित चर में किसी भी हिस्से की विचरणशीलता को बिल्कुल नहीं समझाता। इसके विपरीत, यदि R2 = 1 है, तो इसका अर्थ है कि हमारा रिग्रेशन मॉडल आश्रित चर में संपूर्ण विचरणशीलता को पूरी तरह समझाता है। व्यवहार में, इन अतिवादी मानों का सामना लगभग असंभव है—वास्तविक मामलों में हम प्रायः बीच का कुछ देखेंगे।
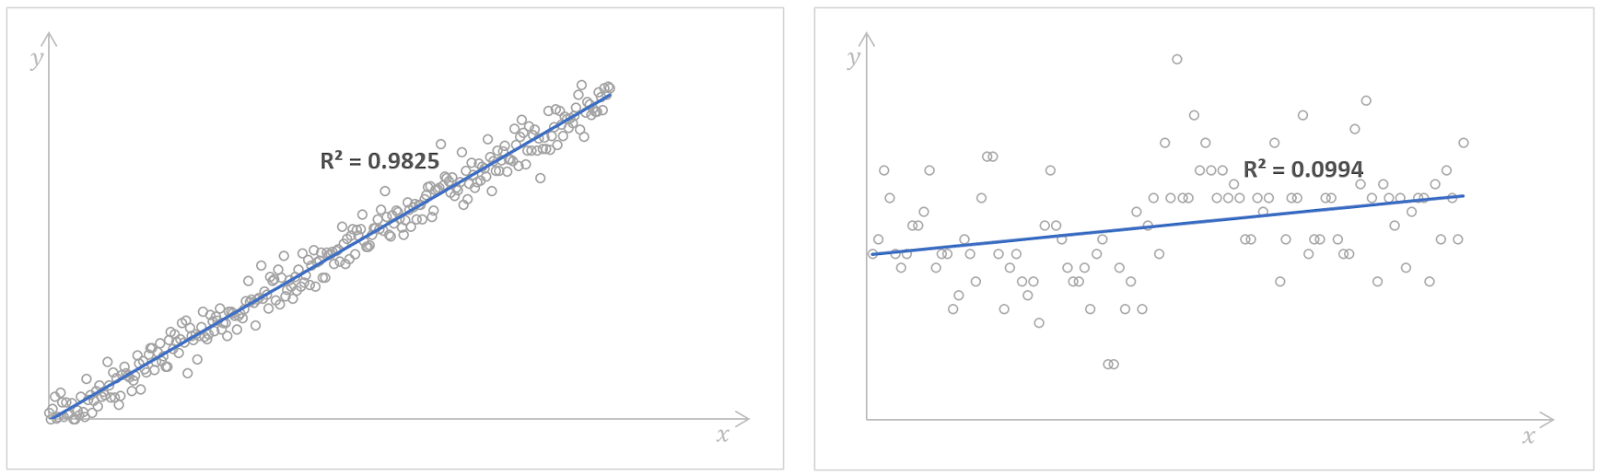
उच्च (बाएँ) और निम्न (दाएँ) R-स्क्वेयर्ड मानों वाले रिग्रेशन मॉडल। स्रोत: Kaggle Number of Books Read और Kaggle Possum Regression। चित्र: लेखक।
R-स्क्वेयर्ड का उच्च मान अच्छे मॉडल प्रदर्शन को इंगित करता है, यानी आश्रित चर को स्वतंत्र चर द्वारा उच्च सटीकता से अनुमानित किया जा सकता है। हालाँकि, ऐसा कोई thumb rule नहीं है कि R-स्क्वेयर्ड का कौन सा मान पर्याप्त रूप से अच्छा माना जाए। यह प्रत्येक विशेष मामले, रिग्रेशन मॉडल की अपेक्षित परिशुद्धता, और डेटा में हम कितनी विचरणशीलता की उम्मीद करते हैं, इस पर निर्भर करता है। अक्सर यह उस डोमेन पर भी निर्भर करता है जिससे हमारा रिग्रेशन विश्लेषण संबंधित है। उदाहरण के लिए, वैज्ञानिक क्षेत्रों में हम 0.8 से अधिक R-स्क्वेयर्ड का मान चाहते हैं, जबकि सामाजिक विज्ञानों में 0.3 का मान भी पर्याप्त हो सकता है।
अंतिम टिप्पणी के रूप में, हमें कहना चाहिए कि बहु-रैखिक रिग्रेशन—अर्थात एक से अधिक स्वतंत्र चरों वाला रिग्रेशन—में, हम अक्सर इसके बजाय adjusted R-squared पर विचार करते हैं, जो R-स्क्वेयर्ड का एक विस्तार है जो प्रेडिक्टर्स की संख्या और सैंपल आकार का हिसाब रखता है।
आज भले ही हम अधिकांश सांख्यिकीय सॉफ़्टवेयर और प्रोग्रामिंग भाषाओं में SST, SSR, और SSE को आसानी से और तेज़ी से गणना कर सकते हों, फिर भी यह समझना सार्थक है कि उनका अर्थ क्या है, उनका आपसी संबंध क्या है, और विशेष रूप से रिग्रेशन विश्लेषण में उनका महत्व क्या है। विचरणशीलता के इन तीन घटकों और R-स्क्वेयर्ड के बीच के संबंध की समझ, डेटा विश्लेषकों और डेटा वैज्ञानिकों को SSE को कम करते हुए SSR को अधिकतम करके मॉडल प्रदर्शन सुधारने में मदद करती है, ताकि वे अपने रिग्रेशन मॉडलों के बारे में सूचित निर्णय ले सकें।
सांख्यिकी में मजबूत नींव बनाने और वास्तविक-विश्व डेटा के साथ काम करते हुए शक्तिशाली सांख्यिकीय तकनीकें सीखने के लिए, निम्न व्यापक और शुरुआती-अनुकूल स्किल ट्रैक्स पर विचार करें: Statistics Fundamentals in Python और Statistics Fundamentals in R। अंत में, यदि आप यह जानने में रुचि रखते हैं कि रिग्रेशन गुणांक कैसे गणना किए जाते हैं, तो हमारा Normal Equation for Linear Regression Tutorial और QR Decomposition in Machine Learning: A Detailed Guide देखें।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स