
Kurs
Konzepte von Programmierparadigmen
2 Std.
4.3K
Gute Struktur ist das Markenzeichen von sauberem Code. Welche Struktur sinnvoll ist, hängt vom gewählten Programmierparadigma ab. Ein Programmierparadigma ist ein in sich stimmiges Set aus Prinzipien und Techniken, das den Ansatz beim Entwerfen und Schreiben von Programmen definiert.
Es gibt viele Paradigmen, etwa prozedural, imperativ, deklarativ, objektorientiert und funktional. Manche Sprachen beschränken sich auf wenige Paradigmen. SQL ist zum Beispiel eine deklarative Sprache. Viele moderne Sprachen, darunter Python, unterstützen jedoch mehrere Paradigmen und bieten so viel Flexibilität.
Übe das Schreiben reiner Funktionen mit einer praktischen Übung aus unserem Kurs Introduction to Programming Paradigms.
Viele Programmiererinnen und Programmierer greifen standardmäßig zu ihrem bevorzugten Paradigma, oft dem zuerst gelernten. Fortgeschrittene verstehen die Stärken und Schwächen der Paradigmen und setzen je nach Situation gezielt auf ihre Vorteile. Schauen wir uns zwei der in der Data Science am häufigsten verwendeten Paradigmen an: funktionale Programmierung und objektorientierte Programmierung.
Bei der funktionalen Programmierung entsteht Code, indem Funktionen definiert und verwendet werden, die festlegen, wie ein Programm arbeiten soll. Sie ist ein Untertyp des deklarativen Paradigmas.
Funktionen sind Codezeilen, die Argumente entgegennehmen und Ausgaben zurückgeben. Eine einfache Funktion könnte beispielsweise eine Zahlenliste als Argument nehmen und nur die geraden Werte zurückgeben.
def get_even_numbers(list):
    return [num for num in list if num % 2 == 0]
Sieh dir diese Kurse an, um Best Practices für das Schreiben von Funktionen in Python und R zu lernen.
Funktionale Programmierung ist besonders nachvollziehbar und gut vorhersagbar. Das liegt daran, dass die verwendeten Funktionen unveränderlich sind, sich also nicht ändern lassen. Funktionen werden definiert – oft in einem separaten Codeteil oder sogar in einer anderen Datei – und dann bei Bedarf im gesamten Code verwendet. So ist leicht ersichtlich, was in einem Abschnitt passiert, denn die Funktion verhält sich überall gleich und wird gleich aufgerufen.
Der Grundsatz der Unveränderlichkeit gilt auch für Datenstrukturen in der funktionalen Programmierung. In FP wird bei Zustandsänderungen bevorzugt eine Kopie der Daten erzeugt. Dadurch entsteht eine Art Protokoll aller Transformationen, was die Nachvollziehbarkeit erhöht und das Debugging vereinfacht. Allerdings steigt dabei häufig der Speicherbedarf, da bei jeder Zustandsänderung der komplette Datensatz kopiert wird.
Eine Teilmenge der in der funktionalen Programmierung verwendeten Funktionen sind Höherordnungsfunktionen. Das sind Funktionen, die eine Funktion als Argument entgegennehmen oder eine Funktion zurückgeben. Du könntest zum Beispiel eine Höherordnungsfunktion haben, die eine andere Funktion mehrfach ausführt, wie unten gezeigt, oder je nach Situation die passende Funktion auswählt.
def run_function_multiple_times(function, num_times):
	for i in range(num_times):
function()Funktionale Programmierung liefert eine Struktur, um Duplikate im Code zu reduzieren. Das Ziel ist, wiederkehrende Aktionen mit ausdrucksstarken, höherstufigen Verben komprimiert zu beschreiben.
Angenommen, du musst an mehreren Stellen Strings in ein bestimmtes Format bringen: Leerzeichen, Satzzeichen und Zahlen entfernen und alles kleinschreiben. Du könntest denselben Codeabschnitt an verschiedenen Stellen einfügen – das bläht den Code aber auf. Stattdessen definierst du eine Funktion zur Bereinigung der Strings und rufst sie an den passenden Stellen auf. So wird dein Code schlanker, besser lesbar und schneller geschrieben.
def clean_string(string):
	exclude = set(string.punctuation + string.digits + " ")
    return ''.join(ch.lower() for ch in string if ch not in exclude)

my_string = "Hello, World! 123"
new_string = clean_string(my_string)
print(new_string)Funktionale Programmierung ist bei großen Datensätzen oder Datenpipelines hilfreich, weil sie komplexe Verarbeitung in kleinere, handhabbare Schritte zerlegt. Häufig wird für jeden Schritt entlang der Pipeline mindestens eine Funktion erstellt. Wenn du die Schritte als Flussdiagramm notiert hast, hast du bereits eine gute Vorstellung, welche Funktionen du brauchst.
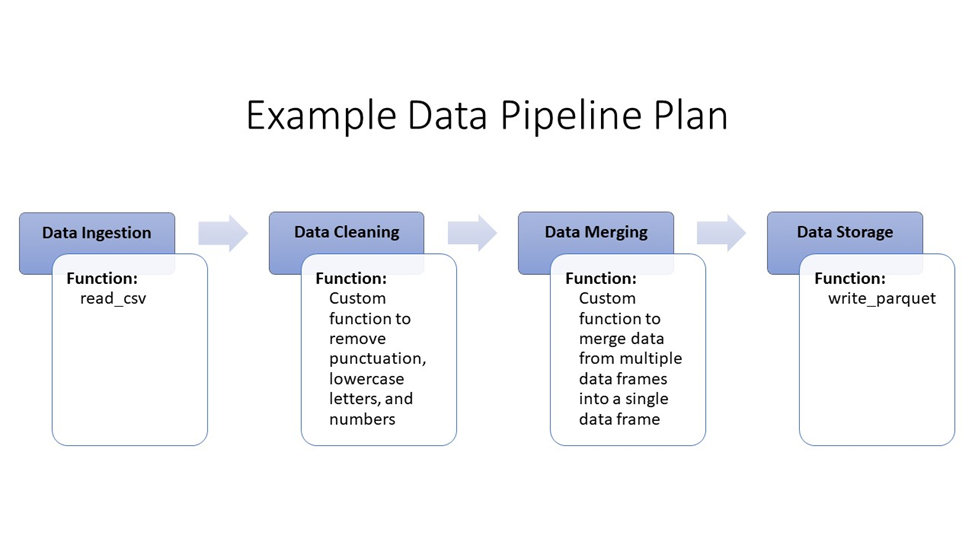
Die meisten Sprachen bringen viele eingebaute Funktionen mit und bieten zusätzlich Bibliotheken zum Herunterladen. Ein gutes Beispiel ist das purrr-Paket in R. So baust du schnell eine Pipeline auf und musst weniger eigene Funktionen schreiben.
Funktionale Programmierung zielt auf sehr gut lesbaren Code. Diese Leitlinien helfen dir, ausdrucksstarken, gut lesbaren Code zu schreiben:
Objektorientierte Programmierung fokussiert sich auf Objekte. Objekte sind in sich geschlossene Einheiten aus Daten und den darauf arbeitenden Methoden. So bleiben Daten und ihre Operationen beieinander – anders als in der funktionalen Programmierung, wo sie oft getrennt sind. Das kann es einfacher machen, den Datenfluss nachzuvollziehen.
In der OOP werden Daten und Methoden in Objekten organisiert, die durch ihre Klasse definiert sind. Klassen legen fest, wie sich jedes Objekt verhalten soll; innerhalb dieser Klasse werden dann konkrete Objekte erstellt. Sieh dir DataCamps Tutorial an, um zu erfahren, wie Klassen in Python funktionieren.
Du könntest etwa eine Klasse BankAccount haben, die beschreibt, wie sich ein Konto verhält. Diese Klasse kann Attribute wie Kontostand, ID-Nummer und Kundennamen enthalten. Außerdem kann sie Methoden haben, die beschreiben, wie Informationen innerhalb der Klasse verändert werden können, etwa Auszahlung, Einzahlung und Kontostand abfragen.
Sobald die Klasse definiert ist, kannst du ein Objekt – also ein konkretes Konto – erstellen. Danach füllst du die Eigenschaften mit Daten und verwendest die Methoden, um das Konto zu verändern. Siehe folgendes Beispiel.
# Define a class representing a bank account
class BankAccount:
    def __init__(self, account_id, customer_name, initial_balance=0.0):
        # Initialize account properties
        self.account_id = account_id
        self.customer_name = customer_name
        self.balance = initial_balance

    # Method to deposit money into the account
    def deposit(self, amount):
        """Deposit money into the account."""
        if amount > 0:
            # Update balance and print deposit information
            self.balance += amount
            print(f"Deposited ${amount}. New balance: ${self.balance}")
        else:
            # Print message for invalid deposit amount
            print("Invalid deposit amount. Please deposit a positive amount.")

    # Method to withdraw money from the account
    def withdraw(self, amount):
        """Withdraw money from the account."""
        if 0 < amount <= self.balance:
            # Update balance and print withdrawal information
            self.balance -= amount
            print(f"Withdrew ${amount}. New balance: ${self.balance}")
        elif amount > self.balance:
            # Print message for insufficient funds
            print("Insufficient funds. Withdrawal canceled.")
        else:
            # Print message for invalid withdrawal amount
            print("Invalid withdrawal amount. Please withdraw a positive amount.")

    # Method to check the current balance of the account
    def check_balance(self):
        """Check the current balance of the account."""
print(f"Current balance for {self.customer_name}'s account (ID: {self.account_id}): ${self.balance}")Das Bündeln von Daten und Verhalten in einem durch eine Klasse definierten Objekt nennt man Kapselung. So entsteht eine klare Struktur, über die der restliche Code einfach mit dem Objekt interagieren kann. Die im Objekt gespeicherten Variablen sind Attribute, die Funktionen, die das Verhalten bestimmen, sind Methoden.
Eine Möglichkeit, Duplikate zu reduzieren, ist Vererbung beim Erstellen neuer Klassen. So entstehen neue Klassen, die Funktionalität der Elternklasse behalten. In unserem Bankbeispiel könnte es eine allgemeine Elternklasse für alle Konten geben sowie Kindklassen mit Details für Spar- und Girokonten.
Polymorphie bedeutet, dass derselbe Methodenname für unterschiedliches Verhalten je nach Eingabe stehen kann. Das wird oft zusammen mit Vererbung genutzt.
Angenommen, wir haben eine Elternklasse Shape mit einer Methode zur Flächenberechnung. Zwei Kindklassen, Circle und Square, übernehmen diese Methode, nennen sie ebenfalls Area, definieren sie aber jeweils anders. Vergleiche die unterschiedlichen Implementierungen im folgenden Codeblock.
# Define the parent class Shape
class Shape:
	# Initialize the attributes for the shape
	def __init__(self, name):
    	    self.name = name

	# Define a generic method for calculating the area
	def area(self):
    	    print(f"The area of {self.name} is unknown.")

# Define the child class Circle that inherits from Shape
class Circle(Shape):
	# Initialize the attributes for the circle
	def __init__(self, name, radius):
    	# Call the parent class constructor
    	    super().__init__(name)
    	    self.radius = radius

	# Override the area method for the circle
	def area(self):
    	# Use the formula pi * r^2
    	    area = 3.14 * self.radius ** 2
    	    print(f"The area of {self.name} is {area}.")

# Define the child class Square that inherits from Shape
class Square(Shape):
	# Initialize the attributes for the square
	def __init__(self, name, side):
    	# Call the parent class constructor
    	    super().__init__(name)
    	    self.side = side

	# Override the area method for the square
	def area(self):
    	# Use the formula s^2
    	    area = self.side ** 2
    	    print(f"The area of {self.name} is {area}.")
Es gibt zahlreiche Ressourcen, um objektorientierte Programmierung zu lernen, darunter DataCamps OOP in Python-Kurs, der OOP in R-Kurs und das OOP in Python-Tutorial.
Objektorientierte Programmierung bietet der Datenanalyse mehrere Vorteile:
Bei der Wahl zwischen OOP und FP für ein Datenprojekt spielen viele Faktoren eine Rolle. Manche Teams bevorzugen klar ein Paradigma – dann ist es sinnvoll, dich daran zu orientieren. In anderen Fällen geben die Art der Daten oder die Anwendung den Ausschlag.
OOP ist ideal, wenn du Entitäten modellieren musst. Beispiele sind ein System zur Bibliotheksverwaltung oder die Bewertung aller Unternehmen in einem Investment-Portfolio. Durch die Kapselung lässt sich der Überblick leicht behalten. OOP ist auch bei wenig Speicher im Vorteil, da FP oft deutlich mehr Speicher benötigt.
Funktionale Programmierung ist stark bei Analysen, die Parallelisierung erfordern. Der Fokus auf Unveränderlichkeit und das Vermeiden von Seiteneffekten erleichtern parallele Operationen auf einem Datensatz. Funktionen können gleichzeitig auf unterschiedliche Datenbereiche angewendet werden, ohne sich zu stören.
Auch für Transformationen in Datenpipelines ist FP sehr gut geeignet. Funktionen lassen sich zu einer Abfolge von Transformationen komponieren, ohne Zustand zu verändern – das macht den Code lesbarer und wartbarer.
In Wissenschaft und Forschung ist FP ebenfalls beliebt, da sie einen stärkeren Bezug zur reinen Mathematik hat.
In der Praxis lassen sich OOP und FP in einem Programm kombinieren. So nutzt du die Stärken beider Ansätze. Die Kapselung der OOP und die Ausdrucksstärke der FP können gemeinsam beim Aufbau einer Machine-Learning-Pipeline oder Webanwendung punkten.
Die Kombination birgt jedoch Herausforderungen und sollte mit Bedacht erfolgen. Code, der zwischen Paradigmen springt, ist schwerer zu lesen. Auch die Integration der Komponenten kann anspruchsvoll sein.
Betrachte das folgende Beispiel. Dieser Python-Code kombiniert OOP und FP, um mathematische Operationen auf eine Zahlenliste anzuwenden. Die Klasse MathOperation fungiert als Container für eine per FP definierte Operation. Die Funktionen filter_odd_numbers und square_operation filtern ungerade Zahlen bzw. berechnen Quadrate. Zusammengenommen filtert der Code effizient ungerade Zahlen aus einer Liste und quadriert sie anschließend – ein Beispiel dafür, wie OOP und FP zusammen Datenanalysen strukturieren und vereinfachen können.
# Object-Oriented Programming (OOP) - Class Definition
class MathOperation:
	def __init__(self, operation):
    	    self.operation = operation

	def apply_operation(self, number):
    	    return self.operation(number)

# Functional Programming (FP) - Higher-Order Functions
def filter_odd_numbers(numbers):
    return list(filter(lambda x: x % 2 != 0, numbers))

def square_operation(number):
    return number ** 2

def process_numbers(numbers, operation_function):
    return list(map(operation_function, numbers))

# Example Usage:
# Define an OOP class representing a mathematical operation (square in this case)
square_operation_instance = MathOperation(square_operation)

# Sample list of numbers
numbers = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]

# Use FP to filter odd numbers
odd_numbers = filter_odd_numbers(numbers)

# Use OOP to apply the square operation to odd numbers
result = process_numbers(odd_numbers, square_operation_instance.apply_operation)

# Display the result
print(result)
Ein weiteres Beispiel für die Kombination von OOP und FP findest du in diesem GitHub-Repository.
Es gibt keine allgemeingültige Antwort auf die Frage nach dem besten Paradigma – es hängt vom Kontext, Ziel, der Sprache und deiner Vorliebe ab. Einige Faustregeln helfen jedoch bei der Wahl für deinen Anwendungsfall.
Nutze OOP, wenn du komplexe Systeme mit vielen Entitäten und Interaktionen modellieren und Daten samt Verhalten in wiederverwendbare Komponenten kapseln willst. Nutze FP, wenn du reine Berechnungen mit klaren Ein- und Ausgaben brauchst und Seiteneffekte oder Zustandsänderungen vermeiden willst. Nutze einen Mischansatz, wenn du die Stärken beider Paradigmen kombinieren und dich an die Eigenheiten der Sprache anpassen möchtest.
Die besten Programmiererinnen und Programmierer legen sich nicht auf ein Paradigma fest, sondern wechseln je nach Zielsetzung. Vertiefe verschiedene Paradigmen im Kurs Introduction to Programming Paradigms. Starte ein Datenprojekt und löse es mit OOP und FP. Durch Übung entwickelst du ein gutes Gespür dafür, was für dein Projekt am besten funktioniert.
Starte heute deine Reise durch die Programmierparadigmen!
Kurs
Kurs
Kurs