Kurs
Einführung in Data Science mit Python
4 Std.
502.2K
Als professionelle:r Programmierer:in musst du bei den Grundlagen glänzen: Variablen, Bedingungen, Datentypen, Sichtbarkeiten, Funktionsaufrufe, Gültigkeitsbereiche usw. Egal, was du programmierst – Middleware, Webentwicklung oder Data Science – diese Basics musst du als Programmierer:in im Griff haben. Du bist zuerst Programmierer:in und dann Data Scientist, Webentwickler:in oder Machine-Learning-Engineer.
Eines dieser grundlegenden Konzepte ist die Rekursion – und sie ist extrem wichtig, wenn du Funktionen eines bestimmten Typs schreibst. Du weißt vielleicht schon: „Rekursion liegt vor, wenn sich eine Funktion selbst aufruft.“ Aber was passiert dabei unter der Haube? Wie wirkt sich Rekursion auf den physischen Speicher aus? Lässt sich jede Funktion in eine rekursive Funktion verwandeln? In diesem Tutorial findest du Antworten auf diese grundlegenden Fragen.
Dem Begriff Rekursion bist du vermutlich schon im Studium der Informatik oder Wirtschaftsinformatik begegnet. In diesem Abschnitt schauen wir uns die Konzepte noch einmal an – aber auf erfrischende Art. Los geht’s.
Noch einmal zur Definition: „Rekursion liegt vor, wenn sich eine Funktion selbst aufruft.“ Ein Beispiel dazu:
void A(n){
    if(n>=1){
        A(n-1);
        print(n);
    }
}
Du siehst, dass die Funktion A() sich selbst aufruft. Das ist Rekursion, und A() ist eine rekursive Funktion.
Schauen wir uns jetzt die Grundlagen einer rekursiven Funktion an.
Eine rekursive Funktion braucht zwingend zwei Eigenschaften:
Betrachte dazu das obige Codesnippet. Die Funktion hat klar eine bestimmte Rekursionsvorschrift:
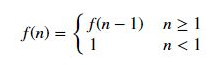
$n\le 1$ ist die Abbruchbedingung / Ankerbedingung / Basisfall. Wenn sie erfüllt ist, endet die Rekursion. Diese Bedingung ist zwingend notwendig, sonst landet die Funktion in einer Endlosschleife.
(Beachte: Das obige Codesnippet ist nicht an eine bestimmte Programmiersprache gebunden. Es soll lediglich eine rekursive Funktion veranschaulichen.)
Vielleicht fragst du dich, warum man überhaupt rekursive Funktionen schreibt, wenn es scheinbar einfachere Alternativen gibt. Ja, Rekursion kann anfangs schwer nachzuvollziehen sein. Mit Übung wirst du sie aber als elegant in Bezug auf Lesbarkeit und Variablenhandhabung schätzen. Rekursion benötigt keine zusätzlichen Variablen zur Ausführung, braucht aber eine saubere Abbruchbedingung. Oft ist es die größere Herausforderung, genau diese Bedingung zu finden. Aber: Übung macht den Meister. Später im Tutorial siehst du, wie kompakt und schön ein Programm mit Rekursion im Vergleich zu herkömmlichen Ansätzen sein kann. Als Nächstes schauen wir uns die Speicherrepräsentation einer rekursiven Funktion an.
In diesem Abschnitt lernst du, wie rekursive Funktionen grundlegend im Speicher über Bäume und Stacks dargestellt werden. Betrachten wir dazu erneut die rekursive Funktion A():
void A(n){
    if(n>=1){
        A(n-1);
        print(n);
    }
}
Zuerst verstehen wir die Darstellung über Bäume. Klingt kompliziert, ist aber ganz simpel. Wenn du jeden Funktionsaufruf baumartig notierst, wie sieht das aus?
Ungefähr so:
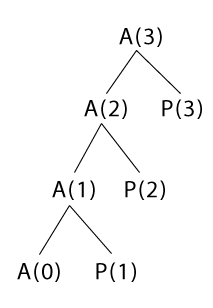
Dazu ein paar Anmerkungen:
A(3) aufgerufen, und daraus ergeben sich 4 (3+1) Funktionsaufrufe. Verallgemeinert: Wird A(n) aufgerufen, entstehen insgesamt (n+1) Funktionsaufrufe.P()-Aufrufe sind die Ausgaben von print(n).A(0), da die anschließende if-Bedingung mit n < 1 false ist und die Funktion endet.Diese baumartige Darstellung brauchst du, um die rekursive Funktion anschließend auf einem Stack abzubilden. Schauen wir uns das an.
(Ein Stack ist eine Datenstruktur, die nach dem Last-in-first-out-Prinzip (LIFO) arbeitet.)
Für die Stack-Darstellung musst du den Baum traversieren – von oben nach unten und von links nach rechts. Das macht die folgende Grafik deutlich.
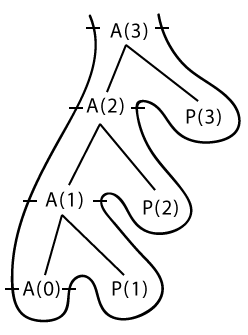
Zur Interpretation: Ein Stack hat zwei Operationen – 1. Push, um ein Element auf den Stack zu legen, und 2. Pop, um ein Element vom Stack zu nehmen.
Beginne nun die Traversierung von oben nach unten und links nach rechts:
print()- bzw. P()-Aufruf wird der entsprechende Wert einfach ausgegeben.So sehen die Stack-Elemente während der Traversierung von A(3) bis A(0) im Top-down-Durchlauf aus:
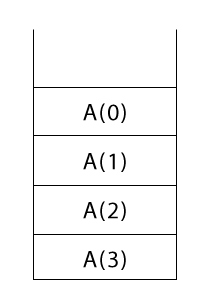
Jetzt folgt die zweite Hälfte der Traversierung, also die Links-rechts-Reihenfolge. Sobald du einem Funktionsaufruf zum zweiten Mal begegnest, wird er gepoppt. Überraschend, aber logisch: Das erste Element, das vom Stack gepoppt wird (A(0)), war das letzte, das gepusht wurde (LIFO!). Auf dem Weg triffst du drei P()-Aufrufe – P(1), P(2) und P(3) – und gibst sie in der Reihenfolge ihres Auftretens aus. Die Ausgabe lautet:
Am Ende der Traversierung ist der Stack komplett leer. Zur Veranschaulichung des Pop-Vorgangs noch ein Bild des leeren Stacks:
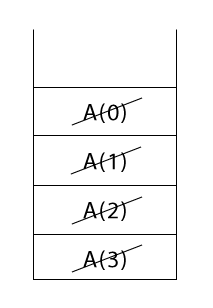
So kannst du eine einfache rekursive Funktion mithilfe eines Baums und eines Stacks im Speicher abbilden. Als Nächstes lernst du, wie man eine Rekursion Schritt für Schritt nachverfolgt.
In diesem Abschnitt lernst du, wie du eine Rekursion systematisch nachvollziehst. Betrachte die folgende rekursive Funktion:
void A(n){
    if(n>0){
        print(n-1);
        A(n-1);
    }
}
Wichtig: Bei jedem Funktionsaufruf entsteht im Speicher ein Aktivierungsdatensatz (Activation Record) mit den lokalen Variablen der Funktion sowie einem Instruction Pointer (der angibt, welche Anweisung als Nächstes ausgeführt wird, wenn die Ausführung in diese Funktion zurückkehrt). Angenommen, eine Funktion main() ruft A() als A(3) auf. Nummerieren wir die Zeilen der A()-Funktion ab dem if für mehr Klarheit:
void A(n){
    1. if(n>0)
    2. {
        3. print(n-1);
        4. A(n-1);
    5. }
}
Die Aktivierungsdatensätze sehen dann so aus:
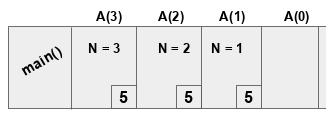
Wie erwähnt, haben Funktionen ihre eigenen Kopien der lokalen Variablen und Instruction Pointer (hier die Zeilennummer). Nach A(0) terminiert A() und das Popping beginnt. Beachte: Hier wird ein horizontal gezeichneter Stack verwendet – inhaltlich identisch zu den zuvor gezeigten. Während die Records auf den Stack gepusht werden, erfolgen auch die Ausgaben. Es werden die folgenden Werte gedruckt:
Instruction Pointer sind hier entscheidend, weil der Kontrollfluss bei Rekursion oft in dieselbe Funktion zurückkehrt – aber mit anderem Variablenwert. Damit alles synchron bleibt, helfen diese Zeiger enorm. Genau so kannst du mithilfe der Baumdarstellung eine Rekursion Schritt für Schritt nachverfolgen.
Als Nächstes betrachten wir die Raum-Zeit-Analyse einer rekursiven Funktion.
DataCamp hat einen hervorragenden Beitrag zur asymptotischen Analyse in Python. Lies ihn idealerweise vor diesem Abschnitt. Kurz zur Auffrischung, was mit Raum- und Zeitanalyse einer Funktion gemeint ist (auch Space Complexity und Time Complexity):
Für eine gegebene Eingabe soll eine Funktion ein Ergebnis liefern. Wie viel Zeit benötigt sie dafür? Die Zeitkomplexität schätzt diese Dauer ab, oft auch Laufzeit genannt. Analog schätzt die Speicherkomplexität den Speicherbedarf (Memory) einer Funktion für eine gegebene Eingabe. Warum ist das wichtig?
Analysieren wir nun eine einfache rekursive Funktion hinsichtlich Raum und Zeit.
void A(n){
    if(n>1) // Anchor condition
    {
       return A(n-1);
    }
}
Zuerst die Zeitkomplexität. Angenommen, die Gesamtlaufzeit von A() sei $T(n)$. Dann setzt sich $T(n)$ zusammen aus der Zeit für den Vergleich „n größer als 1?“ plus der Zeit für den Aufruf A(n-1). Also gilt:
1 steht für die Vergleichsoperation (eine beliebige Konstante). Wie ist dann die Zeit für A(n-1)?
Entsprechend:
und so weiter.
Man sieht: Die Gleichungen hängen zusammen. Durch sukzessives Einsetzen erhältst du:
$T(n)$ = 1 + (1 + $T(n-2)$) = 2 + $T(n-2)$ = 3 + $T(n-3)$ = … = k + $T(n-k)$ (nach k Schritten)
Wann stoppt die Funktion? Gemäß der Ankerbedingung gilt:
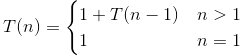
Angenommen, nach k Schritten stoppt sie. Dann gilt:
$n - k = 1 => k = n - 1$
Setze k (= n - 1) in $T(n) = k + T(n-k)$ ein:
$T(n) = (n-1) + T(n-(n-1))$
$=> T(n) = (n-1) + T(1)$
$=> T(n) = n-1 + 1 = n$ // Für T(1) fällt nur der Vergleich an
Nach der asymptotischen Analyse lässt sich $T(n) = n$ als $T(n) = \mathcal{O}(n)$ schreiben. Die (schlimmste) Zeitkomplexität der Funktion ist also $\mathcal{O}(n)$.
Nimm dir hier ruhig einen Moment Zeit und gehe die Schritte sorgfältig durch – am besten mit Stift und Papier.
Die Speicherkomplexität ist einfach: Die Funktion arbeitet im Speicher und nutzt keine zusätzlichen Variablen. Damit liegt die Speicherkomplexität bei $\mathcal{O}(n)$.
Jetzt setzen wir alles zusammen und implementieren eine einfache rekursive Funktion in Python.
Wir schreiben eine rekursive Funktion, die die Fakultät einer Zahl berechnet, und anschließend eine iterative Variante. Los geht’s.
# Recursive function factorial_recursion()

def factorial_recursion(n):
   if n == 1:
       return n
   else:
       return n*factorial_recursion(n-1)
# Call the function

num = 7
print("The factorial of ",num," is ",factorial_recursion(num))
The factorial of 7 is 5040
Erinnerst du dich an die beiden Schlüsselzutaten für rekursive Funktionen?
Hier könnte die Rekursionsvorschrift lauten:
$f(n) = n!$
$f(n) = n * f(n-1)$ und so weiter.
Die Abbruchbedingung ist erfüllt, wenn n gleich 1 ist.
Einleuchtend, oder?
Jetzt implementieren wir die iterative Variante.
def factorial_iterative(num):
    factorial = 1
    if num < 0:
        print("Sorry, factorial does not exist for negative numbers")
    elif num == 0:
        print("The factorial of 0 is 1")
    else:
        for i in range(1,num + 1):
           factorial = factorial*i
        print("The factorial of",num,"is",factorial)
factorial_iterative(7)
The factorial of 7 is 5040
Der Unterschied ist deutlich: Die rekursive Variante ist deutlich eleganter als die iterative. Oder?
Glückwunsch!
Du hast es bis zum Ende geschafft. In diesem Tutorial hast du rekursive Funktionen umfassend betrachtet – von den absoluten Grundlagen bis zur Analyse von Zeit- und Speicherkomplexität. Du hast auch gesehen, wie hilfreich Rekursion für Probleme mit bestimmten Eigenschaften sein kann. Jetzt solltest du in der Lage sein, Probleme mit Rekursionsvorschrift und Abbruchbedingung rekursiv zu lösen. Als Übung kannst du zum Beispiel Fibonacci-Zahlen in einem Bereich rekursiv berechnen.
Ich empfehle dir außerdem, Klassiker wie Binary Search, Mergesort, Tower of Hanoi usw. rekursiv zu lösen und ebenfalls die Raum-Zeit-Analyse durchzuführen. Das macht dich definitiv zu einer besseren Programmierer:in.
Für den Einstieg reichen die behandelten Inhalte aus. Wenn du tiefer einsteigen willst, schau dir diese Links an:
Wenn du mehr über Python lernen möchtest, probiere DataCamps kostenlosen Kurs Intro to Python for Data Science aus.
Mehr über Python lernen
Kurs
Kurs
Kurs