Dieses Tutorial ist ein geschätzter Beitrag aus unserer Community und wurde von DataCamp zur besseren Verständlichkeit und Genauigkeit redigiert.
Du möchtest dein Wissen teilen? Wir freuen uns darauf. Reiche deine Artikel oder Ideen einfach über unser Community Contribution Form ein.
"Globale Erwärmung ist keine Vorhersage. Sie findet statt." – James Hansen
Der Klimawandel geht uns alle an, und Datenvisualisierung ist ein starkes Mittel, um Bewusstsein zu schaffen. In dieser Schritt-für-Schritt-Anleitung lernst du, wie du mit ggplot2 in R wirkungsvolle Visualisierungen historischer Klimadaten erstellst. Am Ende weißt du, wo du kuratierte Datensätze findest, wie du historische Wetterdaten plottest und deine Grafiken so anpasst, dass sie eine klare Geschichte erzählen.
Der Klimawandel geht uns alle an, und Datenvisualisierung ist ein starkes Mittel, um Bewusstsein zu schaffen. In dieser Schritt-für-Schritt-Anleitung lernst du, wie du mit ggplot2 in R wirkungsvolle Visualisierungen historischer Klimadaten erstellst. Am Ende weißt du, wo du kuratierte Datensätze findest, wie du historische Wetterdaten plottest und deine Grafiken so anpasst, dass sie eine klare Geschichte erzählen.
In diesem Tutorial lernst du, wo du verlässliche, kuratierte historische Temperaturdaten findest und sie mit ggplot2 visualisierst.
- Wissen, wo du kuratierte Datensätze mit historischen Wetterdaten findest.
- Sicher historische Wetterdaten mit ggplot2 plotten.
- Deine ggplot2-Grafiken so anpassen, dass sie deine Geschichte besser transportieren.
Schritt 1: Daten finden und laden
Die Daten für dieses Tutorial findest du bei den National Centers for Environmental Information (NCEI). Die NCEI sind in den USA die führende Instanz für Umweltdaten und stellen hochwertige Informationen zu Klima, Ökosystemen und Wasserressourcen bereit. Der Datensatz „Global Summary of the Year“ (GSOY) bietet historische Wetterdaten nach Stadt und Station. Für dieses Tutorial nutzen wir Daten aus Berkeley, CA. Du kannst aber auch eine andere Stadt wählen.
Die Daten werden mit read_csv geladen. Das erste Argument ist der Dateipfad, das zweite, col_select, teilt R mit, welche Spalten geladen werden sollen. Der Datensatz enthält mehrere Variablen, uns interessieren hier jedoch nur „DATE“ und „TAVG“. „DATE“ enthält das Jahr der Beobachtung, „TAVG“ die durchschnittliche Jahrestemperatur in Grad Celsius. Mehr zu den verfügbaren Variablen findest du im Codebook des Datensatzes.
library(readr)23df <- read_csv('USC00040693.csv',4 col_select = c("DATE", "TAVG"))5Rows: 118 Columns: 2── Column specification ────────────────────────────────────────────────────────Delimiter: ","dbl (2): DATE, TAVGIm nächsten Schritt gibst du deinen Datensatz und die zugehörigen deskriptiven Statistiken aus, um ein erstes Gefühl für die Daten zu bekommen. Die R-Funktion summary() zeigt, dass die Daten von 1893 bis 2019 reichen und dass die niedrigste durchschnittliche Jahrestemperatur in diesem Zeitraum in Berkeley, CA, 12,9 °C betrug. Die höchste durchschnittliche Temperatur lag bei 15,93 °C.
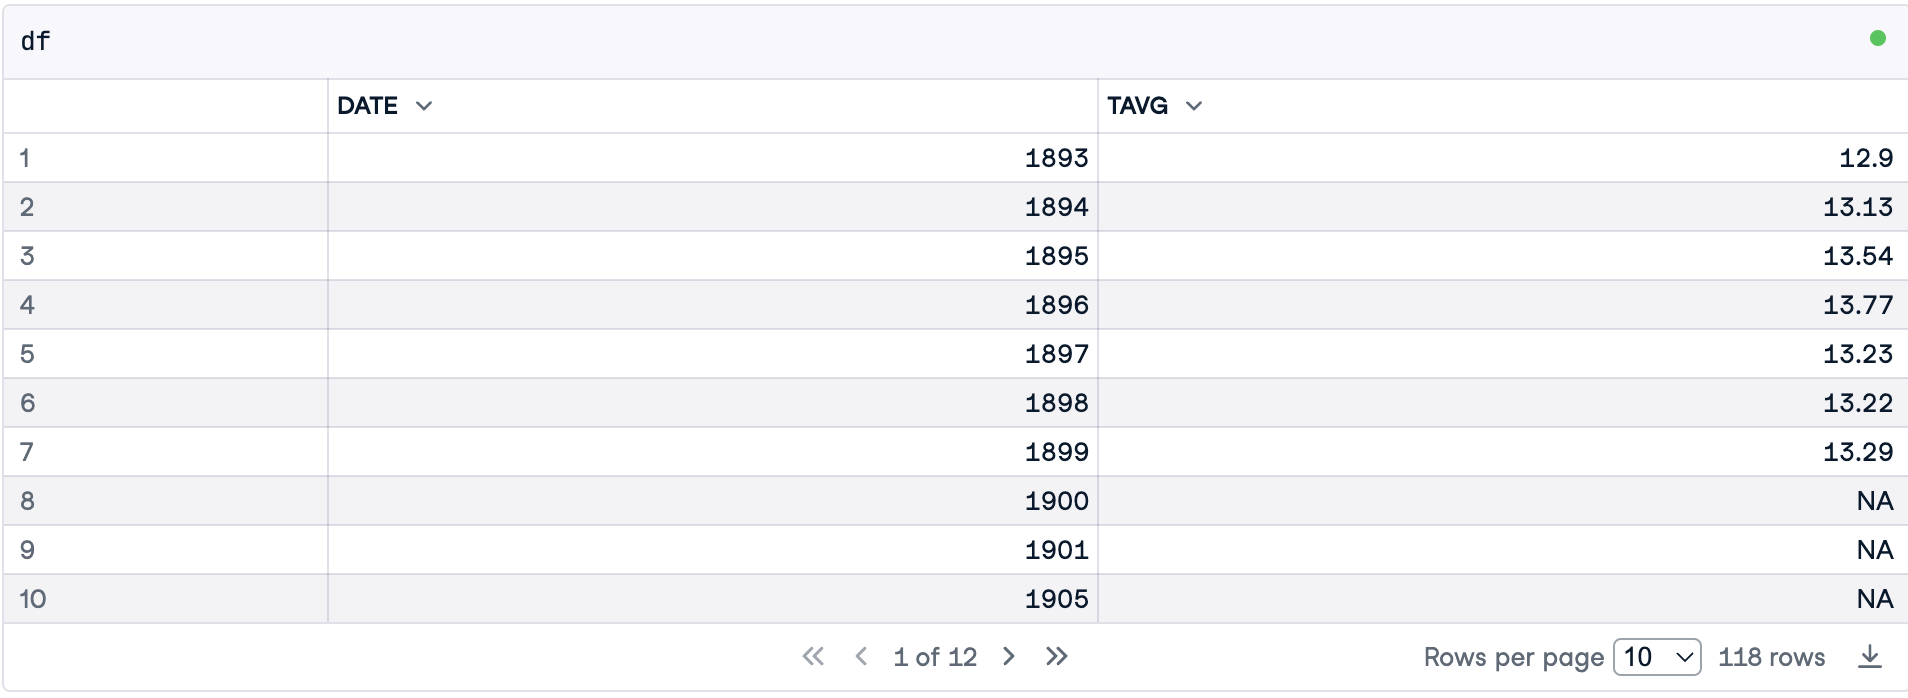
summary(df) DATE TAVG Min. :1893 Min. :12.90 1st Qu.:1926 1st Qu.:13.50 Median :1956 Median :13.91 Mean :1956 Mean :13.97 3rd Qu.:1985 3rd Qu.:14.33 Max. :2019 Max. :15.93 NA's :33 Schritt 2: Fehlende Werte behandeln
Die Funktion summary() hat gezeigt, dass 33 Temperaturen fehlen. Du kannst NAs einer bestimmten Variable auch mit is.na() prüfen. Diese Funktion gibt TRUE zurück, wenn die Beobachtung ein NA ist. Anschließend kannst du alle fehlenden Werte aufsummieren. Die Funktion sum() zählt TRUE als 1.
print(paste("There are", sum(is.na(df$TAVG)), "missing values in this dataset."))[1] "There are 33 missing values in this dataset."Da wir mit einer Zeitreihe arbeiten, füllen wir fehlende Werte per linearer Interpolation. Diese Methode geht davon aus, dass sich die Werte im fehlenden Zeitraum linear entwickelt haben. Tatsächlich werden bei Liniendiagrammen die Intervalle zwischen den Punkten, auch wenn keine Daten fehlen, als gerade Linie zwischen zwei Punkten dargestellt.
Für die lineare Interpolation verwenden wir das Paket imputeTS. Nach der Installation und dem Laden der Bibliothek füllst du die fehlenden Werte mit na_interpolation(). Übergeben werden zwei Argumente: erstens die Spalte des Dataframes, die du behandeln möchtest, und zweitens die gewünschte Methode für die Imputation.
install.packages("imputeTS", quiet = TRUE)library(imputeTS)Registered S3 method overwritten by 'quantmod': method from as.zoo.data.frame zoo df$TAVG <- na_interpolation(df$TAVG, option ="linear")Schritt 3: Die erste Version unseres Plots
Eine ggplot2-Visualisierung besteht aus Schichten. Wie in der Abbildung unten zu sehen, enthält jede Schicht genau ein Geom-Objekt, also ein sichtbares Element in der Grafik (z. B. Linien oder Punkte).
Zuerst übergibst du der Funktion ggplot() einen Datensatz. Dann ordnest du Variablen den Ästhetiken zu – den visuellen Eigenschaften eines Geoms. Dazu zählen etwa Position auf der y-Achse, Position auf der x-Achse, Farbe oder Größe. Mehr zu ggplot findest du im Kurs Introduction to Data Visualization with ggplot2 von Rick Scavetta, bei dem ich viel über Datenvisualisierung gelernt habe.
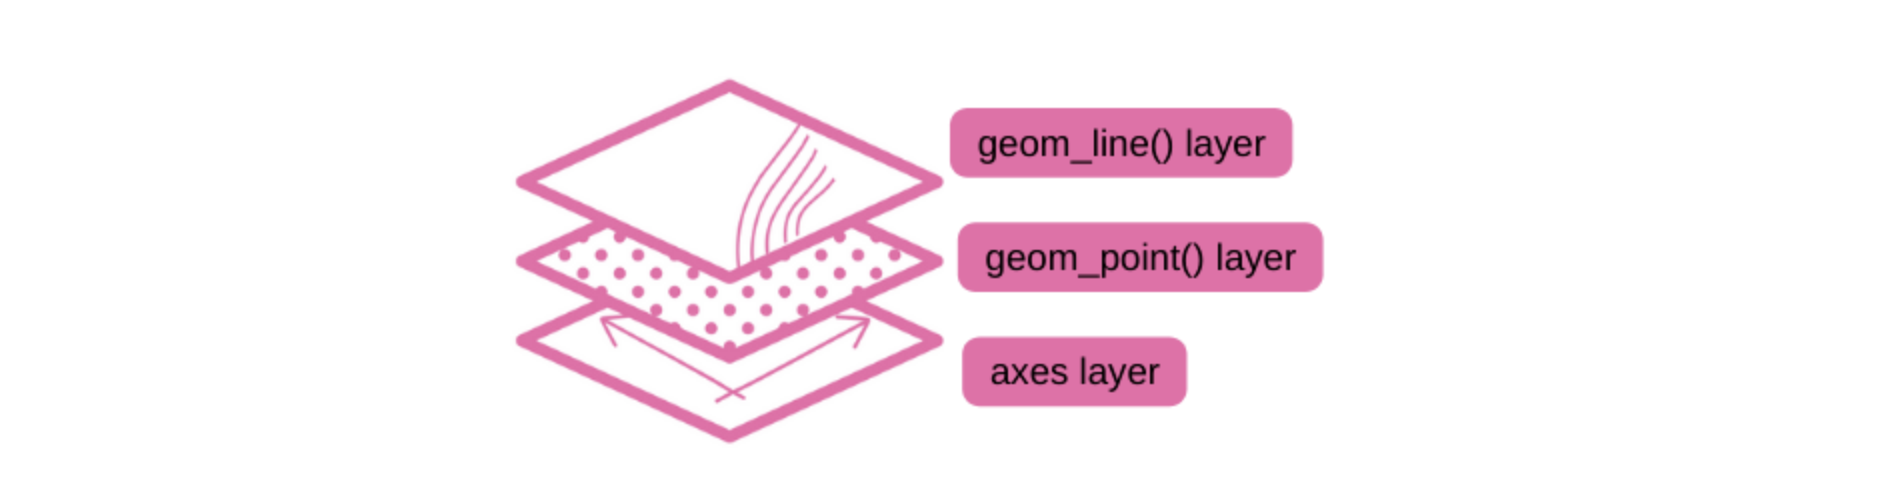
ggplot2-Schichten. Grafik der Autorin/des Autors.
In unserem Mapping (aes()) legen wir fest, dass die x-Achse von „DATE“ abhängt und die y-Achse von der Temperatur. Wenn du nur diese Schicht plottest, zeigt ggplot zunächst nur die Achsen.
Bevor wir mit ggplot starten, setzen wir noch globale Einstellungen, die für alle Plots gelten sollen: erstens Größe und Auflösung, zweitens das Theme.
library(ggplot2)options(repr.plot.width = 10, repr.plot.height = 6, repr.plot.res = 150 )theme_set(theme_bw())axes <- ggplot(data = df, aes(x = DATE, y = TAVG))axes
Jetzt fügst du eine zweite Schicht mit Punkten hinzu, die die Temperaturen über die Zeit markieren. Die neue Schicht kannst du an den zuvor erstellten Plot anhängen.
dot_plot <- axes + geom_point()dot_plot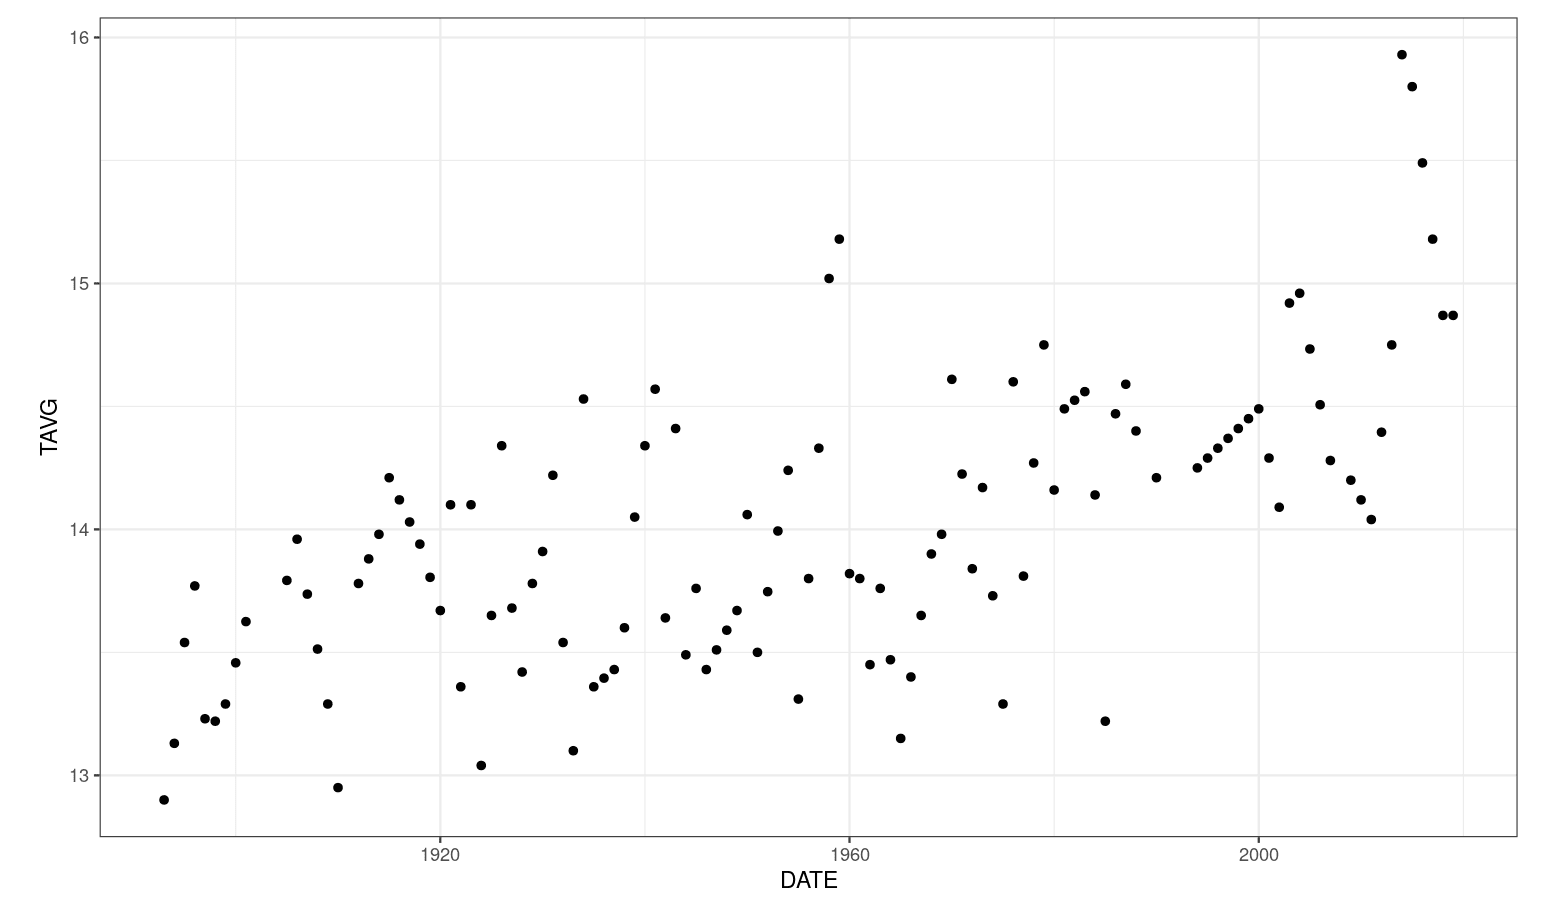
Zum Schluss ergänzt du eine dritte Schicht mit Linien. Wichtig: Manche Autorinnen und Autoren argumentieren, dass Linien keine direkt beobachteten Daten zeigen und daher mit Bedacht eingesetzt werden sollten. Eine ausführliche Diskussion findest du in Kapitel 13 von Fundamentals of Data Visualization von Claus O. Wilke.
dot_plot +geom_line()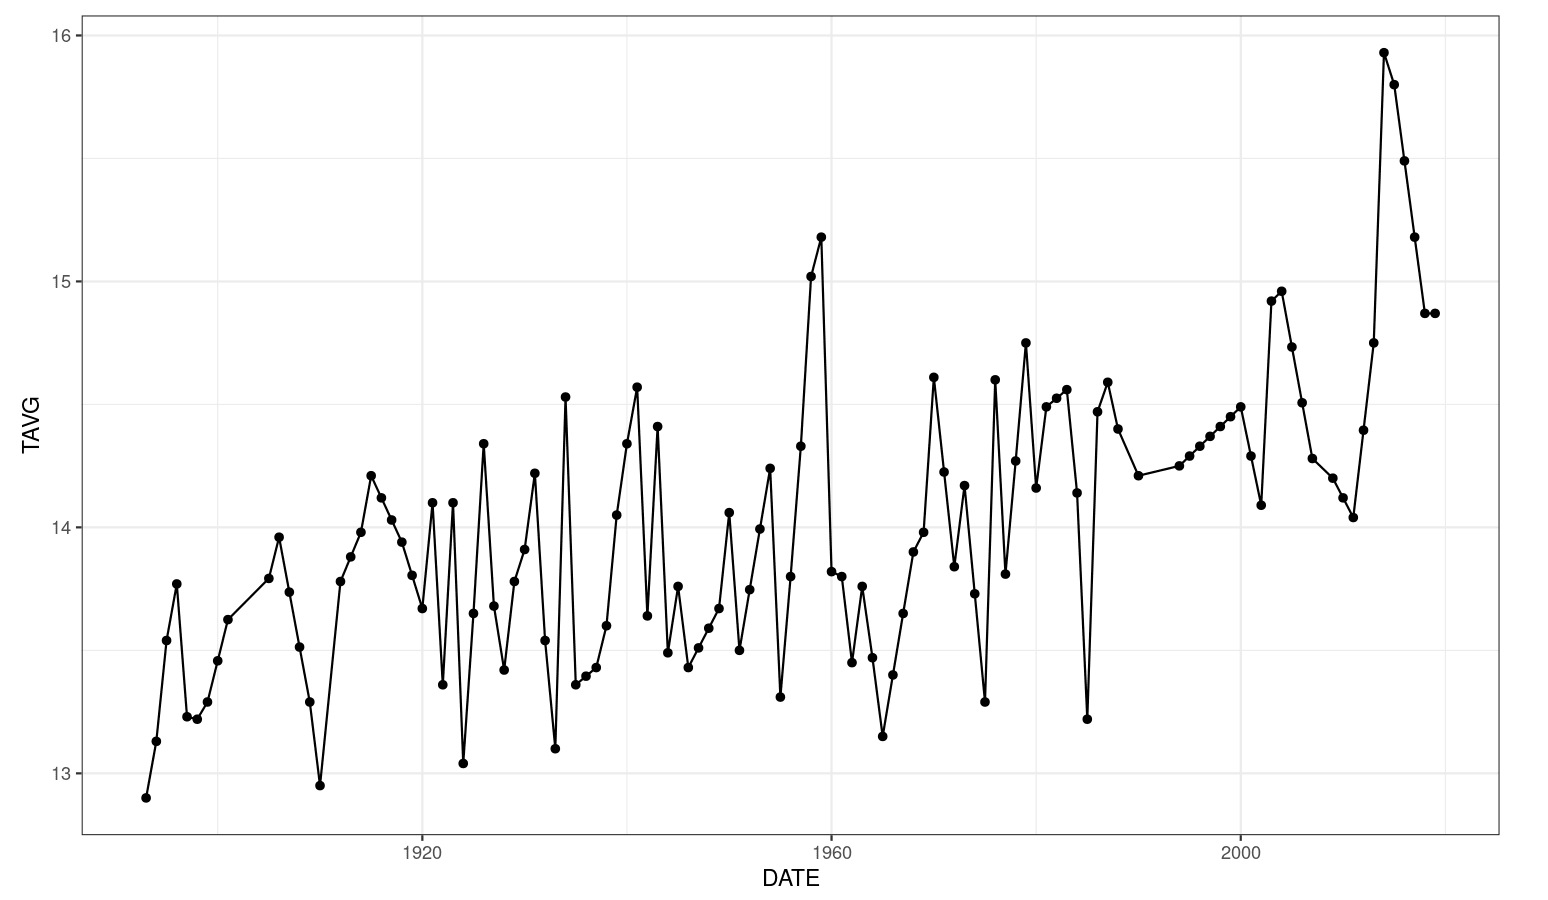
Schritt 4: Deinen Plot anpassen
In diesem Abschnitt passt du deinen Plot so an, dass er klar, informativ und ansprechend ist.
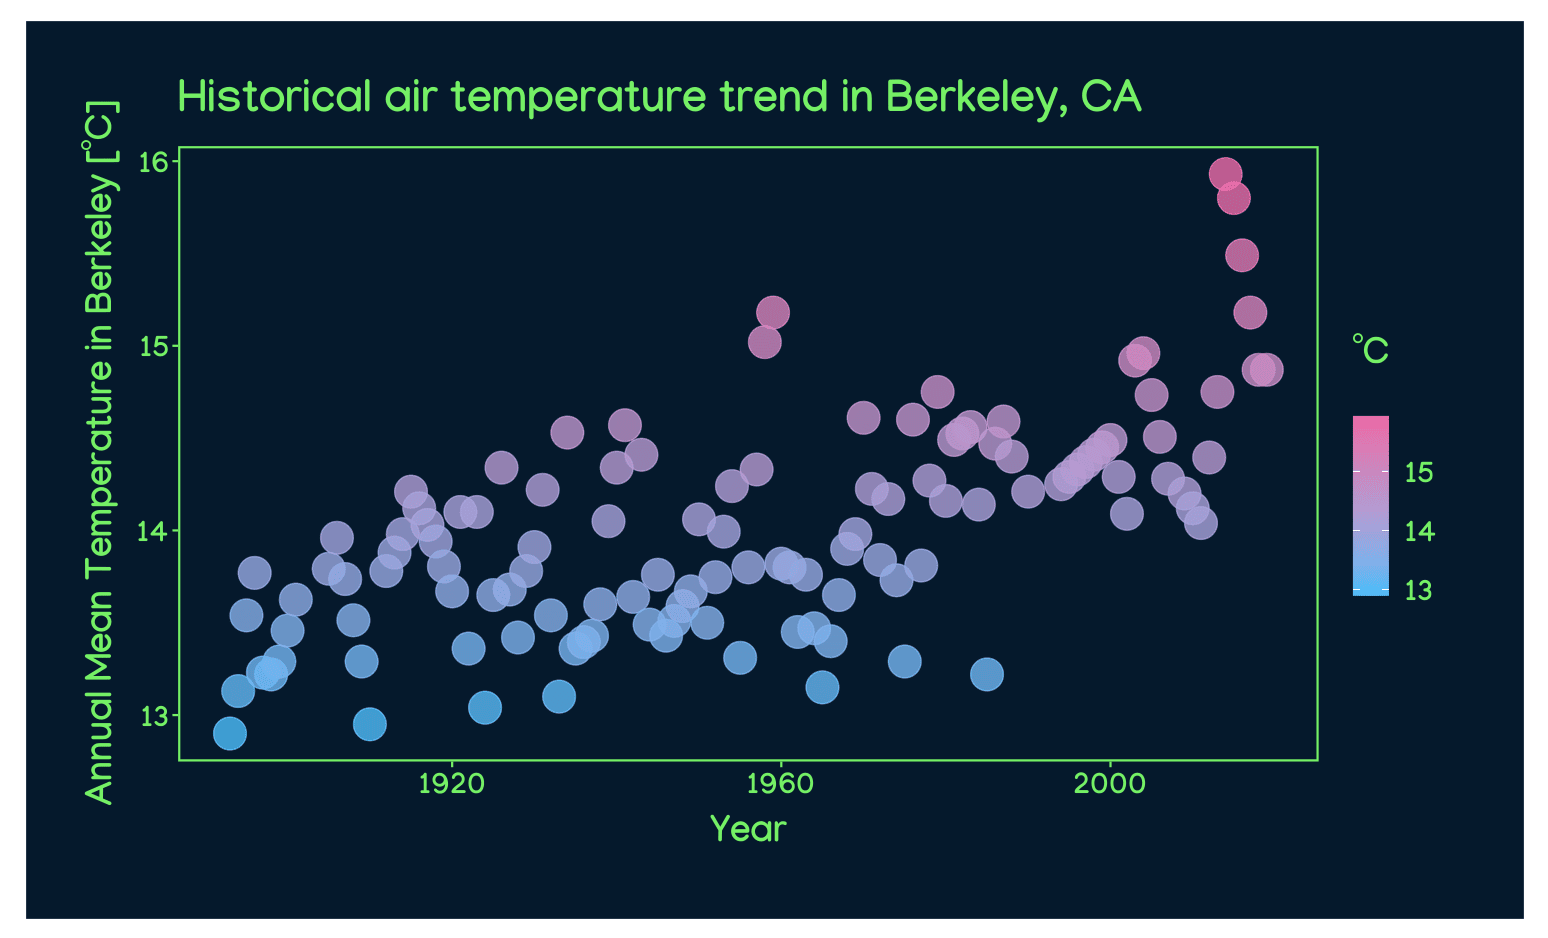
Um den Temperaturanstieg deutlicher zu machen, mappen wir auch die Farbe der Punkte auf „TAVG“. Da es sich um eine numerische Variable handelt, nutzt ggplot2 einen Gradient, um kontinuierliche Werte über Farben darzustellen. Mit scale_color_gradient() bestimmst du, welche Farbe niedrige und welche hohe Temperaturen repräsentiert.
Außerdem kannst du die Achsenbeschriftungen mit xlab() und ylab() setzen. Einen Titel fügst du mit ggtitle() hinzu. Schließlich vergrößern wir die Punkte und fügen Transparenz hinzu, damit sich überlagernde Daten sichtbar bleiben.
ggplot(data = df, aes(x = DATE, y = TAVG, color = TAVG))+geom_point(size = 7, alpha = 0.8)+scale_color_gradient(name = "ºC", low = "#47BEFB", high = "#ED6AA8")+ggtitle("Historical air temperature trend in Berkeley, CA")+xlab("Year")+ylab("Annual Mean Temperature in Berkeley [ºC]")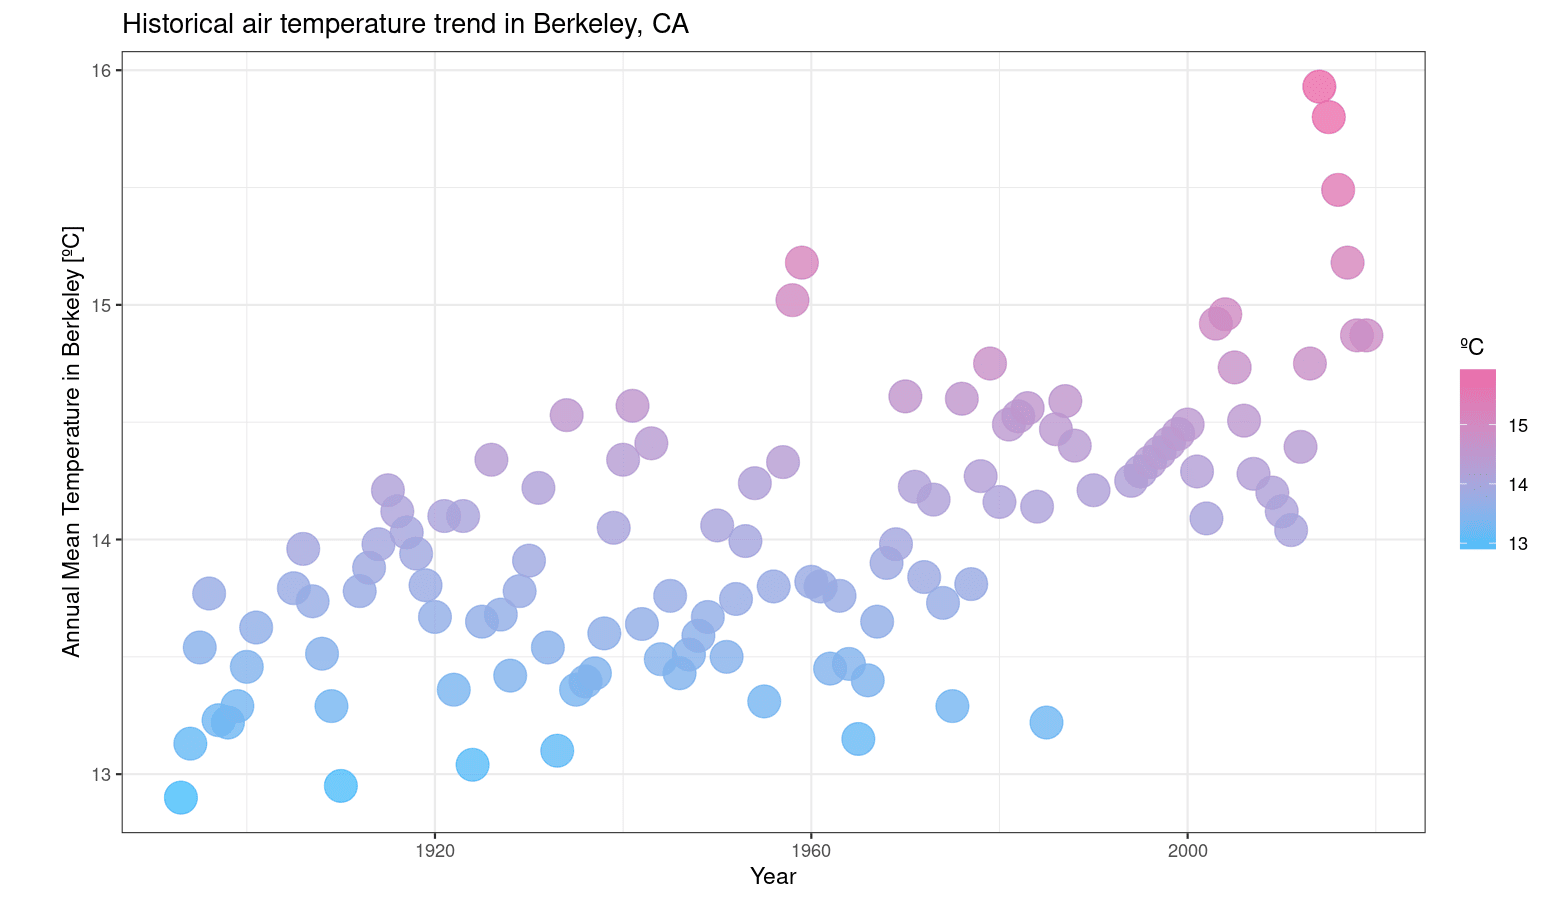
Edward Tufte, ein Vordenker der Datenvisualisierung, empfiehlt, den Anteil der „Tinte“ zu maximieren, der für nicht redundante Daten eingesetzt wird. So werden Grafiken klarer und lenken weniger ab.
Das von uns verwendete ggplot2-Theme (theme_bw()) folgt diesen Empfehlungen bereits weitgehend. Zusätzlich können wir die Rasterlinien entfernen. Das erreichst du mit theme() und den Argumenten panel.grid.minor = element_blank() und panel.grid.major = element_blank().
ggplot(data = df, aes(x = DATE, y = TAVG, color = TAVG))+geom_point(size = 7, alpha = 0.8)+scale_color_gradient(name = "ºC", low = "#47BEFB", high = "#ED6AA8")+ggtitle("Historical air temperature trend in Berkeley, CA")+xlab("Year")+ylab("Annual Mean Temperature in Berkeley [ºC]")+theme(# Eliminates grids: panel.grid.minor = element_blank(), panel.grid.major = element_blank())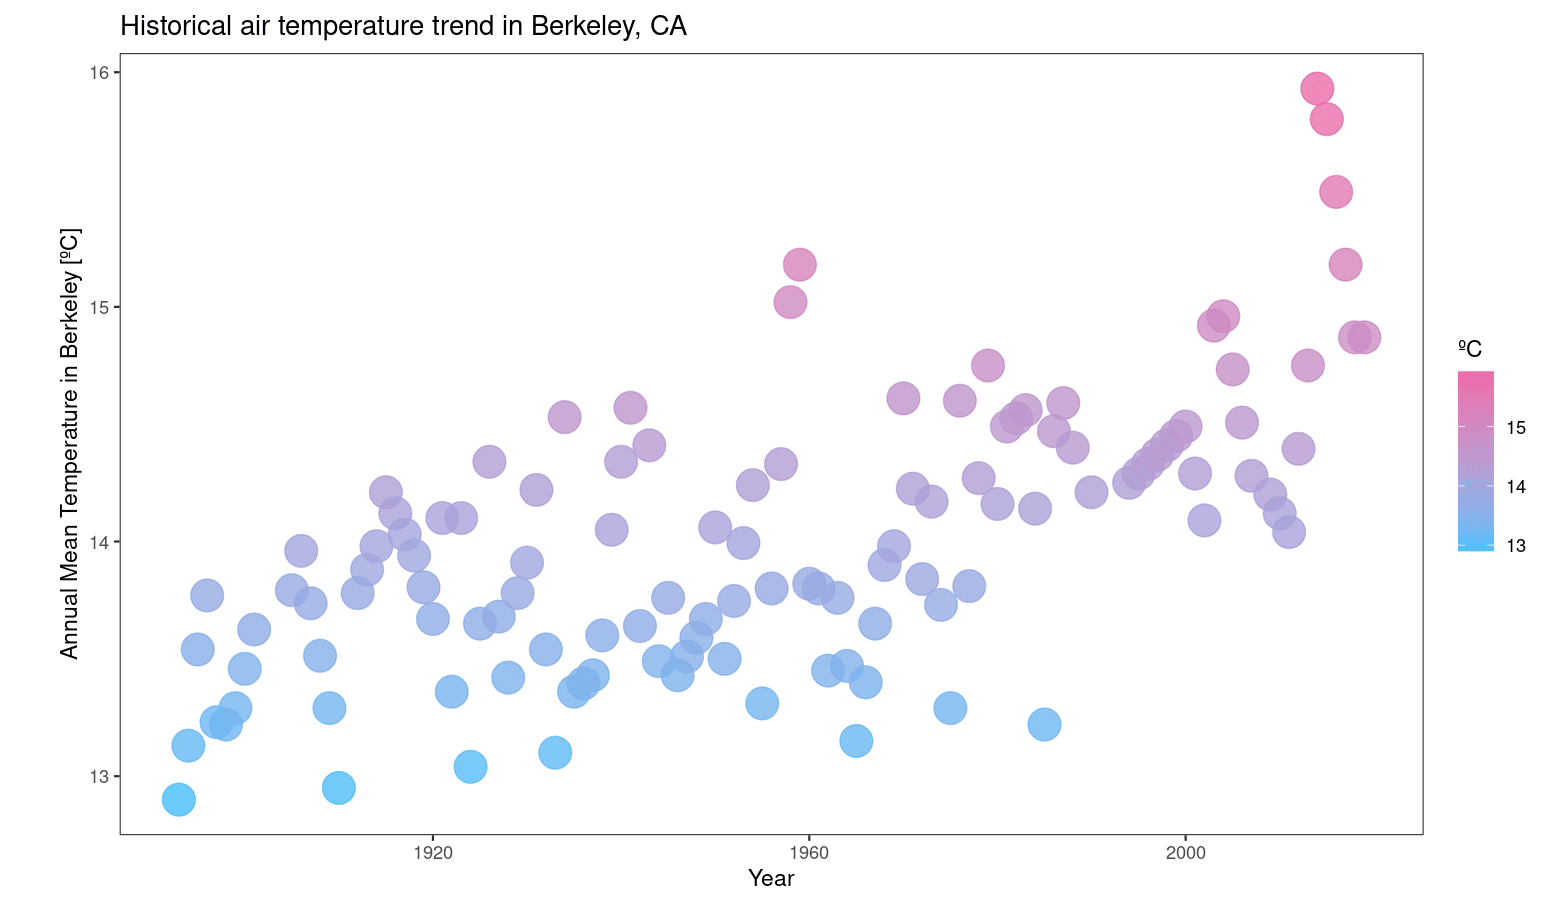
Schritt 5: Ein eigenes ggplot2-Theme erstellen
Jetzt erstellst du dein eigenes ggplot2-Theme. Als Beispiel bauen wir ein theme_datacamp(), damit der Plot optisch besser zum DataCamp-Auftritt passt.
Zunächst definieren wir eine Liste mit einigen DataCamp-Farben für die spätere Verwendung.
datacamp_colors <- list(green = "#74F065", darkblue = "#05192D", blue = "#47BEFB", pink = "#ED6AA8")Anschließend laden wir die Google-Schrift „Manjari“, die wir im Theme verwenden. Das geht bequem mit dem Paket „showtext“. Falls nicht vorhanden, installiere es zuerst.
install.packages("showtext", quiet = TRUE)Unten laden wir das Paket und fügen mit font_add_google() „Manjari“ hinzu. Mit showtext_auto() weist du R an, Text über „showtext“ zu rendern:
library(showtext)font_add_google("Manjari")showtext_auto()Loading required package: sysfontsLoading required package: showtextdbNun passen wir den Plot mit theme() an. Die Abbildung unten zeigt einige der verfügbaren Argumente. Eine vollständige Übersicht findest du in der ggplot2-Referenz.
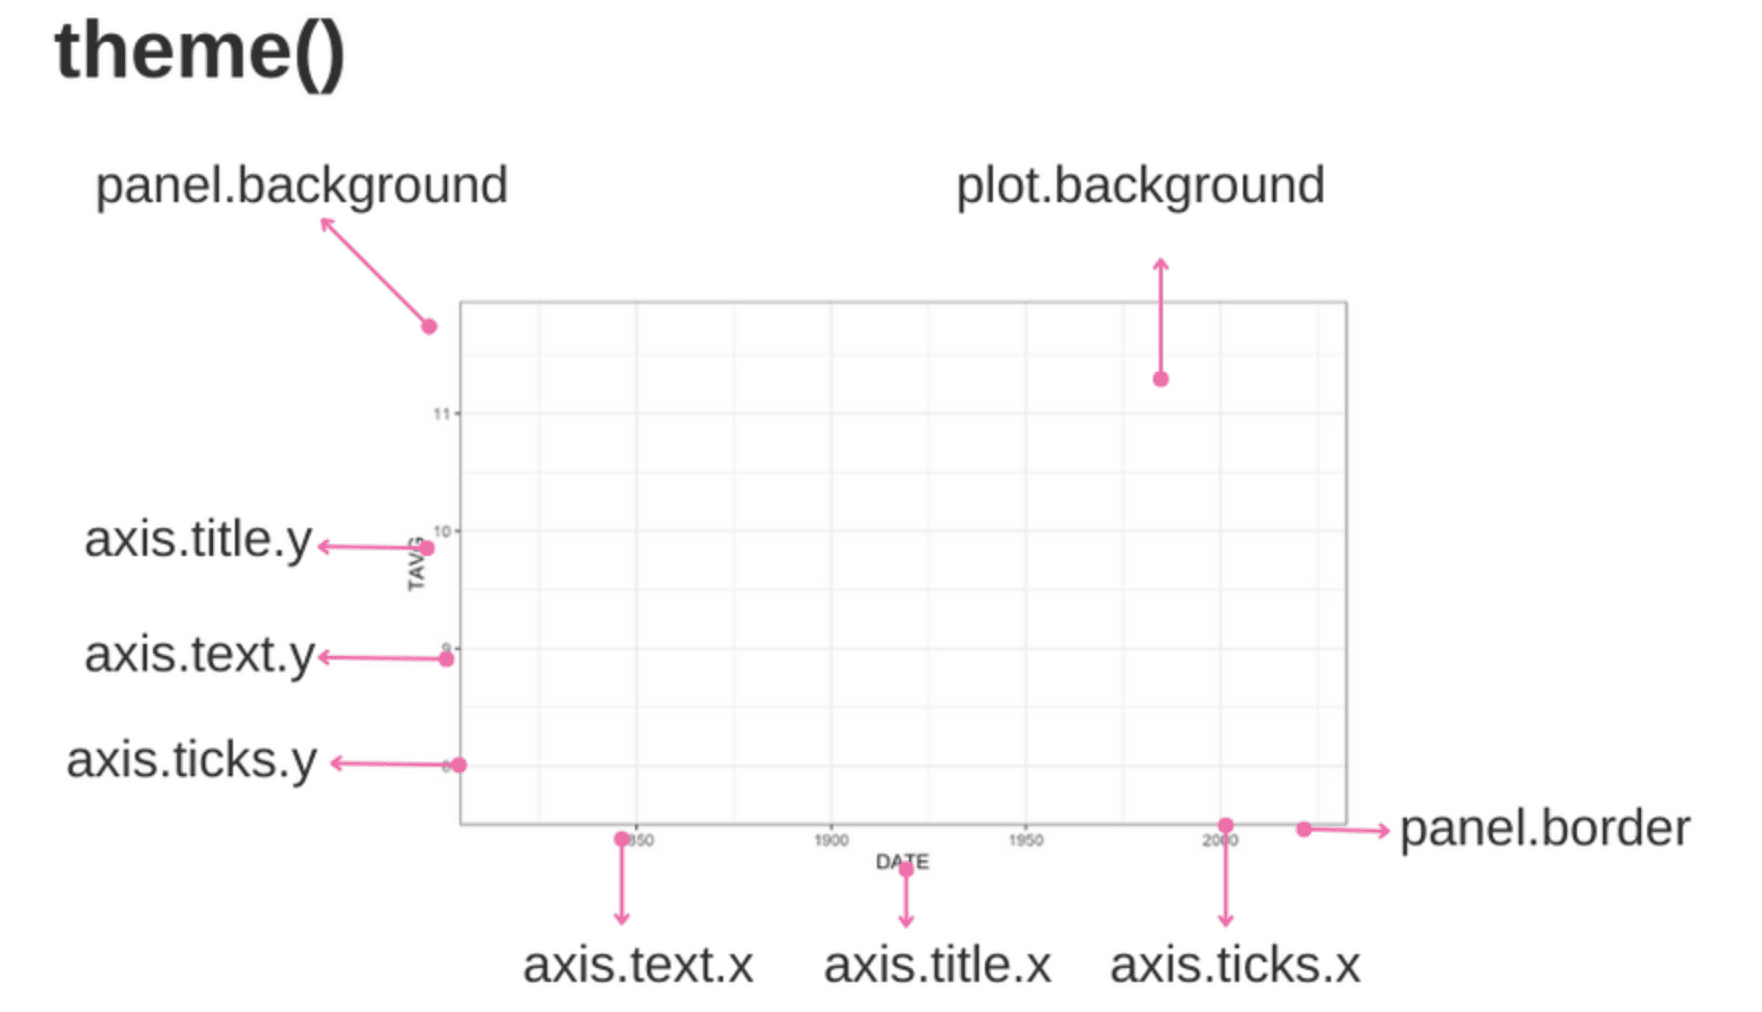
Theme-Argumente. Grafik der Autorin/des Autors.
Du kannst ein neues Theme als Funktion definieren, die theme() mit deinen Einstellungen aufruft. Wir starten vom Schwarz-Weiß-Theme (theme_bw()), entfernen Raster, ändern Hintergrund-, Panel- und Textfarben und fügen einen Rand von 0,5 cm hinzu. Um spätere Anpassungen zu erleichtern, gibt es zwei Argumente, mit denen du Text-/Panelfarbe und Hintergrundfarbe festlegst.
theme_datacamp <- function(text_panel_color, background_color) { theme_bw()+ theme(text=element_text(size=28, family="Manjari", face = "bold", color = text_panel_color), # Eliminates grids panel.grid.minor = element_blank(), panel.grid.major = element_blank(), # Changes panel, plot and legend background to dark blue panel.background = element_rect(fill = background_color), plot.background = element_rect(fill = background_color), legend.background = element_rect(fill= background_color), # Changes legend texts color to white legend.text = element_text(color = text_panel_color, margin = margin(0, 0, 0, -0.5, "cm")), legend.title = element_text(color = text_panel_color), legend.text.align = 0, # Changes color of plot border to white panel.border = element_rect(size = 1, color = text_panel_color), # Changes color of axis texts to white axis.text.x = element_text(color = text_panel_color), axis.text.y = element_text(color = text_panel_color), axis.title.x = element_text(color= text_panel_color), axis.title.y = element_text(color= text_panel_color), # Changes axis ticks color to white axis.ticks.y = element_line(color = text_panel_color), axis.ticks.x = element_line(color = text_panel_color), # Adds margin plot.margin = margin(1, 1, 1, 1, "cm") )}Nun kannst du theme_datacamp() einfach zu deinem Plot hinzufügen und die gewünschten Farben angeben. Hier verwende ich DataCamp-Farben:
ggplot(data = df, aes(x = DATE, y = TAVG, color = TAVG))+geom_point(size = 7, alpha = 0.8)+scale_color_gradient(name = "ºC", low = datacamp_colors$blue, high = datacamp_colors$pink)+ggtitle("Historical air temperature trend in Berkeley, CA")+xlab("Year")+ylab("Annual Mean Temperature in Berkeley [ºC]")+theme_datacamp(text_panel_color = datacamp_colors$green, background_color = datacamp_colors$darkblue)
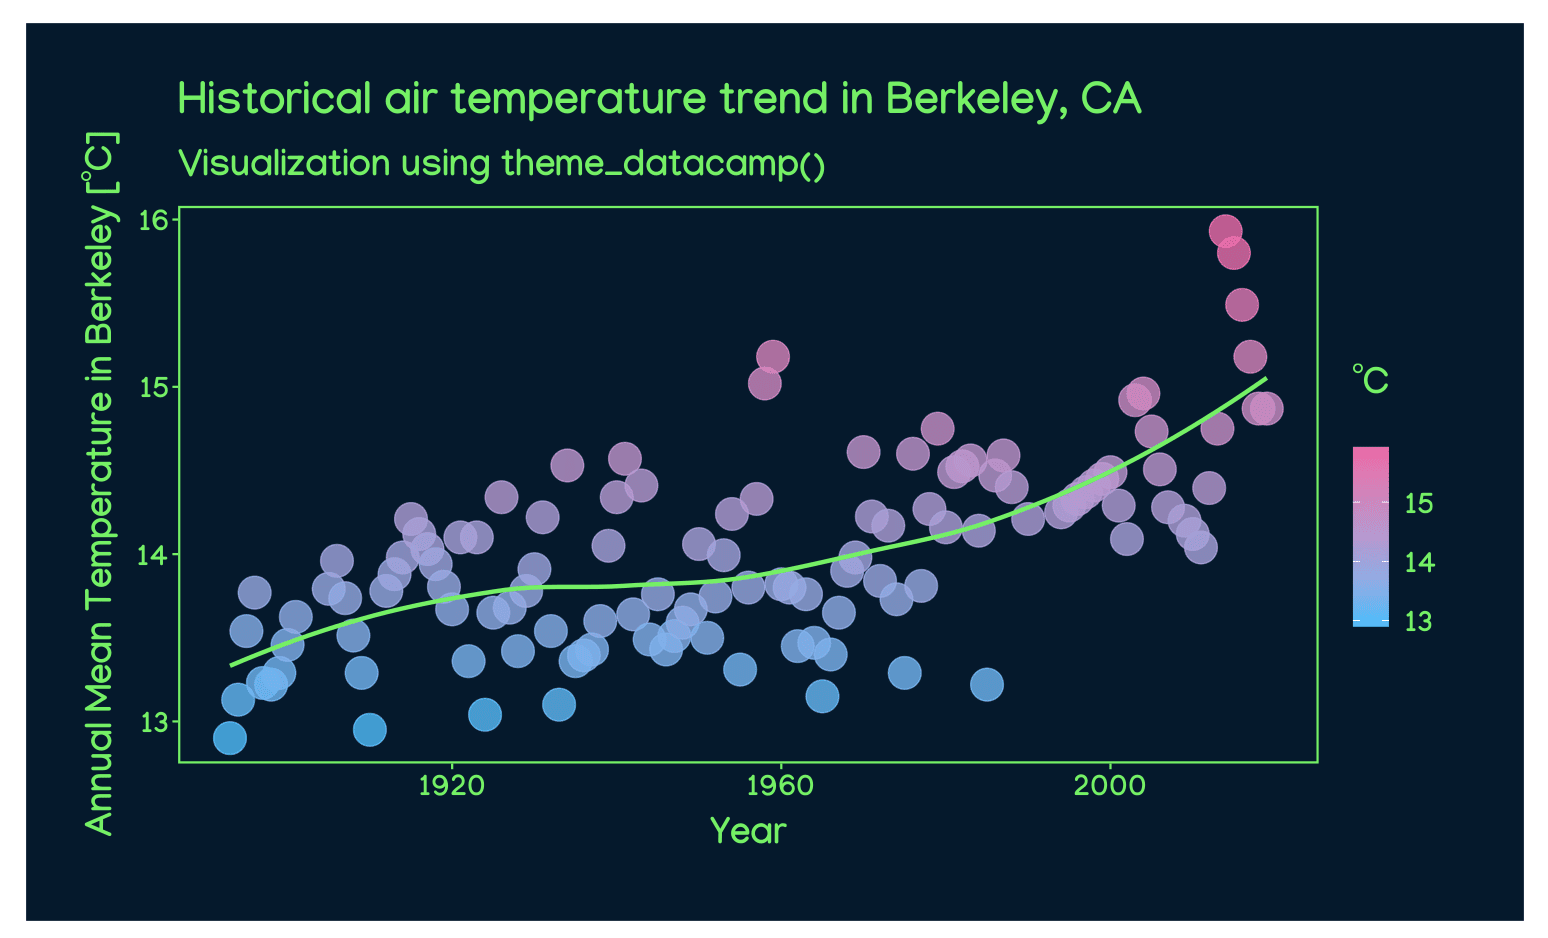
Zum Schluss kannst du den Temperaturtrend mit einem LOESS-Glätter (locally estimated scatterplot smoothing) hervorheben, wie von Claus O. Wilke in Kapitel 14 von Fundamentals of Data Visualization empfohlen. Dafür fügst du eine ggplot-Schicht mit
geom_smooth()hinzu.ggplot(data = df, aes(x = DATE, y = TAVG, color = TAVG))+geom_point(size = 7, alpha = 0.8)+geom_smooth(color = datacamp_colors$green, se = FALSE)+scale_color_gradient(name = "ºC", low = datacamp_colors$blue, high = datacamp_colors$pink)+ggtitle("Historical air temperature trend in Berkeley, CA", subtitle = "Visualization using theme_datacamp()")+xlab("Year")+ylab("Annual Mean Temperature in Berkeley [ºC]")+theme_datacamp(text_panel_color = datacamp_colors$green, background_color = datacamp_colors$darkblue)
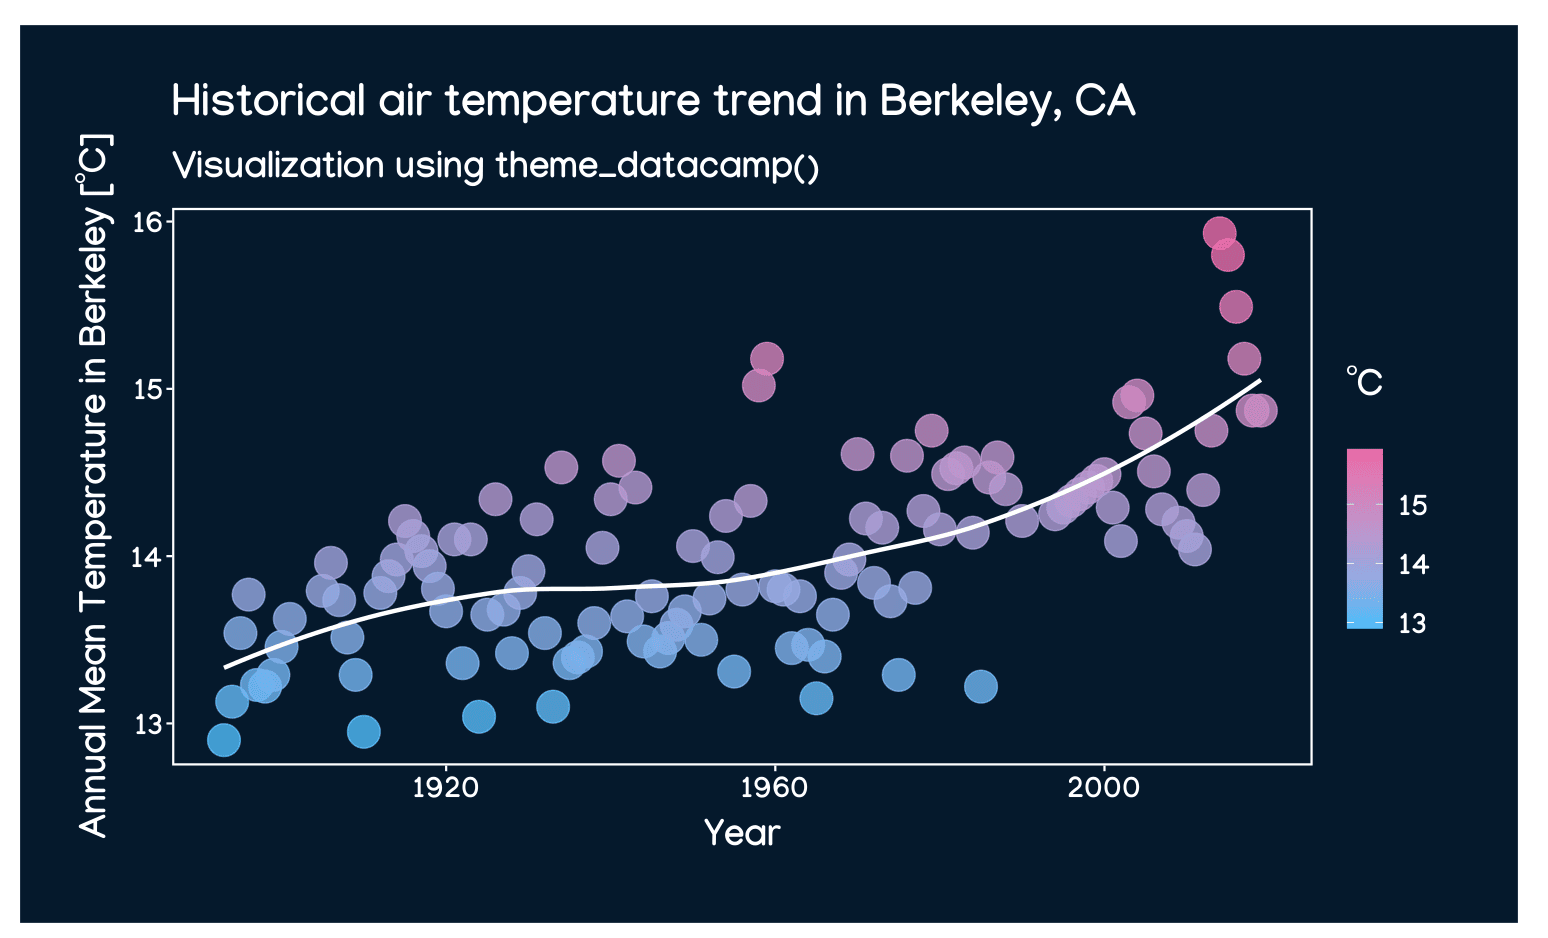
Probiere gerne weitere Farb- und Schriftkombinationen aus, um noch überzeugendere Visualisierungen zu erstellen. Unten habe ich beispielsweise die LOESS-Kurve sowie Panel- und Textfarbe auf Weiß geändert.
ggplot(data = df, aes(x = DATE, y = TAVG, color = TAVG))+geom_point(size = 7, alpha = 0.8)+geom_smooth(color = "white", se = FALSE)+scale_color_gradient(name = "ºC", low = datacamp_colors$blue, high = datacamp_colors$pink)+ggtitle("Historical air temperature trend in Berkeley, CA", subtitle = "Visualization using theme_datacamp()")+xlab("Year")+ylab("Annual Mean Temperature in Berkeley [ºC]")+theme_datacamp(text_panel_color = "white", background_color = datacamp_colors$darkblue)
Fazit
In diesem Tutorial hast du gelernt, wie du mit ggplot2 in R historische Klimadaten wirkungsvoll visualisierst. Von der Datenquelle bis zum eigenen ggplot2-Theme hast du die Kompetenzen aufgebaut, um mit Visualisierungen Bewusstsein für den Klimawandel zu schaffen.
Als nächsten Schritt kannst du mit den DataCamp-Kursen Introduction to Data Visualization with ggplot2 und Intermediate R tiefer in Datenvisualisierung und R einsteigen. Damit vertiefst du das hier Gelernte und nimmst komplexere Projekte in Angriff.