{count, plural, one {Curso} other {Cursos}}
Conceptos de grandes modelos lingüísticos (LLM)
{hours} h
112.4K
Crear aplicaciones con LLM se complica enseguida. Empiezas a estimar a ojo los costes. Depurar fallos es más difícil cuando no ves qué ha pasado. Los prompts acaban desperdigados por el código. LangFuse resuelve esto con una plataforma que lo rastrea todo, gestiona los prompts y mide la calidad.
En este tutorial, construirás una herramienta de preguntas y respuestas sobre documentos y verás cómo LangFuse ordena tu desarrollo. Aprenderás a trazar llamadas a LLM para depurar, gestionar prompts con control de versiones y explorar enfoques de evaluación.
LangFuse es una plataforma open source que ayuda a los equipos a crear mejores aplicaciones con LLM. Mientras tú te centras en las funcionalidades, LangFuse se encarga del monitoreo, las pruebas y la depuración.
La plataforma cubre tres áreas principales:
Querrás LangFuse cuando tu aplicación con LLM vaya más allá de simples experimentos. Estas son las situaciones en las que aporta valor:
Si estás creando un prototipo rápido o un proyecto personal, probablemente aún no lo necesites. Pero cuando tu app tenga usuarios reales o tu equipo crezca más allá de una persona, LangFuse empieza a ser útil.
LangFuse funciona con tu stack de IA actual. Se integra con frameworks como LangChain, LlamaIndex, AutoGen y CrewAI. Puedes usarlo con cualquier proveedor de modelos: OpenAI, Anthropic, Google Gemini, Mistral o modelos de Hugging Face funcionan sin configuración adicional.
La plataforma ofrece SDKs nativas para Python y JavaScript, además de soporte para OpenTelemetry en configuraciones personalizadas. Uses constructores sin código de agentes o frameworks multiagente complejos, LangFuse se conecta sin cambiar tu arquitectura principal.
Empresas como Samsara, Twilio y Khan Academy lo usan en producción, y cumple estándares de seguridad enterprise. El proyecto tiene más de 16.500 estrellas en GitHub con el respaldo de Y Combinator. Puedes usar la versión alojada o ejecutarla en tu propia infraestructura.
Ahora que entiendes qué hace LangFuse y cuándo ayuda, vamos a construir algo con él. Como prometimos, crearemos una sencilla herramienta de preguntas y respuestas sobre documentos que muestre las tres funciones en acción.
Necesitas algo de experiencia con Python y LLM antes de ponerte con LangFuse.
Imprescindible:
Recomendable:
Configuración:
uv o pip)¿Nuevo en desarrollo con IA? Empieza con nuestra guía completa para aprender IA.
Para entender dónde encaja LangFuse en el ecosistema, echa un vistazo a nuestro resumen de herramientas LLMOps.
Ahora sí, vamos a construir. Empezaremos con una función básica de preguntas y respuestas sobre documentos y verás cómo LangFuse registra lo que ocurre al ejecutarla. Este ejemplo cubre las tres funciones clave —observabilidad, gestión de prompts y evaluación— de forma escalable a proyectos más complejos.
Construirás un sistema sencillo de Q&A que responde a preguntas a partir de un PDF. Tendrás algo real que trazar, gestionar y evaluar. Aunque el ejemplo es simple, estos patrones valen para sistemas RAG complejos y flujos multiagente.
Primero, crea un directorio para el proyecto e instala los paquetes necesarios:
mkdir langfuse-qa-demo
cd langfuse-qa-demo
uv add langfuse langchain langchain-openai langchain-community pypdf python-dotenv
Crea una cuenta gratuita en LangFuse Cloud en langfuse.com. Tras iniciar sesión, crea una nueva organización y proyecto. Verás una pantalla con tus claves de API:
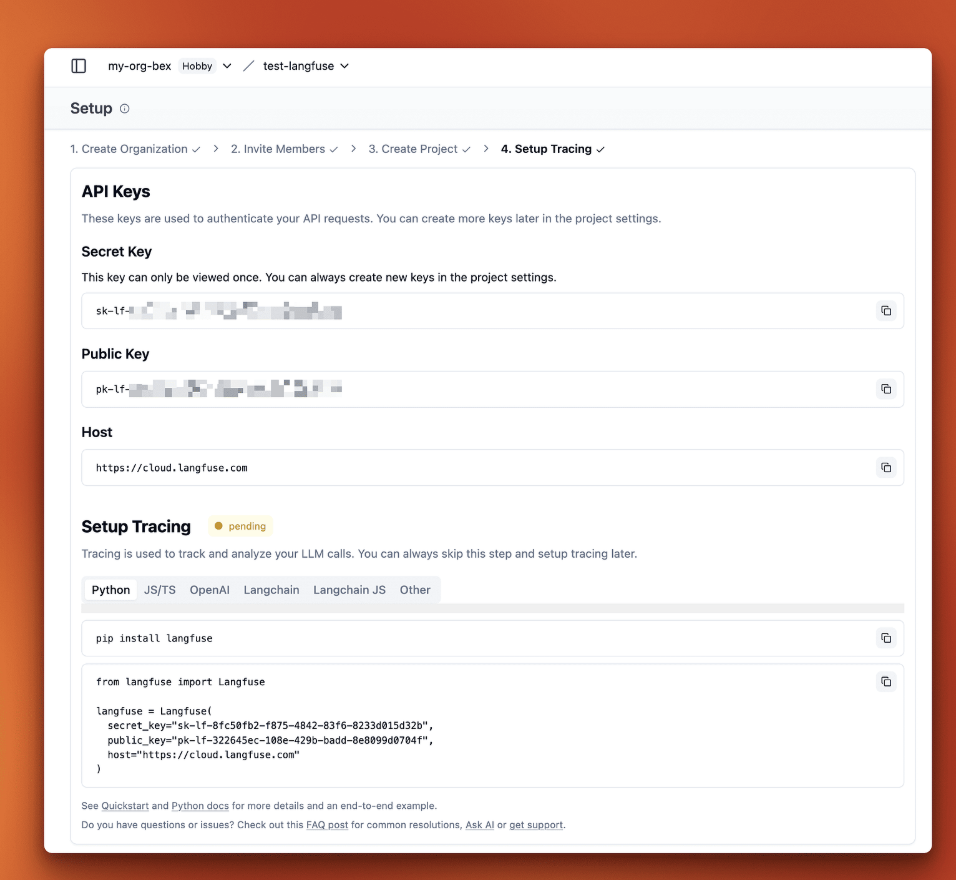
Copia tu Public Key y Secret Key. También necesitarás tu clave de API de OpenAI de platform.openai.com.
Ahora crea un archivo .env en el directorio del proyecto:
OPENAI_API_KEY=your_openai_key_here
LANGFUSE_PUBLIC_KEY=pk-lf-...
LANGFUSE_SECRET_KEY=sk-lf-...
LANGFUSE_HOST=https://cloud.langfuse.com
Si prefieres ejecutar LangFuse en tu propia infraestructura, puedes usar Docker Compose para pruebas locales. La guía de autoservicio explica cómo configurar PostgreSQL, ClickHouse y los servicios de LangFuse. Para despliegues en producción, usa Kubernetes o plantillas de Terraform específicas de tu cloud.
Crearás una cadena de recuperación que carga un PDF, lo divide en fragmentos, los guarda en una base vectorial y responde preguntas con el contexto recuperado.
Crea un archivo llamado qa_chain.py:
from langchain_community.document_loaders import PyPDFLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_core.vectorstores import InMemoryVectorStore
from langchain.chains import create_retrieval_chain
from langchain.chains.combine_documents import create_stuff_documents_chain
from langchain_core.prompts import ChatPromptTemplate
from dotenv import load_dotenv

load_dotenv()
Esto importa todo lo necesario. La llamada load_dotenv() carga tus claves de API desde el archivo .env.
# Load and split PDF
loader = PyPDFLoader("ai-security-landscape.pdf")
docs = loader.load()

text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
splits = text_splitter.split_documents(docs)
Aquí cargamos el documento ai-security-landscape.pdf, uno de los whitepapers de Amazon Web Services. Para ejecutar este ejemplo, tendrás que descargar el archivo y añadirlo a tu directorio de trabajo con el nombre correcto.
El PyPDFLoader lee el PDF y RecursiveCharacterTextSplitter lo divide en fragmentos de 1000 caracteres con 200 de solape. El solape ayuda a mantener el contexto entre fragmentos.
A continuación, crea la base vectorial:
# Create vector store
embeddings = OpenAIEmbeddings()
vectorstore = InMemoryVectorStore.from_documents(documents=splits, embedding=embeddings)
InMemoryVectorStore guarda los embeddings en memoria. En producción, usarías Pinecone, Weaviate u otra base vectorial.
Ahora construye la cadena de Q&A:
# Build QA chain
llm = ChatOpenAI(model="gpt-4")
prompt = ChatPromptTemplate.from_messages([
   ("system", "Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.\n\n{context}"),
   ("human", "{input}"),
])

question_answer_chain = create_stuff_documents_chain(llm, prompt)
qa_chain = create_retrieval_chain(vectorstore.as_retriever(), question_answer_chain)
create_stuff_documents_chain toma los documentos recuperados y los inserta en el contexto del prompt. create_retrieval_chain combina la recuperación y la respuesta en una sola cadena.
Con la cadena lista, conectémosla a LangFuse para trazar.
Añade un callback handler de LangFuse al script:
from langfuse.langchain import CallbackHandler

langfuse_handler = CallbackHandler()

response = qa_chain.invoke(
   {"input": "What are the main security risks discussed?"},
   config={"callbacks": [langfuse_handler]}
)

print(response["answer"])
The main security risks discussed in relation to generative artificial intelligence (AI) are context window overflow, agent mismanagement, indirect prompt injections and data leaks from overprivileged agents, logging, and caching.
Trace sent to LangFuse! Check your dashboard at https://cloud.langfuse.comAl ejecutar esto, LangFuse captura el rastro completo de ejecución. Ve a tu panel de LangFuse y verás que se actualiza con nuevos detalles:
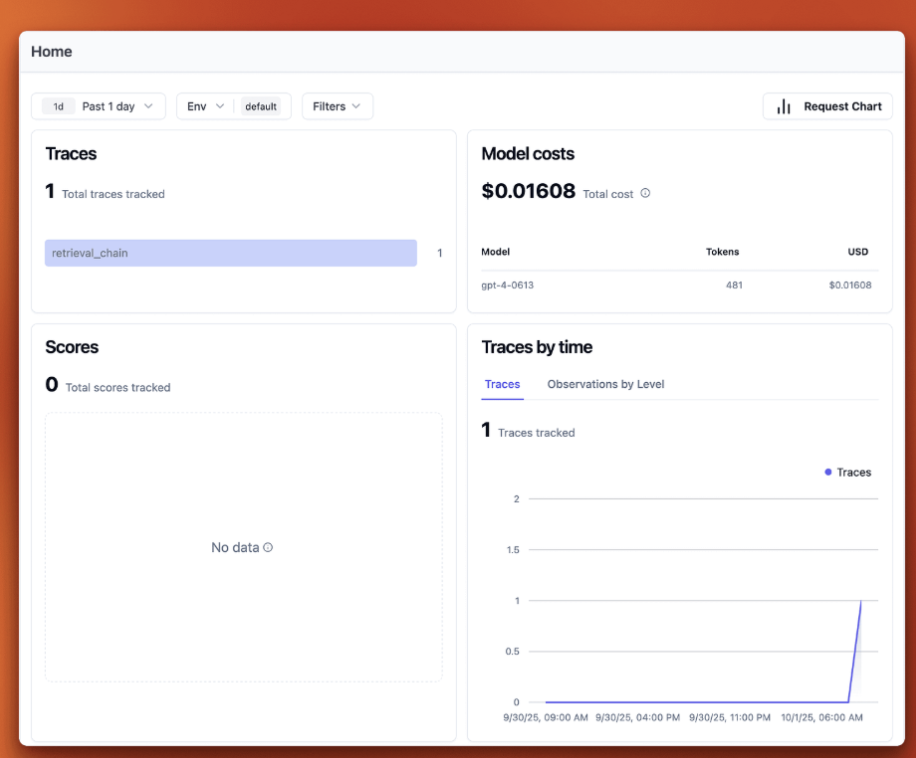
Aunque aquí usamos un ejemplo simple, LangFuse funciona con pipelines RAG complejos que manejan múltiples tipos de documentos, usan reranking o ejecutan varias estrategias de recuperación en paralelo.
Con tu sistema de Q&A en marcha y el trazado de LangFuse activo, ya puedes entender qué captura LangFuse y cómo usar esa información para mejorar tu aplicación.
Acabas de enviar un trace a LangFuse. Ahora, veamos qué te aporta y por qué importa.
El logging tradicional no funciona bien en apps con LLM. Puedes registrar que se ejecutó una función, pero no ves qué hizo realmente el modelo con la entrada del usuario. ¿Recuperó los documentos correctos? ¿Se formateó bien el prompt? ¿Qué paso tardó cinco segundos?
La observabilidad de LLM rastrea toda la ejecución. Ves cada entrada, salida y paso intermedio. Si un usuario reporta respuestas erróneas, abres su trace y observas exactamente qué pasó. No supones: lo sabes.
Esto importa más cuanto más compleja es tu app. Una cadena de Q&A simple tiene 4–5 pasos. Los sistemas RAG en producción incluyen cargadores de documentos, estrategias de troceado, múltiples recuperadores, reordenadores y generación. Sin observabilidad, depurar es imposible. Con ella, localizas el problema.
Abre tu panel de LangFuse y haz clic en «Tracing» en la barra lateral izquierda. Verás tu primer trace listado en una tabla.
La tabla muestra cuándo se ejecutó, cómo se llamó (retrieval_chain) y qué entró y salió. Cada fila representa una ejecución completa de tu cadena de Q&A.
Haz clic en el trace para ver qué pasó dentro. Verás un desglose detallado.
El panel izquierdo muestra tu árbol de ejecución. LangFuse registró cada paso de tu cadena. La raíz retrieval_chain tardó 4,75 segundos en total. Debajo, ves cada operación: recuperación de documentos (retrieve_documents), búsqueda vectorial (VectorStoreRetriever) y generación de la respuesta (stuff_documents_chain). Cada paso muestra su tiempo de ejecución.
Esta jerarquía te indica dónde invierte tiempo tu cadena. Si tu app va lenta, sabrás si es por la búsqueda de embeddings, la consulta vectorial o la llamada al LLM.
El panel derecho muestra los datos del trace. Arriba verás las métricas clave: latencia (4,75 s), coste (~$0,016) y tokens usados (426 de entrada, 55 de salida). Debajo, ves la entrada y la salida reales. La sección context muestra los cuatro fragmentos de documentos que tu recuperador extrajo de la base vectorial.
Al final, un diagrama de flujo mapea cómo encadenó las operaciones tu cadena. Es útil al depurar cadenas complejas con varias ramas.
Hablemos ahora de sesiones. Un trace captura un ciclo de pregunta y respuesta. Pero las apps reales tienen conversaciones. Un usuario puede hacer tres preguntas relacionadas sobre riesgos de seguridad. Querrás agrupar esos traces.
Para eso sirven las sesiones: agrupan múltiples traces en un mismo hilo de conversación. Si un usuario reporta un bug, puedes abrir su sesión y ver todas las preguntas y respuestas.
Vamos a verlo en acción. Primero, crea un archivo auxiliar llamado build_chain.py que encapsule la lógica de construcción de la cadena:
from langchain_community.document_loaders import PyPDFLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_core.vectorstores import InMemoryVectorStore
from langchain.chains import create_retrieval_chain
from langchain.chains.combine_documents import create_stuff_documents_chain
from langchain_core.prompts import ChatPromptTemplate
from dotenv import load_dotenv

load_dotenv()

def build_qa_chain():
   # Load and split PDF
   loader = PyPDFLoader("ai-security-landscape.pdf")
   docs = loader.load()

   text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
   splits = text_splitter.split_documents(docs)

   # Create vector store
   embeddings = OpenAIEmbeddings()
   vectorstore = InMemoryVectorStore.from_documents(documents=splits, embedding=embeddings)

   # Build QA chain
   llm = ChatOpenAI(model="gpt-4")
   prompt = ChatPromptTemplate.from_messages([
       ("system", "Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.\n\n{context}"),
       ("human", "{input}"),
   ])

   question_answer_chain = create_stuff_documents_chain(llm, prompt)
   qa_chain = create_retrieval_chain(vectorstore.as_retriever(), question_answer_chain)

   return qa_chain
Esto lo encapsula todo en una función que puedes importar. Ahora crea sessions_demo.py:
from build_chain import build_qa_chain
from langfuse.langchain import CallbackHandler

# Build the Q&A chain
qa_chain = build_qa_chain()

# Set up LangFuse handler
langfuse_handler = CallbackHandler()
This imports your chain and sets up the LangFuse handler. Now add session tracking for the first conversation:
# Session 1: User asking about security risks
response1 = qa_chain.invoke(
   {"input": "What are the main security risks discussed?"},
   config={
       "callbacks": [langfuse_handler],
       "metadata": {"langfuse_session_id": "conversation-001"}
   }
)
print(f"Q1: {response1['answer']}\n")
El campo metadata con langfuse_session_id etiqueta este trace con un ID de sesión. Al ejecutar verás:
Q1: The main security risks discussed are context window overflow, agent mismanagement, and indirect prompt injections.Ahora añade una pregunta de seguimiento con el mismo ID de sesión:
response2 = qa_chain.invoke(
   {"input": "How can these risks be mitigated?"},
   config={
       "callbacks": [langfuse_handler],
       "metadata": {"langfuse_session_id": "conversation-001"}
   }
)
print(f"Q2: {response2['answer']}\n")
Esta segunda pregunta pertenece a la misma conversación, por eso usa conversation-001 otra vez. Verás una respuesta más larga:
Q2: Risks can be mitigated through several strategies including:
1. Input Management: Limit and sanitize inputs going into the model.
2. Real-time Monitoring: Use systems that alert when the context window is nearing capacity.
3. Principle of Least Privilege: Implement this for all agents and external integrations.
....
Ahora simula un segundo usuario con preguntas diferentes. Añade esto a tu script:
# Session 2: Different user asking about AI applications
response3 = qa_chain.invoke(
   {"input": "What AI applications are mentioned in the document?"},
   config={
       "callbacks": [langfuse_handler],
       "metadata": {"langfuse_session_id": "conversation-002"}
   }
)
print(f"Q3: {response3['answer']}\n")

response4 = qa_chain.invoke(
   {"input": "What are the benefits of these applications?"},
   config={
       "callbacks": [langfuse_handler],
       "metadata": {"langfuse_session_id": "conversation-002"}
   }
)
print(f"Q4: {response4['answer']}\n")
Estas dos preguntas usan conversation-002. Ejecuta el script completo:
uv run python sessions_demo.pyLas dos últimas salidas serán:
Q3: The document does not specifically mention any AI applications. However, it discusses the concept of generative AI and its security considerations.

Q4: The context does not provide specific benefits of these applications.
Ahora ve a tu panel de LangFuse y haz clic en «Sessions» en la barra lateral izquierda. Verás ambas conversaciones listadas:
Aparecen dos sesiones: conversation-002 (~4 segundos) y conversation-001 (~14 segundos). LangFuse agrupó los traces por ID de sesión.
Haz clic en conversation-001 para ver la conversación completa:
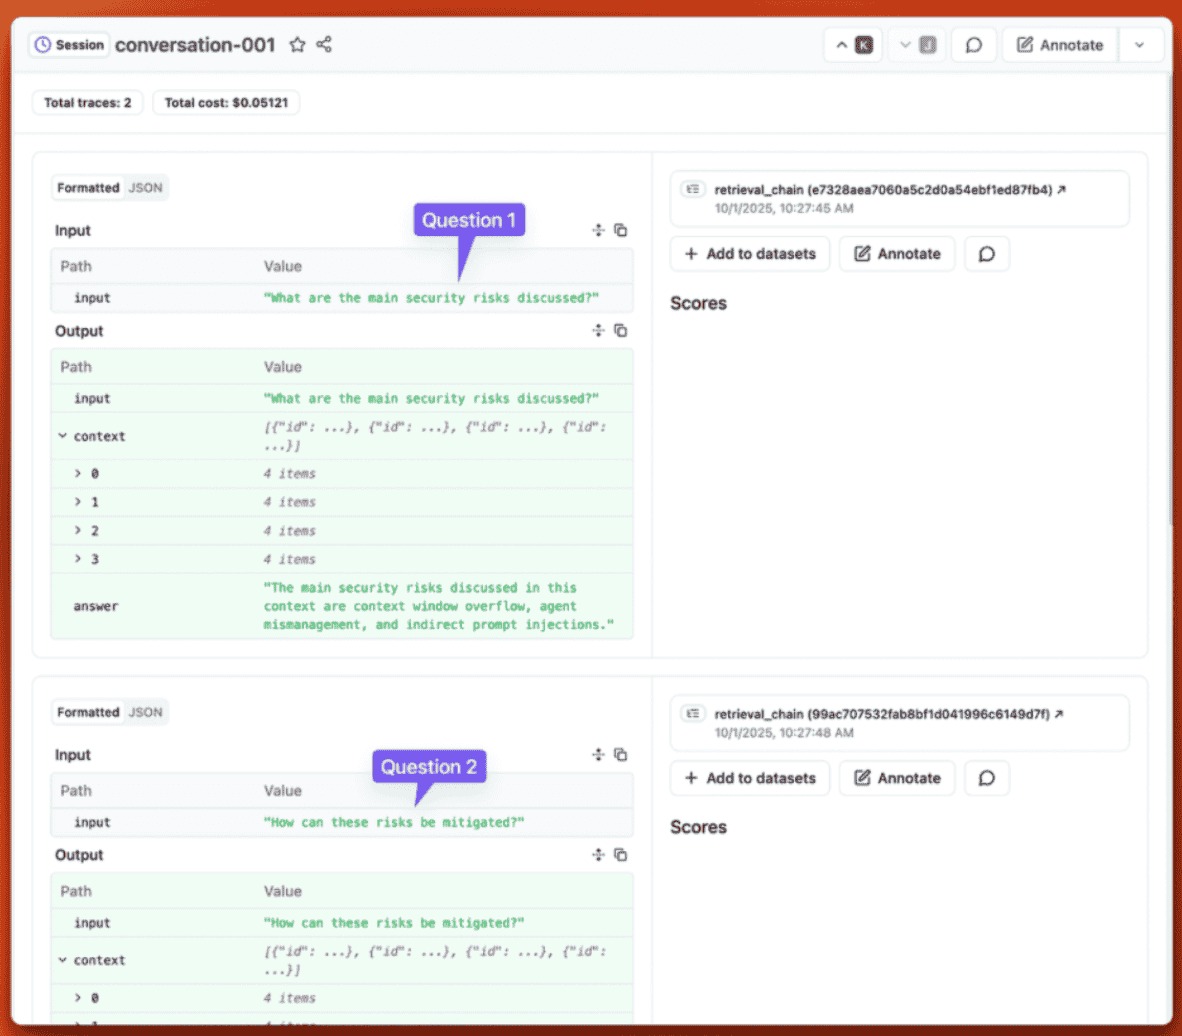
Ves ambos traces en orden: la pregunta 1 sobre riesgos y la pregunta 2 sobre mitigación. La sesión muestra el coste total ($0,05121 sumando los dos traces) y la duración total (14 segundos). Cada trace aparece con su entrada, salida y contexto recuperado.
Esta vista de sesión te enseña exactamente lo que vivió el usuario. Si reporta un problema, no necesitas buscar entre traces sueltos: abres su sesión y ves el flujo completo.
Hasta ahora has rastreado sesiones, pero ¿y los usuarios? Las apps con LLM reales necesitan saber qué usuario hizo cada solicitud. Cuando alguien se registra, generas un ID único. Luego lo adjuntas a cada llamada al LLM que haga.
LangFuse permite agrupar traces por ID de usuario además del agrupado por sesión. Es otra forma de organizar tus datos de observabilidad.
Así añades el seguimiento de usuario. Crea user_tracking.py:
from build_chain import build_qa_chain
from langfuse.langchain import CallbackHandler

# Build the Q&A chain
qa_chain = build_qa_chain()

# Set up LangFuse handler
langfuse_handler = CallbackHandler()

# Simulate a new user asking a question
user_response = qa_chain.invoke(
   {"input": "What security controls are recommended for AI systems?"},
   config={
       "callbacks": [langfuse_handler],
       "metadata": {
           "langfuse_session_id": "conversation-003",
           "langfuse_user_id": "user-12345"
       }
   }
)
print(f"Response: {user_response['answer']}")
El campo langfuse_user_id etiqueta este trace con un ID de usuario. Ejecuta el script:
uv run python user_tracking.pyVerás algo como:
Response: The recommended security controls for AI systems include:

1. Adaptive defenses: Incorporate machine learning-powered filters that continuously learn and adapt to new adversarial techniques.
2. Defense-in-depth: Introduce layered security mechanisms, such as refusal classifiers and real-time input monitoring, to fortify AI system integrity.
3. Data classification: Properly classify your data according to sensitivity.
......
Ahora ve a tu panel de LangFuse. Haz clic en «Users» en la barra lateral, y verás user-12345 listado. Haz clic para ver todos sus traces en distintas sesiones.
Esta vista te ayuda a responder preguntas como «¿Cuánto nos costó el usuario X este mes?» o «¿Qué preguntas repite el usuario Y?». Puedes seguir el comportamiento individual y depurar problemas específicos.
Tu sistema de Q&A tiene un problema: el prompt está enterrado en el código. Para cambiar cómo responde el sistema, tienes que editar qa_chain.py, probar en local y desplegar. Si un compañero quiere probar otra variante, necesita entender tu estructura y crear una rama. No puedes comparar versiones de prompts en paralelo ni revertir a la versión de la semana pasada sin bucear en el historial de git.
La gestión de prompts lo soluciona almacenándolos fuera del código. Los editas en una interfaz, se versionan automáticamente y los obtienes en tiempo de ejecución. Tu código permanece igual mientras tus prompts mejoran.
Mira el prompt de tu cadena de Q&A:
prompt = ChatPromptTemplate.from_messages([
   ("system", "Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.\n\n{context}"),
   ("human", "{input}"),
])
Esto sirve para proyectos en solitario. Pero cuando trabajas en equipo o estás en producción, los prompts hardcoded traen problemas:
La gestión de prompts de LangFuse aborda estos problemas tratando los prompts como datos, no como código.
LangFuse guarda tus prompts en un lugar central con versionado automático. Puedes crearlos desde la interfaz o vía SDK.
Ve a tu panel de LangFuse y haz clic en «Prompts» en la barra lateral. Pulsa «New Prompt» para crear uno.
Verás un formulario donde puedes:
document-qa-prompt)text o chat){{variable}}production o staging)Para nuestro sistema de Q&A, crea un prompt de chat con dos mensajes:
Mensaje del sistema:
Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.

{{context}}
Mensaje del usuario:
{{input}}LangFuse detectará automáticamente las variables {{context}} y {{input}}.
Después, define la configuración:
{
 "model": "gpt-4",
 "temperature": 0.0
}
Añade la etiqueta production para marcarla como versión de producción.
Al guardar, LangFuse crea la versión 1 del prompt. Cada vez que edites y guardes, creará una versión nueva. Las anteriores siguen disponibles.
También puedes crear prompts con el SDK de Python:
from langfuse import Langfuse

langfuse = Langfuse()

langfuse.create_prompt(
   name="document-qa-prompt",
   type="chat",
   prompt=[
       {"role": "system", "content": "Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.\n\n{{context}}"},
       {"role": "user", "content": "{{input}}"}
   ],
   labels=["production"]
)
Esto crea el mismo prompt de forma programática. Si llamas a create_prompt() otra vez con el mismo nombre, LangFuse añade una versión nueva en lugar de sobrescribir.
LangFuse registra cada cambio con números de versión (v1, v2, v3). También puedes asignar etiquetas a versiones. Las etiquetas ayudan a gestionar despliegues:
production: la versión que usa tu app en producciónstaging: la versión en tu entorno de staginglatest: apunta automáticamente a la versión más recienteCuando mejores tu prompt, creas una versión nueva. Pruébala primero en staging dándole la etiqueta staging. Cuando funcione bien, mueve la etiqueta production a la nueva versión. Tu app en producción adoptará el cambio en la siguiente obtención del prompt.
La interfaz de LangFuse incluye un playground donde puedes probar prompts antes de usarlos en código. Puedes:
Así, personas no técnicas pueden experimentar con la redacción sin tocar código.
Así usas los prompts gestionados de LangFuse en tu aplicación. Este flujo mantiene tu código estable mientras los prompts evolucionan.
En tu código, obtén el prompt desde LangFuse en lugar de hardcodearlo:
from langfuse import Langfuse

langfuse = Langfuse()

# Get the production version
prompt = langfuse.get_prompt("document-qa-prompt", type="chat")
Esto recupera la versión etiquetada como production. LangFuse hace caché de los prompts en el cliente, así que no añade latencia a tus llamadas al LLM.
También puedes obtener versiones o etiquetas específicas:
# Get version 2 specifically
prompt = langfuse.get_prompt("document-qa-prompt", version=2, type="chat")

# Get staging version
prompt = langfuse.get_prompt("document-qa-prompt", label="staging", type="chat")

# Get latest version (automatically maintained by LangFuse)
prompt = langfuse.get_prompt("document-qa-prompt", label="latest", type="chat")El prompt obtenido es una plantilla con {{variables}}. Complílala sustituyendo variables por valores reales:
compiled_messages = prompt.compile(
   context="Retrieved document context goes here",
   input="What are the main security risks?"
)
Esto devuelve una lista de mensajes de chat lista para enviar al LLM:
[
   {
       "role": "system",
       "content": "Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.\n\nRetrieved document context goes here"
   },
   {
       "role": "user",
       "content": "What are the main security risks?"
   }
]Pasa los mensajes compilados a tu llamada al LLM. El código exacto depende de si usas LangChain, el SDK de OpenAI directamente u otro framework.
Cuando hagas una llamada al LLM con un prompt gestionado por LangFuse, vincúlala al trace. Así podrás ver qué versión de prompt se usó en cada llamada y seguir métricas por versión:
from langfuse.langchain import CallbackHandler

langfuse_handler = CallbackHandler()

response = qa_chain.invoke(
   {"input": "What are the main security risks?"},
   config={"callbacks": [langfuse_handler]}
)
En el panel de LangFuse verás los traces agrupados por nombre y versión de prompt. Así identificas qué versiones cuestan más, tardan más o dan mejores resultados.
Aquí es donde brilla la gestión de prompts. Para mejorar tu prompt:
staging para probar en stagingproduction para desplegarTu código no cambia. La próxima vez que llame a get_prompt(), obtendrá la versión nueva.
Si el prompt nuevo rinde peor, vuelve atrás moviendo la etiqueta production a la versión anterior. Sin desplegar código.
Este flujo separa el prompt engineering del software engineering. Tu equipo puede iterar rápido en prompts mientras el código de la app se mantiene estable.
Para saber más: LangFuse también admite tests A/B para dividir tráfico automáticamente entre versiones de prompt, webhooks que avisan cuando cambian los prompts y funciones de colaboración como comentarios y flujos de aprobación. Estas funciones ayudan a equipos grandes a gestionar prompts a escala. Consulta la documentación de gestión de prompts para más detalles.
Has creado un sistema de Q&A, añadido observabilidad y configurado la gestión de prompts. Pero ¿cómo sabes si las respuestas son buenas? Ahora mismo, seguramente pruebas a mano: haces una pregunta, lees la respuesta y juzgas. Sirve para unos pocos casos, pero no escala.
¿Qué pasa cuando cambias el prompt? Tienes que volver a probar todo. ¿Y los casos límite? No puedes recordar todas las preguntas que ya probaste. Y en producción, no hay forma de medir si la versión 2 del prompt rinde mejor que la 1.
La evaluación soluciona esto midiendo de forma sistemática el rendimiento de tu LLM. LangFuse te da herramientas para puntuar respuestas automáticamente, comparar versiones de prompts con métricas reales y detectar problemas de calidad antes de que afecten a los usuarios.
Las pruebas manuales te dicen si una respuesta concreta está bien. La evaluación sistemática te dice si todo tu sistema funciona bien en cientos o miles de ejemplos.
Así funciona la evaluación sistemática en LangFuse:
Este proceso sustituye «creo que este prompt es mejor» por «este prompt puntúa 0,85 en relevancia frente a 0,72 de la versión anterior».
Para una guía completa de enfoques de evaluación y cómo implementarlos en LangFuse, consulta la documentación de evaluación.
Necesitas puntuar cientos de respuestas. Hacerlo a mano lleva horas. LLM-as-a-judge lo automatiza usando otro LLM para calificar las salidas de tu LLM principal.
Le das al LLM juez tres cosas: la pregunta original, la respuesta de tu sistema de Q&A y los criterios de puntuación. El juez lee la respuesta y asigna una nota.
En un sistema de Q&A, te importan distintas dimensiones de calidad. Aquí tienes tres jueces posibles:
Juez de corrección: «Valora si la respuesta refleja correctamente la información del contexto proporcionado. Puntúa 1 si es completamente correcta, 0,5 si es parcialmente correcta, 0 si es incorrecta o inventada.»
Esto detecta respuestas que contradicen tus documentos o se las inventan.
Juez de relevancia: «Valora si la respuesta aborda directamente la pregunta. Puntúa 1 si es muy relevante, 0,5 si es algo relevante, 0 si está fuera de tema.»
Esto asegura que el sistema se mantenga en tema y no dé información precisa pero irrelevante.
Juez de fundamentación: «Valora si la respuesta se basa solo en el contexto proporcionado. Puntúa 1 si está totalmente fundamentada, 0,5 si lo está parcialmente, 0 si incluye información ajena al contexto.»
Esto previene alucinaciones donde el LLM añade datos no presentes en tus documentos.
Cada juez mira una dimensión concreta. Ejecutas los tres por respuesta y obtienes un perfil completo de calidad. Puedes añadir más jueces para estilo (¿es concisa?), tono (¿profesional?) o manejo de negativas (¿dice «no lo sé» cuando corresponde?).
LangFuse permite configurar LLM jueces desde la interfaz o la API. El proceso:
Los jueces se ejecutan de forma asíncrona, así que no ralentizan tu app principal. Revisa las puntuaciones en el panel de LangFuse cuando terminen las pruebas.
Los LLM jueces funcionan mejor para criterios subjetivos difíciles de medir con código: tono, relevancia, estilo. Son menos fiables para hechos objetivos. Si necesitas verificar «2+2=4», usa una comprobación determinista, no un juez.
En nuestro Q&A, funcionan bien para relevancia y fundamentación, pero puedes combinarlos con checks deterministas como «longitud < 100 palabras».
Los LLM jueces no son perfectos. Pueden discrepar entre sí, tener sesgos hacia ciertos estilos y equivocarse dando notas altas a respuestas seguras pero erróneas.
Mitígalo probando tus jueces con ejemplos de verdad conocida, usando múltiples jueces y promediando, y haciendo revisiones puntuales para detectar errores del juez.
Nota de implementación: Un flujo completo de evaluación implica preparar datasets, configurar jueces, ejecutar evaluaciones por lotes y analizar resultados. Requiere más preparación de la que cabe en este tutorial manteniéndolo práctico. La documentación de LLM-as-a-judge ofrece todos los detalles, con ejemplos de código y buenas prácticas. Para enfoques personalizados más allá de LLM jueces, consulta la guía de puntuaciones personalizadas.
El flujo que hemos descrito aquí te muestra la mentalidad de evaluación. Una vez que tienes traces y prompts gestionados en LangFuse, añadir evaluación sistemática sale natural. Construyes datasets poco a poco, empiezas con jueces simples y afinas conforme aprendes qué métricas importan para tu app.
Para saber más: LangFuse también soporta gestión de datasets para organizar casos de prueba, funciones de puntuación personalizadas para checks deterministas y evaluación continua que se ejecuta automáticamente sobre tráfico de producción. Estas funciones te ayudan a mantener la calidad a medida que tu sistema escala. Consulta la visión general de evaluación para verlo al completo.
Has creado un sistema de preguntas y respuestas sobre documentos y has aprendido cómo encajan los tres pilares de LangFuse. La observabilidad te mostró qué pasa cuando corre tu LLM: ves cada trace, cada coste, cada token. La gestión de prompts sacó los prompts del código a un sistema con versiones donde puedes iterar sin desplegar. La evaluación te dio formas de medir calidad de manera sistemática en lugar de adivinar. Todo se conecta: los traces alimentan datasets de evaluación, las versiones de prompts se vinculan a métricas de rendimiento y el sistema entero te ayuda a entender si los cambios mejoran o empeoran las cosas.
Empieza poco a poco en tus proyectos. Elige una función. Quizá añade trazado para ver dónde gasta tu app, o mueve un prompt hardcoded a la gestión de LangFuse. Los patrones que has visto con nuestro Q&A simple escalan a pipelines RAG complejos, sistemas multiagente y apps en producción con miles de usuarios. Revisa la documentación de LangFuse para profundizar en funciones concretas, o prueba los notebooks de ejemplo con implementaciones reales. La próxima vez que construyas con LLM, tendrás herramientas para ver qué pasa, controlar qué cambia y medir lo que importa.
Aprende con DataCamp
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Stanislav Karzhev
9 min
{count, plural, one {Tutorial} other {Tutoriales}}
Moez Ali
12 min
{count, plural, one {Tutorial} other {Tutoriales}}
Josep Ferrer
11 min
{count, plural, one {Tutorial} other {Tutoriales}}
Abid Ali Awan
12 min
{count, plural, one {Tutorial} other {Tutoriales}}
Ryan Ong
12 min