{count, plural, one {Kurs} other {Kurse}}
Konzepte großer Sprachmodelle (LLMs)
{hours} Std.
112.3K
LLM-Anwendungen zu bauen, wird schnell unübersichtlich. Du beginnst, Kosten zu schätzen. Debugging wird schwerer, wenn du nicht siehst, was passiert ist. Prompts verteilen sich über die gesamte Codebasis. LangFuse löst das mit einer Plattform, die alles nachverfolgt, Prompts verwaltet und Qualität misst.
In diesem Tutorial baust du ein Q&A-Tool für Dokumente und siehst, wie LangFuse deine Entwicklung organisiert. Du lernst, LLM-Aufrufe zum Debuggen zu tracen, Prompts mit Versionskontrolle zu managen und Evaluationsansätze zu erkunden.
LangFuse ist eine Open-Source-Plattform, mit der Teams bessere LLM-Anwendungen entwickeln. Während du Features baust, übernimmt LangFuse Monitoring, Testing und Debugging.
Die Plattform deckt drei Hauptbereiche ab:
Du willst LangFuse, sobald deine LLM-App über einfache Experimente hinauswächst. In diesen Situationen wird es wertvoll:
Wenn du nur schnell einen Prototyp oder ein persönliches Projekt baust, brauchst du es wahrscheinlich noch nicht. Aber sobald deine App echte Nutzer bedient oder dein Team größer wird als eine Person, wird LangFuse nützlich.
LangFuse funktioniert mit deinem bestehenden KI-Stack. Es integriert sich in gängige Frameworks wie LangChain, LlamaIndex, AutoGen und CrewAI. Du kannst es mit jedem Modellanbieter nutzen — OpenAI, Anthropic, Google Gemini, Mistral oder Hugging Face-Modelle laufen out of the box.
Die Plattform bietet native SDKs für Python und JavaScript sowie OpenTelemetry-Support für Custom-Setups. Egal ob du No-Code-Agent-Builder nutzt oder komplexe Multi-Agent-Frameworks einsetzt, LangFuse fügt sich ein, ohne deine Kernarchitektur zu verändern.
Unternehmen wie Samsara, Twilio und Khan Academy nutzen es produktiv, und es erfüllt Enterprise-Sicherheitsstandards. Das Projekt hat über 16.500 GitHub-Stars mit Y Combinator im Rücken. Du kannst die gehostete Version nutzen oder es in deiner eigenen Infrastruktur betreiben.
Jetzt, da du weißt, was LangFuse kann und wann es hilft, bauen wir etwas damit. Wie versprochen erstellen wir ein einfaches Dokument-Q&A-Tool, das alle drei Features in Aktion zeigt.
Du brauchst etwas Erfahrung mit Python und LLMs, bevor du in LangFuse einsteigst.
Must-have:
Nice-to-have:
Setup:
uv oder pip)Neu in der KI-Entwicklung? Starte zuerst mit unserem kompletten KI-Lernleitfaden.
Für Kontext, wo LangFuse im Ökosystem einzuordnen ist, lies unsere Übersicht zu LLMOps-Tools.
Jetzt bauen wir etwas. Wir starten mit einer einfachen Dokument-Q&A-Funktion und sehen, wie LangFuse den Ablauf beim Ausführen nachverfolgt. Dieses Basisbeispiel zeigt dir die drei Hauptfunktionen — Observability, Prompt-Management und Evaluation — in einer Form, die auf komplexere Projekte skaliert.
Du baust ein simples Q&A-System, das Fragen aus einem PDF beantwortet. So hast du etwas Reales zum Tracen, Managen und Evaluieren. Auch wenn das Beispiel einfach ist, funktionieren dieselben Muster für komplexe RAG-Systeme und Multi-Agent-Workflows.
Erstelle zuerst ein Projektverzeichnis und installiere die benötigten Pakete:
mkdir langfuse-qa-demo
cd langfuse-qa-demo
uv add langfuse langchain langchain-openai langchain-community pypdf python-dotenv
Registriere dich für ein kostenloses LangFuse-Cloud-Konto auf langfuse.com. Erstelle nach dem Login eine neue Organisation und ein Projekt. Du siehst einen Bildschirm mit deinen API-Schlüsseln:
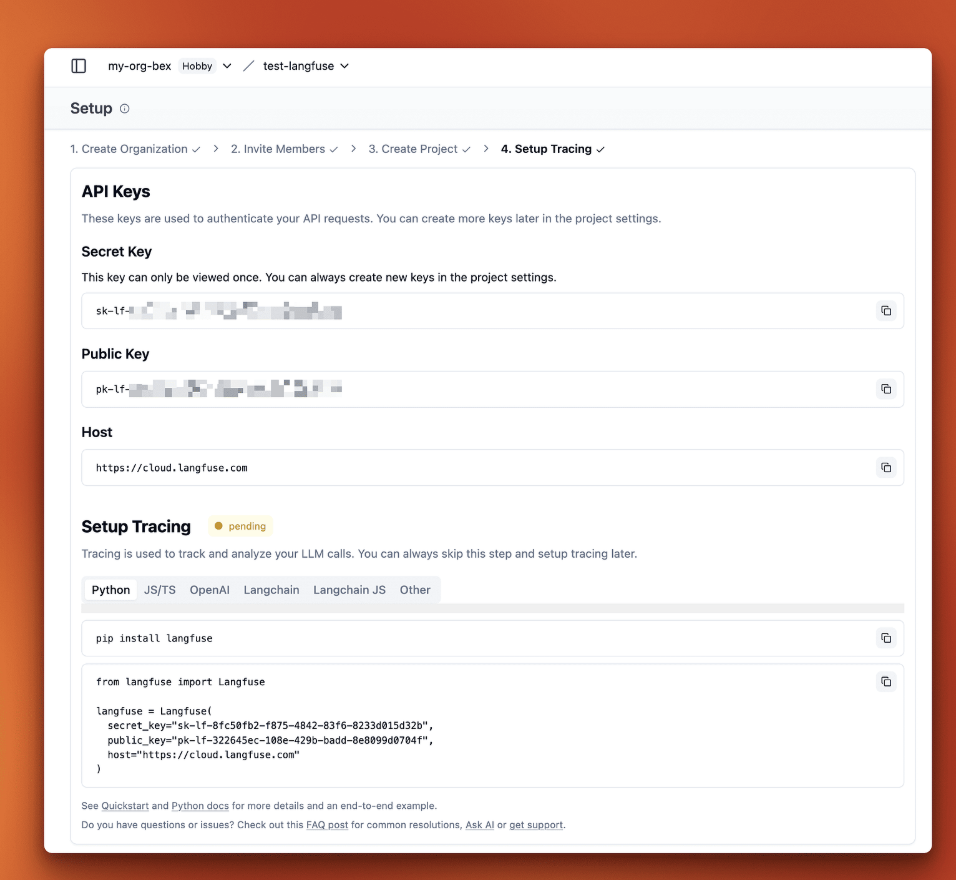
Kopiere deinen Public Key und Secret Key. Du brauchst außerdem deinen OpenAI-API-Schlüssel von platform.openai.com.
Erstelle nun eine .env-Datei in deinem Projektverzeichnis:
OPENAI_API_KEY=your_openai_key_here
LANGFUSE_PUBLIC_KEY=pk-lf-...
LANGFUSE_SECRET_KEY=sk-lf-...
LANGFUSE_HOST=https://cloud.langfuse.com
Wenn du LangFuse lieber selbst betreiben möchtest, kannst du für lokale Tests Docker Compose verwenden. Die Self-Hosting-Anleitung führt durch das Setup von PostgreSQL, ClickHouse und den LangFuse-Services. Für produktive Deployments nutze Kubernetes oder Cloud-spezifische Terraform-Templates.
Du baust eine Retrieval-Chain, die ein PDF lädt, in Chunks splittet, in einem Vektorspeicher ablegt und Fragen auf Basis des gefundenen Kontexts beantwortet.
Erstelle eine Datei namens qa_chain.py:
from langchain_community.document_loaders import PyPDFLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_core.vectorstores import InMemoryVectorStore
from langchain.chains import create_retrieval_chain
from langchain.chains.combine_documents import create_stuff_documents_chain
from langchain_core.prompts import ChatPromptTemplate
from dotenv import load_dotenv

load_dotenv()
Das importiert alles Nötige. Der Aufruf load_dotenv() lädt deine API-Schlüssel aus der .env-Datei.
# Load and split PDF
loader = PyPDFLoader("ai-security-landscape.pdf")
docs = loader.load()

text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
splits = text_splitter.split_documents(docs)
Hier laden wir das Dokument ai-security-landscape.pdf, eines der Whitepaper von Amazon Web Services. Um das Beispiel auszuführen, musst du die Datei selbst herunterladen und mit dem korrekten Namen in dein Arbeitsverzeichnis legen.
Der PyPDFLoader liest das PDF, und der RecursiveCharacterTextSplitter zerlegt es in 1000-Zeichen-Chunks mit 200 Zeichen Überlappung. Die Überlappung hilft, Kontext über Chunk-Grenzen hinweg zu erhalten.
Erstelle als Nächstes den Vektorspeicher:
# Create vector store
embeddings = OpenAIEmbeddings()
vectorstore = InMemoryVectorStore.from_documents(documents=splits, embedding=embeddings)
InMemoryVectorStore speichert Dokument-Embeddings im Speicher. Im Produktivbetrieb würdest du Pinecone, Weaviate oder eine andere Vektordatenbank nutzen.
Baue nun die QA-Chain:
# Build QA chain
llm = ChatOpenAI(model="gpt-4")
prompt = ChatPromptTemplate.from_messages([
   ("system", "Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.\n\n{context}"),
   ("human", "{input}"),
])

question_answer_chain = create_stuff_documents_chain(llm, prompt)
qa_chain = create_retrieval_chain(vectorstore.as_retriever(), question_answer_chain)
create_stuff_documents_chain nimmt die gefundenen Dokumente und „stopft“ sie in den Prompt-Kontext. create_retrieval_chain kombiniert Retrieval und Beantwortung in einer Chain.
Mit der fertigen Chain verbinden wir sie jetzt mit LangFuse fürs Tracing.
Füge dem Skript einen LangFuse-Callback-Handler hinzu:
from langfuse.langchain import CallbackHandler

langfuse_handler = CallbackHandler()

response = qa_chain.invoke(
   {"input": "What are the main security risks discussed?"},
   config={"callbacks": [langfuse_handler]}
)

print(response["answer"])
The main security risks discussed in relation to generative artificial intelligence (AI) are context window overflow, agent mismanagement, indirect prompt injections and data leaks from overprivileged agents, logging, and caching.
Trace sent to LangFuse! Check your dashboard at https://cloud.langfuse.comWenn du das ausführst, erfasst LangFuse den kompletten Execution-Trace. Wechsle zu deinem LangFuse-Dashboard, und du siehst neue Details:
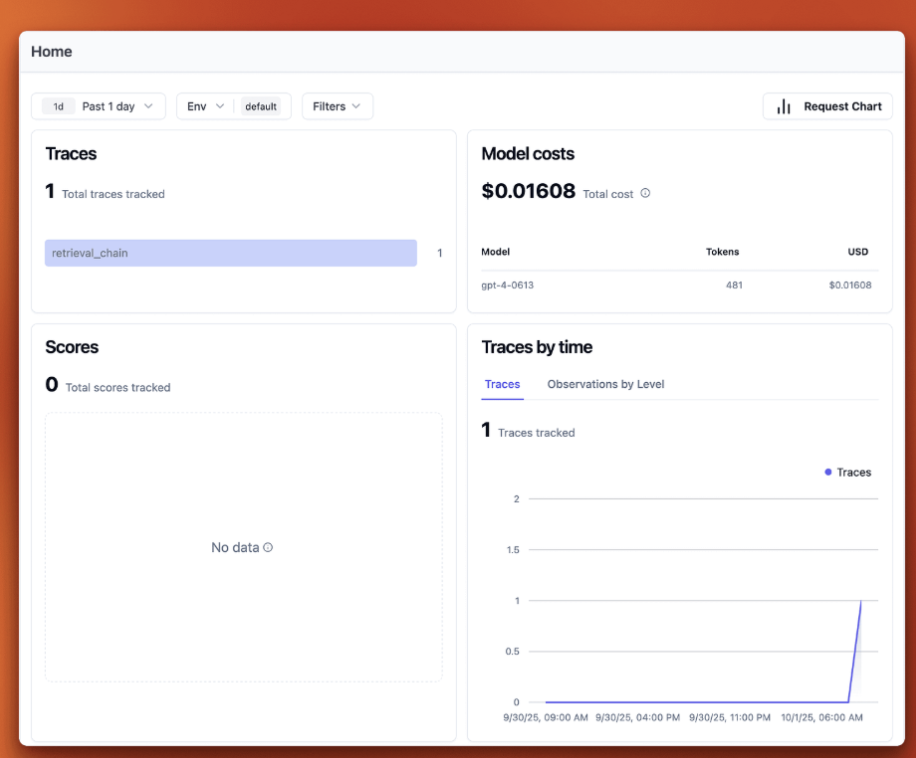
Beachte: Auch wenn wir hier ein einfaches Beispiel nutzen, funktioniert LangFuse mit komplexen RAG-Pipelines, die mehrere Dokumenttypen verarbeiten, Re-Ranking einsetzen oder mehrere Retrieval-Strategien parallel fahren.
Mit deinem laufenden Q&A-System und aktivem LangFuse-Tracing bist du bereit zu verstehen, was LangFuse erfasst und wie du diese Informationen zur Verbesserung deiner Anwendung nutzt.
Du hast gerade einen Trace an LangFuse gesendet. Schauen wir uns an, was dir das bringt und warum es wichtig ist.
Klassisches Logging funktioniert für LLM-Apps nur bedingt. Du kannst loggen, dass eine Funktion lief, aber nicht, was dein Modell wirklich mit der Nutzereingabe gemacht hat. Wurden die richtigen Dokumente gefunden? War der Prompt korrekt formatiert? Welcher Schritt hat fünf Sekunden gedauert?
LLM-Observability verfolgt den gesamten Ausführungspfad. Du siehst jeden Input, Output und Zwischenschritt. Meldet ein Nutzer falsche Antworten, rufst du seinen Trace auf und siehst genau, was passiert ist. Du rätst nicht. Du weißt es.
Das ist umso wichtiger, je komplexer deine App wird. Eine einfache Q&A-Chain hat 4–5 Schritte. Produktive RAG-Systeme haben Document Loader, Chunking-Strategien, mehrere Retriever, Re-Ranker und Generierungsschritte. Ohne Observability wird Debugging unmöglich. Mit Observability findest du die Ursache.
Öffne dein LangFuse-Dashboard und klicke in der linken Sidebar auf „Tracing“. Du siehst deinen ersten Trace in einer Tabelle.
Die Tabelle zeigt, wann der Trace lief, wie er hieß (retrieval_chain) und welche Ein- und Ausgaben es gab. Jede Zeile ist eine vollständige Ausführung deiner Q&A-Chain.
Klicke auf den Trace, um die Details zu sehen. Du erhältst eine detaillierte Aufschlüsselung.
Links siehst du den Ausführungsbaum. LangFuse hat jeden Schritt deiner Chain erfasst. Die Wurzel retrieval_chain dauerte insgesamt 4,75 Sekunden. Darunter siehst du jede Operation: Dokumenten-Retrieval (retrieve_documents), Vektorsuche (VectorStoreRetriever) und Antwortgenerierung (stuff_documents_chain). Jeder Schritt zeigt seine Laufzeit.
Diese Hierarchie zeigt dir, wo deine Chain Zeit verbraucht. Wenn deine App langsam ist, erkennst du, ob es am Embedding-Lookup, der Vektorsuche oder dem LLM-Call liegt.
Rechts siehst du die Trace-Daten. Oben stehen die wichtigsten Kennzahlen: Latenz (4,75s), Kosten (~$0,016) und Tokens (426 Input, 55 Output). Darunter siehst du den tatsächlichen Input und Output. Der Abschnitt context zeigt die vier Dokument-Chunks, die dein Retriever aus dem Vektorspeicher geholt hat.
Unten hilft ein Flow-Diagramm beim Verständnis, wie deine Chain die Schritte verbindet. Das ist nützlich beim Debuggen komplexer Chains mit Verzweigungen.
Kommen wir zu Sessions. Ein Trace erfasst einen Frage-und-Antwort-Zyklus. In echten Apps gibt es Unterhaltungen. Ein Nutzer stellt vielleicht drei verwandte Fragen zu Sicherheitsrisiken. Diese Traces willst du zusammenfassen.
Genau das machen Sessions. Sie bündeln mehrere Traces zu einem Gesprächs-Thread. Meldet ein Nutzer einen Bug, rufst du seine gesamte Session auf und siehst jede Frage und jede Antwort.
Sehen wir uns das an. Erstelle zuerst eine Hilfsdatei build_chain.py, die deine Chain-Erstellung kapselt:
from langchain_community.document_loaders import PyPDFLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_core.vectorstores import InMemoryVectorStore
from langchain.chains import create_retrieval_chain
from langchain.chains.combine_documents import create_stuff_documents_chain
from langchain_core.prompts import ChatPromptTemplate
from dotenv import load_dotenv

load_dotenv()

def build_qa_chain():
   # Load and split PDF
   loader = PyPDFLoader("ai-security-landscape.pdf")
   docs = loader.load()

   text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
   splits = text_splitter.split_documents(docs)

   # Create vector store
   embeddings = OpenAIEmbeddings()
   vectorstore = InMemoryVectorStore.from_documents(documents=splits, embedding=embeddings)

   # Build QA chain
   llm = ChatOpenAI(model="gpt-4")
   prompt = ChatPromptTemplate.from_messages([
       ("system", "Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.\n\n{context}"),
       ("human", "{input}"),
   ])

   question_answer_chain = create_stuff_documents_chain(llm, prompt)
   qa_chain = create_retrieval_chain(vectorstore.as_retriever(), question_answer_chain)

   return qa_chain
Das kapselt alles in einer Funktion zum Importieren. Erstelle nun sessions_demo.py:
from build_chain import build_qa_chain
from langfuse.langchain import CallbackHandler

# Build the Q&A chain
qa_chain = build_qa_chain()

# Set up LangFuse handler
langfuse_handler = CallbackHandler()
This imports your chain and sets up the LangFuse handler. Now add session tracking for the first conversation:
# Session 1: User asking about security risks
response1 = qa_chain.invoke(
   {"input": "What are the main security risks discussed?"},
   config={
       "callbacks": [langfuse_handler],
       "metadata": {"langfuse_session_id": "conversation-001"}
   }
)
print(f"Q1: {response1['answer']}\n")
Das metadata-Feld mit langfuse_session_id markiert diesen Trace mit einer Session-ID. Führe das aus und du siehst:
Q1: The main security risks discussed are context window overflow, agent mismanagement, and indirect prompt injections.Füge nun eine Rückfrage mit derselben Session-ID hinzu:
response2 = qa_chain.invoke(
   {"input": "How can these risks be mitigated?"},
   config={
       "callbacks": [langfuse_handler],
       "metadata": {"langfuse_session_id": "conversation-001"}
   }
)
print(f"Q2: {response2['answer']}\n")
Diese zweite Frage gehört zur gleichen Unterhaltung und nutzt daher erneut conversation-001. Du siehst eine längere Antwort:
Q2: Risks can be mitigated through several strategies including:
1. Input Management: Limit and sanitize inputs going into the model.
2. Real-time Monitoring: Use systems that alert when the context window is nearing capacity.
3. Principle of Least Privilege: Implement this for all agents and external integrations.
....
Simuliere nun einen zweiten Nutzer mit anderen Fragen. Ergänze dein Skript:
# Session 2: Different user asking about AI applications
response3 = qa_chain.invoke(
   {"input": "What AI applications are mentioned in the document?"},
   config={
       "callbacks": [langfuse_handler],
       "metadata": {"langfuse_session_id": "conversation-002"}
   }
)
print(f"Q3: {response3['answer']}\n")

response4 = qa_chain.invoke(
   {"input": "What are the benefits of these applications?"},
   config={
       "callbacks": [langfuse_handler],
       "metadata": {"langfuse_session_id": "conversation-002"}
   }
)
print(f"Q4: {response4['answer']}\n")
Diese beiden Fragen nutzen conversation-002. Führe das komplette Skript aus:
uv run python sessions_demo.pyDie letzten beiden Ausgaben sind:
Q3: The document does not specifically mention any AI applications. However, it discusses the concept of generative AI and its security considerations.

Q4: The context does not provide specific benefits of these applications.
Wechsle nun in deinem LangFuse-Dashboard zur linken Sidebar und klicke auf „Sessions“. Du siehst beide Unterhaltungen gelistet:
Es erscheinen zwei Sessions: conversation-002 (~4 Sekunden Dauer) und conversation-001 (~14 Sekunden Dauer). LangFuse hat deine Traces per Session-ID gruppiert.
Klicke auf conversation-001, um die gesamte Unterhaltung zu sehen:
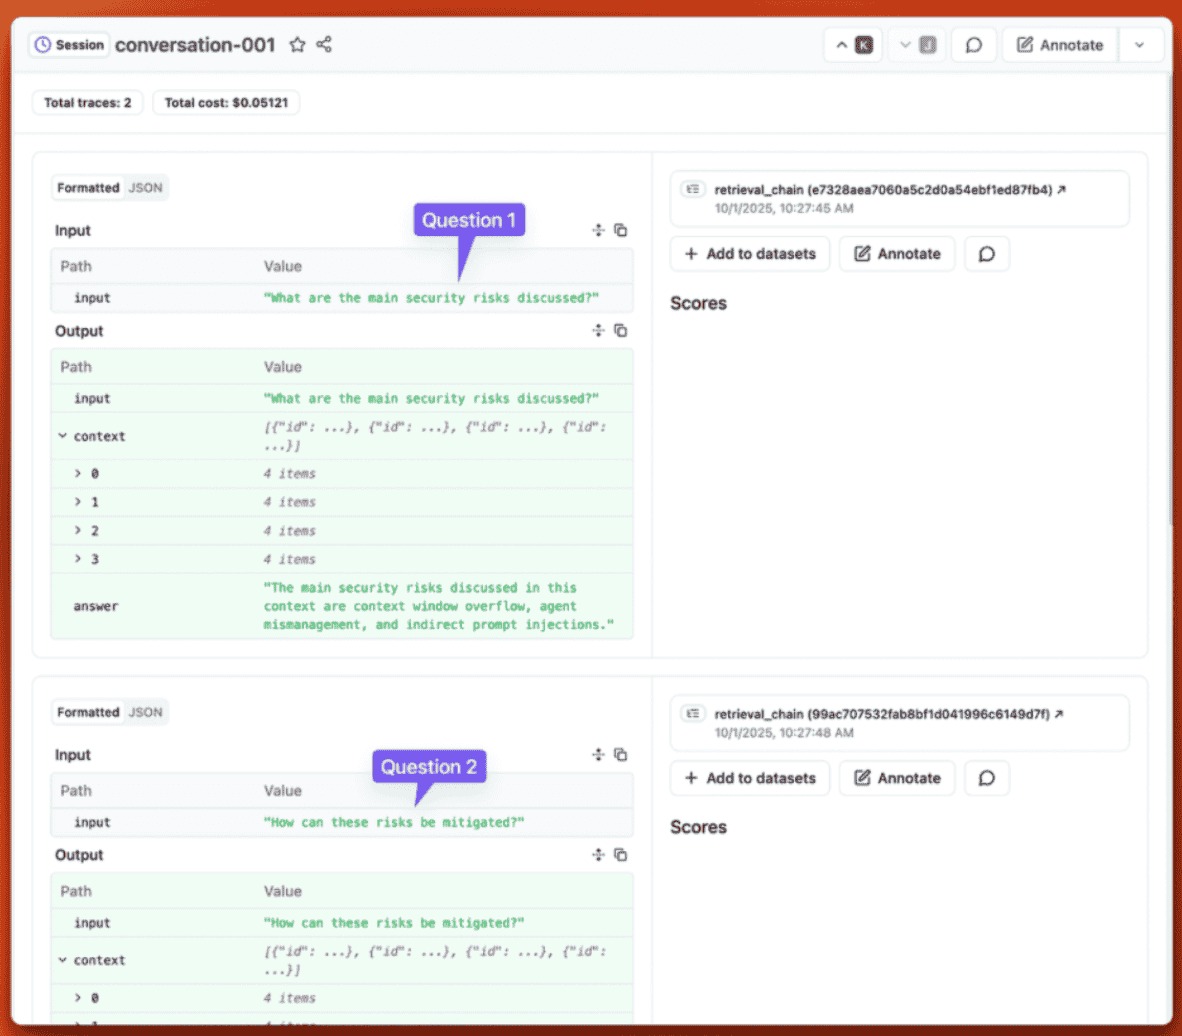
Du siehst beide Traces in Reihenfolge: Frage 1 zu Risiken, Frage 2 zu Gegenmaßnahmen. Die Session zeigt Gesamtkosten ($0,05121 für beide Traces) und Gesamtdauer (14 Sekunden). Jeder Trace erscheint mit Input, Output und gezogenem Kontext.
Diese Session-Ansicht zeigt dir genau, was ein Nutzer erlebt hat. Meldet er ein Problem, musst du nicht einzelne Traces durchsuchen. Du öffnest seine Session und siehst den gesamten Gesprächsverlauf.
Bisher hast du Sessions getrackt, aber was ist mit einzelnen Nutzern? Echte LLM-Apps müssen wissen, welcher Nutzer welche Anfrage gestellt hat. Beim Signup erzeugst du eine eindeutige ID und hängst sie an jeden LLM-Call an.
LangFuse erlaubt dir, Traces zusätzlich nach Nutzer-ID zu gruppieren. Das gibt dir eine weitere Ebene zur Organisation deiner Observability-Daten.
So fügst du User-Tracking hinzu. Erstelle user_tracking.py:
from build_chain import build_qa_chain
from langfuse.langchain import CallbackHandler

# Build the Q&A chain
qa_chain = build_qa_chain()

# Set up LangFuse handler
langfuse_handler = CallbackHandler()

# Simulate a new user asking a question
user_response = qa_chain.invoke(
   {"input": "What security controls are recommended for AI systems?"},
   config={
       "callbacks": [langfuse_handler],
       "metadata": {
           "langfuse_session_id": "conversation-003",
           "langfuse_user_id": "user-12345"
       }
   }
)
print(f"Response: {user_response['answer']}")
Das Feld langfuse_user_id markiert diesen Trace mit einer Nutzer-ID. Führe das Skript aus:
uv run python user_tracking.pyDu siehst:
Response: The recommended security controls for AI systems include:

1. Adaptive defenses: Incorporate machine learning-powered filters that continuously learn and adapt to new adversarial techniques.
2. Defense-in-depth: Introduce layered security mechanisms, such as refusal classifiers and real-time input monitoring, to fortify AI system integrity.
3. Data classification: Properly classify your data according to sensitivity.
......
Wechsle nun im LangFuse-Dashboard zur linken Sidebar und klicke auf „Users“. Du siehst user-12345 gelistet. Klicke auf den Nutzer, um alle seine Traces über Sessions hinweg zu sehen.
Diese Nutzeransicht hilft dir bei Fragen wie „Wie viel hat Nutzer X uns diesen Monat gekostet?“ oder „Welche Fragen stellt Nutzer Y immer wieder?“. Du kannst Verhalten einzelner Nutzer tracken und nutzerspezifische Probleme debuggen.
Dein Q&A-System hat ein Problem. Der Prompt steckt im Code. Um das Antwortverhalten zu ändern, musst du qa_chain.py editieren, lokal testen und neu deployen. Will ein Teamkollege eine andere Variante probieren, muss er deine Code-Struktur verstehen und einen Branch anlegen. Du kannst Prompt-Versionen nicht nebeneinander vergleichen oder auf letzte Woche zurückrollen, ohne im Git-Verlauf zu graben.
Prompt-Management löst das, indem es Prompts außerhalb deines Codes speichert. Du bearbeitest sie in einer UI, versionierst automatisch und holst sie zur Laufzeit. Dein Code bleibt gleich, während deine Prompts besser werden.
Sieh dir den Prompt in deiner Q&A-Chain an:
prompt = ChatPromptTemplate.from_messages([
   ("system", "Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.\n\n{context}"),
   ("human", "{input}"),
])
Für Solo-Projekte ist das okay. In Teamarbeit oder im Produktivbetrieb sorgen hardcodierte Prompts jedoch für Probleme:
LangFuse löst das, indem Prompts wie Daten statt wie Code behandelt werden.
LangFuse speichert deine Prompts zentral mit automatischer Versionierung. Du kannst sie in der UI oder per SDK anlegen.
Gehe im LangFuse-Dashboard links auf „Prompts“. Klicke auf „New Prompt“, um einen zu erstellen.
Du siehst ein Formular, in dem du Folgendes festlegst:
document-qa-prompt)text oder chat){{variable}}-Syntaxproduction oder staging)Für unser Q&A-System erstellst du einen Chat-Prompt mit zwei Nachrichten:
System-Nachricht:
Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.

{{context}}
User-Nachricht:
{{input}}LangFuse erkennt die Variablen {{context}} und {{input}} automatisch.
Setze dann die Konfiguration auf:
{
 "model": "gpt-4",
 "temperature": 0.0
}
Füge das Label production hinzu, um diese Version als produktiv zu markieren.
Nach dem Speichern erstellt LangFuse Version 1 deines Prompts. Jedes Bearbeiten und Speichern erzeugt eine neue Version. Alte Versionen bleiben verfügbar.
Du kannst Prompts auch mit dem Python-SDK erstellen:
from langfuse import Langfuse

langfuse = Langfuse()

langfuse.create_prompt(
   name="document-qa-prompt",
   type="chat",
   prompt=[
       {"role": "system", "content": "Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.\n\n{{context}}"},
       {"role": "user", "content": "{{input}}"}
   ],
   labels=["production"]
)
Damit erstellst du denselben Prompt programmatisch. Wenn du create_prompt() erneut mit dem gleichen Namen aufrufst, legt LangFuse eine neue Version an, statt zu überschreiben.
LangFuse verfolgt jede Prompt-Änderung mit Versionsnummern (v1, v2, v3). Zusätzlich kannst du Versionen Labels zuweisen. Labels helfen dir beim Deployment:
production – Die Version, die deine Produktionsapp nutztstaging – Die Version in deiner Staging-Umgebunglatest – Verweist automatisch auf die neueste VersionWenn du deinen Prompt verbesserst, erstellst du eine neue Version. Teste sie zuerst im Staging, indem du das Label staging vergibst. Läuft alles gut, verschiebst du das Label production auf die neue Version. Deine Produktionsapp übernimmt die Änderung automatisch beim nächsten Prompt-Fetch.
Die LangFuse-UI enthält einen Playground, in dem du Prompts vor dem Einsatz im Code testen kannst. Du kannst:
So können auch Nicht-Techniker mit Formulierungen experimentieren, ohne Code zu berühren.
So nutzt du von LangFuse verwaltete Prompts in deiner Anwendung. Dieser Workflow hält deinen Code stabil, während sich deine Prompts weiterentwickeln.
Hole in deinem Anwendungscode den Prompt aus LangFuse statt ihn zu hardcoden:
from langfuse import Langfuse

langfuse = Langfuse()

# Get the production version
prompt = langfuse.get_prompt("document-qa-prompt", type="chat")
Dies lädt die Version mit dem Label production. LangFuse cached Prompts clientseitig, daher entsteht keine zusätzliche Latenz bei deinen LLM-Aufrufen.
Du kannst auch spezifische Versionen oder Labels abrufen:
# Get version 2 specifically
prompt = langfuse.get_prompt("document-qa-prompt", version=2, type="chat")

# Get staging version
prompt = langfuse.get_prompt("document-qa-prompt", label="staging", type="chat")

# Get latest version (automatically maintained by LangFuse)
prompt = langfuse.get_prompt("document-qa-prompt", label="latest", type="chat")Der geholte Prompt ist eine Vorlage mit {{variables}}. Kompiliere ihn, indem du Variablen mit Werten ersetzt:
compiled_messages = prompt.compile(
   context="Retrieved document context goes here",
   input="What are the main security risks?"
)
Das ergibt eine Liste von Chat-Nachrichten, die du direkt an dein LLM senden kannst:
[
   {
       "role": "system",
       "content": "Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.\n\nRetrieved document context goes here"
   },
   {
       "role": "user",
       "content": "What are the main security risks?"
   }
]Übergebe die kompilierten Nachrichten an deinen LLM-Aufruf. Der genaue Code hängt davon ab, ob du LangChain, direkt das OpenAI-SDK oder ein anderes Framework nutzt.
Wenn du einen LLM-Aufruf mit einem von LangFuse verwalteten Prompt machst, verknüpfe ihn mit dem Trace. So siehst du, welche Prompt-Version für jeden LLM-Aufruf genutzt wurde, und kannst Metriken pro Prompt-Version tracken:
from langfuse.langchain import CallbackHandler

langfuse_handler = CallbackHandler()

response = qa_chain.invoke(
   {"input": "What are the main security risks?"},
   config={"callbacks": [langfuse_handler]}
)
Im LangFuse-Dashboard siehst du Traces gruppiert nach Prompt-Name und -Version. So erkennst du, welche Versionen teurer sind, langsamer laufen oder bessere Ergebnisse liefern.
Hier zahlt sich Prompt-Management aus. So verbesserst du deinen Prompt:
staging für Tests in Stagingproduction für den RolloutDein Code bleibt unverändert. Beim nächsten get_prompt() holt er die neue Version.
Läuft die neue Prompt-Version schlechter, rollst du zurück, indem du das Label production wieder auf die vorherige Version setzt. Ohne Code-Deployment.
Dieser Workflow trennt Prompt Engineering von Software-Engineering. Dein Team kann Prompts schnell iterieren, während dein Anwendungscode stabil bleibt.
Weiterführende Inhalte: LangFuse unterstützt außerdem A/B-Tests zur automatischen Traffic-Aufteilung zwischen Prompt-Versionen, Webhooks zur Benachrichtigung bei Prompt-Änderungen und Teamfunktionen wie Kommentare und Freigabe-Workflows. Diese Features helfen größeren Teams beim Prompt-Management in der Breite. Siehe die Prompt-Management-Dokumentation für Details.
Du hast ein Q&A-System gebaut, Observability hinzugefügt und Prompt-Management eingerichtet. Aber woher weißt du, ob die Antworten gut sind? Wahrscheinlich testest du bisher manuell: Frage stellen, Antwort lesen, Urteil fällen. Das klappt für ein paar Beispiele, skaliert aber nicht.
Was passiert, wenn du den Prompt änderst? Du musst alles neu testen. Was ist mit Edge Cases? Du erinnerst dich nicht an jede Frage, die du je getestet hast. Und in Produktion kannst du nicht messen, ob Version 2 deines Prompts besser abschneidet als Version 1.
Evaluation löst das, indem sie die Leistung deines LLMs systematisch misst. LangFuse liefert Tools, um Antworten automatisch zu bewerten, Prompt-Versionen mit echten Metriken zu vergleichen und Qualitätsprobleme zu erkennen, bevor Nutzer sie sehen.
Manuelle Tests sagen dir, ob eine konkrete Antwort passt. Systematische Evaluation sagt dir, ob dein gesamtes System über Hunderte oder Tausende Beispiele gut funktioniert.
So funktioniert systematische Evaluation in LangFuse:
So ersetzt du „Ich glaube, dieser Prompt ist besser“ durch „Dieser Prompt erreicht 0,85 Relevanz gegenüber 0,72 zuvor.“
Für einen vollständigen Leitfaden zu Evaluationsansätzen und deren Umsetzung in LangFuse, siehe die Evaluation-Overview-Dokumentation.
Du musst Hunderte Antworten scoren. Manuell kostet das Stunden. LLM-as-a-Judge automatisiert das, indem ein weiteres LLM die Ausgaben deines Haupt-LLMs bewertet.
Du gibst dem Bewertungs-LLM drei Dinge: die ursprüngliche Frage, die Antwort deines Q&A-Systems und Bewertungskriterien. Der „Judge“ liest die Antwort und vergibt einen Score.
Für ein Q&A-System zählen verschiedene Qualitätsdimensionen. Hier sind drei mögliche Judges:
Correctness Judge: „Bewerte, ob diese Antwort die Informationen im bereitgestellten Kontext korrekt widerspiegelt. Score 1 bei vollständig korrekt, 0,5 bei teilweise korrekt, 0 bei falsch oder halluziniert.“
Damit fängst du Antworten ab, die deinen Dokumenten widersprechen oder Dinge erfinden.
Relevance Judge: „Bewerte, ob diese Antwort die gestellte Frage direkt adressiert. Score 1 bei hoher Relevanz, 0,5 bei teilweiser Relevanz, 0 wenn off-topic.“
So stellst du sicher, dass das System beim Thema bleibt, statt korrekte, aber irrelevante Infos zu liefern.
Groundedness Judge: „Bewerte, ob die Antwort ausschließlich auf dem bereitgestellten Kontext basiert. Score 1 bei vollständig im Kontext verankert, 0,5 bei teilweise verankert, 0 wenn Infos außerhalb des Kontexts enthalten sind.“
So verhinderst du Halluzinationen, bei denen das LLM Fakten ergänzt, die nicht in den Dokumenten stehen.
Jeder Judge betrachtet eine spezifische Dimension. Du lässt alle drei auf jede Antwort laufen und bekommst ein vollständiges Qualitätsprofil. Optional ergänzt du weitere Judges für Stil (ist es prägnant?), Ton (professionell?) oder Umgang mit Nichtwissen (sagt es „Ich weiß es nicht“, wenn angebracht?).
In LangFuse konfigurierst du LLM-Judges per UI oder API. Der Ablauf:
Die Judges laufen asynchron und verlangsamen deine Hauptanwendung nicht. Du prüfst die Scores im LangFuse-Dashboard, sobald die Tests fertig sind.
LLM-Judges eignen sich besonders für subjektive Kriterien, die sich schwer deterministisch messen lassen: Ton, Relevanz, Stil. Für objektive Fakten sind sie weniger verlässlich. Wenn du „2+2=4“ prüfen willst, nutze einen deterministischen Check statt eines Judges.
Für unser Q&A-System sind Judges für Relevanz und Groundedness sinnvoll. Ergänze sie ggf. um deterministische Checks wie „Antwortlänge unter 100 Wörtern“.
LLM-Judges sind nicht perfekt. Sie können uneins sein, bestimmte Antwortstile bevorzugen und sich irren, indem sie selbstbewusst klingenden, aber falschen Antworten hohe Scores geben.
Dem begegnest du, indem du sie an Beispielen mit bekanntem Score testest, mehrere Judges nutzt und ihre Scores mittelt sowie Stichproben prüfst, um Fehler zu erkennen.
Hinweis zur Umsetzung: Vollständige Evaluations-Workflows umfassen das Aufsetzen von Datensätzen, die Konfiguration von Judges, Batch-Evaluierungen und Ergebnisanalysen. Das erfordert mehr Setup, als wir in diesem praktischen Tutorial abdecken können. Die LLM-as-a-Judge-Dokumentation liefert vollständige Details inkl. Codebeispielen und Best Practices. Für eigene Scoring-Ansätze jenseits von LLM-Judges siehe den Leitfaden für Custom Scores.
Der hier skizzierte Workflow zeigt dir die Evaluations-Denkweise. Hast du Traces und Prompt-Management in LangFuse, folgt die systematische Evaluation ganz natürlich. Du baust schrittweise Testsätze auf, startest mit einfachen Judges und verfeinerst, sobald klar ist, welche Metriken für deine App zählen.
Weiterführende Inhalte: LangFuse unterstützt zudem Dataset-Management zur Organisation von Testfällen, Custom-Scoring-Funktionen für deterministische Checks und Continuous Evaluation, die automatisch auf Produktionstraffic läuft. Diese Features helfen dir, Qualität beim Skalieren zu sichern. Siehe die Evaluation-Übersicht für das Gesamtbild.
Du hast ein Dokument-Q&A-System gebaut und gelernt, wie die drei Säulen von LangFuse zusammenspielen. Observability zeigt dir, was passiert, wenn dein LLM läuft. Du siehst jeden Trace, jede Kostenposition, jedes Token. Prompt-Management holt Prompts aus dem Code in ein versionskontrolliertes System, in dem du ohne Deployments iterierst. Evaluation gibt dir Wege, Qualität systematisch statt gefühlt zu messen. Diese Funktionen greifen ineinander: Traces speisen Evaluationsdatensätze, Prompt-Versionen sind mit Performance-Metriken verknüpft, und das ganze System zeigt dir, ob Änderungen wirklich verbessern oder verschlechtern.
Starte klein in deinen Projekten. Wähle ein Feature. Vielleicht Tracing, um zu sehen, wo deine App Geld ausgibt, oder verschiebe einen hardcodierten Prompt ins LangFuse-Management. Die Muster aus unserem einfachen Q&A-Beispiel skalieren auf komplexe RAG-Pipelines, Multi-Agent-Systeme und produktive Anwendungen mit Tausenden Nutzern. Sieh dir die LangFuse-Dokumentation für Deep Dives in einzelne Features an oder probiere die Beispiel-Notebooks mit realen Implementierungen. Beim nächsten LLM-Projekt hast du die Tools, um zu sehen, was passiert, zu steuern, was sich ändert, und zu messen, was zählt.
Lerne mit DataCamp
{count, plural, one {Kurs} other {Kurse}}
{count, plural, one {Kurs} other {Kurse}}
{count, plural, one {Kurs} other {Kurse}}
{count, plural, one {Blog} other {Blogs}}
{count, plural, one {Blog} other {Blogs}}
Hesam Sheikh Hassani
15 Min.
{count, plural, one {Tutorial} other {Tutorials}}
Mark Pedigo
10 Min.
{count, plural, one {Tutorial} other {Tutorials}}
Sejal Jaiswal
24 Min.
{count, plural, one {Tutorial} other {Tutorials}}
Matt Crabtree
5 Min.
{count, plural, one {Tutorial} other {Tutorials}}
Josef Waples
8 Min.


