

कोर्स
Large Language Models (LLMs) कॉन्सेप्ट्स
2 घंटा
113K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंLLM एप्लिकेशन बनाना बहुत जल्दी बेतरतीब हो सकता है। आप लागत का अनुमान लगाने लगते हैं। जब आप नहीं देख पाते कि क्या हुआ, तो विफलताओं को डिबग करना कठिन हो जाता है। प्रॉम्प्ट्स आपके कोडबेस में इधर-उधर बिखर जाते हैं। LangFuse इसे एक ऐसे प्लेटफ़ॉर्म से ठीक करता है जो हर चीज़ को ट्रैक करता है, प्रॉम्प्ट्स को मैनेज करता है, और गुणवत्ता को मापता है।
इस ट्यूटोरियल में, आप एक दस्तावेज़ Q&A टूल बनाएंगे और देखेंगे कि LangFuse आपकी डेवलपमेंट प्रक्रिया को कैसे संगठित करता है। आप डिबगिंग के लिए LLM कॉल्स को ट्रेस करना, वर्शन कंट्रोल के साथ प्रॉम्प्ट्स मैनेज करना, और इवैल्यूएशन अप्रोचेज़ का पता लगाना सीखेंगे।
LangFuse एक ओपन-सोर्स प्लेटफ़ॉर्म है जो टीमों को बेहतर LLM एप्लिकेशन बनाने में मदद करता है। जब आप फीचर्स बनाने पर ध्यान देते हैं, LangFuse मॉनिटरिंग, टेस्टिंग, और डिबगिंग संभालता है।
यह प्लेटफ़ॉर्म तीन मुख्य क्षेत्रों को कवर करता है:
जब आपका LLM एप्लिकेशन साधारण प्रयोगों से आगे बढ़ता है, तब आपको LangFuse चाहिए होगा। ये वे स्थितियाँ हैं जहाँ यह मूल्यवान हो जाता है:
यदि आप एक त्वरित प्रोटोटाइप या व्यक्तिगत प्रोजेक्ट बना रहे हैं, तो शायद अभी इसकी ज़रूरत नहीं। लेकिन जैसे ही आपका ऐप असली उपयोगकर्ताओं को हैंडल करने लगता है या आपकी टीम एक व्यक्ति से आगे बढ़ती है, LangFuse उपयोगी हो जाता है।
LangFuse आपके मौजूदा AI स्टैक के साथ काम करता है। यह LangChain, LlamaIndex, AutoGen, और CrewAI जैसे प्रमुख फ़्रेमवर्क्स के साथ इंटीग्रेट होता है। आप इसे किसी भी मॉडल प्रोवाइडर के साथ उपयोग कर सकते हैं — OpenAI, Anthropic, Google Gemini, Mistral, या Hugging Face मॉडल बॉक्स से बाहर काम करते हैं।
यह प्लेटफ़ॉर्म Python और JavaScript के लिए नेटिव SDK देता है, और कस्टम सेटअप के लिए OpenTelemetry सपोर्ट भी। चाहे आप नो-कोड एजेंट बिल्डर्स उपयोग करें या जटिल मल्टी-एजेंट फ़्रेमवर्क, LangFuse आपके कोर आर्किटेक्चर बदले बिना प्लग-इन हो जाता है।
Samsara, Twilio, और Khan Academy जैसी कंपनियाँ इसे प्रोडक्शन में उपयोग करती हैं, और यह एंटरप्राइज़ सुरक्षा मानकों को पूरा करता है। प्रोजेक्ट के 16,500+ GitHub स्टार हैं और इसे Y Combinator का समर्थन प्राप्त है। आप होस्टेड वर्शन इस्तेमाल कर सकते हैं या इसे अपनी इंफ़्रास्ट्रक्चर पर चला सकते हैं।
अब जब आप समझ गए हैं कि LangFuse क्या करता है और कब मददगार है, तो चलिए इससे कुछ बनाते हैं। वादे के मुताबिक, हम एक सरल दस्तावेज़ Q&A टूल बनाएँगे जो तीनों फ़ीचर्स को एक्शन में दिखाएगा।
LangFuse में उतरने से पहले आपको कुछ Python और LLM अनुभव चाहिए।
जरूरी:
अच्छा होगा यदि:
सेटअप:
uv या pip)AI डेवलपमेंट में नए हैं? पहले हमारा पूर्ण AI लर्निंग गाइड से शुरू करें।
यह समझने के लिए कि व्यापक इकोसिस्टम में LangFuse कहाँ फिट बैठता है, हमारा LLMOps टूल्स ओवरव्यू देखें।
अब कुछ बनाते हैं। हम एक सरल दस्तावेज़ Q&A फ़ंक्शन से शुरू करेंगे और देखेंगे कि LangFuse रन होने पर क्या-क्या ट्रैक करता है। यह बुनियादी उदाहरण आपको तीनों मुख्य फ़ीचर्स — ऑब्ज़र्वेबिलिटी, प्रॉम्प्ट प्रबंधन, और इवैल्यूएशन — ऐसे तरीके से दिखाएगा जो जटिल प्रोजेक्ट्स तक स्केल करता है।
आप एक सरल दस्तावेज़ Q&A सिस्टम बनाएँगे जो PDF से सवालों के जवाब देता है। इससे आपके पास ट्रेस, प्रबंधन, और इवैल्यूएशन के लिए वास्तविक डेटा होगा। हम उदाहरण को सरल रखेंगे, लेकिन यही पैटर्न जटिल RAG सिस्टम और मल्टी-एजेंट वर्कफ़्लोज़ पर भी काम करते हैं।
सबसे पहले, प्रोजेक्ट के लिए एक डायरेक्टरी बनाएँ और ज़रूरी पैकेज इंस्टॉल करें:
mkdir langfuse-qa-demo
cd langfuse-qa-demo
uv add langfuse langchain langchain-openai langchain-community pypdf python-dotenv
मुफ़्त LangFuse Cloud अकाउंट के लिए langfuse.com पर साइन अप करें। साइन इन करने के बाद, एक नया ऑर्गनाइज़ेशन और प्रोजेक्ट बनाएँ। आपको अपनी API कुंजियों वाली स्क्रीन दिखेगी:
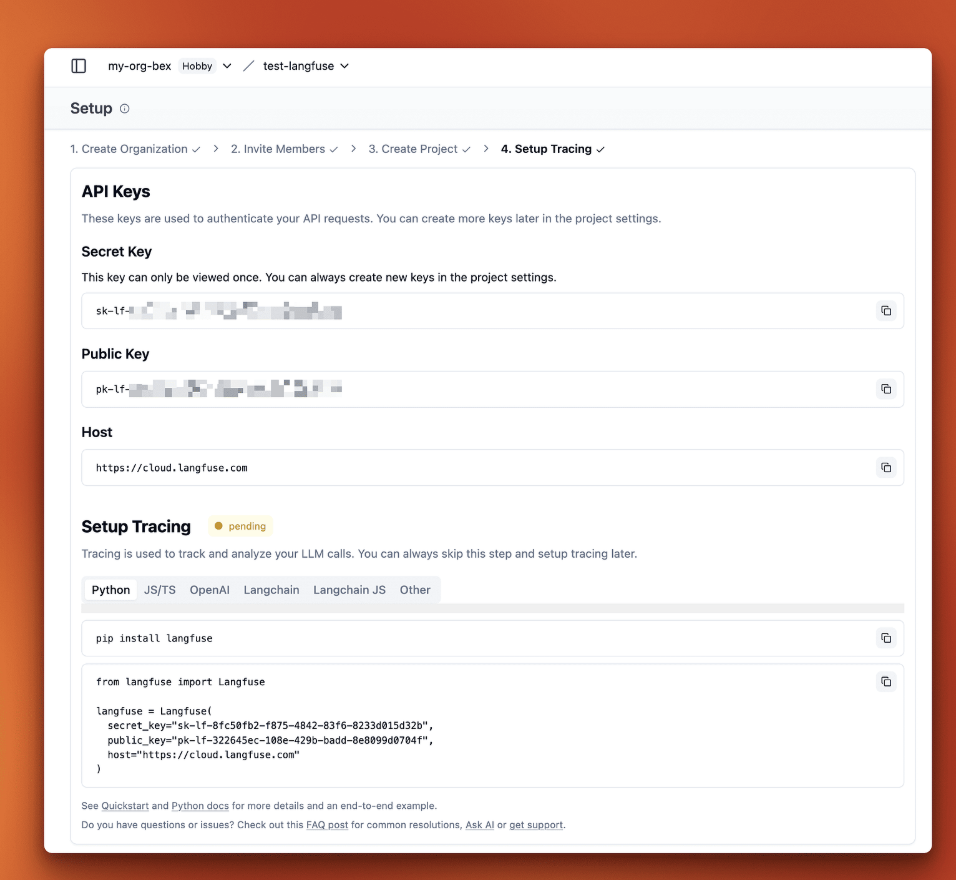
अपनी Public Key और Secret Key कॉपी करें। आपको अपनी OpenAI API कुंजी भी चाहिए होगी, जो platform.openai.com पर मिलेगी।
अब अपने प्रोजेक्ट डायरेक्टरी में एक .env फ़ाइल बनाएँ:
OPENAI_API_KEY=your_openai_key_here
LANGFUSE_PUBLIC_KEY=pk-lf-...
LANGFUSE_SECRET_KEY=sk-lf-...
LANGFUSE_HOST=https://cloud.langfuse.com
यदि आप LangFuse को अपनी इंफ़्रास्ट्रक्चर पर चलाना पसंद करते हैं, तो लोकल टेस्टिंग के लिए Docker Compose का उपयोग कर सकते हैं। self-hosting गाइड PostgreSQL, ClickHouse, और LangFuse सेवाएँ सेट करने की प्रक्रिया समझाता है। प्रोडक्शन डिप्लॉयमेंट के लिए Kubernetes या क्लाउड-विशिष्ट Terraform टेम्पलेट्स उपयोग करें।
आप एक रिट्रीवल चेन बनाएँगे जो PDF लोड करता है, उसे टुकड़ों में बाँटता है, उन्हें एक वेक्टर डेटाबेस में स्टोर करता है, और रिट्रीव्ड संदर्भ के आधार पर सवालों के जवाब देता है।
qa_chain.py नाम की फ़ाइल बनाएँ:
from langchain_community.document_loaders import PyPDFLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_core.vectorstores import InMemoryVectorStore
from langchain.chains import create_retrieval_chain
from langchain.chains.combine_documents import create_stuff_documents_chain
from langchain_core.prompts import ChatPromptTemplate
from dotenv import load_dotenv

load_dotenv()
यह वह सब आयात करता है जिसकी आपको ज़रूरत है। load_dotenv() कॉल आपकी API कुंजियों को .env फ़ाइल से लोड करता है।
# Load and split PDF
loader = PyPDFLoader("ai-security-landscape.pdf")
docs = loader.load()

text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
splits = text_splitter.split_documents(docs)
यहाँ हम ai-security-landscape.pdf डॉक्यूमेंट लोड कर रहे हैं, जो Amazon Web Services द्वारा लिखे गए श्वेतपत्रों में से एक है। इस उदाहरण को चलाने के लिए, आपको फ़ाइल स्वयं डाउनलोड करनी होगी और सही नाम के साथ अपनी वर्किंग डायरेक्टरी में जोड़नी होगी।
PyPDFLoader PDF पढ़ता है और RecursiveCharacterTextSplitter उसे 1000-कैरेक्टर के चंक्स में 200-कैरेक्टर ओवरलैप के साथ तोड़ता है। ओवरलैप चंक सीमाओं के पार संदर्भ बनाए रखने में मदद करता है।
अब वेक्टर स्टोर बनाइए:
# Create vector store
embeddings = OpenAIEmbeddings()
vectorstore = InMemoryVectorStore.from_documents(documents=splits, embedding=embeddings)
InMemoryVectorStore डॉक्यूमेंट एंबेडिंग्स को मेमोरी में स्टोर करता है। प्रोडक्शन में, आप Pinecone, Weaviate, या अन्य किसी वेक्टर डेटाबेस का उपयोग करेंगे।
अब QA चेन बनाइए:
# Build QA chain
llm = ChatOpenAI(model="gpt-4")
prompt = ChatPromptTemplate.from_messages([
   ("system", "Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.\n\n{context}"),
   ("human", "{input}"),
])

question_answer_chain = create_stuff_documents_chain(llm, prompt)
qa_chain = create_retrieval_chain(vectorstore.as_retriever(), question_answer_chain)
create_stuff_documents_chain रिट्रीव किये गए डॉक्यूमेंट्स को प्रॉम्प्ट संदर्भ में “स्टफ़” करता है। create_retrieval_chain रिट्रीवल और आंसरिंग को एक ही चेन में जोड़ता है।
चेन तैयार है, अब इसे ट्रेसिंग के लिए LangFuse से जोड़ते हैं।
स्क्रिप्ट में LangFuse कॉलबैक हैंडलर जोड़ें:
from langfuse.langchain import CallbackHandler

langfuse_handler = CallbackHandler()

response = qa_chain.invoke(
   {"input": "What are the main security risks discussed?"},
   config={"callbacks": [langfuse_handler]}
)

print(response["answer"])
The main security risks discussed in relation to generative artificial intelligence (AI) are context window overflow, agent mismanagement, indirect prompt injections and data leaks from overprivileged agents, logging, and caching.
Trace sent to LangFuse! Check your dashboard at https://cloud.langfuse.comजब आप इसे चलाते हैं, LangFuse पूरा एक्ज़ीक्यूशन ट्रेस कैप्चर करता है। अपने LangFuse डैशबोर्ड पर जाएँ, और आप देखेंगे कि यह नई डिटेल्स के साथ अपडेट हो गया है:
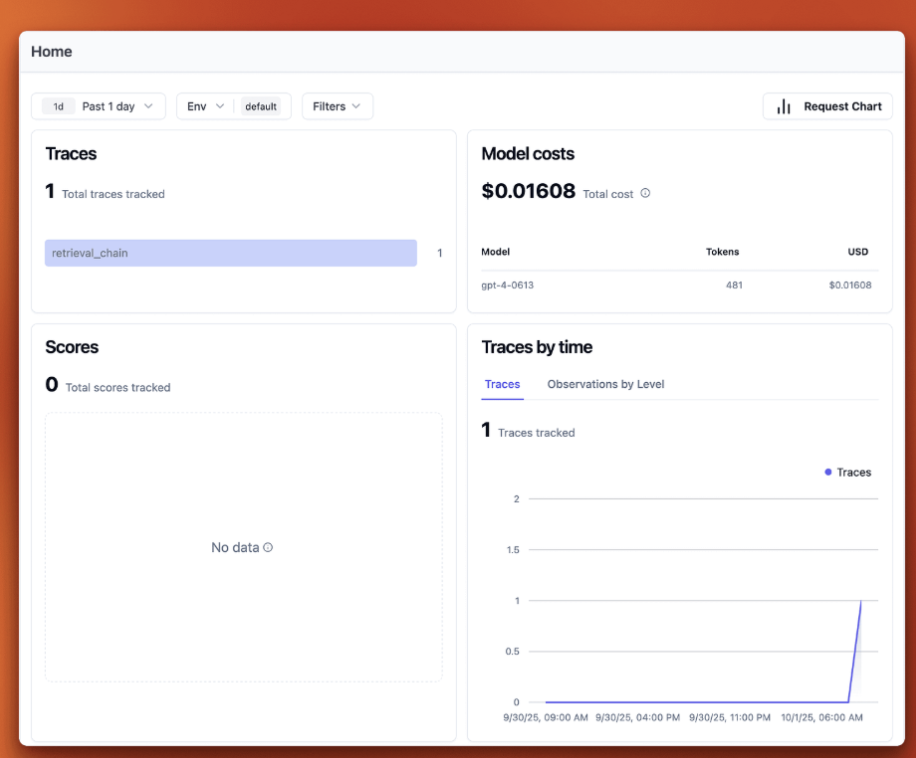
ध्यान दें कि हम यहाँ सरल उदाहरण उपयोग कर रहे हैं, लेकिन LangFuse जटिल RAG पाइपलाइनों के साथ भी काम करता है जो कई डॉक्यूमेंट प्रकार हैंडल करती हैं, री-रैंकिंग उपयोग करती हैं, या समानांतर में कई रिट्रीवल स्ट्रैटेजी चलाती हैं।
आपका Q&A सिस्टम चल रहा है और LangFuse ट्रेसिंग सेट है, अब आप तैयार हैं समझने के लिए कि LangFuse क्या-क्या कैप्चर करता है और उस जानकारी को अपने एप्लिकेशन को बेहतर बनाने में कैसे उपयोग करें।
आपने अभी एक ट्रेस LangFuse को भेजा। अब समझते हैं कि इससे आपको क्या मिलता है और यह क्यों मायने रखता है।
पारंपरिक लॉगिंग LLM ऐप्स के लिए अच्छी नहीं बैठती। आप लॉग कर सकते हैं कि कोई फ़ंक्शन चला, लेकिन आप नहीं देख पाते कि मॉडल ने उपयोगकर्ता इनपुट के साथ वास्तव में क्या किया। क्या उसने सही डॉक्यूमेंट्स रिट्रीव किए? क्या प्रॉम्प्ट सही फ़ॉर्मेट हुआ? कौन सा स्टेप पाँच सेकंड लगा?
LLM ऑब्ज़र्वेबिलिटी पूरी एक्ज़ीक्यूशन पथ को ट्रैक करती है। आप हर इनपुट, आउटपुट, और मध्यवर्ती स्टेप देखते हैं। जब कोई उपयोगकर्ता गलत उत्तर रिपोर्ट करता है, तो आप उसका ट्रेस खोलकर ठीक-ठीक देखते हैं कि क्या हुआ। अनुमान नहीं। निश्चित जानकारी।
जैसे-जैसे आपका ऐप जटिल होता है, यह और मायने रखता है। एक साधारण Q&A चेन में 4–5 स्टेप होते हैं। प्रोडक्शन RAG सिस्टम में डॉक्यूमेंट लोडर्स, चंकिंग रणनीतियाँ, कई रिट्रीवर्स, री-रैंकर्स, और जनरेशन स्टेप होते हैं। ऑब्ज़र्वेबिलिटी के बिना, डिबगिंग असंभव हो जाता है। इसके साथ, आप समस्याएँ पिनपॉइंट करते हैं।
अपना LangFuse डैशबोर्ड खोलें और बाएँ साइडबार में “Tracing” पर क्लिक करें। आपको अपनी पहली ट्रेस तालिका में दिखेगी।
तालिका दिखाती है कि ट्रेस कब चला, उसका नाम क्या था (retrieval_chain), और अंदर-बाहर क्या गया। हर पंक्ति आपके Q&A चेन के एक पूर्ण एक्ज़ीक्यूशन का प्रतिनिधित्व करती है।
ट्रेस पर क्लिक करें ताकि अंदर क्या हुआ, देखें। आपको विस्तृत ब्रेकडाउन मिलेगा।
बाएँ पैनल में आपका एक्ज़ीक्यूशन ट्री दिखता है। LangFuse ने आपकी चेन के हर स्टेप को ट्रैक किया। रूट retrieval_chain कुल 4.75 सेकंड लगा। इसके नीचे आपको हर ऑपरेशन दिखेगा जो चला: डॉक्यूमेंट रिट्रीवल (retrieve_documents), वेक्टर सर्च (VectorStoreRetriever), और आंसर जनरेशन (stuff_documents_chain)। हर स्टेप अपना एक्ज़ीक्यूशन समय दिखाता है।
यह पदानुक्रम बताता है कि आपकी चेन ने समय कहाँ खर्च किया। यदि आपका ऐप धीमा चलता है, तो आपको पता चल जाएगा कि यह एंबेडिंग लुकअप है, वेक्टर सर्च है, या LLM कॉल।
दाएँ पैनल में ट्रेस डेटा दिखता है। ऊपर, आपको महत्वपूर्ण मेट्रिक्स मिलते हैं: लेटेंसी (4.75s), लागत (~$0.016), और उपयोग किए गए टोकन (426 इनपुट, 55 आउटपुट)। नीचे, आप वास्तविक इनपुट और आउटपुट देखते हैं। context सेक्शन वह चार डॉक्यूमेंट चंक्स दिखाता है जो आपके रिट्रीवर ने वेक्टर स्टोर से निकाले।
नीचे, एक फ़्लो डायग्राम दिखाता है कि आपकी चेन अपने ऑपरेशंस को कैसे जोड़ती है। यह तब मदद करता है जब आप कई ब्रांच वाली जटिल चेनों को डिबग करते हैं।
अब सेशंस की बात करते हैं। एक ट्रेस एक प्रश्न-उत्तर चक्र को कैप्चर करता है। लेकिन असली ऐप्स में बातचीत होती है। कोई उपयोगकर्ता सुरक्षा जोखिमों के बारे में तीन संबंधित सवाल पूछ सकता है। आप वे ट्रेसेज़ एक साथ ग्रुप करना चाहते हैं।
सेशंस यही करते हैं। वे कई ट्रेसेज़ को एक ही कन्वर्सेशन थ्रेड में बाँधते हैं। जब कोई उपयोगकर्ता बग रिपोर्ट करता है, तो आप उसका पूरा सेशन खोलकर देख सकते हैं कि उसने कौन-कौन से सवाल पूछे और उसे क्या-क्या जवाब मिले।
इसे एक्शन में देखते हैं। पहले, build_chain.py नाम की हेल्पर फ़ाइल बनाएँ जो आपकी चेन-बिल्डिंग लॉजिक को रैप करे:
from langchain_community.document_loaders import PyPDFLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_core.vectorstores import InMemoryVectorStore
from langchain.chains import create_retrieval_chain
from langchain.chains.combine_documents import create_stuff_documents_chain
from langchain_core.prompts import ChatPromptTemplate
from dotenv import load_dotenv

load_dotenv()

def build_qa_chain():
   # Load and split PDF
   loader = PyPDFLoader("ai-security-landscape.pdf")
   docs = loader.load()

   text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
   splits = text_splitter.split_documents(docs)

   # Create vector store
   embeddings = OpenAIEmbeddings()
   vectorstore = InMemoryVectorStore.from_documents(documents=splits, embedding=embeddings)

   # Build QA chain
   llm = ChatOpenAI(model="gpt-4")
   prompt = ChatPromptTemplate.from_messages([
       ("system", "Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.\n\n{context}"),
       ("human", "{input}"),
   ])

   question_answer_chain = create_stuff_documents_chain(llm, prompt)
   qa_chain = create_retrieval_chain(vectorstore.as_retriever(), question_answer_chain)

   return qa_chain
यह सब कुछ एक फ़ंक्शन में रैप करता है जिसे आप इंपोर्ट कर सकते हैं। अब sessions_demo.py बनाएँ:
from build_chain import build_qa_chain
from langfuse.langchain import CallbackHandler

# Build the Q&A chain
qa_chain = build_qa_chain()

# Set up LangFuse handler
langfuse_handler = CallbackHandler()
This imports your chain and sets up the LangFuse handler. Now add session tracking for the first conversation:
# Session 1: User asking about security risks
response1 = qa_chain.invoke(
   {"input": "What are the main security risks discussed?"},
   config={
       "callbacks": [langfuse_handler],
       "metadata": {"langfuse_session_id": "conversation-001"}
   }
)
print(f"Q1: {response1['answer']}\n")
metadata फ़ील्ड में langfuse_session_id इस ट्रेस को एक सेशन ID से टैग करता है। इसे चलाएँ और आप देखेंगे:
Q1: The main security risks discussed are context window overflow, agent mismanagement, and indirect prompt injections.अब उसी सेशन ID के साथ एक फ़ॉलो-अप प्रश्न जोड़ें:
response2 = qa_chain.invoke(
   {"input": "How can these risks be mitigated?"},
   config={
       "callbacks": [langfuse_handler],
       "metadata": {"langfuse_session_id": "conversation-001"}
   }
)
print(f"Q2: {response2['answer']}\n")
यह दूसरा सवाल उसी बातचीत से संबंधित है, इसलिए यह फिर से conversation-001 उपयोग करता है। आपको लंबा उत्तर दिखेगा:
Q2: Risks can be mitigated through several strategies including:
1. Input Management: Limit and sanitize inputs going into the model.
2. Real-time Monitoring: Use systems that alert when the context window is nearing capacity.
3. Principle of Least Privilege: Implement this for all agents and external integrations.
....
अब अलग सवालों के साथ दूसरे उपयोगकर्ता का सिमुलेशन करें। अपनी स्क्रिप्ट में यह जोड़ें:
# Session 2: Different user asking about AI applications
response3 = qa_chain.invoke(
   {"input": "What AI applications are mentioned in the document?"},
   config={
       "callbacks": [langfuse_handler],
       "metadata": {"langfuse_session_id": "conversation-002"}
   }
)
print(f"Q3: {response3['answer']}\n")

response4 = qa_chain.invoke(
   {"input": "What are the benefits of these applications?"},
   config={
       "callbacks": [langfuse_handler],
       "metadata": {"langfuse_session_id": "conversation-002"}
   }
)
print(f"Q4: {response4['answer']}\n")
ये दोनों सवाल conversation-002 का उपयोग करते हैं। पूरी स्क्रिप्ट चलाएँ:
uv run python sessions_demo.pyअंतिम दो आउटपुट होंगे:
Q3: The document does not specifically mention any AI applications. However, it discusses the concept of generative AI and its security considerations.

Q4: The context does not provide specific benefits of these applications.
अब अपने LangFuse डैशबोर्ड पर जाएँ और बाएँ साइडबार में “Sessions” पर क्लिक करें। आपको दोनों बातचीतें सूचीबद्ध दिखेंगी:
दो सेशंस दिखेंगे: conversation-002 (~4 सेकंड अवधि) और conversation-001 (~14 सेकंड अवधि)। LangFuse ने आपकी ट्रेसेज़ को सेशन ID के अनुसार ग्रुप कर दिया।
conversation-001 पर क्लिक करें और पूरी बातचीत देखें:
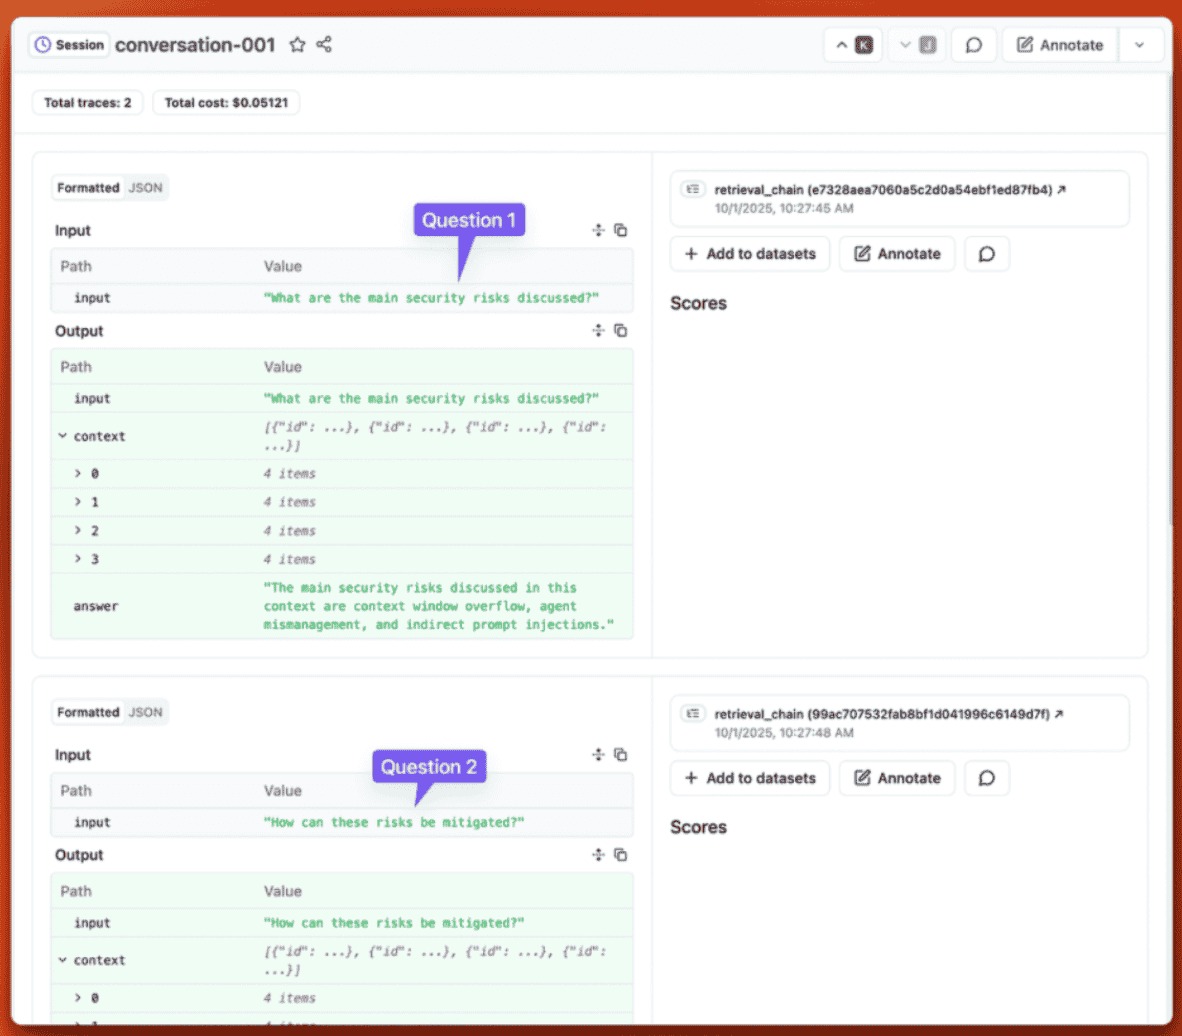
आप दोनों ट्रेसेज़ क्रम में देखते हैं: प्रश्न 1 सुरक्षा जोखिमों के बारे में, और प्रश्न 2 निवारण के बारे में। सेशन कुल लागत ($0.05121 दोनों ट्रेसेज़ के लिए) और कुल अवधि (14 सेकंड) दिखाता है। हर ट्रेस अपने इनपुट, आउटपुट, और रिट्रीव्ड संदर्भ के साथ दिखता है।
यह सेशन व्यू आपको ठीक-ठीक दिखाता है कि उपयोगकर्ता ने अपनी इंटरैक्शन के दौरान क्या अनुभव किया। यदि वह कोई समस्या रिपोर्ट करता है, तो आपको अलग-अलग ट्रेसेज़ में खोजने की ज़रूरत नहीं। आप उसका सेशन खोलते हैं और पूरी बातचीत का फ्लो देखते हैं।
अब तक आपने सेशंस ट्रैक किए, लेकिन व्यक्तिगत उपयोगकर्ताओं का क्या? वास्तविक LLM ऐप्स को जानना होता है कि किस उपयोगकर्ता ने कौन-सी रिक्वेस्ट की। जब कोई साइन अप करता है, तो आप उसके लिए एक यूनिक ID जनरेट करते हैं। फिर वह ID हर LLM कॉल के साथ संलग्न करते हैं।
LangFuse आपको सेशन ग्रुपिंग के ऊपर यूज़र ID के अनुसार ट्रेसेज़ ग्रुप करने देता है। यह आपके ऑब्ज़र्वेबिलिटी डेटा को व्यवस्थित करने का एक और तरीका देता है।
यूज़र ट्रैकिंग ऐसे जोड़ें। user_tracking.py बनाएँ:
from build_chain import build_qa_chain
from langfuse.langchain import CallbackHandler

# Build the Q&A chain
qa_chain = build_qa_chain()

# Set up LangFuse handler
langfuse_handler = CallbackHandler()

# Simulate a new user asking a question
user_response = qa_chain.invoke(
   {"input": "What security controls are recommended for AI systems?"},
   config={
       "callbacks": [langfuse_handler],
       "metadata": {
           "langfuse_session_id": "conversation-003",
           "langfuse_user_id": "user-12345"
       }
   }
)
print(f"Response: {user_response['answer']}")
langfuse_user_id फ़ील्ड इस ट्रेस को एक यूज़र ID से टैग करता है। स्क्रिप्ट चलाएँ:
uv run python user_tracking.pyआप देखेंगे:
Response: The recommended security controls for AI systems include:

1. Adaptive defenses: Incorporate machine learning-powered filters that continuously learn and adapt to new adversarial techniques.
2. Defense-in-depth: Introduce layered security mechanisms, such as refusal classifiers and real-time input monitoring, to fortify AI system integrity.
3. Data classification: Properly classify your data according to sensitivity.
......
अब अपने LangFuse डैशबोर्ड पर जाएँ। बाएँ साइडबार में “Users” पर क्लिक करें, और आपको user-12345 सूची में दिखेगा। उस उपयोगकर्ता पर क्लिक करें और अलग-अलग सेशंस में उनकी सभी ट्रेसेज़ देखें।
यह यूज़र व्यू आपको ऐसे सवालों के जवाब देने में मदद करता है: “इस महीने उपयोगकर्ता X ने हमें कितना खर्च कराया?” या “उपयोगकर्ता Y बार-बार कौन से सवाल पूछता है?” आप व्यक्तिगत यूज़र व्यवहार ट्रैक कर सकते हैं और विशिष्ट उपयोगकर्ताओं की समस्याओं को डिबग कर सकते हैं।
आपके Q&A सिस्टम में एक समस्या है। प्रॉम्प्ट आपके कोड में दबा हुआ है। सिस्टम की प्रतिक्रिया बदलने के लिए, आपको qa_chain.py एडिट करना, लोकल टेस्ट करना, और फिर से डिप्लॉय करना पड़ता है। यदि कोई सहकर्मी अलग अप्रोच आज़माना चाहता है, तो उसे आपके कोड स्ट्रक्चर को समझना और नई ब्रांच बनानी होगी। आप अलग-अलग प्रॉम्प्ट वर्शन्स को साथ-साथ तुलना नहीं कर सकते या पिछले सप्ताह के वर्शन पर बिना git हिस्ट्री खंगाले रोलबैक नहीं कर सकते।
प्रॉम्प्ट प्रबंधन इसे कोड के बाहर प्रॉम्प्ट्स स्टोर करके हल करता है। आप उन्हें UI में एडिट करते हैं, वे स्वतः वर्शन होते हैं, और रनटाइम पर फ़ेच होते हैं। आपका कोड वही रहता है जबकि आपके प्रॉम्प्ट्स बेहतर होते जाते हैं।
अपने Q&A चेन में प्रॉम्प्ट पर नज़र डालें:
prompt = ChatPromptTemplate.from_messages([
   ("system", "Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.\n\n{context}"),
   ("human", "{input}"),
])
यह सोलो प्रोजेक्ट्स के लिए काम करता है। लेकिन जब आप टीम के साथ काम कर रहे हों या प्रोडक्शन में चला रहे हों, तो हार्डकोडेड प्रॉम्प्ट्स समस्याएँ पैदा करते हैं:
LangFuse का प्रॉम्प्ट प्रबंधन प्रॉम्प्ट्स को कोड नहीं, डेटा की तरह ट्रीट करके इन समस्याओं का समाधान करता है।
LangFuse आपके प्रॉम्प्ट्स को एक केंद्रीय स्थान पर ऑटो-वर्शनिंग के साथ स्टोर करता है। आप UI के ज़रिए या SDK से प्रॉम्प्ट बना सकते हैं।
अपने LangFuse डैशबोर्ड पर जाएँ और बाएँ साइडबार में “Prompts” पर क्लिक करें। “New Prompt” पर क्लिक करके एक प्रॉम्प्ट बनाएँ।
आपको एक फ़ॉर्म दिखेगा जहाँ आप:
document-qa-prompt)text या chat){{variable}} सिंटैक्स के साथ वैरिएबल्स सहित लिखेंproduction या staging)हमारे Q&A सिस्टम के लिए, दो संदेशों वाला एक चैट प्रॉम्प्ट बनाएँ:
सिस्टम संदेश:
Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.

{{context}}
उपयोगकर्ता संदेश:
{{input}}LangFuse {{context}} और {{input}} वैरिएबल्स को अपने-आप पहचान लेगा।
अगला, कॉन्फ़िग को यह सेट करें:
{
 "model": "gpt-4",
 "temperature": 0.0
}
production लेबल जोड़ें ताकि इसे प्रोडक्शन वर्शन के रूप में चिह्नित किया जा सके।
सेव करते ही, LangFuse आपके प्रॉम्प्ट का वर्शन 1 बना देता है। हर बार एडिट और सेव करने पर नया वर्शन बनता है। पुराने वर्शन उपलब्ध रहते हैं।
आप Python SDK का उपयोग करके भी प्रॉम्प्ट बना सकते हैं:
from langfuse import Langfuse

langfuse = Langfuse()

langfuse.create_prompt(
   name="document-qa-prompt",
   type="chat",
   prompt=[
       {"role": "system", "content": "Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.\n\n{{context}}"},
       {"role": "user", "content": "{{input}}"}
   ],
   labels=["production"]
)
यह प्रोग्रामेटिक रूप से वही प्रॉम्प्ट बनाता है। यदि आप create_prompt() को उसी नाम के साथ फिर कॉल करते हैं, तो LangFuse ओवरराइट करने के बजाय नया वर्शन जोड़ता है।
LangFuse हर प्रॉम्प्ट बदलाव को वर्शन नंबर (v1, v2, v3) से ट्रैक करता है। आप वर्शन्स को लेबल भी दे सकते हैं। लेबल डिप्लॉयमेंट मैनेज करने में मदद करते हैं:
production - वह वर्शन जिसे आपका प्रोडक्शन ऐप उपयोग करता हैstaging - वह वर्शन जो आपके स्टेजिंग वातावरण में हैlatest - अपने-आप नवीनतम वर्शन की ओर संकेत करता हैजब आप अपना प्रॉम्प्ट सुधारते हैं, तो नया वर्शन बनता है। पहले उसे स्टेजिंग में टेस्ट करें और staging लेबल दें। जब यह अच्छा काम करे, तो production लेबल नए वर्शन पर ले जाएँ। आपका प्रोडक्शन ऐप अगली बार प्रॉम्प्ट फ़ेच पर अपने-आप बदलाव ले लेगा।
LangFuse UI में एक प्लेग्राउंड शामिल है जहाँ आप कोड में उपयोग करने से पहले प्रॉम्प्ट्स टेस्ट कर सकते हैं। आप:
इससे गैर-तकनीकी टीम सदस्य बिना कोड छुए शब्दावली के साथ प्रयोग कर सकते हैं।
यहाँ बताया गया है कि अपने एप्लिकेशन में LangFuse-मैनेज्ड प्रॉम्प्ट्स कैसे उपयोग करें। यह वर्कफ़्लो आपके कोड को स्थिर रखता है जबकि आपके प्रॉम्प्ट्स विकसित होते रहते हैं।
एप्लिकेशन कोड में, हार्डकोड करने के बजाय LangFuse से प्रॉम्प्ट फ़ेच करें:
from langfuse import Langfuse

langfuse = Langfuse()

# Get the production version
prompt = langfuse.get_prompt("document-qa-prompt", type="chat")
यह production लेबल वाले वर्शन को फ़ेच करता है। LangFuse क्लाइंट-साइड पर प्रॉम्प्ट्स को कैश करता है, इसलिए आपके LLM कॉल्स पर कोई लेटेंसी प्रभाव नहीं पड़ता।
आप विशेष वर्शन या लेबल भी फ़ेच कर सकते हैं:
# Get version 2 specifically
prompt = langfuse.get_prompt("document-qa-prompt", version=2, type="chat")

# Get staging version
prompt = langfuse.get_prompt("document-qa-prompt", label="staging", type="chat")

# Get latest version (automatically maintained by LangFuse)
prompt = langfuse.get_prompt("document-qa-prompt", label="latest", type="chat")फ़ेच किया गया प्रॉम्प्ट {{variables}} के साथ एक टेम्पलेट है। वैरिएबल्स को वास्तविक मानों से बदलकर इसे कम्पाइल करें:
compiled_messages = prompt.compile(
   context="Retrieved document context goes here",
   input="What are the main security risks?"
)
यह चैट संदेशों की एक सूची लौटाता है जो आपके LLM को भेजने के लिए तैयार है:
[
   {
       "role": "system",
       "content": "Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.\n\nRetrieved document context goes here"
   },
   {
       "role": "user",
       "content": "What are the main security risks?"
   }
]कम्पाइल्ड संदेशों को अपनी LLM कॉल में पास करें। सटीक कोड इस पर निर्भर करता है कि आप LangChain, OpenAI SDK सीधे, या कोई और फ़्रेमवर्क उपयोग कर रहे हैं।
जब आप LangFuse-मैनेज्ड प्रॉम्प्ट के साथ LLM कॉल करते हैं, तो उसे ट्रेस से लिंक करें। इससे आप देख सकते हैं कि हर LLM कॉल के लिए कौन-सा प्रॉम्प्ट वर्शन उपयोग हुआ और प्रॉम्प्ट वर्शन के अनुसार मेट्रिक्स ट्रैक कर सकते हैं:
from langfuse.langchain import CallbackHandler

langfuse_handler = CallbackHandler()

response = qa_chain.invoke(
   {"input": "What are the main security risks?"},
   config={"callbacks": [langfuse_handler]}
)
अपने LangFuse डैशबोर्ड में, आप प्रॉम्प्ट नाम और वर्शन के अनुसार ग्रुप की हुई ट्रेसेज़ देखेंगे। इससे पता चलता है कि कौन-से प्रॉम्प्ट वर्शन अधिक महँगे, धीमे, या बेहतर परिणाम देने वाले हैं।
यही वह जगह है जहाँ प्रॉम्प्ट प्रबंधन फ़ायदा देता है। अपना प्रॉम्प्ट सुधारने के लिए:
staging लेबल असाइन करें ताकि स्टेजिंग वातावरण में टेस्ट हो सकेproduction लेबल शिफ्ट करेंआपका कोड कभी नहीं बदलता। अगली बार get_prompt() कॉल पर यह नया वर्शन फ़ेच करता है।
यदि नया प्रॉम्प्ट खराब प्रदर्शन करता है, तो production लेबल को पिछले वर्शन पर वापस ले जाएँ। किसी कोड डिप्लॉय की आवश्यकता नहीं।
यह वर्कफ़्लो प्रॉम्प्ट इंजीनियरिंग को सॉफ़्टवेयर इंजीनियरिंग से अलग करता है। आपकी टीम प्रॉम्प्ट्स पर तेज़ी से इटरेट कर सकती है जबकि आपका एप्लिकेशन कोड स्थिर रहता है।
आगे पढ़ें: LangFuse A/B टेस्टिंग भी सपोर्ट करता है जो प्रॉम्प्ट वर्शन्स के बीच ट्रैफ़िक अपने-आप बाँटता है, वेबहुक्स जो आपके सिस्टम्स को प्रॉम्प्ट बदलने पर सूचित करते हैं, और टीम सहयोग फ़ीचर्स जैसे कमेंट्स और अप्रूवल वर्कफ़्लोज़। ये उन्नत फ़ीचर्स बड़ी टीमों को बड़े पैमाने पर प्रॉम्प्ट्स मैनेज करने में मदद करते हैं। विस्तृत जानकारी के लिए प्रॉम्प्ट प्रबंधन दस्तावेज़ देखें।
आपने एक Q&A सिस्टम बनाया, ऑब्ज़र्वेबिलिटी जोड़ी, और प्रॉम्प्ट प्रबंधन सेट किया। लेकिन आपको कैसे पता कि आपके जवाब अच्छे हैं? अभी, आप शायद मैन्युअल रूप से टेस्ट कर रहे हैं। आप सवाल पूछते हैं, जवाब पढ़ते हैं, और तय करते हैं कि वह समझ में आता है या नहीं। यह कुछ उदाहरणों के लिए काम करता है, लेकिन स्केल पर नहीं।
जब आप प्रॉम्प्ट बदलते हैं, तो क्या होता है? आपको सब कुछ फिर से टेस्ट करना पड़ता है। एज केस का क्या? आपको हर सवाल याद नहीं रहता जो पहले टेस्ट किया था। और जब आप प्रोडक्शन में डिप्लॉय करते हैं, तो आपके पास यह मापने का कोई तरीका नहीं कि आपके प्रॉम्प्ट का वर्शन 2 वर्शन 1 से बेहतर प्रदर्शन करता है या नहीं।
इवैल्यूएशन इसे व्यवस्थित रूप से आपके LLM के प्रदर्शन को मापकर ठीक करता है। LangFuse आपको जवाबों को स्वचालित रूप से स्कोर करने, वास्तविक मेट्रिक्स के साथ प्रॉम्प्ट वर्शन्स की तुलना करने, और उपयोगकर्ताओं के देखने से पहले गुणवत्ता समस्याएँ पकड़ने के टूल देता है।
मैन्युअल टेस्टिंग बताती है कि कोई एक विशेष जवाब अच्छा दिखता है या नहीं। व्यवस्थित इवैल्यूएशन बताती है कि आपका पूरा सिस्टम सैकड़ों या हज़ारों उदाहरणों में कितना अच्छा काम करता है।
LangFuse में व्यवस्थित इवैल्यूएशन ऐसे काम करता है:
यह प्रक्रिया “मुझे लगता है यह प्रॉम्प्ट बेहतर है” को “यह प्रॉम्प्ट प्रासंगिकता पर 0.85 स्कोर करता है जबकि पुराना 0.72 था” में बदल देती है।
इवैल्यूएशन अप्रोचेज़ और उन्हें LangFuse में लागू करने की पूरी गाइड के लिए इवैल्यूएशन ओवरव्यू दस्तावेज़ देखें।
आपको सैकड़ों जवाब स्कोर करने हैं। यह मैन्युअल रूप से करने में घंटों लगते हैं। LLM-as-a-judge इसे स्वचालित करता है — आपका मुख्य LLM जो आउटपुट देता है, उसे ग्रेड करने के लिए एक और LLM का उपयोग करके।
आप जज LLM को तीन चीज़ें देते हैं: मूल सवाल, आपके Q&A सिस्टम का जवाब, और स्कोरिंग मानदंड। जज जवाब पढ़ता है और एक स्कोर असाइन करता है।
Q&A सिस्टम के लिए, आप अलग-अलग गुणवत्ता आयामों की परवाह करते हैं। यहाँ तीन जज हैं जो आप बना सकते हैं:
शुद्धता (Correctness) जज: “रेट करें कि यह उत्तर दिए गए संदर्भ की जानकारी को सही तरह दर्शाता है या नहीं। पूरी तरह सही हो तो 1, आंशिक रूप से सही हो तो 0.5, गलत या गढ़ा हुआ हो तो 0।”
यह ऐसे जवाबों को पकड़ता है जो आपके डॉक्यूमेंट्स का खंडन करते हैं या बातें गढ़ते हैं।
प्रासंगिकता (Relevance) जज: “रेट करें कि यह उत्तर पूछे गए सवाल को सीधे संबोधित करता है या नहीं। अत्यधिक प्रासंगिक हो तो 1, कुछ-कुछ प्रासंगिक हो तो 0.5, विषयांतर हो तो 0।”
यह सुनिश्चित करता है कि आपका सिस्टम विषय पर रहे, न कि सटीक पर अप्रासंगिक जानकारी दे।
ग्राउंडेडनेस (Groundedness) जज: “रेट करें कि यह उत्तर केवल दिए गए संदर्भ पर आधारित है या नहीं। पूरी तरह संदर्भ-आधारित हो तो 1, आंशिक रूप से हो तो 0.5, संदर्भ से बाहर की जानकारी शामिल हो तो 0।”
यह उन ‘हैलुसिनेशंस’ को रोकता है जहाँ LLM आपके डॉक्यूमेंट्स में मौजूद नहीं तथ्यों को जोड़ देता है।
हर जज एक विशिष्ट गुणवत्ता आयाम देखता है। आप हर जवाब पर तीनों जज चलाते हैं और एक संपूर्ण गुणवत्ता प्रोफ़ाइल पाते हैं। आप शैली (क्या यह संक्षिप्त है?), टोन (क्या यह प्रोफ़ेशनल है?), या अस्वीकार-हैंडलिंग (उचित हो तो “मुझे नहीं पता” कहता है?) के लिए और जज जोड़ सकते हैं।
LangFuse आपको UI या API के ज़रिए LLM जज कॉन्फ़िगर करने देता है। सेटअप प्रक्रिया:
जज असिंक्रोनस रूप से चलते हैं, इसलिए वे आपके मुख्य एप्लिकेशन को धीमा नहीं करते। आपके टेस्ट पूरे होने के बाद आप LangFuse डैशबोर्ड में स्कोर्स देखते हैं।
LLM जज उन विषयगत मानदंडों के लिए सबसे अच्छे हैं जिन्हें कोड से मापना कठिन है — जैसे टोन, प्रासंगिकता, और शैली। वे उद्देश्यपूर्ण तथ्यों के लिए कम भरोसेमंद हैं। यदि आपको “2+2=4” सत्यापित करना है, तो जज के बजाय निर्धारक जाँच लिखें।
हमारे Q&A सिस्टम के लिए, प्रासंगिकता और ग्राउंडेडनेस पर जज अच्छे काम करते हैं, लेकिन आप “जवाब की लंबाई 100 शब्दों से कम हो” जैसी चीज़ों के लिए निर्धारक जाँचों के साथ इन्हें जोड़ सकते हैं।
LLM जज परिपूर्ण नहीं हैं। वे एक-दूसरे से असहमत हो सकते हैं, कुछ उत्तर शैलियों की ओर पक्षपाती हो सकते हैं, और आत्मविश्वास से भरे लेकिन गलत जवाबों को उच्च स्कोर दे सकते हैं।
आप इसे इस तरह हैंडल करते हैं: उन उदाहरणों पर अपने जज टेस्ट करें जहाँ सही स्कोर पता है, एक से अधिक जजों का उपयोग करें और उनके स्कोर्स का औसत लें, और जज त्रुटियाँ पकड़ने के लिए स्पॉट-चेक करें।
इम्प्लीमेंटेशन नोट: पूर्ण इवैल्यूएशन वर्कफ़्लोज़ में डेटासेट्स सेट करना, जज कॉन्फ़िगर करना, बैच इवैल्यूएशन चलाना, और नतीजों का विश्लेषण शामिल है। इसे व्यावहारिक रखते हुए इस ट्यूटोरियल में जितना कवर कर सकते हैं, उससे अधिक सेटअप चाहिए। LLM-as-a-judge दस्तावेज़ में पूर्ण इम्प्लीमेंटेशन विवरण, कोड उदाहरण, और सर्वोत्तम प्रथाएँ मिलती हैं। LLM जज से परे कस्टम स्कोरिंग अप्रोचेज़ के लिए कस्टम स्कोर्स गाइड देखें।
यहाँ बताई गई वर्कफ़्लो आपको इवैल्यूएशन मानसिकता दिखाती है। एक बार जब आपके पास LangFuse में ट्रेसेज़ और मैनेज्ड प्रॉम्प्ट्स हों, तो व्यवस्थित इवैल्यूएशन जोड़ना स्वाभाविक अगला कदम है। आप टेस्ट सेट धीरे-धीरे बनाते हैं, सरल जज से शुरू करते हैं, और जैसे-जैसे आप सीखते हैं कि आपके एप्लिकेशन के लिए कौन-से मेट्रिक्स मायने रखते हैं, अपना अप्रोच परिष्कृत करते हैं।
आगे पढ़ें: LangFuse टेस्ट केसों को व्यवस्थित करने के लिए डेटासेट मैनेजमेंट, निर्धारक जाँचों के लिए कस्टम स्कोरिंग फ़ंक्शंस, और प्रोडक्शन ट्रैफ़िक पर अपने-आप चलने वाली कंटीन्युअस इवैल्यूएशन भी सपोर्ट करता है। ये फ़ीचर्स सिस्टम के स्केल होने पर गुणवत्ता बनाए रखने में मदद करते हैं। पूरी तस्वीर के लिए इवैल्यूएशन ओवरव्यू देखें।
आपने एक दस्तावेज़ Q&A सिस्टम बनाया और सीखा कि LangFuse के तीन स्तंभ एक साथ कैसे काम करते हैं। ऑब्ज़र्वेबिलिटी दिखाती है कि आपका LLM चलने पर क्या होता है। आप हर ट्रेस, हर लागत, हर टोकन देखते हैं। प्रॉम्प्ट प्रबंधन आपके प्रॉम्प्ट्स को कोड से बाहर एक वर्शन-कंट्रोल्ड सिस्टम में ले गया जहाँ आप बिना डिप्लॉयमेंट के इटरेट कर सकते हैं। इवैल्यूएशन ने आपको अंदाज़ों के बजाय व्यवस्थित रूप से गुणवत्ता मापने के तरीके दिए। ये फ़ीचर्स जुड़े हुए हैं: ट्रेसेज़ इवैल्यूएशन डेटासेट्स में फ़ीड होते हैं, प्रॉम्प्ट वर्शन्स परफ़ॉर्मेंस मेट्रिक्स से लिंक होते हैं, और पूरा सिस्टम आपको समझने में मदद करता है कि बदलाव बेहतर करते हैं या नहीं।
अपने प्रोजेक्ट्स में छोटा शुरू करें। कोई एक फ़ीचर चुनें। शायद ट्रेसिंग जोड़ें ताकि देखें कि आपका ऐप पैसा कहाँ खर्च करता है, या किसी एक हार्डकोडेड प्रॉम्प्ट को LangFuse के प्रबंधन सिस्टम में ले जाएँ। हमारे सरल Q&A उदाहरण से सीखे पैटर्न जटिल RAG पाइपलाइनों, मल्टी-एजेंट सिस्टम, और हज़ारों उपयोगकर्ताओं को हैंडल करने वाले प्रोडक्शन ऐप्स तक स्केल करते हैं। LangFuse दस्तावेज़ में विशेष फ़ीचर्स पर गहराई से पढ़ें, या उदाहरण नोटबुक्स आज़माएँ जो वास्तविक दुनिया के इम्प्लीमेंटेशन दिखाती हैं। अगली बार जब आप LLMs के साथ बनायेंगे, तो आपके पास यह देखने, नियंत्रित करने, और मापने के टूल होंगे कि क्या हो रहा है, क्या बदल रहा है, और क्या मायने रखता है।
DataCamp के साथ सीखें
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें