{count, plural, one {Cours} other {Cours}}
Concepts des grands modèles de langage (LLM)
{hours} h
112.4K
Développer des applications LLM devient vite chaotique. Vous commencez à estimer les coûts au doigt mouillé. Le débogage se complique quand vous ne voyez pas ce qui s’est passé. Les prompts se dispersent dans votre code. LangFuse résout ces problèmes avec une plateforme qui trace tout, gère les prompts et mesure la qualité.
Dans ce tutoriel, vous allez créer un outil de questions-réponses sur documents et voir comment LangFuse structure votre développement. Vous apprendrez à tracer les appels LLM pour le débogage, à gérer les prompts avec du versioning et à explorer des approches d’évaluation.
LangFuse est une plateforme open source qui aide les équipes à construire de meilleures applications LLM. Pendant que vous développez les fonctionnalités, LangFuse se charge du monitoring, des tests et du débogage.
La plateforme couvre trois axes principaux :
Vous aurez besoin de LangFuse dès que votre application LLM dépasse le stade de l’expérimentation. Voici les situations où il devient précieux :
Pour un prototype rapide ou un projet personnel, ce n’est sans doute pas nécessaire. Mais dès que votre app gère de vrais utilisateurs ou que votre équipe dépasse une personne, LangFuse devient utile.
LangFuse fonctionne avec votre pile IA existante. Il s’intègre aux frameworks majeurs comme LangChain, LlamaIndex, AutoGen et CrewAI. Vous pouvez l’utiliser avec n’importe quel fournisseur de modèles — OpenAI, Anthropic, Google Gemini, Mistral ou des modèles Hugging Face : tout marche nativement.
La plateforme propose des SDK natifs pour Python et JavaScript, ainsi qu’une compatibilité OpenTelemetry pour les configurations sur mesure. Que vous utilisiez des builders no-code d’agents ou des frameworks multi-agents complexes, LangFuse s’insère sans modifier votre architecture cœur.
Des entreprises comme Samsara, Twilio et Khan Academy l’utilisent en production, et la solution répond aux standards de sécurité des grands comptes. Le projet cumule plus de 16 500 étoiles GitHub et est soutenu par Y Combinator. Vous pouvez l’utiliser en mode hébergé ou l’exécuter sur votre propre infrastructure.
Maintenant que vous savez ce que fait LangFuse et dans quels cas il aide, passons à la pratique. Comme promis, nous allons créer un simple outil de questions-réponses sur documents pour illustrer ces trois fonctionnalités en action.
Vous aurez besoin d’un peu d’expérience en Python et avec les LLM avant de vous lancer avec LangFuse.
Indispensable :
Apprécié :
Mise en place :
uv ou pip)Débutant en développement IA ? Commencez par notre guide complet pour apprendre l’IA.
Pour situer LangFuse dans l’écosystème plus large, consultez notre panorama des outils LLMOps.
Passons à la construction. Nous allons commencer par une fonction simple de Q&R sur document et voir comment LangFuse trace son exécution. Cet exemple basique mettra en lumière les trois piliers — observabilité, gestion des prompts et évaluation — et s’adapte à des projets plus complexes.
Vous allez construire un système simple de Q&R qui répond à partir d’un PDF. Cela vous fournit un cas concret à tracer, gérer et évaluer. Même si l’exemple reste simple, ces mêmes schémas s’appliquent à des systèmes RAG complexes et à des workflows multi-agents.
Commencez par créer un répertoire pour le projet et installez les paquets nécessaires :
mkdir langfuse-qa-demo
cd langfuse-qa-demo
uv add langfuse langchain langchain-openai langchain-community pypdf python-dotenv
Inscrivez-vous à un compte gratuit LangFuse Cloud sur langfuse.com. Après connexion, créez une nouvelle organisation et un projet. Vous verrez un écran avec vos clés d’API :
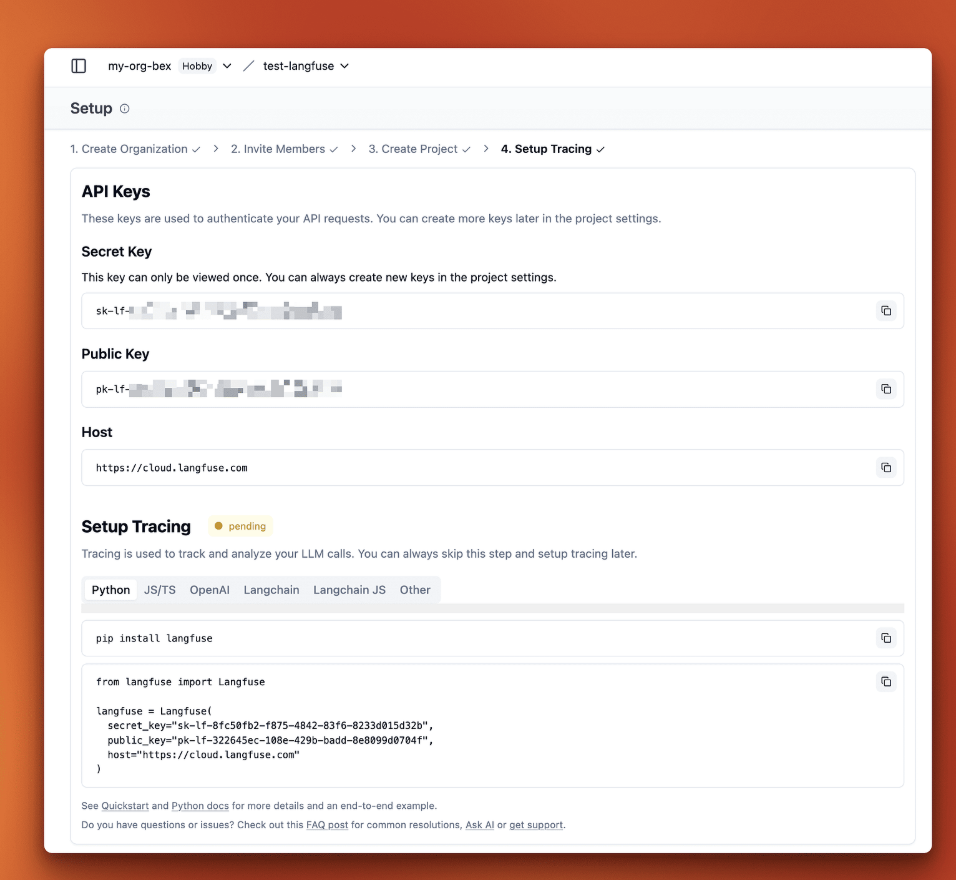
Copiez votre Public Key et votre Secret Key. Vous aurez aussi besoin de votre clé d’API OpenAI depuis platform.openai.com.
Créez maintenant un fichier .env dans le répertoire du projet :
OPENAI_API_KEY=your_openai_key_here
LANGFUSE_PUBLIC_KEY=pk-lf-...
LANGFUSE_SECRET_KEY=sk-lf-...
LANGFUSE_HOST=https://cloud.langfuse.com
Si vous préférez exécuter LangFuse sur votre propre infrastructure, vous pouvez utiliser Docker Compose pour des tests locaux. Le guide d’auto-hébergement explique comment configurer PostgreSQL, ClickHouse et les services LangFuse. Pour la production, optez pour Kubernetes ou des templates Terraform spécifiques cloud.
Vous allez créer une chaîne de recherche qui charge un PDF, le segmente, stocke les morceaux dans une base vectorielle et répond aux questions à partir du contexte retrouvé.
Créez un fichier nommé qa_chain.py :
from langchain_community.document_loaders import PyPDFLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_core.vectorstores import InMemoryVectorStore
from langchain.chains import create_retrieval_chain
from langchain.chains.combine_documents import create_stuff_documents_chain
from langchain_core.prompts import ChatPromptTemplate
from dotenv import load_dotenv

load_dotenv()
Ces importations couvrent vos besoins. L’appel load_dotenv() charge vos clés d’API depuis le fichier .env.
# Load and split PDF
loader = PyPDFLoader("ai-security-landscape.pdf")
docs = loader.load()

text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
splits = text_splitter.split_documents(docs)
Ici, nous chargeons le document ai-security-landscape.pdf, l’un des livres blancs publiés par Amazon Web Services. Pour exécuter cet exemple, vous devrez télécharger le fichier vous-même et l’ajouter à votre répertoire de travail avec le bon nom.
Le PyPDFLoader lit le PDF et RecursiveCharacterTextSplitter le découpe en blocs de 1 000 caractères avec un chevauchement de 200 caractères. Le chevauchement aide à conserver le contexte entre les blocs.
Créez ensuite le store vectoriel :
# Create vector store
embeddings = OpenAIEmbeddings()
vectorstore = InMemoryVectorStore.from_documents(documents=splits, embedding=embeddings)
InMemoryVectorStore stocke les embeddings des documents en mémoire. En production, vous utiliserez Pinecone, Weaviate ou une autre base vectorielle.
Construisez maintenant la chaîne de Q&R :
# Build QA chain
llm = ChatOpenAI(model="gpt-4")
prompt = ChatPromptTemplate.from_messages([
   ("system", "Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.\n\n{context}"),
   ("human", "{input}"),
])

question_answer_chain = create_stuff_documents_chain(llm, prompt)
qa_chain = create_retrieval_chain(vectorstore.as_retriever(), question_answer_chain)
create_stuff_documents_chain injecte les documents retrouvés dans le contexte du prompt. create_retrieval_chain combine la recherche et la réponse en une seule chaîne.
La chaîne est prête : connectons-la à LangFuse pour le tracing.
Ajoutez un gestionnaire de callbacks LangFuse au script :
from langfuse.langchain import CallbackHandler

langfuse_handler = CallbackHandler()

response = qa_chain.invoke(
   {"input": "What are the main security risks discussed?"},
   config={"callbacks": [langfuse_handler]}
)

print(response["answer"])
The main security risks discussed in relation to generative artificial intelligence (AI) are context window overflow, agent mismanagement, indirect prompt injections and data leaks from overprivileged agents, logging, and caching.
Trace sent to LangFuse! Check your dashboard at https://cloud.langfuse.comAu lancement, LangFuse capture la trace d’exécution complète. Rendez-vous sur votre tableau de bord LangFuse : vous verrez les détails apparaître.
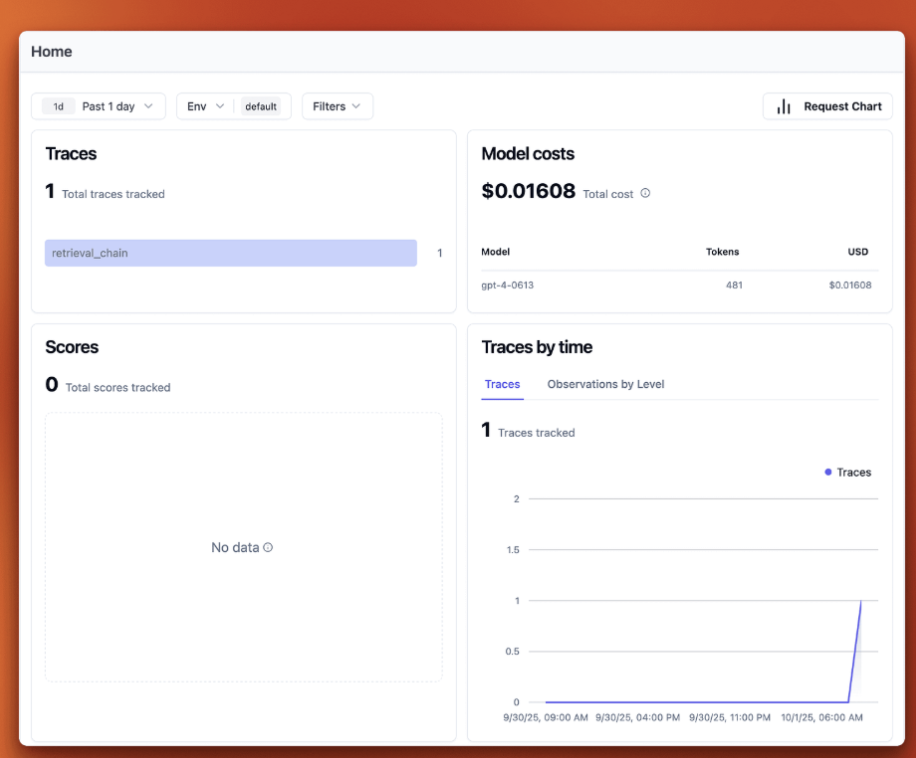
Notez que même si l’exemple est simple, LangFuse gère des pipelines RAG complexes avec types de documents variés, reranking ou stratégies de recherche parallèles.
Votre système de Q&R tourne et LangFuse trace l’exécution : voyons maintenant ce que LangFuse capture et comment exploiter ces informations pour améliorer votre application.
Vous venez d’envoyer une trace à LangFuse. Voyons ce que ça vous apporte et pourquoi c’est clé.
La journalisation classique fonctionne mal pour les apps LLM. Vous pouvez consigner qu’une fonction a tourné, sans voir ce que le modèle a vraiment fait avec l’entrée utilisateur. A-t-il retrouvé les bons documents ? Le prompt était-il correctement formaté ? Quelle étape a pris cinq secondes ?
L’observabilité LLM suit tout le chemin d’exécution. Vous voyez chaque entrée, chaque sortie, chaque étape intermédiaire. Quand un utilisateur signale une mauvaise réponse, vous ouvrez sa trace et voyez exactement ce qui s’est passé. Vous ne devinez pas. Vous savez.
C’est d’autant plus crucial quand l’app se complexifie. Une chaîne de Q&R simple a 4 à 5 étapes. Un RAG de production comprend des chargeurs de documents, des stratégies de segmentation, plusieurs retrieveurs, des re-rankers et la génération. Sans observabilité, déboguer devient impossible. Avec, vous localisez les problèmes.
Ouvrez votre tableau de bord LangFuse et cliquez sur « Tracing » dans le menu de gauche. Votre première trace s’affiche dans un tableau.
Le tableau indique quand la trace s’est exécutée, son nom (retrieval_chain) et les entrées/sorties. Chaque ligne représente une exécution complète de votre chaîne de Q&R.
Cliquez sur la trace pour voir le détail. Vous obtenez une analyse pas à pas.
Le panneau de gauche affiche l’arbre d’exécution. LangFuse a suivi chaque étape. La racine retrieval_chain a pris 4,75 secondes au total. En dessous, vous voyez chaque opération : recherche de documents (retrieve_documents), recherche vectorielle (VectorStoreRetriever) et génération de réponse (stuff_documents_chain). Chaque étape indique sa durée.
Cette hiérarchie révèle où votre chaîne passe du temps. Si l’app est lente, vous saurez si c’est la requête d’embeddings, la recherche vectorielle ou l’appel LLM.
Le panneau de droite affiche les données de la trace. En haut, les métriques utiles : latence (4,75 s), coût (~ 0,016 $) et tokens utilisés (426 en entrée, 55 en sortie). En dessous, vous voyez l’entrée et la sortie réelles. La section context présente les quatre blocs de documents récupérés depuis le store vectoriel.
En bas, un diagramme de flux cartographie les étapes et leurs liens. Idéal pour déboguer des chaînes complexes avec embranchements.
Parlons maintenant des sessions. Une trace capture un cycle question-réponse. Mais les vraies apps gèrent des conversations. Un utilisateur peut poser trois questions liées sur les risques sécurité. Vous souhaitez regrouper ces traces.
C’est le rôle des sessions : elles agrègent plusieurs traces dans un même fil de discussion. Si un utilisateur signale un bug, vous ouvrez sa session et retrouvez toutes ses questions et réponses.
Voyons ça concrètement. Créez d’abord un fichier utilitaire build_chain.py qui encapsule la logique de construction de la chaîne :
from langchain_community.document_loaders import PyPDFLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_core.vectorstores import InMemoryVectorStore
from langchain.chains import create_retrieval_chain
from langchain.chains.combine_documents import create_stuff_documents_chain
from langchain_core.prompts import ChatPromptTemplate
from dotenv import load_dotenv

load_dotenv()

def build_qa_chain():
   # Load and split PDF
   loader = PyPDFLoader("ai-security-landscape.pdf")
   docs = loader.load()

   text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
   splits = text_splitter.split_documents(docs)

   # Create vector store
   embeddings = OpenAIEmbeddings()
   vectorstore = InMemoryVectorStore.from_documents(documents=splits, embedding=embeddings)

   # Build QA chain
   llm = ChatOpenAI(model="gpt-4")
   prompt = ChatPromptTemplate.from_messages([
       ("system", "Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.\n\n{context}"),
       ("human", "{input}"),
   ])

   question_answer_chain = create_stuff_documents_chain(llm, prompt)
   qa_chain = create_retrieval_chain(vectorstore.as_retriever(), question_answer_chain)

   return qa_chain
Cela regroupe tout dans une fonction importable. Créez maintenant sessions_demo.py :
from build_chain import build_qa_chain
from langfuse.langchain import CallbackHandler

# Build the Q&A chain
qa_chain = build_qa_chain()

# Set up LangFuse handler
langfuse_handler = CallbackHandler()
This imports your chain and sets up the LangFuse handler. Now add session tracking for the first conversation:
# Session 1: User asking about security risks
response1 = qa_chain.invoke(
   {"input": "What are the main security risks discussed?"},
   config={
       "callbacks": [langfuse_handler],
       "metadata": {"langfuse_session_id": "conversation-001"}
   }
)
print(f"Q1: {response1['answer']}\n")
Le champ metadata avec langfuse_session_id associe la trace à un ID de session. Exécutez et vous verrez :
Q1: The main security risks discussed are context window overflow, agent mismanagement, and indirect prompt injections.Ajoutez maintenant une relance avec le même ID de session :
response2 = qa_chain.invoke(
   {"input": "How can these risks be mitigated?"},
   config={
       "callbacks": [langfuse_handler],
       "metadata": {"langfuse_session_id": "conversation-001"}
   }
)
print(f"Q2: {response2['answer']}\n")
Cette deuxième question appartient à la même conversation, donc on réutilise conversation-001. Vous obtiendrez une réponse plus longue :
Q2: Risks can be mitigated through several strategies including:
1. Input Management: Limit and sanitize inputs going into the model.
2. Real-time Monitoring: Use systems that alert when the context window is nearing capacity.
3. Principle of Least Privilege: Implement this for all agents and external integrations.
....
Simulez maintenant un deuxième utilisateur avec d’autres questions. Ajoutez ceci à votre script :
# Session 2: Different user asking about AI applications
response3 = qa_chain.invoke(
   {"input": "What AI applications are mentioned in the document?"},
   config={
       "callbacks": [langfuse_handler],
       "metadata": {"langfuse_session_id": "conversation-002"}
   }
)
print(f"Q3: {response3['answer']}\n")

response4 = qa_chain.invoke(
   {"input": "What are the benefits of these applications?"},
   config={
       "callbacks": [langfuse_handler],
       "metadata": {"langfuse_session_id": "conversation-002"}
   }
)
print(f"Q4: {response4['answer']}\n")
Ces deux questions utilisent conversation-002. Exécutez le script complet :
uv run python sessions_demo.pyLes deux dernières sorties seront :
Q3: The document does not specifically mention any AI applications. However, it discusses the concept of generative AI and its security considerations.

Q4: The context does not provide specific benefits of these applications.
Allez maintenant dans votre tableau de bord LangFuse et cliquez sur « Sessions » à gauche. Vous verrez les deux conversations listées :
Deux sessions apparaissent : conversation-002 (~4 secondes) et conversation-001 (~14 secondes). LangFuse a regroupé les traces par ID de session.
Cliquez sur conversation-001 pour voir la conversation complète :
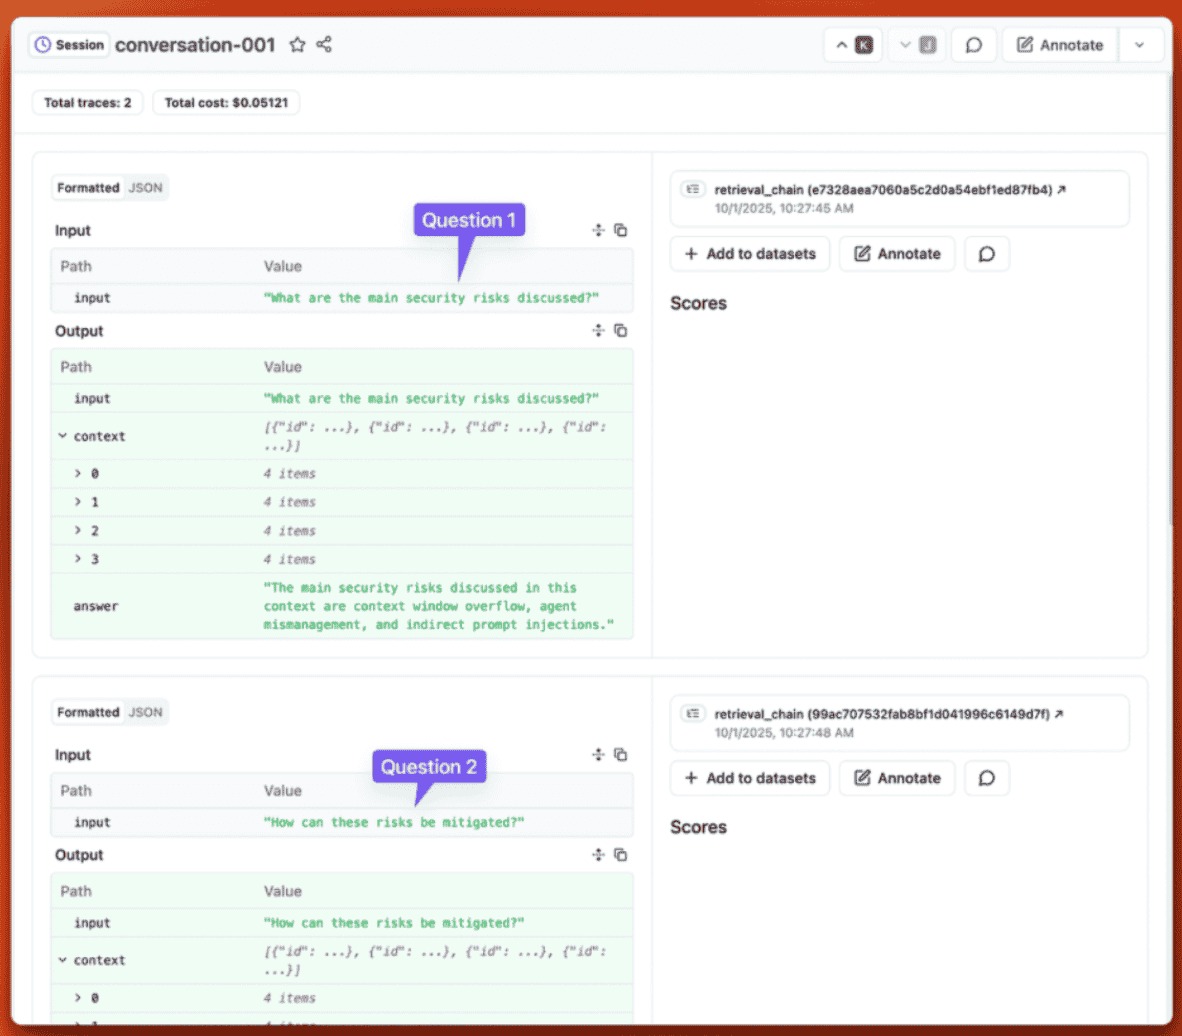
Vous voyez les deux traces dans l’ordre : Question 1 sur les risques, Question 2 sur l’atténuation. La session affiche le coût total (0,05121 $ pour les deux) et la durée (14 secondes). Chaque trace présente son entrée, sa sortie et le contexte retrouvé.
Cette vue session reflète exactement l’expérience de l’utilisateur. En cas d’incident, inutile de fouiller trace par trace : ouvrez sa session et suivez le fil complet.
Jusqu’ici, vous avez suivi les sessions. Mais qu’en est-il des utilisateurs ? Les vraies apps LLM doivent savoir quel utilisateur a fait quelle requête. À l’inscription, vous générez un ID unique et l’attachez à chaque appel LLM.
LangFuse permet de regrouper les traces par ID utilisateur en plus des sessions. C’est une autre façon d’organiser vos données d’observabilité.
Voici comment ajouter ce suivi. Créez user_tracking.py :
from build_chain import build_qa_chain
from langfuse.langchain import CallbackHandler

# Build the Q&A chain
qa_chain = build_qa_chain()

# Set up LangFuse handler
langfuse_handler = CallbackHandler()

# Simulate a new user asking a question
user_response = qa_chain.invoke(
   {"input": "What security controls are recommended for AI systems?"},
   config={
       "callbacks": [langfuse_handler],
       "metadata": {
           "langfuse_session_id": "conversation-003",
           "langfuse_user_id": "user-12345"
       }
   }
)
print(f"Response: {user_response['answer']}")
Le champ langfuse_user_id associe la trace à un utilisateur. Lancez le script :
uv run python user_tracking.pyVous verrez :
Response: The recommended security controls for AI systems include:

1. Adaptive defenses: Incorporate machine learning-powered filters that continuously learn and adapt to new adversarial techniques.
2. Defense-in-depth: Introduce layered security mechanisms, such as refusal classifiers and real-time input monitoring, to fortify AI system integrity.
3. Data classification: Properly classify your data according to sensitivity.
......
Allez dans le tableau de bord LangFuse. Cliquez sur « Users » à gauche : user-12345 apparaît. Cliquez pour voir toutes ses traces, toutes sessions confondues.
Cette vue utilisateur répond à des questions comme : « Combien l’utilisateur X nous a-t-il coûté ce mois-ci ? » ou « Quelles questions l’utilisateur Y pose-t-il régulièrement ? » Vous suivez ainsi les comportements individuels et déboguez des cas spécifiques.
Votre système de Q&R a un problème : le prompt est enfoui dans le code. Pour changer le comportement, vous devez éditer qa_chain.py, tester en local et redéployer. Si un collègue veut tenter une autre approche, il doit comprendre votre structure de code et ouvrir une branche. Vous ne pouvez pas comparer des versions de prompt côte à côte ni revenir à la version de la semaine dernière sans fouiller l’historique Git.
La gestion des prompts résout cela en les stockant hors du code. Vous les éditez dans une interface, ils sont versionnés automatiquement et récupérés dynamiquement à l’exécution. Votre code reste stable pendant que vos prompts s’améliorent.
Regardez le prompt de votre chaîne de Q&R :
prompt = ChatPromptTemplate.from_messages([
   ("system", "Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.\n\n{context}"),
   ("human", "{input}"),
])
C’est suffisants pour un projet solo. Mais en équipe ou en production, des prompts en dur posent des soucis :
La gestion des prompts de LangFuse traite les prompts comme des données, pas du code.
LangFuse stocke vos prompts de façon centrale avec versionnage automatique. Vous pouvez les créer via l’UI ou le SDK.
Allez dans votre tableau de bord LangFuse et cliquez sur « Prompts ». Cliquez sur « New Prompt » pour en créer un.
Vous verrez un formulaire pour :
document-qa-prompt)text ou chat){{variable}}production ou staging)Pour notre Q&R, créez un prompt de type chat avec deux messages :
Message système :
Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.

{{context}}
Message utilisateur :
{{input}}LangFuse détecte automatiquement les variables {{context}} et {{input}}.
Définissez ensuite la configuration :
{
 "model": "gpt-4",
 "temperature": 0.0
}
Ajoutez le label production pour marquer cette version en production.
Une fois enregistré, LangFuse crée la version 1 de votre prompt. Chaque édition sauvegardée crée une nouvelle version, les anciennes restent disponibles.
Vous pouvez aussi créer des prompts avec le SDK Python :
from langfuse import Langfuse

langfuse = Langfuse()

langfuse.create_prompt(
   name="document-qa-prompt",
   type="chat",
   prompt=[
       {"role": "system", "content": "Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.\n\n{{context}}"},
       {"role": "user", "content": "{{input}}"}
   ],
   labels=["production"]
)
Cela crée le même prompt de manière programmatique. Si vous rappelez create_prompt() avec le même nom, LangFuse ajoute une nouvelle version au lieu d’écraser l’existante.
LangFuse suit chaque modification avec des numéros de version (v1, v2, v3). Vous pouvez aussi affecter des labels aux versions pour gérer les déploiements :
production - version utilisée en prodstaging - version de préproductionlatest - pointe automatiquement vers la plus récenteQuand vous améliorez un prompt, vous créez une nouvelle version. Testez-la d’abord en staging via le label staging. Une fois validée, déplacez le label production sur la nouvelle version. Votre app de prod prendra le changement au prochain fetch.
L’UI LangFuse inclut un playground pour tester les prompts avant de les intégrer au code. Vous pouvez :
Ainsi, les non-tech peuvent expérimenter la formulation sans toucher au code.
Voici comment utiliser les prompts gérés par LangFuse dans votre application. Ce flux garde votre code stable pendant que vos prompts évoluent.
Dans votre code applicatif, récupérez le prompt depuis LangFuse plutôt que de le coder en dur :
from langfuse import Langfuse

langfuse = Langfuse()

# Get the production version
prompt = langfuse.get_prompt("document-qa-prompt", type="chat")
Cela récupère la version étiquetée production. LangFuse met les prompts en cache côté client : pas d’impact de latence sur vos appels LLM.
Vous pouvez aussi cibler des versions ou labels précis :
# Get version 2 specifically
prompt = langfuse.get_prompt("document-qa-prompt", version=2, type="chat")

# Get staging version
prompt = langfuse.get_prompt("document-qa-prompt", label="staging", type="chat")

# Get latest version (automatically maintained by LangFuse)
prompt = langfuse.get_prompt("document-qa-prompt", label="latest", type="chat")Le prompt récupéré est un modèle avec des {{variables}}. Compilez-le en remplaçant les variables par des valeurs réelles :
compiled_messages = prompt.compile(
   context="Retrieved document context goes here",
   input="What are the main security risks?"
)
Cela renvoie une liste de messages de chat prêts à envoyer au LLM :
[
   {
       "role": "system",
       "content": "Use the given context to answer the question. If you don't know the answer, say you don't know. Keep the answer concise.\n\nRetrieved document context goes here"
   },
   {
       "role": "user",
       "content": "What are the main security risks?"
   }
]Passez les messages compilés à votre appel LLM. Le code exact dépend de LangChain, de l’SDK OpenAI ou d’un autre framework.
Quand vous faites un appel LLM avec un prompt géré par LangFuse, liez-le à la trace. Vous verrez ainsi quelle version de prompt a été utilisée pour chaque appel et suivrez les métriques par version de prompt :
from langfuse.langchain import CallbackHandler

langfuse_handler = CallbackHandler()

response = qa_chain.invoke(
   {"input": "What are the main security risks?"},
   config={"callbacks": [langfuse_handler]}
)
Dans votre tableau de bord, vous verrez les traces regroupées par nom et version de prompt. Vous identifierez les versions plus coûteuses, plus lentes ou plus performantes.
C’est là que la gestion des prompts apporte le plus :
staging pour tester en préproductionproduction pour déployerVotre code ne change pas. Au prochain get_prompt() le nouveau prompt est récupéré.
Si la nouvelle version performe moins bien, revenez en arrière en réaffectant le label production à la version précédente. Aucun déploiement requis.
Ce mode de fonctionnement dissocie l’ingénierie de prompt du développement applicatif. Votre équipe itère vite sur les prompts pendant que le code reste stable.
Pour aller plus loin : LangFuse prend aussi en charge l’A/B testing pour répartir automatiquement le trafic entre versions de prompts, des webhooks pour notifier vos systèmes lors des changements, et des fonctions collaboratives comme commentaires et workflows d’approbation. Ces fonctionnalités avancées aident les équipes à l’échelle. Consultez la documentation sur la gestion des prompts pour les détails.
Vous avez construit un système de Q&R, ajouté l’observabilité et mis en place la gestion des prompts. Mais comment savoir si les réponses sont bonnes ? Pour l’instant, vous testez sans doute à la main : vous posez une question, lisez la réponse et jugez. Ça passe pour quelques exemples, pas à l’échelle.
Que se passe-t-il quand vous changez le prompt ? Il faut tout retester. Et les cas limites ? Difficile de se souvenir de tout. En production, impossible de mesurer si la v2 du prompt fait mieux que la v1.
L’évaluation corrige cela en mesurant systématiquement la performance de votre LLM. LangFuse fournit des outils pour scorer automatiquement les réponses, comparer des versions de prompts avec de vraies métriques et détecter les problèmes de qualité avant qu’ils n’atteignent les utilisateurs.
Les tests manuels vous disent si une réponse particulière est bonne. L’évaluation systématique vous dit si tout le système fonctionne bien sur des centaines ou milliers d’exemples.
Voici comment cela s’organise avec LangFuse :
Ce processus remplace « Je pense que ce prompt est meilleur » par « Ce prompt obtient 0,85 en pertinence vs 0,72 pour l’ancien. »
Pour un guide complet des approches d’évaluation et leur implémentation dans LangFuse, consultez la documentation d’ensemble sur l’évaluation.
Vous devez scorer des centaines de réponses. À la main, cela prend des heures. LLM-as-a-judge automatise la notation en utilisant un autre LLM comme juge pour évaluer les sorties du LLM principal.
Vous fournissez à ce juge trois éléments : la question d’origine, la réponse de votre système de Q&R et les critères de notation. Le juge lit la réponse et attribue un score.
Pour un système de Q&R, plusieurs dimensions qualitatives comptent. Voici trois juges possibles :
Juge de justesse : « Évaluez si la réponse reflète correctement l’information du contexte fourni. Notez 1 si c’est exact, 0,5 si partiellement correct, 0 si faux ou hallucination. »
Cela détecte les contradictions ou inventions par rapport à vos documents.
Juge de pertinence : « Évaluez si la réponse traite directement la question. Notez 1 si très pertinente, 0,5 si moyennement, 0 si hors sujet. »
Cela évite de donner des réponses exactes mais éloignées du besoin.
Juge d’ancrage : « Évaluez si la réponse s’appuie uniquement sur le contexte fourni. Notez 1 si totalement ancrée, 0,5 si partiellement, 0 si elle inclut des informations extérieures. »
Cela prévient les hallucinations où le LLM ajoute des faits non présents.
Chaque juge évalue une dimension. En les combinant, vous obtenez un profil de qualité complet. Vous pouvez ajouter des juges pour le style (est-ce concis ?), le ton (professionnel ?), ou la gestion du refus (dire « Je ne sais pas » au bon moment).
LangFuse permet de configurer des juges LLM via l’UI ou l’API. Le processus :
Les juges s’exécutent de façon asynchrone, sans ralentir l’app principale. Vous consultez les scores dans le tableau de bord une fois les tests terminés.
Les juges LLM excellent pour des critères subjectifs difficiles à coder : ton, pertinence, style. Ils sont moins fiables pour des faits objectifs. Pour vérifier « 2+2=4 », préférez un contrôle déterministe.
Pour notre Q&R, les juges sont pertinents pour la pertinence et l’ancrage, et peuvent être combinés à des vérifications déterministes (par ex. : réponse < 100 mots).
Les juges LLM ne sont pas parfaits. Ils peuvent diverger, présenter des biais de style et se laisser convaincre par des réponses assurées mais fausses.
Pour gérer cela : testez-les sur des cas à score connu, utilisez plusieurs juges et faites une moyenne, et effectuez des contrôles ponctuels pour détecter leurs erreurs.
Note d’implémentation : des workflows d’évaluation complets impliquent la création de datasets, la configuration des juges, l’exécution en batch et l’analyse des résultats. C’est plus étendu que ce que nous pouvons couvrir ici. La documentation LLM-as-a-judge détaille l’implémentation, avec code et bonnes pratiques. Pour des scores personnalisés au-delà des juges LLM, voir le guide sur les scores personnalisés.
Le flux présenté décrit l’état d’esprit évaluation. Une fois vos traces et prompts gérés dans LangFuse, l’évaluation systématique vient naturellement : construisez vos jeux de test progressivement, commencez par des juges simples et affinez au fil des apprentissages sur les métriques qui comptent pour votre application.
Pour aller plus loin : LangFuse gère aussi l’organisation des datasets de test, des fonctions de scoring personnalisées pour des contrôles déterministes, et l’évaluation continue qui s’exécute automatiquement sur le trafic de production. Ces fonctionnalités vous aident à maintenir la qualité en croissance. Consultez la vue d’ensemble de l’évaluation pour une vision complète.
Vous avez construit un système de Q&R sur documents et vu comment les trois piliers de LangFuse se complètent. L’observabilité vous montre ce qui se passe quand votre LLM tourne : chaque trace, chaque coût, chaque token. La gestion des prompts sort les prompts du code et les place dans un système versionné pour itérer sans déploiement. L’évaluation vous permet de mesurer la qualité de façon systématique au lieu de deviner. Ces briques se connectent : les traces alimentent les datasets d’évaluation, les versions de prompts se lient aux métriques de performance, et l’ensemble vous aide à savoir si vos changements améliorent ou non le système.
Commencez petit sur vos propres projets. Choisissez une fonctionnalité : ajoutez le tracing pour voir où votre app dépense, ou sortez un prompt codé en dur vers la gestion LangFuse. Les schémas vus avec notre Q&R simple s’étendent aux pipelines RAG complexes, aux systèmes multi-agents et aux apps de production à grande échelle. Consultez la documentation LangFuse pour approfondir des fonctionnalités spécifiques, ou essayez les notebooks d’exemples montrant des implémentations réelles. La prochaine fois que vous construirez avec des LLM, vous aurez les outils pour voir, contrôler et mesurer l’essentiel.
Apprenez avec DataCamp
{count, plural, one {Cours} other {Cours}}
{count, plural, one {Cours} other {Cours}}
{count, plural, one {Cours} other {Cours}}